Dlaczego liczby w pracy się rozjeżdżają
Rozdział wyników powstaje zwykle tak: liczysz w SPSS, R albo jamovi, przepisujesz liczby do Worda, potem poprawiasz analizę po uwagach promotora, usuwasz kilka ankiet, przeliczasz – i część liczb w tekście zostaje ze starej wersji. Na końcu streszczenie piszesz z pamięci albo kopiujesz z wcześniejszego szkicu. Widać go dopiero wtedy, gdy zestawisz ją z innymi: suma liczebności nie daje N, wartość p nie pasuje do statystyki testu, a przedział ufności nie wynika ze średniej i odchylenia standardowego.
To nie jest problem wyłącznie studentów. Bakker i Wicherts (2011) sprawdzili 281 artykułów z czasopism psychologicznych i ocenili, że około 18% wyników statystycznych podano niespójnie, a w około 15% artykułów co najmniej jeden wniosek o istotności zmieniał się po przeliczeniu. Nuijten i in. (2016) przeliczyli programem ponad 250 tysięcy wartości p: połowa artykułów stosujących testy istotności zawierała co najmniej jedną wartość niezgodną ze statystyką testu i stopniami swobody. Brown i Heathers (2017) pokazali, że średnią z odpowiedzi całkowitych można sprawdzić przy znanym n – tak działa test GRIM.
Ten wpis to procedura na ostatni tydzień przed oddaniem pracy: osiem kontroli, które przechodzisz po kolei, z kodem w R, który robi to za Ciebie. Nie omawia, co sprawdza recenzent ani jak odpowiadać na jego uwagi – to jest we wpisie recenzja pracy magisterskiej – część badawcza. Nie powtarza też listy poprawek promotora z wpisu poprawki promotora w rozdziale wyników. Tu chodzi o jedno: czy liczby w Twojej pracy mogą być jednocześnie prawdziwe.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa bada wypalenie zawodowe (skala z 6 pozycji 1–5) i satysfakcję z pracy (jedno pytanie 1–5) u pielęgniarek. Zwrócono 163 ankiety, wykluczono 5 z brakami powyżej 20% odpowiedzi i 5 osób niespełniających kryteriów włączenia, analizowano N = 153. Liczby policzyliśmy w R z symulowanych danych, a potem do „pracy” wstawiliśmy sześć błędów, które najczęściej powstają przy przepisywaniu. Kontrola nie korzysta z surowych danych – widzi tylko to, co widziałby promotor: tekst i tabele.
Przykład: fragment rozdziału z sześcioma błędami
Tak wygląda akapit wyników w wersji, którą studentka chciała oddać (błędy są w nim celowo):
Analizowano odpowiedzi N = 153 osób. Średni poziom wypalenia w grupie pracującej zmianowo wynosił M = 3.33 (SD = 0.64), a w grupie bez pracy zmianowej M = 3.08 (SD = 0.71), t(151) = 2.33, p = .011. Staż korelował z wypaleniem, r(151) = −.22, p = .007. Odsetek pracy zmianowej nie różnił się między grupami stażu, χ²(2, N = 153) = 2.51, p = .285. Wypalenie różniło się między grupami stażu, F(2, 153) = 4.00, p = .020.
Streszczenie powtarza wynik testu t w tym samym brzmieniu, a dyskusja – korelację i obie średnie. Do tego dwie tabele:
| Zmienna | Kategoria | n | % |
|---|---|---|---|
| Płeć | kobieta | 133 | 88.2 |
| mężczyzna | 18 | 11.8 | |
| Staż pracy | do 5 lat | 25 | 16.3 |
| 6–15 lat | 83 | 50.9 | |
| powyżej 15 lat | 45 | 29.4 | |
| Praca zmianowa | nie | 60 | 39.2 |
| tak | 93 | 60.8 |
| Zmienna | Grupa | n | M | SD | 95% CI |
|---|---|---|---|---|---|
| Wypalenie (6 pozycji) | bez pracy zmianowej | 60 | 3.08 | 0.71 | [2.89, 3.26] |
| praca zmianowa | 93 | 3.33 | 0.64 | [3.10, 3.46] | |
| Satysfakcja (1 pytanie) | kobiety | 135 | 3.57 | 1.00 | [3.40, 3.74] |
| mężczyźni | 18 | 3.62 | 1.24 | [2.99, 4.23] |
Osiem kontroli – przegląd
Każda kontrola porównuje dwie liczby, które muszą do siebie pasować. Tolerancja wynika z zaokrąglenia: jeśli liczba ma jedno miejsce po przecinku, jej prawdziwa wartość może się różnić od zapisanej najwyżej o 0.05.
| Kontrola | Co z czym porównać | Dopuszczalna różnica |
|---|---|---|
| 1. Przepływ i N | zebrane − wykluczone = analizowane; to samo N w metodzie, tabelach, streszczeniu | zero |
| 2. Suma n | suma liczebności kategorii w tabeli = N (albo N minus opisane braki) | zero |
| 3. Procenty | % = n / N · 100; suma procentów = 100 | 0.05 na każdy procent z jednym miejscem po przecinku |
| 4. p a statystyka | p przeliczone z t, F, χ² lub r i df | zakres wynikający z zaokrąglenia statystyki |
| 5. Stopnie swobody | df a liczebność i plan analizy | zero (wyjątek: test Welcha, braki) |
| 6. Przedział ufności | CI = M ± t · SD / √n; środek przedziału = M | około 0.01 przy dwóch miejscach |
| 7. GRIM | czy średnia z odpowiedzi całkowitych jest możliwa przy n i liczbie pozycji | zero; działa tylko przy n · k < 100 |
| 8. Te same liczby w całej pracy | streszczenie, wyniki, dyskusja, wnioski; liczba miejsc po przecinku | zero |
Kontrola 1–2: przepływ, N i suma liczebności
Zacznij od liczby, na której opiera się wszystko inne. W metodzie piszesz, ile ankiet zebrano, ile wykluczono i z jakich powodów, oraz ile osób analizowano. Odejmij: 163 − 5 − 5 = 153. Ta sama liczba musi się pojawić w streszczeniu, w nagłówku tabeli charakterystyki próby i w opisie wyników. Jeśli przepływ ma kilka etapów, narysuj go – sposób pokazuje wpis o diagramie przepływu respondentów.
Potem zsumuj liczebności każdej zmiennej w tabeli charakterystyki próby. W przykładzie płeć daje 133 + 18 = 151, a nie 153. Brakuje dwóch osób. Są dwie możliwości: albo dwie osoby nie podały płci i trzeba to napisać w nocie pod tabelą (np. „2 osoby nie odpowiedziały na pytanie o płeć”), albo w tabeli jest literówka. Tu jest literówka – w danych kobiet jest 135, co zdradza też procent (o tym niżej). Jeśli różnica wynika z braków, opisz je; zasady podaje wpis braki danych w ankiecie, a układ tabeli – tabela 1 – charakterystyka próby.
Kontrola 3: procenty i zaokrąglenia
Każdy procent przelicz z liczebności: 133 / 153 · 100 = 86.9%, a w tabeli stoi 88.2%. Takie 88.2% daje 135 osób ze 153 – więc liczba 133 jest błędna, a procent został policzony z prawdziwej liczebności. Jeden błąd dał dwa sygnały: zła suma i zły procent.
Drugi błąd jest typowy: procent policzony od złego mianownika. Grupa stażu 6–15 lat to 83 osoby, czyli 54.2% z 153. W tabeli jest 50.9%, czyli 83 ze 163 zwróconych ankiet. Suma procentów w tej zmiennej wynosi 96.6%.
Czy suma musi wynosić dokładnie 100.0%? Nie. Każdy procent zaokrąglony do jednego miejsca może się różnić od prawdziwego o 0.05 punktu procentowego, więc przy trzech kategoriach suma może leżeć między 99.85% a 100.15%. Po poprawieniu błędu procenty stażu to 16.3%, 54.2% i 29.4% – razem 99.9%. To zaokrąglenie, a nie błąd. Nie poprawiaj ręcznie jednej kategorii, żeby suma wyszła 100.0%. Lepiej dodaj notę: „Odsetki mogą nie sumować się do 100% z powodu zaokrągleń”. Wyjątkiem są pytania wielokrotnego wyboru – tam suma może przekraczać 100% i to nie jest błąd.
Kontrola 4: wartość p a statystyka testu
Wartość p nie jest niezależną liczbą. Wynika ze statystyki testu i stopni swobody, więc możesz ją przeliczyć – tak samo jak robi to program statcheck opisany w haśle statcheck i SPRITE. W R wystarczy jedna linia: dla testu t to 2 * pt(-abs(t), df), dla F – pf(F, df1, df2, lower.tail = FALSE), dla χ² – pchisq(x, df, lower.tail = FALSE). Bez R przeliczysz to w kalkulatorze wartości p.
Statystyka w tekście jest zaokrąglona, więc licz zakres. Zapis t(151) = 2.33 oznacza wartość od 2.325 do 2.335, a to daje p od .0209 do .0214, czyli po zaokrągleniu .021. W pracy jest p = .011 – mniej więcej połowa. Taki wzór niemal zawsze oznacza, że ktoś podał p jednostronne (albo program je wydrukował), a w tekście nie napisał, że test był jednostronny. Rysunek 1 pokazuje, że podana wartość leży na krzywej jednostronnej, a nie dwustronnej.
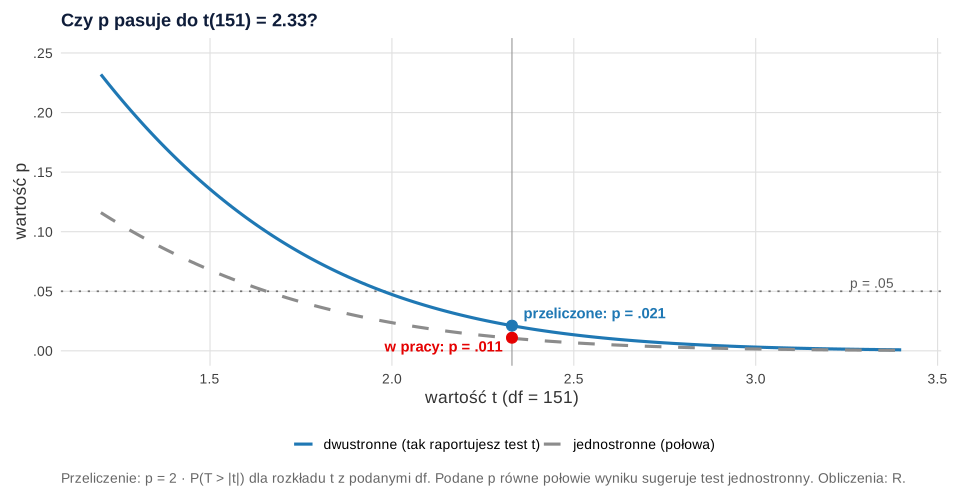
W tym przykładzie wniosek się nie zmienia – oba p są poniżej .05. Gdyby jednak przeliczone p wynosiło .08, a podane .04, zmieniłby się wniosek o hipotezie. Nuijten i in. (2016) nazywają to błędem rażącym (decyzji). Pozostałe trzy wyniki z akapitu są spójne: dla r(151) = −.22 możliwe p leży między .0052 a .0076 (podane .007), dla χ²(2, N = 153) = 2.51 – między .2844 a .2858 (podane .285), a dla F = 4.00 – .020. Zapis „p < .001” jest spójny, jeśli cały zakres przeliczonego p leży poniżej .001.
Jeśli zamiast p podajesz różnicę z przedziałem ufności, kontrola działa w drugą stronę. Altman i Bland (2011) pokazują, jak z oszacowania i 95% CI odtworzyć p: błąd standardowy to szerokość przedziału podzielona przez 2 · 1.96, a z to oszacowanie podzielone przez ten błąd. Przedział, który nie obejmuje zera, musi iść w parze z p < .05.
Kontrola 5: stopnie swobody a liczebność
Stopnie swobody wynikają z liczby osób i z planu analizy, więc sprawdzisz je bez danych:
| Analiza | Stopnie swobody | W przykładzie (N = 153) |
|---|---|---|
| test t dla dwóch grup niezależnych (Student) | n1 + n2 − 2 | 60 + 93 − 2 = 151 |
| test t dla prób zależnych | liczba par − 1 | – |
| korelacja Pearsona | N − 2 | 151 |
| ANOVA jednoczynnikowa, k grup | k − 1, N − k | 2, 150 |
| χ² w tabeli w × k | (w − 1)(k − 1), plus N w nawiasie | 2, N = 153 |
| regresja z p predyktorami | p, N − p − 1 | – |
W przykładzie ANOVA ma zapis F(2, 153), a przy trzech grupach stażu i 153 osobach powinno być F(2, 150). Ten błąd bierze się z wpisania N zamiast N − k. Wartość p prawie się nie zmienia, więc kontrola 4 go nie wyłapie – dlatego df sprawdzasz osobno. Dwa wyjątki nie są błędami: test Welcha ma ułamkowe df (np. t(127.4)), a analiza z brakami w jednej zmiennej ma mniejsze df niż wynika z N. W obu przypadkach wystarczy zdanie wyjaśnienia w tekście albo w nocie.
Kontrola 6: przedział ufności a średnia, SD i n
Przedział ufności dla średniej to M ± t0.975; n−1 · SD / √n, gdzie SD / √n to błąd standardowy. Dwie szybkie kontrole: środek przedziału powinien równać się średniej (z dokładnością do zaokrąglenia), a szerokość – wynikać z SD i n. W grupie pracującej zmianowo przedział [3.10, 3.46] ma środek 3.28, czyli o 0.05 mniej niż M = 3.33. Z M = 3.33, SD = 0.64 i n = 93 wychodzi [3.20, 3.46] – dolna granica ma literówkę.
Przedział dla średniej jest symetryczny, ale nie każdy musi taki być. Asymetryczne są przedziały dla proporcji (np. Wilsona), dla ilorazu szans, dla korelacji i przedziały bootstrapowe. Wtedy sprawdzaj tylko, czy oszacowanie leży w przedziale i czy przedział zgadza się z p. Pojedynczy przedział przeliczysz w kalkulatorze przedziału ufności, a sposób raportowania CI w pracy opisuje wpis przedziały ufności w pracy.
Kontrola 7: GRIM – czy średnia jest w ogóle możliwa
Jeśli odpowiedzi są liczbami całkowitymi (pytanie 1–5), ich suma też jest liczbą całkowitą. Średnia z n osób i k pozycji może więc przyjmować tylko wartości co 1 / (n · k). Przy 18 mężczyznach i jednym pytaniu o satysfakcję możliwe są np. 65 / 18 = 3.611 i 66 / 18 = 3.667. Podana w tabeli średnia 3.62 nie wynika z żadnej sumy – jest niemożliwa (rysunek 2). Prawdziwa średnia w danych to 3.61.
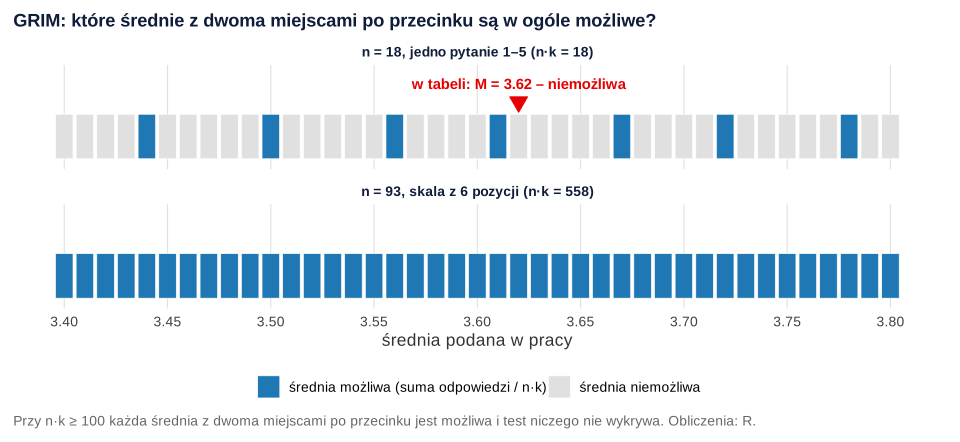
GRIM ma wyraźną granicę. Gdy n · k wynosi co najmniej 100, możliwa jest każda średnia z dwoma miejscami po przecinku. W przykładzie nie da się więc sprawdzić średniej satysfakcji kobiet (n = 135) ani średnich wypalenia (6 pozycji, n · k = 360 i 558). Test przydaje się przy małych podgrupach i pojedynczych pytaniach, czyli tam, gdzie błędy przy przepisywaniu są najbardziej prawdopodobne. Pamiętaj o liczbie pozycji: średnia skali z trzech pozycji ma trzy razy gęstszą siatkę niż średnia jednego pytania.
Kontrola 8: te same liczby w streszczeniu, wynikach, dyskusji i wnioskach
Najczęstsze źródło niezgodności to nie rachunek, tylko wersje. Wyniki poprawiasz po uwagach promotora, a streszczenie, dyskusja i wnioski zostają ze starej wersji. Przejdź po kolei: każdą liczbę ze streszczenia, z dyskusji i z wniosków znajdź w rozdziale wyników i porównaj. Sprawdź też słowa: jeśli wynik okazał się nieistotny, w streszczeniu nie może zostać „istotnie wyższy”.
W przykładzie streszczenie i wyniki podają ten sam zapis testu t – z tym samym błędnym p. Sama zgodność między sekcjami nie oznacza więc poprawności. Oznacza natomiast, że poprawka musi trafić w oba miejsca. Dlatego listę miejsc do poprawienia prowadź według liczb, a nie według rozdziałów.
Przy okazji sprawdź liczbę miejsc po przecinku. Zasady zapisu liczb i wyników statystycznych opisuje rozdział 6 podręcznika APA (American Psychological Association, 2020). Na metodolog.pl stosujemy konwencję: średnie, SD i statystyki testów z dwoma miejscami, p z trzema i bez zera wiodącego, procenty z jednym miejscem. Konkretna liczba miejsc jest mniej ważna niż konsekwencja – ta sama wielkość ma mieć tyle samo miejsc w tekście, tabelach i streszczeniu. Więcej o zapisie: jak opisać wyniki w stylu APA i statystyki opisowe w pracy.
Pojedyncze liczby sprawdzisz bez kodu w kalkulatorze spójności wyników: GRIM, p ze statystyki, sumy i odsetki oraz przedziały ufności.
Co znalazła kontrola
Kod na końcu wpisu przeszedł osiem kontroli i sprawdził 38 wartości. Zgłosił 9 sygnałów, które prowadzą do 6 błędów (rysunek 3).
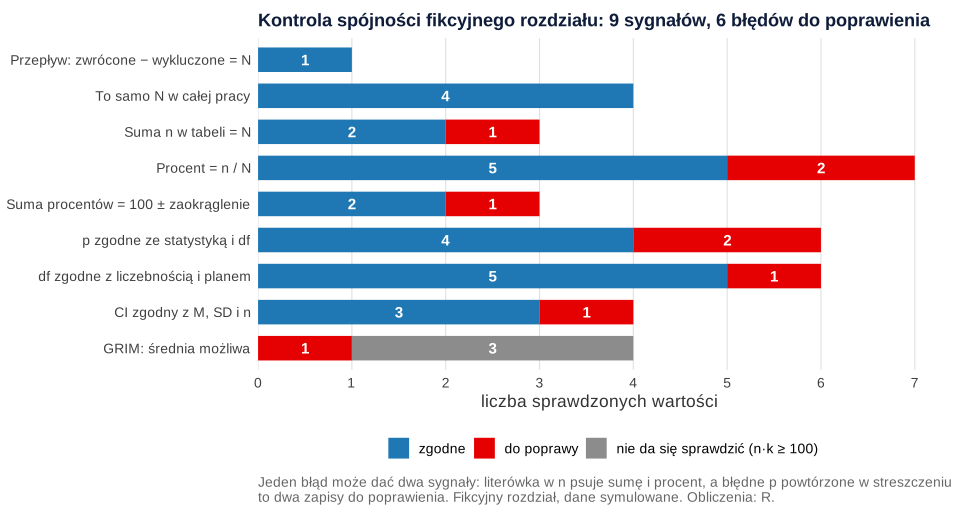
| Gdzie | Było | Sygnał | Poprawka |
|---|---|---|---|
| Tabela 1, płeć | kobiety 133 | suma 151 ≠ 153; 133/153 = 86.9%, a nie 88.2% | 135 (88.2%) |
| Tabela 1, staż | 6–15 lat: 50.9% | suma procentów 96.6%; 83/163 zamiast 83/153 | 54.2% |
| Streszczenie i wyniki | t(151) = 2.33, p = .011 | przeliczone p = .021 (podane to połowa) | p = .021 w obu miejscach |
| Wyniki, ANOVA | F(2, 153) | 3 grupy, N = 153 → df = 2, 150 | F(2, 150) = 4.00 |
| Tabela 2, wypalenie | [3.10, 3.46] | środek przedziału 3.28 ≠ M = 3.33 | [3.20, 3.46] |
| Tabela 2, satysfakcja | mężczyźni M = 3.62 | GRIM: przy n = 18 możliwe 3.611 lub 3.667 | M = 3.61 |
Kod sprawdza tylko to, co da się przeliczyć. Nie oceni, czy test był dobrze dobrany ani czy interpretacja jest trafna. Nie wykryje też błędu, który jest spójny – np. gdy cały wiersz przepisano z innej analizy. Tę część kontroli robisz, czytając wyniki obok wydruku z programu.
Jak nie wprowadzać błędów: liczby z kodu, nie z klawiatury
Wszystkie sześć błędów w przykładzie powstało przy przenoszeniu liczb z programu do tekstu. Najskuteczniejsza ochrona to nie przepisywać. W R zdanie z wynikiem może powstać wprost z obiektu testu (przepis 3 w kodzie): funkcja bierze t, df i p z wyniku t.test() i składa zapis APA. Po każdej zmianie danych uruchamiasz skrypt jeszcze raz i wszystkie liczby aktualizują się razem. W poprawionej wersji ta sama kontrola nie znalazła ani jednego problemu. Jeśli pracujesz w SPSS albo jamovi, kopiuj tabele wyników bezpośrednio z okna wyników, a zdania sprawdzaj w generatorze opisu wyników APA.
Druga ochrona to porządek w plikach: jeden skrypt albo plik składni, który od surowych danych dochodzi do tabel z pracy. Jak taki zestaw przygotować, opisuje wpis pakiet replikacyjny. To nie tylko wygoda. Wicherts, Bakker i Molenaar (2011) zauważyli, że autorzy, którzy nie chcieli udostępnić danych do ponownej analizy, częściej mieli w artykułach widoczne błędy w raportowaniu wyników. Reguły kontroli samych danych przed analizą (zakresy, logika odpowiedzi) to osobny krok – opisuje go wpis o regułach kontroli danych.
Gotowe zdania i noty do pracy
Większość niezgodności znika po poprawieniu liczby. Część ma jednak uzasadnienie – wtedy trzeba je wyjaśnić jednym zdaniem albo notą pod tabelą. Poniższe wzory dopasuj do swoich liczb.
Nota przy brakach w jednej zmiennej: Dwie osoby nie odpowiedziały na pytanie o płeć; odsetki obliczono względem n = 151 osób, które na nie odpowiedziały.
Zdanie przy teście jednostronnym: Hipotezę kierunkową sformułowano przed zebraniem danych, dlatego zastosowano test jednostronny; t(151) = 2.33, p = .011 (jednostronne).
Zdanie przy różnej liczebności analiz: Liczebność w poszczególnych analizach różni się od N = 153, ponieważ braki danych usuwano oddzielnie dla każdej analizy; stopnie swobody podano dla liczby osób uwzględnionych w danej analizie.
Zdanie przy teście Welcha: Ze względu na różne wariancje w grupach zastosowano test t Welcha, stąd ułamkowa liczba stopni swobody.
Jeśli po kontroli wysyłasz promotorowi poprawioną wersję, dołącz krótką listę: co zmieniono i gdzie. Do tego służy tabela poprawek z wpisu o poprawkach promotora.
Najczęstsze błędy przy kontroli liczb
- Poprawianie liczby w jednym miejscu. Błędne p poprawione w wynikach, ale nie w streszczeniu i wnioskach. Szukaj każdej liczby w całym pliku (Ctrl+F).
- „Dociąganie” procentów do 100.0%. Suma 99.9% przy trzech kategoriach mieści się w granicach zaokrąglenia. Ręczna zmiana jednej kategorii tworzy prawdziwy błąd.
- Uznanie zgodności za poprawność. Ten sam zapis w streszczeniu i wynikach może być w obu miejscach błędny.
- Sprawdzanie p bez stopni swobody. Błędne df często prawie nie zmieniają p, więc trzeba je porównać z liczebnością osobno.
- GRIM przy dużej próbie albo bez liczby pozycji. Przy n · k ≥ 100 test niczego nie wykrywa, a średnia skali ma inną siatkę niż średnia jednego pytania.
- Traktowanie fałszywego alarmu jak błędu. Test Welcha, test jednostronny, poprawka na wielokrotne porównania albo braki w jednej zmiennej dają „niezgodności”, które wymagają zdania wyjaśnienia, a nie zmiany liczby.
- Kontrola na starej wersji pliku. Sprawdzaj wersję, którą naprawdę oddajesz – po ostatnich poprawkach i po złożeniu całości.
Kontrola spójności liczb w R
Trzy przepisy w bazowym R, bez dodatkowych pakietów. Pierwszy tworzy symulowane dane i fikcyjny rozdział z sześcioma błędami (tekst zapisuje w pliku b440-rozdzial.txt, a tabele – w pliku CSV w folderze nadrzędnym, ../). Drugi to właściwa kontrola: czyta tylko tekst i tabele, tak jak promotor. Trzeci pokazuje, jak generować zdania z wyników i sprawdza poprawioną wersję tą samą kontrolą. Przepisy uruchamiaj po kolei z jednego folderu. Na własnej pracy użyj przepisu 2: wklej swój tekst do pliku (jedna linia na sekcję: metoda:, streszczenie:, wyniki:, dyskusja:), tabele zapisz w CSV o tych samych kolumnach, a oczekiwane df dopasuj do swojego planu analizy. Rysunki powstały w osobnym skrypcie na wynikach przepisu 2. Tabele z fikcyjnej pracy możesz pobrać: kontrola-spojnosci-tabele-z-pracy.csv (11 wierszy: tabela, zmienna, kategoria, n, procent, M, SD, granice 95% CI, liczba pozycji skali).
Dane i fikcyjny rozdział z sześcioma błędami
R
# B440 – fikcyjne badanie ankietowe i fikcyjny „rozdział wyników” z sześcioma celowo wstawionymi błędami
# Badanie (wymyślone, dane symulowane): wypalenie zawodowe i satysfakcja z pracy u pielęgniarek.
# Ten przepis liczy poprawne wyniki z danych, a potem zapisuje tekst rozdziału z błędami,
# które zwykle powstają przy ręcznym przepisywaniu liczb z programu do pracy.
set.seed(440)

# ---- 1. Dane: 163 zwrócone ankiety, część wykluczona przed analizą
N_zwrot <- 163
plec  <- sample(c("kobieta", "mężczyzna"), N_zwrot, TRUE, c(.88, .12))
staz  <- pmin(pmax(round(rgamma(N_zwrot, 2.2, 0.17)), 1), 38)          # staż pracy w latach
zmiany <- rbinom(N_zwrot, 1, plogis(0.9 - 0.04 * staz))                 # praca zmianowa 0/1
w_lat <- -0.022 * staz + 0.22 * zmiany + rnorm(N_zwrot, 0, .55)
poz   <- sapply(1:6, function(j) pmin(pmax(round(3.4 + w_lat + rnorm(N_zwrot, 0, .7)), 1), 5))
satysf <- pmin(pmax(round(3.6 - 0.8 * w_lat + rnorm(N_zwrot, 0, .9)), 1), 5)  # jedno pytanie 1–5
braki <- rbinom(N_zwrot, 1, .06) == 1                                   # > 20% braków w ankiecie
kryt  <- !braki & rbinom(N_zwrot, 1, .03) == 1                          # poza kryteriami włączenia
d <- data.frame(plec, staz, zmiany = factor(zmiany, 0:1, c("nie", "tak")),
                wypalenie = rowMeans(poz), satysf)[!braki & !kryt, ]
d$staz_gr <- cut(d$staz, c(0, 5, 15, 99), c("do 5 lat", "6–15 lat", "powyżej 15 lat"))
N <- nrow(d)
cat(sprintf("Zwrócone: %d, wykluczone: %d (braki) + %d (kryteria włączenia), analizowane: N = %d\n",
            N_zwrot, sum(braki), sum(kryt), N))

write.csv(d, "b440-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")   # dane do przepisu 3

# ---- 2. Poprawne wyniki
f1 <- function(x) formatC(x, format = "f", digits = 1)
f2 <- function(x) formatC(x, format = "f", digits = 2)
pp <- function(p) if (p < .001) "< .001" else paste("=", sub("^0", "", formatC(p, format = "f", digits = 3)))
tab_n <- function(x) { t <- table(x); data.frame(kategoria = names(t), n = as.vector(t), proc = round(100 * as.vector(t) / N, 1)) }
T_plec <- tab_n(d$plec); T_staz <- tab_n(d$staz_gr); T_zm <- tab_n(d$zmiany)
tt <- t.test(wypalenie ~ zmiany, data = d, var.equal = TRUE)
rr <- cor.test(d$staz, d$wypalenie)
ch <- chisq.test(table(d$zmiany, d$staz_gr))
av <- summary(aov(wypalenie ~ staz_gr, data = d))[[1]]
opis <- function(y, g) do.call(rbind, lapply(split(y, g), function(v) {
  n <- length(v); m <- mean(v); s <- sd(v); se <- s / sqrt(n); q <- qt(.975, n - 1)
  data.frame(n = n, M = round(m, 2), SD = round(s, 2), CI_od = round(m - q * se, 2), CI_do = round(m + q * se, 2))
}))
T_wyp <- opis(d$wypalenie, d$zmiany)
T_sat <- opis(d$satysf, d$plec)
cat("\nPoprawne wyniki z danych:\n")
cat(sprintf("t(%d) = %s, p %s\n", tt$parameter, f2(abs(tt$statistic)), pp(tt$p.value)))
cat(sprintf("r(%d) = %s, p %s\n", rr$parameter, sub("0\\.", ".", f2(rr$estimate)), pp(rr$p.value)))
cat(sprintf("chi2(%d, N = %d) = %s, p %s\n", ch$parameter, N, f2(ch$statistic), pp(ch$p.value)))
cat(sprintf("F(%d, %d) = %s, p %s\n", av$Df[1], av$Df[2], f2(av$`F value`[1]), pp(av$`Pr(>F)`[1])))
print(rbind(T_plec, T_staz, T_zm), row.names = FALSE)
print(cbind(zmienna = c("wypalenie", "wypalenie", "satysfakcja", "satysfakcja"), rbind(T_wyp, T_sat)))

# ---- 3. Sześć błędów, które wstawiamy do „pracy” (tak powstają przy przepisywaniu)
B <- list()
B$plec_n   <- T_plec$n; B$plec_n[1] <- T_plec$n[1] - 2                  # 1: literówka w n (suma ≠ N)
B$plec_p   <- T_plec$proc
B$staz_n   <- T_staz$n
B$staz_p   <- T_staz$proc; B$staz_p[2] <- round(100 * T_staz$n[2] / N_zwrot, 1)  # 2: procent ze 163 zwróconych, nie z N
B$t_p      <- tt$p.value / 2                                               # 3: p jednostronne bez informacji
B$F_df2    <- N                                                            # 4: df2 = N zamiast N − k
B$wyp_CIod <- T_wyp$CI_od; B$wyp_CIod[2] <- T_wyp$CI_od[2] - 0.10          # 5: literówka w dolnej granicy CI
B$sat_M    <- T_sat$M; B$sat_M[2] <- T_sat$M[2] + 0.01                     # 6: średnia niemożliwa (GRIM)

# ---- 4. Tekst „pracy”: metoda (przepływ), streszczenie, wyniki, dyskusja
t_txt  <- sprintf("t(%d) = %s, p %s", tt$parameter, f2(abs(tt$statistic)), pp(B$t_p))
r_txt  <- sprintf("r(%d) = −%s, p %s", rr$parameter, sub("^-?0", "", f2(rr$estimate)), pp(rr$p.value))
ch_txt <- sprintf("χ²(%d, N = %d) = %s, p %s", ch$parameter, N, f2(ch$statistic), pp(ch$p.value))
F_txt  <- sprintf("F(%d, %d) = %s, p %s", av$Df[1], B$F_df2, f2(av$`F value`[1]), pp(av$`Pr(>F)`[1]))
rozdzial <- c(
  metoda = paste0("Zwrócono ", N_zwrot, " ankiet. Wykluczono ", sum(braki), " ankiet z brakami powyżej 20% odpowiedzi i ",
                  sum(kryt), " osób niespełniających kryteriów włączenia. Analizowano odpowiedzi N = ", N, " osób."),
  streszczenie = paste0("Zbadano N = ", N, " pielęgniarek. Osoby pracujące w systemie zmianowym miały istotnie wyższy ",
                        "poziom wypalenia, ", t_txt, ". Dłuższy staż wiązał się z niższym wypaleniem, ", r_txt, "."),
  wyniki = paste0("Analizowano odpowiedzi N = ", N, " osób. Średni poziom wypalenia w grupie pracującej zmianowo wynosił M = ",
                  f2(T_wyp$M[2]), " (SD = ", f2(T_wyp$SD[2]), "), a w grupie bez pracy zmianowej M = ", f2(T_wyp$M[1]),
                  " (SD = ", f2(T_wyp$SD[1]), "), ", t_txt, ". Staż korelował z wypaleniem, ", r_txt,
                  ". Odsetek pracy zmianowej nie różnił się między grupami stażu, ", ch_txt,
                  ". Wypalenie różniło się między grupami stażu, ", F_txt, "."),
  dyskusja = paste0("Wynik r = −", sub("^-?0", "", f2(rr$estimate)), " wskazuje na umiarkowany związek stażu z wypaleniem. ",
                    "Średnie wypalenie w grupie pracującej zmianowo (M = ", f2(T_wyp$M[2]), ") było wyższe niż ",
                    "bez pracy zmianowej (M = ", f2(T_wyp$M[1]), ")."))
writeLines(paste0(names(rozdzial), ": ", rozdzial), "b440-rozdzial.txt", useBytes = TRUE)

# Tabele z „pracy” (z błędami) – plik do pobrania; pozycji skali wypalenia jest 6, satysfakcja to 1 pytanie
tabele <- rbind(
  data.frame(tabela = "Tabela 1", zmienna = "płeć", kategoria = T_plec$kategoria, n = B$plec_n, proc = B$plec_p,
             M = NA, SD = NA, CI_od = NA, CI_do = NA, pozycje = NA),
  data.frame(tabela = "Tabela 1", zmienna = "staż", kategoria = T_staz$kategoria, n = B$staz_n, proc = B$staz_p,
             M = NA, SD = NA, CI_od = NA, CI_do = NA, pozycje = NA),
  data.frame(tabela = "Tabela 1", zmienna = "praca zmianowa", kategoria = T_zm$kategoria, n = T_zm$n, proc = T_zm$proc,
             M = NA, SD = NA, CI_od = NA, CI_do = NA, pozycje = NA),
  data.frame(tabela = "Tabela 2", zmienna = "wypalenie", kategoria = paste("praca zmianowa:", rownames(T_wyp)),
             n = T_wyp$n, proc = NA, M = T_wyp$M, SD = T_wyp$SD, CI_od = B$wyp_CIod, CI_do = T_wyp$CI_do, pozycje = 6),
  data.frame(tabela = "Tabela 2", zmienna = "satysfakcja", kategoria = rownames(T_sat),
             n = T_sat$n, proc = NA, M = B$sat_M, SD = T_sat$SD, CI_od = T_sat$CI_od, CI_do = T_sat$CI_do, pozycje = 1))
write.csv(tabele, "../kontrola-spojnosci-tabele-z-pracy.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")
cat("\nZapisano: b440-rozdzial.txt i ../kontrola-spojnosci-tabele-z-pracy.csv (", nrow(tabele), "wierszy )\n")
cat("\nTekst wyników w „pracy”:\n"); cat(strwrap(rozdzial[["wyniki"]], 100), sep = "\n")
Wynik w R
Zwrócone: 163, wykluczone: 5 (braki) + 5 (kryteria włączenia), analizowane: N = 153

Poprawne wyniki z danych:
t(151) = 2.33, p = .021
r(151) = -.22, p = .007
chi2(2, N = 153) = 2.51, p = .285
F(2, 150) = 4.00, p = .020
      kategoria   n proc
        kobieta 135 88.2
      mężczyzna  18 11.8
       do 5 lat  25 16.3
       6–15 lat  83 54.2
 powyżej 15 lat  45 29.4
            nie  60 39.2
            tak  93 60.8
              zmienna   n    M   SD CI_od CI_do
nie         wypalenie  60 3.08 0.71  2.89  3.26
tak         wypalenie  93 3.33 0.64  3.20  3.46
kobieta   satysfakcja 135 3.57 1.00  3.40  3.74
mężczyzna satysfakcja  18 3.61 1.24  2.99  4.23

Zapisano: b440-rozdzial.txt i ../kontrola-spojnosci-tabele-z-pracy.csv ( 11 wierszy )

Tekst wyników w „pracy”:
Analizowano odpowiedzi N = 153 osób. Średni poziom wypalenia w grupie pracującej zmianowo wynosił M
= 3.33 (SD = 0.64), a w grupie bez pracy zmianowej M = 3.08 (SD = 0.71), t(151) = 2.33, p = .011.
Staż korelował z wypaleniem, r(151) = −.22, p = .007. Odsetek pracy zmianowej nie różnił się między
grupami stażu, χ²(2, N = 153) = 2.51, p = .285. Wypalenie różniło się między grupami stażu, F(2,
153) = 4.00, p = .020.
Osiem kontroli: przepływ, N, procenty, p, df, CI, GRIM i sekcje
R
# B440 – kontrola spójności liczb w rozdziale przed oddaniem pracy (tylko bazowy R)
# Wejście: tekst pracy (metoda, streszczenie, wyniki, dyskusja) i tabele przepisane z pracy.
# Skrypt nie widzi surowych danych – sprawdza tylko, czy liczby w pracy mogą być jednocześnie prawdziwe.
if (!exists("plik_tekst")) plik_tekst <- "b440-rozdzial.txt"                        # tekst pracy
if (!exists("plik_tabele")) plik_tabele <- "../kontrola-spojnosci-tabele-z-pracy.csv"  # tabele z pracy
tekst <- readLines(plik_tekst, encoding = "UTF-8")
sekcje <- setNames(sub("^[a-z]+: ", "", tekst), sub(":.*$", "", tekst))
tab <- read.csv(plik_tabele, fileEncoding = "UTF-8")
num <- function(x) as.numeric(gsub("−", "-", x))                 # minus typograficzny → zwykły
miejsca <- function(x) nchar(sub("^[^.]*\\.?", "", x))            # liczba cyfr po kropce w zapisie
problemy <- data.frame(kontrola = character(), gdzie = character(), podane = character(), oczekiwane = character())
zglos <- function(k, g, p, o) problemy[nrow(problemy) + 1, ] <<- c(k, g, p, o)

# ---- 1. Przepływ uczestników i to samo N w całej pracy
m <- regmatches(sekcje[["metoda"]], gregexpr("[0-9]+(?![0-9%])", sekcje[["metoda"]], perl = TRUE))[[1]]  # bez „20%”
zwrot <- num(m[1]); wykl <- num(m[2:3]); N <- num(m[length(m)])
cat(sprintf("1. Przepływ: %d − %d − %d = %d; w metodzie N = %d\n", zwrot, wykl[1], wykl[2], zwrot - sum(wykl), N))
if (zwrot - sum(wykl) != N) zglos("przepływ", "metoda", N, zwrot - sum(wykl))
for (s in names(sekcje)) for (n_txt in regmatches(sekcje[[s]], gregexpr("N = [0-9]+", sekcje[[s]]))[[1]])
  if (num(sub("N = ", "", n_txt)) != N) zglos("to samo N", s, n_txt, paste("N =", N))

# ---- 2. Tabela 1: suma n = N, procent = n / N, suma procentów 100 ± zaokrąglenia
t1 <- tab[tab$tabela == "Tabela 1", ]
for (z in unique(t1$zmienna)) {
  w <- t1[t1$zmienna == z, ]
  proc_n <- round(100 * w$n / N, 1)
  tol <- 0.05 * nrow(w) + 1e-9                                    # każdy procent zaokrąglono o najwyżej 0.05
  cat(sprintf("2. %-15s suma n = %d (N = %d); suma %% = %.1f (dopuszczalne %.2f–%.2f)\n",
              z, sum(w$n), N, sum(w$proc), 100 - tol, 100 + tol))
  if (sum(w$n) != N) zglos("suma n = N", paste("Tabela 1:", z), sum(w$n), N)
  if (abs(sum(w$proc) - 100) > tol) zglos("suma % = 100", paste("Tabela 1:", z), sum(w$proc), "100 ± zaokrąglenie")
  for (i in which(abs(w$proc - proc_n) > 0.05 + 1e-9))
    zglos("procent = n/N", paste("Tabela 1:", z, w$kategoria[i]), w$proc[i],
          sprintf("%.1f (%d/%d); podane %.1f%% to %d/%d albo %d/%d", proc_n[i], w$n[i], N, w$proc[i],
                  round(w$proc[i] * N / 100), N, w$n[i], round(100 * w$n[i] / w$proc[i])))
}

# ---- 3. Wyniki testów: wyciągnięcie z tekstu, przeliczenie p i stopnie swobody
wzor <- "(t|r|F|χ²)\\(([^)]*)\\) = ([−-]?[0-9]*\\.[0-9]+), p ([=<]) (\\.[0-9]+)"
testy <- do.call(rbind, lapply(names(sekcje), function(s) {
  x <- regmatches(sekcje[[s]], gregexpr(wzor, sekcje[[s]]))[[1]]
  if (!length(x)) return(NULL)
  cz <- regmatches(x, regexec(wzor, x))
  data.frame(sekcja = s, zapis = x, test = sapply(cz, `[`, 2), df = sapply(cz, `[`, 3),
             stat = sapply(cz, `[`, 4), znak = sapply(cz, `[`, 5), p = sapply(cz, `[`, 6))
}))
p_z <- function(test, df, s) {                                  # dwustronne p ze statystyki i df
  d <- num(strsplit(sub("N = ", "", df), ", ")[[1]]); s <- abs(s)
  switch(test, t = 2 * pt(-s, d[1]), r = 2 * pt(-s * sqrt(d[1] / (1 - s^2)), d[1]),
         F = pf(s, d[1], d[2], lower.tail = FALSE), "χ²" = pchisq(s, d[1], lower.tail = FALSE))
}
testy$p_od <- testy$p_do <- NA
for (i in seq_len(nrow(testy))) {                                # statystyka jest zaokrąglona: przedział możliwych p
  s <- abs(num(testy$stat[i])); h <- 0.5 / 10^miejsca(testy$stat[i])
  pr <- sort(c(p_z(testy$test[i], testy$df[i], s - h), p_z(testy$test[i], testy$df[i], s + h)))
  testy$p_od[i] <- pr[1]; testy$p_do[i] <- pr[2]
}
pp <- num(testy$p); hp <- 0.5 / 10^miejsca(testy$p)
testy$p_zgodne <- ifelse(testy$znak == "<", testy$p_od < pp, testy$p_do >= pp - hp & testy$p_od <= pp + hp)
testy$df_oczek <- c(t = N - 2, r = N - 2, F = paste(3 - 1, N - 3, sep = ", "),
                    "χ²" = paste0((2 - 1) * (3 - 1), ", N = ", N))[testy$test]   # plan: 2 grupy, 3 grupy stażu
testy$df_zgodne <- testy$df == testy$df_oczek
cat("\n3. Testy w tekście (p_od–p_do: p możliwe przy zaokrąglonej statystyce):\n")
print(transform(testy[, c("sekcja", "zapis", "df_oczek", "df_zgodne", "p_zgodne")]), row.names = FALSE)
print(data.frame(zapis = testy$zapis, p_od = round(testy$p_od, 4), p_do = round(testy$p_do, 4)), row.names = FALSE)
for (i in which(!testy$p_zgodne)) {
  pol <- pp[i] >= testy$p_od[i] / 2 - hp[i] & pp[i] <= testy$p_do[i] / 2 + hp[i]
  zglos("p ze statystyki", paste0(testy$sekcja[i], ": test ", testy$test[i]), paste("p", testy$znak[i], testy$p[i]),
        sprintf("%.4f–%.4f%s", testy$p_od[i], testy$p_do[i], if (pol) "; podane p to połowa – test jednostronny?" else ""))
}
for (i in which(!testy$df_zgodne)) zglos("df a liczebność", paste0(testy$sekcja[i], ": test ", testy$test[i]), testy$df[i], testy$df_oczek[i])

# ---- 4. Przedziały ufności: czy CI wynika z M, SD i n (M ± t·SD/√n) i czy jest symetryczny wokół M
t2 <- tab[tab$tabela == "Tabela 2", ]
t2$CI_od_oczek <- round(t2$M - qt(.975, t2$n - 1) * t2$SD / sqrt(t2$n), 2)
t2$CI_do_oczek <- round(t2$M + qt(.975, t2$n - 1) * t2$SD / sqrt(t2$n), 2)
t2$srodek_minus_M <- round((t2$CI_od + t2$CI_do) / 2 - t2$M, 3)
cat("\n4. Przedziały ufności w Tabeli 2:\n")
print(t2[, c("zmienna", "kategoria", "n", "M", "SD", "CI_od", "CI_do", "CI_od_oczek", "CI_do_oczek", "srodek_minus_M")],
      row.names = FALSE)
for (i in which(abs(t2$CI_od - t2$CI_od_oczek) > 0.015 | abs(t2$CI_do - t2$CI_do_oczek) > 0.015))
  zglos("CI z M, SD i n", paste("Tabela 2:", t2$zmienna[i], t2$kategoria[i]), sprintf("[%.2f, %.2f]", t2$CI_od[i], t2$CI_do[i]),
        sprintf("[%.2f, %.2f]", t2$CI_od_oczek[i], t2$CI_do_oczek[i]))

# ---- 5. GRIM: czy średnia z odpowiedzi całkowitych jest możliwa przy n i liczbie pozycji k?
grim <- function(M, n, k, d = 2) {
  if (n * k >= 10^d) return(NA)                                  # przy n·k ≥ 100 każda średnia jest możliwa
  s <- round(M * n * k)
  any(abs(round((s + -1:1) / (n * k), d) - M) < 1e-9)
}
t2$GRIM <- mapply(grim, t2$M, t2$n, t2$pozycje)
cat("\n5. GRIM (NA = test nie działa, bo n·k ≥ 100):\n")
print(t2[, c("zmienna", "kategoria", "n", "pozycje", "M", "GRIM")], row.names = FALSE)
for (i in which(t2$GRIM %in% FALSE)) {
  nk <- t2$n[i] * t2$pozycje[i]; s <- floor(t2$M[i] * nk)
  zglos("GRIM", paste("Tabela 2:", t2$zmienna[i], t2$kategoria[i]), t2$M[i],
        sprintf("możliwe najbliższe: %.3f lub %.3f", s / nk, (s + 1) / nk))
}

# ---- 6. Te same liczby w różnych częściach pracy
cat("\n6. Ten sam test w kilku sekcjach:\n")
for (k in unique(paste(testy$test, testy$df))) {
  w <- testy[paste(testy$test, testy$df) == k, ]
  if (nrow(w) > 1) cat(sprintf("   %s: %s – %s\n", k, paste(w$sekcja, collapse = ", "),
                              if (length(unique(w$zapis)) == 1) "zapis identyczny" else "RÓŻNE ZAPISY"))
}
M_w <- regmatches(sekcje[["wyniki"]], gregexpr("M = [0-9.]+", sekcje[["wyniki"]]))[[1]]
M_d <- regmatches(sekcje[["dyskusja"]], gregexpr("M = [0-9.]+", sekcje[["dyskusja"]]))[[1]]
r_d <- regmatches(sekcje[["dyskusja"]], gregexpr("r = [−-]?\\.[0-9]+", sekcje[["dyskusja"]]))[[1]]
cat("   średnie w dyskusji obecne w wynikach:", all(M_d %in% M_w), "\n")
cat("   r w dyskusji:", r_d, "; w wynikach:", sub("\\(.*\\)", "", testy$zapis[testy$sekcja == "wyniki" & testy$test == "r"]), "\n")

# ---- 7. Liczba miejsc po przecinku (spójność zapisu)
cat("\n7. Miejsca po przecinku: p w tekście:", paste(unique(miejsca(testy$p)), collapse = ", "),
    "| statystyki testów:", paste(unique(miejsca(testy$stat)), collapse = ", "),
    "| procenty w Tabeli 1:", paste(unique(nchar(sub("^[^.]*\\.?", "", formatC(t1$proc, format = "f", digits = 1)))), collapse = ", "), "\n")

# ---- Podsumowanie
cat("\nDo poprawy lub wyjaśnienia:\n"); print(problemy, row.names = FALSE)
elementy <- unique(sub(" (kobieta|mężczyzna|6–15 lat|do 5 lat|powyżej 15 lat)$", "", sub("^(streszczenie|wyniki): ", "", problemy$gdzie)))
cat(sprintf("\nSygnałów: %d; elementów pracy do poprawienia: %d\n", nrow(problemy), length(elementy)))
print(elementy)
if (!exists("plik_problemy")) plik_problemy <- "b440-problemy.csv"
write.csv(problemy, plik_problemy, row.names = FALSE, fileEncoding = "UTF-8")
Wynik w R
1. Przepływ: 163 − 5 − 5 = 153; w metodzie N = 153
2. płeć          suma n = 151 (N = 153); suma % = 100.0 (dopuszczalne 99.90–100.10)
2. staż           suma n = 153 (N = 153); suma % = 96.6 (dopuszczalne 99.85–100.15)
2. praca zmianowa  suma n = 153 (N = 153); suma % = 100.0 (dopuszczalne 99.90–100.10)

3. Testy w tekście (p_od–p_do: p możliwe przy zaokrąglonej statystyce):
       sekcja                           zapis   df_oczek df_zgodne p_zgodne
 streszczenie         t(151) = 2.33, p = .011        151      TRUE    FALSE
 streszczenie         r(151) = −.22, p = .007        151      TRUE     TRUE
       wyniki         t(151) = 2.33, p = .011        151      TRUE    FALSE
       wyniki         r(151) = −.22, p = .007        151      TRUE     TRUE
       wyniki χ²(2, N = 153) = 2.51, p = .285 2, N = 153      TRUE     TRUE
       wyniki      F(2, 153) = 4.00, p = .020     2, 150     FALSE     TRUE
                           zapis   p_od   p_do
         t(151) = 2.33, p = .011 0.0209 0.0214
         r(151) = −.22, p = .007 0.0052 0.0076
         t(151) = 2.33, p = .011 0.0209 0.0214
         r(151) = −.22, p = .007 0.0052 0.0076
 χ²(2, N = 153) = 2.51, p = .285 0.2844 0.2858
      F(2, 153) = 4.00, p = .020 0.0202 0.0204

4. Przedziały ufności w Tabeli 2:
     zmienna           kategoria   n    M   SD CI_od CI_do CI_od_oczek
   wypalenie praca zmianowa: nie  60 3.08 0.71  2.89  3.26         2.9
   wypalenie praca zmianowa: tak  93 3.33 0.64  3.10  3.46         3.2
 satysfakcja             kobieta 135 3.57 1.00  3.40  3.74         3.4
 satysfakcja           mężczyzna  18 3.62 1.24  2.99  4.23         3.0
 CI_do_oczek srodek_minus_M
        3.26         -0.005
        3.46         -0.050
        3.74          0.000
        4.24         -0.010

5. GRIM (NA = test nie działa, bo n·k ≥ 100):
     zmienna           kategoria   n pozycje    M  GRIM
   wypalenie praca zmianowa: nie  60       6 3.08    NA
   wypalenie praca zmianowa: tak  93       6 3.33    NA
 satysfakcja             kobieta 135       1 3.57    NA
 satysfakcja           mężczyzna  18       1 3.62 FALSE

6. Ten sam test w kilku sekcjach:
   t 151: streszczenie, wyniki – zapis identyczny
   r 151: streszczenie, wyniki – zapis identyczny
   średnie w dyskusji obecne w wynikach: TRUE
   r w dyskusji: r = −.22 ; w wynikach: r = −.22, p = .007

7. Miejsca po przecinku: p w tekście: 3 | statystyki testów: 2 | procenty w Tabeli 1: 1

Do poprawy lub wyjaśnienia:
        kontrola                                   gdzie       podane
      suma n = N                          Tabela 1: płeć          151
   procent = n/N                  Tabela 1: płeć kobieta         88.2
    suma % = 100                          Tabela 1: staż         96.6
   procent = n/N                 Tabela 1: staż 6–15 lat         50.9
 p ze statystyki                    streszczenie: test t     p = .011
 p ze statystyki                          wyniki: test t     p = .011
 df a liczebność                          wyniki: test F       2, 153
  CI z M, SD i n Tabela 2: wypalenie praca zmianowa: tak [3.10, 3.46]
            GRIM         Tabela 2: satysfakcja mężczyzna         3.62
                                             oczekiwane
                                                    153
   86.9 (133/153); podane 88.2% to 135/153 albo 133/151
                                     100 ± zaokrąglenie
      54.2 (83/153); podane 50.9% to 78/153 albo 83/163
 0.0209–0.0214; podane p to połowa – test jednostronny?
 0.0209–0.0214; podane p to połowa – test jednostronny?
                                                 2, 150
                                           [3.20, 3.46]
                    możliwe najbliższe: 3.611 lub 3.667

Sygnałów: 9; elementów pracy do poprawienia: 6
[1] "Tabela 1: płeć"
[2] "Tabela 1: staż"
[3] "test t"
[4] "test F"
[5] "Tabela 2: wypalenie praca zmianowa: tak"
[6] "Tabela 2: satysfakcja"
Zdania APA prosto z wyników i ponowna kontrola
R
# B440 – zapobieganie: zdania z liczbami generowane z wyników w R, a potem ta sama kontrola co w przepisie 2
# Uruchom po przepisach 1 i 2 z tego samego folderu.
d <- read.csv("b440-dane.csv", fileEncoding = "UTF-8")
d$staz_gr <- factor(d$staz_gr, c("do 5 lat", "6–15 lat", "powyżej 15 lat"))
N <- nrow(d)
f2 <- function(x) formatC(x, format = "f", digits = 2)
p_apa <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0", "", formatC(p, format = "f", digits = 3)))
zdanie_t <- function(m) sprintf("t(%d) = %s, %s", m$parameter, f2(abs(m$statistic)), p_apa(m$p.value))
zdanie_r <- function(m) sprintf("r(%d) = %s, %s", m$parameter, sub("^(-?)0", "\\1", f2(m$estimate)), p_apa(m$p.value))
zdanie_chi <- function(m, n) sprintf("χ²(%d, N = %d) = %s, %s", m$parameter, n, f2(m$statistic), p_apa(m$p.value))
zdanie_F <- function(a) sprintf("F(%d, %d) = %s, %s", a$Df[1], a$Df[2], f2(a$`F value`[1]), p_apa(a$`Pr(>F)`[1]))

tt <- t.test(wypalenie ~ zmiany, data = d, var.equal = TRUE)
rr <- cor.test(d$staz, d$wypalenie)
ch <- chisq.test(table(d$zmiany, d$staz_gr))
av <- summary(aov(wypalenie ~ staz_gr, data = d))[[1]]
M <- tapply(d$wypalenie, d$zmiany, mean); SD <- tapply(d$wypalenie, d$zmiany, sd)
z <- c(t = zdanie_t(tt), r = gsub("-", "−", zdanie_r(rr)), chi = zdanie_chi(ch, N), F = zdanie_F(av))
print(z)

# Poprawiony tekst: każda liczba wstawiona z obiektu wyniku, nie przepisana ręcznie
# (zdanie o przepływie zawiera liczby z wyniku przepisu 1)
tekst <- c(
  metoda = "Zwrócono 163 ankiet. Wykluczono 5 ankiet z brakami powyżej 20% odpowiedzi i 5 osób niespełniających kryteriów włączenia. Analizowano odpowiedzi N = 153 osób.",
  streszczenie = paste0("Zbadano N = ", N, " pielęgniarek. Osoby pracujące w systemie zmianowym miały wyższy poziom wypalenia, ",
                        z[["t"]], ". Dłuższy staż wiązał się z niższym wypaleniem, ", z[["r"]], "."),
  wyniki = paste0("Średni poziom wypalenia w grupie pracującej zmianowo wynosił M = ", f2(M[["tak"]]), " (SD = ", f2(SD[["tak"]]),
                  "), a w grupie bez pracy zmianowej M = ", f2(M[["nie"]]), " (SD = ", f2(SD[["nie"]]), "), ", z[["t"]],
                  ". Staż korelował z wypaleniem, ", z[["r"]], ". Odsetek pracy zmianowej nie różnił się między grupami stażu, ",
                  z[["chi"]], ". Wypalenie różniło się między grupami stażu, ", z[["F"]], "."),
  dyskusja = paste0("Wynik r = ", sub("^.*= (−?\\.[0-9]+),.*$", "\\1", z[["r"]]), " wskazuje na umiarkowany związek stażu z wypaleniem."))
writeLines(paste0(names(tekst), ": ", tekst), "b440-rozdzial-poprawiony.txt", useBytes = TRUE)

# Poprawione tabele: liczone z danych tą samą funkcją dla wszystkich wierszy
tab <- read.csv("../kontrola-spojnosci-tabele-z-pracy.csv", fileEncoding = "UTF-8")
t1 <- tab$tabela == "Tabela 1"
zm <- c("płeć" = "plec", "staż" = "staz_gr", "praca zmianowa" = "zmiany")
tab$n[t1] <- unlist(lapply(names(zm), function(v) as.vector(table(d[[zm[[v]]]]))))
tab$proc[t1] <- round(100 * tab$n[t1] / N, 1)
opis <- function(y) { n <- length(y); q <- qt(.975, n - 1) * sd(y) / sqrt(n)
  c(n = n, M = round(mean(y), 2), SD = round(sd(y), 2), CI_od = round(mean(y) - q, 2), CI_do = round(mean(y) + q, 2)) }
t2 <- rbind(t(sapply(split(d$wypalenie, d$zmiany), opis)), t(sapply(split(d$satysf, d$plec), opis)))
tab[!t1, c("n", "M", "SD", "CI_od", "CI_do")] <- t2
write.csv(tab, "b440-tabele-poprawione.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Ta sama kontrola na wersji poprawionej
plik_tekst <- "b440-rozdzial-poprawiony.txt"; plik_tabele <- "b440-tabele-poprawione.csv"
plik_problemy <- "b440-problemy-po-poprawkach.csv"
wyjscie <- capture.output(source("b440-2-kontrola-spojnosci.R"))
cat(grep("^(1|2)\\. |^Sygnałów", wyjscie, value = TRUE), sep = "\n")
Wynik w R
                                t                                 r
        "t(151) = 2.33, p = .021"         "r(151) = −.22, p = .007"
                              chi                                 F
"χ²(2, N = 153) = 2.51, p = .285"      "F(2, 150) = 4.00, p = .020"
1. Przepływ: 163 − 5 − 5 = 153; w metodzie N = 153
2. płeć          suma n = 153 (N = 153); suma % = 100.0 (dopuszczalne 99.90–100.10)
2. staż           suma n = 153 (N = 153); suma % = 99.9 (dopuszczalne 99.85–100.15)
2. praca zmianowa  suma n = 153 (N = 153); suma % = 100.0 (dopuszczalne 99.90–100.10)
Sygnałów: 0; elementów pracy do poprawienia: 0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 bez dodatkowych pakietów; rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem pracy sprawdź…
- Czy zebrane − wykluczone = analizowane, a to samo N jest w metodzie, streszczeniu i tabelach?
- Czy liczebności każdej zmiennej w tabeli sumują się do N albo nota wyjaśnia braki?
- Czy każdy procent to n / N z właściwym mianownikiem, a suma mieści się w granicach zaokrąglenia?
- Czy każde p zgadza się ze statystyką testu i df (z uwzględnieniem testu jednostronnego, jeśli był zapowiedziany)?
- Czy df wynikają z liczby osób i grup w każdej analizie?
- Czy przedziały ufności dla średnich wynikają z M, SD i n, a ich środek równa się średniej?
- Czy średnie z pojedynczych pytań w małych grupach przechodzą test GRIM?
- Czy streszczenie, dyskusja i wnioski podają te same liczby i te same słowa o istotności co wyniki, z tą samą liczbą miejsc po przecinku?
Najczęstsze pytania
Czy suma procentów 99.9% albo 100.1% w tabeli to błąd?
Nie, jeśli wynika z zaokrągleń. Każdy procent z jednym miejscem po przecinku może się różnić od prawdziwego o 0.05 punktu, więc przy trzech kategoriach suma może wynosić od 99.85% do 100.15%. Nie poprawiaj ręcznie żadnej kategorii – dodaj notę, że odsetki mogą nie sumować się do 100% z powodu zaokrągleń.
Jak sprawdzić stopnie swobody w teście t, korelacji i ANOVA, znając liczbę osób?
Dla testu t dwóch grup niezależnych df = n₁ + n₂ − 2, dla korelacji Pearsona N − 2, dla jednoczynnikowej ANOVA z k grupami (k − 1, N − k), a dla χ² w tabeli w × k (w − 1)(k − 1). Mniejsze df oznaczają braki danych w tej analizie, a ułamkowe – test Welcha; oba przypadki opisz jednym zdaniem.
Co zrobić, gdy błędna liczba jest też w streszczeniu i wnioskach?
Popraw ją we wszystkich miejscach naraz. Wyszukaj liczbę w całym pliku (np. „.011”), zanotuj każde wystąpienie, a po poprawce sprawdź słowa wokół niej – jeśli zmienił się wniosek o istotności, popraw też sformułowania typu „istotnie wyższy” w streszczeniu, dyskusji i wnioskach.
Dlaczego kontrola zgłasza niezgodność przy teście Welcha albo teście jednostronnym?
Bo przelicza p ze standardowego wzoru: test t ze stopniami swobody całkowitymi i p dwustronnym. Test Welcha ma ułamkowe df, test jednostronny daje połowę p, a poprawka Bonferroniego lub Holma zmienia p po przeliczeniu. To nie są błędy, jeśli w tekście jest o nich zdanie – wtedy oznacz wynik jako wyjaśniony.
Czy kontrolę spójności liczb trzeba opisać w pracy?
Zwykle nie – to część przygotowania tekstu, tak jak korekta językowa. Opisz tylko jej skutki, które czytelnik musi znać: inne N w części analiz, test jednostronny, zaokrąglenia w tabelach. Jeśli promotor prosi o listę zmian po kontroli, wyślij ją osobno, z numerami stron i tabel.
Powiązane hasła
Przeczytaj też
Wynik wygląda podejrzanie
Tabela objaw × przyczyna × test, plik CSV z usterkami, kod R z wynikami przed naprawą i po niej oraz lista kontrolna na 10 minut.
Czytaj →PoradnikMatryca spójności pracy
Cel, pytanie, hipoteza, zmienna, narzędzie, test, tabela i wniosek w jednej tabeli: dwa przykłady, typowe błędy i szablon XLSX.
Czytaj →PoradnikRecenzja pracy magisterskiej: część badawcza
Co recenzent sprawdza w części empirycznej: tabela kryteriów, 12 przykładowych uwag z odpowiedziami na obronę i lista kontrolna przed złożeniem pracy.
Czytaj →PoradnikPoprawki promotora w rozdziale wyników
15 najczęstszych uwag do rozdziału wyników z przykładami „przed → po”, wzorem tabeli poprawek do pobrania i wiadomością do promotora.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikPrzedziały ufności w pracy dyplomowej
Zapis APA, wybór przedziału dla średniej, odsetka, różnicy, korelacji i OR, poprawne i błędne zdania, nakładanie się przedziałów i słupki błędów – z tabelą wyników w R.
Czytaj →Chcesz, żeby ktoś sprawdził liczby w Twojej pracy przed oddaniem?
Przejdziemy rozdział wyników, tabele i streszczenie, przeliczymy wartości p, stopnie swobody i przedziały ufności, a znalezione niezgodności opiszemy z gotowymi poprawkami – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Bland, J. M. (2011). How to obtain the P value from a confidence interval. BMJ, 343, Article d2304. https://doi.org/10.1136/bmj.d2304 ● Otwarty dostęp
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Bakker, M., & Wicherts, J. M. (2011). The (mis)reporting of statistical results in psychology journals. Behavior Research Methods, 43(3), 666–678. https://doi.org/10.3758/s13428-011-0089-5 ● Otwarty dostęp
- Brown, N. J. L., & Heathers, J. A. J. (2017). The GRIM test: A simple technique detects numerous anomalies in the reporting of results in psychology. Social Psychological and Personality Science, 8(4), 363–369. https://doi.org/10.1177/1948550616673876 ● Otwarty dostęp: pełny tekst
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. https://doi.org/10.3758/s13428-015-0664-2 ● Otwarty dostęp
- Wicherts, J. M., Bakker, M., & Molenaar, D. (2011). Willingness to share research data is related to the strength of the evidence and the quality of reporting of statistical results. PLoS ONE, 6(11), Article e26828. https://doi.org/10.1371/journal.pone.0026828 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2011obtain, author={Altman, Douglas G. and Bland, J. Martin}, title={{How to obtain the P value from a confidence interval}}, journal={BMJ}, year={2011}, volume={343}, eid={d2304}, doi={10.1136/bmj.d2304}}@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{bakker2011misreporting, author={Bakker, Marjan and Wicherts, Jelte M.}, title={{The (mis)reporting of statistical results in psychology journals}}, journal={Behavior Research Methods}, year={2011}, volume={43}, number={3}, pages={666--678}, doi={10.3758/s13428-011-0089-5}}@article{brown2017grim, author={Brown, Nicholas J. L. and Heathers, James A. J.}, title={{The GRIM test: A simple technique detects numerous anomalies in the reporting of results in psychology}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={363--369}, doi={10.1177/1948550616673876}}@article{nuijten2016prevalence, author={Nuijten, Michèle B. and Hartgerink, Chris H. J. and van Assen, Marcel A. L. M. and Epskamp, Sacha and Wicherts, Jelte M.}, title={{The prevalence of statistical reporting errors in psychology (1985–2013)}}, journal={Behavior Research Methods}, year={2016}, volume={48}, number={4}, pages={1205--1226}, doi={10.3758/s13428-015-0664-2}}@article{wicherts2011willingness, author={Wicherts, Jelte M. and Bakker, Marjan and Molenaar, Dylan}, title={{Willingness to share research data is related to the strength of the evidence and the quality of reporting of statistical results}}, journal={PLoS ONE}, year={2011}, volume={6}, number={11}, eid={e26828}, doi={10.1371/journal.pone.0026828}}