Poprawki „na oko” zostają tylko w Twojej pamięci
Ankieta zamknięta, plik pobrany, a w kolumnie wieku stoją liczby 1999 i 210. Ktoś pracuje 400 godzin tygodniowo, ktoś inny śpi 49 godzin na dobę, a osoba, która zaznaczyła „nie pracuję”, podała godziny pracy. Najprostszy odruch to otworzyć plik w Excelu i poprawić to, co „widać, że jest źle”. Po tygodniu nie pamiętasz już, co zmieniłeś(-aś), a po pytaniu promotora „skąd ta średnia wieku?” nie umiesz tego odtworzyć.
Ten wpis pokazuje inną drogę, w czterech krokach. Najpierw spisujesz reguły kontroli, zanim zobaczysz dane. Potem uruchamiasz funkcję, która zwraca tabelę wszystkich naruszeń. Dla każdego naruszenia podejmujesz decyzję według reguły ustalonej wcześniej. Na końcu prowadzisz dziennik zmian, z którego skrypt sam tworzy czysty zbiór, bez dotykania danych surowych. Van den Broeck i in. (2005) opisują czyszczenie danych jako cykl trzech etapów: przesiewu, diagnozy i edycji. Zalecają, by postępowanie z błędami było określone z góry, a nie wynikało z przypadkowych odkryć. Huebner i in. (2016) nazywają ten etap wstępną analizą danych i oddzielają go od analiz odpowiadających na pytania badawcze. Błędy na tym etapie mogą prowadzić do złego doboru metod i błędnych wniosków.
Serwis ma już kilka stron o pokrewnych etapach i ten wpis ich nie powtarza. Hasło czyszczenie danych z ankiety online opisuje kolejność usuwania rekordów (duplikaty, osoby spoza kryteriów, nieuważni). Procedurę kontroli jakości dla eksportu z formularzy pokazuje analiza ankiety z Google Forms krok po kroku. To, ile osób odpadło na każdym etapie, pokazuje diagram przepływu respondentów. Kontrolę eksportu z danych testowych przed startem badania omawia test techniczny ankiety. Tu zajmujemy się wartościami w komórkach: co uznać za błąd, co z nim zrobić i jak to udokumentować.
Przykład przewodni (dane symulowane). Studentka pielęgniarstwa bada stres i pracę zarobkową studentów kierunków medycznych. Zebrała 272 odpowiedzi przez formularz online i 40 ankiet papierowych, które przepisała do arkusza. Plik ma 312 wierszy i 17 kolumn: identyfikator, źródło, wiek, płeć, pytanie filtrujące „Czy pracujesz zarobkowo?”, staż pracy, godziny pracy w tygodniu, podział typowego dnia (sen, nauka, praca, inne – w godzinach) i sześć pozycji skali stresu 1–5, z których str_4 jest pozycją odwróconą. Surowy plik pobierzesz tutaj: ankieta-stres-praca-surowe.csv. Wszystkie liczby poniżej pochodzą z kodu w sekcji Kod R.
Pięć rodzajów reguł kontroli
Reguła kontroli to zdanie o danych, które musi być prawdziwe w każdym poprawnym rekordzie. Zapisujesz ją tak, żeby komputer mógł ją sprawdzić. W ankiecie studenckiej prawie wszystkie reguły należą do pięciu rodzajów:
- Zakresy i dozwolone kody. Wiek 18–70, skala Likerta 1–5, płeć 1, 2 lub 9. Kody pochodzą z książki kodowej, a nie z danych.
- Logika między pytaniami. Po odpowiedzi „nie pracuję” pytania o pracę mają być puste – tak działa pytanie filtrujące. Staż pracy nie może przekraczać wieku minus 18 lat. Tę regułę spójności wieku i stażu omawia wpis o kodowaniu metryczki.
- Sumy kontrolne. Części, które z definicji składają się na całość: godziny w dobie, odsetki czasu, które mają dać 100%, liczby dzieci w kilku grupach wieku a liczba dzieci ogółem. Przy sumach ustal z góry tolerancję na zaokrąglenia (w przykładzie ±1 godzina).
- Wzorce odpowiedzi. Na przykład identyczne odpowiedzi w całej skali, także w pozycji odwróconej. Taki wzorzec nie dowodzi błędu, ale jest sygnałem możliwej nieuwagi (zob. nieuważne odpowiedzi w ankietach online i straightlining). Przegląd wskaźników nieuważnego odpowiadania znajdziesz u Currana (2016).
- Identyfikator. Każdy rekord ma niepowtarzalny numer. Bez tego nie zbudujesz dziennika zmian, bo dziennik wskazuje rekordy po identyfikatorze. Powtórzenia identyfikatora bywają też sygnałem duplikatów albo błędu przy łączeniu danych z kilku plików.
W przykładzie powstało 17 reguł, bo zakres skali stresu sprawdza osobna reguła dla każdej z sześciu pozycji. Fragment pokazuje tabela.
| Reguła | Co sprawdza | Warunek, który musi być prawdziwy (R) | Rodzaj |
|---|---|---|---|
| R01 | wiek 18–70 lat | wiek >= 18 & wiek <= 70 | twarda |
| R02 | dozwolone kody płci | is.na(plec) | plec %in% c(1, 2, 9) | twarda |
| R04 | pozycja skali w zakresie 1–5 (sześć reguł) | is.na(str_1) | str_1 %in% 1:5 | twarda |
| R05 | staż a wiek | staz <= wiek - 18 | twarda |
| R06 | filtr: „nie pracuję” – brak godzin pracy | pracuje == 1 | is.na(godz_pracy) | twarda |
| R08 | „pracuję” – godziny podane | !(pracuje == 1 & is.na(godz_pracy)) | miękka |
| R10 | suma doby | abs(sen + nauka + praca_d + inne - 24) <= 1 | twarda |
| R11 | nie wszystkie odpowiedzi w skali jednakowe | liczba różnych odpowiedzi w str_1–str_6 > 1 | miękka |
| R12 | identyfikator niepowtarzalny | !duplicated(id) & !duplicated(id, fromLast = TRUE) | twarda |
Kolumna „rodzaj” rozróżnia dwa typy reguł. Naruszenie reguły twardej to wartość niemożliwa albo sprzeczna z innymi odpowiedziami. Naruszenie reguły miękkiej to wartość możliwa, ale podejrzana, którą trzeba przejrzeć. Van den Broeck i in. (2005) piszą w tym kontekście o progach „twardych” i „miękkich”. Rozróżnienie od razu podpowiada decyzję: twarde naruszenie zawsze coś zmienia w danych, a miękkie zwykle kończy się oznaczeniem rekordu.
Zapisz reguły, zanim otworzysz dane
Reguły wynikają z kwestionariusza i z książki kodowej, a nie z tego, co widać w pliku. Jeśli ustalasz zakres wieku dopiero po obejrzeniu rozkładu, łatwo przesunąć granicę tak, żeby „niewygodne” osoby wypadły. Dlatego reguły zapisz w planie analizy, a w książce kodowej przy każdej zmiennej podaj dozwolony zakres i kody braków. Buchanan i in. (2021) prowadzą przez budowę słownika danych od surowych odpowiedzi z ankiety do zbioru, który można udostępnić. Zakresy i kody w takim słowniku to gotowy materiał na reguły.
Wygodnie jest trzymać reguły w osobnym pliku: jeden wiersz to jedna reguła z identyfikatorem, opisem, listą zmiennych, warunkiem i rodzajem. Plik z przykładu pobierzesz jako wzór: reguly-kontroli-danych.csv. Razem z regułami zapisz też reguły decyzji, czyli co zrobisz z każdym rodzajem naruszenia (sekcja o decyzjach). Przy ankietach papierowych dochodzą reguły dla odpowiedzi nieczytelnych i podwójnie zaznaczonych. Opisuje je wpis o wprowadzaniu ankiet papierowych.
Funkcja, która zwraca tabelę naruszeń
Sprawdzanie reguł „ręcznie”, filtrem w arkuszu, kończy się zwykle po trzech regułach. Lepiej napisać jedną funkcję, która przejdzie przez wszystkie. W przykładzie sprawdz_reguly() ma kilkanaście linii bazowego R (kod na końcu wpisu). Dla każdej reguły oblicza warunek na całym zbiorze i wybiera wiersze, w których wynik to FALSE. Zwraca tabelę: jeden wiersz to jedno naruszenie z identyfikatorem reguły, rodzajem, numerem rekordu i wartościami zmiennych, których reguła dotyczy.
Najważniejsza decyzja projektowa dotyczy braków danych. W funkcji wynik NA nie jest naruszeniem. Reguła „staż ≤ wiek − 18” daje NA u 148 osób niepracujących, które nie miały pytania o staż – i słusznie, bo ich ta reguła nie dotyczy. Brak tam, gdzie powinna być odpowiedź, sprawdza osobna, wprost zapisana reguła (R08). Druga pułapka jest odwrotna: w R wyrażenie NA %in% c(1, 2, 9) daje FALSE, więc reguła kodów bez is.na(x) | zgłosiłaby każdy brak jako błędny kod.
W surowych danych przykładu funkcja znalazła 37 naruszeń w 36 rekordach: 24 naruszenia reguł twardych i 13 – miękkich. Trzy reguły (kody pytania o pracę, staż przy „nie pracuję” i identyfikator) nie miały żadnego naruszenia. Rozkład naruszeń pokazuje rysunek 1.
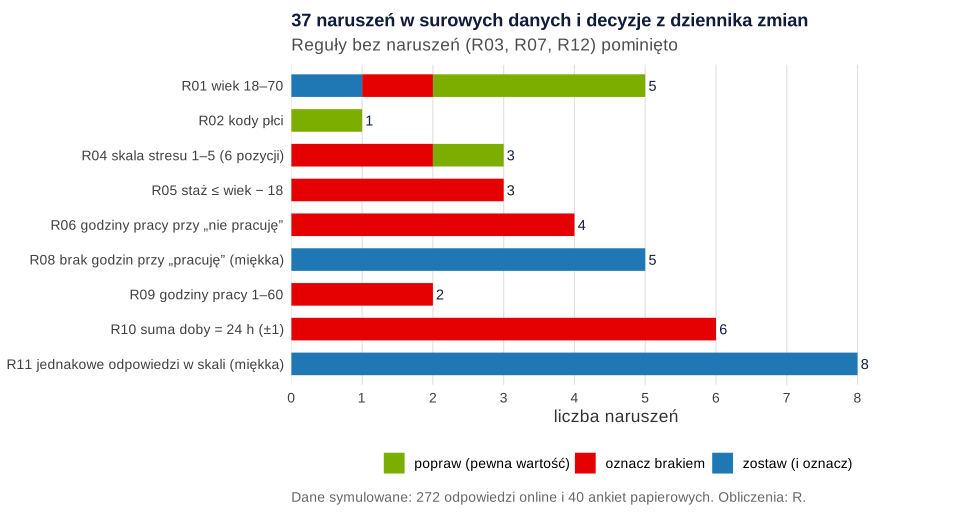
Jedna wartość może naruszać kilka reguł. Osoba O189 zaznaczyła „nie pracuję” i wpisała 0 godzin pracy. Łamie to regułę filtra (R06) i regułę zakresu 1–60 (R09). To jedno źródło błędu i jedna decyzja, więc w dzienniku ma jeden wiersz. Dlatego liczba naruszeń nie jest liczbą błędów, a w pracy podajesz liczbę zmienionych wartości.
Poprawić, oznaczyć brakiem czy zostawić
Każde naruszenie kończy się jedną z trzech decyzji. Kryteria są proste, ale trzeba je stosować konsekwentnie:
- Popraw – tylko wtedy, gdy znasz prawdziwą wartość. Ma to miejsce w dwóch sytuacjach. Pierwsza: masz źródło, np. ankietę papierową, na której widać „21”, a w arkuszu wpisano „210”. Druga: masz regułę zapisaną z góry, która nie zostawia wątpliwości. W przykładzie liczba 1940–2008 w polu wieku oznacza rok urodzenia, więc wiek = 2026 − rok, z dokładnością do roku.
- Oznacz brakiem – gdy wartość jest niemożliwa, a prawdziwej nie da się ustalić. Wiek 7 lat, 400 godzin pracy, suma doby 30 godzin (nie wiadomo, która z czterech liczb jest błędna). Staż 48 przy wieku 22 lata to najpewniej miesiące, ale „najpewniej” to za mało, żeby dzielić przez 12. Przy złamanym filtrze rozstrzyga odpowiedź na pytanie filtrujące: godziny pracy u osoby niepracującej zamieniasz na brak typu „nie dotyczy”. Taka osoba nie wchodzi do mianownika w pytaniu o godziny (zob. pytania filtrujące i mianownik).
- Zostaw (i oznacz) – gdy wartość jest możliwa. Brak odpowiedzi zostaje brakiem, a co z nim zrobić w analizie, opisuje wpis o brakach danych w ankiecie. Jednakowe odpowiedzi w skali dostają flagę do analizy wrażliwości. Wiek 17 lat to prawdziwa wartość, tylko poza kryterium włączenia. Tę osobę wykluczasz na etapie kryteriów i pokazujesz na diagramie przepływu, a nie „poprawiasz” jej wieku.
Osobny przypadek to wartości skrajne, ale możliwe, np. 60 godzin pracy tygodniowo. To nie błąd danych, tylko pytanie analityczne. Odpowiadają na nie wpisy o wartościach odstających i o tym, czy można usuwać obserwacje odstające. Reguła kontroli nie powinna łapać wartości tylko dlatego, że są rzadkie.
| Naruszenie | Liczba | Decyzja | Uzasadnienie |
|---|---|---|---|
| R01: rok urodzenia w polu wieku (1999, 2002) | 2 | popraw | reguła zapisana z góry: wiek = 2026 − rok |
| R01, R02, R04: błędy przepisywania ankiet papierowych | 5 | popraw (3) / brak (2) | wartość z oryginału; puste pole i dwa zaznaczenia = brak |
| R01: wiek 7 | 1 | brak | wartość niemożliwa, prawdziwa nieznana |
| R01: wiek 17 | 1 | zostaw | wartość możliwa; wykluczenie według kryteriów włączenia |
| R05: staż > wiek − 18 | 3 | brak | jednostki nie zgadujemy |
| R06 i R09: godziny pracy przy „nie pracuję”, 400 godzin | 5 wartości | brak | „nie dotyczy” albo wartość niemożliwa |
| R08: brak godzin pracy przy „pracuję” | 5 | zostaw | brak odpowiedzi pozostaje brakiem |
| R10: suma doby poza 23–25 godz. | 6 rekordów | brak (4 zmienne) | nie wiadomo, która liczba jest błędna |
| R11: jednakowe odpowiedzi w skali | 8 | zostaw | flaga do analizy wrażliwości |
Flaga ma sens tylko wtedy, gdy potem jej użyjesz. W przykładzie średni wynik skali stresu wyniósł 3.03 u 311 osób (bez 17-latka) i 3.02 u 303 osób bez flagi. Osoby z flagą miały średnio 3.42, ale jest ich zbyt mało, by zmienić wynik – wystarczy o tym jedno zdanie w wynikach.
Dziennik zmian: jeden wiersz na jedną decyzję
Dziennik zmian to zwykły plik CSV. Ma kolumny: identyfikator rekordu, zmienna, stara wartość, nowa wartość (pusta = brak), reguła, decyzja, powód i data. Do dziennika trafiają także decyzje „zostaw” – wtedy stara i nowa wartość są takie same. Fragment z przykładu:
| id | Zmienna | Stara | Nowa | Decyzja | Powód |
|---|---|---|---|---|---|
| O165 | wiek | 2002 | 24 | popraw | rok urodzenia w polu wieku: wiek = 2026 − rok (±1 rok) |
| O175 | wiek | 7 | (brak) | brak | wartość niemożliwa, prawdziwej nie da się ustalić |
| O271 | wiek | 17 | 17 | zostaw | wartość możliwa; osoba poniżej 18 lat – wykluczenie wg kryteriów włączenia |
| P005 | wiek | 210 | 21 | popraw | błąd przepisywania; ankieta papierowa: na ankiecie 21 |
| O041 | staz | 48 | (brak) | brak | staż > wiek − 18; jednostki (miesiące?) nie zgadujemy |
| O114 | godz_pracy | (brak) | (brak) | zostaw | brak odpowiedzi – pozostaje brakiem danych |
Kolumna ze starą wartością jest zabezpieczeniem, a nie ozdobnikiem. Funkcja zastosuj_dziennik() przed każdą zmianą sprawdza, czy w danych naprawdę jest to, co zapisano w dzienniku. Jeśli ktoś „poprawił” plik surowy ręcznie albo pobrał nowy eksport z inną wartością, skrypt zatrzymuje się z komunikatem zamiast po cichu nadpisać nie tę liczbę. W przykładzie zmieniliśmy w kopii danych wiek O165 z 2002 na 2001. Skrypt odpowiedział: „w danych jest 2001, w dzienniku 2002 – sprawdź, czy plik surowy się nie zmienił”. Dziennik wskazuje rekordy po identyfikatorze, a nie po numerze wiersza, więc inna kolejność wierszy w nowym eksporcie mu nie przeszkadza.
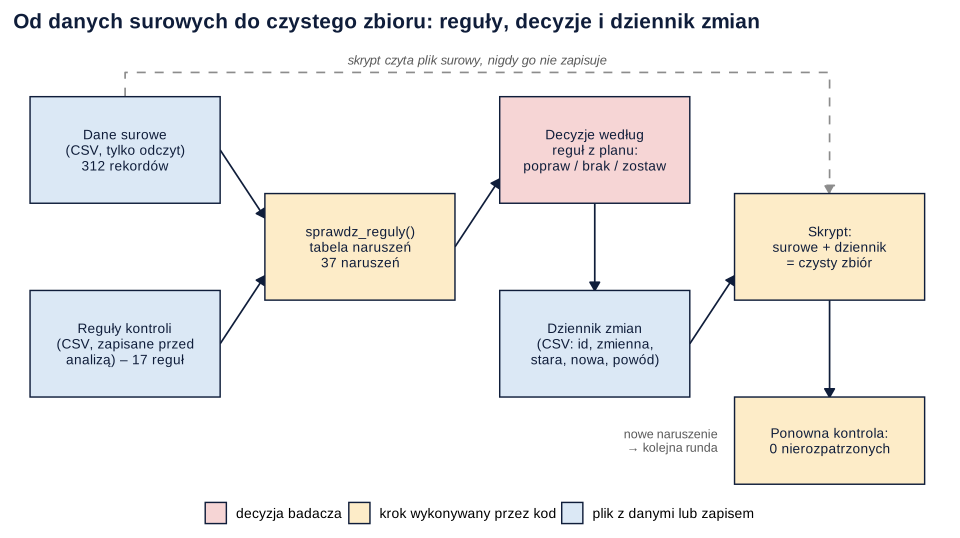
Po zastosowaniu dziennika uruchom reguły jeszcze raz. W przykładzie dziennik zmienił 40 komórek w 22 rekordach (5 poprawek, 35 braków), a liczba rekordów pozostała równa 312. Ponowna kontrola znalazła 15 naruszeń: 14 z decyzją „zostaw” i jedno nowe. Osoba O199 pracuje, a jej 400 godzin zamieniło się w brak, więc teraz łamie regułę R08 („pracuję”, ale brak godzin). Zmiana jednej wartości wywołała nowe naruszenie. Dlatego kontrolę powtarzasz, aż nie zostanie nic nierozpatrzonego. Po dopisaniu decyzji „zostaw” dla O199 druga runda dała 15 naruszeń, wszystkie z decyzją w dzienniku, i 0 nierozpatrzonych. Dziennik ma 55 wierszy. Cały obieg pokazuje rysunek 2.
Dziennik możesz pobrać jako wzór: dziennik-zmian-ankieta.csv. W przykładzie większość wierszy tworzy kod według reguł decyzji, a ręcznie dopisuje się tylko notatki z ponownego przejrzenia ankiet papierowych. W małym badaniu dziennik możesz w całości prowadzić ręcznie w arkuszu – ważne, żeby miał te same kolumny i był czytany przez skrypt, a nie przepisywany.
Dane surowe nietknięte, czysty zbiór z jednego skryptu
Cały układ opiera się na jednej zasadzie: pliku surowego nie zmieniasz nigdy. Wilson i in. (2017) wśród „wystarczająco dobrych” praktyk pracy z danymi zalecają przechowywanie danych surowych w niezmienionej postaci, najlepiej jako plików tylko do odczytu, i zapisywanie wszystkich kroków przetwarzania. Sandve i in. (2013) radzą unikać ręcznych przekształceń danych i zapisywać, jak powstał każdy wynik. Broman i Woo (2018) dodają, że w pliku z danymi surowymi nie robi się obliczeń. W przykładzie skrypt na początku i na końcu liczy sumę kontrolną MD5 pliku surowego. Obie sumy są identyczne, czyli plik nie zmienił się ani o bajt.
W praktyce wystarczą trzy pliki wejściowe i jeden skrypt: dane surowe, reguły i dziennik. Skrypt czyta je i zapisuje czysty zbiór oraz raport naruszeń. Czystego zbioru nie poprawiasz ręcznie, bo przy następnym uruchomieniu skryptu poprawka zniknie. Gdy dojdzie 10 spóźnionych ankiet papierowych, dopisujesz je do danych surowych i uruchamiasz skrypt. Reguły sprawdzą nowe rekordy, a dziennik zastosuje stare decyzje do starych. Taki układ folderów i plików to też gotowy zalążek pakietu replikacyjnego. Prostszą wersję dla pracy dyplomowej opisuje wpis jak przygotować bazę danych do analizy.
Jeśli nie pracujesz w R, zasada się nie zmienia. W SPSS reguły i poprawki zapisujesz w pliku składni, który zaczyna się od wczytania danych surowych. Kolejne kroki przygotowania danych w tym programie opisuje wpis przygotowanie danych w SPSS. W Excelu trzymaj dane surowe w osobnym, nieedytowanym arkuszu, reguły licz formułami w kopii, a dziennik prowadź w trzecim arkuszu. Ograniczenia tego rozwiązania opisuje wpis czy Excel wystarczy do analizy. Kod z tego wpisu nie wymaga żadnych pakietów, więc dobrze nadaje się na pierwsze kroki z R dla początkujących.
Jak opisać kontrolę danych w metodach
W rozdziale metodologicznym wystarczy jeden akapit. Podajesz w nim, że reguły powstały przed analizą, jakie są ich rodzaje, ile wartości zmieniono i jak. Wzór na liczbach z przykładu – uzupełnij nawiasy i usuń zdania, które Cię nie dotyczą:
Wyniki analizy wrażliwości dodaj w rozdziale wyników jednym zdaniem, np.: „Wykluczenie 8 osób oznaczonych z powodu jednakowych odpowiedzi nie zmieniło średniego wyniku skali stresu (M = 3.02 wobec 3.03)”. Osobę wykluczoną za wiek i inne wykluczenia rekordów pokazujesz na diagramie przepływu. Przed oddaniem pracy sprawdź jeszcze, czy liczby z opisu kontroli zgadzają się z tabelami (zob. kontrola spójności liczb w pracy).
Najczęstsze błędy
- Poprawki w pliku surowym. Po pierwszej zmianie nie ma już punktu odniesienia ani możliwości sprawdzenia, co było w danych.
- Reguły ustalane po obejrzeniu danych. Granice dobrane tak, żeby „pasowały”, to ukryta selekcja.
- Zgadywanie prawdziwej wartości. „Pewnie miesiące”, „pewnie literówka” – bez źródła albo reguły zapisanej z góry to brak, nie poprawka.
- Usuwanie całej osoby za jedną błędną wartość. Zwykle wystarczy oznaczyć brakiem jedną komórkę, a resztę odpowiedzi zachować.
- Braki traktowane jako naruszenia (albo odwrotnie). Bez osobnych reguł dla braków funkcja albo zgłasza setki fałszywych alarmów, albo przepuszcza puste pola, które powinny być wypełnione.
- Wartości skrajne poprawiane jak błędy. Rzadka wartość nie jest wartością niemożliwą.
- Brak ponownej kontroli. Zmiana jednej wartości potrafi wywołać nowe naruszenie innej reguły.
- Flaga bez analizy wrażliwości. Oznaczenie rekordów ma sens tylko wtedy, gdy sprawdzisz, czy zmieniają wynik.
Jeśli chcesz, żeby ktoś przejrzał z Tobą reguły kontroli, dziennik zmian i skrypt przed analizą, zobacz pomoc w analizie dla studentów.
Reguły kontroli i dziennik zmian w R
Trzy przepisy liczą wszystkie liczby z tekstu i używają tylko bazowego R. Pierwszy tworzy symulowany surowy zbiór z błędami i zapisuje go w folderze nadrzędnym (../). Drugi zapisuje reguły i funkcję sprawdz_reguly() i tworzy tabelę naruszeń. Trzeci wczytuje wynik drugiego, podejmuje decyzje, zapisuje dziennik zmian, odtwarza czysty zbiór i powtarza kontrolę. Przepisy uruchamiaj po kolei z jednego folderu. Rysunki powstały w osobnym skrypcie na tych samych plikach. Do własnych danych wystarczą przepisy 2 i 3: podmień plik danych, wiersze tabeli reguł i reguły decyzji. Pliki do pobrania: dane surowe, reguły i dziennik zmian (CSV, UTF-8, dane fikcyjne).
Surowy zbiór: 272 ankiety online i 40 papierowych z typowymi błędami
R
# B448 – symulowany surowy zbiór ankiety: 272 odpowiedzi online i 40 ankiet papierowych
# Dane fikcyjne. Badanie: stres i praca zarobkowa studentów kierunków medycznych (marzec 2026).
# W danych są błędy, jakie zdarzają się w prawdziwych zbiorach; skrypt zapisuje plik do ../
set.seed(448)
n_on <- 272; n_pap <- 40; N <- n_on + n_pap
d <- data.frame(id = c(sprintf("O%03d", 1:n_on), sprintf("P%03d", 1:n_pap)),
                zrodlo = rep(c("online", "papier"), c(n_on, n_pap)))
d$wiek <- pmin(55, pmax(19, round(rnorm(N, 23.5, 4.5))))
d$plec <- sample(c(1, 2, 9), N, replace = TRUE, prob = c(.80, .17, .03))   # 1 K, 2 M, 9 wolę nie podawać
d$pracuje <- ifelse(runif(N) < .55, 1, 2)                                   # 1 tak, 2 nie
pr <- d$pracuje == 1
d$staz <- NA; d$staz[pr] <- pmin(d$wiek[pr] - 18, round(rgamma(sum(pr), 2, 1)))
d$godz_pracy <- NA; d$godz_pracy[pr] <- round(runif(sum(pr), 8, 40))
# Typowy dzień powszedni w godzinach: sen + nauka + praca + inne = 24
d$sen <- pmin(10, pmax(4, round(rnorm(N, 7, 1))))
d$nauka <- pmin(10, pmax(1, round(rnorm(N, 4, 1.5))))
d$praca_d <- ifelse(pr, round(d$godz_pracy / 5), 0)
d$nauka <- pmin(d$nauka, 23 - d$sen - d$praca_d)
d$inne <- 24 - d$sen - d$nauka - d$praca_d
# Skala stresu: 6 pozycji 1–5, str_4 odwrócona
theta <- rnorm(N)
for (j in 1:6) {
  x <- cut(.8 * theta + rnorm(N, 0, .7), c(-Inf, -1.2, -.4, .4, 1.2, Inf), labels = FALSE)
  d[[paste0("str_", j)]] <- if (j == 4) 6 - x else x
}
items <- paste0("str_", 1:6)

# ---- błędy w odpowiedziach online (wiersze losowane bez powtórzeń) ----
on <- which(d$zrodlo == "online")
wolne <- on
bierz <- function(pula, k) { w <- sample(intersect(pula, wolne), k); wolne <<- setdiff(wolne, w); w }
w <- bierz(on, 2); d$wiek[w] <- c(1999, 2002)                   # rok urodzenia zamiast wieku
w <- bierz(on, 1); d$wiek[w] <- 7                               # literówka
w <- bierz(on, 1); d$wiek[w] <- 17                              # wartość prawdziwa, poza kryterium
w <- bierz(which(pr & d$staz >= 3), 3); d$staz[w] <- d$staz[w] * 12   # staż w miesiącach
w <- bierz(which(!pr), 4); d$godz_pracy[w] <- c(0, 10, 12, 16)  # odpowiedź mimo „nie pracuję”
w <- bierz(which(pr), 5); d$godz_pracy[w] <- NA                 # brak odpowiedzi
w <- bierz(which(pr), 1); d$godz_pracy[w] <- 400                # literówka
w <- bierz(on, 3); d$nauka[w] <- d$nauka[w] + c(6, 8, 10)       # suma doby > 25
w <- bierz(on, 2); d$sen[w] <- d$sen[w] * 7                     # sen za cały tydzień
w <- bierz(on, 1); d$inne[w] <- 0                               # suma doby < 23
w <- bierz(on, 7); for (i in w) d[i, items] <- sample(3:5, 1)   # te same odpowiedzi w całej skali

# ---- błędy przy przepisywaniu ankiet papierowych ----
pap <- which(d$zrodlo == "papier")
d$wiek[pap[5]] <- 210        # na ankiecie: 21
d$str_2[pap[12]] <- 33       # na ankiecie: 3
d$str_5[pap[19]] <- 0        # na ankiecie: brak zaznaczenia
d$plec[pap[26]] <- 3         # na ankiecie: 2
d$str_6[pap[33]] <- 6        # na ankiecie: zaznaczone dwa pola (4 i 5)

write.csv(d, "../ankieta-stres-praca-surowe.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")
cat(sprintf("Zapisano surowy zbiór: %d wierszy (%d online, %d papier), %d kolumn\n",
            nrow(d), n_on, n_pap, ncol(d)))
options(width = 110)
print(head(d, 4), row.names = FALSE)
Wynik w R
Zapisano surowy zbiór: 312 wierszy (272 online, 40 papier), 17 kolumn
   id zrodlo wiek plec pracuje staz godz_pracy sen nauka praca_d inne str_1 str_2 str_3 str_4 str_5 str_6
 O001 online   24    1       1    3         35   7     1       7    9     4     5     4     1     5     4
 O002 online   19    1       2   NA         NA   7     5       0   12     3     2     1     4     2     2
 O003 online   24    1       2   NA         NA   7     2       0   15     3     2     2     3     1     2
 O004 online   30    2       1    2         24   5     2       5   12     4     3     3     2     4     4
Tabela reguł i funkcja zwracająca tabelę naruszeń
R
# B448 – reguły kontroli zapisane przed analizą i funkcja zwracająca tabelę naruszeń (tylko bazowy R)
options(width = 110)
surowe <- read.csv("../ankieta-stres-praca-surowe.csv", colClasses = c(id = "character"),
                   fileEncoding = "UTF-8")
items <- paste0("str_", 1:6)

# 1. Reguły: każda to warunek, który MUSI być prawdziwy w poprawnym rekordzie.
#    Warunek z wynikiem NA (brak danych w zmiennej) nie jest naruszeniem – braki mają osobne reguły.
#    rodzaj: twarda = wartość niemożliwa albo sprzeczna, miękka = wartość podejrzana do przejrzenia
reguly <- data.frame(
  regula = c("R01", "R02", "R03", paste0("R04_", items), "R05", "R06", "R07", "R08", "R09", "R10", "R11", "R12"),
  opis = c("wiek 18–70 lat", "płeć: kody 1, 2, 9", "pracuje: kody 1, 2",
           paste("pozycja", items, "w zakresie 1–5"),
           "staż pracy ≤ wiek − 18", "godziny pracy puste, gdy pracuje = 2 (nie)",
           "staż pusty, gdy pracuje = 2 (nie)", "godziny pracy podane, gdy pracuje = 1 (tak)",
           "godziny pracy 1–60 tygodniowo", "sen + nauka + praca + inne = 24 h (±1)",
           "nie wszystkie odpowiedzi w skali stresu jednakowe (str_4 odwrócona)", "id niepowtarzalny"),
  zmienne = c("wiek", "plec", "pracuje", items, "staz,wiek", "pracuje,godz_pracy", "pracuje,staz",
              "pracuje,godz_pracy", "godz_pracy", "sen,nauka,praca_d,inne", paste(items, collapse = ","), "id"),
  warunek = c("wiek >= 18 & wiek <= 70", "is.na(plec) | plec %in% c(1, 2, 9)", "is.na(pracuje) | pracuje %in% 1:2",
              paste0("is.na(", items, ") | ", items, " %in% 1:5"),
              "staz <= wiek - 18", "pracuje == 1 | is.na(godz_pracy)", "pracuje == 1 | is.na(staz)",
              "!(pracuje == 1 & is.na(godz_pracy))", "godz_pracy >= 1 & godz_pracy <= 60",
              "abs(sen + nauka + praca_d + inne - 24) <= 1",
              "apply(cbind(str_1, str_2, str_3, str_4, str_5, str_6), 1, function(x) length(unique(x)) > 1)",
              "!duplicated(id) & !duplicated(id, fromLast = TRUE)"),
  rodzaj = c("twarda", "twarda", "twarda", rep("twarda", 6), "twarda", "twarda", "twarda", "miękka",
             "twarda", "twarda", "miękka", "twarda"))
write.csv(reguly, "../reguly-kontroli-danych.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat(sprintf("Reguł: %d (twardych %d, miękkich %d)\n", nrow(reguly),
            sum(reguly$rodzaj == "twarda"), sum(reguly$rodzaj == "miękka")))

# 2. Funkcja: jeden wiersz wyniku = jedno naruszenie (reguła, id, wartości zmiennych z reguły)
sprawdz_reguly <- function(dane, reguly, id = "id") {
  wynik <- lapply(seq_len(nrow(reguly)), function(i) {
    ok <- eval(parse(text = reguly$warunek[i]), envir = dane)
    zle <- which(ok %in% FALSE)                      # NA nie jest naruszeniem
    if (length(zle) == 0) return(NULL)
    zm <- strsplit(reguly$zmienne[i], ",")[[1]]
    wart <- apply(dane[zle, zm, drop = FALSE], 1, function(w)
      paste(paste0(zm, "=", ifelse(is.na(w), "NA", trimws(w))), collapse = "; "))
    data.frame(regula = reguly$regula[i], rodzaj = reguly$rodzaj[i], id = dane[[id]][zle],
               wartosc = unname(wart))
  })
  out <- do.call(rbind, wynik)
  if (is.null(out)) out <- data.frame(regula = character(), rodzaj = character(), id = character(),
                                      wartosc = character())
  out
}

naruszenia <- sprawdz_reguly(surowe, reguly)
write.csv(naruszenia, "b448-naruszenia.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat(sprintf("\nNaruszeń: %d w %d rekordach (twarde %d, miękkie %d)\n", nrow(naruszenia),
            length(unique(naruszenia$id)), sum(naruszenia$rodzaj == "twarda"),
            sum(naruszenia$rodzaj == "miękka")))

# 3. Podsumowanie: liczba naruszeń każdej reguły (także reguł bez naruszeń)
podsum <- data.frame(regula = reguly$regula, opis = reguly$opis,
                     naruszen = as.vector(table(factor(naruszenia$regula, levels = reguly$regula))))
print(podsum, row.names = FALSE, right = FALSE)

cat("\nTabela naruszeń (pierwsze 14 wierszy):\n")
print(head(naruszenia, 14), row.names = FALSE, right = FALSE)

# 4. Ten sam test bez reguły dla braków: ile byłoby „naruszeń” R05, gdyby NA liczyć jako błąd?
ok <- eval(parse(text = "staz <= wiek - 18"), envir = surowe)
cat(sprintf("\nR05: FALSE = %d, NA = %d (osoby niepracujące – reguła ich nie dotyczy)\n",
            sum(ok %in% FALSE), sum(is.na(ok))))
Wynik w R
Reguł: 17 (twardych 15, miękkich 2)

Naruszeń: 37 w 36 rekordach (twarde 24, miękkie 13)
 regula    opis                                                                naruszen
 R01       wiek 18–70 lat                                                      5
 R02       płeć: kody 1, 2, 9                                                  1
 R03       pracuje: kody 1, 2                                                  0
 R04_str_1 pozycja str_1 w zakresie 1–5                                        0
 R04_str_2 pozycja str_2 w zakresie 1–5                                        1
 R04_str_3 pozycja str_3 w zakresie 1–5                                        0
 R04_str_4 pozycja str_4 w zakresie 1–5                                        0
 R04_str_5 pozycja str_5 w zakresie 1–5                                        1
 R04_str_6 pozycja str_6 w zakresie 1–5                                        1
 R05       staż pracy ≤ wiek − 18                                              3
 R06       godziny pracy puste, gdy pracuje = 2 (nie)                          4
 R07       staż pusty, gdy pracuje = 2 (nie)                                   0
 R08       godziny pracy podane, gdy pracuje = 1 (tak)                         5
 R09       godziny pracy 1–60 tygodniowo                                       2
 R10       sen + nauka + praca + inne = 24 h (±1)                              6
 R11       nie wszystkie odpowiedzi w skali stresu jednakowe (str_4 odwrócona) 8
 R12       id niepowtarzalny                                                   0

Tabela naruszeń (pierwsze 14 wierszy):
 regula    rodzaj id   wartosc
 R01       twarda O165 wiek=2002
 R01       twarda O175 wiek=7
 R01       twarda O182 wiek=1999
 R01       twarda O271 wiek=17
 R01       twarda P005 wiek=210
 R02       twarda P026 plec=3
 R04_str_2 twarda P012 str_2=33
 R04_str_5 twarda P019 str_5=0
 R04_str_6 twarda P033 str_6=6
 R05       twarda O041 staz=48; wiek=22
 R05       twarda O096 staz=48; wiek=24
 R05       twarda O151 staz=36; wiek=24
 R06       twarda O130 pracuje=2; godz_pracy=10
 R06       twarda O189 pracuje=2; godz_pracy=0

R05: FALSE = 3, NA = 148 (osoby niepracujące – reguła ich nie dotyczy)
Decyzje, dziennik zmian, czysty zbiór i ponowna kontrola
R
# B448 – decyzje, dziennik zmian i odtworzenie czystego zbioru z danych surowych (tylko bazowy R)
options(width = 110)
invisible(capture.output(source("b448-2-reguly.R")))   # reguły, sprawdz_reguly(), naruszenia, surowe
plik_surowy <- "../ankieta-stres-praca-surowe.csv"
md5_przed <- unname(tools::md5sum(plik_surowy))

# 1. Notatki z ponownego sprawdzenia ankiet papierowych (co jest na kartce)
wglad <- data.frame(id = c("P005", "P012", "P019", "P026", "P033"),
                    zmienna = c("wiek", "str_2", "str_5", "plec", "str_6"),
                    na_ankiecie = c("21", "3", "", "2", ""),
                    uwaga = c("na ankiecie 21", "na ankiecie 3", "brak zaznaczenia na ankiecie",
                              "na ankiecie zaznaczone 2", "zaznaczone dwa pola (4 i 5)"))

# 2. Reguły decyzji ustalone przed analizą – dla każdego naruszenia jeden lub kilka wierszy dziennika
wiersz <- function(id, zm, stara, nowa, reg, dec, powod)
  data.frame(id = id, zmienna = zm, stara_wartosc = stara, nowa_wartosc = nowa,
             regula = reg, decyzja = dec, powod = powod, data = "2026-04-02")
wart <- function(id, zm) { x <- surowe[surowe$id == id, zm]; ifelse(is.na(x), "", as.character(x)) }
dz <- list()
for (k in seq_len(nrow(naruszenia))) {
  r <- naruszenia$regula[k]; id <- naruszenia$id[k]; pap <- substr(id, 1, 1) == "P"
  if (r %in% c("R01", "R02") || startsWith(r, "R04")) {
    zm <- c(R01 = "wiek", R02 = "plec")[r]; if (is.na(zm)) zm <- sub("R04_", "", r)
    if (pap) {
      g <- wglad[wglad$id == id & wglad$zmienna == zm, ]
      dz[[k]] <- wiersz(id, zm, wart(id, zm), g$na_ankiecie, r, ifelse(g$na_ankiecie == "", "brak", "popraw"),
                        paste("błąd przepisywania; ankieta papierowa:", g$uwaga))
    } else if (zm == "wiek" && surowe$wiek[surowe$id == id] %in% 1940:2008) {
      dz[[k]] <- wiersz(id, zm, wart(id, zm), as.character(2026 - surowe$wiek[surowe$id == id]), r, "popraw",
                        "rok urodzenia w polu wieku: wiek = 2026 − rok (±1 rok)")
    } else if (zm == "wiek" && surowe$wiek[surowe$id == id] %in% 10:17) {
      dz[[k]] <- wiersz(id, zm, wart(id, zm), wart(id, zm), r, "zostaw",
                        "wartość możliwa; osoba poniżej 18 lat – wykluczenie wg kryteriów włączenia")
    } else {
      dz[[k]] <- wiersz(id, zm, wart(id, zm), "", r, "brak", "wartość niemożliwa, prawdziwej nie da się ustalić")
    }
  } else if (r == "R05") {
    dz[[k]] <- wiersz(id, "staz", wart(id, "staz"), "", r, "brak", "staż > wiek − 18; jednostki (miesiące?) nie zgadujemy")
  } else if (r == "R06") {
    dz[[k]] <- wiersz(id, "godz_pracy", wart(id, "godz_pracy"), "", r, "brak",
                      "nie dotyczy: w pytaniu filtrującym „nie pracuję”")
  } else if (r == "R08") {
    dz[[k]] <- wiersz(id, "godz_pracy", "", "", r, "zostaw", "brak odpowiedzi – pozostaje brakiem danych")
  } else if (r == "R09") {
    if (any(naruszenia$regula == "R06" & naruszenia$id == id)) next   # ta sama wartość już rozstrzygnięta w R06
    dz[[k]] <- wiersz(id, "godz_pracy", wart(id, "godz_pracy"), "", r, "brak", "wartość niemożliwa (> 60 h)")
  } else if (r == "R10") {
    zm <- c("sen", "nauka", "praca_d", "inne")
    dz[[k]] <- wiersz(id, zm, sapply(zm, function(z) wart(id, z)), "", r, "brak",
                      "suma doby ≠ 24 h; nie wiadomo, która wartość jest błędna")
  } else if (r == "R11") {
    dz[[k]] <- wiersz(id, "str_1–str_6", wart(id, "str_1"), wart(id, "str_1"), r, "zostaw",
                      "jednakowe odpowiedzi mimo pozycji odwróconej; flaga do analizy wrażliwości")
  }
}
dziennik <- do.call(rbind, dz); rownames(dziennik) <- NULL
write.csv(dziennik, "../dziennik-zmian-ankieta.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat(sprintf("Dziennik: %d wierszy dla %d naruszeń\n", nrow(dziennik), nrow(naruszenia)))
print(table(dziennik$decyzja))
cat("\nFragment dziennika:\n")
options(width = 160)
print(dziennik[c(1:6, 10, 12, 18), c("id", "zmienna", "stara_wartosc", "nowa_wartosc", "decyzja", "powod")],
      row.names = FALSE, right = FALSE)
options(width = 110)

# 3. Czysty zbiór powstaje wyłącznie z pliku surowego i pliku dziennika
zastosuj_dziennik <- function(dane, dz) {
  zm <- dz[dz$decyzja %in% c("popraw", "brak"), ]
  for (k in seq_len(nrow(zm))) {
    w <- match(zm$id[k], dane$id); v <- zm$zmienna[k]
    if (is.na(w) || !v %in% names(dane)) stop(sprintf("Nie ma rekordu %s albo zmiennej %s", zm$id[k], v))
    obecna <- ifelse(is.na(dane[w, v]), "", as.character(dane[w, v]))
    if (obecna != zm$stara_wartosc[k])
      stop(sprintf("%s, %s: w danych jest „%s”, w dzienniku „%s” – sprawdź, czy plik surowy się nie zmienił",
                   zm$id[k], v, obecna, zm$stara_wartosc[k]))
    dane[w, v] <- if (zm$nowa_wartosc[k] == "") NA else as.numeric(zm$nowa_wartosc[k])
  }
  dane
}
surowe <- read.csv(plik_surowy, colClasses = c(id = "character"), fileEncoding = "UTF-8")
dziennik <- read.csv("../dziennik-zmian-ankieta.csv", colClasses = "character", fileEncoding = "UTF-8")
czyste <- zastosuj_dziennik(surowe, dziennik)
czyste$flaga_wzorzec <- as.integer(czyste$id %in% dziennik$id[dziennik$regula == "R11"])
zmienione <- sum(sapply(names(surowe), function(v)
  sum(xor(is.na(surowe[[v]]), is.na(czyste[[v]])) | (surowe[[v]] != czyste[[v]]) %in% TRUE)))
cat(sprintf("\nZmienionych komórek: %d (popraw %d, brak %d) w %d rekordach; rekordów nadal %d\n", zmienione,
            sum(dziennik$decyzja == "popraw"), sum(dziennik$decyzja == "brak"),
            length(unique(dziennik$id[dziennik$decyzja != "zostaw"])), nrow(czyste)))

# 4. Ponowna kontrola: czy zostały tylko naruszenia z decyzją „zostaw”?
nierozpatrzone <- function(po, dz) {
  zostaw <- dz[dz$decyzja == "zostaw", ]
  po[!paste(po$regula, po$id) %in% paste(zostaw$regula, zostaw$id), ]
}
po <- sprawdz_reguly(czyste, reguly)
nr <- nierozpatrzone(po, dziennik)
cat(sprintf("Runda 1 – po czyszczeniu naruszeń: %d, z decyzją „zostaw”: %d, nierozpatrzonych: %d\n",
            nrow(po), nrow(po) - nrow(nr), nrow(nr)))
print(nr, row.names = FALSE, right = FALSE)
# Nowe naruszenie powstało przez zmianę z dziennika (400 → brak) – decyzja dopisana w drugiej rundzie
dziennik <- rbind(dziennik, wiersz(nr$id, "godz_pracy", "", "", nr$regula, "zostaw",
                                   "brak po usunięciu wartości niemożliwej (R09)"))
write.csv(dziennik, "../dziennik-zmian-ankieta.csv", row.names = FALSE, fileEncoding = "UTF-8")
czyste <- zastosuj_dziennik(surowe, dziennik)
czyste$flaga_wzorzec <- as.integer(czyste$id %in% dziennik$id[dziennik$regula == "R11"])
po <- sprawdz_reguly(czyste, reguly)
nr <- nierozpatrzone(po, dziennik)
cat(sprintf("Runda 2 – naruszeń: %d, z decyzją „zostaw”: %d, nierozpatrzonych: %d; dziennik: %d wierszy\n",
            nrow(po), nrow(po) - nrow(nr), nrow(nr), nrow(dziennik)))
print(table(po$regula))
write.csv(czyste, "b448-czyste.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# 5. Flaga w analizie wrażliwości: wynik skali stresu (średnia, str_4 odwrócona)
czyste$stres <- rowMeans(cbind(czyste[, c("str_1", "str_2", "str_3", "str_5", "str_6")], 6 - czyste$str_4),
                         na.rm = TRUE)
a <- czyste[!(czyste$wiek %in% 10:17), ]               # bez osoby poniżej 18 lat
cat(sprintf("\nStres: wszyscy n = %d, M = %.2f; bez flagi wzorca n = %d, M = %.2f; flagowani M = %.2f\n",
            nrow(a), mean(a$stres), sum(a$flaga_wzorzec == 0), mean(a$stres[a$flaga_wzorzec == 0]),
            mean(a$stres[a$flaga_wzorzec == 1])))

# 6. Plik surowy nietknięty, a dziennik pilnuje zgodności z nim
cat(sprintf("\nMD5 pliku surowego przed: %s\nMD5 pliku surowego po:    %s\nIdentyczne: %s\n",
            md5_przed, unname(tools::md5sum(plik_surowy)), md5_przed == unname(tools::md5sum(plik_surowy))))
inny <- surowe; inny$wiek[inny$id == "O165"] <- 2001        # np. ktoś poprawił plik surowy ręcznie
cat(tryCatch({ zastosuj_dziennik(inny, dziennik); "bez błędu" }, error = function(e) conditionMessage(e)), "\n")
Wynik w R
Dziennik: 54 wierszy dla 37 naruszeń

  brak popraw zostaw
    35      5     14

Fragment dziennika:
 id   zmienna    stara_wartosc nowa_wartosc decyzja powod
 O165 wiek       2002          24           popraw  rok urodzenia w polu wieku: wiek = 2026 − rok (±1 rok)
 O175 wiek       7                          brak    wartość niemożliwa, prawdziwej nie da się ustalić
 O182 wiek       1999          27           popraw  rok urodzenia w polu wieku: wiek = 2026 − rok (±1 rok)
 O271 wiek       17            17           zostaw  wartość możliwa; osoba poniżej 18 lat – wykluczenie wg kryteriów włączenia
 P005 wiek       210           21           popraw  błąd przepisywania; ankieta papierowa: na ankiecie 21
 P026 plec       3             2            popraw  błąd przepisywania; ankieta papierowa: na ankiecie zaznaczone 2
 O041 staz       48                         brak    staż > wiek − 18; jednostki (miesiące?) nie zgadujemy
 O151 staz       36                         brak    staż > wiek − 18; jednostki (miesiące?) nie zgadujemy
 O114 godz_pracy                            zostaw  brak odpowiedzi – pozostaje brakiem danych

Zmienionych komórek: 40 (popraw 5, brak 35) w 22 rekordach; rekordów nadal 312
Runda 1 – po czyszczeniu naruszeń: 15, z decyzją „zostaw”: 14, nierozpatrzonych: 1
 regula rodzaj id   wartosc
 R08    miękka O199 pracuje=1; godz_pracy=NA
Runda 2 – naruszeń: 15, z decyzją „zostaw”: 15, nierozpatrzonych: 0; dziennik: 55 wierszy

R01 R08 R11
  1   6   8

Stres: wszyscy n = 311, M = 3.03; bez flagi wzorca n = 303, M = 3.02; flagowani M = 3.42

MD5 pliku surowego przed: bba98ef8e38c3577cbaa314ecd288c35
MD5 pliku surowego po:    bba98ef8e38c3577cbaa314ecd288c35
Identyczne: TRUE
O165, wiek: w danych jest „2001”, w dzienniku „2002” – sprawdź, czy plik surowy się nie zmienił
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base, stats, utils i tools); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed analizą sprawdź…
- Czy reguły kontroli są zapisane (plik lub plan analizy) z datą sprzed otwarcia danych?
- Czy każda zmienna ma w książce kodowej zakres, kody i oznaczenie braków?
- Czy masz reguły dla wszystkich pytań filtrujących i dla sum, które muszą się zgadzać?
- Czy braki sprawdzają osobne reguły, a reguły kodów nie zgłaszają pustych pól?
- Czy reguły decyzji (popraw / brak / zostaw) są ustalone, zanim zobaczysz naruszenia?
- Czy każda zmiana ma wiersz w dzienniku z wartością przed i po zmianie oraz powodem?
- Czy plik surowy jest tylko do odczytu, a czysty zbiór powstaje wyłącznie ze skryptu?
- Czy po zastosowaniu dziennika ponowna kontrola daje 0 nierozpatrzonych naruszeń?
- Czy flagi zostały użyte w analizie wrażliwości, a liczby trafiły do opisu w metodach?
Najczęstsze pytania
Czy wolno poprawiać odpowiedzi respondentów przed analizą danych?
Tak, ale tylko wtedy, gdy znasz prawdziwą wartość: masz oryginał ankiety papierowej albo regułę zapisaną przed analizą, która nie zostawia wątpliwości (np. rok urodzenia wpisany w polu wieku). Każdą taką zmianę zapisz w dzienniku z wartością przed i po zmianie oraz powodem, a w metodach podaj, ile wartości poprawiono. Zgadywanie („pewnie literówka”) nie jest poprawką – wtedy wartość oznaczasz jako brak.
Co zrobić z wartością spoza zakresu, gdy nie wiadomo, jaka jest prawdziwa?
Oznacz ją jako brak danych w tej jednej komórce, a resztę odpowiedzi osoby zachowaj. Nie zamieniaj jej na najbliższą dozwoloną wartość ani na średnią. Jeśli kilka liczb razem nie pasuje (np. suma godzin w dobie wynosi 30), a nie wiadomo, która jest błędna, oznacz brakiem wszystkie, których dotyczy reguła.
Czym różni się dziennik zmian od książki kodowej?
Książka kodowa opisuje zmienne: nazwy, kody, zakresy i oznaczenia braków – to z niej wynikają reguły kontroli. Dziennik zmian opisuje konkretne rekordy: który identyfikator, która zmienna, jaka wartość była, jaka jest teraz i dlaczego. Książkę piszesz przed zebraniem danych, dziennik powstaje przy ich sprawdzaniu.
Czy w pracy dyplomowej trzeba opisywać, jak sprawdzono dane?
Wystarczy krótki akapit w metodach: że reguły kontroli ustalono przed analizą, jakie były ich rodzaje, ile wartości poprawiono, ile oznaczono jako braki i jak postąpiono z rekordami podejrzanymi. Sam dziennik zmian możesz dołączyć jako załącznik albo zachować do wglądu promotora i recenzenta.
Czy zamiast reguł w R wystarczy sprawdzanie poprawności danych w Excelu?
Sprawdzanie poprawności przy wpisywaniu zapobiega części błędów w ankietach papierowych, ale nie wyłapie sprzeczności między pytaniami ani błędów w eksporcie z formularza internetowego. Reguły możesz liczyć formułami w kopii arkusza, a dziennik prowadzić w osobnym arkuszu. Ważne, żeby plik surowy pozostał nietknięty, a każda zmiana miała swój wiersz w dzienniku.
Powiązane hasła
Przeczytaj też
Nie da się połączyć pomiaru przed i po
Uczciwe łączenie kodów regułami ustalonymi z góry, analiza jak dla dwóch grup, utrata mocy, selektywne łączenie, kod R i gotowe zdania.
Czytaj →PoradnikWynik wygląda podejrzanie
Tabela objaw × przyczyna × test, plik CSV z usterkami, kod R z wynikami przed naprawą i po niej oraz lista kontrolna na 10 minut.
Czytaj →PoradnikBłąd w ankiecie po zebraniu danych
Dwanaście usterek formularza: jak je wykryć, co zrobić i co napisać w pracy, z symulowaną ankietą w R i gotowymi zdaniami.
Czytaj →PoradnikPorządek w plikach pracy
Pięć folderów, surowe dane tylko do odczytu, nazwy bez „final2”, kopie 3-2-1, osobny klucz ID i co robić, gdy plik zniknie.
Czytaj →PoradnikAnaliza ankiety z Google Forms krok po kroku
Od surowego CSV do zdań APA: słownik zmiennych, kontrola jakości, przekodowanie pytań, tabela próby i trzy hipotezy w R.
Czytaj →PoradnikDiagram przepływu respondentów
Od 612 wejść w link do 413 analizowanych: etapy, kryteria wykluczeń i ich kolejność, odsetek odpowiedzi i diagram w R.
Czytaj →PoradnikTest techniczny ankiety online
Plan testów dla każdej ścieżki, obowiązkowe pytania, dane testowe ręczne i wygenerowane oraz kontrola eksportu w R według książki kodowej przed wysłaniem linku.
Czytaj →PoradnikPakiet replikacyjny: dane i kod do artykułu
Struktura folderów, README, książka kodowa, skrypty R działające od zera, anonimizacja i RODO, licencje, OSF i deklaracja dostępności danych + szablon ZIP.
Czytaj →Masz surowe dane z ankiety i nie wiesz, co poprawić, a czego nie ruszać?
Spiszemy z Tobą reguły kontroli, przejrzymy naruszenia i decyzje, przygotujemy skrypt z dziennikiem zmian w R lub SPSS i wyjaśnimy, jak opisać to w metodach, żebyś umiał(a) obronić każdą zmianę.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Buchanan, E. M., Crain, S. E., Cunningham, A. L., Johnson, H. R., Stash, H., Papadatou-Pastou, M., Isager, P. M., Carlsson, R., & Aczel, B. (2021). Getting started creating data dictionaries: How to create a shareable data set. Advances in Methods and Practices in Psychological Science, 4(1), Article 2515245920928007. https://doi.org/10.1177/2515245920928007 ● Otwarty dostęp
- Curran, P. G. (2016). Methods for the detection of carelessly invalid responses in survey data. Journal of Experimental Social Psychology, 66, 4–19. https://doi.org/10.1016/j.jesp.2015.07.006 ● Otwarty dostęp: pełny tekst
- Huebner, M., Vach, W., & le Cessie, S. (2016). A systematic approach to initial data analysis is good research practice. The Journal of Thoracic and Cardiovascular Surgery, 151(1), 25–27. https://doi.org/10.1016/j.jtcvs.2015.09.085 ● Otwarty dostęp
- Sandve, G. K., Nekrutenko, A., Taylor, J., & Hovig, E. (2013). Ten Simple Rules for Reproducible Computational Research. PLoS Computational Biology, 9(10), Article e1003285. https://doi.org/10.1371/journal.pcbi.1003285 ● Otwarty dostęp
- Van den Broeck, J., Argeseanu Cunningham, S., Eeckels, R., & Herbst, K. (2005). Data cleaning: Detecting, diagnosing, and editing data abnormalities. PLoS Medicine, 2(10), Article e267. https://doi.org/10.1371/journal.pmed.0020267 ● Otwarty dostęp
- Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLOS Computational Biology, 13(6), Article e1005510. https://doi.org/10.1371/journal.pcbi.1005510 ● Otwarty dostęp
Cytowania BibTeX
@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{buchanan2021getting, author={Buchanan, Erin M. and Crain, Sarah E. and Cunningham, Ari L. and Johnson, Hannah R. and Stash, Hannah and Papadatou-Pastou, Marietta and Isager, Peder M. and Carlsson, Rickard and Aczel, Balazs}, title={{Getting started creating data dictionaries: How to create a shareable data set}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={1}, eid={2515245920928007}, doi={10.1177/2515245920928007}}@article{curran2016methods, author={Curran, Paul G.}, title={{Methods for the detection of carelessly invalid responses in survey data}}, journal={Journal of Experimental Social Psychology}, year={2016}, volume={66}, pages={4--19}, doi={10.1016/j.jesp.2015.07.006}}@article{huebner2016systematic, author={Huebner, Marianne and Vach, Werner and le Cessie, Saskia}, title={{A systematic approach to initial data analysis is good research practice}}, journal={The Journal of Thoracic and Cardiovascular Surgery}, year={2016}, volume={151}, number={1}, pages={25--27}, doi={10.1016/j.jtcvs.2015.09.085}}@article{sandve2013ten, author={Sandve, Geir Kjetil and Nekrutenko, Anton and Taylor, James and Hovig, Eivind}, title={{Ten Simple Rules for Reproducible Computational Research}}, journal={PLoS Computational Biology}, year={2013}, volume={9}, number={10}, eid={e1003285}, doi={10.1371/journal.pcbi.1003285}}@article{vandenbroeck2005data, author={Van den Broeck, Jan and Argeseanu Cunningham, Solveig and Eeckels, Roger and Herbst, Kobus}, title={{Data cleaning: Detecting, diagnosing, and editing data abnormalities}}, journal={PLoS Medicine}, year={2005}, volume={2}, number={10}, eid={e267}, doi={10.1371/journal.pmed.0020267}}@article{wilson2017good, author={Wilson, Greg and Bryan, Jennifer and Cranston, Karen and Kitzes, Justin and Nederbragt, Lex and Teal, Tracy K.}, title={{Good enough practices in scientific computing}}, journal={PLOS Computational Biology}, year={2017}, volume={13}, number={6}, eid={e1005510}, doi={10.1371/journal.pcbi.1005510}}