Metryczka psuje się w formularzu, nie w analizie
Metryczka wygląda na najprostszą część ankiety: wiek, staż, wykształcenie, miejsce zamieszkania. Kłopoty wychodzą dopiero po pobraniu odpowiedzi. Wiek zebrany w przedziałach „20–30, 30–40” nie daje średniej, a 40-latka nie wie, którą odpowiedź zaznaczyć. W polu „staż pracy” są wpisy „15 lat”, „11 miesięcy” i „6,7”. Wykształcenie ma pięć kategorii, z których jedna liczy cztery osoby. Promotor prosi o „grupy stażu”, a Ty nie wiesz, gdzie postawić granice.
Co powinna zawierać metryczka i jak sformułować pytania, opisuje hasło w słowniku. Pytania o płeć i wiek mają osobne hasło: pytania o płeć i wiek w ankiecie. Średnią czy medianę wieku podać w opisie próby, wyjaśnia wpis jak opisać charakterystykę próby. Ten poradnik zajmuje się tym, co dzieje się pomiędzy: jak zapisać wiek, staż i wykształcenie w formularzu i w danych, żeby niczego nie stracić, i jak je potem pogrupować do opisu i do analizy. Jest częścią serii o ankiecie własnej. Pozostałe wpisy omawiają opis wyników ankiety z wieloma pytaniami, łączenie kategorii odpowiedzi, pytania filtrujące i mianownik oraz analizę ankiety z Google Forms krok po kroku.
Przykład przewodni: ankieta online o wyczerpaniu zawodowym wśród 260 pielęgniarek i pielęgniarzy (dane symulowane, rok badania 2026). Metryczka ma pola tekstowe na wiek i staż pracy w zawodzie, pytanie jednokrotnego wyboru o wykształcenie i pytanie o miejsce zamieszkania. Wyczerpanie mierzy skala o wynikach 10–50. Surowe odpowiedzi możesz pobrać: metryczka-pielegniarki-surowe.csv. Wszystkie liczby poniżej pochodzą z kodu w sekcji Kod R.
Krok 1. Wiek i staż: pytaj o liczbę, nie o przedział
Zasada jest jedna: to, co da się policzyć w latach, zbieraj w latach. Z liczby lat zrobisz później dowolne przedziały, a z przedziału nie odtworzysz liczby lat. Przedziały w samym pytaniu mają sens głównie wtedy, gdy dokładny wiek w małej grupie mógłby pomóc rozpoznać osobę. Tak bywa w ankiecie wśród kilkunastu osób z jednego oddziału (zob. anonimizacja i pseudonimizacja danych).
Przedziały nachodzące na siebie
Najczęstszy błąd w metryczkach studenckich to kafeteria „20–30, 30–40, 40–50, 50–60, powyżej 60”. Wiek 30, 40, 50 i 60 lat pasuje do dwóch odpowiedzi. To nie jest margines: w przykładzie na granicy przedziałów było 31 z 258 osób (12.0%), które podały wiek. Każda z nich wybrałaby przedział według własnego uznania, a tego w danych nie odróżnisz.
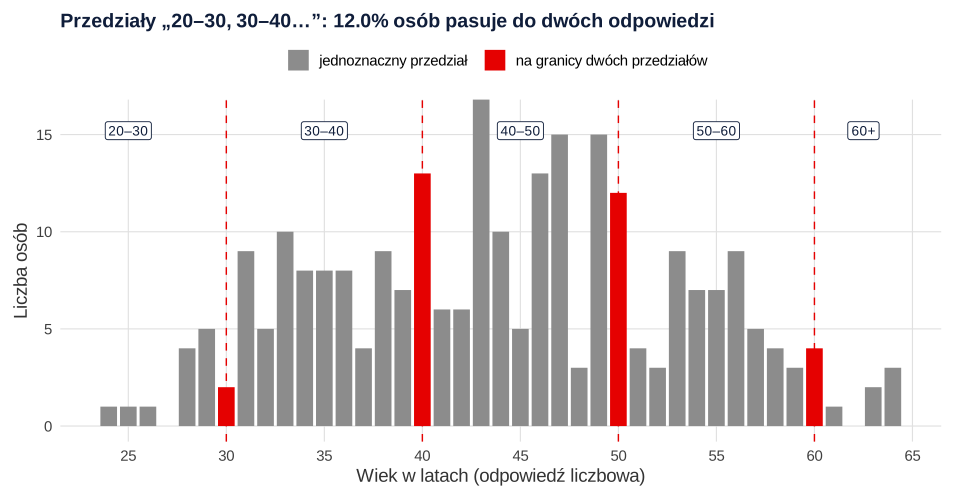
Przedziały muszą być rozłączne („20–29, 30–39”) i razem obejmować wszystkie możliwe odpowiedzi. Unikaj też przedziałów nierównych bez powodu, np. „do 25, 26–30, 31–50, powyżej 50”. W szerokim środkowym przedziale znajdą się zarówno osoby na początku pracy, jak i bliskie emerytury.
Rok urodzenia zamiast wieku
Część osób zamiast wieku wpisuje rok urodzenia. Wiek obliczony jako rok badania minus rok urodzenia może być o rok za wysoki, bo nie wiesz, czy dana osoba miała już w tym roku urodziny. W przykładzie 6 osób podało rok urodzenia i u 5 z nich wiek wyszedł o rok wyższy niż prawdziwy. Do opisu próby taki błąd nie ma znaczenia. Jeśli wiek jest kryterium włączenia, np. pełnoletność, zapytaj wprost o ukończone lata.
Jaki staż i w jakich jednostkach
„Staż pracy” ma kilka znaczeń: staż w zawodzie, w obecnej placówce, na obecnym oddziale, na stanowisku kierowniczym. Wybierz ten, który wynika z hipotezy, i nazwij go w pytaniu: „Ile lat pracujesz w zawodzie pielęgniarki/pielęgniarza? Jeśli krócej niż rok, wpisz 0”. Jeśli potrzebujesz kilku rodzajów stażu, zadaj kilka osobnych pytań. W formularzu ustaw walidację liczby i rozsądny zakres, np. 0–50.
Pamiętaj, że staż to odpowiedź z pamięci. Ludzie zaokrąglają długie okresy do okrągłych liczb. Huttenlocher i in. (1990) opisują to zjawisko w raportach o czasie, który upłynął od zdarzenia: wartości zaokrąglone reprezentują coraz szersze kategorie czasu. W danych może się to objawiać nadmiarem odpowiedzi 10, 15, 20 czy 25 lat. Dlatego staż podawaj w pełnych latach, a nie z dokładnością do miesiąca.
Krok 2. Zamień tekst na liczbę lat i sprawdź spójność
Nawet przy pytaniu o liczbę pole tekstowe przynosi różne zapisy. Ogólne zasady zamiany tekstu na liczby (przecinek dziesiętny, dopiski „lat”) pokazuje poradnik dane z Google Forms i LimeSurvey do SPSS i R. W metryczce dochodzą do nich dwie sprawy charakterystyczne dla wieku i stażu: jednostki i spójność obu zmiennych.
| Wpis | Pole | Decyzja | Ile w przykładzie |
|---|---|---|---|
| „50 lat” | wiek | wyciągnij liczbę: 50 | 14 wpisów z dopiskiem |
| „1988” | wiek | rok urodzenia: 2026 − 1988 = 38 | 6 |
| „11 miesięcy” | staż | podziel przez 12: 0.92 roku | 1 |
| „6,7” | staż | zamień przecinek na kropkę: 6.7 | 4 |
| „44” u osoby w wieku 29 lat | staż | niespójne – prawdopodobnie miesiące; brak danych albo kontakt, jeśli ankieta nie jest anonimowa | 2 |
| pusta komórka | wiek | brak danych | 2 |
Ostatni typ błędu jest najgroźniejszy, bo wygląda jak poprawna liczba. Dwie osoby w wieku 29 lat wpisały staż 44 i 43. Najpewniej podały go w miesiącach. Wykryjesz to tylko regułą spójności: staż nie może być większy niż wiek minus wiek, w którym najwcześniej można zacząć pracę w zawodzie. W przykładzie przyjęto próg wiek − 18. Takich wartości nie poprawiaj „na oko”. Oznacz je jako braki albo przekoduj według reguły zapisanej przed analizą, a w pracy podaj, ile było takich przypadków. Reguły sprawdzania zakresów i spójności to część czyszczenia danych z ankiety online. Kody braków i jednostki zapisz w książce kodowej.
Krok 3. Ile tracisz, gdy staż zbierasz w przedziałach
Załóżmy, że zamiast liczby lat ankieta pytała o staż w pięciu przedziałach: poniżej 5, 5–9, 10–19, 20–29, 30 i więcej lat. To dane zgrubne (ang. coarse data). Heitjan i Rubin (1991) zaliczają do nich dane zaokrąglone, skategoryzowane i cenzurowane. Co z nimi tracisz?
- Średnią. Możesz ją tylko przybliżyć ze środków przedziałów, a dla przedziału otwartego musisz zgadnąć wartość. Średni staż z liczby lat wyniósł 20.74 roku. Ze środków przedziałów wychodzi 21.42 roku, jeśli dla „30 i więcej” przyjmiesz 35, albo 22.37 roku, jeśli przyjmiesz 40. Wynik zależy od założenia, którego nie da się sprawdzić.
- Medianę. Z liczby lat wynosi 21.0. Z przedziałów wiesz tylko, że leży w przedziale 20–29 lat.
- Część mocy. Ile – zależy od liczby przedziałów.
W przykładzie wyczerpanie korelowało ze stażem w latach: r = .175, 95% CI [.055, .291], p = .005. Z kodami pięciu przedziałów wynik był podobny (r = .180, p = .004). Po podziale stażu medianą korelacja spadła do r = .156, 95% CI [.035, .273], p = .012. Pojedyncza próba niewiele jednak mówi. W tej przedziały wypadły nawet minimalnie lepiej niż liczba lat. Dlatego te same dane wygenerowano 2000 razy dla czterech liczebności i policzono, jak często test wykrywa związek (rysunek 2).
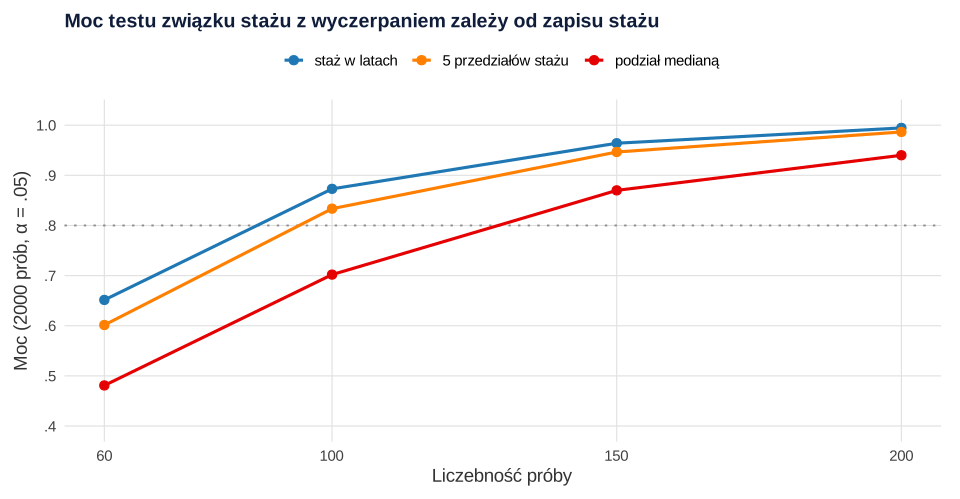
Przy 100 osobach test wykrył związek w 87.3% prób dla stażu w latach, w 83.4% dla pięciu przedziałów i w 70.2% po podziale medianą. Przy 60 osobach było to odpowiednio 65.1%, 60.2% i 48.1%. Pięć sensownych przedziałów kosztuje więc niewiele mocy, a dwie grupy – sporo. To zgodne z wnioskami MacCalluma i in. (2002) oraz Altmana i Roystona (2006): dychotomizacja zmiennej ciągłej rzadko jest uzasadniona i kosztuje moc. Więcej o tym piszemy w haśle dzielenie medianą i we wpisie o dychotomizacji zmiennych ciągłych. Przedziały nie odbierają więc dużo mocy, ale zabierają średnią, medianę i możliwość innego pogrupowania później. Dla dochodu, o który i tak pyta się w przedziałach, wpis pytanie o dochód w ankiecie pokazuje model przedziałowy zamiast punktów środkowych.
Krok 4. Grupy do opisu: kwartyle próby czy progi merytoryczne
Do analiz zostaw wiek i staż w latach. Do opisu próby i do tabel z odsetkami często potrzebne są jednak grupy. Masz dwie drogi: podzielić próbę według kwartyli albo przyjąć progi merytoryczne, ustalone przed zebraniem danych.
| Sposób grupowania | Grupy (staż w latach) | n | M wyczerpania |
|---|---|---|---|
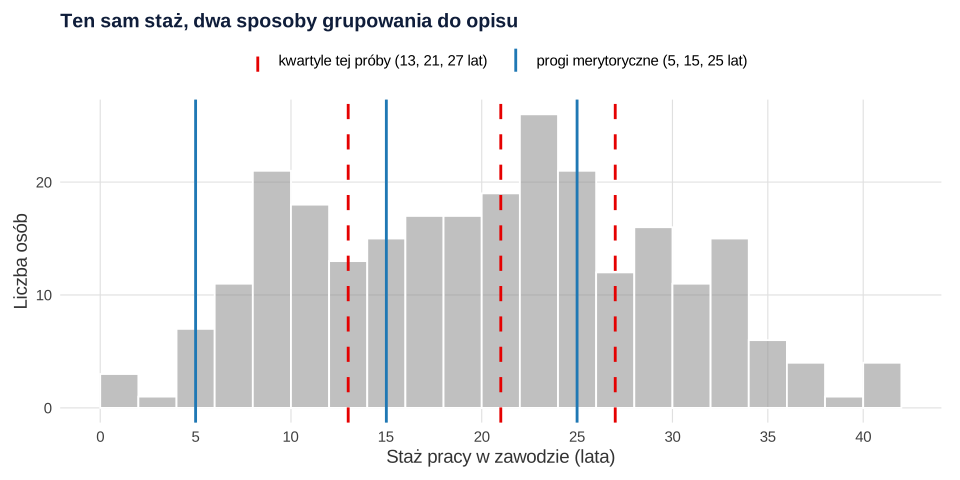
| Kwartyle tej próby | Q1: 0.9–13 / Q2: 14–21 / Q3: 22–27 / Q4: 28–42 | 69 / 64 / 64 / 61 | 24.67 / 26.75 / 28.45 / 27.62 |
| Progi merytoryczne | poniżej 5 / 5–14 / 15–24 / 25 i więcej | 4 / 70 / 94 / 90 | 22.75 / 24.64 / 27.31 / 28.19 |
Kwartyle dają równe grupy, ale ich granice (13, 21 i 27 lat) wynikają z tej konkretnej próby. W innym szpitalu wypadną gdzie indziej, więc wyników nie porównasz z innymi badaniami. Grupy kwartylowe są też niejednorodne: Q1 obejmuje zarówno osobę z 11 miesiącami stażu, jak i osoby z 13 latami pracy. Bennette i Vickers (2012) krytykują dzielenie zmiennych ciągłych na tercyle, kwartyle i kwintyle w badaniach epidemiologicznych jako problematyczne. Szerzej piszemy o tym w haśle o tercylach i podziale kwantylowym.
Progi merytoryczne (5, 15 i 25 lat) są czytelne i możesz je powtórzyć w kolejnym badaniu. Wybierz je przed analizą: z literatury, z raportów, z którymi porównujesz próbę, albo z etapów kariery w zawodzie. Wada jest jedna: grupy bywają nierówne. Tu najkrótszy staż miały tylko 4 osoby. Taką grupę połącz z sąsiednią („poniżej 15 lat”, 74 osoby) albo opisz liczebnością bez odsetków i średnich. Zasady łączenia, także ustalone przed analizą, opisuje wpis o łączeniu kategorii odpowiedzi.
Krok 5. Wykształcenie: kategorie porządkowe, nie liczba
Wykształcenie to zmienna na skali porządkowej. Kategorie mają kolejność, ale odległości między nimi nie są równe. W pielęgniarstwie kafeteria powinna odpowiadać ścieżkom kształcenia w zawodzie, np. średnie medyczne (liceum lub szkoła policealna), licencjat pielęgniarstwa, magister pielęgniarstwa, magister innego kierunku i stopień doktora. Specjalizacja i kursy kwalifikacyjne to inne kwalifikacje niż poziom wykształcenia, więc pytaj o nie osobnym pytaniem.
W przykładzie rozkład wyglądał tak: średnie medyczne 79 osób, licencjat 80, magister pielęgniarstwa 82, magister innego kierunku 15, doktor 4. Do tabel i porównań połączono trzy ostatnie kategorie w „magister lub wyższe” (101 osób). Granica łączenia wynika z poziomu wykształcenia, a nie z tego, która wersja daje „lepsze” p.
- Nie wpisuj kodów 1–3 do regresji jak liczby. Zakładałbyś, że przejście od średniego do licencjatu „waży” tyle samo co od licencjatu do magistra. Użyj kodowania zero-jedynkowego z kategorią odniesienia.
- Pamiętaj o związku z wiekiem. W przykładzie mediana wieku wynosiła 49 lat w grupie z wykształceniem średnim, 40 lat po licencjacie i 43 lata w grupie „magister lub wyższe”. Różnica w wyczerpaniu między grupami wykształcenia może więc częściowo odzwierciedlać wiek i staż. Czy i kiedy dodać wiek do modelu, wyjaśnia wpis czy kontrolować wiek i płeć.
- W badaniu studentów zamiast wykształcenia zapytaj o rok, poziom i tryb studiów.
Płeć, miejsce zamieszkania i dochód
Te pytania mają już swoje strony, więc tu tylko decyzje kodowania:
- Płeć. Odpowiedzi „inna” i „wolę nie odpowiadać” zachowaj w danych jako osobne kody. Nie usuwaj tych osób z próby. Hughes i in. (2022) proponują inkluzywne pytania o tożsamość płciową i płeć przypisaną przy urodzeniu. Gotowe sformułowania znajdziesz w haśle o pytaniach o płeć i wiek.
- Miejsce zamieszkania. Pięć kategorii wielkości miejscowości zakoduj porządkowo (1 = wieś … 5 = miasto powyżej 500 tys.). Do opisu możesz je połączyć według treści. W przykładzie po połączeniu wieś wskazało 57 osób (21.9%), miasto do 100 tys. – 82 (31.5%), a miasto powyżej 100 tys. – 121 (46.5%).
- Dochód. Dochód osobisty czy gospodarstwa, netto czy brutto, kwota czy przedziały – te decyzje i analizę odmów omawia wpis o pytaniu o dochód.
Krok 6. Wiek i staż w analizie: zostaw liczby
Jeśli hipoteza dotyczy stażu, wprowadź staż do modelu jako liczbę lat. Gdy podejrzewasz zależność nieliniową, np. wyczerpanie rośnie przez pierwsze lata, a potem się stabilizuje, nie dziel stażu na grupy. Użyj członu kwadratowego albo splajnu (zob. nieliniowe zależności: splajny i GAM).
Uwaga na parę wiek–staż. W przykładzie korelowały na poziomie r = .95, bo większość osób zaczyna pracę w podobnym wieku. Wstawienie obu zmiennych do jednej regresji daje współliniowość: szerokie przedziały ufności i współczynniki trudne do interpretacji. Vanhove (2021) przekonuje, że współliniowość sama w sobie nie jest chorobą do leczenia, a typowe „lekarstwa” zmieniają pytanie, na które odpowiada model. Najpierw zdecyduj więc, o co pytasz. „Czy liczy się doświadczenie zawodowe?” – to staż. „Czy liczy się wiek?” – to wiek. Jeśli oba są tylko zmiennymi kontrolnymi, ich współliniowość nie szkodzi efektowi, który Cię interesuje. Pokazuje to wpis wysoki VIF – co zrobić.
Krok 7. Metryczka w tabeli charakterystyki próby
Na końcu metryczka trafia do tabeli charakterystyki próby. Dla zmiennych ilościowych podaj średnią i odchylenie standardowe lub medianę z kwartylami. Dla kategorii podaj liczebności i odsetki, a braki w osobnym wierszu. Szczegóły układu (kolumny dla grup, braki, wartości p) omawia wpis Tabela 1 – charakterystyka próby, a gotowe wzory dla kilku typów badań – wzór charakterystyki próby.
Tabela 1
Charakterystyka uczestników badania (N = 260)
| Cecha | Wartość |
|---|---|
| Wiek w latach, M (SD) | 44.1 (8.9) |
| Wiek w latach, Me [Q1, Q3] | 44 [37, 50] |
| brak danych, n | 2 |
| Staż pracy w zawodzie w latach, Me [Q1, Q3] | 21.0 [13.0, 27.0] |
| brak danych lub niespójne, n | 2 |
| Wykształcenie, n (%) | |
| średnie medyczne | 79 (30.4) |
| licencjat pielęgniarstwa | 80 (30.8) |
| magister lub wyższe | 101 (38.8) |
| Miejsce zamieszkania, n (%) | |
| wieś | 57 (21.9) |
| miasto do 100 tys. mieszkańców | 82 (31.5) |
| miasto powyżej 100 tys. mieszkańców | 121 (46.5) |
Uwaga. Wiek i staż zebrano jako liczbę lat. Dwie wartości stażu przekraczające wiek pomniejszony o 18 lat potraktowano jako braki danych. Kategorie wykształcenia „magister pielęgniarstwa”, „magister innego kierunku” i „doktor” połączono; miejsce zamieszkania połączono z pięciu kategorii w trzy. Me – mediana; Q1, Q3 – pierwszy i trzeci kwartyl. Dane symulowane.
Gotowy akapit do rozdziału o metodzie, z opisem kodowania:
I akapit do opisu próby:
Najczęstsze błędy
- Przedziały nachodzące na siebie („20–30, 30–40”) albo niewyczerpujące (brak przedziału dla najstarszych).
- Wiek lub staż zebrane od razu w przedziałach, choć nic nie przemawiało za ochroną tożsamości. Potem nie da się podać średniej ani mediany.
- Pytanie „staż pracy” bez doprecyzowania – jedni podają staż w zawodzie, inni w obecnej placówce.
- Brak kontroli spójności wieku i stażu. Staż w miesiącach wygląda wtedy jak 44 lata pracy u 29-latki.
- Grupy według kwartyli próby przedstawione jak uniwersalne kategorie („niski staż”, „wysoki staż”).
- Podział stażu medianą do testu t zamiast korelacji lub regresji ze stażem w latach.
- Kody wykształcenia 1–5 traktowane jak liczba w średniej albo w regresji.
- Łączenie kategorii po obejrzeniu wyników, aż różnica „wyjdzie”.
- Wiek i staż razem w modelu bez decyzji, o który efekt pytasz, i interpretacja nieistotnych współczynników jako „brak wpływu”.
Metryczka w R: kod i wynik
Jeden skrypt liczy wszystkie liczby z tekstu. Tworzy surowe odpowiedzi z pól tekstowych i zapisuje je do pliku CSV w folderze nadrzędnym (../), zamienia wpisy na liczbę lat, sprawdza spójność wieku i stażu, liczy skutki przedziałów (średnia, korelacja, moc w 2000 powtórzeniach), porównuje grupy kwartylowe z progami merytorycznymi, łączy kategorie wykształcenia i podaje liczby do tabeli charakterystyki próby. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane do pobrania: metryczka-pielegniarki-surowe.csv.
Od wpisów „50 lat” i „1988” do Tabeli 1
R
# B432 – metryczka: wiek, staż i wykształcenie od surowych odpowiedzi do opisu próby
# 260 pielęgniarek i pielęgniarzy, ankieta online w 2026 r. (dane symulowane)
set.seed(432)
N <- 260
ROK_BADANIA <- 2026

# ---- 1. Dane „prawdziwe” (tego nie widzi badacz) ----
wiek <- pmin(pmax(round(rnorm(N, 44, 10)), 22), 64)
start <- 21 + rpois(N, 1.5) + ifelse(runif(N) < .15, sample(3:12, N, replace = TRUE), 0)
staz <- pmax(wiek - start - rpois(N, .6), 0) + round(runif(N), 1)   # lata, z ułamkiem
staz <- pmin(staz, wiek - 20)
wyczerpanie <- round(pmin(pmax(22 + 0.25 * staz + rnorm(N, 0, 8), 10), 50))   # skala 10–50
p_sr <- plogis(-6 + 0.12 * wiek)                                    # starsze osoby częściej po szkole średniej
wyk <- ifelse(runif(N) < p_sr, "Średnie medyczne",
         sample(c("Licencjat pielęgniarstwa", "Magister pielęgniarstwa", "Magister innego kierunku", "Doktor"),
                N, replace = TRUE, prob = c(.46, .44, .07, .03)))
miejsce <- sample(c("Wieś", "Miasto do 20 tys.", "Miasto 20–100 tys.", "Miasto 100–500 tys.", "Miasto pow. 500 tys."),
                  N, replace = TRUE, prob = c(.24, .12, .22, .26, .16))

# ---- 2. Surowe odpowiedzi z pól tekstowych (jak w eksporcie formularza) ----
wiek_txt <- as.character(wiek)
i <- sample(N, 14); wiek_txt[i] <- paste(wiek[i], "lat")
i <- sample(setdiff(1:N, i), 6); wiek_txt[i] <- as.character(ROK_BADANIA - wiek[i] - rbinom(6, 1, .5))  # rok urodzenia
i <- sample(which(!grepl("lat|^19", wiek_txt)), 2); wiek_txt[i] <- ""                               # brak odpowiedzi
staz_txt <- ifelse(staz < 1, paste(round(staz * 12), "miesięcy"), as.character(round(staz)))
i <- sample(which(staz >= 1), 18); staz_txt[i] <- paste(round(staz[i]), "lat")
i <- sample(which(staz >= 1 & staz < 10), 4); staz_txt[i] <- sub("\\.", ",", as.character(staz[i]))   # „2,5”
mlodzi <- which(wiek <= 30 & staz >= 2 & staz < 5)[1:2]
staz_txt[mlodzi] <- as.character(round(staz[mlodzi] * 12))                                            # wpisane w miesiącach
surowe <- data.frame(id = 1:N, wiek_odp = wiek_txt, staz_odp = staz_txt, wyksztalcenie = wyk,
                     miejsce = miejsce, wyczerpanie = wyczerpanie)
write.csv(surowe, "../metryczka-pielegniarki-surowe.csv", row.names = FALSE, fileEncoding = "UTF-8")
cat("SUROWE ODPOWIEDZI – przykłady\n")
print(surowe[c(which(grepl("lat", wiek_txt))[1], which(grepl("^19", wiek_txt))[1],
               which(grepl("mies", staz_txt))[1], which(grepl(",", staz_txt))[1], mlodzi[1]), 1:3], row.names = FALSE)

# ---- 3. Czyszczenie: tekst -> liczba lat ----
na_liczbe <- function(x) {
  x <- tolower(trimws(x)); x <- gsub(",", ".", x)
  liczba <- sub("^[^0-9]*([0-9]+(\\.[0-9]+)?).*$", "\\1", x)       # pierwsza liczba w tekście
  as.numeric(ifelse(grepl("[0-9]", x), liczba, NA))
}
wiek_c <- na_liczbe(surowe$wiek_odp)
z_roku <- !is.na(wiek_c) & wiek_c > 1900
wiek_c[z_roku] <- ROK_BADANIA - wiek_c[z_roku]          # rok urodzenia -> wiek (błąd do 1 roku)
staz_c <- na_liczbe(surowe$staz_odp)
mies <- grepl("mies", surowe$staz_odp)
staz_c[mies] <- staz_c[mies] / 12
niespojne <- which(!is.na(wiek_c) & staz_c > wiek_c - 18)
cat("\nCZYSZCZENIE\n")
cat("Wiek podany jako rok urodzenia:", sum(z_roku), "| z dopiskiem 'lat':", sum(grepl("lat", surowe$wiek_odp)),
    "| braki:", sum(is.na(wiek_c)), "\n")
cat("Staż w miesiącach (słownie):", sum(mies), "| z przecinkiem:", sum(grepl(",", surowe$staz_odp)), "\n")
cat("Niespójne (staż > wiek − 18):\n")
print(data.frame(id = niespojne, wiek = wiek_c[niespojne], staz_wpisany = surowe$staz_odp[niespojne]), row.names = FALSE)
staz_c[niespojne] <- NA                                  # do wyjaśnienia; w analizie jako brak
cat("Wiek z roku urodzenia minus prawdziwy wiek (lata):\n"); print(table(wiek_c[z_roku] - wiek[z_roku]))

# ---- 4. Przedziały nachodzące na siebie ----
granice <- c(30, 40, 50, 60)
cat("\nPRZEDZIAŁY „20–30, 30–40, 40–50, 50–60, 60+”\n")
cat("Osób w wieku równym granicy (30, 40, 50, 60):", sum(wiek_c %in% granice), "z", sum(!is.na(wiek_c)),
    sprintf("(%.1f%%)\n", 100 * mean(wiek_c[!is.na(wiek_c)] %in% granice)))

# ---- 5. Staż w przedziałach zamiast w latach: co tracisz ----
przedz <- cut(staz_c, c(-Inf, 5, 10, 20, 30, Inf), right = FALSE,
              labels = c("poniżej 5", "5–9", "10–19", "20–29", "30 i więcej"))
srodki <- c(2.5, 7.5, 15, 25, 35)                         # dla otwartej kategorii: założenie 35
cat("\nSTAŻ: LICZBA LAT A PRZEDZIAŁY\n")
print(table(przedz, useNA = "ifany"))
ok <- !is.na(staz_c)
cat(sprintf("Średnia z liczby lat: %.2f | ze środków przedziałów: %.2f | gdy 'otwarty' = 40: %.2f\n",
            mean(staz_c[ok]), mean(srodki[przedz[ok]]), mean(c(srodki[1:4], 40)[przedz[ok]])))
cat(sprintf("Mediana z liczby lat: %.1f | przedział z medianą: %s\n", median(staz_c[ok]),
            levels(przedz)[median(as.integer(przedz[ok]))]))
r_lata <- cor.test(staz_c, wyczerpanie)
r_przedz <- cor.test(as.integer(przedz), wyczerpanie)
r_mediana <- cor.test(as.integer(staz_c > median(staz_c, na.rm = TRUE)), wyczerpanie)
bz <- function(x) sub("^(-?)0\\.", "\\1.", sprintf("%.3f", x))      # zapis APA bez zera
f <- function(t) paste0("r = ", bz(t$estimate), ", 95% CI [", bz(t$conf.int[1]), ", ", bz(t$conf.int[2]), "], p = ", bz(t$p.value))
cat("Wyczerpanie a staż – liczba lat:  ", f(r_lata), "\n")
cat("Wyczerpanie a staż – 5 przedziałów:", f(r_przedz), "\n")
cat("Wyczerpanie a staż – podział medianą:", f(r_mediana), "\n")

# ---- 6. Moc w powtórzeniach: liczba lat, 5 przedziałów, podział medianą ----
moc <- function(n, R = 2000) {
  wynik <- replicate(R, {
    w <- pmin(pmax(round(rnorm(n, 44, 10)), 22), 64)
    s <- pmin(pmax(w - 21 - rpois(n, 1.5) - ifelse(runif(n) < .15, sample(3:12, n, TRUE), 0), 0) + runif(n), w - 20)
    y <- 22 + 0.25 * s + rnorm(n, 0, 8)
    pr <- cut(s, c(-Inf, 5, 10, 20, 30, Inf), right = FALSE)
    c(cor.test(s, y)$p.value, cor.test(as.integer(pr), y)$p.value, cor.test(as.integer(s > median(s)), y)$p.value) < .05
  })
  rowMeans(wynik)
}
set.seed(4321)
tab_moc <- t(sapply(c(60, 100, 150, 200), moc))
dimnames(tab_moc) <- list(paste0("n = ", c(60, 100, 150, 200)), c("lata", "5_przedzialow", "mediana"))
cat("\nMOC (alfa = .05, 2000 prób na wiersz)\n"); print(round(tab_moc, 3))

# ---- 7. Grupy do opisu: kwartyle próby a progi merytoryczne ----
kw <- quantile(staz_c, c(.25, .5, .75), na.rm = TRUE)
gr_kw <- cut(staz_c, c(-Inf, kw, Inf), labels = c("Q1", "Q2", "Q3", "Q4"))
gr_mer <- cut(staz_c, c(-Inf, 5, 15, 25, Inf), right = FALSE,
              labels = c("poniżej 5 lat", "5–14 lat", "15–24 lata", "25 lat i więcej"))
cat("\nGRUPY STAŻU\nGranice kwartyli:", round(kw, 1), "\n")
opis <- function(g) data.frame(n = as.vector(table(g)), M_wyczerpanie = round(as.vector(tapply(wyczerpanie, g, mean)), 2),
                                min = round(as.vector(tapply(staz_c, g, min)), 1), max = round(as.vector(tapply(staz_c, g, max)), 1),
                                row.names = levels(g))
print(opis(gr_kw)); print(opis(gr_mer))

# ---- 8. Wykształcenie: łączenie rzadkich kategorii ----
poziomy <- c("Średnie medyczne", "Licencjat pielęgniarstwa", "Magister pielęgniarstwa", "Magister innego kierunku", "Doktor")
wyk_f <- factor(surowe$wyksztalcenie, poziomy)
wyk3 <- factor(ifelse(wyk_f %in% poziomy[3:5], "Magister lub wyższe", as.character(wyk_f)),
               c("Średnie medyczne", "Licencjat pielęgniarstwa", "Magister lub wyższe"))
cat("\nWYKSZTAŁCENIE\n"); print(table(wyk_f)); print(table(wyk3))
cat("Mediana wieku w grupach wykształcenia:\n")
print(round(tapply(wiek_c, wyk3, median, na.rm = TRUE), 1))

# ---- 9. Liczby do Tabeli 1 ----
pr <- function(x) { t <- table(x); paste0(names(t), ": ", t, " (", sprintf("%.1f", 100 * t / sum(t)), "%)") }
miejsce3 <- factor(ifelse(surowe$miejsce == "Wieś", "Wieś",
                    ifelse(surowe$miejsce %in% c("Miasto do 20 tys.", "Miasto 20–100 tys."), "Miasto do 100 tys.", "Miasto pow. 100 tys.")),
                   c("Wieś", "Miasto do 100 tys.", "Miasto pow. 100 tys."))
cat("\nTABELA 1\n")
cat(sprintf("Wiek: n = %d, M = %.1f, SD = %.1f, Me = %.0f, IQR %.0f–%.0f, zakres %d–%d, braki = %d\n",
            sum(!is.na(wiek_c)), mean(wiek_c, na.rm = TRUE), sd(wiek_c, na.rm = TRUE), median(wiek_c, na.rm = TRUE),
            quantile(wiek_c, .25, na.rm = TRUE), quantile(wiek_c, .75, na.rm = TRUE),
            min(wiek_c, na.rm = TRUE), max(wiek_c, na.rm = TRUE), sum(is.na(wiek_c))))
cat(sprintf("Staż: n = %d, M = %.1f, SD = %.1f, Me = %.1f, IQR %.1f–%.1f, zakres %.1f–%.1f, braki = %d\n",
            sum(ok), mean(staz_c[ok]), sd(staz_c[ok]), median(staz_c[ok]), quantile(staz_c[ok], .25),
            quantile(staz_c[ok], .75), min(staz_c[ok]), max(staz_c[ok]), sum(!ok)))
cat("Wykształcenie:", pr(wyk3), sep = "\n  "); cat("Miejsce:", pr(miejsce3), sep = "\n  ")
cat("Korelacja wiek–staż: r =", sub("^0", "", sprintf("%.2f", cor(wiek_c, staz_c, use = "complete.obs"))), "\n")
Wynik w R
SUROWE ODPOWIEDZI – przykłady
 id wiek_odp    staz_odp
  3   50 lat          25
  7     1988          12
 90       30 11 miesięcy
 16       28         6,7
 34       29          44

CZYSZCZENIE
Wiek podany jako rok urodzenia: 6 | z dopiskiem 'lat': 14 | braki: 2
Staż w miesiącach (słownie): 1 | z przecinkiem: 4
Niespójne (staż > wiek − 18):
 id wiek staz_wpisany
 34   29           44
 79   29           43
Wiek z roku urodzenia minus prawdziwy wiek (lata):

0 1
1 5

PRZEDZIAŁY „20–30, 30–40, 40–50, 50–60, 60+”
Osób w wieku równym granicy (30, 40, 50, 60): 31 z 258 (12.0%)

STAŻ: LICZBA LAT A PRZEDZIAŁY
przedz
  poniżej 5         5–9       10–19       20–29 30 i więcej        <NA>
          4          27          85          93          49           2
Średnia z liczby lat: 20.74 | ze środków przedziałów: 21.42 | gdy 'otwarty' = 40: 22.37
Mediana z liczby lat: 21.0 | przedział z medianą: 20–29
Wyczerpanie a staż – liczba lat:   r = .175, 95% CI [.055, .291], p = .005
Wyczerpanie a staż – 5 przedziałów: r = .180, 95% CI [.059, .296], p = .004
Wyczerpanie a staż – podział medianą: r = .156, 95% CI [.035, .273], p = .012

MOC (alfa = .05, 2000 prób na wiersz)
         lata 5_przedzialow mediana
n = 60  0.651         0.602   0.481
n = 100 0.873         0.834   0.702
n = 150 0.964         0.947   0.870
n = 200 0.995         0.987   0.940

GRUPY STAŻU
Granice kwartyli: 13 21 27
    n M_wyczerpanie  min max
Q1 69         24.67  0.9  13
Q2 64         26.75 14.0  21
Q3 64         28.45 22.0  27
Q4 61         27.62 28.0  42
                 n M_wyczerpanie  min max
poniżej 5 lat    4         22.75  0.9   4
5–14 lat        70         24.64  5.0  14
15–24 lata      94         27.31 15.0  24
25 lat i więcej 90         28.19 25.0  42

WYKSZTAŁCENIE
wyk_f
        Średnie medyczne Licencjat pielęgniarstwa  Magister pielęgniarstwa
                      79                       80                       82
Magister innego kierunku                   Doktor
                      15                        4
wyk3
        Średnie medyczne Licencjat pielęgniarstwa      Magister lub wyższe
                      79                       80                      101
Mediana wieku w grupach wykształcenia:
        Średnie medyczne Licencjat pielęgniarstwa      Magister lub wyższe
                      49                       40                       43

TABELA 1
Wiek: n = 258, M = 44.1, SD = 8.9, Me = 44, IQR 37–50, zakres 24–64, braki = 2
Staż: n = 258, M = 20.7, SD = 9.1, Me = 21.0, IQR 13.0–27.0, zakres 0.9–42.0, braki = 2
Wykształcenie:
  Średnie medyczne: 79 (30.4%)
  Licencjat pielęgniarstwa: 80 (30.8%)
  Magister lub wyższe: 101 (38.8%)
Miejsce:
  Wieś: 57 (21.9%)
  Miasto do 100 tys.: 82 (31.5%)
  Miasto pow. 100 tys.: 121 (46.5%)
Korelacja wiek–staż: r = .95
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim wyślesz ankietę i zanim policzysz metryczkę, sprawdź…
- Czy wiek i staż zbierasz jako liczbę lat, z walidacją zakresu w formularzu?
- Czy pytanie o staż mówi, o jaki staż chodzi i co wpisać przy stażu krótszym niż rok?
- Jeśli używasz przedziałów: czy są rozłączne i wyczerpujące?
- Czy kafeteria wykształcenia pasuje do populacji, a kwalifikacje zawodowe są w osobnym pytaniu?
- Czy masz regułę spójności wieku i stażu i zapisany sposób postępowania z wartościami niespójnymi?
- Czy progi grup do opisu i reguły łączenia kategorii ustaliłeś(-aś) przed analizą?
- Czy w analizach wiek i staż są liczbami, a wykształcenie – zmiennymi zero-jedynkowymi?
- Czy tabela charakterystyki próby podaje braki i mianownik odsetków?
Jeśli piszesz pracę z pielęgniarstwa, zobacz też przegląd analiz we wpisie statystyka w pracy z pielęgniarstwa.
Najczęstsze pytania
Jak zapytać o staż pracy w ankiecie?
Napisz, o jaki staż chodzi (w zawodzie, w obecnej placówce, na oddziale), i poproś o liczbę pełnych lat, z instrukcją dla stażu krótszego niż rok, np. „wpisz 0”. Ustaw w formularzu walidację liczby i zakres. Jeśli potrzebujesz dwóch rodzajów stażu, zadaj dwa osobne pytania.
Jak policzyć wiek, gdy respondent wpisał rok urodzenia?
Odejmij rok urodzenia od roku badania. Taki wynik może być o rok za wysoki, bo nie wiesz, czy osoba miała już urodziny – w przykładzie dotyczyło to 5 z 6 osób. Do opisu próby to wystarczy; jeśli wiek jest kryterium włączenia, pytaj o ukończone lata.
Czy wykształcenie można wpisać do regresji jako liczbę 1–3?
Lepiej nie. Kody 1–3 zakładają równe odległości między poziomami wykształcenia, a to zmienna porządkowa. Utwórz zmienne zero-jedynkowe z kategorią odniesienia (np. wykształcenie średnie) i interpretuj każdy współczynnik jako różnicę względem niej.
Na jakie grupy podzielić staż pracy w opisie próby?
Najlepiej według progów ustalonych przed analizą – z literatury, raportów, z którymi porównujesz próbę, albo etapów kariery, np. poniżej 5, 5–14, 15–24, 25 i więcej lat. Kwartyle próby dają równe grupy, ale ich granice zależą od konkretnej próby. Bardzo małe grupy połącz z sąsiednimi.
Czy w regresji uwzględnić jednocześnie wiek i staż pracy?
Tylko jeśli oba są potrzebne do odpowiedzi na pytanie badawcze. Wiek i staż są zwykle bardzo silnie skorelowane (w przykładzie r = .95), więc ich osobne współczynniki mają szerokie przedziały ufności. Jako zmienne kontrolne mogą zostać razem; jeśli pytasz o doświadczenie zawodowe, interpretuj staż, a nie oba naraz.
Powiązane hasła
Przeczytaj też
Błąd w ankiecie po zebraniu danych
Dwanaście usterek formularza: jak je wykryć, co zrobić i co napisać w pracy, z symulowaną ankietą w R i gotowymi zdaniami.
Czytaj →PoradnikTabela 1 – charakterystyka próby
M (SD) czy mediana z kwartylami, n (%), braki w osobnych wierszach, kolumny grup i wartości p w RCT – ze wzorem APA do skopiowania i kodem gtsummary w R.
Czytaj →PoradnikŁączenie kategorii odpowiedzi – kiedy i jak
Likert 5 na 3, „nie wiem”, małe kategorie metryczki, łączenie pod wynik w symulacji i alternatywy: test Fishera, trend, regresja porządkowa – z kodem R.
Czytaj →PoradnikJak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikAnaliza ankiety z Google Forms krok po kroku
Od surowego CSV do zdań APA: słownik zmiennych, kontrola jakości, przekodowanie pytań, tabela próby i trzy hipotezy w R.
Czytaj →Masz metryczkę z przedziałami, wpisami tekstowymi i nie wiesz, jak ją zakodować?
Sprawdzimy kodowanie wieku, stażu i wykształcenia, przygotujemy tabelę charakterystyki próby w R lub SPSS i wyjaśnimy decyzje tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Royston, P. (2006). The cost of dichotomising continuous variables. BMJ, 332(7549), 1080. https://doi.org/10.1136/bmj.332.7549.1080 ● Otwarty dostęp
- Bennette, C., & Vickers, A. (2012). Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents. BMC Medical Research Methodology, 12(1), Article 21. https://doi.org/10.1186/1471-2288-12-21 ● Otwarty dostęp
- Heitjan, D. F., & Rubin, D. B. (1991). Ignorability and coarse data. The Annals of Statistics, 19(4), 2244–2253. https://doi.org/10.1214/aos/1176348396 ● Otwarty dostęp
- Hughes, J. L., Camden, A. A., Yangchen, T., Smith, G. P. A., Domenech Rodríguez, M. M., Rouse, S. V., McDonald, C. P., & Lopez, S. (2022). Guidance for researchers when using inclusive demographic questions for surveys: Improved and updated questions. Psi Chi Journal of Psychological Research, 27(4), 232–255. https://doi.org/10.24839/2325-7342.JN27.4.232 ● Otwarty dostęp
- Huttenlocher, J., Hedges, L. V., & Bradburn, N. M. (1990). Reports of elapsed time: Bounding and rounding processes in estimation. Journal of Experimental Psychology: Learning, Memory, and Cognition, 16(2), 196–213. https://doi.org/10.1037/0278-7393.16.2.196
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- Vanhove, J. (2021). Collinearity isn’t a disease that needs curing. Meta-Psychology, 5. https://doi.org/10.15626/mp.2021.2548 ● Otwarty dostęp
Cytowania BibTeX
@article{altman2006cost, author={Altman, Douglas G. and Royston, Patrick}, title={{The cost of dichotomising continuous variables}}, journal={BMJ}, year={2006}, volume={332}, number={7549}, pages={1080}, doi={10.1136/bmj.332.7549.1080}}@article{bennette2012against, author={Bennette, Caroline and Vickers, Andrew}, title={{Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={21}, doi={10.1186/1471-2288-12-21}}@article{heitjan1991ignorability, author={Heitjan, Daniel F. and Rubin, Donald B.}, title={{Ignorability and coarse data}}, journal={The Annals of Statistics}, year={1991}, volume={19}, number={4}, pages={2244--2253}, doi={10.1214/aos/1176348396}}@article{hughes2022guidance, author={Hughes, Jennifer L. and Camden, Abigail A. and Yangchen, Tenzin and Smith, Gabrielle P. A. and Domenech Rodríguez, Melanie M. and Rouse, Steven V. and McDonald, C. Peeper and Lopez, Stella}, title={{Guidance for researchers when using inclusive demographic questions for surveys: Improved and updated questions}}, journal={Psi Chi Journal of Psychological Research}, year={2022}, volume={27}, number={4}, pages={232--255}, doi={10.24839/2325-7342.jn27.4.232}}@article{huttenlocher1990reports, author={Huttenlocher, Janellen and Hedges, Larry V. and Bradburn, Norman M.}, title={{Reports of elapsed time: Bounding and rounding processes in estimation}}, journal={Journal of Experimental Psychology: Learning, Memory, and Cognition}, year={1990}, volume={16}, number={2}, pages={196--213}, doi={10.1037/0278-7393.16.2.196}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{vanhove2021collinearity, author={Vanhove, Jan}, title={{Collinearity isn’t a disease that needs curing}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2021.2548}}