Po co w ogóle łączyć kategorie
Ankieta z Google Forms rzadko daje „ładne” tabele. W pytaniu o wykształcenie jedna kategoria ma cztery osoby, w skali Likerta skrajne odpowiedzi wybrało po kilka osób, a obok jest jeszcze „nie wiem”. Kusi wtedy, żeby coś połączyć. Czasem to rozsądny krok, a czasem sposób na zmianę wyniku bez zmiany danych. Ten wpis pokazuje, jak odróżnić jedno od drugiego. Jest częścią serii o analizie własnej ankiety – wpis główny opisuje, jak opisać wyniki ankiety z wieloma pytaniami bez setki testów.
Przykład przewodni (dane symulowane). Studentka zdrowia publicznego zbadała 180 dorosłych: 80 mieszkańców wsi i 100 mieszkańców miasta. Interesują ją trzy pytania: zaufanie do informacji o szczepieniach od lekarza rodzinnego (skala 1–5 i „nie wiem”), zamiar szczepienia przeciw grypie (tak / nie / nie wiem) oraz wykształcenie z metryczki. Hipoteza: mieszkańcy miasta bardziej ufają informacjom od lekarza rodzinnego.
Łączenie kategorii, czyli rekodowanie kilku kodów w jeden, ma trzy uczciwe powody:
- kategoria jest za mała, żeby cokolwiek o niej powiedzieć – odsetek liczony z trzech osób zmienia się o 33 punkty procentowe, gdy jedna z nich odpowie inaczej;
- test, który zaplanowałeś(-aś), ma wymagania – np. test chi-kwadrat działa źle przy małych liczebnościach oczekiwanych;
- pytanie badawcze jest grubsze niż skala – np. interesuje Cię odsetek osób, które się zgadzają, a nie różnica między „raczej” i „zdecydowanie”.
Czwarty powód – „po połączeniu wyszło istotnie” – nie jest powodem. Dalej zobaczysz w symulacji, dlaczego.
Kiedy łączenie ma sens, a kiedy nie
Zanim połączysz cokolwiek, zadaj sobie pytanie, co dzięki temu zyskasz. Poniższa tabela zbiera typowe sytuacje z prac dyplomowych.
| Sytuacja | Czy łączyć? | Co zrobić |
|---|---|---|
| Kategoria metryczki z 1–5 osobami (np. wykształcenie podstawowe) | Zwykle tak | Połącz z sąsiednią, podobną treściowo kategorią; w tabeli charakterystyki próby możesz pokazać też rozkład pierwotny |
| Tabela krzyżowa łamie regułę liczebności oczekiwanych | Tylko gdy połączenie ma sens merytoryczny | Najpierw rozważ test dokładny; reguła łączenia zapisana w planie analizy |
| Skala Likerta 1–5, porównanie grup | Raczej nie do testu | Test dla danych porządkowych na pełnej skali; połączenie 5 → 3 do opisu i wykresu |
| Pytanie badawcze dotyczy odsetka zgadzających się | Tak | Zdefiniuj z góry, że „zgadza się” = 4 lub 5, i trzymaj się tego w całej pracy |
| „Nie wiem” obok „tak” i „nie” | Nie z „nie” | Osobna kategoria albo brak odpowiedzi merytorycznej – zależnie od pytania |
| Wynik nieistotny, „może po połączeniu wyjdzie” | Nie | Raportuj zaplanowaną analizę; inne łączenia najwyżej jako jawnie opisaną analizę wrażliwości |
Kwestię liczebności oczekiwanych omawia szczegółowo wpis chi-kwadrat czy test Fishera, więc tu tylko skrót. Popularna reguła mówi, że najwyżej 20% komórek tabeli może mieć liczebność oczekiwaną poniżej 5 i żadna nie może mieć poniżej 1 (Kim, 2017). Liczy się liczebność oczekiwana, a nie obserwowana. W przykładzie, po odłożeniu na bok odpowiedzi „nie wiem”, tabela miejsce zamieszkania × zaufanie (2 × 5) ma tylko jedną komórkę z liczebnością oczekiwaną poniżej 5 (3.95, czyli 10% komórek). Reguła jest spełniona, więc test nie wymaga tu żadnego łączenia. Mimo to zwykły chi-kwadrat nie jest najlepszym wyborem – o tym za chwilę.
Jak łączyć: cztery zasady
- Łącz według treści, nie według liczebności czy wyniku. Łączysz kategorie, które znaczą coś podobnego: „raczej się zgadzam” z „zdecydowanie się zgadzam”, wykształcenie podstawowe z zasadniczym zawodowym. Nie łączysz „wsi” z „miastem powyżej 500 tys.” tylko dlatego, że obie są małe.
- W skalach porządkowych łącz tylko sąsiednie kategorie. Połączenie 1 z 5 (bo obie są rzadkie) niszczy porządek. Środek skali zostaw osobno albo opisz, dlaczego przypisujesz go do którejś strony – „ani tak, ani nie” to nie „nie”.
- Regułę zapisz przed analizą. Najlepiej w planie analizy statystycznej i w książce kodowej: „pytania 5–12 w opisie przedstawiamy w trzech kategoriach: 1–2, 3, 4–5”. Wtedy łączenie jest decyzją projektową, a nie reakcją na wynik.
- Pokaż rozkład pierwotny. W tabeli opisowej albo w aneksie podaj wszystkie kategorie, a w tekście napisz, co połączono i dlaczego. Czytelnik może wtedy sprawdzić, czy połączenie nie ukrywa czegoś ważnego.
Zasady te są proste, ale ich złamanie ma realne skutki. Strömberg (1996) przypomina, że w konkretnym zbiorze danych zmiana kategorii wyniku porządkowego może zmienić oszacowanie efektu i wnioski, choć prawdziwy efekt jest ten sam, i zaleca szczególną ostrożność przy dychotomizacji. Ten sam problem przy zmiennych ilościowych opisuje wpis o dychotomizacji zmiennych ciągłych.
Skala Likerta: z pięciu kategorii na trzy
Najczęstsze łączenie w pracach dyplomowych to zamiana pięciostopniowej skali Likerta na trzy kategorie: nie zgadza się (1–2), ani tak, ani nie (3) i zgadza się (4–5). Do opisu i wykresu to często dobry pomysł – tabela z trzema kolumnami jest czytelniejsza niż z pięcioma, a różnica „raczej” – „zdecydowanie” bywa dla pytania badawczego drugorzędna. Inne sposoby pokazania odpowiedzi Likerta zebrano we wpisie odpowiedzi Likerta w raporcie.
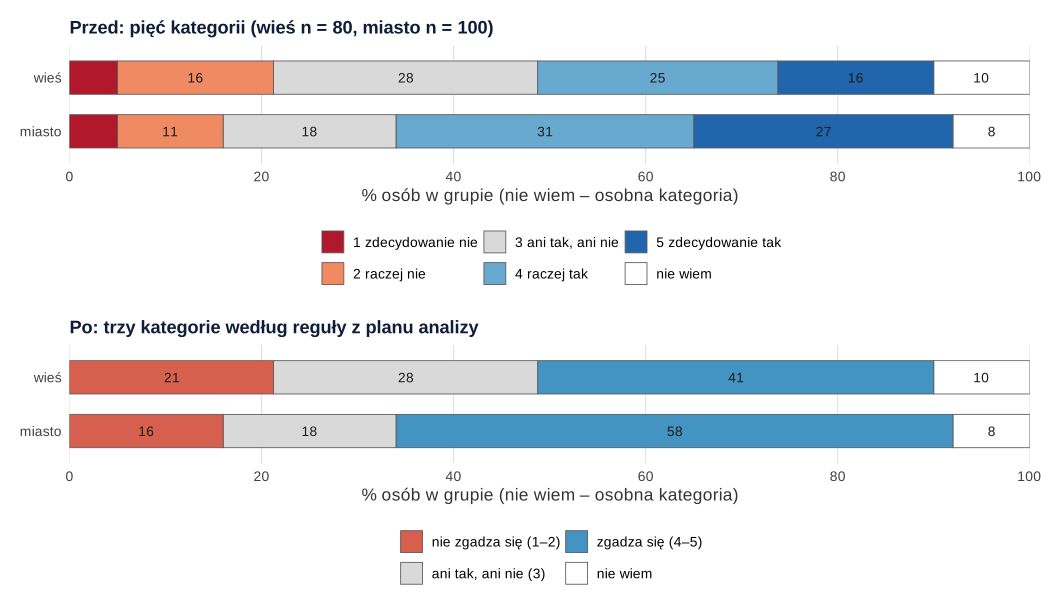
Wśród osób, które wybrały odpowiedź na skali (72 na wsi i 92 w mieście), zgadzało się 45.8% mieszkańców wsi i 63.0% mieszkańców miasta. Tabela 2 × 3 ma najmniejszą liczebność oczekiwaną 14.49, a test chi-kwadrat daje χ²(2, N = 164) = 4.93, p = .085, V Craméra = .17.
Tyle że to nie jest najlepszy test dla tej hipotezy. Hipoteza ma kierunek („w mieście więcej zaufania”), a kategorie mają porządek. Ani chi-kwadrat 2 × 5, ani 2 × 3 tego porządku nie widzi: przestawienie kolumn nie zmienia wyniku. Cochran (1954) zwracał uwagę, że zwykłe testy chi-kwadrat nie są skierowane przeciw żadnej konkretnej alternatywie, przez co bywają mało czułe, a test dobrany do przewidywanego wzoru odchyleń jest mocniejszy. Tu takim testem jest test dla danych porządkowych na pełnej skali (sekcja Zamiast łączenia). Jakobsson (2004) w przeglądzie artykułów z czasopism pielęgniarskich stwierdził, że tylko około połowy analiz danych porządkowych przeprowadzono poprawnie, a błędna analiza może zmniejszać zdolność wykrywania różnic.
Wniosek praktyczny: połączenie 5 → 3 stosuj do opisu, a hipotezę testuj na pełnej skali. Jeśli pytanie badawcze naprawdę dotyczy odsetka zgadzających się (np. „czy co najmniej połowa respondentów ufa…”), dychotomia 4–5 vs 1–3 jest w porządku – pod warunkiem, że ustalisz ją przed analizą.
„Nie wiem” to nie „nie”
Odpowiedź „nie wiem” nie jest punktem skali. Hasło słownika opisuje, dlaczego nie należy jej kodować jako środka skali Likerta. Równie częsty błąd w pytaniach typu tak/nie to doliczanie „nie wiem” do „nie”. Zobacz, co się dzieje w przykładzie z zamiarem szczepienia przeciw grypie.
Tabela 1
Zamiar szczepienia przeciw grypie w tym sezonie według miejsca zamieszkania
| Odpowiedź | Wieś (n = 80) n (%) | Miasto (n = 100) n (%) |
|---|---|---|
| Tak | 18 (22.5) | 30 (30.0) |
| Nie | 30 (37.5) | 48 (48.0) |
| Nie wiem | 32 (40.0) | 22 (22.0) |
Uwaga. Odsetki liczone od wszystkich osób w grupie. Test chi-kwadrat dla trzech kategorii: χ²(2, N = 180) = 6.87, p = .032. Dane symulowane.
Te same dane można opisać na trzy sposoby i każdy mówi coś innego:
- Trzy kategorie: grupy się różnią, χ²(2) = 6.87, p = .032. Różnica dotyczy przede wszystkim niezdecydowania – „nie wiem” wybrało 40.0% mieszkańców wsi i 22.0% mieszkańców miasta.
- „Nie wiem” doliczone do „nie”: „nie” deklaruje rzekomo 77.5% mieszkańców wsi i 70.0% mieszkańców miasta, χ²(1) = 1.28, p = .258. Różnica znika, a do tego połowa z tych „przeciwników” szczepienia to osoby niezdecydowane.
- Tylko osoby zdecydowane: „tak” odpowiedziało 37.5% zdecydowanych na wsi i 38.5% w mieście, χ²(1) = 0.01, p = .914.
Uczciwa interpretacja: wśród zdecydowanych proporcje są takie same, a mieszkańcy wsi częściej jeszcze nie wiedzą. Dla promocji zdrowia to inny wniosek niż „na wsi więcej osób nie chce się szczepić”. Porównanie „tak” z „nie lub nie wiem” jest dopuszczalne, jeśli pytanie badawcze brzmi „jaki odsetek zamierza się zaszczepić” – ale wtedy nazwij kategorię uczciwie: „nie lub nie wiem”, a nie „nie”. Gdzie ustawić „nie wiem” w mianowniku i jak oznaczyć to w tabeli, opisuje wpis o pytaniach filtrujących i mianowniku.
Kategoria z kilkoma osobami
W metryczce przykładu wykształcenie podstawowe zadeklarowały 4 osoby (1 na wsi i 3 w mieście). Porównywanie tej kategorii z innymi nie ma sensu: przedział ufności dla odsetka z czterech osób jest tak szeroki, że obejmuje niemal wszystko, a jedna osoba więcej lub mniej zmienia wynik o 25 punktów procentowych. Po połączeniu z wykształceniem zasadniczym zawodowym powstaje kategoria „podstawowe lub zasadnicze zawodowe” z 21 osobami (10 na wsi i 11 w mieście), obok 59 osób z wykształceniem średnim i 100 z wyższym.
Takie połączenie jest uzasadnione merytorycznie (sąsiednie poziomy wykształcenia) i ma jeszcze jedną zaletę. W małych badaniach, np. w jednej szkole czy na jednym oddziale, kategoria z jedną lub dwiema osobami może pozwolić rozpoznać respondenta. Dlatego w tabelach zwykle nie pokazuje się bardzo małych komórek (zob. anonimizacja i pseudonimizacja danych oraz wpis o badaniu ankietowym personelu jednego szpitala). Jak od razu zaprojektować pytania o wiek, staż i wykształcenie, żeby potem łatwo je pogrupować, wyjaśnia wpis o kodowaniu metryczki. Jak opisać połączone kategorie w tabeli próby, pokazuje wpis jak opisać charakterystykę próby.
Uwaga: małą kategorię łączysz, a nie usuwasz. Osoby z wykształceniem podstawowym zostają w próbie i w pozostałych analizach.
Łączenie pod wynik: symulacja
Wróćmy do pytania o zaufanie. To samo pytanie można połączyć na wiele sposobów i każdy da inne p dla porównania wsi i miasta:
| Sposób analizy | Test | p |
|---|---|---|
| Pięć kategorii (2 × 5) | chi-kwadrat | .232 |
| Pięć kategorii (2 × 5) | Fishera–Freemana–Haltona | .226 |
| 1–2 vs 3–5 | chi-kwadrat 2 × 2 | .324 |
| 5 vs 1–4 | chi-kwadrat 2 × 2 | .095 |
| 1–2 | 3 | 4–5 | chi-kwadrat 2 × 3 | .085 |
| 4–5 vs 1–3 | chi-kwadrat 2 × 2 | .028 |
Jeśli spróbujesz kilku łączeń i opiszesz to, które „wyszło”, popełniasz p-hacking, nawet jeśli każdy pojedynczy test jest policzony poprawnie. Simmons, Nelson i Simonsohn (2011) pokazali, że niezgłoszona elastyczność w analizie danych radykalnie zwiększa odsetek wyników fałszywie pozytywnych. Wybór sposobu łączenia to jedna z rozwidlających się ścieżek analizy (zob. ogród rozwidlających się ścieżek).
Ile to kosztuje, sprawdziliśmy w symulacji. Wygenerowaliśmy 5000 badań, w których dwie grupy po 50 osób odpowiadają na pytanie 1–5 z dokładnie tym samym rozkładem. Każdy wynik istotny jest więc fałszywym alarmem. Każde badanie przeanalizowaliśmy pięcioma sposobami łączenia z tabeli wyżej (bez wersji z testem Fishera) oraz testem Manna–Whitneya i testem trendu liniowego.
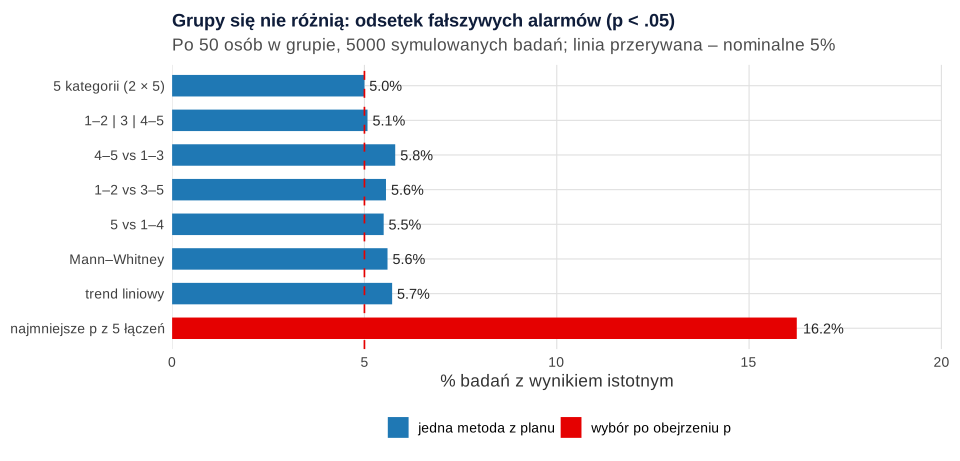
Każdy sposób analizy stosowany samodzielnie dawał od 5.0% do 5.8% fałszywych alarmów – blisko nominalnych 5% (błąd Monte Carlo wynosi tu około ±0.6 punktu procentowego). Gdy jednak badacz wybierał najmniejsze p z pięciu łączeń, odsetek fałszywych alarmów wzrósł do 16.2%, czyli ponad trzykrotnie. Wzrost nie jest pięciokrotny, bo różne łączenia tych samych danych dają podobne wyniki – ale i tak co szóste badanie bez żadnego efektu kończyłoby się „istotną różnicą”. W 138 z 5000 badań istotne były co najmniej trzy sposoby łączenia naraz, więc „sprawdziłem kilka wersji i wszystkie wyszły” też nie jest dowodem.
Lekarstwo jest jedno: regułę łączenia i test wybierz przed obejrzeniem wyników. Jeśli później chcesz pokazać inne łączenia, opisz je jako analizę wrażliwości – wszystkie, które sprawdziłeś(-aś), a nie tylko tę, która „wyszła”.
Ile kosztuje łączenie: moc testu
Łączenie ma też koszt, gdy efekt jest prawdziwy. W drugiej części symulacji mieszkańcy jednej grupy odpowiadali wyżej na skali (iloraz szans 1.8 w modelu proporcjonalnych szans). Dla liczebności od 30 do 150 osób w grupie policzyliśmy w 2000 powtórzeniach, jak często każda metoda wykrywa różnicę, czyli moc testu.
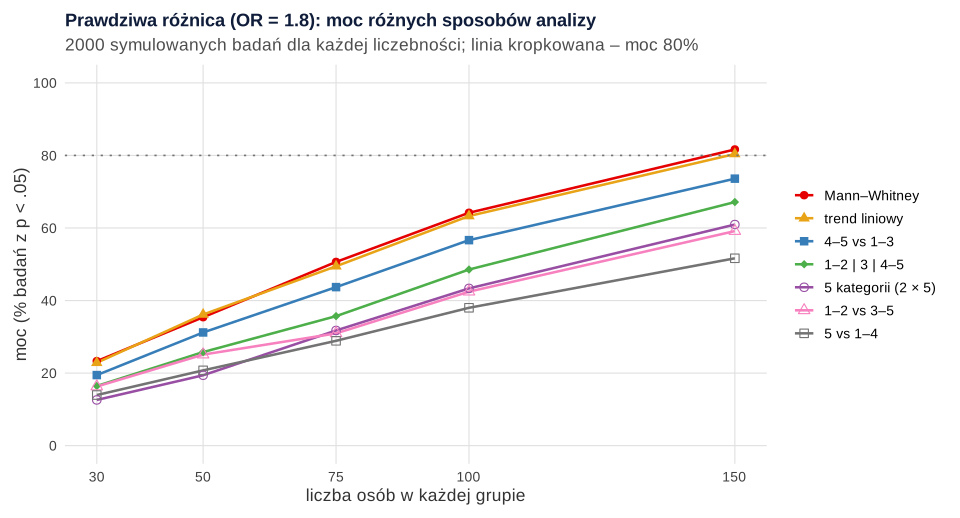
Przy 100 osobach w grupie test Manna–Whitneya na pełnej skali wykrywał różnicę w 64.2% badań, a test trendu w 63.3%. Po połączeniu w trzy kategorie moc spadła do 48.5%, a przy dychotomii „5 vs 1–4” do 38.0%. Żeby osiągnąć moc 80%, testom porządkowym wystarczyło około 150 osób w grupie (81.7% i 80.4%); żaden test po łączeniu nie osiągnął jej przy tej liczebności. Whitehead (1993) analizował, jak liczba i szerokość kategorii wpływają na efektywność porównania danych porządkowych, i warto to brać pod uwagę już przy planowaniu liczebności próby.
Zwróć uwagę na dwie rzeczy. Po pierwsze, zwykły chi-kwadrat na pięciu kategoriach miał moc niższą niż po połączeniu w trzy (43.4% wobec 48.5%), bo rozkłada informację na cztery stopnie swobody i nie korzysta z porządku. Po drugie, to, która dychotomia jest najlepsza, zależy od tego, gdzie na skali leży różnica – a tego przed badaniem nie wiesz. Test na pełnej skali nie wymaga zgadywania. Manor, Matthews i Power (2000) porównali dla samooceny zdrowia dychotomię z modelami dla kategorii uporządkowanych i otrzymali podobne wnioski – dychotomia nie zawsze zmienia wynik, ale trzeba ją uzasadnić, a nie przyjmować z przyzwyczajenia.
Zamiast łączenia: testy dokładne i porządkowe
Zanim połączysz kategorie, sprawdź, czy inny test nie rozwiązuje problemu bez utraty informacji:
- Test dokładny – test Fishera dla tabel 2 × 2 i test Fishera–Freemana–Haltona dla większych tabel nie wymagają reguły liczebności oczekiwanych. Pasują do zmiennych nominalnych (np. kierunek studiów × odpowiedź).
- Test trendu – test Cochrana–Armitage’a (w SPSS jako Linear-by-Linear Association) sprawdza, czy odsetek w grupie rośnie lub maleje wzdłuż uporządkowanych kategorii. Zhou i in. (2017) pokazali, że wykrywa on przesunięcie położenia między grupami, a chi-kwadrat Pearsona – przesunięcie położenia i rozproszenia; test trendu przegrywa więc wtedy, gdy różnica nie układa się wzdłuż skali.
- Test Manna–Whitneya – dla dwóch grup i odpowiedzi porządkowej. Whitehead (1993) wskazuje, że przy założeniu proporcjonalnych szans jest on równoważny porównaniu w regresji logistycznej dla danych porządkowych.
- Regresja porządkowa – model proporcjonalnych szans (McCullagh, 1980) wykorzystuje porządek kategorii bez nadawania im wartości liczbowych, daje iloraz szans z przedziałem ufności i pozwala dodać zmienne kontrolne. Krok po kroku opisuje ją wpis regresja porządkowa; sprawdź też założenie proporcjonalnych szans.
W przykładzie testy porządkowe na pełnej skali (bez „nie wiem”) dały: test Manna–Whitneya W = 2707.0, p = .039; regresja porządkowa OR = 1.80, 95% CI [1.04, 3.16], χ²LR(1) = 4.34, p = .037; test trendu Cochrana–Armitage’a Z = −1.90, p = .057. Trzy testy porządkowe nie dały identycznych p, a jeden z nich znalazł się po drugiej stronie progu .05. To kolejny powód, żeby test wskazać w planie analizy: w tym przykładzie jest nim regresja porządkowa, bo daje wielkość efektu z przedziałem ufności. Wynik należy opisać ostrożnie – różnica jest umiarkowana, a dolna granica przedziału leży blisko 1.
Jak opisać łączenie kategorii w pracy
W rozdziale o metodzie napisz, które kategorie połączono, według jakiej reguły i kiedy ją ustalono, a także jak potraktowano „nie wiem”. W wynikach podaj liczebności po połączeniu, a w tabeli opisowej lub aneksie – rozkład pierwotny. Gotowe zdania dla przykładu:
Jeśli chcesz, żeby ktoś sprawdził, czy łączenie kategorii i dobór testów w Twojej ankiecie się bronią, zanim oddasz rozdział promotorowi, zobacz ofertę analiz statystycznych dla studentów. Wyniki omawiamy tak, abyś umiał(a) samodzielnie je wyjaśnić; pomoc w analizie ujawnij zgodnie z zasadami swojej uczelni.
Najczęstsze błędy
- Łączenie po zobaczeniu p. Sprawdzanie kolejnych wersji, aż któraś „wyjdzie”, w symulacji ponad trzykrotnie zwiększyło odsetek fałszywych alarmów.
- Doliczanie „nie wiem” do „nie” (albo do środka skali). Niezdecydowani to nie przeciwnicy; w przykładzie takie połączenie ukryło jedyną różnicę między grupami.
- Łączenie niesąsiednich kategorii skali porządkowej, np. obu skrajnych, bo są rzadkie.
- Chi-kwadrat dla hipotezy kierunkowej na skali porządkowej – i to po połączeniu kategorii. Test porządkowy na pełnej skali miał w symulacji wyraźnie większą moc.
- Usuwanie małej kategorii z próby zamiast połączenia jej z sąsiednią albo opisania jej osobno.
- Brak rozkładu pierwotnego – czytelnik nie wie, co połączono i ile osób było w każdej kategorii.
- Różne łączenia tego samego pytania w różnych rozdziałach – raz „zgadza się” to 4–5, raz tylko 5.
Łączenie kategorii w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z tekstu, tabel i rysunków. Pierwszy tworzy dane przykładu, zapisuje plik CSV w folderze nadrzędnym (../) i porównuje analizy przed połączeniem i po połączeniu kategorii. Drugi to symulacja z Rysunków 2 i 3. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane przykładu możesz pobrać: laczenie-kategorii-dane.csv (180 osób: miejsce zamieszkania, zaufanie 1–5 z kodem 9 = „nie wiem”, zamiar szczepienia 1 = tak, 2 = nie, 9 = nie wiem, wykształcenie 1–4).
Przykład z ankiety: skala Likerta, „nie wiem” i mała kategoria metryczki
R
# B430 – łączenie kategorii odpowiedzi przed analizą (dane symulowane)
# Ankieta wśród dorosłych mieszkańców wsi i miasta (praca ze zdrowia publicznego).
# P1: „Ufam informacjom o szczepieniach przekazywanym przez lekarza rodzinnego”
#     1 = zdecydowanie się nie zgadzam ... 5 = zdecydowanie się zgadzam, 9 = nie wiem
# P2: „Czy zamierzasz zaszczepić się przeciw grypie w tym sezonie?” 1 = tak, 2 = nie, 9 = nie wiem
# M3: wykształcenie 1 = podstawowe, 2 = zasadnicze zawodowe, 3 = średnie, 4 = wyższe
suppressPackageStartupMessages({library(ordinal); library(DescTools)})
options(width = 100)
fp <- function(x) sub("^0", "", sprintf("%.3f", x))   # p bez zera wiodącego (APA)
set.seed(430)
n_wies <- 80; n_miasto <- 100; N <- n_wies + n_miasto
miejsce <- factor(rep(c("wieś", "miasto"), c(n_wies, n_miasto)), levels = c("wieś", "miasto"))
zaufanie <- c(sample(c(1:5, 9), n_wies, TRUE, c(.10, .17, .25, .30, .10, .08)),
              sample(c(1:5, 9), n_miasto, TRUE, c(.05, .10, .22, .38, .18, .07)))
zamiar <- c(sample(c(1, 2, 9), n_wies, TRUE, c(.30, .38, .32)),
            sample(c(1, 2, 9), n_miasto, TRUE, c(.36, .46, .18)))
wyksztalcenie <- sample(1:4, N, TRUE, c(.02, .09, .36, .53))
d <- data.frame(id = 1:N, miejsce, zaufanie, zamiar, wyksztalcenie)
write.csv(d, "../laczenie-kategorii-dane.csv", row.names = FALSE)

cat("1. ROZKŁAD ODPOWIEDZI NA P1 (kody; 9 = nie wiem)\n")
print(addmargins(table(d$miejsce, d$zaufanie), 2))

cat("\n2. „NIE WIEM” POZA SKALĄ: tabela 2 × 5 i liczebności oczekiwane\n")
z <- subset(d, zaufanie != 9)
z$p1 <- factor(z$zaufanie, levels = 1:5)
tab5 <- table(z$miejsce, z$p1)
print(tab5)
oczek <- suppressWarnings(chisq.test(tab5)$expected)
print(round(oczek, 1))
cat(sprintf("Komórki z E < 5: %d z %d (%.0f%%); najmniejsza E = %.2f\n",
            sum(oczek < 5), length(oczek), 100 * mean(oczek < 5), min(oczek)))

cat("\n3. TESTY NA PEŁNEJ SKALI (5 kategorii)\n")
ch5 <- suppressWarnings(chisq.test(tab5))
cat(sprintf("chi-kwadrat 2 × 5 (przybliżenie): X2(%d) = %.2f, p = %s\n", ch5$parameter, ch5$statistic, fp(ch5$p.value)))
cat(sprintf("test Fishera–Freemana–Haltona 2 × 5: p = %s\n", fp(fisher.test(tab5)$p.value)))
mw <- wilcox.test(zaufanie ~ miejsce, data = z, exact = FALSE)
cat(sprintf("test Manna–Whitneya: W = %.1f, p = %s\n", mw$statistic, fp(mw$p.value)))
ca <- CochranArmitageTest(tab5)
cat(sprintf("test trendu Cochrana–Armitage'a: Z = %.2f, p = %s\n", ca$statistic, fp(ca$p.value)))
m <- clm(p1 ~ miejsce, data = z)
lr <- anova(m, clm(p1 ~ 1, data = z))
or <- exp(c(coef(m)["miejscemiasto"], confint(m)["miejscemiasto", ]))
cat(sprintf("regresja porządkowa (proporcjonalne szanse): OR = %.2f, 95%% CI [%.2f, %.2f], LR X2(1) = %.2f, p = %s\n",
            or[1], or[2], or[3], lr$LR.stat[2], fp(lr$`Pr(>Chisq)`[2])))

cat("\n4. ŁĄCZENIE 5 -> 3 WEDŁUG REGUŁY Z PLANU ANALIZY (1–2 nie zgadza się, 3 środek, 4–5 zgadza się)\n")
z$p1_3 <- factor(c("nie zgadza się", "nie zgadza się", "ani tak, ani nie", "zgadza się", "zgadza się")[z$zaufanie],
                 levels = c("nie zgadza się", "ani tak, ani nie", "zgadza się"))
tab3 <- table(z$miejsce, z$p1_3)
print(tab3)
print(round(100 * prop.table(tab3, 1), 1))
ch3 <- chisq.test(tab3)
cat(sprintf("najmniejsza E = %.2f; chi-kwadrat 2 × 3: X2(%d) = %.2f, p = %s, V Craméra = %s\n",
            min(ch3$expected), ch3$parameter, ch3$statistic, fp(ch3$p.value),
            sub("^0", "", sprintf("%.2f", sqrt(ch3$statistic / (sum(tab3) * (min(dim(tab3)) - 1)))))))

cat("\n5. TO SAMO PYTANIE, INNE ŁĄCZENIA (tylko do pokazania, jak zmienia się p)\n")
schematy <- list("4–5 vs 1–3" = c(1, 1, 1, 2, 2), "1–2 vs 3–5" = c(1, 1, 2, 2, 2), "5 vs 1–4" = c(1, 1, 1, 1, 2))
for (s in names(schematy)) {
  t2 <- table(z$miejsce, schematy[[s]][z$zaufanie])
  cat(sprintf("%-11s p = %s\n", s, fp(chisq.test(t2, correct = FALSE)$p.value)))
}

cat("\n6. P2: „NIE WIEM” OSOBNO CZY RAZEM Z „NIE”?\n")
d$p2 <- factor(c("tak", "nie", rep(NA, 6), "nie wiem")[d$zamiar], levels = c("tak", "nie", "nie wiem"))
t3 <- table(d$miejsce, d$p2)
print(addmargins(t3, 2))
print(round(100 * prop.table(t3, 1), 1))
c3 <- chisq.test(t3)
cat(sprintf("trzy kategorie: X2(%d) = %.2f, p = %s\n", c3$parameter, c3$statistic, fp(c3$p.value)))
d$p2_tak <- ifelse(d$p2 == "tak", "tak", "nie lub nie wiem")
t2 <- table(d$miejsce, d$p2_tak)
c2 <- chisq.test(t2, correct = FALSE)
cat(sprintf("„nie wiem” dodane do „nie”: odsetek „nie” wieś %.1f%%, miasto %.1f%%; X2(1) = %.2f, p = %s\n",
            100 * t2["wieś", "nie lub nie wiem"] / n_wies, 100 * t2["miasto", "nie lub nie wiem"] / n_miasto,
            c2$statistic, fp(c2$p.value)))
zd <- droplevels(subset(d, p2 != "nie wiem"))
c2z <- chisq.test(table(zd$miejsce, zd$p2), correct = FALSE)
cat(sprintf("tylko zdecydowani (bez „nie wiem”): „tak” wieś %.1f%%, miasto %.1f%%; X2(1) = %.2f, p = %s\n",
            100 * mean(zd$p2[zd$miejsce == "wieś"] == "tak"), 100 * mean(zd$p2[zd$miejsce == "miasto"] == "tak"),
            c2z$statistic, fp(c2z$p.value)))

cat("\n7. METRYCZKA: WYKSZTAŁCENIE – KATEGORIA Z 4 OSOBAMI\n")
w4 <- factor(d$wyksztalcenie, levels = 1:4, labels = c("podstawowe", "zasadnicze zawodowe", "średnie", "wyższe"))
print(table(w4, d$miejsce))
w3 <- factor(c(1, 1, 2, 3)[d$wyksztalcenie], levels = 1:3,
             labels = c("podstawowe lub zasadnicze zawodowe", "średnie", "wyższe"))
print(addmargins(table(w3, d$miejsce)))
Wynik w R
1. ROZKŁAD ODPOWIEDZI NA P1 (kody; 9 = nie wiem)

           1   2   3   4   5   9 Sum
  wieś     4  13  22  20  13   8  80
  miasto   5  11  18  31  27   8 100

2. „NIE WIEM” POZA SKALĄ: tabela 2 × 5 i liczebności oczekiwane

          1  2  3  4  5
  wieś    4 13 22 20 13
  miasto  5 11 18 31 27

         1    2    3    4    5
  wieś   4 10.5 17.6 22.4 17.6
  miasto 5 13.5 22.4 28.6 22.4
Komórki z E < 5: 1 z 10 (10%); najmniejsza E = 3.95

3. TESTY NA PEŁNEJ SKALI (5 kategorii)
chi-kwadrat 2 × 5 (przybliżenie): X2(4) = 5.59, p = .232
test Fishera–Freemana–Haltona 2 × 5: p = .226
test Manna–Whitneya: W = 2707.0, p = .039
test trendu Cochrana–Armitage'a: Z = -1.90, p = .057
regresja porządkowa (proporcjonalne szanse): OR = 1.80, 95% CI [1.04, 3.16], LR X2(1) = 4.34, p = .037

4. ŁĄCZENIE 5 -> 3 WEDŁUG REGUŁY Z PLANU ANALIZY (1–2 nie zgadza się, 3 środek, 4–5 zgadza się)

         nie zgadza się ani tak, ani nie zgadza się
  wieś               17               22         33
  miasto             16               18         58

         nie zgadza się ani tak, ani nie zgadza się
  wieś             23.6             30.6       45.8
  miasto           17.4             19.6       63.0
najmniejsza E = 14.49; chi-kwadrat 2 × 3: X2(2) = 4.93, p = .085, V Craméra = .17

5. TO SAMO PYTANIE, INNE ŁĄCZENIA (tylko do pokazania, jak zmienia się p)
4–5 vs 1–3 p = .028
1–2 vs 3–5 p = .324
5 vs 1–4  p = .095

6. P2: „NIE WIEM” OSOBNO CZY RAZEM Z „NIE”?

         tak nie nie wiem Sum
  wieś    18  30       32  80
  miasto  30  48       22 100

          tak  nie nie wiem
  wieś   22.5 37.5     40.0
  miasto 30.0 48.0     22.0
trzy kategorie: X2(2) = 6.87, p = .032
„nie wiem” dodane do „nie”: odsetek „nie” wieś 77.5%, miasto 70.0%; X2(1) = 1.28, p = .258
tylko zdecydowani (bez „nie wiem”): „tak” wieś 37.5%, miasto 38.5%; X2(1) = 0.01, p = .914

7. METRYCZKA: WYKSZTAŁCENIE – KATEGORIA Z 4 OSOBAMI

w4                    wieś miasto
  podstawowe             1      3
  zasadnicze zawodowe    9      8
  średnie               26     33
  wyższe                44     56

w3                                   wieś miasto Sum
  podstawowe lub zasadnicze zawodowe   10     11  21
  średnie                              26     33  59
  wyższe                               44     56 100
  Sum                                  80    100 180
Symulacja: łączenie „pod wynik” i moc testów
R
# B430 – symulacja: łączenie kategorii „pod wynik” i utrata mocy (dane symulowane)
# Pytanie na skali 1–5, dwie grupy. Porównujemy pięć sposobów analizy tej samej odpowiedzi.
options(width = 100)
set.seed(4300)
p0 <- c(.10, .20, .25, .30, .15)                 # rozkład odpowiedzi w grupie 1
schematy <- list("5 kategorii (2 × 5)" = 1:5,
                 "1–2 | 3 | 4–5"       = c(1, 1, 2, 3, 3),
                 "4–5 vs 1–3"          = c(1, 1, 1, 2, 2),
                 "1–2 vs 3–5"          = c(1, 1, 2, 2, 2),
                 "5 vs 1–4"            = c(1, 1, 1, 1, 2))
p_chi <- function(y, g, s) {                     # chi-kwadrat Pearsona po połączeniu według schematu s
  tab <- table(g, s[y])
  if (ncol(tab) < 2) return(1)
  suppressWarnings(chisq.test(tab, correct = FALSE)$p.value)
}
p_trend <- function(y, g) {                      # test trendu liniowego (linear-by-linear), df = 1
  r <- cor(y, as.numeric(g)); n <- length(y)
  pchisq((n - 1) * r^2, 1, lower.tail = FALSE)
}
przesun <- function(p, logOR) {                  # model proporcjonalnych szans: grupa 2 odpowiada wyżej
  sk <- plogis(qlogis(cumsum(p)[1:4]) - logOR)
  diff(c(0, sk, 1))
}
jedno_badanie <- function(n, logOR) {
  g <- factor(rep(1:2, each = n))
  y <- c(sample(1:5, n, TRUE, p0), sample(1:5, n, TRUE, przesun(p0, logOR)))
  p <- c(sapply(schematy, function(s) p_chi(y, g, s)),
         "Mann–Whitney" = wilcox.test(y ~ g, exact = FALSE)$p.value,
         "trend liniowy" = p_trend(y, g))
  p
}

cat("A. BRAK RÓŻNICY MIĘDZY GRUPAMI (po 50 osób), 5000 powtórzeń\n")
R <- 5000
H0 <- t(replicate(R, jedno_badanie(50, 0)))
falsz <- 100 * colMeans(H0 < .05)
najlepsze <- apply(H0[, names(schematy)], 1, min)
print(round(falsz, 1))
cat(sprintf("Wybór najmniejszego p z 5 sposobów łączenia: %.1f%% fałszywych alarmów\n", 100 * mean(najlepsze < .05)))
cat(sprintf("Wybór najmniejszego p z 5 łączeń i testu Manna–Whitneya: %.1f%%\n",
            100 * mean(apply(H0[, c(names(schematy), "Mann–Whitney")], 1, min) < .05)))
cat("Liczba istotnych wyników (z 5 łączeń) w jednym badaniu:\n")
print(table(rowSums(H0[, names(schematy)] < .05)))
cat(sprintf("Błąd Monte Carlo przy 5%%: ±%.1f pkt proc. (2 SE)\n", 200 * sqrt(.05 * .95 / R)))

cat("\nB. MOC PRZY PRAWDZIWEJ RÓŻNICY (OR = 1.8 w modelu proporcjonalnych szans), 2000 powtórzeń na n\n")
cat("Rozkład w grupie 2:", round(przesun(p0, log(1.8)), 3), "\n")
R2 <- 2000
moc <- do.call(rbind, lapply(c(30, 50, 75, 100, 150), function(n) {
  P <- t(replicate(R2, jedno_badanie(n, log(1.8))))
  data.frame(n_w_grupie = n, metoda = colnames(P), moc = 100 * colMeans(P < .05))
}))
szer <- reshape(moc, idvar = "metoda", timevar = "n_w_grupie", direction = "wide")
names(szer) <- sub("moc.", "n = ", names(szer), fixed = TRUE)
print(format(szer, digits = 3, nsmall = 1), row.names = FALSE)
write.csv(rbind(data.frame(n_w_grupie = 50, metoda = c(names(falsz), "najmniejsze p z 5 łączeń"),
                           moc = c(falsz, 100 * mean(najlepsze < .05)), scenariusz = "H0"),
                cbind(moc, scenariusz = "OR = 1.8")), "b430-symulacja.csv", row.names = FALSE)
Wynik w R
A. BRAK RÓŻNICY MIĘDZY GRUPAMI (po 50 osób), 5000 powtórzeń
5 kategorii (2 × 5)       1–2 | 3 | 4–5          4–5 vs 1–3          1–2 vs 3–5            5 vs 1–4
                5.0                 5.1                 5.8                 5.6                 5.5
       Mann–Whitney       trend liniowy
                5.6                 5.7
Wybór najmniejszego p z 5 sposobów łączenia: 16.2% fałszywych alarmów
Wybór najmniejszego p z 5 łączeń i testu Manna–Whitneya: 16.6%
Liczba istotnych wyników (z 5 łączeń) w jednym badaniu:

   0    1    2    3    4    5
4188  481  193   80   50    8
Błąd Monte Carlo przy 5%: ±0.6 pkt proc. (2 SE)

B. MOC PRZY PRAWDZIWEJ RÓŻNICY (OR = 1.8 w modelu proporcjonalnych szans), 2000 powtórzeń na n
Rozkład w grupie 2: 0.058 0.134 0.212 0.355 0.241
              metoda n = 30 n = 50 n = 75 n = 100 n = 150
 5 kategorii (2 × 5)   12.6   19.4   31.8    43.4    61.0
       1–2 | 3 | 4–5   16.4   25.8   35.7    48.5    67.2
          4–5 vs 1–3   19.4   31.2   43.7    56.6    73.6
          1–2 vs 3–5   16.3   25.1   30.9    42.4    59.2
            5 vs 1–4   14.0   20.8   28.9    38.0    51.6
        Mann–Whitney   23.3   35.4   50.6    64.2    81.7
       trend liniowy   22.9   36.1   49.5    63.3    80.4
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami ordinal i DescTools (pozostałe obliczenia: funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data (R package version 2026.7-26) [Computer software]. https://CRAN.R-project.org/package=ordinal
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim połączysz kategorie, sprawdź…
- Czy masz powód merytoryczny lub statystyczny – a nie „może wyjdzie istotnie”?
- Czy reguła łączenia jest zapisana w planie analizy lub książce kodowej przed analizą?
- Czy łączysz tylko sąsiednie i podobne treściowo kategorie?
- Czy „nie wiem” i braki odpowiedzi są osobno, a nie w „nie” ani w środku skali?
- Czy test dokładny albo test porządkowy na pełnej skali nie rozwiązuje problemu bez łączenia?
- Czy pokazujesz w pracy rozkład przed połączeniem i opisujesz, co połączono?
- Czy to samo pytanie łączysz tak samo w całej pracy?
Najczęstsze pytania
Czy mogę połączyć „raczej się zgadzam” i „zdecydowanie się zgadzam” w jedną kategorię?
Tak, do opisu i wykresu to częsta i rozsądna decyzja, o ile ustalisz ją przed analizą i stosujesz tak samo w całej pracy. Do testowania hipotezy lepiej użyj pełnej skali i testu porządkowego, bo po połączeniu tracisz moc: w symulacji przy 100 osobach w grupie spadła z 64.2% do 48.5% (trzy kategorie).
Co zrobić z odpowiedzią „nie wiem”, gdy łączę kategorie?
Nie doliczaj jej do „nie” ani do środka skali. W pytaniu tak/nie pokaż ją jako osobną kategorię, a w skali traktuj jako brak odpowiedzi merytorycznej i podaj jej odsetek osobno. Porównanie „tak” z „nie lub nie wiem” jest dopuszczalne tylko wtedy, gdy tak nazwiesz kategorię i wynika to z pytania badawczego.
Czy łączenie kategorii po zobaczeniu wyników to błąd?
Tak, jeśli wybierasz to łączenie, które daje istotny wynik. W symulacji bez żadnej różnicy między grupami pojedynczy test dawał około 5% fałszywych alarmów, a wybór najmniejszego p z pięciu sposobów łączenia – 16.2%. Inne łączenia możesz pokazać jako analizę wrażliwości, ale wszystkie, które sprawdziłeś(-aś).
Co zamiast łączenia kategorii, gdy w tabeli są małe liczebności?
Dla zmiennych nominalnych użyj testu dokładnego Fishera lub Fishera–Freemana–Haltona, które nie wymagają reguły liczebności oczekiwanych. Dla odpowiedzi porządkowych wybierz test Manna–Whitneya, test trendu Cochrana–Armitage’a albo regresję porządkową na pełnej skali. Łącz tylko wtedy, gdy kategoria jest bardzo mała i ma sensowną sąsiadkę.
Jak opisać łączenie kategorii w rozdziale metodologicznym?
Napisz, które kategorie połączono, według jakiej reguły, z jakiego powodu i kiedy regułę ustalono (np. w planie analizy przed zebraniem danych), a także jak potraktowano „nie wiem”. W aneksie lub tabeli opisowej pokaż rozkład przed połączeniem, żeby czytelnik mógł ocenić decyzję.
Powiązane hasła
Przeczytaj też
Wyniki ankiety z 30 pytaniami bez 30 testów
Rola każdego pytania, tabela zbiorcza z 95% CI, wynik skali, testy tylko dla hipotez, eksploracja z FDR i gotowy szkic rozdziału wyników.
Czytaj →PoradnikChi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikRegresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikMetryczka: jak zakodować wiek, staż i wykształcenie
Liczba czy przedział, czyszczenie wpisów „50 lat” i „1988”, spójność wieku i stażu, kwartyle a progi, wykształcenie w analizie i Tabela 1.
Czytaj →Nie wiesz, czy połączyć kategorie w swojej ankiecie?
Sprawdzimy rozkłady odpowiedzi, zaproponujemy regułę łączenia i test pasujący do hipotezy, policzymy analizy w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Jakobsson, U. (2004). Statistical presentation and analysis of ordinal data in nursing research. Scandinavian Journal of Caring Sciences, 18(4), 437–440. https://doi.org/10.1111/j.1471-6712.2004.00305.x ● Otwarty dostęp: pełny tekst
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Manor, O., Matthews, S., & Power, C. (2000). Dichotomous or categorical response? Analysing self-rated health and lifetime social class. International Journal of Epidemiology, 29(1), 149–157. https://doi.org/10.1093/ije/29.1.149
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Strömberg, U. (1996). Collapsing ordered outcome categories: A note of concern. American Journal of Epidemiology, 144(4), 421–424. https://doi.org/10.1093/oxfordjournals.aje.a008944
- Whitehead, J. (1993). Sample size calculations for ordered categorical data. Statistics in Medicine, 12(24), 2257–2271. https://doi.org/10.1002/sim.4780122404
- Zhou, Z., Ku, H.-C., Huang, Z., Xing, G., & Xing, C. (2017). Differentiating the Cochran–Armitage trend test and Pearson’s χ² test: Location and dispersion. Annals of Human Genetics, 81(5), 184–189. https://doi.org/10.1111/ahg.12202 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cochran1954some, author={Cochran, William G.}, title={{Some methods for strengthening the common χ² tests}}, journal={Biometrics}, year={1954}, volume={10}, number={4}, pages={417--451}, doi={10.2307/3001616}}@article{jakobsson2004statistical, author={Jakobsson, Ulf}, title={{Statistical presentation and analysis of ordinal data in nursing research}}, journal={Scandinavian Journal of Caring Sciences}, year={2004}, volume={18}, number={4}, pages={437--440}, doi={10.1111/j.1471-6712.2004.00305.x}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{manor2000dichotomous, author={Manor, Orly and Matthews, Sharon and Power, Chris}, title={{Dichotomous or categorical response? Analysing self-rated health and lifetime social class}}, journal={International Journal of Epidemiology}, year={2000}, volume={29}, number={1}, pages={149--157}, doi={10.1093/ije/29.1.149}}@article{mccullagh1980regression, author={McCullagh, Peter}, title={{Regression models for ordinal data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1980}, volume={42}, number={2}, pages={109--127}, doi={10.1111/j.2517-6161.1980.tb01109.x}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}@article{stromberg1996collapsing, author={Strömberg, U.}, title={{Collapsing ordered outcome categories: A note of concern}}, journal={American Journal of Epidemiology}, year={1996}, volume={144}, number={4}, pages={421--424}, doi={10.1093/oxfordjournals.aje.a008944}}@article{whitehead1993sample, author={Whitehead, John}, title={{Sample size calculations for ordered categorical data}}, journal={Statistics in Medicine}, year={1993}, volume={12}, number={24}, pages={2257--2271}, doi={10.1002/sim.4780122404}}@article{zhou2017differentiating, author={Zhou, Zhengyang and Ku, Hung-Chih and Huang, Zhipeng and Xing, Guan and Xing, Chao}, title={{Differentiating the Cochran–Armitage trend test and Pearson’s χ² test: Location and dispersion}}, journal={Annals of Human Genetics}, year={2017}, volume={81}, number={5}, pages={184--189}, doi={10.1111/ahg.12202}}