Jedna odpowiedź „tak”, trzy różne odsetki
W ankiecie wśród personelu pielęgniarskiego pada pytanie: „Czy w ciągu ostatnich 12 miesięcy doświadczyłaś(-eś) agresji słownej ze strony pacjenta lub jego bliskich?”. Kto odpowie „tak”, przechodzi do sekcji z pytaniami o to zdarzenie. Pozostali ją pomijają. Po zebraniu 320 ankiet widzisz, że 50 osób zgłosiło zdarzenie przełożonemu. Jaki to odsetek?
W przykładzie z tego wpisu są trzy poprawne arytmetycznie odpowiedzi: 15.6% (od wszystkich badanych), 39.1% (od osób, których pytanie dotyczyło) i 48.5% (od osób, które odpowiedziały „tak” albo „nie”). Każda z tych liczb odpowiada na inne pytanie badawcze. Błąd polega nie na wyborze którejś z nich, tylko na tym, że czytelnik nie wie, którą wybrano. Druga pułapka jest mniej widoczna: porównania grup w pytaniu zadanym tylko części osób mogą pokazać różnicę, której w rzeczywistości nie ma.
Sam mechanizm pytania filtrującego i logiki przejść opisuje hasło pytanie filtrujące i logika przejść. Tu idziemy krok dalej: od eksportu z Formularzy Google, przez kody braków, do mianownika, tabeli i porównania grup. To część serii o analizie własnej ankiety. Wpis główny serii pokazuje, jak opisać wyniki ankiety z wieloma pytaniami. Mianowniki w pytaniach wielokrotnego wyboru (pominięte pytanie, opcja „żadne z powyższych”) omawia osobny wpis o kodowaniu i liczeniu pytań wielokrotnego wyboru, więc tutaj ich nie powtarzamy.
Przykład przewodni to ankieta 320 pielęgniarek i pielęgniarzy (dane symulowane). Plik w układzie eksportu z Formularzy Google możesz pobrać: pytania-filtrujace-eksport-google-forms.csv. Wszystkie liczby pochodzą z kodu w sekcji Kod R.
Co zostaje w eksporcie po przejściu do innej sekcji
W Formularzach Google pytanie warunkowe buduje się z sekcji. Po dodaniu sekcji przy pytaniu filtrującym wybierasz opcję Go to section based on answer i dla każdej odpowiedzi wskazujesz sekcję, do której osoba przejdzie. Ta opcja działa tylko w pytaniach jednokrotnego wyboru (Multiple choice) i w liście rozwijanej (Dropdown). Pytanie z polami wyboru nie może więc być filtrem (Google, b.d.).
W przykładzie formularz ma taki układ:
- Sekcja 2: P5 – filtr, pytanie obowiązkowe: „Tak” / „Nie” / „Wolę nie odpowiadać”. „Tak” prowadzi do sekcji 3, pozostałe odpowiedzi – do sekcji 4.
- Sekcja 3: P6 „Czy zgłosiłaś(-eś) ostatnie takie zdarzenie przełożonemu?” („Tak” / „Nie” / „Nie pamiętam”) i P7 – ocena wsparcia po zdarzeniu na skali 1–5. Oba pytania są nieobowiązkowe.
- Sekcja 4: P8 „Czy w Twoim miejscu pracy jest procedura zgłaszania agresji wobec personelu?” („Tak” / „Nie” / „Nie wiem”), zadane wszystkim.
W pobranym pliku kolumna P6 ma 196 pustych komórek. Kryją się w nich trzy różne sytuacje. 176 osób odpowiedziało „Nie” w filtrze, więc pytanie ich nie dotyczyło. 16 osób wybrało „Wolę nie odpowiadać”, więc nie wiadomo, czy pytanie ich dotyczyło. 4 osoby przeszły do sekcji 3, ale P6 pominęły. Arkusz tych sytuacji nie rozróżnia. Rozróżnisz je tylko na podstawie odpowiedzi na filtr, dlatego kolumnę z filtrem zachowaj w danych zawsze, nawet jeśli samo pytanie filtrujące nie jest dla Ciebie ważne. Jak sprawdzić przejścia przed rozesłaniem linku, pokazuje wpis o teście technicznym ankiety online. Ogólne przygotowanie eksportu (krótkie nazwy, przekodowanie skal) opisuje poradnik dane z Google Forms i LimeSurvey do SPSS i R.
„Nie dotyczy”, „nie wiem”, odmowa i brak odpowiedzi
Pusta komórka albo odpowiedź „bez treści” może znaczyć kilka różnych rzeczy. Każda z nich inaczej wpływa na mianownik.
| Sytuacja | Przykład | Kod | Czy w mianowniku odsetka? |
|---|---|---|---|
| Nie dotyczy (przejście) | „Nie” w P5, więc P6 nie wyświetlono | 97 | Nie – osoba jest poza populacją pytania |
| Kwalifikacja nieustalona | „Wolę nie odpowiadać” w P5 | 96 | Nie – nie wiadomo, czy pytanie jej dotyczy; podaj liczbę osobno |
| „Nie wiem”, „nie pamiętam” | „Nie pamiętam” w P6 | 98 | Zależy od pytania – decyzja przed analizą (niżej) |
| Brak odpowiedzi | Osoba w sekcji 3 pominęła P6 | 99 | W mianowniku „pytanie dotyczy”, poza mianownikiem „odpowiedzieli” |
„Nie dotyczy” to nie brak danych. Prawdziwej wartości nie ma, więc tych komórek nie imputujesz i nie wliczasz do odsetka braków. Podział na MCAR, MAR i MNAR i imputacja wielokrotna dotyczą tylko kodu 99, czyli osób, które powinny odpowiedzieć, a nie odpowiedziały. Ogólne postępowanie z takimi brakami opisuje wpis braki danych w ankiecie – co zrobić.
„Nie wiem” to odpowiedź, ale nie merytoryczna. W pytaniu o fakt („Czy jest procedura?”) jest wynikiem samym w sobie: 29.6% personelu nie wie, czy procedura istnieje. To ważna informacja, której nie wolno zgubić. Przegląd badań nad konstrukcją kwestionariuszy (Lietz, 2010) traktuje stosowanie opcji „nie wiem” jako osobną decyzję projektową. Więcej o jej kodowaniu znajdziesz w haśle odpowiedź „nie wiem” i „trudno powiedzieć”.
Z samym filtrem też bywa kłopot. W badaniach z danymi administracyjnymi część respondentów odpowiadała „nie” na pytania filtrujące, gdy nauczyła się, że skraca to ankietę. Zjawisko było silniejsze, gdy pytania dalsze padały zaraz po każdym filtrze (Eckman i in., 2014). Zadanie najpierw wszystkich filtrów zmniejsza ten efekt, ale w pytaniach dalszych pojawia się więcej braków (Kreuter i in., 2011). Dla analizy wniosek jest prosty: grupa „nie dotyczy” może zawierać osoby, których pytanie jednak dotyczyło. W ograniczeniach badania napisz o tym jednym zdaniem.
Kody 97, 98 i 99 w danych
Kody odtwarzasz w skrypcie, nie ręcznie w arkuszu. Reguła dla pytania warunkowego ma trzy kroki:
- Jeśli filtr = „Nie”, wpisz 97 we wszystkich pytaniach sekcji warunkowej, niezależnie od zawartości komórki.
- Jeśli filtr = „Wolę nie odpowiadać”, wpisz 96 (kwalifikacja nieustalona).
- Jeśli filtr = „Tak”, przekoduj odpowiedzi na liczby, „Nie pamiętam” na 98, a pustą komórkę na 99.
Potem sprawdź spójność: czy ktoś z „Nie” w filtrze nie ma jednak odpowiedzi w sekcji warunkowej. W tym przykładzie takich osób było 0. Niezerowy wynik zdarza się po zmianie formularza w trakcie badania albo przy ankiecie papierowej, w której instrukcja „przejdź do…” nie zatrzymuje nikogo przed wypełnieniem kolejnych pytań. Każdą taką decyzję zapisz w książce kodowej. Broman i Woo (2018) podkreślają, że braki trzeba oznaczać spójnie w całym pliku i opisać w słowniku danych.
Kody 97–99 mają sens w pytaniach kategorialnych i na krótkich skalach, gdzie takie wartości są niemożliwe. W pytaniach liczbowych (wiek, staż, liczba dyżurów) 97 może być prawdziwą odpowiedzią. Wtedy użyj kodów ujemnych, np. −1 i −9, jak w haśle o pytaniu filtrującym, albo wartości 997–999. Ważne, żeby kody były opisane i zdefiniowane w programie jako braki. Niezdefiniowany kod program policzy jak liczbę, co pokazuje wpis o przygotowaniu bazy danych do analizy.
W SPSS kody wpisujesz w kolumnie Missing w karcie Variable View. Program przyjmuje do trzech pojedynczych wartości braków albo przedział i jedną wartość. Przewodnik IBM podaje też wprost przykład odróżniania odmowy od sytuacji „nie dotyczy” (IBM Corp., 2026). Przy czterech kodach 96–99 wpisz więc przedział 96–99. W tabeli częstości SPSS pokaże je osobno w części Missing, a odsetki w kolumnie Valid Percent policzy bez nich. Pozostałe ustawienia omawia wpis przygotowanie danych w SPSS. W R kody trzymasz w zmiennej źródłowej, a do analizy tworzysz kopię z NA (zob. rekodowanie). Dzięki temu w każdej chwili policzysz, ile było odpowiedzi każdego rodzaju.
Trzy mianowniki: kiedy który
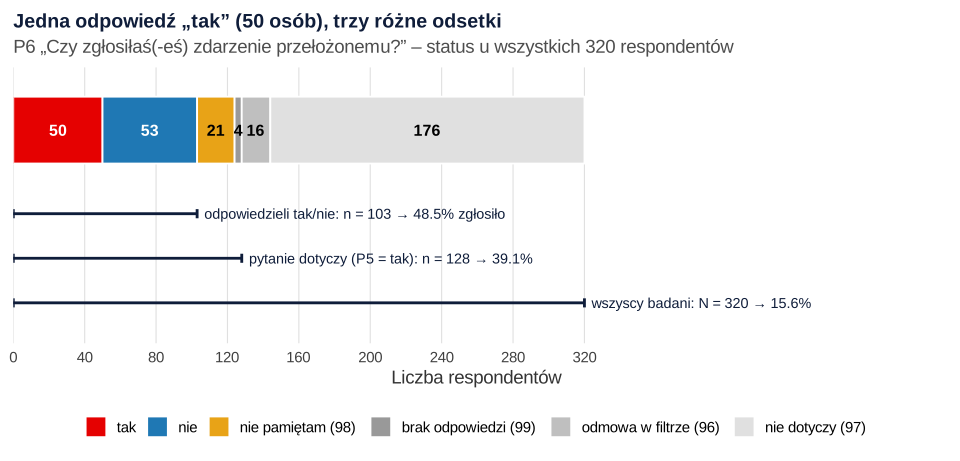
Po zakodowaniu P6 wygląda u wszystkich 320 osób tak, jak na rysunku 1. „Tak” odpowiedziało 50 osób, „nie” – 53, „nie pamiętam” – 21, a 4 osoby pominęły pytanie. 16 osób miało kwalifikację nieustaloną, a 176 pytanie nie dotyczyło.
| Mianownik | n | % „tak” [95% CI] | Na jakie pytanie odpowiada |
|---|---|---|---|
| Wszyscy badani | 320 | 15.6 [12.1, 20.0] | Jaka część personelu doświadczyła agresji i ją zgłosiła? |
| Ci, których pytanie dotyczy (P5 = tak) | 128 | 39.1 [31.0, 47.7] | Jaka część poszkodowanych na pewno zgłosiła zdarzenie (z „nie pamiętam” i brakami w mianowniku)? |
| Ci, którzy odpowiedzieli tak/nie | 103 | 48.5 [39.1, 58.1] | Jaka część poszkodowanych, którzy pamiętają, zgłosiła zdarzenie? |
Jak wybrać?
- Wszyscy badani – gdy pytasz o całą populację, np. o odsetek pracowników, którzy przeszli całą ścieżkę „zdarzenie → zgłoszenie”. Nie nazywaj tej liczby „odsetkiem zgłaszających”, bo 176 osób nie miało czego zgłaszać.
- Ci, których pytanie dotyczy – domyślnie do tabeli rozkładu odpowiedzi. Pokaż wszystkie kategorie, także „nie pamiętam” (16.4%) i brak odpowiedzi (3.1%), tak żeby suma wynosiła 100%. Czytelnik widzi wtedy, ile odpowiedzi nie ma treści.
- Ci, którzy odpowiedzieli merytorycznie – gdy podajesz jedną liczbę z przedziałem ufności albo porównujesz grupy testem. Zawsze dopisz obok, ile osób wyłączono i dlaczego.
Decyzję o „nie wiem” podejmij przed analizą. W P8 (pytanie do wszystkich) „tak” to 55.3% osób z odpowiedzią albo 78.5% po wyłączeniu „nie wiem”. Gdyby promotor zobaczył tylko drugą liczbę, uznałby, że procedurę zna prawie cały personel. Tymczasem prawie co trzecia osoba nie wie, czy ona istnieje. W pytaniach o wiedzę i fakty „nie wiem” zostaw w mianowniku i pokaż jako osobną kategorię. Wyłączaj je tylko wtedy, gdy pytanie badawcze dotyczy osób z wyrobionym zdaniem, i napisz to wprost. Jeśli „nie wiem” chcesz połączyć z inną odpowiedzią, przeczytaj najpierw wpis o łączeniu kategorii odpowiedzi. Łączenie „nie wiem” z „nie” zmienia znaczenie pytania.
Tabela z różnymi n w wierszach
W ankiecie z filtrami każde pytanie może mieć inny mianownik. Nie ukrywaj tego. Dodaj kolumnę n albo podaj n przy nazwie pytania, a w nocie wyjaśnij, skąd się biorą różnice. Ten sam problem (braki w tabeli charakterystyki próby) opisuje wpis o tabeli 1, a zasady opisu zmiennych – poradnik jak opisać charakterystykę próby.
Tabela 1
Doświadczenie agresji słownej, jej zgłaszanie i znajomość procedury wśród personelu pielęgniarskiego
| Pytanie | n | Wynik |
|---|---|---|
| Agresja słowna w ostatnich 12 miesiącach, n (%) tak | 304 | 128 (42.1) |
| Zgłoszenie zdarzenia przełożonemua, n (%) tak | 103 | 50 (48.5) |
| Ocena wsparcia po zdarzeniua (1–5), M (SD) | 125 | 2.90 (1.03) |
| Procedura zgłaszania agresji, n (%) | 304 | |
| Tak | 168 (55.3) | |
| Nie | 46 (15.1) | |
| Nie wiem | 90 (29.6) |
Uwaga. N = 320. Odsetki liczono od osób, które udzieliły odpowiedzi na dane pytanie. Na pytanie o agresję 16 osób wybrało odpowiedź „wolę nie odpowiadać”, a pytanie o procedurę pominęło 16 osób. a Pytania zadawano tylko osobom, które doświadczyły agresji (n = 128). W pytaniu o zgłoszenie pominięto odpowiedzi „nie pamiętam” (n = 21) i braki odpowiedzi (n = 4); oceny wsparcia nie podały 3 osoby. Dane symulowane.
Zwróć uwagę na trzy szczegóły. Pytania warunkowe mają przypis z nazwą filtra i liczbą osób, które go przeszły. Nota wylicza wszystkie wyłączenia, więc z tabeli da się odtworzyć każdą liczbę. „Nie wiem” w pytaniu o procedurę jest osobnym wierszem, a nie zniknęło z mianownika.
Porównanie grup w pytaniu warunkowym: kto przeszedł przez filtr?
Załóżmy, że chcesz sprawdzić, czy osoby pracujące na zmianach nocnych rzadziej zgłaszają agresję. Wśród poszkodowanych, którzy odpowiedzieli tak/nie, zgłosiło ją 71.4% osób bez nocy (25 z 35) i tylko 36.8% osób pracujących w nocy (25 z 68). Test chi-kwadrat daje χ²(1, N = 103) = 11.12, p < .001. Wniosek o „kulturze milczenia na nocnych dyżurach” wydaje się gotowy.
W danych symulowanych wiemy jednak, jak powstały odpowiedzi. Praca w nocy w ogóle nie wpływa na zgłaszanie. Szansa zgłoszenia zależy tylko od oddziału: na oddziałach o dużym natężeniu zdarzeń (np. izba przyjęć) są procedury i zgłasza się częściej. Na doświadczenie agresji wpływają dwie rzeczy: praca w nocy i taki oddział. Do sekcji warunkowej trafiają więc osoby z nocnych zmian z dowolnych oddziałów, a osoby bez nocy – głównie z oddziałów o dużym natężeniu. W całej próbie z takich oddziałów pochodziło 29.0% osób bez nocy i 20.8% pracujących w nocy. Wśród poszkodowanych było to już 68.6% i 30.9%.
Tak działa błąd selekcji. Pytanie filtrujące wybiera osoby według zmiennej, która jest wspólnym skutkiem porównywanej cechy (praca w nocy) i przyczyny wyniku (oddział). Hernán i in. (2004) pokazują, że różne postacie błędu selekcji mają właśnie taką strukturę: warunkowanie na wspólnym skutku. Elwert i Winship (2014) zaznaczają, że wywołuje go każdy sposób warunkowania na zmiennej zderzeniowej, także dobór do próby. Filtr w ankiecie to taki dobór. Szerzej o tym mechanizmie piszemy we wpisie błąd selekcji i zmienna zderzeniowa w praktyce.
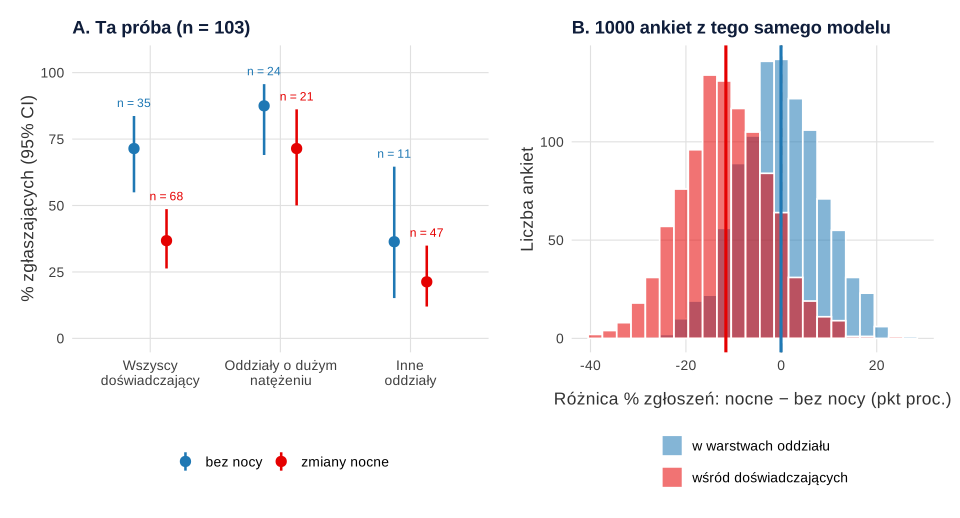
Ta konkretna próba wypadła bardziej skrajnie niż przeciętna. W 1000 ankietach z tego samego modelu różnica wśród poszkodowanych wynosiła średnio −11.6 punktu procentowego, a w 90.1% ankiet była ujemna. Po porównaniu w obrębie typu oddziału średnio wynosiła −0.1 punktu, czyli zero. W naszej próbie regresja logistyczna bez oddziału daje OR = 0.23, 95% CI [0.10, 0.56]. Z oddziałem w modelu OR = 0.42, 95% CI [0.15, 1.16], więc przedział obejmuje 1. Różnice w warstwach (87.5% wobec 71.4% i 36.4% wobec 21.3%) opierają się na kilkunastu–kilkudziesięciu osobach i mieszczą się w zakresie przypadku z panelu B.
Co z tego wynika dla Twojej pracy?
- Porównanie bez warunku często jest bezpieczniejsze. Odsetek osób, które doświadczyły agresji i ją zgłosiły, liczony od wszystkich z odpowiedzią na filtr, wynosi 16.1% bez nocy i 16.8% w nocy. Ta liczba nie wybiera osób według filtra. Odpowiada jednak na inne pytanie (o całą ścieżkę), więc nazwij ją precyzyjnie.
- Uwzględnij znane czynniki, które wpływają i na filtr, i na wynik. Porównaj grupy w warstwach (np. testem Cochrana–Mantela–Haenszela) albo dodaj je do regresji. To pomaga tylko wtedy, gdy te czynniki zmierzyłeś(-aś). Dlatego metryczka powinna zawierać zmienne, które mogą decydować o przejściu przez filtr (zob. metryczka: wiek, staż, wykształcenie).
- Pisz opisowo. „Wśród osób, które doświadczyły agresji, zgłoszenia były rzadsze u pracujących w nocy” jest poprawne. „Praca w nocy zmniejsza gotowość do zgłaszania” – już nie.
- Zawsze pokaż najpierw, jak grupy różnią się w samym filtrze (tu 26.5% wobec 58.4% poszkodowanych). Jeśli grupy przechodzą przez filtr w bardzo różnym odsetku, porównanie po filtrze dotyczy różnie wyselekcjonowanych osób.
Jak opisać w pracy
W metodzie opisz logikę przejść i kody. W wynikach przy każdej liczbie podaj mianownik. Przykładowe fragmenty:
Jeśli porównujesz grupy w pytaniu warunkowym, dodaj zdanie o selekcji, np.: „Porównanie dotyczy wyłącznie osób, które doświadczyły agresji. Grupy różniły się odsetkiem takich osób (26.5% i 58.4%) i typem oddziału, dlatego różnicy nie należy interpretować jako wpływu pracy w nocy na zgłaszanie”. Cały tok analizy, od eksportu do zdań APA, pokazuje wpis analiza ankiety z Google Forms krok po kroku. Jeśli chcesz, żeby ktoś sprawdził kodowanie i mianowniki przed oddaniem rozdziału, zobacz pomoc w analizie dla studentów.
Najczęstsze błędy
- „Nie dotyczy” policzone jak „nie”. W przykładzie dałoby to 71.6% „niezgłaszających” zamiast 51.5%. Zaniżasz też średnie, jeśli „nie dotyczy” zamienisz na 0.
- Imputacja „nie dotyczy”. Nie ma czego uzupełniać – imputujesz tylko kod 99.
- Usunięcie kolumny z filtrem przed przekodowaniem. Bez niej 196 pustych komórek P6 jest nie do rozróżnienia.
- „Nie wiem” wyrzucone bez śladu – 78.5% zamiast 55.3% przy pytaniu, na które prawie co trzecia osoba odpowiedziała „nie wiem”.
- Jeden odsetek bez mianownika w tekście albo w tabeli, w której wiersze mają różne n.
- Odsetek braków liczony od całej próby przy pytaniu warunkowym – wygląda dramatycznie, a dotyczy osób, których pytanie nie obejmowało.
- Wniosek przyczynowy z porównania po filtrze bez sprawdzenia, czy grupy w podobnym stopniu przechodzą przez filtr.
- Pytanie z polami wyboru jako filtr w Formularzach Google – przejście do sekcji nie zadziała. Filtr musi być pytaniem jednokrotnego wyboru albo listą rozwijaną.
Pytania filtrujące w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy plik w układzie eksportu z Formularzy Google (zapisuje go w folderze nadrzędnym, ../), odtwarza kody 96–99 z odpowiedzi na filtr, liczy trzy mianowniki i tabelę z różnymi n. Drugi wczytuje ten sam plik i pokazuje porównanie grup po filtrze oraz 1000 powtórzeń symulacji. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane do pobrania: pytania-filtrujace-eksport-google-forms.csv.
Przepis 1. Od pustych komórek do kodów 97/98/99 i trzech mianowników
R
# B431 – pytanie filtrujące w Formularzach Google: kody 97/98/99 i trzy mianowniki
# Ankieta personelu pielęgniarskiego (dane symulowane, układ jak w eksporcie z Formularzy Google)
# Sekcja 2: P5 (filtr, obowiązkowe) – „Tak” → sekcja 3 (P6, P7), „Nie” i „Wolę nie odpowiadać” → sekcja 4 (P8)
set.seed(431)
N <- 320
noc <- rbinom(N, 1, .5)                      # praca na zmianach nocnych
ryzyko <- rbinom(N, 1, .3)                   # oddział o dużym natężeniu zdarzeń (np. izba przyjęć)
agresja <- rbinom(N, 1, plogis(-2 + 2 * noc + 2.2 * ryzyko))
odmowa <- rbinom(N, 1, .04)                  # „Wolę nie odpowiadać” w pytaniu filtrującym
p5 <- ifelse(odmowa == 1, "Wolę nie odpowiadać", ifelse(agresja == 1, "Tak", "Nie"))
# Zgłoszenie zależy tylko od oddziału (procedury), nie od pracy w nocy
zglosil <- rbinom(N, 1, .25 + .5 * ryzyko)
u <- runif(N)
p6 <- ifelse(zglosil == 1, "Tak", "Nie")
p6[u < .10] <- "Nie pamiętam"
p6[u > .95] <- ""                            # pytanie nieobowiązkowe, pominięte
p7 <- as.character(pmin(5, pmax(1, round(2.6 + .8 * zglosil + rnorm(N, 0, 1)))))
p7[runif(N) < .06] <- ""
p6[p5 != "Tak"] <- ""; p7[p5 != "Tak"] <- ""   # sekcja 3 pominięta przez przejście
p8 <- sample(c("Tak", "Nie", "Nie wiem"), N, replace = TRUE, prob = c(.55, .15, .30))
p8[runif(N) < .03] <- ""

surowe <- data.frame(
  "Sygnatura czasowa" = format(as.POSIXct("2026-10-05 08:00:00", tz = "UTC") + sort(sample(0:(20 * 86400), N)),
                               "%Y-%m-%d %H:%M:%S"),
  "Czy pracujesz na zmianach nocnych?" = ifelse(noc == 1, "Tak", "Nie"),
  "Na jakim oddziale pracujesz?" = ifelse(ryzyko == 1, "Izba przyjęć lub oddział o podobnym profilu", "Inny oddział"),
  "Czy w ciągu ostatnich 12 miesięcy doświadczyłaś(-eś) agresji słownej ze strony pacjenta lub jego bliskich?" = p5,
  "Czy zgłosiłaś(-eś) ostatnie takie zdarzenie przełożonemu?" = p6,
  "Jak oceniasz wsparcie, które otrzymałaś(-eś) po tym zdarzeniu? (1 – bardzo złe, 5 – bardzo dobre)" = p7,
  "Czy w Twoim miejscu pracy jest procedura zgłaszania agresji wobec personelu?" = p8,
  check.names = FALSE)
write.csv(surowe, "../pytania-filtrujace-eksport-google-forms.csv", row.names = FALSE, fileEncoding = "UTF-8")

# 1. Krótkie nazwy zmiennych
d <- read.csv("../pytania-filtrujace-eksport-google-forms.csv", check.names = FALSE, encoding = "UTF-8",
              colClasses = "character", na.strings = NULL)     # puste komórki zostają pustym tekstem
names(d) <- c("czas", "noc", "oddzial", "p5_agresja", "p6_zgloszenie", "p7_wsparcie", "p8_procedura")
cat("Puste komórki w eksporcie:\n")
print(colSums(d == ""))

# 2. Odtworzenie kodów z odpowiedzi na filtr
# 1/0 = odpowiedź; 96 = nieustalone (odmowa w filtrze); 97 = nie dotyczy; 98 = nie pamiętam / nie wiem; 99 = brak odpowiedzi
d$p5 <- c("Tak" = 1, "Nie" = 0, "Wolę nie odpowiadać" = 99)[d$p5_agresja]
koduj_dalsze <- function(x, filtr, mapa) {
  k <- unname(mapa[x])
  k[filtr == 1 & x == ""] <- 99
  k[filtr == 0] <- 97
  k[filtr == 99] <- 96
  k
}
d$p6 <- koduj_dalsze(d$p6_zgloszenie, d$p5, c("Tak" = 1, "Nie" = 0, "Nie pamiętam" = 98))
d$p7 <- koduj_dalsze(d$p7_wsparcie, d$p5, setNames(1:5, 1:5))
d$p8 <- c("Tak" = 1, "Nie" = 0, "Nie wiem" = 98)[d$p8_procedura]
d$p8[d$p8_procedura == ""] <- 99

cat("\nKontrola spójności: odpowiedź w P6 mimo „Nie” w filtrze:",
    sum(d$p5 == 0 & d$p6_zgloszenie != ""), "\n")
cat("\nP5 – filtr (1 = tak, 0 = nie, 99 = wolę nie odpowiadać):\n"); print(table(d$p5))
cat("\nP6 – zgłoszenie (kody):\n"); print(table(d$p6))
cat("\nP7 – wsparcie (kody):\n"); print(table(d$p7))
cat("\nP8 – procedura (1 = tak, 0 = nie, 98 = nie wiem, 99 = brak):\n"); print(table(d$p8))

# 3. Trzy mianowniki dla odpowiedzi „Tak” w P6
wilson <- function(x, n, z = qnorm(.975)) {
  p <- x / n; s <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  h <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  round(100 * c(dol = s - h, gor = s + h), 1)
}
x <- sum(d$p6 == 1)
mian <- c("wszyscy badani" = N,
          "ci, których pytanie dotyczy (P5 = tak)" = sum(d$p5 == 1),
          "ci, którzy odpowiedzieli tak/nie" = sum(d$p6 %in% 0:1))
cat("\nTRZY MIANOWNIKI – zgłoszenie zdarzenia (tak: n =", x, ")\n")
print(data.frame(mianownik = names(mian), n = unname(mian), procent = round(100 * x / mian, 1),
                 t(sapply(mian, function(m) wilson(x, m))), row.names = NULL), right = FALSE)

cat("\nP6 – rozkład wśród osób, których pytanie dotyczy (n =", sum(d$p5 == 1), ")\n")
e <- d[d$p5 == 1, ]
r6 <- table(factor(e$p6, levels = c(1, 0, 98, 99), labels = c("tak", "nie", "nie pamiętam", "brak odpowiedzi")))
print(cbind(n = r6, proc = round(100 * prop.table(r6), 1)))

# Błąd: „nie dotyczy” (97) policzone jak „nie”
cat("\nBłąd: 97 policzone jak „nie”:", round(100 * sum(d$p6 %in% c(0, 97)) / N, 1),
    "% „nie zgłosiło” (od wszystkich badanych) zamiast", round(100 * sum(e$p6 == 0) / sum(e$p6 %in% 0:1), 1),
    "% (od odpowiadających tak/nie)\n")

# 4. Tabela z różnymi n
w7 <- e$p7[e$p7 %in% 1:5]
p5_odp <- d$p5[d$p5 %in% 0:1]
p8_odp <- d$p8[d$p8 != 99]
cat("\nTABELA Z RÓŻNYMI n\n")
tab <- data.frame(
  pytanie = c("P5 Doświadczenie agresji – tak", "P6 Zgłoszenie przełożonemu – tak",
              "P7 Ocena wsparcia (1–5), M (SD)", "P8 Procedura – tak", "P8 Procedura – nie", "P8 Procedura – nie wiem"),
  n = c(length(p5_odp), sum(e$p6 %in% 0:1), length(w7), rep(length(p8_odp), 3)),
  wynik = c(sprintf("%d (%.1f%%)", sum(p5_odp == 1), 100 * mean(p5_odp == 1)),
            sprintf("%d (%.1f%%)", x, 100 * x / sum(e$p6 %in% 0:1)),
            sprintf("%.2f (%.2f)", mean(w7), sd(w7)),
            sprintf("%d (%.1f%%)", sum(p8_odp == 1), 100 * mean(p8_odp == 1)),
            sprintf("%d (%.1f%%)", sum(p8_odp == 0), 100 * mean(p8_odp == 0)),
            sprintf("%d (%.1f%%)", sum(p8_odp == 98), 100 * mean(p8_odp == 98))))
print(tab, right = FALSE, row.names = FALSE)
cat("Bez odpowiedzi merytorycznej: P5 odmowa =", sum(d$p5 == 99), "; P6 nie pamiętam =", sum(e$p6 == 98),
    ", brak =", sum(e$p6 == 99), "; P7 brak =", sum(e$p7 == 99), "; P8 brak =", sum(d$p8 == 99), "\n")
cat("P8 bez „nie wiem” w mianowniku: tak =", sum(p8_odp == 1), "z", sum(p8_odp %in% 0:1),
    sprintf("(%.1f%%)", 100 * sum(p8_odp == 1) / sum(p8_odp %in% 0:1)), "\n")

write.csv(d[, c("noc", "oddzial", "p5", "p6", "p7", "p8")], "b431-dane-kody.csv", row.names = FALSE)
Wynik w R
Puste komórki w eksporcie:
         czas           noc       oddzial    p5_agresja p6_zgloszenie
            0             0             0             0           196
  p7_wsparcie  p8_procedura
          195            16

Kontrola spójności: odpowiedź w P6 mimo „Nie” w filtrze: 0

P5 – filtr (1 = tak, 0 = nie, 99 = wolę nie odpowiadać):

  0   1  99
176 128  16

P6 – zgłoszenie (kody):

  0   1  96  97  98  99
 53  50  16 176  21   4

P7 – wsparcie (kody):

  1   2   3   4   5  96  97  99
 11  32  47  28   7  16 176   3

P8 – procedura (1 = tak, 0 = nie, 98 = nie wiem, 99 = brak):

  0   1  98  99
 46 168  90  16

TRZY MIANOWNIKI – zgłoszenie zdarzenia (tak: n = 50 )
  mianownik                              n   procent dol  gor
1 wszyscy badani                         320 15.6    12.1 20.0
2 ci, których pytanie dotyczy (P5 = tak) 128 39.1    31.0 47.7
3 ci, którzy odpowiedzieli tak/nie       103 48.5    39.1 58.1

P6 – rozkład wśród osób, których pytanie dotyczy (n = 128 )
                 n proc
tak             50 39.1
nie             53 41.4
nie pamiętam    21 16.4
brak odpowiedzi  4  3.1

Błąd: 97 policzone jak „nie”: 71.6 % „nie zgłosiło” (od wszystkich badanych) zamiast 51.5 % (od odpowiadających tak/nie)

TABELA Z RÓŻNYMI n
 pytanie                          n   wynik
 P5 Doświadczenie agresji – tak   304 128 (42.1%)
 P6 Zgłoszenie przełożonemu – tak 103 50 (48.5%)
 P7 Ocena wsparcia (1–5), M (SD)  125 2.90 (1.03)
 P8 Procedura – tak               304 168 (55.3%)
 P8 Procedura – nie               304 46 (15.1%)
 P8 Procedura – nie wiem          304 90 (29.6%)
Bez odpowiedzi merytorycznej: P5 odmowa = 16 ; P6 nie pamiętam = 21 , brak = 4 ; P7 brak = 3 ; P8 brak = 16
P8 bez „nie wiem” w mianowniku: tak = 168 z 214 (78.5%)
Przepis 2. Porównanie grup w pytaniu warunkowym
R
# B431 – porównanie grup w pytaniu warunkowym: kto jest w grupie po filtrze?
# Te same dane co w przepisie 1 (plik pytania-filtrujace-eksport-google-forms.csv)
d <- read.csv("../pytania-filtrujace-eksport-google-forms.csv", check.names = FALSE, encoding = "UTF-8",
              colClasses = "character", na.strings = NULL)
names(d) <- c("czas", "noc", "oddzial", "p5_agresja", "p6_zgloszenie", "p7_wsparcie", "p8_procedura")
d$noc <- factor(d$noc, levels = c("Nie", "Tak"), labels = c("bez nocy", "zmiany nocne"))
d$ryzyko <- as.integer(d$oddzial != "Inny oddział")
d <- d[d$p5_agresja != "Wolę nie odpowiadać", ]            # kwalifikacja nieustalona – poza analizą
d$agresja <- as.integer(d$p5_agresja == "Tak")

proc <- function(x) sprintf("%d/%d = %.1f%%", sum(x), length(x), 100 * mean(x))

cat("1. Odsetek doświadczających agresji (mianownik: wszyscy z odpowiedzią w P5)\n")
print(tapply(d$agresja, d$noc, proc))

e <- d[d$agresja == 1 & d$p6_zgloszenie %in% c("Tak", "Nie"), ]  # grupa po filtrze, odpowiedź tak/nie
e$zglosil <- as.integer(e$p6_zgloszenie == "Tak")
cat("\n2. Odsetek zgłaszających wśród doświadczających (pytanie warunkowe)\n")
print(tapply(e$zglosil, e$noc, proc))
print(chisq.test(table(e$noc, e$zglosil), correct = FALSE))

cat("\n3. Skład grupy po filtrze: odsetek osób z oddziałów o dużym natężeniu zdarzeń\n")
cat("Wszyscy badani:\n"); print(tapply(d$ryzyko, d$noc, proc))
cat("Doświadczający agresji:\n"); print(tapply(e$ryzyko, e$noc, proc))

cat("\n4. Zgłoszenia w warstwach oddziału\n")
print(tapply(e$zglosil, list(oddzial = ifelse(e$ryzyko == 1, "duże natężenie", "inne"), e$noc), proc))
m0 <- glm(zglosil ~ noc, family = binomial, data = e)
m1 <- glm(zglosil ~ noc + ryzyko, family = binomial, data = e)
ors <- function(m) round(exp(cbind(OR = coef(m), confint.default(m)))["noczmiany nocne", ], 2)
cat("\nOR dla zmian nocnych bez uwzględnienia oddziału:", ors(m0), "\n")
cat("OR dla zmian nocnych z oddziałem w modelu:   ", ors(m1), "\n")

cat("\n5. Odsetek osób, które doświadczyły agresji i ją zgłosiły (mianownik: wszyscy z P5)\n")
d$dosw_zgl <- as.integer(d$agresja == 1 & d$p6_zgloszenie == "Tak")
print(tapply(d$dosw_zgl, d$noc, proc))

# 6. Czy to przypadek jednej próby? 1000 ankiet z tego samego modelu
set.seed(4310)
jedna <- function(N = 320) {
  noc <- rbinom(N, 1, .5); ryzyko <- rbinom(N, 1, .3)
  agresja <- rbinom(N, 1, plogis(-2 + 2 * noc + 2.2 * ryzyko))
  zgl <- rbinom(N, 1, .25 + .5 * ryzyko)
  k <- agresja == 1
  warunkowa <- mean(zgl[k & noc == 1]) - mean(zgl[k & noc == 0])
  w_warstwach <- mean(sapply(0:1, function(r) mean(zgl[k & noc == 1 & ryzyko == r]) -
                                               mean(zgl[k & noc == 0 & ryzyko == r])))
  c(warunkowa = warunkowa, w_warstwach = w_warstwach)
}
sym <- t(replicate(1000, jedna()))
cat("\n6. Różnica odsetków zgłoszeń (zmiany nocne − bez nocy), 1000 symulowanych ankiet po 320 osób\n")
print(round(100 * rbind(srednia = colMeans(sym), q025 = apply(sym, 2, quantile, .025),
                        q975 = apply(sym, 2, quantile, .975)), 1))
cat("Odsetek ankiet z różnicą warunkową poniżej zera:", round(100 * mean(sym[, 1] < 0), 1), "%\n")
saveRDS(sym, "b431-symulacja.rds")
Wynik w R
1. Odsetek doświadczających agresji (mianownik: wszyscy z odpowiedzią w P5)
        bez nocy     zmiany nocne
"41/155 = 26.5%" "87/149 = 58.4%"

2. Odsetek zgłaszających wśród doświadczających (pytanie warunkowe)
       bez nocy    zmiany nocne
"25/35 = 71.4%" "25/68 = 36.8%"

	Pearson's Chi-squared test

data:  table(e$noc, e$zglosil)
X-squared = 11.115, df = 1, p-value = 0.0008562


3. Skład grupy po filtrze: odsetek osób z oddziałów o dużym natężeniu zdarzeń
Wszyscy badani:
        bez nocy     zmiany nocne
"45/155 = 29.0%" "31/149 = 20.8%"
Doświadczający agresji:
       bez nocy    zmiany nocne
"24/35 = 68.6%" "21/68 = 30.9%"

4. Zgłoszenia w warstwach oddziału

oddzial          bez nocy        zmiany nocne
  duże natężenie "21/24 = 87.5%" "15/21 = 71.4%"
  inne           "4/11 = 36.4%"  "10/47 = 21.3%"

OR dla zmian nocnych bez uwzględnienia oddziału: 0.23 0.1 0.56
OR dla zmian nocnych z oddziałem w modelu:    0.42 0.15 1.16

5. Odsetek osób, które doświadczyły agresji i ją zgłosiły (mianownik: wszyscy z P5)
        bez nocy     zmiany nocne
"25/155 = 16.1%" "25/149 = 16.8%"

6. Różnica odsetków zgłoszeń (zmiany nocne − bez nocy), 1000 symulowanych ankiet po 320 osób
        warunkowa w_warstwach
srednia     -11.6        -0.1
q025        -29.7       -17.3
q975          6.8        16.9
Odsetek ankiet z różnicą warunkową poniżej zera: 90.1 %
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim policzysz odsetki z pytań warunkowych, sprawdź…
- Czy masz w danych odpowiedź na filtr dla każdej osoby i odtworzone kody 97, 98, 99 (i ewentualnie 96)?
- Czy nikt z „nie” w filtrze nie ma odpowiedzi w sekcji warunkowej?
- Czy kody są opisane w książce kodowej i zdefiniowane jako braki w programie?
- Czy dla każdego pytania wiesz, który mianownik stosujesz i dlaczego, a decyzję o „nie wiem” podjąłeś(-ęłaś) przed analizą?
- Czy tabela ma kolumnę n albo n przy pytaniu, a nota wymienia wszystkie wyłączenia?
- Czy przy porównaniu grup w pytaniu warunkowym pokazujesz najpierw różnicę w samym filtrze i unikasz wniosków przyczynowych?
Najczęstsze pytania
Od jakiej liczby osób liczyć procent w pytaniu, które nie dotyczyło wszystkich respondentów?
Zwykle od osób, których pytanie dotyczyło (przeszły przez filtr), a gdy podajesz jedną liczbę z przedziałem ufności – od tych z nich, które odpowiedziały merytorycznie. Odsetek od wszystkich badanych opisuje coś innego: jaka część całej próby doświadczyła zdarzenia i np. je zgłosiła. W przykładzie te same 50 zgłoszeń to 39.1%, 48.5% albo 15.6%, więc mianownik zawsze podaj w tekście lub nocie.
Czy odpowiedź „nie wiem” wliczać do mianownika odsetka?
W pytaniach o fakty i wiedzę – tak, i pokaż ją jako osobną kategorię, bo sama jest wynikiem. W przykładzie procedurę zgłaszania znało 55.3% osób, ale po wyrzuceniu „nie wiem” wyszłoby 78.5%. Wyłączaj „nie wiem” tylko wtedy, gdy pytanie badawcze dotyczy osób z wyrobionym zdaniem, i zdecyduj o tym przed analizą.
Jakie kody braków stosować: 97, 98, 99 czy liczby ujemne?
Dowolne, byle niemożliwe dla danej zmiennej, opisane w książce kodowej i zdefiniowane w programie jako braki. 97–99 dobrze sprawdzają się w pytaniach kategorialnych i na krótkich skalach. W pytaniach liczbowych, w których 97 może być prawdziwą odpowiedzią (np. liczba godzin), użyj kodów ujemnych albo 997–999.
Czy można porównywać grupy w pytaniu zadanym tylko części respondentów?
Można, ale porównanie dotyczy wyłącznie osób, które przeszły przez filtr, a grupy mogą przechodzić przez niego w różnym odsetku i z różnych powodów. Wtedy różnica po filtrze bywa efektem selekcji, a nie badanej cechy. Pokaż najpierw różnicę w samym filtrze, rozważ odsetek liczony od wszystkich i uwzględnij znane czynniki, które wpływają na filtr i na wynik.
Jak w eksporcie z Google Forms odróżnić „nie dotyczy” od pominiętego pytania?
W arkuszu obie sytuacje wyglądają tak samo – jak pusta komórka. Odróżnisz je tylko na podstawie odpowiedzi na pytanie filtrujące: pusta komórka u osoby, którą filtr skierował do innej sekcji, to „nie dotyczy”, a u osoby, która widziała pytanie – brak odpowiedzi. Dlatego kolumny z filtrem nie usuwaj przed przekodowaniem.
Powiązane hasła
Przeczytaj też
Błąd w ankiecie po zebraniu danych
Dwanaście usterek formularza: jak je wykryć, co zrobić i co napisać w pracy, z symulowaną ankietą w R i gotowymi zdaniami.
Czytaj →PoradnikWyniki ankiety z 30 pytaniami bez 30 testów
Rola każdego pytania, tabela zbiorcza z 95% CI, wynik skali, testy tylko dla hipotez, eksploracja z FDR i gotowy szkic rozdziału wyników.
Czytaj →PoradnikŁączenie kategorii odpowiedzi – kiedy i jak
Likert 5 na 3, „nie wiem”, małe kategorie metryczki, łączenie pod wynik w symulacji i alternatywy: test Fishera, trend, regresja porządkowa – z kodem R.
Czytaj →PoradnikAnaliza ankiety z Google Forms krok po kroku
Od surowego CSV do zdań APA: słownik zmiennych, kontrola jakości, przekodowanie pytań, tabela próby i trzy hipotezy w R.
Czytaj →PoradnikPytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →Masz w ankiecie pytania warunkowe i nie wiesz, od czego liczyć procenty?
Sprawdzimy kodowanie przejść i braków, dobierzemy mianowniki, policzymy tabele w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Eckman, S., Kreuter, F., Kirchner, A., Jäckle, A., Tourangeau, R., & Presser, S. (2014). Assessing the mechanisms of misreporting to filter questions in surveys. Public Opinion Quarterly, 78(3), 721–733. https://doi.org/10.1093/poq/nfu030
- Elwert, F., & Winship, C. (2014). Endogenous selection bias: The problem of conditioning on a collider variable. Annual Review of Sociology, 40(1), 31–53. https://doi.org/10.1146/annurev-soc-071913-043455 ● Otwarty dostęp
- Google. (b.d.). Show questions based on answers. Google Docs Editors Help. https://support.google.com/docs/answer/141062 ● Otwarty dostęp
- Hernán, M. A., Hernández-Díaz, S., & Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
- IBM Corp. (2026). IBM SPSS Statistics 31 brief guide. https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Brief_Guide.pdf ● Otwarty dostęp
- Kreuter, F., McCulloch, S., Presser, S., & Tourangeau, R. (2011). The effects of asking filter questions in interleafed versus grouped format. Sociological Methods & Research, 40(1), 88–104. https://doi.org/10.1177/0049124110392342
- Lietz, P. (2010). Research into questionnaire design: A summary of the literature. International Journal of Market Research, 52(2), 249–272. https://doi.org/10.2501/S147078530920120X ● Otwarty dostęp
Cytowania BibTeX
@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{eckman2014assessing, author={Eckman, Stephanie and Kreuter, Frauke and Kirchner, Antje and Jäckle, Annette and Tourangeau, Roger and Presser, Stanley}, title={{Assessing the mechanisms of misreporting to filter questions in surveys}}, journal={Public Opinion Quarterly}, year={2014}, volume={78}, number={3}, pages={721--733}, doi={10.1093/poq/nfu030}}@article{elwert2014endogenous, author={Elwert, Felix and Winship, Christopher}, title={{Endogenous selection bias: The problem of conditioning on a collider variable}}, journal={Annual Review of Sociology}, year={2014}, volume={40}, number={1}, pages={31--53}, doi={10.1146/annurev-soc-071913-043455}}@misc{googlendshowquestions, author={{Google}}, title={{Show questions based on answers}}, howpublished={Google Docs Editors Help}, year={b.d.}, url={https://support.google.com/docs/answer/141062}}@article{hernan2004structural, author={Hernán, Miguel A. and Hernández-Díaz, Sonia and Robins, James M.}, title={{A structural approach to selection bias}}, journal={Epidemiology}, year={2004}, volume={15}, number={5}, pages={615--625}, doi={10.1097/01.ede.0000135174.63482.43}}@techreport{ibm2026brief, author={{IBM Corp.}}, title={{IBM SPSS Statistics 31 brief guide}}, year={2026}, institution={IBM Corp.}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Brief_Guide.pdf}}@article{kreuter2011effects, author={Kreuter, Frauke and McCulloch, Susan and Presser, Stanley and Tourangeau, Roger}, title={{The effects of asking filter questions in interleafed versus grouped format}}, journal={Sociological Methods \& Research}, year={2011}, volume={40}, number={1}, pages={88--104}, doi={10.1177/0049124110392342}}@article{lietz2010research, author={Lietz, Petra}, title={{Research into questionnaire design: A summary of the literature}}, journal={International Journal of Market Research}, year={2010}, volume={52}, number={2}, pages={249--272}, doi={10.2501/s147078530920120x}}