Jeden plik CSV, jeden skrypt, jeden rozdział wyników
Ankieta w Formularzach Google jest zamknięta, a pobrany plik ma 258 wierszy i 17 kolumn. Nagłówki to całe pytania, odpowiedzi są słowami, a w jednej kolumnie siedzi i „W akademiku”, i „u babci”. Promotor czeka na wyniki trzech hipotez. Ten wpis prowadzi przez całą drogę na jednym przykładzie: od surowego eksportu do tabel i zdań w stylu APA. Każdy krok jest zapisany w kodzie R, więc na końcu możesz go powtórzyć na własnych danych.
W serwisie są już osobne poradniki do poszczególnych etapów i tu do nich odsyłamy. Technikę kodowania (nazwy zmiennych, mapa Likerta, pozycje odwrócone, plik .sav) opisuje poradnik dane z Google Forms i LimeSurvey do SPSS i R. Ogólną kolejność analizy ankiety, z rzetelnością skal i omegą, pokazuje analiza ankiety do pracy dyplomowej. Ten wpis składa te elementy w jeden projekt. Skupia się na trzech rzeczach, które łatwo pominąć. Pierwsza to słownik zmiennych, który prowadzi całe przekodowanie. Druga to pułapki samego eksportu z Formularzy Google. Trzecia to przejście od wyniku testu do gotowego zdania bez ręcznego przepisywania liczb.
Przykład przewodni (dane symulowane). Studentka zdrowia publicznego bada, czy korzystanie z telefonu w łóżku wiąże się z sennością w ciągu dnia i krótszym snem. Ankietę wypełnili studenci dietetyki, fizjoterapii i zdrowia publicznego. Formularz zawiera wszystkie typowe rodzaje pytań. Jest metryczka, pytania jednokrotnego wyboru (jedno z opcją „Inne”) i pytanie o częstość. Jest siatka z sześcioma stwierdzeniami o senności (jedno odwrócone) i pytaniem kontrolnym, pola wyboru, krótkie odpowiedzi i jedno pytanie otwarte. Surowy plik w układzie eksportu z Formularzy Google pobierzesz tutaj: ankieta-sen-telefon-google-forms.csv. Wszystkie liczby poniżej pochodzą z kodu w sekcji Kod R.
Krok 0. Zanim pobierzesz plik: hipotezy i kolumny
Analiza zaczyna się od listy hipotez, a nie od pliku. Przy każdej hipotezie badawczej zapisz, z których kolumn eksportu powstaną zmienne i jakim testem je sprawdzisz. Dobór testu zależy od rodzaju zmiennych, a nie od tego, który test „wyjdzie”. Wszystkie pozostałe pytania opisujesz tylko statystykami opisowymi. Jeśli ankieta ma 30 pytań, a kusi Cię, żeby każde skrzyżować z metryczką, przeczytaj najpierw, jak opisać wyniki ankiety z wieloma pytaniami.
| Hipoteza | Kolumny eksportu | Zmienne po przekodowaniu | Analiza |
|---|---|---|---|
| H1: częstsze korzystanie z telefonu w łóżku wiąże się z większą sennością | pytanie o częstość, sześć wierszy siatki | częstość 1–5 (porządkowa), wynik skali senności | ρ Spearmana z 95% CI |
| H2: osoby przeglądające media społecznościowe przed snem śpią krócej | pola wyboru, krótka odpowiedź o liczbie godzin | opcja „media” 0/1, godziny snu | test t Welcha, d z 95% CI |
| H3: senność różni się w zależności od miejsca zamieszkania | pytanie jednokrotnego wyboru z „Inne” | trzy kategorie, wynik skali senności | ANOVA Welcha, η² |
Hipotezy są trzy i każda dotyczy innego pytania, więc traktujesz je jako analizy główne. W kodzie liczymy też p po poprawce Holma i wniosek się nie zmienia. Kiedy poprawka jest naprawdę potrzebna, wyjaśnia wpis czy muszę stosować poprawkę na wielokrotne porównania.
Krok 1. Pobierz odpowiedzi i obejrzyj surowy plik
W Formularzach Google odpowiedzi pobierzesz w zakładce Odpowiedzi (Responses). Kliknij menu ⋮ (More), a potem Pobierz odpowiedzi (.csv) (Download responses (.csv)). Możesz też połączyć formularz z arkuszem (Link to Sheets) i pobrać plik z arkusza (Google, b.d.). Do analizy bierz plik CSV i nigdy go nie edytuj. Zapisz go w folderze z danymi surowymi i pracuj na kopii wczytanej skryptem.
Zanim cokolwiek przekodujesz, sprawdź cztery rzeczy, typowe dla tego narzędzia:
- Kolejność wierszy. Pomoc Google zaznacza, że pobrane odpowiedzi nie są posortowane według sygnatury czasowej (Google, b.d.). Jeśli reguły czyszczenia odwołują się do czasu (np. wypełnienia testowe przed startem badania), najpierw posortuj plik. W przykładzie pierwszy wiersz pliku pochodził z 4 marca, a wypełnienia testowe z 1 marca stały dopiero w 13. i 14. wierszu danych.
- Adresy e-mail. Przy włączonej opcji zbierania adresów (Collect email addresses: Verified albo Responder input) respondent musi podać adres przed wysłaniem formularza (Google, b.d.). W ankiecie deklarowanej jako anonimowa wyłącz to ustawienie przed startem. Jeśli adresy trafiły do pliku, usuń tę kolumnę przed analizą i nie udostępniaj surowego eksportu.
- Zgodność liczby wierszy. Porównaj liczbę wierszy z liczbą odpowiedzi widoczną w formularzu. W przykładzie to 258 wierszy, łącznie z wypełnieniami testowymi.
- Wartości w kolumnach zamkniętych. Wypisz tabelę liczebności każdej kolumny jednokrotnego wyboru. To najszybszy sposób, żeby zobaczyć wpisy „Inne” i różne wersje tej samej etykiety (więcej w kroku 4).
Jeśli formularz jest dopiero w przygotowaniu, zrób test techniczny ankiety: wypełnij go kilka razy, pobierz plik i uruchom na nim ten sam skrypt.
Krok 2. Słownik zmiennych zamiast ręcznego zmieniania nagłówków
Nagłówek w eksporcie z Formularzy Google to pełna treść pytania. W siatce dochodzi do niego treść stwierdzenia w nawiasie kwadratowym, np. „Na ile zgadzasz się z poniższymi stwierdzeniami? [Rano budzę się wypoczęty(-a).]”. Taki nagłówek nie nadaje się na nazwę zmiennej, ale nie należy go wyrzucać. To gotowa etykieta zmiennej do tabel i do książki kodowej.
Zamiast poprawiać nagłówki w arkuszu, zbuduj tabelę: jeden wiersz na kolumnę eksportu. W kolumnach tabeli zapisz krótką nazwę, typ pytania, etykietę i informację, czy pozycja jest odwrócona. Broman i Woo (2018) wymieniają słownik danych wśród podstawowych zasad porządkowania danych w arkuszach, obok zapisu w plikach tekstowych i braku obliczeń w pliku surowym. W przykładzie słownik ma 17 wierszy. Kod sprawdza, czy liczba nazw zgadza się z liczbą kolumn i czy żadna nazwa się nie powtarza. Etykiety stwierdzeń z siatki wycina z nawiasu kwadratowego. Gotowy słownik zapisuje do pliku, który możesz pobrać jako wzór: slownik-zmiennych-ankieta-sen.csv.
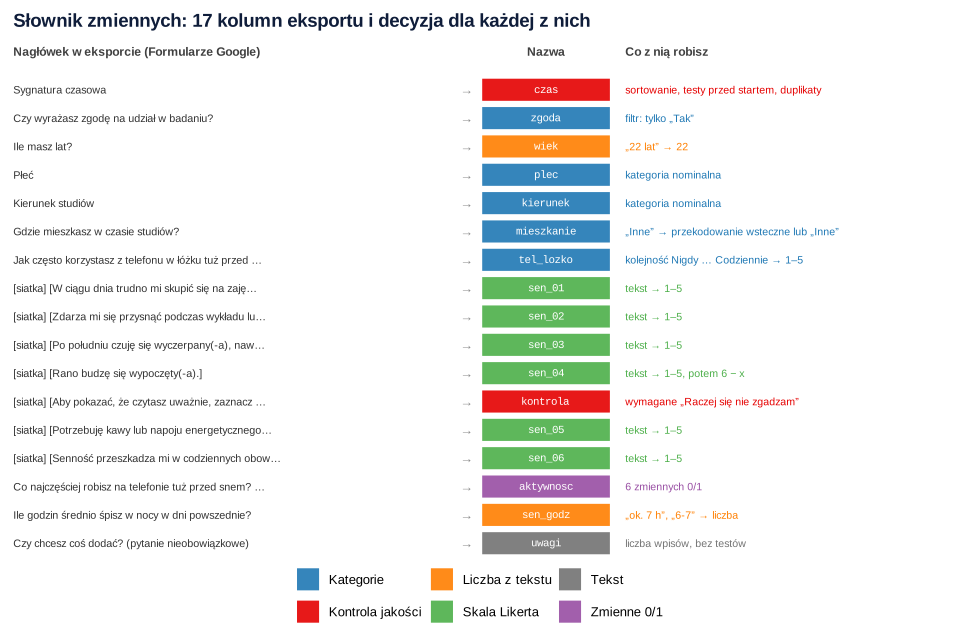
Typ pytania w słowniku nie jest ozdobnikiem. To od niego zależy, co zrobisz z kolumną (rysunek 1). Formularze Google mają kilkanaście typów pytań, ale w ankiecie studenckiej zwykle wystarcza sześć sposobów obróbki: kategorie, kategorie uporządkowane, skala Likerta, zmienne 0/1, liczba wyciągnięta z tekstu i tekst pozostawiony do przeglądu. Dwie kolumny służą tylko kontroli jakości: sygnatura czasowa i pytanie kontrolne.
Krok 3. Kontrola jakości: reguły po kolei, każda policzona
Reguły wykluczeń spisz przed obejrzeniem wyników hipotez. Stosuj je w ustalonej kolejności, a liczbę usuniętych wierszy zapisuj po każdym kroku. Szczegóły technik (duplikaty, osoby bez zgody, zamiana tekstu na liczby) są w poradniku o danych z formularzy. Tu liczy się sama procedura i jej wynik.
| Reguła (w tej kolejności) | Usunięto | Zostało |
|---|---|---|
| Surowy eksport | – | 258 |
| Wypełnienia testowe sprzed startu badania (sygnatura czasowa) | 2 | 256 |
| Brak zgody na udział | 2 | 254 |
| Duplikaty: te same odpowiedzi wysłane ponownie | 3 | 251 |
| Błędna odpowiedź na pytanie kontrolne w siatce | 9 | 242 |
| Jednakowa odpowiedź we wszystkich sześciu pozycjach skali | 6 | 236 |
Dwie ostatnie reguły dotyczą odpowiedzi nieuważnych. Pytanie kontrolne wstawione w siatkę („zaznacz w tym wierszu »Raczej się nie zgadzam«”) wychwyciło 9 osób. Osoba, która klika tę samą kolumnę w całej siatce, zda jednak taki test, jeśli trafi akurat w wymaganą odpowiedź. Dlatego dodano drugą regułę: jednakowa odpowiedź we wszystkich sześciu pozycjach. Skala ma pozycję odwróconą, więc osoba czytająca treść rzadko odpowiada identycznie na „Rano budzę się wypoczęty(-a)” i na „Senność przeszkadza mi w codziennych obowiązkach”. Ta reguła usunęła kolejnych 6 osób. Ma jednak wadę: może też usunąć kogoś, kto naprawdę tak odpowiedział. Dlatego opisz ją w pracy i sprawdź, czy wnioski bez niej się nie zmieniają.
Meade i Craig (2012) pokazali, że nieuważność ma różne wzorce: losowe klikanie i powtarzanie tej samej odpowiedzi. Każdy z nich wymaga innego wskaźnika. Przegląd Warda i Meade’a (2023) opisuje, jak takim odpowiedziom zapobiegać, jak je wykrywać i jak raportować ich usunięcie. Formularze Google zapisują tylko moment wysłania, a nie czas wypełniania, więc wskaźnika szybkości z nich nie policzysz. Tym ważniejsze są pytanie kontrolne i reguła straightliningu. Pełny przegląd wskaźników znajdziesz we wpisie nieuważne odpowiedzi w ankietach online.
Krok 4. Przekoduj każdy typ pytania
Siatka Likerta
Odpowiedzi słowne zamieniasz na liczby według jawnej mapy, w kolejności skali, a nie alfabetu. Przed zamianą sprawdź, czy w danych nie ma etykiet spoza mapy (w przykładzie: 0). Pusta komórka staje się brakiem, nie zerem. Pozycję odwróconą przekoduj do nowej zmiennej (6 − x dla skali 1–5). Oryginał zostaw w danych.
Jednokrotny wybór: kolejność, wersje etykiet i „Inne”
Przy pytaniu o częstość korzystania z telefonu kategorie mają naturalny porządek. Zapisz go wprost, od „Nigdy” do „Codziennie”, i dopiero wtedy nadaj kody 1–5. Domyślne sortowanie alfabetyczne ustawiłoby „1–3 razy w tygodniu” przed „Nigdy”.
Pytanie o miejsce zamieszkania pokazało dwie pułapki. Pierwsza: opcja ma w pliku dwie wersje etykiety. „W wynajmowanym mieszkaniu” wybrało 25 osób, a „W wynajmowanym mieszkaniu lub pokoju” 73 osoby. Tak się dzieje, gdy treść opcji poprawiono w trakcie zbierania odpowiedzi – wcześniejsze wiersze mogą zachować starą wersję. Obie wersje połącz w jedną kategorię i zapisz to w słowniku. Druga pułapka: przy opcji „Inne” w pliku stoi sam wpisany tekst, np. „stancja” albo „u partnera”, zamiast etykiety. Rozpoznasz go po tym, że nie ma go na liście opcji. Sprawdź to też na wypełnieniu testowym własnego formularza.
Z 9 wpisów w polu „Inne” trzy („stancja” i dwa razy „wynajmuję pokój”) pasują do istniejącej kategorii. Przypisano je do wynajmu zgodnie z regułą ustaloną przed analizą. Pozostałe 6 wpisów (np. „u partnera”, „u babci”) utworzyło kategorię „Inne”. Jest za mała do porównań, więc nie weszła do testu H3, ale jest opisana w tabeli próby. Zasady takiego przekodowania wstecznego opisuje wpis o kodowaniu wpisów „Inne (jakie?)”. Kiedy łączyć małe kategorie, a kiedy je pomijać, wyjaśnia wpis łączenie kategorii odpowiedzi przed analizą.
Pola wyboru
Pytanie „Co najczęściej robisz na telefonie tuż przed snem?” rozbijasz na sześć zmiennych 0/1, dopasowując pełne etykiety opcji. Osoba z pustą komórką dostaje braki, a nie zera. Na pytanie odpowiedziały 233 osoby, a media społecznościowe zaznaczyło 137 z nich. Dlaczego nie dzielić tekstu po przecinku i od czego liczyć odsetki, wyjaśnia wpis o pytaniach wielokrotnego wyboru. W H2 opcja „media społecznościowe” działa jak zwykła zmienna grupująca.
Krótka odpowiedź z liczbą
Pole „Ile godzin średnio śpisz w nocy?” przyniosło odpowiedzi w rodzaju „7”, „6,5”, „ok. 7 h” i „6-7”. Reguły ustal z góry i zastosuj w skrypcie. Przecinek zamieniasz na kropkę i wyciągasz liczby. Przedział „6-7” zastępujesz środkiem (6.5; w przykładzie 4 takie odpowiedzi). Wartości niemożliwe zamieniasz na brak – tu „65”, zapewne „6,5” bez przecinka, ale tego nie wiadomo. Tekst bez liczby („różnie”) i puste pola to braki. Łącznie godziny snu znamy dla 230 z 236 osób.
Pytanie otwarte
Pole „Czy chcesz coś dodać?” zostaje w danych jako tekst. W przykładzie merytoryczny wpis zostawiły 23 osoby (po pominięciu „-”, „brak” i pustych pól). Wystarczy podać tę liczbę i przejrzeć wpisy. Mogą ujawnić problem z pytaniem, np. „Pytanie o sen dotyczy tylko dni z zajęciami?”. Jeśli odpowiedzi otwarte mają być wynikiem badania, przypisz je do kategorii według spisanego klucza i policz liczebności.
Krok 5. Wynik skali i jej rzetelność
Wynik senności to średnia sześciu pozycji, po odwróceniu pozycji 4. Wynik liczono, gdy osoba odpowiedziała na co najmniej 5 z 6 pozycji. Tak było u wszystkich 236 osób, mimo pojedynczych pominięć. Średnia zostaje w jednostkach odpowiedzi 1–5 i nie karze za jedno pominięcie (zob. wynik skali: średnia czy suma). Sullivan i Artino (2013) przypominają, że połączenie pozycji Likerta w jeden wynik trzeba uzasadnić dowodami rzetelności lub struktury. Pojedyncze pozycje opisuje się raczej rozkładem odpowiedzi niż średnią.
Alfa Cronbacha wyniosła α = .81. Bez odwrócenia pozycji 4 spadłaby do .57, więc niska alfa to często sygnał błędu kodowania, a nie „złej skali”.
Krok 6. Charakterystyka próby w jednej tabeli
Tabela charakterystyki próby zbiera metryczkę i najważniejsze zmienne opisowe. Do analizy weszło 236 osób w wieku 19–28 lat (M = 21.52, SD = 1.60). Jakie cechy pokazać, jak grupować kategorie i co z brakami, opisuje wpis Tabela 1 – charakterystyka próby.
Tabela 1
Charakterystyka próby (N = 236)
| Zmienna | n lub M (SD) | % |
|---|---|---|
| Wiek (lata), M (SD) | 21.52 (1.60) | |
| Płeć | ||
| Kobieta | 166 | 70.3 |
| Mężczyzna | 67 | 28.4 |
| Wolę nie odpowiadać | 3 | 1.3 |
| Kierunek studiów | ||
| Dietetyka | 91 | 38.6 |
| Fizjoterapia | 66 | 28.0 |
| Zdrowie publiczne | 79 | 33.5 |
| Miejsce zamieszkania | ||
| Z rodzicami | 85 | 36.0 |
| Akademik | 52 | 22.0 |
| Wynajmowane mieszkanie lub pokój | 93 | 39.4 |
| Inne | 6 | 2.5 |
| Telefon w łóżku przed snem | ||
| Nigdy | 14 | 5.9 |
| Rzadziej niż raz w tygodniu | 27 | 11.4 |
| 1–3 razy w tygodniu | 57 | 24.2 |
| 4–6 razy w tygodniu | 54 | 22.9 |
| Codziennie | 84 | 35.6 |
| Senność w ciągu dnia (1–5), M (SD) | 3.21 (0.66) | |
| Godziny snu w dni powszednie, M (SD)a | 6.85 (0.85) |
Uwaga. Odsetki liczone od N = 236. Kategoria „Inne” (np. mieszkanie u partnera lub krewnych) nie była uwzględniona w porównaniu miejsc zamieszkania. Dane symulowane.
a n = 230 (6 odpowiedzi bez liczby lub spoza zakresu 3–12 h).
Zwróć uwagę na dwie rzeczy. Kategoria „Inne” jest w tabeli, choć nie wchodzi do testu H3 – czytelnik ma wiedzieć, ile osób pominięto i dlaczego. Liczba godzin snu ma własne n (230), bo braki w tej zmiennej są inne niż w skali. Tak samo postępuj z pytaniami, których nie wszyscy widzieli – wpis o pytaniach filtrujących i mianowniku pokazuje, jak oznaczyć różne n w tabeli.
Krok 7. Trzy hipotezy, trzy różne testy
H1: częstość korzystania z telefonu a senność
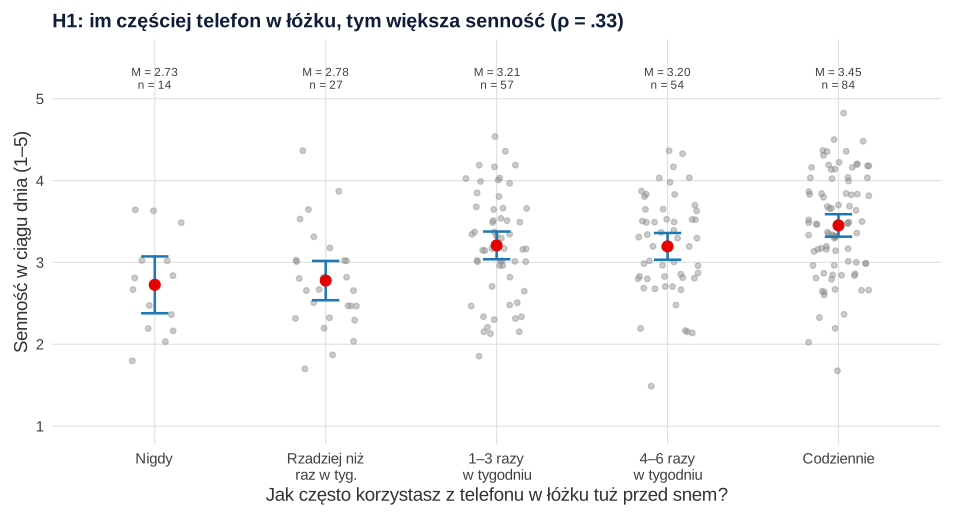
Częstość to zmienna porządkowa o pięciu kategoriach, więc zastosowano korelację Spearmana. Przedział ufności policzono metodą bootstrap (2000 prób). Średnia senność rosła od 2.73 u osób, które nigdy nie korzystają z telefonu w łóżku, do 3.45 u korzystających codziennie (rysunek 2). Korelacja wyniosła ρ = .33, 95% CI [.20, .44], p < .001. W badaniu przekrojowym to związek, nie dowód wpływu: równie dobrze senne osoby mogą dłużej leżeć z telefonem.
H2: media społecznościowe przed snem a długość snu
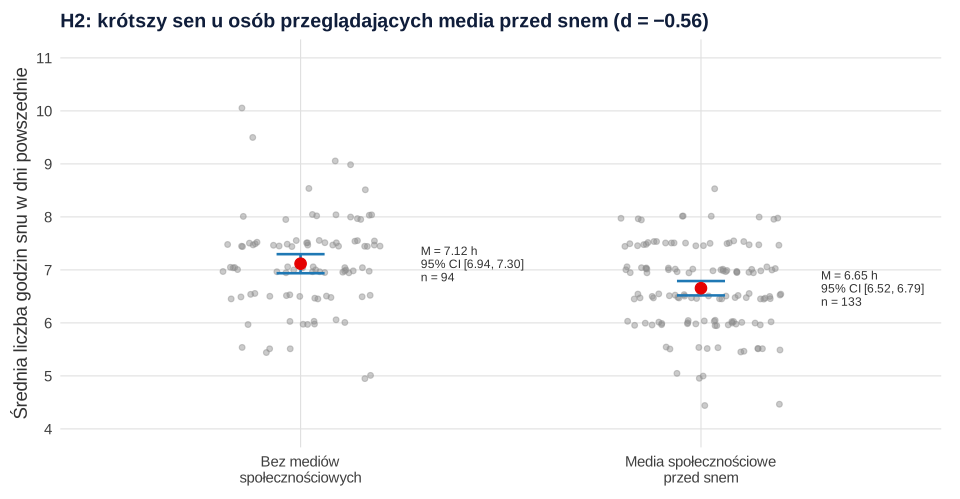
Porównanie dwóch grup o różnej liczebności przeprowadzono testem t Welcha. Delacre i in. (2017) zalecają go jako domyślny, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach, a przy równych niewiele traci. Osoby przeglądające media społecznościowe przed snem spały średnio 6.65 h (SD = 0.79, n = 133), a pozostałe 7.12 h (SD = 0.88, n = 94). Różnica wyniosła −0.46 h, 95% CI [−0.69, −0.24], t(186.94) = −4.07, p < .001. d Cohena = −0.56, 95% CI [−0.83, −0.29]. Lakens (2013) pokazuje, jak liczyć i raportować wielkości efektu, żeby wynik dało się wykorzystać w analizach mocy i metaanalizach. Różnica niecałej pół godziny snu na noc jest też łatwa do opisania w języku praktyki.
H3: miejsce zamieszkania a senność
Trzy grupy porównano ANOVA Welcha, którą Delacre i in. (2019) zalecają zamiast klasycznego testu F przy nierównych wariancjach. Średnie były prawie identyczne: z rodzicami 3.22, w akademiku 3.25, w wynajmowanym mieszkaniu 3.17. F(2, 123.86) = 0.29, p = .746, η² = .003. Hipoteza H3 nie znalazła potwierdzenia. Wynik nieistotny opisz równie starannie jak istotny, z liczebnościami i wielkością efektu. Brak istotności nie dowodzi jednak braku różnic.
Tabela 2
Wyniki testów hipotez H1–H3
| Hipoteza | n | Test | Statystyka | p | Wielkość efektu |
|---|---|---|---|---|---|
| H1: częstość telefonu w łóżku a senność | 236 | ρ Spearmana | ρ = .33 | < .001 | 95% CI [.20, .44] |
| H2: media społecznościowe a godziny snu | 227 | t Welcha | t(186.94) = −4.07 | < .001 | d = −0.56, 95% CI [−0.83, −0.29] |
| H3: miejsce zamieszkania a senność | 230 | ANOVA Welcha | F(2, 123.86) = 0.29 | .746 | η² = .003 |
Uwaga. Przedział ufności dla ρ – bootstrap percentylowy (2000 prób); d – różnica średnich podzielona przez połączone odchylenie standardowe. Po poprawce Holma dla trzech hipotez: p < .001, p < .001 i p = .746. W H3 pominięto 6 osób z kategorii „Inne”. Dane symulowane.
Krok 8. Zdania do metody i wyników
Ostatni przepis w sekcji z kodem składa zdania z wyników funkcją sprintf(). Liczby trafiają do tekstu prosto z obiektów R, bez przepisywania z konsoli, więc znika najczęstsze źródło literówek w rozdziale wyników. Kolejność treści odpowiada zaleceniom JARS-Quant (Appelbaum i in., 2018). Najpierw opis przygotowania danych i wykluczeń, potem opis próby, na końcu wyniki hipotez w kolejności ich postawienia. Gotowe zdania dla innych testów znajdziesz w poradniku jak opisać wyniki w stylu APA.
Jeśli chcesz, żeby ktoś sprawdził Twój skrypt, reguły wykluczeń i dobór testów przed oddaniem rozdziału, zobacz pomoc w analizie dla studentów. Wyniki i tak musisz rozumieć i umieć obronić samodzielnie.
To samo w SPSS i jamovi
Kolejność kroków jest taka sama w każdym programie. Słownik zmiennych, reguły wykluczeń i mapy kodów przygotujesz w arkuszu, a wykonasz w składni SPSS albo w jamovi. Plik CSV z Formularzy Google otworzysz w obu programach. W SPSS zapisz każdą operację w składni (Paste zamiast samego OK). Wtedy, jak w R, cały proces da się powtórzyć po dopisaniu jednej reguły. Kroki znajdziesz we wpisach z serii o programach: przygotowanie danych w SPSS oraz przygotowanie danych i statystyki opisowe w jamovi. Liczby powinny wyjść takie same jak w R, jeśli zaczniesz od tych samych zmiennych i tych samych reguł.
Najczęstsze błędy
- Poprawki ręczne w pobranym pliku. Usunięte wiersze i zmienione etykiety znikają bez śladu. Surowy CSV zostaw nietknięty, a zmiany rób w skrypcie lub składni.
- Brak słownika zmiennych. Nazwy nadawane „w locie” rozjeżdżają się z kolejnością kolumn po każdej zmianie formularza.
- Reguły czasowe na nieposortowanym pliku. Pobrany plik nie jest posortowany po czasie, więc „pierwsze dwa wiersze to testy” bywa nieprawdą.
- Nie sprawdzone wartości w kolumnach. Dwie wersje tej samej etykiety albo wpisy „Inne” liczone jako osobne kategorie.
- Sortowanie alfabetyczne kategorii porządkowych. „1–3 razy w tygodniu” przed „Nigdy” zniszczy korelację rangową.
- Tylko jeden wskaźnik nieuważności. Pytanie kontrolne nie wyłapie osoby, która klika w całej siatce wymaganą odpowiedź.
- Kolumna z adresami e-mail w pliku do analizy w badaniu deklarowanym jako anonimowe.
- Liczby przepisywane ręcznie z konsoli do tekstu. Jedna literówka w t lub df wystarczy, by promotor zakwestionował cały rozdział.
Analiza ankiety z Google Forms w R: kod i wynik
Trzy przepisy uruchamiane po kolei w folderze, w którym leży pobrany plik. Każdy zapisuje wynik do pliku .rds, z którego korzysta następny. Wystarczy bazowy R. Dane do pobrania: ankieta-sen-telefon-google-forms.csv; słownik zmiennych: slownik-zmiennych-ankieta-sen.csv. Rysunki powstały w osobnym skrypcie na tych samych danych.
1. Wczytanie eksportu i słownik zmiennych
R
# B433, przepis 1: wczytanie eksportu z Formularzy Google i słownik zmiennych
surowe <- read.csv("ankieta-sen-telefon-google-forms.csv", colClasses = "character",
                   check.names = FALSE, encoding = "UTF-8")
cat("Wiersze i kolumny eksportu:", dim(surowe), "\n")

# Słownik: krótka nazwa i typ pytania dla każdej kolumny (kolejność jak w eksporcie)
slownik <- data.frame(
  nazwa = c("czas", "zgoda", "wiek", "plec", "kierunek", "mieszkanie", "tel_lozko",
            "sen_01", "sen_02", "sen_03", "sen_04", "kontrola", "sen_05", "sen_06",
            "aktywnosc", "sen_godz", "uwagi"),
  typ = c("techniczna", "jednokrotny", "krótka odpowiedź", "jednokrotny", "jednokrotny",
          "jednokrotny + Inne", "jednokrotny (porządkowy)", rep("siatka Likerta", 4),
          "pytanie kontrolne", rep("siatka Likerta", 2), "pola wyboru (wielokrotny)",
          "krótka odpowiedź", "akapit (otwarte)"))
slownik$pytanie <- names(surowe)
# w siatce Google Forms treść stwierdzenia stoi w nawiasie kwadratowym na końcu nagłówka
w_siatce <- grepl("\\[.*\\]$", slownik$pytanie)
slownik$etykieta <- ifelse(w_siatce, sub("^.*\\[(.*)\\]$", "\\1", slownik$pytanie), slownik$pytanie)
slownik$odwrocona <- slownik$nazwa == "sen_04"
stopifnot(nrow(slownik) == ncol(surowe), !anyDuplicated(slownik$nazwa))
names(surowe) <- slownik$nazwa

options(width = 100)
skrot <- function(x, n = 44) ifelse(nchar(x) > n, paste0(substr(x, 1, n - 1), "…"), x)
print(data.frame(nazwa = slownik$nazwa, typ = slownik$typ, etykieta = skrot(slownik$etykieta)),
      row.names = FALSE, right = FALSE)
write.csv(slownik[, c("nazwa", "typ", "etykieta", "odwrocona", "pytanie")],
          "slownik-zmiennych.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Każda kolumna zamknięta: jakie odpowiedzi naprawdę są w pliku?
for (v in c("plec", "kierunek", "mieszkanie", "tel_lozko")) {
  tab <- setNames(as.data.frame(table(surowe[[v]], useNA = "ifany")), c("odpowiedz", "n"))
  cat("\n", v, "\n", sep = ""); print(tab, row.names = FALSE, right = FALSE)
}
saveRDS(list(surowe = surowe, slownik = slownik), "b433-krok1.rds")
Wynik w R
Wiersze i kolumny eksportu: 258 17
 nazwa      typ                       etykieta
 czas       techniczna                Sygnatura czasowa
 zgoda      jednokrotny               Czy wyrażasz zgodę na udział w badaniu?
 wiek       krótka odpowiedź          Ile masz lat?
 plec       jednokrotny               Płeć
 kierunek   jednokrotny               Kierunek studiów
 mieszkanie jednokrotny + Inne        Gdzie mieszkasz w czasie studiów?
 tel_lozko  jednokrotny (porządkowy)  Jak często korzystasz z telefonu w łóżku tu…
 sen_01     siatka Likerta            W ciągu dnia trudno mi skupić się na zajęci…
 sen_02     siatka Likerta            Zdarza mi się przysnąć podczas wykładu lub …
 sen_03     siatka Likerta            Po południu czuję się wyczerpany(-a), nawet…
 sen_04     siatka Likerta            Rano budzę się wypoczęty(-a).
 kontrola   pytanie kontrolne         Aby pokazać, że czytasz uważnie, zaznacz w …
 sen_05     siatka Likerta            Potrzebuję kawy lub napoju energetycznego, …
 sen_06     siatka Likerta            Senność przeszkadza mi w codziennych obowią…
 aktywnosc  pola wyboru (wielokrotny) Co najczęściej robisz na telefonie tuż prze…
 sen_godz   krótka odpowiedź          Ile godzin średnio śpisz w nocy w dni powsz…
 uwagi      akapit (otwarte)          Czy chcesz coś dodać? (pytanie nieobowiązko…

plec
 odpowiedz           n
                       2
 Kobieta             181
 Mężczyzna            71
 Wolę nie odpowiadać   4

kierunek
 odpowiedz         n
                     2
 Dietetyka         100
 Fizjoterapia       75
 Zdrowie publiczne  81

mieszkanie
 odpowiedz                            n
                                       2
 stancja                               1
 u babci                               1
 u partnera                            3
 W akademiku                          57
 W wynajmowanym mieszkaniu            25
 W wynajmowanym mieszkaniu lub pokoju 73
 wynajmuję pokój                       2
 z partnerem                           1
 z rodzeństwem                         1
 Z rodzicami                          92

tel_lozko
 odpowiedz                   n
                              2
 1–3 razy w tygodniu         62
 4–6 razy w tygodniu         59
 Codziennie                  91
 Nigdy                       16
 Rzadziej niż raz w tygodniu 28
2. Kontrola jakości, przekodowanie i wynik skali
R
# B433, przepis 2: przekodowanie, kontrola jakości i wynik skali
k1 <- readRDS("b433-krok1.rds"); d <- k1$surowe

# 1. Kontrola jakości – reguły ustalone przed analizą, stosowane po kolei
d$czas <- as.POSIXct(d$czas, format = "%d.%m.%Y %H:%M:%S", tz = "Europe/Warsaw")
d <- d[order(d$czas), ]                         # pobrany plik nie jest posortowany po czasie
przeplyw <- c(eksport = nrow(d))
d <- d[d$czas >= as.POSIXct("2026-03-02", tz = "Europe/Warsaw"), ]; przeplyw["po_testach"] <- nrow(d)
d <- d[d$zgoda == "Tak, wyrażam zgodę", ]; przeplyw["po_zgodzie"] <- nrow(d)
d <- d[!duplicated(d[, names(d) != "czas"]), ]; przeplyw["po_duplikatach"] <- nrow(d)
d <- d[d$kontrola %in% "Raczej się nie zgadzam", ]; przeplyw["po_kontrolnym"] <- nrow(d)

# 2. Siatka Likerta: tekst -> 1–5 według jawnej mapy, pozycja 4 odwrócona
likert <- c("Zdecydowanie się nie zgadzam" = 1, "Raczej się nie zgadzam" = 2,
            "Ani się zgadzam, ani się nie zgadzam" = 3, "Raczej się zgadzam" = 4,
            "Zdecydowanie się zgadzam" = 5)
sen <- paste0("sen_0", 1:6)
poza <- setdiff(unique(unlist(d[sen])), c(names(likert), ""))
cat("Etykiety spoza mapy w siatce:", length(poza), "\n")
for (v in sen) d[[v]] <- unname(likert[d[[v]]])          # pusta komórka -> NA
d$sen_04_r <- 6 - d$sen_04
poz <- c("sen_01", "sen_02", "sen_03", "sen_04_r", "sen_05", "sen_06")
jednakowe <- apply(d[sen], 1, function(x) length(unique(na.omit(x))) == 1)   # bez odwrócenia!
cat("Jednakowa odpowiedź we wszystkich 6 pozycjach (mimo pozycji odwróconej):", sum(jednakowe), "\n")
d <- d[!jednakowe, ]; przeplyw["po_straightliningu"] <- nrow(d)
print(data.frame(krok = names(przeplyw), n = przeplyw, usunieto = c(NA, -diff(przeplyw))), row.names = FALSE)

# 3. Pytania jednokrotnego wyboru: kolejność kategorii, wersje etykiet, wpisy „Inne”
d$tel_lozko <- factor(d$tel_lozko, levels = c("Nigdy", "Rzadziej niż raz w tygodniu",
                      "1–3 razy w tygodniu", "4–6 razy w tygodniu", "Codziennie"))
d$tel_kod <- as.integer(d$tel_lozko)                     # 1–5 do korelacji rangowej
d$mieszkanie[d$mieszkanie == "W wynajmowanym mieszkaniu"] <- "W wynajmowanym mieszkaniu lub pokoju"
opcje_m <- c("Z rodzicami", "W akademiku", "W wynajmowanym mieszkaniu lub pokoju")
d$mieszkanie_inne <- ifelse(d$mieszkanie %in% opcje_m, NA, d$mieszkanie)
cat("\nWpisy w „Inne” (miejsce zamieszkania):\n"); print(table(d$mieszkanie_inne))
wynajem <- c("stancja", "wynajmuję pokój")               # reguła przekodowania wstecznego
d$miejsce <- ifelse(d$mieszkanie %in% wynajem, "W wynajmowanym mieszkaniu lub pokoju",
                    ifelse(d$mieszkanie %in% opcje_m, d$mieszkanie, "Inne"))
d$miejsce <- factor(d$miejsce, levels = c(opcje_m, "Inne"),
                    labels = c("Z rodzicami", "Akademik", "Wynajem", "Inne"))
print(table(d$miejsce))

# 4. Pola wyboru -> zmienne 0/1 (pełne etykiety; pusta komórka = brak)
akt <- c(akt_media = "Przeglądam media społecznościowe", akt_filmy = "Oglądam filmy lub seriale",
         akt_nauka = "Uczę się lub czytam materiały", akt_gry = "Gram w gry",
         akt_wiad = "Piszę wiadomości", akt_brak = "Nie korzystam z telefonu przed snem")
for (v in names(akt)) d[[v]] <- ifelse(d$aktywnosc == "", NA,
                                        as.integer(grepl(akt[[v]], d$aktywnosc, fixed = TRUE)))
cat("\nZaznaczenia (n osób) przy", sum(d$aktywnosc != ""), "odpowiadających:\n")
print(colSums(d[names(akt)], na.rm = TRUE))

# 5. Krótkie odpowiedzi liczbowe: wiek i liczba godzin snu
d$wiek <- as.numeric(sub("^([0-9]+).*$", "\\1", d$wiek))
g <- sub(",", ".", d$sen_godz)
licz <- regmatches(g, gregexpr("[0-9]+(\\.[0-9]+)?", g))
d$sen_h <- sapply(licz, function(x) if (length(x)) mean(as.numeric(x)) else NA)   # „6-7” -> 6.5
cat("\nGodziny snu: przedziały „a-b” zamienione na środek:", sum(grepl("[0-9]-[0-9]", g)),
    "| tekst bez liczby lub puste:", sum(is.na(d$sen_h)), "\n")
zle <- !is.na(d$sen_h) & (d$sen_h < 3 | d$sen_h > 12)
cat("Wartości poza zakresem 3–12 h (zamienione na brak):", d$sen_godz[zle], "\n")
d$sen_h[zle] <- NA

# 6. Pytanie otwarte: zostaje jako tekst, liczymy tylko, ile osób coś wpisało
merytoryczne <- !(trimws(tolower(d$uwagi)) %in% c("", "-", "brak", "nie"))
cat("Odpowiedzi w polu „Czy chcesz coś dodać?”:", sum(merytoryczne), "z", nrow(d), "\n")

# 7. Wynik skali senności: średnia, gdy jest co najmniej 5 z 6 pozycji; alfa Cronbacha
n_odp <- rowSums(!is.na(d[poz]))
d$sennosc <- ifelse(n_odp >= 5, rowMeans(d[poz], na.rm = TRUE), NA)
alfa <- function(x) { x <- na.omit(x); k <- ncol(x)
  k / (k - 1) * (1 - sum(apply(x, 2, var)) / var(rowSums(x))) }
cat("\nWynik skali policzono dla", sum(!is.na(d$sennosc)), "osób; brak przy n_odp < 5:",
    sum(n_odp < 5), "\n")
cat("Alfa Cronbacha: z sen_04_r =", round(alfa(d[poz]), 2), "| z sen_04 bez odwrócenia =",
    round(alfa(d[sen]), 2), "\n")
saveRDS(list(d = d, przeplyw = przeplyw), "b433-krok2.rds")
Wynik w R
Etykiety spoza mapy w siatce: 0
Jednakowa odpowiedź we wszystkich 6 pozycjach (mimo pozycji odwróconej): 6
               krok   n usunieto
            eksport 258       NA
         po_testach 256        2
         po_zgodzie 254        2
     po_duplikatach 251        3
      po_kontrolnym 242        9
 po_straightliningu 236        6

Wpisy w „Inne” (miejsce zamieszkania):

        stancja         u babci      u partnera wynajmuję pokój     z partnerem
              1               1               3               2               1
  z rodzeństwem
              1

Z rodzicami    Akademik     Wynajem        Inne
         85          52          93           6

Zaznaczenia (n osób) przy 233 odpowiadających:
akt_media akt_filmy akt_nauka   akt_gry  akt_wiad  akt_brak
      137       105        53        38       101        14

Godziny snu: przedziały „a-b” zamienione na środek: 4 | tekst bez liczby lub puste: 5
Wartości poza zakresem 3–12 h (zamienione na brak): 65
Odpowiedzi w polu „Czy chcesz coś dodać?”: 23 z 236

Wynik skali policzono dla 236 osób; brak przy n_odp < 5: 0
Alfa Cronbacha: z sen_04_r = 0.81 | z sen_04 bez odwrócenia = 0.57
3. Charakterystyka próby, hipotezy H1–H3 i zdania APA
R
# B433, przepis 3: charakterystyka próby, hipotezy H1–H3 i zdania APA
set.seed(433)
d <- readRDS("b433-krok2.rds")$d
N <- nrow(d)
p_apa <- function(p) if (p < .001) "p < .001" else paste("p =", sub("^0", "", sprintf("%.3f", p)))
bz <- function(x, k = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", k, "f"), x))   # bez zera
f2 <- function(x) sprintf("%.2f", x)

# Tabela 1: charakterystyka próby
cat("N =", N, "| wiek: M =", f2(mean(d$wiek)), "SD =", f2(sd(d$wiek)),
    "zakres", min(d$wiek), "–", max(d$wiek), "\n")
kat <- function(v) { t <- table(d[[v]]); data.frame(zmienna = v, kategoria = names(t),
                     n = as.vector(t), proc = sprintf("%.1f", 100 * as.vector(t) / N)) }
print(do.call(rbind, lapply(c("plec", "kierunek", "miejsce", "tel_lozko"), kat)), row.names = FALSE)
cat("Senność (1–5): M =", f2(mean(d$sennosc)), "SD =", f2(sd(d$sennosc)),
    "| godziny snu: n =", sum(!is.na(d$sen_h)), "M =", f2(mean(d$sen_h, na.rm = TRUE)),
    "SD =", f2(sd(d$sen_h, na.rm = TRUE)), "\n")

# H1: częstość korzystania z telefonu w łóżku (1–5) a senność – rho Spearmana z bootstrapem
h1 <- cor.test(d$tel_kod, d$sennosc, method = "spearman", exact = FALSE)
boot_rho <- replicate(2000, { i <- sample(N, replace = TRUE)
  cor(d$tel_kod[i], d$sennosc[i], method = "spearman") })
ci1 <- quantile(boot_rho, c(.025, .975))
cat("\nH1 – średnia senność według częstości:\n")
print(data.frame(n = tapply(d$sennosc, d$tel_lozko, length),
                 M = round(tapply(d$sennosc, d$tel_lozko, mean), 2)))
cat(sprintf("rho = %s, 95%% CI [%s, %s] (bootstrap, 2000 prób), %s\n",
            bz(h1$estimate), bz(ci1[1]), bz(ci1[2]), p_apa(h1$p.value)))

# H2: media społecznościowe przed snem a liczba godzin snu – test t Welcha i d Cohena
h2d <- d[!is.na(d$akt_media) & !is.na(d$sen_h), ]
x <- h2d$sen_h[h2d$akt_media == 1]; y <- h2d$sen_h[h2d$akt_media == 0]
h2 <- t.test(x, y)                                        # Welch domyślnie
n1 <- length(x); n2 <- length(y)
s_p <- sqrt(((n1 - 1) * var(x) + (n2 - 1) * var(y)) / (n1 + n2 - 2))
dc <- (mean(x) - mean(y)) / s_p
se_d <- sqrt((n1 + n2) / (n1 * n2) + dc^2 / (2 * (n1 + n2)))
cat(sprintf("\nH2 – media: n = %d, M = %s, SD = %s; bez mediów: n = %d, M = %s, SD = %s\n",
            n1, f2(mean(x)), f2(sd(x)), n2, f2(mean(y)), f2(sd(y))))
cat(sprintf("różnica = %s h, 95%% CI [%s, %s], t(%s) = %s, %s, d = %s, 95%% CI [%s, %s]\n",
            f2(mean(x) - mean(y)), f2(h2$conf.int[1]), f2(h2$conf.int[2]), f2(h2$parameter),
            f2(h2$statistic), p_apa(h2$p.value), f2(dc), f2(dc - 1.96 * se_d), f2(dc + 1.96 * se_d)))

# H3: miejsce zamieszkania a senność – ANOVA Welcha (bez kategorii „Inne”, n = 6)
h3d <- droplevels(d[d$miejsce != "Inne", ])
h3 <- oneway.test(sennosc ~ miejsce, data = h3d)          # var.equal = FALSE: test Welcha
ss <- summary(aov(sennosc ~ miejsce, data = h3d))[[1]][["Sum Sq"]]
cat("\nH3 – senność według miejsca zamieszkania:\n")
print(data.frame(n = tapply(h3d$sennosc, h3d$miejsce, length),
                 M = round(tapply(h3d$sennosc, h3d$miejsce, mean), 2),
                 SD = round(tapply(h3d$sennosc, h3d$miejsce, sd), 2)))
cat(sprintf("F(%d, %s) = %s, %s, eta^2 = %s\n", h3$parameter[1], f2(h3$parameter[2]),
            f2(h3$statistic), p_apa(h3$p.value), bz(ss[1] / sum(ss), 3)))
cat("p po poprawce Holma (H1–H3):", sapply(p.adjust(c(h1$p.value, h2$p.value, h3$p.value), "holm"), p_apa), "\n")

# Zdania APA składane z wyników (bez ręcznego przepisywania liczb)
cat("\nZDANIA APA\n")
cat(sprintf("H1: Częstsze korzystanie z telefonu w łóżku przed snem wiązało się z większą sennością w ciągu dnia, rho(%d) = %s, 95%% CI [%s, %s], %s.\n",
            N - 2, bz(h1$estimate), bz(ci1[1]), bz(ci1[2]), p_apa(h1$p.value)))
cat(sprintf("H2: Osoby przeglądające media społecznościowe przed snem (n = %d, M = %s, SD = %s) spały krócej niż pozostałe (n = %d, M = %s, SD = %s), t(%s) = %s, %s, d = %s, 95%% CI [%s, %s].\n",
            n1, f2(mean(x)), f2(sd(x)), n2, f2(mean(y)), f2(sd(y)), f2(h2$parameter), f2(h2$statistic),
            p_apa(h2$p.value), f2(dc), f2(dc - 1.96 * se_d), f2(dc + 1.96 * se_d)))
cat(sprintf("H3: Senność %s w zależności od miejsca zamieszkania, F(%d, %s) = %s, %s, eta^2 = %s.\n",
            if (h3$p.value < .05) "różniła się" else "nie różniła się istotnie",
            h3$parameter[1], f2(h3$parameter[2]), f2(h3$statistic), p_apa(h3$p.value), bz(ss[1] / sum(ss), 3)))
saveRDS(list(d = d, h3d = h3d), "b433-krok3.rds")
Wynik w R
N = 236 | wiek: M = 21.52 SD = 1.60 zakres 19 – 28
   zmienna                   kategoria   n proc
      plec                     Kobieta 166 70.3
      plec                   Mężczyzna  67 28.4
      plec         Wolę nie odpowiadać   3  1.3
  kierunek                   Dietetyka  91 38.6
  kierunek                Fizjoterapia  66 28.0
  kierunek           Zdrowie publiczne  79 33.5
   miejsce                 Z rodzicami  85 36.0
   miejsce                    Akademik  52 22.0
   miejsce                     Wynajem  93 39.4
   miejsce                        Inne   6  2.5
 tel_lozko                       Nigdy  14  5.9
 tel_lozko Rzadziej niż raz w tygodniu  27 11.4
 tel_lozko         1–3 razy w tygodniu  57 24.2
 tel_lozko         4–6 razy w tygodniu  54 22.9
 tel_lozko                  Codziennie  84 35.6
Senność (1–5): M = 3.21 SD = 0.66 | godziny snu: n = 230 M = 6.85 SD = 0.85

H1 – średnia senność według częstości:
                             n    M
Nigdy                       14 2.73
Rzadziej niż raz w tygodniu 27 2.78
1–3 razy w tygodniu         57 3.21
4–6 razy w tygodniu         54 3.20
Codziennie                  84 3.45
rho = .33, 95% CI [.20, .44] (bootstrap, 2000 prób), p < .001

H2 – media: n = 133, M = 6.65, SD = 0.79; bez mediów: n = 94, M = 7.12, SD = 0.88
różnica = -0.46 h, 95% CI [-0.69, -0.24], t(186.94) = -4.07, p < .001, d = -0.56, 95% CI [-0.83, -0.29]

H3 – senność według miejsca zamieszkania:
             n    M   SD
Z rodzicami 85 3.22 0.69
Akademik    52 3.25 0.74
Wynajem     93 3.17 0.58
F(2, 123.86) = 0.29, p = .746, eta^2 = .003
p po poprawce Holma (H1–H3): p < .001 p < .001 p = .746

ZDANIA APA
H1: Częstsze korzystanie z telefonu w łóżku przed snem wiązało się z większą sennością w ciągu dnia, rho(234) = .33, 95% CI [.20, .44], p < .001.
H2: Osoby przeglądające media społecznościowe przed snem (n = 133, M = 6.65, SD = 0.79) spały krócej niż pozostałe (n = 94, M = 7.12, SD = 0.88), t(186.94) = -4.07, p < .001, d = -0.56, 95% CI [-0.83, -0.29].
H3: Senność nie różniła się istotnie w zależności od miejsca zamieszkania, F(2, 123.86) = 0.29, p = .746, eta^2 = .003.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base, stats i utils); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim oddasz rozdział wyników, sprawdź…
- Czy surowy CSV jest zapisany bez zmian, a każda zmiana jest w skrypcie lub składni?
- Czy masz słownik zmiennych (nazwa, typ, etykieta, odwrócenie) i czy liczba nazw zgadza się z liczbą kolumn?
- Czy plik posortowano po sygnaturze czasowej przed regułami czasowymi?
- Czy reguły wykluczeń są spisane, zastosowane po kolei i policzone?
- Czy tabela liczebności każdej kolumny zamkniętej nie pokazuje wersji etykiet ani wpisów „Inne”?
- Czy kategorie porządkowe mają ręcznie ustaloną kolejność?
- Czy każda hipoteza ma test dobrany do rodzaju zmiennych, wielkość efektu i przedział ufności?
- Czy liczby w zdaniach pochodzą z kodu, a tabela próby pokazuje n każdej zmiennej?
Najczęstsze pytania
Dlaczego w pobranym pliku z Google Forms ta sama odpowiedź występuje w dwóch wersjach?
Najczęściej dlatego, że treść opcji poprawiono, gdy formularz zbierał już odpowiedzi – wcześniejsze wiersze mogą zachować starą etykietę. W przykładzie „W wynajmowanym mieszkaniu” (25 osób) i „W wynajmowanym mieszkaniu lub pokoju” (73 osoby) to jedna kategoria. Przed analizą wypisz tabelę liczebności każdej kolumny zamkniętej, połącz wersje w skrypcie i zapisz to w słowniku zmiennych.
Jak zakodować opcję „Inne” w pytaniu jednokrotnego wyboru z Google Forms?
W kolumnie stoi wtedy sam wpisany tekst zamiast etykiety, więc rozpoznasz go po tym, że nie ma go na liście opcji. Wpisy pasujące do istniejącej kategorii przypisz do niej według reguły ustalonej przed analizą, a resztę zostaw jako „Inne”. Małej grupy „Inne” zwykle nie porównuje się testem, ale pokazuje się ją w tabeli próby.
Czy pytanie kontrolne wystarczy, żeby wykryć nieuważne odpowiedzi w Google Forms?
Nie zawsze. Osoba, która klika tę samą kolumnę w całej siatce, zda pytanie kontrolne, jeśli trafi w wymaganą odpowiedź. Dlatego warto dodać drugą regułę, np. jednakowa odpowiedź we wszystkich pozycjach skali z pozycją odwróconą. Formularze Google nie zapisują czasu wypełniania, więc wskaźnika szybkości z nich nie policzysz.
Jak opisać w rozdziale metodologicznym, że ankieta była przeprowadzona w Google Forms?
Podaj narzędzie, sposób pobrania danych (plik CSV) i program do analizy, a potem liczbę rekordów w eksporcie i liczbę usuniętych na każdym kroku czyszczenia z regułą. Dodaj, jak policzono wynik skali i co zrobiono z wpisami „Inne” i odpowiedziami tekstowymi. Gotowy akapit znajdziesz w sekcji ze zdaniami do metody.
Jak uniknąć błędów przy przepisywaniu wyników z R do pracy?
Nie przepisuj ich ręcznie. Złóż zdania z obiektów wynikowych funkcją sprintf() albo paste(), tak żeby statystyka, stopnie swobody, p i wielkość efektu trafiały do tekstu prosto z testu. Po każdej zmianie w danych uruchamiasz skrypt ponownie i zdania aktualizują się same.
Powiązane hasła
Przeczytaj też
Analiza ankiety w Arkuszach Google
Kodowanie odpowiedzi formułami, pola wyboru bez SPLIT, tabela przestawna, chi-kwadrat, korelacja i T.TEST typ 3 – z plikiem CSV i liczbami kontrolnymi z R.
Czytaj →PoradnikReguły kontroli danych i dziennik zmian
Zakresy, logika pytań i sumy kontrolne zapisane z góry, tabela naruszeń w R, decyzje i dziennik zmian odtwarzający czysty zbiór.
Czytaj →PoradnikDane z Google Forms i LimeSurvey: kodowanie do SPSS i R
Eksport, nazwy zmiennych, rekodowanie Likerta, pozycje odwrócone, wielokrotny wybór i braki – krok po kroku, z kodem R i wzorem książki kodowej.
Czytaj →PoradnikAnaliza ankiety do pracy dyplomowej
Od surowego eksportu do wyników hipotez: czyszczenie danych, wyniki skal, alfa i omega, opis próby, testy i opis APA – z danymi i kodem R.
Czytaj →PoradnikWyniki ankiety z 30 pytaniami bez 30 testów
Rola każdego pytania, tabela zbiorcza z 95% CI, wynik skali, testy tylko dla hipotez, eksploracja z FDR i gotowy szkic rozdziału wyników.
Czytaj →PoradnikPytania wielokrotnego wyboru – kodowanie i liczenie
Eksport z Google Forms i LimeSurvey, zmienne 0/1, mianownik, % osób z przedziałem Wilsona i liczenie w R, Excelu, SPSS, jamovi i SZTOS.
Czytaj →Masz eksport z Google Forms i nie wiesz, jak zamienić go w rozdział wyników?
Sprawdzimy słownik zmiennych, reguły czyszczenia i dobór testów, policzymy analizy w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Broman, K. W., & Woo, K. H. (2018). Data organization in spreadsheets. The American Statistician, 72(1), 2–10. https://doi.org/10.1080/00031305.2017.1375989 ● Otwarty dostęp: pełny tekst
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Google. (b.d.). View & manage form responses. Google Docs Editors Help. Pobrano 15 października 2026 z https://support.google.com/docs/answer/139706 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Meade, A. W., & Craig, S. B. (2012). Identifying careless responses in survey data. Psychological Methods, 17(3), 437–455. https://doi.org/10.1037/a0028085
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- Ward, M. K., & Meade, A. W. (2023). Dealing with careless responding in survey data: Prevention, identification, and recommended best practices. Annual Review of Psychology, 74(1), 577–596. https://doi.org/10.1146/annurev-psych-040422-045007 ● Otwarty dostęp
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{broman2018data, author={Broman, Karl W. and Woo, Kara H.}, title={{Data organization in spreadsheets}}, journal={The American Statistician}, year={2018}, volume={72}, number={1}, pages={2--10}, doi={10.1080/00031305.2017.1375989}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@misc{googlendview, author={{Google}}, title={{View \& manage form responses}}, howpublished={Google Docs Editors Help}, url={https://support.google.com/docs/answer/139706}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{meade2012identifying, author={Meade, Adam W. and Craig, S. Bartholomew}, title={{Identifying careless responses in survey data}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={437--455}, doi={10.1037/a0028085}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{ward2023dealing, author={Ward, M. K. and Meade, Adam W.}, title={{Dealing with careless responding in survey data: Prevention, identification, and recommended best practices}}, journal={Annual Review of Psychology}, year={2023}, volume={74}, number={1}, pages={577--596}, doi={10.1146/annurev-psych-040422-045007}}