Co to jest test Fishera–Freemana–Haltona?
Test Fishera–Freemana–Haltona (ang. Fisher–Freeman–Halton test, FFH) to uogólnienie testu dokładnego Fishera z tabeli 2 × 2 na dowolną tabelę krzyżową r × c (Freeman i Halton, 1951). Sprawdza niezależność dwóch zmiennych kategorialnych bez przybliżenia rozkładem χ², z którego korzysta test chi-kwadrat niezależności. Stosuje się go, gdy wiele komórek ma małe liczebności oczekiwane.
Jak działa
Test traktuje sumy wierszy i kolumn jako stałe. Każda tabela o tych sumach ma przy hipotezie niezależności prawdopodobieństwo z wielowymiarowego rozkładu hipergeometrycznego. Wartość p to suma prawdopodobieństw wszystkich tabel nie bardziej prawdopodobnych niż obserwowana (Mehta i Patel, 1983). Liczba takich tabel szybko rośnie, dlatego potrzebne są wydajne algorytmy, np. sieciowy algorytm Mehty i Patela. Agresti (1992) opisuje, jak takie algorytmy i moc obliczeniowa upowszechniły metody dokładne. Przy dużych tabelach p można oszacować symulacją Monte Carlo.
Przykład w R
30 studentów trzech kierunków wybrało metodę badania do pracy (ankieta, wywiad, eksperyment; dane przykładowe). Wszystkie dziewięć liczebności oczekiwanych mieści się w przedziale 2.79–3.45. Test χ² daje χ²(4) = 11.97, p = .018, z ostrzeżeniem o przybliżeniu. Test Fishera–Freemana–Haltona: p = .031, a z 100 000 symulacji p = .031. Mehta i Patel (1983) zauważają, że w tabelach rzadkich oba testy często prowadzą do sprzecznych wniosków; tu wniosek jest ten sam, ale p z przybliżenia jest wyraźnie mniejsze.
Na rysunku
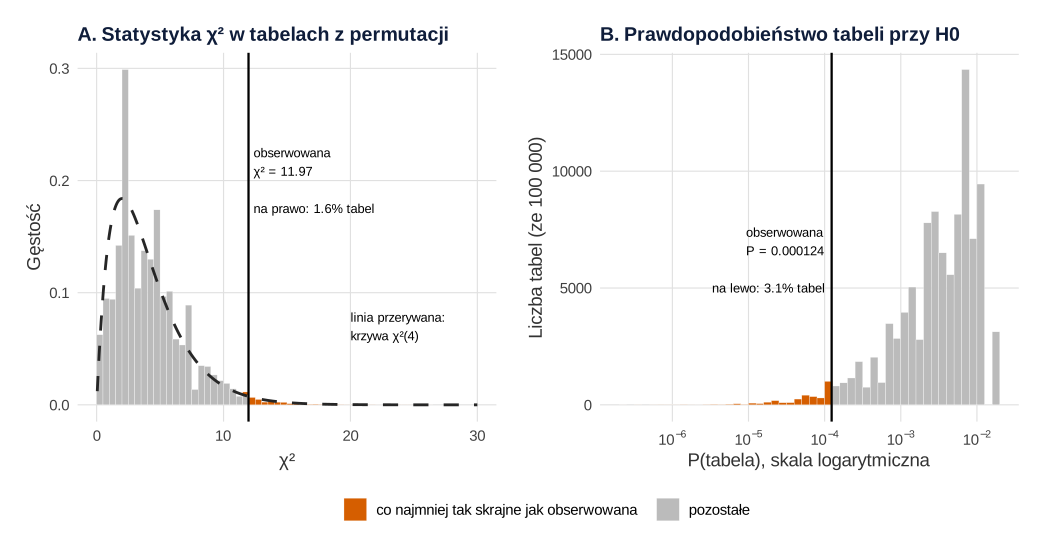
set.seed(626)).Co widać. Funkcja r2dtable() wylosowała 100 000 tabel o tych samych sumach wierszy i kolumn co tabela z przykładu, każdą z prawdopodobieństwem, jakie ma przy niezależności. Panel B pokazuje to, co liczy test Fishera–Freemana–Haltona: prawdopodobieństwo każdej tabeli. Obserwowana tabela ma prawdopodobieństwo 0.000124. Tabele co najmniej tak mało prawdopodobne stanowią 3.1% próby, czyli p = .0308 (błąd Monte Carlo .0005), zgodnie z dokładnym p = .031. Panel A pokazuje dla tych samych tabel statystykę χ². Jej rozkład jest schodkowy – przy 30 osobach wystąpiło tylko 215 różnych wartości – i nie pokrywa się dokładnie z krzywą χ²(4). Na prawo od obserwowanej wartości 11.97 leży 1.6% tabel (błąd Monte Carlo .0004), a krzywa χ²(4) daje .018.
Na co uważać. Panele A i B porządkują te same tabele według różnych kryteriów, więc dają różne p: .016 według χ², .031 według prawdopodobieństwa tabeli. Oba są poprawnymi testami dokładnymi przy ustalonych brzegach. Kryterium wybierz przed analizą i podaj w pracy, a test FFH oznacza kryterium z panelu B. Wykres nie pokazuje, które komórki odpowiadają za związek. Do tego służą skorygowane reszty standaryzowane, opisane we wpisie tabela krzyżowa na wykresie. Skąd się bierze krzywa χ², wyjaśnia wpis skąd się biorą rozkłady t, χ² i F. Ziarno 626 ustalono raz, przed uruchomieniem kodu.
Podpis do pracy:
Kod losuje tabele raz, z ziarnem 626, i liczy oba odsetki z błędem Monte Carlo. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rozkład permutacyjny tabel 3 × 3 o sumach brzegowych z przykładu
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("co najmniej tak skrajne jak obserwowana" = "#D55E00", "pozostałe" = "#BBBBBB")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

tab <- matrix(c(6, 2, 1,
                3, 5, 2,
                1, 2, 7), nrow = 3, byrow = TRUE)          # dane przykładowe z hasła, N = 30
r <- rowSums(tab); k <- colSums(tab); N <- sum(tab); E <- outer(r, k) / N
log_P <- function(t) sum(lfactorial(r)) + sum(lfactorial(k)) - lfactorial(N) - sum(lfactorial(t))
chi2 <- function(t) sum((t - E)^2 / E)

# 100 000 losowych tabel o tych samych sumach brzegowych (losowanie z rozkładu przy H0)
set.seed(626)
B <- 1e5
tabele <- r2dtable(B, r, k)
sym <- data.frame(chi2 = vapply(tabele, chi2, 0), logP = vapply(tabele, log_P, 0))
obs <- c(chi2 = chi2(tab), logP = log_P(tab))

# p z permutacji: odsetek tabel co najmniej tak skrajnych jak obserwowana (z błędem Monte Carlo)
p_mc <- function(x) c(p = mean(x), blad_MC = sqrt(mean(x) * (1 - mean(x)) / B))
round(rbind(FFH_P_tabeli = p_mc(sym$logP <= obs[["logP"]] + 1e-7),
            chi2_permutacyjny = p_mc(sym$chi2 >= obs[["chi2"]] - 1e-7)), 4)
round(c(chi2_obs = obs[["chi2"]], p_chi2_przyblizenie = pchisq(obs[["chi2"]], 4, lower.tail = FALSE),
        p_FFH_dokladne = fisher.test(tab)$p.value), 4)
length(unique(round(sym$chi2, 6)))               # liczba różnych wartości chi2 w próbie tabel

# A: rozkład chi2 w tabelach z permutacji na tle krzywej chi2(4)
sym$skrajna_chi2 <- ifelse(sym$chi2 >= obs[["chi2"]] - 1e-7, names(kol)[1], names(kol)[2])
krzywa <- data.frame(x = seq(0.05, 30, by = 0.05))
krzywa$y <- dchisq(krzywa$x, 4)
pA <- ggplot(sym, aes(chi2)) +
  geom_histogram(aes(y = after_stat(count) / (B * 0.5), fill = skrajna_chi2), binwidth = 0.5, boundary = 0,
                 colour = "white", linewidth = 0.1) +
  geom_line(aes(x, y), data = krzywa, linewidth = 1, linetype = "dashed", colour = "grey15") +
  geom_vline(xintercept = obs[["chi2"]], linewidth = 0.8) +
  annotate("text", x = obs[["chi2"]] + 0.4, y = 0.2, hjust = 0, size = 3.4,
           label = sprintf("obserwowana\nχ² = %.2f\n\nna prawo: %.1f%% tabel", obs[["chi2"]],
                           100 * mean(sym$chi2 >= obs[["chi2"]] - 1e-7))) +
  annotate("text", x = 20, y = 0.07, hjust = 0, size = 3.4, label = "linia przerywana:\nkrzywa χ²(4)") +
  scale_fill_manual(values = kol, name = NULL) +
  coord_cartesian(xlim = c(0, 30)) +
  labs(title = "A. Statystyka χ² w tabelach z permutacji", x = "χ²", y = "Gęstość") +
  motyw

# B: prawdopodobieństwo tabel (skala log10) – test FFH sumuje tabele nie bardziej prawdopodobne
sym$log10P <- sym$logP / log(10)
sym$skrajna_P <- ifelse(sym$logP <= obs[["logP"]] + 1e-7, names(kol)[1], names(kol)[2])
pB <- ggplot(sym, aes(log10P, fill = skrajna_P)) +
  geom_histogram(binwidth = 0.1, boundary = 0, colour = "white", linewidth = 0.1) +
  geom_vline(xintercept = obs[["logP"]] / log(10), linewidth = 0.8) +
  annotate("text", x = obs[["logP"]] / log(10) - 0.1, y = 6200, hjust = 1, size = 3.4,
           label = sprintf("obserwowana\nP = %.6f\n\nna lewo: %.1f%% tabel", exp(obs[["logP"]]),
                           100 * mean(sym$logP <= obs[["logP"]] + 1e-7))) +
  scale_fill_manual(values = kol, name = NULL) +
  scale_x_continuous(labels = function(x) parse(text = paste0("10^", x))) +
  labs(title = "B. Prawdopodobieństwo tabeli przy H0", x = "P(tabela), skala logarytmiczna",
       y = "Liczba tabel (ze 100 000)") +
  motyw

p <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p
Wynik w R
                       p blad_MC
FFH_P_tabeli      0.0308   5e-04
chi2_permutacyjny 0.0160   4e-04
           chi2_obs p_chi2_przyblizenie      p_FFH_dokladne
            11.9688              0.0176              0.0311
[1] 215
Jak opisać w pracy
Na co uważać
- Brak statystyki i df. Test podaje samo p. Siłę związku opisz osobno, np. V Craméra, i pokaż odsetki w tabeli.
- Kategorie uporządkowane. Test pomija kolejność kategorii. Gdy jedna zmienna jest porządkowa, rozważ test trendu Cochrana–Armitage’a.
- Brak pamięci. Przy dużych tabelach
fisher.test()może zgłosić błąd przekroczenia przestrzeni roboczej; zwiększ argumentworkspacealbo użyjsimulate.p.value = TRUE.
Test Fishera–Freemana–Haltona w R
Kod tworzy tabelę 3 × 3, pokazuje liczebności oczekiwane i test χ², a potem test Fishera–Freemana–Haltona funkcją fisher.test() – dokładnie i z p z symulacji Monte Carlo. Na końcu liczy prawdopodobieństwo zaobserwowanej tabeli z wielowymiarowego rozkładu hipergeometrycznego. Liczby w tekście pochodzą z tego kodu.
Test dokładny dla tabeli 3 × 3
R
# Test Fishera-Freemana-Haltona: tabela 3 x 3 z małymi liczebnościami
tab <- matrix(c(6, 2, 1,
                3, 5, 2,
                1, 2, 7), nrow = 3, byrow = TRUE,
              dimnames = list(kierunek = c("psychologia", "pedagogika", "socjologia"),
                              metoda = c("ankieta", "wywiad", "eksperyment")))
round(chisq.test(tab)$expected, 2)            # liczebności oczekiwane
suppressWarnings(chisq.test(tab))             # przybliżenie chi-kwadrat
fisher.test(tab)                              # test Fishera-Freemana-Haltona (dokładny)
set.seed(626)
fisher.test(tab, simulate.p.value = TRUE, B = 1e5)  # p z symulacji Monte Carlo
# Prawdopodobieństwo zaobserwowanej tabeli przy H0 (wielowymiarowy rozkład hipergeometryczny)
P_obs <- exp(sum(lfactorial(rowSums(tab))) + sum(lfactorial(colSums(tab))) -
             lfactorial(sum(tab)) - sum(lfactorial(tab)))
signif(P_obs, 3)
Wynik w R
             metoda
kierunek      ankieta wywiad eksperyment
  psychologia    3.10   2.79        3.10
  pedagogika     3.45   3.10        3.45
  socjologia     3.45   3.10        3.45
Warning message:
In chisq.test(tab) : Chi-squared approximation may be incorrect

	Pearson's Chi-squared test

data:  tab
X-squared = 11.969, df = 4, p-value = 0.01759


	Fisher's Exact Test for Count Data

data:  tab
p-value = 0.03106
alternative hypothesis: two.sided


	Fisher's Exact Test for Count Data with simulated p-value (based on
	1e+05 replicates)

data:  tab
p-value = 0.03078
alternative hypothesis: two.sided

[1] 0.000124
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersję R i pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy zamiast testu chi-kwadrat użyć testu Fishera–Freemana–Haltona?
Gdy tabela jest większa niż 2 × 2, a wiele komórek ma małe liczebności oczekiwane, zwłaszcza poniżej 5 lub 1. Wtedy przybliżenie rozkładem χ² bywa niedokładne, a test dokładny podaje p bez tego przybliżenia.
Jak wykonać test Fishera–Freemana–Haltona w R?
Wystarczy fisher.test(tabela) dla tabeli większej niż 2 × 2. Przy dużych tabelach dodaj simulate.p.value = TRUE i liczbę replikacji B albo zwiększ argument workspace.
Czym test Fishera–Freemana–Haltona różni się od testu Barnarda?
Test Fishera–Freemana–Haltona warunkuje na obu sumach brzegowych i działa dla tabel r × c. Test Barnarda jest testem bezwarunkowym, zwykle stosowanym do tabel 2 × 2 i często o większej mocy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Chi-kwadrat czy test Fishera?
Reguła Cochrana, test Fishera i Fishera–Freemana–Haltona, chi-kwadrat z symulowanym p, łączenie kategorii i spór o poprawkę Yatesa – z przykładem w R.
Czytaj →PoradnikKalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A. (1992). A survey of exact inference for contingency tables. Statistical Science, 7(1), 131–153. https://doi.org/10.1214/ss/1177011454 ● Otwarty dostęp
- Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1–2), 141–149. https://doi.org/10.1093/biomet/38.1-2.141
- Mehta, C. R., & Patel, N. R. (1983). A network algorithm for performing Fisher’s exact test in r × c contingency tables. Journal of the American Statistical Association, 78(382), 427–434. https://doi.org/10.1080/01621459.1983.10477989
Cytowania BibTeX
@article{agresti1992survey, author={Agresti, Alan}, title={{A survey of exact inference for contingency tables}}, journal={Statistical Science}, year={1992}, volume={7}, number={1}, pages={131--153}, doi={10.1214/ss/1177011454}}@article{freeman1951note, author={Freeman, G. H. and Halton, J. H.}, title={{Note on an exact treatment of contingency, goodness of fit and other problems of significance}}, journal={Biometrika}, year={1951}, volume={38}, number={1–2}, pages={141--149}, doi={10.1093/biomet/38.1-2.141}}@article{mehta1983network, author={Mehta, Cyrus R. and Patel, Nitin R.}, title={{A network algorithm for performing Fisher’s exact test in r × c contingency tables}}, journal={Journal of the American Statistical Association}, year={1983}, volume={78}, number={382}, pages={427--434}, doi={10.1080/01621459.1983.10477989}}