Co to jest test G?
Test G (ang. G-test, test ilorazu wiarygodności dla tabel krzyżowych, statystyka G² lub L²) sprawdza niezależność zmiennych w tabeli krzyżowej albo zgodność liczebności z zakładanymi proporcjami. To szczególny przypadek testu ilorazu wiarygodności: porównuje model niezależności z modelem nasyconym. Woolf (1957) opisał jego podstawy i podał tablice do badania heterogeniczności tabel; wtedy zaletą była szybkość obliczeń w porównaniu z testem Pearsona.
Wzór
G = 2 Σ O · ln(O/E), gdzie O to liczebności obserwowane, a E – oczekiwane przy niezależności. Stopnie swobody są takie same jak w teście chi-kwadrat niezależności: (r − 1)(c − 1). Przy dużych próbach G i χ² Pearsona dają prawie te same wyniki. Wersja dla jednej zmiennej odpowiada testowi chi-kwadrat zgodności. Hasło informacja wzajemna opisuje ten sam związek od strony miary: G = 2N · I (w natach). Statystyka G jest addytywna: rozkłada się na części dla podtabel, co wykorzystuje analiza logliniowa.
Przykład w R
Po 50 osób w trzech grupach wieku odpowiedziało „tak” w 60%, 36% i 24% przypadków (dane przykładowe). G(2) = 14.15, p < .001; χ²(2) = 14.00. Z poprawką Williamsa G = 13.96. Podział: porównanie grup 18–29 i 30–49 daje G(1) = 5.83, a połączonych młodszych z grupą 50+ – G(1) = 8.33; razem 14.15.
Na rysunku
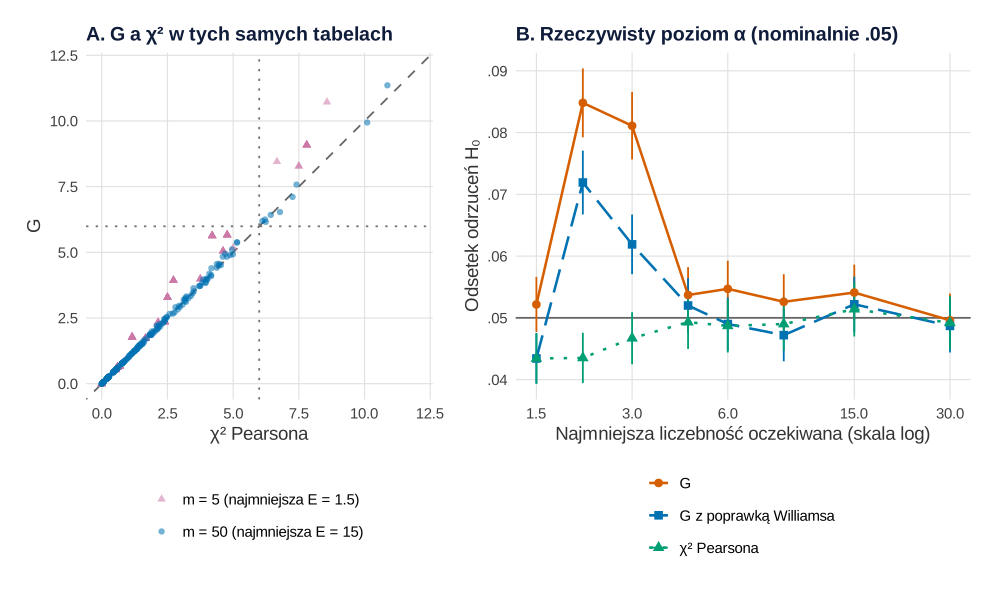
set.seed(627)).Co widać. Symulacja dotyczy tabeli jak w przykładzie: trzy grupy po m osób, w każdej prawdopodobieństwo odpowiedzi „tak” wynosi 0.3, więc H₀ jest prawdziwa. Przy 50 osobach w grupie (najmniejsza liczebność oczekiwana E = 15) punkty w panelu A leżą na przekątnej: G i χ² są prawie równe. Przy 5 osobach w grupie G jest zwykle większe od χ². Panel B pokazuje skutek. Przy E = 2.1 test G odrzucał prawdziwą H₀ w 8.5% tabel, z poprawką Williamsa w 7.2%, a χ² w 4.4% (błąd Monte Carlo ok. 0.3 punktu procentowego). W 4.1% tabel G był istotny, a χ² nie. Od E = 4.5 wszystkie trzy testy trzymają się blisko .05. To obraz wyniku Larntza (1978). Prawdopodobieństwo 0.3 i liczebności grup wybrano ręcznie.
Na co uważać. Przy E = 1.5 G ma znów α = .052, ale to nie znaczy, że przy bardzo małych liczebnościach test działa dobrze. Możliwych tabel jest wtedy mało, a rozmiar testu skacze z jednej liczebności na drugą. W 52 z 10 000 tabel nikt nie odpowiedział „tak” i statystyki nie dało się policzyć – pominięto je. Rysunek dotyczy jednego układu (3 × 2, równe grupy, jednakowa proporcja). Przy innym kształcie tabeli granica może leżeć gdzie indziej, a moc obu testów nie jest tu pokazana. Przy małych E wybierz test dokładny albo test Fishera–Freemana–Haltona. Jak pokazać samą tabelę, opisuje wpis tabela krzyżowa na wykresie.
Podpis do pracy:
Kod losuje tabele z ziarnem ustalonym raz (set.seed(627), numer hasła) i liczy G z poprawką Williamsa ręcznie; na tabeli z przykładu daje te same 14.15, 13.96 i 14.00. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Test G a chi-kwadrat Pearsona przy małych i dużych liczebnościach oczekiwanych
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c("G" = "#D55E00", "G z poprawką Williamsa" = "#0072B2", "χ² Pearsona" = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Statystyki G, G z poprawką Williamsa i chi-kwadrat dla tabeli r x c
statystyki <- function(t) {
  N <- sum(t); r <- nrow(t); k <- ncol(t)
  E <- outer(rowSums(t), colSums(t)) / N
  G <- 2 * sum(ifelse(t > 0, t * log(t / E), 0))                 # 0 · ln 0 = 0
  X2 <- sum((t - E)^2 / E)
  q <- 1 + (N * sum(1 / rowSums(t)) - 1) * (N * sum(1 / colSums(t)) - 1) / (6 * N * (r - 1) * (k - 1))
  c(G = G, G_Williams = G / q, X2 = X2)
}
# Kontrola na tabeli z przykładu: 14.15, 13.96 i 14.00
tab <- matrix(c(30, 20, 18, 32, 12, 38), nrow = 3, byrow = TRUE)
round(statystyki(tab), 3)

# Symulacja przy prawdziwej H0: 3 grupy po m osób, w każdej P("tak") = 0.3
set.seed(627)
R <- 10000; p_tak <- 0.3; m_siatka <- c(5, 7, 10, 15, 20, 30, 50, 100)
sym <- lapply(m_siatka, function(m) {
  tak <- matrix(rbinom(3 * R, m, p_tak), ncol = 3)                  # wiersz = jedna replikacja
  s <- t(apply(tak, 1, function(x) {
    t <- cbind(x, m - x)
    if (any(colSums(t) == 0)) return(c(G = NA, G_Williams = NA, X2 = NA))  # tabela bez jednej kolumny
    statystyki(t)
  }))
  data.frame(m = m, E_min = m * p_tak, s)
})
sym <- do.call(rbind, sym)

# Rzeczywisty odsetek odrzuceń H0 przy alfa = .05 (df = 2) i błąd Monte Carlo
kryt <- qchisq(0.95, df = 2)
alfa <- do.call(rbind, lapply(split(sym, sym$m), function(d) {
  ok <- !is.na(d$G)
  a <- c(G = mean(d$G[ok] > kryt), "G z poprawką Williamsa" = mean(d$G_Williams[ok] > kryt),
         "χ² Pearsona" = mean(d$X2[ok] > kryt))
  data.frame(m = d$m[1], E_min = d$E_min[1], test = names(a), alfa = a,
             blad_MC = sqrt(a * (1 - a) / sum(ok)), pominiete = sum(!ok))
}))
alfa$test <- factor(alfa$test, levels = names(kol))
print(within(alfa, { alfa <- round(alfa, 4); blad_MC <- round(blad_MC, 4) }), row.names = FALSE)

# Jak często G odrzuca H0, a chi-kwadrat nie (ta sama tabela)?
round(sapply(split(sym, sym$m), function(d) mean(d$G > kryt & d$X2 <= kryt, na.rm = TRUE)), 4)

# A: G a chi-kwadrat w tych samych tabelach (po 200 replikacji dla m = 5 i m = 50)
pary <- subset(sym, m %in% c(5, 50) & !is.na(G))
pary <- do.call(rbind, lapply(split(pary, pary$m), head, 200))
pary$uklad <- factor(ifelse(pary$m == 5, "m = 5 (najmniejsza E = 1.5)", "m = 50 (najmniejsza E = 15)"),
                     levels = c("m = 5 (najmniejsza E = 1.5)", "m = 50 (najmniejsza E = 15)"))
pA <- ggplot(pary, aes(X2, G, colour = uklad, shape = uklad)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", colour = "grey40") +
  geom_vline(xintercept = kryt, linetype = "dotted", colour = "grey45") +
  geom_hline(yintercept = kryt, linetype = "dotted", colour = "grey45") +
  geom_point(alpha = 0.55, size = 1.8) +
  scale_colour_manual(values = c("#CC79A7", "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  coord_equal(xlim = c(0, 12), ylim = c(0, 12)) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(title = "A. G a χ² w tych samych tabelach", x = "χ² Pearsona", y = "G") +
  motyw

# B: rzeczywisty poziom alfa w funkcji najmniejszej liczebności oczekiwanej
pB <- ggplot(alfa, aes(E_min, alfa, colour = test, shape = test, linetype = test)) +
  geom_hline(yintercept = 0.05, colour = "grey40") +
  geom_errorbar(aes(ymin = alfa - 2 * blad_MC, ymax = alfa + 2 * blad_MC), width = 0, linetype = "solid") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(16, 15, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotted"), name = NULL) +
  scale_x_log10(breaks = c(1.5, 3, 6, 15, 30)) +
  scale_y_continuous(labels = function(x) sub("^0", "", sprintf("%.2f", x))) +
  guides(colour = guide_legend(ncol = 1)) +
  labs(title = "B. Rzeczywisty poziom α (nominalnie .05)", x = "Najmniejsza liczebność oczekiwana (skala log)",
       y = "Odsetek odrzuceń H₀") +
  motyw

p <- pA + pB
p
Wynik w R
         G G_Williams         X2
    14.153     13.956     14.000
   m E_min                   test   alfa blad_MC pominiete
   5   1.5                      G 0.0522  0.0022        52
   5   1.5 G z poprawką Williamsa 0.0434  0.0020        52
   5   1.5            χ² Pearsona 0.0434  0.0020        52
   7   2.1                      G 0.0848  0.0028         2
   7   2.1 G z poprawką Williamsa 0.0719  0.0026         2
   7   2.1            χ² Pearsona 0.0435  0.0020         2
  10   3.0                      G 0.0811  0.0027         0
  10   3.0 G z poprawką Williamsa 0.0619  0.0024         0
  10   3.0            χ² Pearsona 0.0467  0.0021         0
  15   4.5                      G 0.0537  0.0023         0
  15   4.5 G z poprawką Williamsa 0.0520  0.0022         0
  15   4.5            χ² Pearsona 0.0493  0.0022         0
  20   6.0                      G 0.0547  0.0023         0
  20   6.0 G z poprawką Williamsa 0.0490  0.0022         0
  20   6.0            χ² Pearsona 0.0487  0.0022         0
  30   9.0                      G 0.0526  0.0022         0
  30   9.0 G z poprawką Williamsa 0.0472  0.0021         0
  30   9.0            χ² Pearsona 0.0490  0.0022         0
  50  15.0                      G 0.0541  0.0023         0
  50  15.0 G z poprawką Williamsa 0.0522  0.0022         0
  50  15.0            χ² Pearsona 0.0514  0.0022         0
 100  30.0                      G 0.0496  0.0022         0
 100  30.0 G z poprawką Williamsa 0.0487  0.0022         0
 100  30.0            χ² Pearsona 0.0492  0.0022         0
     5      7     10     15     20     30     50    100
0.0087 0.0413 0.0344 0.0079 0.0075 0.0049 0.0044 0.0013
Jak opisać w pracy
Na co uważać
- Małe liczebności. Larntz (1978) pokazał, że przy umiarkowanych liczebnościach oczekiwanych test ilorazu wiarygodności odrzuca hipotezę zerową częściej niż nominalne α, a χ² Pearsona trzyma się poziomu nominalnego. Williams (1976) zaproponował mnożnik, który poprawia przybliżenie rozkładem χ². Przy bardzo małych liczebnościach wybierz test dokładny.
- Zera. Komórka z O = 0 wnosi do sumy 0 (przyjmuje się 0 · ln 0 = 0). W ręcznym kodzie R takie komórki dają
NaN, więc użyjsum(..., na.rm = TRUE). - Siła związku. Sam test nie mówi, jak silny jest związek – pokaż odsetki i miarę efektu.
Test G w R
Kod liczy statystykę G ręcznie ze wzoru 2 Σ O ln(O/E), porównuje ją z chisq.test() i funkcją GTest() z pakietu DescTools (bez poprawki i z poprawką Williamsa), a na końcu sprawdza addytywność G dla dwóch podtabel. Liczby w tekście pochodzą z tego kodu.
Test G dla tabeli 3 × 2
R
# Test G (iloraz wiarygodności) dla tabeli krzyżowej 3 x 2
library(DescTools)
tab <- matrix(c(30, 20,
                18, 32,
                12, 38), nrow = 3, byrow = TRUE,
              dimnames = list(wiek = c("18-29", "30-49", "50+"),
                              odpowiedz = c("tak", "nie")))
E_ <- outer(rowSums(tab), colSums(tab)) / sum(tab)  # liczebności oczekiwane
G <- 2 * sum(tab * log(tab / E_))                   # G = 2 * suma O * ln(O / E)
df <- (nrow(tab) - 1) * (ncol(tab) - 1)
round(c(G = G, df = df, p = pchisq(G, df, lower.tail = FALSE)), 4)
chisq.test(tab)                                     # chi-kwadrat Pearsona
GTest(tab)                                          # test G (DescTools)
GTest(tab, correct = "williams")                    # z poprawką Williamsa
# Addytywność: G dla podtabel (18-29 vs 30-49) i (połączone vs 50+)
G2 <- function(t) { e <- outer(rowSums(t), colSums(t)) / sum(t); 2 * sum(t * log(t / e)) }
g1 <- G2(tab[1:2, ]); g2 <- G2(rbind(colSums(tab[1:2, ]), tab[3, ]))
round(c(G_1 = g1, G_2 = g2, suma = g1 + g2), 4)
Wynik w R
      G      df       p
14.1525  2.0000  0.0008

	Pearson's Chi-squared test

data:  tab
X-squared = 14, df = 2, p-value = 0.0009119


	Log likelihood ratio (G-test) test of independence without correction

data:  tab
G = 14.153, X-squared df = 2, p-value = 0.0008449


	Log likelihood ratio (G-test) test of independence with Williams'
	correction

data:  tab
G = 13.956, X-squared df = 2, p-value = 0.0009321

    G_1     G_2    suma
 5.8264  8.3261 14.1525
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet DescTools 0.99.60). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test G różni się od testu chi-kwadrat Pearsona?
Oba porównują liczebności obserwowane z oczekiwanymi i mają te same stopnie swobody. Pearson sumuje (O − E)²/E, a test G – 2 O ln(O/E). W dużych próbach wyniki są prawie takie same; w małych χ² Pearsona lepiej trzyma nominalny poziom istotności.
Gdzie znaleźć test G w SPSS i R?
W SPSS to wiersz Likelihood Ratio w tabeli testów chi-kwadrat procedury Crosstabs. W R policzysz go ręcznie ze wzoru albo funkcją GTest() z pakietu DescTools, także z poprawką Williamsa.
Co daje poprawka Williamsa w teście G?
Dzieli statystykę G przez czynnik nieco większy od 1, dzięki czemu jej rozkład lepiej przybliża rozkład χ² w mniejszych próbach. Wynik jest nieco mniejszy i bardziej zachowawczy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test chi-kwadrat krok po kroku
Test zgodności i niezależności na jednym badaniu: odsetki, liczebności oczekiwane, reszty, V Craméra, test Fishera i gotowy opis APA.
Czytaj →PoradnikChi-kwadrat w SPSS krok po kroku
Crosstabs w SPSS od pliku po opis APA: opcje Statistics i Cells, wiersz Pearsona, V Craméra, reszty skorygowane, test dokładny, Weight Cases i składnia CROSSTABS – z plikiem .sav.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Larntz, K. (1978). Small-sample comparisons of exact levels for chi-squared goodness-of-fit statistics. Journal of the American Statistical Association, 73(362), 253–263. https://doi.org/10.1080/01621459.1978.10481567
- Williams, D. A. (1976). Improved likelihood ratio tests for complete contingency tables. Biometrika, 63(1), 33–37. https://doi.org/10.1093/biomet/63.1.33
- Woolf, B. (1957). The log likelihood ratio test (the G-test). Annals of Human Genetics, 21(4), 397–409. https://doi.org/10.1111/j.1469-1809.1972.tb00293.x
Cytowania BibTeX
@article{larntz1978small, author={Larntz, Kinley}, title={{Small-sample comparisons of exact levels for chi-squared goodness-of-fit statistics}}, journal={Journal of the American Statistical Association}, year={1978}, volume={73}, number={362}, pages={253--263}, doi={10.1080/01621459.1978.10481567}}@article{williams1976improved, author={Williams, D. A.}, title={{Improved likelihood ratio tests for complete contingency tables}}, journal={Biometrika}, year={1976}, volume={63}, number={1}, pages={33--37}, doi={10.1093/biomet/63.1.33}}@article{woolf1957log, author={Woolf, Barnet}, title={{The log likelihood ratio test (the G-test)}}, journal={Annals of Human Genetics}, year={1957}, volume={21}, number={4}, pages={397--409}, doi={10.1111/j.1469-1809.1972.tb00293.x}}