Co to jest informacja wzajemna?
Informacja wzajemna (ang. mutual information) I(X; Y) mówi, o ile zmniejsza się niepewność jednej zmiennej, gdy znamy wartość drugiej. Wywodzi się z teorii komunikacji Shannona (1948), w której niepewność mierzy entropia. Wynik podaje się w bitach (logarytm o podstawie 2) lub w natach (logarytm naturalny).
Wzór i własności
I(X; Y) = H(X) + H(Y) − H(X, Y) = Σ p(x, y) log [p(x, y) / (p(x)p(y))]. To dywergencja Kullbacka–Leiblera rozkładu łącznego od iloczynu rozkładów brzegowych. Miara jest nieujemna i symetryczna, a zero osiąga tylko przy niezależności. Dla tablicy krzyżowej o liczebności N statystyka G = 2N·I (w natach), czyli statystyka testu ilorazu wiarygodności dla niezależności.
Przykład
Dwie grupy po 60 osób wybierają jedną z trzech opcji (A: 40, 10, 10; B: 15, 25, 20). H(X) = 1 bit, H(Y) = 1.534 bita, H(X, Y) = 2.403 bita, więc I = 0.131 bita (0.091 nata). Test G daje G = 21.83, df = 2, p < .001 (chi-kwadrat Pearsona: 21.13). Wartość I nie przekracza min(H(X), H(Y)) – tu 1 bita – więc jej skala zależy od liczby kategorii; dlatego często dzieli się ją przez entropię, jak we współczynniku niepewności Theila; obok można podać V Craméra.
Zmienne ciągłe
Dla zmiennych ciągłych najprostsza metoda dzieli wartości na przedziały, ale wynik zależy wtedy od ich liczby. Kraskov i in. (2004) zaproponowali estymatory oparte na odległościach do k najbliższych sąsiadów, które mają małe obciążenie i przy niezależnych zmiennych dają wartości bliskie zeru. Podobnie jak korelacja odległościowa, informacja wzajemna wykrywa zależności nieliniowe.
Na rysunku
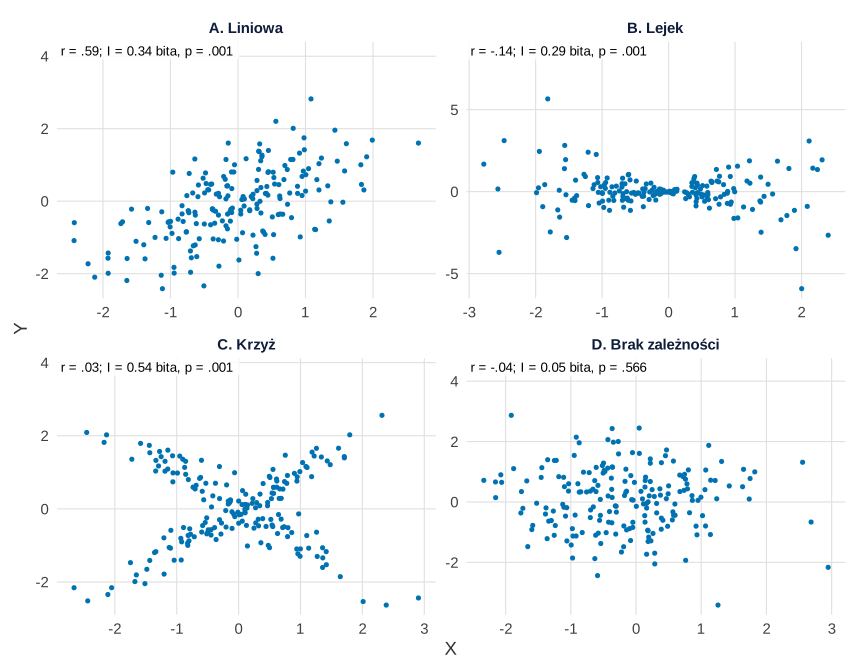
Co widać. Korelacja Pearsona wychwytuje tylko zależność liniową (r = .59); w lejku i krzyżu wynosi −.14 i .03. Informacja wzajemna liczona po podziale obu zmiennych na pięć przedziałów o równej liczebności jest wyraźnie dodatnia we wszystkich trzech zależnościach (od 0.29 do 0.54 bita, p = .001 w teście permutacyjnym, 999 permutacji), a dla zmiennych niezależnych wynosi 0.05 bita, p = .566.
Na co uważać. Przy niezależności I z próby też jest dodatnia (95. percentyl rozkładu permutacyjnego to około 0.10 bita), więc rozstrzyga test, nie sama liczba. I nie mówi też, jaki jest kształt związku; widać go tylko na wykresie rozrzutu. Kształty i szum ustalono ręcznie, ziarna nie zmieniano. Inne wzorce (parabola, okrąg, fala) pokazuje hasło korelacja odległościowa.
Podpis do pracy:
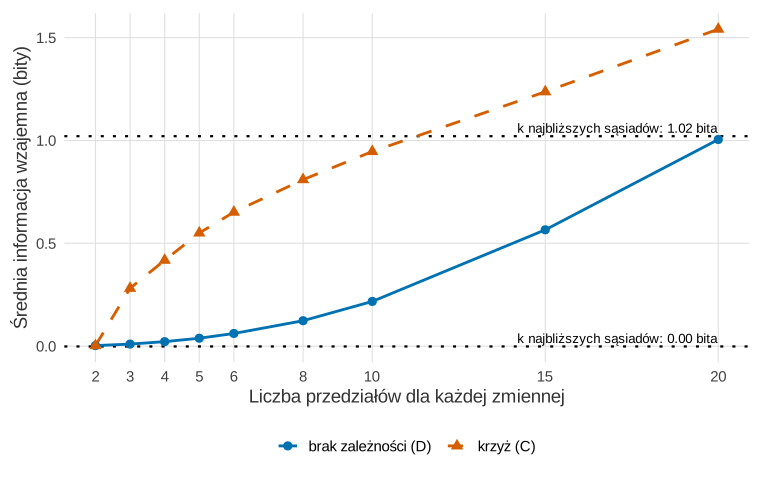
Co widać. Wynik zależy od liczby przedziałów. Dla zmiennych niezależnych średnia rośnie od 0.003 bita przy dwóch przedziałach przez 0.22 przy dziesięciu do 1.01 przy dwudziestu – to obciążenie przy małych liczebnościach komórek. Dla krzyża dwa przedziały dają tylko 0.003 bita, bo podział na połowy nie widzi symetrycznego wzoru. Estymator najbliższych sąsiadów (Kraskov i in., 2004; k = 5) nie potrzebuje przedziałów i daje średnio 0.00 bita przy niezależności oraz 1.02 bita dla krzyża.
Na co uważać. Liczbę przedziałów ustal przed analizą i porównuj I tylko przy tej samej liczbie przedziałów i podobnym N.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: informacja wzajemna przy różnych wzorcach zależności i jej zależność od liczby przedziałów
library(infotheo)   # mutinformation(), discretize()
# z pakietu FNN używamy tylko FNN::mutinfo() (estymator k najbliższych sąsiadów)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(punkty = "#0072B2", niezalezne = "#0072B2", krzyz = "#D55E00", knn = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA))
# informacja wzajemna w bitach po podziale obu zmiennych na k przedziałów o równej liczebności
mi_bity <- function(x, y, k = 5) {
  mutinformation(discretize(x, "equalfreq", k)[[1]], discretize(y, "equalfreq", k)[[1]]) / log(2)
}
# cztery wzorce zależności (kształty i szum ustalone ręcznie)
wzorce <- function(n) {
  x1 <- rnorm(n); y1 <- 0.6 * x1 + rnorm(n, sd = 0.8)                 # liniowa
  x2 <- rnorm(n); y2 <- x2 * rnorm(n)                                   # lejek: rośnie rozrzut
  x3 <- rnorm(n); y3 <- sample(c(-1, 1), n, TRUE) * x3 + rnorm(n, sd = 0.3)  # krzyż: dwie proste
  x4 <- rnorm(n); y4 <- rnorm(n)                                        # zmienne niezależne
  list(x = list(x1, x2, x3, x4), y = list(y1, y2, y3, y4))
}

# Rysunek 1: cztery zbiory po n = 200, MI z 5 przedziałów i test permutacyjny (999 permutacji)
set.seed(6191)
n <- 200
w <- wzorce(n)
nazwy <- c("A. Liniowa", "B. Lejek", "C. Krzyż", "D. Brak zależności")
dane <- data.frame(x = unlist(w$x), y = unlist(w$y),
                   panel = factor(rep(nazwy, each = n), levels = nazwy))
wyniki <- do.call(rbind, lapply(1:4, function(i) {
  x <- w$x[[i]]; y <- w$y[[i]]
  obs <- mi_bity(x, y)
  perm <- replicate(999, mi_bity(x, sample(y)))
  data.frame(panel = nazwy[i], r = cor(x, y), MI_bity = obs,
             perm_95 = unname(quantile(perm, .95)), p = (sum(perm >= obs) + 1) / 1000)
}))
print(transform(wyniki, r = round(r, 3), MI_bity = round(MI_bity, 3),
                perm_95 = round(perm_95, 3), p = round(p, 3)), row.names = FALSE)
wyniki$panel <- factor(wyniki$panel, levels = nazwy)
wyniki$etyk <- sprintf("r = %s;  I = %.2f bita, p %s", sub("0\\.", ".", sprintf("%.2f", wyniki$r)),
                       wyniki$MI_bity,
                       ifelse(wyniki$p < .001, "< .001", paste("=", sub("0\\.", ".", sprintf("%.3f", wyniki$p)))))
p1 <- ggplot(dane, aes(x, y)) +
  geom_point(colour = kol[["punkty"]], size = 1.4, shape = 16) +
  geom_label(data = wyniki, aes(x = -Inf, y = Inf, label = etyk), hjust = 0, vjust = 1,
             size = 3.5, linewidth = 0, fill = "white", alpha = 0.85) +
  facet_wrap(~ panel, ncol = 2, scales = "free") +
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.3))) +
  labs(x = "X", y = "Y") + motyw

# Rysunek 2: średnia MI z przedziałów vs liczba przedziałów (500 prób n = 300 dla każdego k)
# oraz estymator k najbliższych sąsiadów (Kraskov i in., k = 5) dla tych samych prób
set.seed(6192)
ks <- c(2, 3, 4, 5, 6, 8, 10, 15, 20)
sym <- do.call(rbind, lapply(1:500, function(rep) {
  w <- wzorce(300)
  do.call(rbind, lapply(c(4, 3), function(i) {
    x <- w$x[[i]]; y <- w$y[[i]]
    data.frame(wzorzec = ifelse(i == 4, "brak zależności (D)", "krzyż (C)"),
               k = ks, MI = sapply(ks, function(k) mi_bity(x, y, k)),
               knn = FNN::mutinfo(x, y, k = 5) / log(2))
  }))
}))
podsum <- aggregate(cbind(MI, knn) ~ wzorzec + k, data = sym, FUN = mean)
print(transform(podsum, MI = round(MI, 3), knn = round(knn, 3)), row.names = FALSE)
podsum$wzorzec <- factor(podsum$wzorzec, levels = c("brak zależności (D)", "krzyż (C)"))
knn_sr <- aggregate(knn ~ wzorzec, data = podsum, FUN = mean)
p2 <- ggplot(podsum, aes(k, MI, colour = wzorzec, shape = wzorzec, linetype = wzorzec)) +
  geom_hline(data = knn_sr, aes(yintercept = knn), colour = kol[["knn"]], linetype = "dotted",
             linewidth = 0.8) +
  annotate("text", x = 20, y = knn_sr$knn + 0.04, hjust = 1, size = 3.5,
           label = paste0("k najbliższych sąsiadów: ", sprintf("%.2f", round(knn_sr$knn, 2) + 0), " bita")) +
  geom_line(linewidth = 1) + geom_point(size = 2.8) +
  scale_x_continuous(breaks = ks) +
  scale_colour_manual(values = unname(kol[c("niezalezne", "krzyz")]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(x = "Liczba przedziałów dla każdej zmiennej", y = "Średnia informacja wzajemna (bity)") + motyw

p1   # zapis: ggsave("informacja-wzajemna-wzorce.svg", p1, width = 9, height = 7)
p2   # zapis: ggsave("informacja-wzajemna-przedzialy.svg", p2, width = 8, height = 5)
Wynik w R
              panel      r MI_bity perm_95     p
         A. Liniowa  0.587   0.344   0.096 0.001
           B. Lejek -0.140   0.290   0.100 0.001
           C. Krzyż  0.029   0.544   0.095 0.001
 D. Brak zależności -0.042   0.054   0.098 0.566
             wzorzec  k    MI    knn
 brak zależności (D)  2 0.003 -0.002
           krzyż (C)  2 0.003  1.021
 brak zależności (D)  3 0.010 -0.002
           krzyż (C)  3 0.281  1.021
 brak zależności (D)  4 0.022 -0.002
           krzyż (C)  4 0.418  1.021
 brak zależności (D)  5 0.039 -0.002
           krzyż (C)  5 0.550  1.021
 brak zależności (D)  6 0.062 -0.002
           krzyż (C)  6 0.652  1.021
 brak zależności (D)  8 0.124 -0.002
           krzyż (C)  8 0.810  1.021
 brak zależności (D) 10 0.217 -0.002
           krzyż (C) 10 0.946  1.021
 brak zależności (D) 15 0.566 -0.002
           krzyż (C) 15 1.237  1.021
 brak zależności (D) 20 1.005 -0.002
           krzyż (C) 20 1.541  1.021
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Na co uważać
- Obciążenie w małych próbach. Prosty estymator z częstości zawyża I, zwłaszcza przy wielu kategoriach i małym N.
- Brak kierunku i znaku. I nie mówi, która kategoria idzie w parze z którą – pokaż tablicę.
- Jednostki. Zawsze podaj, czy wynik jest w bitach, czy w natach.
Informacja wzajemna w R
Kod liczy entropie i informację wzajemną ręcznie z tablicy krzyżowej, a potem statystykę G = 2N·I i jej p. Funkcja infotheo::mutinformation() daje ten sam wynik co obliczenie ręczne (0.0910 nata = 0.1312 bita, G = 21.83).
Entropie, informacja wzajemna i test G
R
# Informacja wzajemna z tablicy krzyżowej, związek z entropią i testem G
tab <- matrix(c(40, 10, 10,
                15, 25, 20), nrow = 2, byrow = TRUE,
              dimnames = list(grupa = c("A", "B"), wybor = c("y1", "y2", "y3")))
N <- sum(tab); p <- tab / N
px <- rowSums(p); py <- colSums(p)
H <- function(q) -sum(q[q > 0] * log2(q[q > 0]))        # entropia w bitach
MI_bit <- sum(p * log2(p / outer(px, py)))              # informacja wzajemna
MI_nat <- MI_bit * log(2)                                # ta sama wartość w natach
G <- 2 * N * MI_nat                                      # statystyka G (iloraz wiarygodności)
df <- (nrow(tab) - 1) * (ncol(tab) - 1)
round(c(H_X = H(px), H_Y = H(py), H_XY = H(p),
        MI_z_entropii = H(px) + H(py) - H(p), MI_bit = MI_bit,
        G = G,
        chi2 = unname(chisq.test(tab)$statistic)), 4)
signif(pchisq(G, df, lower.tail = FALSE), 3)                # p dla testu G, df = 2
# To samo z pakietu infotheo: dane surowe odtworzone z tablicy, wynik w natach
library(infotheo)
x <- rep(rep(1:2, 3), times = c(tab)); y <- rep(rep(1:3, each = 2), times = c(tab))
MI_infotheo <- mutinformation(x, y)
round(c(MI_nat = MI_infotheo, MI_bit = MI_infotheo / log(2), G = 2 * N * MI_infotheo), 4)
Wynik w R
          H_X           H_Y          H_XY MI_z_entropii        MI_bit
       1.0000        1.5343        2.4031        0.1312        0.1312
            G          chi2
      21.8308       21.1255
[1] 1.82e-05
 MI_nat  MI_bit       G
 0.0910  0.1312 21.8308
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem infotheo 1.2.0.1; rysunki policzono pakietami infotheo i FNN (estymator najbliższych sąsiadów) i wykonano w pakiecie ggplot2, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- infotheo (wersja 1.2.0.1): Meyer, P. E. (2022). infotheo: Information-theoretic measures (R package version 1.2.0.1) [Computer software]. https://doi.org/10.32614/CRAN.package.infotheo
- FNN (wersja 1.1.4.1): Beygelzimer, A., Kakadet, S., Langford, J., Arya, S., Mount, D., & Li, S. (2024). FNN: Fast nearest neighbor search algorithms and applications [R package]. https://doi.org/10.32614/CRAN.package.FNN
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym informacja wzajemna różni się od korelacji Pearsona?
Korelacja Pearsona mierzy tylko zależność liniową dwóch zmiennych ilościowych. Informacja wzajemna wychwytuje każdy rodzaj zależności, także nieliniowy i między kategoriami, ale nie ma znaku ani kierunku.
Jak zinterpretować informację wzajemną równą 0.13 bita?
Znajomość jednej zmiennej zmniejsza niepewność drugiej średnio o 0.13 bita. Żeby ocenić, czy to dużo, podziel wynik przez entropię przewidywanej zmiennej, jak we współczynniku niepewności Theila.
Jak sprawdzić, czy informacja wzajemna jest istotna?
Dla zmiennych kategorialnych policz G = 2N·I (I w natach) i porównaj z rozkładem chi-kwadrat o (r − 1)(c − 1) stopniach swobody. Przy małych liczebnościach lepiej użyć testu permutacyjnego.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kraskov, A., Stögbauer, H., & Grassberger, P. (2004). Estimating mutual information. Physical Review E, 69(6), Article 066138. https://doi.org/10.1103/physreve.69.066138 ● Otwarty dostęp
- Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Cytowania BibTeX
@article{kraskov2004estimating, author={Kraskov, Alexander and Stögbauer, Harald and Grassberger, Peter}, title={{Estimating mutual information}}, journal={Physical Review E}, year={2004}, volume={69}, number={6}, eid={066138}, doi={10.1103/physreve.69.066138}}@article{shannon1948mathematical, author={Shannon, Claude E.}, title={{A mathematical theory of communication}}, journal={Bell System Technical Journal}, year={1948}, volume={27}, number={3}, pages={379--423}, doi={10.1002/j.1538-7305.1948.tb01338.x}}