Co to jest korelacja odległościowa?
Korelacja odległościowa (ang. distance correlation, dCor) to miara zależności między dwiema zmiennymi, a także między wektorami zmiennych dowolnego, niekoniecznie równego wymiaru. W populacji jest równa zero wtedy i tylko wtedy, gdy zmienne są niezależne (Székely i in., 2007; Székely i Rizzo, 2009). Przyjmuje wartości od 0 do 1 i nie ma znaku. Tym różni się od korelacji Pearsona, która wykrywa tylko związek liniowy, i od korelacji Spearmana, która wykrywa związek monotoniczny.
Jak się ją liczy
- Dla każdej zmiennej tworzy się macierz odległości euklidesowych między wszystkimi parami osób.
- Każdą macierz centruje się podwójnie: od elementu odejmuje się średnią jego wiersza i kolumny oraz dodaje średnią całej macierzy.
- Średnia iloczynów odpowiadających sobie elementów to kwadrat kowariancji odległościowej, a jej standaryzacja przez wariancje odległościowe daje dCor.
Przykład w R: parabola
W 100 symulowanych obserwacjach y = x² + szum. Korelacja Pearsona wynosi r = .008, choć związek jest silny, a dCor = .524; test permutacyjny (999 permutacji) daje p = .001. Dla zmiennej niezależnej od x otrzymano r = −.024 i dCor = .188, p = .311. Wartość dCor z próby jest dodatnia nawet przy niezależności, więc samą liczbę trzeba uzupełnić testem. Test permutacyjny miesza wartości y względem x, co niszczy zależność, i sprawdza, jak często dCor z permutacji jest co najmniej tak duża jak obserwowana.
Na rysunku
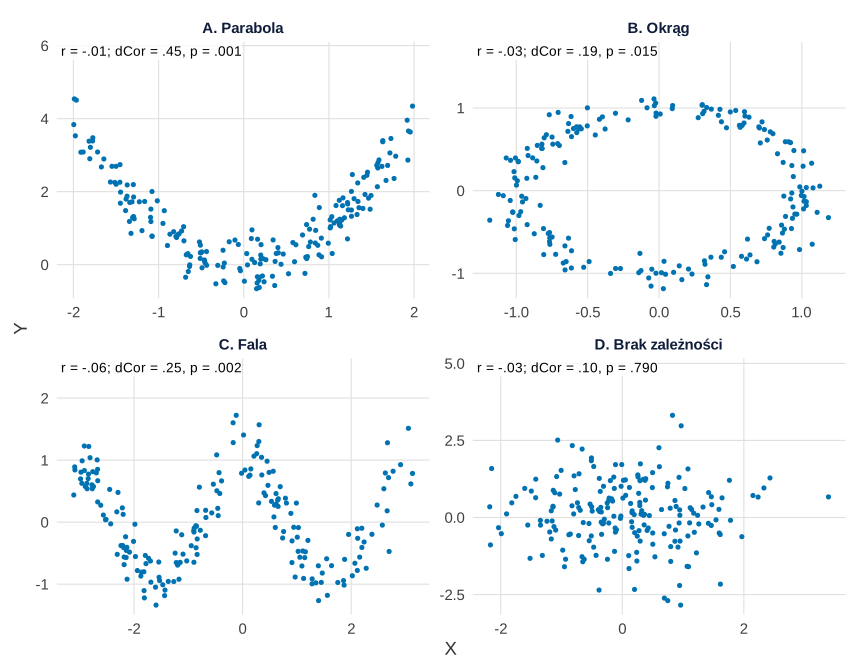
Co widać. We wszystkich czterech zbiorach r jest bliskie zera (od −.06 do −.01). Korelacja odległościowa odróżnia jednak trzy zależności nieliniowe od braku zależności: dCor wynosi .45 dla paraboli, .25 dla fali i .19 dla okręgu (p od .001 do .015 w teście permutacyjnym, 999 permutacji), a dla zmiennych niezależnych .10, p = .790.
Na co uważać. Wysokość dCor nie mówi, jak ciasno punkty leżą wokół krzywej: okrąg jest wyraźniejszy niż parabola, a ma niższe dCor. Kształtu zależności nie odczytasz z liczby, tylko z wykresu – podobny przykład z r bliskim zera ma wpis Zawsze narysuj dane. Kształty, zakresy i szum dobrano ręcznie; ziarna nie zmieniano.
Podpis do pracy:
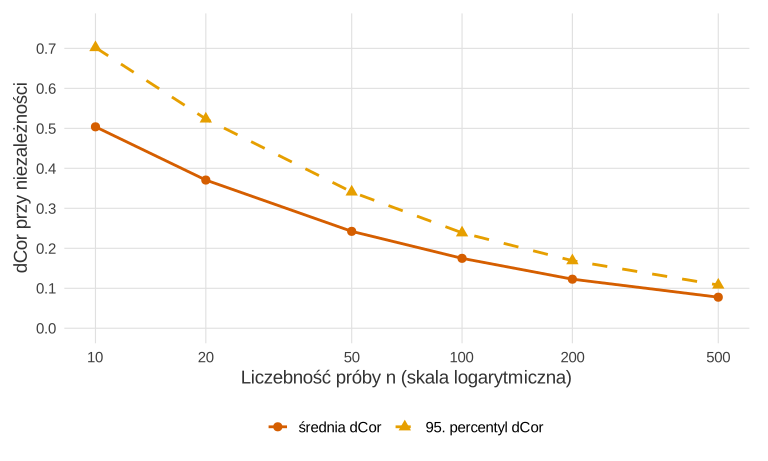
Co widać. Choć w populacji zależności nie ma, średnie dCor wynosi .504 przy n = 10, .242 przy n = 50 i .078 przy n = 500. W 5% prób po 10 osób dCor przekracza .702.
Na co uważać. dCor z próby jest obciążone w górę, więc nie oceniaj go progami w rodzaju „.3 to umiarkowany związek” – rozstrzyga test permutacyjny. Pakiet energy ma też wersję z korektą obciążenia, bcdcor().
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: korelacja odległościowa przy zależnościach nieliniowych i przy niezależności
library(energy)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(punkty = "#0072B2", srednia = "#D55E00", kwantyl = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: cztery zbiory po n = 200 punktów
set.seed(4893)
n <- 200
x1 <- runif(n, -2, 2);       y1 <- x1^2 + rnorm(n, sd = 0.4)                 # parabola
kat <- runif(n, 0, 2 * pi)
x2 <- cos(kat) + rnorm(n, sd = 0.08); y2 <- sin(kat) + rnorm(n, sd = 0.08)  # okrąg
x3 <- runif(n, -pi, pi);     y3 <- cos(2 * x3) + rnorm(n, sd = 0.3)          # fala
x4 <- rnorm(n);              y4 <- rnorm(n)                                  # zmienne niezależne
nazwy <- c("A. Parabola", "B. Okrąg", "C. Fala", "D. Brak zależności")
dane <- data.frame(x = c(x1, x2, x3, x4), y = c(y1, y2, y3, y4),
                   panel = factor(rep(nazwy, each = n), levels = nazwy))
wyniki <- do.call(rbind, lapply(split(dane, dane$panel), function(d) {
  t <- dcor.test(d$x, d$y, R = 999)                      # test permutacyjny niezależności
  data.frame(panel = d$panel[1], r = cor(d$x, d$y), dCor = dcor(d$x, d$y), p = t$p.value)
}))
print(transform(wyniki, r = round(r, 3), dCor = round(dCor, 3), p = round(p, 3)), row.names = FALSE)
wyniki$etyk <- sprintf("r = %s;  dCor = %s, p %s", sub("0\\.", ".", sprintf("%.2f", wyniki$r)),
                       sub("0\\.", ".", sprintf("%.2f", wyniki$dCor)),
                       ifelse(wyniki$p < .001, "< .001", paste("=", sub("0\\.", ".", sprintf("%.3f", wyniki$p)))))
p1 <- ggplot(dane, aes(x, y)) +
  geom_point(colour = kol[["punkty"]], size = 1.4, shape = 16) +
  geom_label(data = wyniki, aes(x = -Inf, y = Inf, label = etyk), hjust = 0, vjust = 1,
             size = 3.6, linewidth = 0, fill = "white", alpha = 0.85) +
  facet_wrap(~ panel, ncol = 2, scales = "free") +
  scale_y_continuous(expand = expansion(mult = c(0.05, 0.3))) +
  labs(x = "X", y = "Y") + motyw

# Rysunek 2: dCor w próbie przy niezależnych zmiennych, 1000 prób dla każdego n
set.seed(4894)
ns <- c(10, 20, 50, 100, 200, 500)
sym <- do.call(rbind, lapply(ns, function(m) {
  d <- replicate(1000, dcor(rnorm(m), rnorm(m)))
  data.frame(n = m, srednia = mean(d), kwantyl95 = unname(quantile(d, .95)))
}))
print(round(sym, 3), row.names = FALSE)
dl <- rbind(data.frame(n = sym$n, wart = sym$srednia, miara = "średnia dCor"),
            data.frame(n = sym$n, wart = sym$kwantyl95, miara = "95. percentyl dCor"))
dl$miara <- factor(dl$miara, levels = c("średnia dCor", "95. percentyl dCor"))
p2 <- ggplot(dl, aes(n, wart, colour = miara, linetype = miara, shape = miara)) +
  geom_line(linewidth = 1) + geom_point(size = 2.8) +
  scale_x_log10(breaks = ns) + scale_y_continuous(limits = c(0, 0.75), breaks = seq(0, 0.7, 0.1)) +
  scale_colour_manual(values = unname(kol[c("srednia", "kwantyl")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(x = "Liczebność próby n (skala logarytmiczna)", y = "dCor przy niezależności") + motyw

p1   # zapis: ggsave("korelacja-odleglosciowa-nieliniowe.svg", p1, width = 9, height = 7)
p2   # zapis: ggsave("korelacja-odleglosciowa-niezaleznosc.svg", p2, width = 8, height = 4.8)
Wynik w R
              panel      r  dCor     p
        A. Parabola -0.012 0.450 0.001
           B. Okrąg -0.026 0.188 0.015
            C. Fala -0.056 0.249 0.002
 D. Brak zależności -0.033 0.104 0.790
   n srednia kwantyl95
  10   0.504     0.702
  20   0.371     0.523
  50   0.242     0.341
 100   0.175     0.239
 200   0.123     0.169
 500   0.078     0.108
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne). Funkcja dcor() z pakietu energy daje dla danych z przykładu tę samą wartość (.524) co ręczna funkcja z kodu niżej.
Jak opisać w pracy
Na co uważać
- Brak kierunku i kształtu. dCor mówi, że zależność istnieje, ale nie jaka. Zawsze pokaż wykres rozrzutu; dlaczego to ważne, pokazuje kwartet Anscombe’a.
- Porównanie z Pearsonem. Dla związku liniowego podawaj r, a dCor traktuj jako uzupełnienie.
- Duże próby. Macierze n × n szybko zajmują pamięć. Gotowe funkcje
dcor()idcor.test()ma pakiet energy; tu liczymy ręcznie w bazowym R. - Opis kształtu. Gdy test wskaże zależność, jej przebieg opisz modelem, np. splajnami lub GAM – zob. wpis o zależnościach nieliniowych.
Korelacja odległościowa w R
Kod liczy korelację odległościową ręcznie z podwójnie centrowanych macierzy odległości, porównuje ją z korelacją Pearsona dla zależności parabolicznej i dla zmiennych niezależnych oraz wykonuje test permutacyjny.
Pearson a dCor dla paraboli
R
dcor <- function(x, y) {                 # korelacja odległościowa (wersja z próby)
  centruj <- function(d) {               # podwójne centrowanie macierzy odległości
    d <- as.matrix(d)
    d - outer(rowMeans(d), colMeans(d), "+") + mean(d)
  }
  A <- centruj(dist(x)); B <- centruj(dist(y))
  sqrt(mean(A * B) / sqrt(mean(A * A) * mean(B * B)))
}
set.seed(4892)
x <- rnorm(100)
y <- x^2 + rnorm(100, sd = 0.3)          # zależność paraboliczna
round(c(pearson = cor(x, y), dcor = dcor(x, y)), 3)
obs <- dcor(x, y)
perm <- replicate(999, dcor(x, sample(y)))  # test permutacyjny niezależności
round((sum(perm >= obs) + 1) / 1000, 3)
z <- rnorm(100)                          # zmienna niezależna od x
round(c(pearson = cor(x, z), dcor = dcor(x, z)), 3)
perm_z <- replicate(999, dcor(x, sample(z)))
round((sum(perm_z >= dcor(x, z)) + 1) / 1000, 3)
Wynik w R
pearson    dcor
  0.008   0.524
[1] 0.001
pearson    dcor
 -0.024   0.188
[1] 0.311
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów); rysunki policzono pakietem energy i wykonano w pakiecie ggplot2, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- energy (wersja 1.7.12): Rizzo, M., & Szekely, G. (2024). energy: E-statistics: Multivariate inference via the energy of data [R package]. https://doi.org/10.32614/CRAN.package.energy
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy dCor bliskie zeru oznacza brak związku?
W populacji dCor = 0 oznacza niezależność. W próbie wartość jest zawsze dodatnia, nawet dla zmiennych niezależnych (w przykładzie na tej stronie .188), dlatego oceniaj ją testem permutacyjnym, a nie samą liczbą.
Czy korelacja odległościowa zastępuje korelację Pearsona?
Nie. Korelacja Pearsona podaje kierunek i siłę związku liniowego, a dCor wykrywa każdą zależność, ale bez kierunku i kształtu. Przy związku nieliniowym podaj obie miary i wykres rozrzutu.
Czy dCor można policzyć dla grup zmiennych?
Tak. X i Y mogą być wektorami zmiennych o dowolnym, także różnym wymiarze, np. trzy podskale lęku i dwie miary snu (Székely i Rizzo, 2009). Odległości liczy się wtedy w przestrzeni wszystkich zmiennych danej grupy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Székely, G. J., & Rizzo, M. L. (2009). Brownian distance covariance. The Annals of Applied Statistics, 3(4), 1236–1265. https://doi.org/10.1214/09-aoas312 ● Otwarty dostęp: pełny tekst
- Székely, G. J., Rizzo, M. L., & Bakirov, N. K. (2007). Measuring and testing dependence by correlation of distances. The Annals of Statistics, 35(6), 2769–2794. https://doi.org/10.1214/009053607000000505 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{szekely2009brownian, author={Sz{\'e}kely, G{\'a}bor J. and Rizzo, Maria L.}, title={{Brownian distance covariance}}, journal={The Annals of Applied Statistics}, year={2009}, volume={3}, number={4}, pages={1236--1265}, doi={10.1214/09-aoas312}}@article{szekely2007measuring, author={Sz{\'e}kely, G{\'a}bor J. and Rizzo, Maria L. and Bakirov, Nail K.}, title={{Measuring and testing dependence by correlation of distances}}, journal={The Annals of Statistics}, year={2007}, volume={35}, number={6}, pages={2769--2794}, doi={10.1214/009053607000000505}}