Co to jest kwartet Anscombe’a?
Kwartet Anscombe’a (ang. Anscombe’s quartet) to cztery małe zbiory danych x–y po 11 par, które mają prawie identyczne statystyki opisowe, korelację Pearsona i prostą regresji liniowej, a na wykresie wyglądają zupełnie inaczej. Anscombe (1973) ułożył je, by pokazać, że wykres jest częścią analizy, a nie ozdobą wyniku. W R zbiór jest wbudowany jako anscombe.
Te same liczby
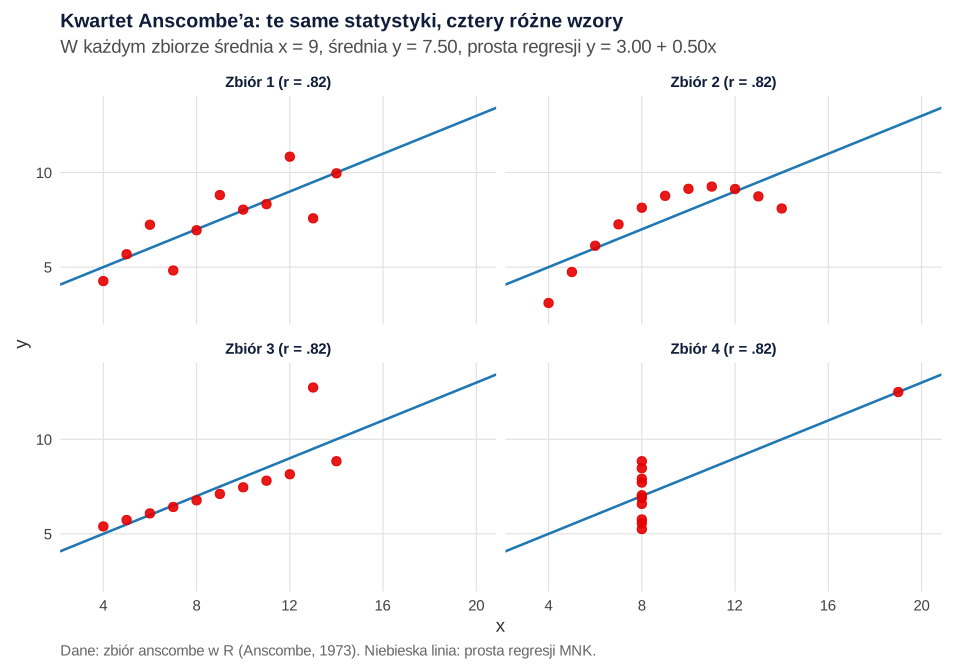
We wszystkich czterech zbiorach średnia x wynosi 9, wariancja x – 11, średnia y – 7.50, wariancja y – od 4.12 do 4.13, korelacja r = .82, a prosta regresji y = 3.00 + 0.50x z R² = .67. Tabela z tymi liczbami nie odróżni zbiorów.
anscombe.Cztery różne obrazy
- Zbiór 1 – zwykły związek liniowy z losowym rozrzutem; tu prosta i r dobrze opisują dane.
- Zbiór 2 – zależność krzywoliniowa. Parabola opisuje ją niemal idealnie (R² = 1.00), a prosta jest złym modelem.
- Zbiór 3 – dziesięć punktów na jednej prostej i jedna obserwacja odstająca. Bez niej r = 1.00, a nachylenie spada z 0.50 do 0.35.
- Zbiór 4 – dziesięć osób ma x = 8, a całe nachylenie wyznacza jeden punkt z x = 19 o ogromnej dźwigni. Bez niego korelacji nie dałoby się policzyć.
Matejka i Fitzmaurice (2017) opracowali metodę generowania kolejnych takich zbiorów – o tych samych statystykach i różnych kształtach – przez stopniowe przesuwanie punktów zbioru wyjściowego.
Jak opisać w pracy
Na co uważać
- Najpierw wykres. Przed korelacją i regresją narysuj wykres rozrzutu, a po regresji – wykres reszt.
- Testy tego nie zastąpią. W zbiorze 2 korelacja jest wysoka i istotna (p = .002), choć model liniowy jest błędny.
- W pracy pokaż dane. Wskazówki, jak to zrobić, podajemy we wpisie wykresy w pracy dyplomowej.
Kwartet Anscombe’a w R
Kod liczy dla czterech zbiorów średnie, wariancje, korelację i współczynniki regresji, a potem sprawdza zbiór 3 bez obserwacji odstającej oraz dopasowanie paraboli i istotność korelacji w zbiorze 2.
Statystyki czterech zbiorów i dwie kontrole
R
# Kwartet Anscombe'a: zbiór anscombe z bazowego R (pakiet datasets)
staty <- sapply(1:4, function(i) {
  x <- anscombe[[paste0("x", i)]]; y <- anscombe[[paste0("y", i)]]
  b <- coef(lm(y ~ x))
  c(sr_x = mean(x), war_x = var(x), sr_y = mean(y), war_y = var(y),
    r = cor(x, y), b0 = b[[1]], b1 = b[[2]], R2 = summary(lm(y ~ x))$r.squared)
})
colnames(staty) <- paste("zbiór", 1:4)
round(staty, 3)
# Zbiór 3 bez jednej obserwacji odstającej (x = 13, y = 12.74)
z3 <- subset(anscombe, !(x3 == 13 & y3 > 12))
round(c(r = cor(z3$x3, z3$y3), coef(lm(y3 ~ x3, data = z3))), 4)
# Zbiór 2: dopasowanie paraboli
round(summary(lm(y2 ~ x2 + I(x2^2), data = anscombe))$r.squared, 4)
# Zbiór 2: test istotności korelacji liniowej
round(cor.test(anscombe$x2, anscombe$y2)$p.value, 4)
Wynik w R
      zbiór 1 zbiór 2 zbiór 3 zbiór 4
sr_x    9.000   9.000   9.000   9.000
war_x  11.000  11.000  11.000  11.000
sr_y    7.501   7.501   7.500   7.501
war_y   4.127   4.128   4.123   4.123
r       0.816   0.816   0.816   0.817
b0      3.000   3.001   3.002   3.002
b1      0.500   0.500   0.500   0.500
R2      0.667   0.666   0.666   0.667
          r (Intercept)          x3
     1.0000      4.0056      0.3454
[1] 1
[1] 0.0022
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (bez dodatkowych pakietów). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
Najczęstsze pytania
Gdzie znaleźć dane kwartetu Anscombe’a?
W R są wbudowane jako zbiór anscombe w pakiecie datasets, z kolumnami x1–x4 i y1–y4. Wystarczy wpisać anscombe w konsoli, bez instalowania pakietów.
Co pokazuje kwartet Anscombe’a?
Że te same średnie, wariancje, korelacja r = .82 i prosta regresji mogą opisywać związek liniowy, krzywoliniowy albo wynik jednej obserwacji odstającej. Dlatego dane trzeba najpierw obejrzeć na wykresie rozrzutu.
Który zbiór kwartetu Anscombe’a nadaje się do regresji liniowej?
Tylko zbiór 1. W zbiorze 2 zależność jest krzywoliniowa, w zbiorze 3 prostą przesuwa jedna obserwacja odstająca, a w zbiorze 4 nachylenie wyznacza jeden punkt o dużej dźwigni.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Zawsze narysuj dane
Kwartet Anscombe’a i cztery pułapki korelacji na wykresach z R – z podpisem APA i zdaniem do Wyników przy każdym rysunku.
Czytaj →PoradnikWykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikKorelacja Pearsona i Spearmana krok po kroku
Wybór miary, wykres rozrzutu, przedział ufności z transformacji Fishera, siła r, korelacja cząstkowa, macierz w APA i opis wyników z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Matejka, J., & Fitzmaurice, G. (2017). Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing. In Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems (pp. 1290–1294). Association for Computing Machinery. https://doi.org/10.1145/3025453.3025912
Cytowania BibTeX
@article{anscombe1973graphs, author={Anscombe, Francis J.}, title={{Graphs in statistical analysis}}, journal={The American Statistician}, year={1973}, volume={27}, number={1}, pages={17--21}, doi={10.1080/00031305.1973.10478966}}@inproceedings{matejka2017same, author={Matejka, Justin and Fitzmaurice, George}, title={{Same stats, different graphs: Generating datasets with varied appearance and identical statistics through simulated annealing}}, booktitle={Proceedings of the 2017 CHI Conference on Human Factors in Computing Systems}, year={2017}, pages={1290--1294}, publisher={Association for Computing Machinery}, doi={10.1145/3025453.3025912}}