Co to jest dywergencja Kullbacka–Leiblera?
Dywergencja Kullbacka–Leiblera (ang. Kullback–Leibler divergence, KL, entropia względna) mierzy, jak bardzo rozkład prawdopodobieństwa Q różni się od rozkładu odniesienia P. Miarę wprowadzili Kullback i Leibler (1951). Dla kategorii:
DKL(P ‖ Q) = Σ pi · ln(pi / qi)
To nadwyżka entropii krzyżowej nad entropią Shannona rozkładu P: ile dodatkowej informacji (w natach przy logarytmie naturalnym, w bitach przy log2) tracimy, opisując dane z P za pomocą Q. Dla zmiennych ciągłych sumę zastępuje całka z funkcji gęstości.
Własności
- DKL ≥ 0 i równa się 0 tylko wtedy, gdy rozkłady są identyczne.
- Nie jest odległością: DKL(P ‖ Q) zwykle różni się od DKL(Q ‖ P).
- Jest nieskończona, gdy qi = 0 w kategorii, w której pi > 0. Lin (1991) zaproponował miary oparte na entropii Shannona, w tym dywergencję Jensena–Shannona, które tego warunku nie wymagają i są ograniczone.
Przykład
Dwie grupy po 200 osób odpowiadały na pytanie w skali Likerta 1–5 (dane symulowane). DKL(P ‖ Q) = 0.285 nata (0.411 bita), a w odwrotnym kierunku 0.296 nata. Ta sama wartość 0.285 wychodzi jako entropia krzyżowa minus entropia P. Symetryczna dywergencja Jensena–Shannona wynosi 0.069 nata.
Gdzie się pojawia
Maksymalizacja wiarygodności w metodzie największej wiarygodności odpowiada minimalizacji dywergencji KL między rozkładem empirycznym a modelem. Na tej idei opiera się AIC, który szacuje względną utratę informacji przez model. Statystyka G w teście zgodności to 2n razy dywergencja rozkładu obserwowanego od oczekiwanego.
Na rysunku
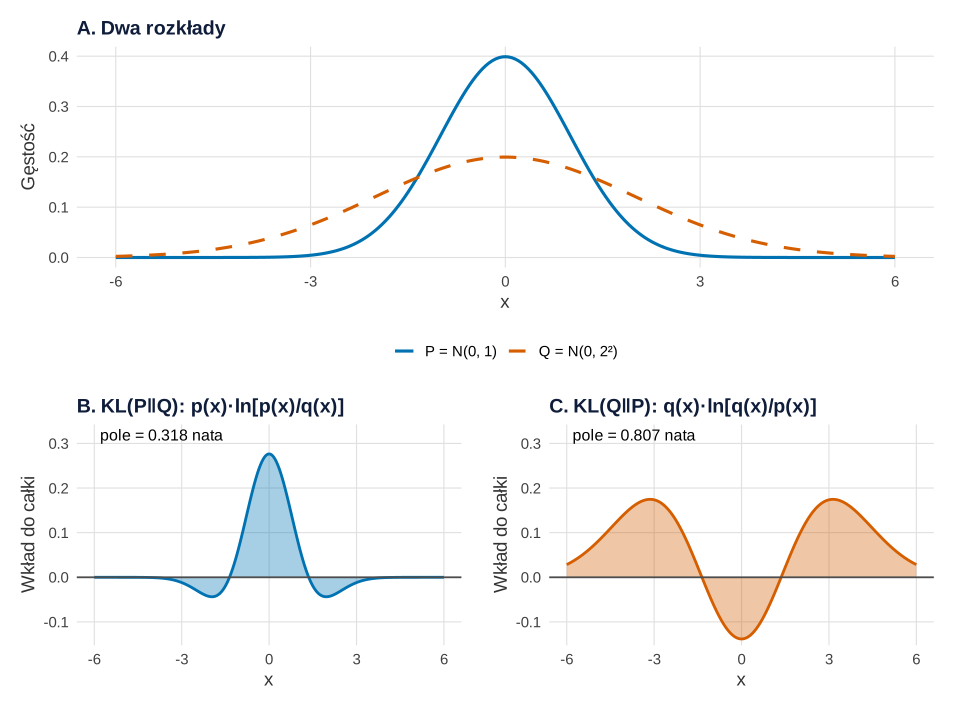
Co widać. Pole pod krzywą w panelu B to DKL(P ‖ Q) = 0.318 nata, a w panelu C DKL(Q ‖ P) = 0.807 nata – ponad dwa razy więcej. W pierwszym kierunku liczy się środek, gdzie P ma większość masy, a Q jest za płaski: przedział |x| ≤ 2 daje 0.385 nata. W drugim prawie całą wartość (0.982 nata) dają ogony |x| > 2, w których Q ma sporo masy, a P prawie żadnej; środek odejmuje 0.175.
Na co uważać. Funkcja podcałkowa bywa ujemna, więc pojedyncze fragmenty osi „odejmują”, ale cała dywergencja nigdy nie spada poniżej zera. Wykres nie rozstrzyga, który kierunek jest właściwy – to wynika z pytania: który rozkład jest odniesieniem, a który przybliżeniem. Parametry rozkładów wybrano ręcznie dla ilustracji.
Podpis do pracy:
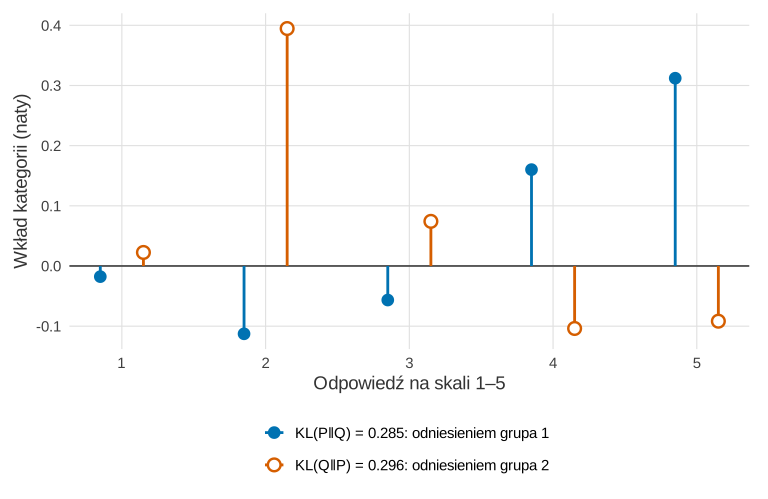
Co widać. W przykładzie ze skalą 1–5 sumy w obu kierunkach są prawie równe (0.285 i 0.296 nata), ale biorą się z innych odpowiedzi. Do DKL(P ‖ Q) najwięcej wnosi odpowiedź 5 (0.312), częsta w grupie 1 i rzadka w grupie 2. Do DKL(Q ‖ P) – odpowiedź 2 (0.395), częsta w grupie 2. Wkłady ujemne mają kategorie, w których rozkład porównywany ma więcej masy niż rozkład odniesienia.
Na co uważać. Bliskie sumy to tu zbieg okoliczności, nie dowód symetrii. Pusta kategoria w rozkładzie porównywanym dałaby nieskończony wkład. Taki układ to wykres lizakowy.
Podpis do pracy:
Kod R rysunków
# Rysunki 1–2: asymetria dywergencji KL (rozkłady ciągłe) i wkłady kategorii w przykładzie z hasła
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(P = "#0072B2", Q = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(0.95)),
        plot.background = element_rect(fill = "white", colour = NA))

# Rysunek 1: P = N(0, 1), Q = N(0, 2²); funkcje podcałkowe obu kierunków KL
p <- function(x) dnorm(x, 0, 1)
q <- function(x) dnorm(x, 0, 2)
lr <- function(x) dnorm(x, 0, 1, log = TRUE) - dnorm(x, 0, 2, log = TRUE)   # ln[p(x)/q(x)]
f_PQ <- function(x) p(x) * lr(x)                  # funkcja podcałkowa KL(P‖Q)
f_QP <- function(x) -q(x) * lr(x)                 # funkcja podcałkowa KL(Q‖P)
KL <- c(KL_PQ_calka = integrate(f_PQ, -Inf, Inf)$value,
        KL_PQ_wzor  = log(2) + 1 / 8 - 1 / 2,       # wzór dla dwóch rozkładów normalnych
        KL_QP_calka = integrate(f_QP, -Inf, Inf)$value,
        KL_QP_wzor  = log(1 / 2) + 4 / 2 - 1 / 2)
round(KL, 3)
# skąd biorą się wartości: wkład ogonów |x| > 2 i środka |x| ≤ 2 (w natach)
round(c(QP_ogony = 2 * integrate(f_QP, 2, Inf)$value, QP_srodek = integrate(f_QP, -2, 2)$value,
        PQ_ogony = 2 * integrate(f_PQ, 2, Inf)$value, PQ_srodek = integrate(f_PQ, -2, 2)$value), 3)

x <- seq(-6, 6, length.out = 241)
d <- data.frame(x = x, p = p(x), q = q(x), fPQ = f_PQ(x), fQP = f_QP(x))
gest <- rbind(data.frame(x = x, y = d$p, rozklad = "P = N(0, 1)"),
              data.frame(x = x, y = d$q, rozklad = "Q = N(0, 2²)"))
pA <- ggplot(gest, aes(x, y, colour = rozklad, linetype = rozklad)) +
  geom_line(linewidth = 1.1) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(title = "A. Dwa rozkłady", x = "x", y = "Gęstość") + motyw
panel <- function(kolumna, kolor, tytul, wartosc) {
  ggplot(d, aes(x, .data[[kolumna]])) +
    geom_area(fill = kolor, alpha = 0.35) + geom_line(colour = kolor, linewidth = 1) +
    geom_hline(yintercept = 0, colour = "grey30") +
    annotate("text", x = -5.8, y = Inf, vjust = 1.4, hjust = 0, size = 4.2,
             label = sprintf("pole = %.3f nata", wartosc)) +
    coord_cartesian(ylim = c(-0.13, 0.32)) +
    labs(title = tytul, x = "x", y = "Wkład do całki") + motyw
}
pB <- panel("fPQ", kol[["P"]], "B. KL(P‖Q): p(x)·ln[p(x)/q(x)]", KL[["KL_PQ_calka"]])
pC <- panel("fQP", kol[["Q"]], "C. KL(Q‖P): q(x)·ln[q(x)/p(x)]", KL[["KL_QP_calka"]])
p1 <- pA / (pB | pC)

# Rysunek 2: wkład każdej kategorii w przykładzie z hasła (te same dane co w kodzie hasła)
set.seed(550)
g1 <- sample(1:5, 200, replace = TRUE, prob = c(0.05, 0.10, 0.20, 0.40, 0.25))
g2 <- sample(1:5, 200, replace = TRUE, prob = c(0.15, 0.25, 0.30, 0.20, 0.10))
P <- as.numeric(prop.table(table(factor(g1, levels = 1:5))))
Q <- as.numeric(prop.table(table(factor(g2, levels = 1:5))))
wklad <- rbind(data.frame(kat = 1:5, w = P * log(P / Q), kier = "PQ"),
               data.frame(kat = 1:5, w = Q * log(Q / P), kier = "QP"))
print(transform(wklad, w = round(w, 3)), row.names = FALSE)
sumy <- tapply(wklad$w, wklad$kier, sum); round(sumy, 3)
etyk <- c(PQ = sprintf("KL(P‖Q) = %.3f: odniesieniem grupa 1", sumy[["PQ"]]),
          QP = sprintf("KL(Q‖P) = %.3f: odniesieniem grupa 2", sumy[["QP"]]))
wklad$kierunek <- factor(etyk[wklad$kier], levels = etyk)
wklad$xpos <- wklad$kat + ifelse(wklad$kier == "PQ", -0.15, 0.15)
p2 <- ggplot(wklad, aes(xpos, w, colour = kierunek, shape = kierunek)) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_segment(aes(xend = xpos, y = 0, yend = w), linewidth = 1) +
  geom_point(size = 3.6, fill = "white", stroke = 1.3) +
  scale_colour_manual(values = unname(kol), name = NULL) +
  scale_shape_manual(values = c(16, 21), name = NULL) +
  scale_x_continuous(breaks = 1:5) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1)) +
  labs(x = "Odpowiedź na skali 1–5", y = "Wkład kategorii (naty)") + motyw

p1   # zapis: ggsave("dywergencja-kl-asymetria.svg", p1, width = 10, height = 7.4)
p2   # zapis: ggsave("dywergencja-kl-kategorie.svg", p2, width = 8, height = 5.2)
Wynik w R
KL_PQ_calka  KL_PQ_wzor KL_QP_calka  KL_QP_wzor
      0.318       0.318       0.807       0.807
 QP_ogony QP_srodek  PQ_ogony PQ_srodek
    0.982    -0.175    -0.067     0.385
 kat      w kier
   1 -0.018   PQ
   2 -0.113   PQ
   3 -0.057   PQ
   4  0.160   PQ
   5  0.312   PQ
   1  0.022   QP
   2  0.395   QP
   3  0.074   QP
   4 -0.104   QP
   5 -0.092   QP
   PQ    QP
0.285 0.296
Rysunki na stronie powstały z tego kodu z motywem serwisu (dane, geometrie i skale identyczne).
Jak opisać w pracy
Na co uważać
- Kierunek. Zawsze podaj, który rozkład jest odniesieniem P.
- Puste kategorie. Zero w Q daje nieskończoność; rozważ JS albo wygładzenie częstości i opisz to.
- Brak skali „dużych” wartości. KL to nie test; porównuj wartości liczone na tych samych kategoriach i jednostkach.
Dywergencja KL w R
Kod symuluje odpowiedzi dwóch grup na skali 1–5, liczy dywergencję KL w obu kierunkach (w natach i bitach), sprawdza związek z entropią krzyżową, liczy dywergencję Jensena–Shannona i pokazuje, kiedy KL jest nieskończona.
KL, entropia krzyżowa i Jensen–Shannon
R
set.seed(550)                                   # odpowiedzi na skali 1–5 w dwóch grupach po 200 osób
g1 <- sample(1:5, 200, replace = TRUE, prob = c(0.05, 0.10, 0.20, 0.40, 0.25))
g2 <- sample(1:5, 200, replace = TRUE, prob = c(0.15, 0.25, 0.30, 0.20, 0.10))
P <- prop.table(table(factor(g1, levels = 1:5)))
Q <- prop.table(table(factor(g2, levels = 1:5)))
kl <- function(p, q) sum(ifelse(p > 0, p * log(p / q), 0))   # w natach (log naturalny)
H  <- function(p) -sum(ifelse(p > 0, p * log(p), 0))         # entropia Shannona
M  <- (P + Q) / 2
round(rbind(P = P, Q = Q), 3)
round(c(KL_PQ = kl(P, Q), KL_QP = kl(Q, P),
        KL_PQ_bity = kl(P, Q) / log(2),
        entropia_krzyzowa_minus_H = -sum(P * log(Q)) - H(P),
        JS = (kl(P, M) + kl(Q, M)) / 2), 3)
kl(c(0.5, 0.5, 0), c(0.5, 0.5, 0))   # brak kategorii w obu rozkładach: 0
kl(c(0.4, 0.4, 0.2), c(0.5, 0.5, 0)) # Q = 0 tam, gdzie P > 0: nieskończoność
Wynik w R
      1     2     3    4     5
P 0.075 0.090 0.210 0.37 0.255
Q 0.095 0.315 0.275 0.24 0.075
                    KL_PQ                     KL_QP                KL_PQ_bity
                    0.285                     0.296                     0.411
entropia_krzyzowa_minus_H                        JS
                    0.285                     0.069
[1] 0
[1] Inf
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów); rysunki wykonano w pakiecie ggplot2, panele połączono pakietem patchwork, a pliki zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Dlaczego dywergencja Kullbacka–Leiblera nie jest odległością?
Bo nie jest symetryczna: D(P‖Q) zwykle różni się od D(Q‖P), i nie spełnia nierówności trójkąta. W przykładzie wartości wynoszą 0.285 i 0.296 nata.
Co zrobić, gdy dywergencja KL wychodzi nieskończona?
Oznacza to zero w rozkładzie Q w kategorii, która występuje w P. Można użyć dywergencji Jensena–Shannona, połączyć rzadkie kategorie albo wygładzić częstości i opisać to w pracy.
Jaki jest związek dywergencji KL z AIC?
AIC szacuje względną utratę informacji mierzoną dywergencją KL między prawdziwym procesem a modelem. Dlatego model o niższym AIC uznaje się za lepsze przybliżenie danych.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Kullback, S., & Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22(1), 79–86. https://doi.org/10.1214/aoms/1177729694 ● Otwarty dostęp
- Lin, J. (1991). Divergence measures based on the Shannon entropy. IEEE Transactions on Information Theory, 37(1), 145–151. https://doi.org/10.1109/18.61115
Cytowania BibTeX
@article{kullback1951information, author={Kullback, S. and Leibler, R. A.}, title={{On information and sufficiency}}, journal={The Annals of Mathematical Statistics}, year={1951}, volume={22}, number={1}, pages={79--86}, doi={10.1214/aoms/1177729694}}@article{lin1991divergence, author={Lin, J.}, title={{Divergence measures based on the Shannon entropy}}, journal={IEEE Transactions on Information Theory}, year={1991}, volume={37}, number={1}, pages={145--151}, doi={10.1109/18.61115}}