Co to jest wykres lizakowy?
Wykres lizakowy (ang. lollipop chart) to wykres słupkowy, w którym każdy słupek zastąpiono cienką linią zakończoną punktem. Linia (patyczek) biegnie od punktu odniesienia – zwykle od zera – do wartości, a punkt (cukierek) zaznacza samą wartość. Pokazuje po jednej liczbie na kategorię.
Lizak koduje wartość jednocześnie długością patyczka i położeniem punktu. Położenie na wspólnej skali należy do zadań percepcyjnych odczytywanych najdokładniej (Cleveland i McGill, 1984), ale długość patyczka nadal sugeruje proporcje – dlatego lizak podlega tej samej zasadzie co słupek: oś powinna zaczynać się od zera.
Kiedy go użyć
- Ranking wielu kategorii. Przy 15–30 kategoriach rząd grubych słupków tworzy ciężką plamę, a cienkie lizaki zostawiają więcej światła i ułatwiają czytanie etykiet.
- Wartości o podobnej wielkości. Gdy wszystkie słupki są długie i niemal równe, różnice widać głównie na ich końcach – lizak eksponuje właśnie koniec.
- Dwie wartości na kategorię (np. dwa lata, dwie grupy) lepiej pokazać na wykresie hantlowym niż na dwóch lizakach obok siebie.
- Liczebności i wskaźniki, dla których zero ma sens. Jeśli zero nie ma znaczenia albo wszystkie wartości leżą daleko od niego, wybierz wykres punktowy Clevelanda – same punkty bez patyczków.
Przykład
Wbudowany w R zbiór state.x77 zawiera m.in. wskaźnik zabójstw na 100 tys. mieszkańców (1976) i oczekiwaną długość życia (1969–1971) w 50 stanach USA. Wybraliśmy 15 stanów z najwyższym wskaźnikiem zabójstw: od 10.3 (California) do 15.1 (Alabama). Oczekiwana długość życia w tych stanach wynosi od 67.96 (South Carolina) do 71.71 roku (California), więc największa wartość jest tylko 1.055 raza większa od najmniejszej. Początek osi 67.5 w rysunku 2 wybraliśmy ręcznie, żeby pokazać skutki ucięcia osi.
Na rysunku
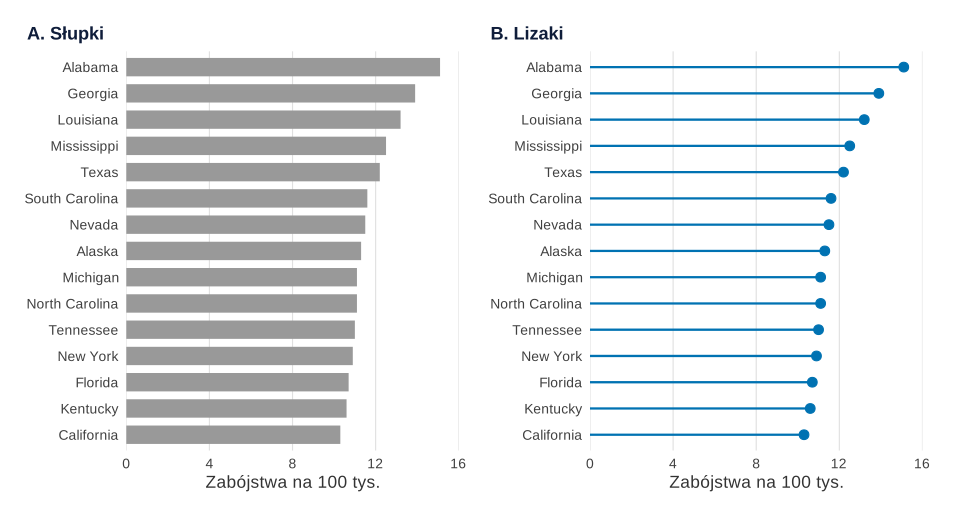
state.x77).Co widać. Oba panele są poprawne. W panelu B mniej jest tuszu, a wzrok trafia na punkty – łatwiej zauważyć, że Alabama (15.1) wyraźnie prowadzi, a od Mississippi (12.5) w dół wartości tworzą łagodny stok. Michigan i North Carolina mają tę samą wartość 11.1.
Na co uważać. Ranking nie mówi nic o niepewności ani o liczbie mieszkańców, na której oparto wskaźnik; gdy ją znasz, dodaj przedziały ufności. W małych stanach wskaźnik na 100 tys. jest mniej stabilny, a różnica 0.1 między sąsiednimi stanami nie znaczy, że kolejność jest pewna.
Podpis do pracy:
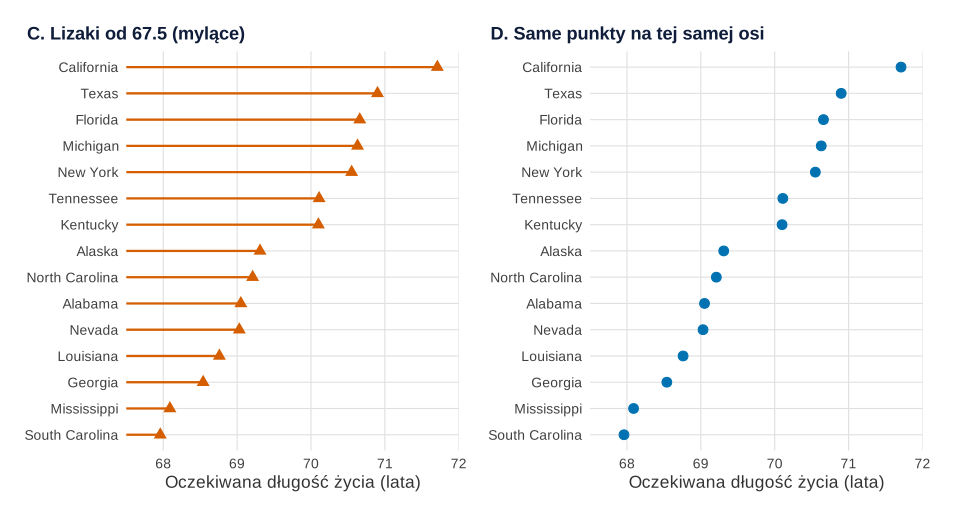
state.x77).Co widać. W panelu C patyczek Kalifornii jest 9.2 raza dłuższy niż patyczek South Caroliny, choć oczekiwana długość życia różni się o 5.5%. Długość patyczka czyta się jak długość słupka, więc wykres wyolbrzymia różnice. W panelu D na tej samej osi zostały same punkty: liczy się odległość między nimi, a nie długość od krawędzi wykresu.
Na co uważać. Ucięta oś wyolbrzymia oceniane różnice i ten efekt utrzymuje się nawet wtedy, gdy oglądający wiedzą o ucięciu (Yang i in., 2021). Wpływ ucięcia na subiektywną wielkość efektu widziano w różnych rodzajach wykresów, także przy wyraźnych oznaczeniach ucięcia (Correll i in., 2020). Lizak od zera dla tych danych dałby 15 patyczków niemal równej długości – dlatego przy wartościach dalekich od zera wybierz punkty.
Podpis do pracy:
Jak opisać w pracy
Podaj w tekście skrajne wartości, a w podpisie jednostkę i porządek kategorii. Więcej we wpisie wykresy w pracy dyplomowej.
Na co uważać
- Oś nie od zera. Patyczek to słupek w innym stroju. Jeśli nie możesz zacząć od zera, usuń patyczki.
- Brak sortowania. Kolejność alfabetyczna marnuje ranking; sortuj według wartości, chyba że kategorie mają naturalny porządek.
- Średnie zamiast liczebności. Lizak ze średnią grupy ukrywa rozkład tak samo jak słupek średniej – przy porównaniu grup lepsze są wykresy z wynikami osób, opisane we wpisie porównanie grup na wykresie.
Wykres lizakowy w R
W ggplot2 lizak to geom_segment() od zera do wartości i geom_point() na jej końcu. Kod wybiera 15 stanów z wbudowanego zbioru, rysuje oba rysunki i liczy ilorazy z rysunku 2. Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Dane są wbudowane, więc kod nie losuje i nie potrzebuje ziarna.
Słupki a lizaki i oś nie od zera
Kod R rysunków 1 i 2
# Wykres lizakowy: słupki a lizaki (rysunek 1) i lizak na osi, która nie zaczyna się od zera (rysunek 2)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(niebieski = "#0072B2", cynober = "#D55E00", szary = "grey60")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), panel.grid.major.y = element_blank(),
                                             plot.title.position = "plot")

# Wbudowany zbiór state.x77: 15 stanów USA z najwyższym wskaźnikiem zabójstw (na 100 tys. mieszkańców, 1976)
s <- data.frame(stan = rownames(state.x77), zabojstwa = state.x77[, "Murder"], dlugosc = state.x77[, "Life Exp"])
s <- s[order(-s$zabojstwa), ][1:15, ]
print(s[, c("stan", "zabojstwa", "dlugosc")], row.names = FALSE)

# Rysunek 1: ten sam ranking jako słupki (A) i lizaki (B), oba od zera
s$stan_z <- factor(s$stan, levels = rev(s$stan))
pA <- ggplot(s, aes(x = zabojstwa, y = stan_z)) +
  geom_col(fill = oi[["szary"]], width = 0.7) +
  scale_x_continuous(limits = c(0, 16), expand = c(0, 0)) +
  labs(title = "A. Słupki", x = "Zabójstwa na 100 tys.", y = NULL)
pB <- ggplot(s, aes(x = zabojstwa, y = stan_z)) +
  geom_segment(aes(x = 0, xend = zabojstwa, yend = stan_z), colour = oi[["niebieski"]], linewidth = 0.8) +
  geom_point(colour = oi[["niebieski"]], size = 3) +
  scale_x_continuous(limits = c(0, 16), expand = c(0, 0)) +
  labs(title = "B. Lizaki", x = "Zabójstwa na 100 tys.", y = NULL)
p1 <- (pA + pB) & motyw

# Rysunek 2: oczekiwana długość życia tych samych stanów; oś od 67.5 lat
start <- 67.5
s <- s[order(-s$dlugosc), ]
s$stan_d <- factor(s$stan, levels = rev(s$stan))
cat("Długość życia: od", min(s$dlugosc), "do", max(s$dlugosc), "lat\n")
cat("Iloraz wartości (max / min):", round(max(s$dlugosc) / min(s$dlugosc), 3), "\n")
cat("Iloraz długości patyczków od", start, "(max / min):",
    round((max(s$dlugosc) - start) / (min(s$dlugosc) - start), 1), "\n")
pC <- ggplot(s, aes(x = dlugosc, y = stan_d)) +
  geom_segment(aes(x = start, xend = dlugosc, yend = stan_d), colour = oi[["cynober"]], linewidth = 0.8) +
  geom_point(colour = oi[["cynober"]], size = 3, shape = 17) +
  scale_x_continuous(limits = c(start, 72), expand = c(0, 0)) +
  labs(title = "C. Lizaki od 67.5 (mylące)", x = "Oczekiwana długość życia (lata)", y = NULL)
pD <- ggplot(s, aes(x = dlugosc, y = stan_d)) +
  geom_point(colour = oi[["niebieski"]], size = 3) +
  scale_x_continuous(limits = c(start, 72), expand = c(0, 0)) +
  labs(title = "D. Same punkty na tej samej osi", x = "Oczekiwana długość życia (lata)", y = NULL)
p2 <- (pC + pD) & motyw & theme(panel.grid.major.y = element_line(colour = "grey92"))
p1
p2
Wynik w R
           stan zabojstwa dlugosc
        Alabama      15.1   69.05
        Georgia      13.9   68.54
      Louisiana      13.2   68.76
    Mississippi      12.5   68.09
          Texas      12.2   70.90
 South Carolina      11.6   67.96
         Nevada      11.5   69.03
         Alaska      11.3   69.31
       Michigan      11.1   70.63
 North Carolina      11.1   69.21
      Tennessee      11.0   70.11
       New York      10.9   70.55
        Florida      10.7   70.66
       Kentucky      10.6   70.10
     California      10.3   71.71
Długość życia: od 67.96 do 71.71 lat
Iloraz wartości (max / min): 1.055
Iloraz długości patyczków od 67.5 (max / min): 9.2
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dane – wbudowany zbiór state.x77; rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy wykres lizakowy jest lepszy od słupkowego?
Niesie tę samą informację, ale ma mniej tuszu, więc przy wielu kategoriach jest czytelniejszy, a wzrok trafia na koniec wartości. Przy kilku kategoriach i w porównaniach skumulowanych słupki są równie dobre lub lepsze.
Czy oś wykresu lizakowego musi zaczynać się od zera?
Tak, jeśli rysujesz patyczki, bo ich długość czyta się jak długość słupka. Gdy wartości leżą daleko od zera i chcesz pokazać małe różnice, usuń patyczki i zostaw same punkty, czyli wykres punktowy Clevelanda.
Jak zrobić wykres lizakowy w ggplot2?
Połącz geom_segment() z x = 0 i xend = wartość (patyczek) z geom_point() na końcu (cukierek). Kategorie posortuj funkcją reorder() albo factor() z poziomami ułożonymi według wartości; przy długich etykietach połóż je na osi pionowej.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Correll, M., Bertini, E., & Franconeri, S. (2020). Truncating the y-axis: Threat or menace? In Proceedings of the 2020 CHI Conference on Human Factors in Computing Systems (pp. 1–12). Association for Computing Machinery. https://doi.org/10.1145/3313831.3376222 ● Otwarty dostęp: pełny tekst
- Yang, B. W., Vargas Restrepo, C., Stanley, M. L., & Marsh, E. J. (2021). Truncating bar graphs persistently misleads viewers. Journal of Applied Research in Memory and Cognition, 10(2), 298–311. https://doi.org/10.1016/j.jarmac.2020.10.002 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@inproceedings{correll2020truncating, author={Correll, Michael and Bertini, Enrico and Franconeri, Steven}, title={{Truncating the y-axis: Threat or menace?}}, booktitle={Proceedings of the 2020 CHI Conference on Human Factors in Computing Systems}, year={2020}, pages={1--12}, publisher={Association for Computing Machinery}, doi={10.1145/3313831.3376222}}@article{yang2021truncating, author={Yang, Brenda W. and Vargas Restrepo, Camila and Stanley, Matthew L. and Marsh, Elizabeth J.}, title={{Truncating bar graphs persistently misleads viewers}}, journal={Journal of Applied Research in Memory and Cognition}, year={2021}, volume={10}, number={2}, pages={298--311}, doi={10.1016/j.jarmac.2020.10.002}}