Co to jest wykres hantlowy?
Wykres hantlowy (ang. dumbbell plot lub dumbbell chart) pokazuje dwie wartości dla każdej kategorii – na przykład wynik przed i po interwencji albo odsetek u kobiet i u mężczyzn – jako dwa punkty na wspólnej osi połączone odcinkiem. Dwa punkty i łączący je odcinek przypominają hantlę, stąd nazwa. To odmiana wykresu punktowego Clevelanda z dwiema seriami zamiast jednej.
Cleveland (1984) zaproponował wykresy punktowe jako zamiennik słupków dla danych z etykietami, a Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu: położenie na wspólnej skali wypadło najlepiej. W hantli oba porównywane punkty leżą w jednym wierszu na tej samej osi, więc odległość między nimi, czyli różnicę, widać od razu.
Jak czytać wykres hantlowy
- Dwa punkty w wierszu to dwie wartości tej samej kategorii. Kształt i kolor mówią, która jest która.
- Długość odcinka to bezwzględna różnica, a strona, po której leży dany punkt, to jej znak. Różnicę warto dopisać liczbą na końcu wiersza.
- Kolejność wierszy niesie informację, jeśli kategorie posortowano według różnicy (pytanie o lukę lub zmianę) albo według jednej z wartości (pytanie o ranking).
- Oś nie musi zaczynać się od zera, bo wartość koduje położenie punktu, a nie długość od zera jak w wykresie słupkowym.
Hantla pokazuje podsumowania w wielu kategoriach. Gdy masz dwa pomiary tych samych jednostek i chcesz zobaczyć każdą z nich, lepszy bywa wykres nachyleń; różnica dwóch pomiarów jednej osoby to wynik różnicowy.
Przykład
W symulowanych danych 240 kobiet i 160 mężczyzn odpowiedziało „zgadzam się” lub „nie zgadzam się” na 11 stwierdzeń o nauce statystyki. Największa luka dotyczy prośby o pomoc prowadzącego: 55.4% kobiet i 23.1% mężczyzn, różnica 32.3 punktu procentowego (95% CI [23.2, 41.4]). W czterech stwierdzeniach odsetek był wyższy u mężczyzn, najbardziej przy samodzielnym rozwiązywaniu zadań (−7.1 p.p., 95% CI [−17.0, 2.9]). Odsetki w populacji ustawiono ręcznie tak, by luki miały różną wielkość i znak; ziarna (768) nie zmieniano.
Na rysunku
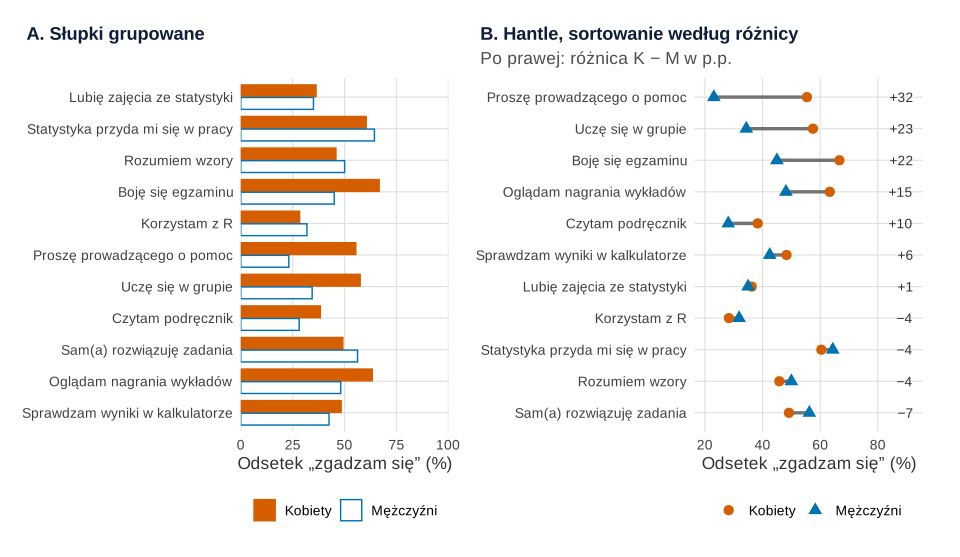
set.seed(768)).Co widać. W panelu A trzeba porównać 11 par słupków i zapamiętać, która para różni się najbardziej. W panelu B wiersze ułożono od największej luki na korzyść kobiet do największej na korzyść mężczyzn. Trzy górne stwierdzenia dzieli ponad 20 punktów, w środku jest „Lubię zajęcia ze statystyki” z różnicą 1.2 punktu, a na dole cztery stwierdzenia, w których trójkąt leży na prawo od koła.
Na co uważać. Hantla nie pokazuje niepewności ani liczebności. Wszystkie cztery ujemne różnice (od −3.5 do −7.1 p.p.) mają 95% przedziały obejmujące zero, więc ich kierunek może być przypadkowy. Jeśli różnice są tematem pracy, pokaż je osobno z przedziałami ufności, na przykład jako wykres punktowy różnic.
Podpis do pracy:
Jak opisać w pracy
Wykres zastępuje długą tabelę, ale najważniejsze liczby podaj w tekście. Zasady numerowania i podpisywania rysunków zebraliśmy we wpisie wykresy w pracy dyplomowej.
Na co uważać
- Kolor jako jedyny wyróżnik. Dwie serie odróżniaj też kształtem punktu albo etykietą przy pierwszym wierszu – czytelnik z zaburzeniem widzenia barw albo na wydruku czarno-białym inaczej ich nie rozpozna.
- Grupy niezależne a pomiary powtarzane. Wykres wygląda tak samo dla dwóch grup osób i dla tych samych osób zbadanych dwa razy, ale analiza jest inna. Przy pomiarach powtarzanych odsetków właściwy jest test McNemara; przykład hantli dla wiedzy przed i po szkoleniu jest we wpisie badanie wiedzy przed i po szkoleniu.
- Nakładające się punkty. Gdy różnica jest bliska zeru, jeden punkt zasłania drugi. Pomaga różny kształt i rozmiar punktów albo liczba różnicy przy wierszu.
- Różnica bezwzględna a względna. Odcinek pokazuje różnicę w jednostkach osi (tu w punktach procentowych). Ta sama luka 10 punktów znaczy co innego przy 15% i przy 70%.
Wykres hantlowy w R
Kod symuluje odpowiedzi, liczy odsetki i różnice z 95% przedziałami (przybliżenie normalne) i rysuje oba panele w ggplot2: odcinek to geom_segment(), a końce hantli – geom_point(). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Słupki grupowane a hantle
Kod R rysunku 1
# Wykres hantlowy: słupki grupowane (rysunek 1A) a hantle posortowane według różnicy (rysunek 1B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
oi <- c(kobiety = "#D55E00", mezczyzni = "#0072B2", szary = "grey45")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom",
                                             plot.title.position = "plot")

# Odsetek odpowiedzi „zgadzam się” na 11 stwierdzeń o nauce statystyki, kobiety i mężczyźni (dane symulowane)
set.seed(768)
pozycje <- c("Lubię zajęcia ze statystyki", "Statystyka przyda mi się w pracy", "Rozumiem wzory",
             "Boję się egzaminu", "Korzystam z R", "Proszę prowadzącego o pomoc", "Uczę się w grupie",
             "Czytam podręcznik", "Sam(a) rozwiązuję zadania", "Oglądam nagrania wykładów",
             "Sprawdzam wyniki w kalkulatorze")
pK <- c(.38, .62, .45, .71, .30, .52, .58, .41, .55, .66, .49)   # prawdopodobieństwa ustawione ręcznie
pM <- c(.42, .60, .52, .48, .39, .31, .40, .37, .57, .51, .47)
nK <- 240; nM <- 160
d <- data.frame(pozycja = pozycje,
                K = 100 * rbinom(11, nK, pK) / nK,
                M = 100 * rbinom(11, nM, pM) / nM)
d$roznica <- d$K - d$M
se <- sqrt(d$K * (100 - d$K) / nK + d$M * (100 - d$M) / nM)        # błąd standardowy różnicy (Wald), w p.p.
d$dolna <- d$roznica - qnorm(.975) * se
d$gorna <- d$roznica + qnorm(.975) * se
d <- d[order(d$roznica), ]
print(data.frame(pozycja = d$pozycja, round(d[, c("K", "M", "roznica", "dolna", "gorna")], 1)), row.names = FALSE)

# A: słupki grupowane w kolejności z kwestionariusza; mężczyźni bez wypełnienia, żeby nie odróżniał ich sam kolor
dl <- rbind(data.frame(pozycja = d$pozycja, grupa = "Kobiety", odsetek = d$K),
            data.frame(pozycja = d$pozycja, grupa = "Mężczyźni", odsetek = d$M))
dl$pozycja <- factor(dl$pozycja, levels = rev(pozycje))
dl$grupa <- factor(dl$grupa, levels = c("Mężczyźni", "Kobiety"))
pA <- ggplot(dl, aes(x = odsetek, y = pozycja, fill = grupa, colour = grupa)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75, linewidth = 0.5) +
  scale_fill_manual(values = c("Kobiety" = oi[["kobiety"]], "Mężczyźni" = "white"), breaks = c("Kobiety", "Mężczyźni")) +
  scale_colour_manual(values = c("Kobiety" = oi[["kobiety"]], "Mężczyźni" = oi[["mezczyzni"]]), breaks = c("Kobiety", "Mężczyźni")) +
  scale_x_continuous(limits = c(0, 100), expand = c(0, 0)) +
  labs(title = "A. Słupki grupowane", x = "Odsetek „zgadzam się” (%)", y = NULL, fill = NULL, colour = NULL)

# B: hantle – odcinek od mężczyzn do kobiet, wiersze posortowane według różnicy K − M
d$pozycja <- factor(d$pozycja, levels = d$pozycja)
d$etykieta <- sub("-", "\u2212", sprintf("%+.0f", d$roznica))
dp <- rbind(data.frame(pozycja = d$pozycja, grupa = "Kobiety", odsetek = d$K),
            data.frame(pozycja = d$pozycja, grupa = "Mężczyźni", odsetek = d$M))
pB <- ggplot(d, aes(y = pozycja)) +
  geom_segment(aes(x = M, xend = K, yend = pozycja), colour = oi[["szary"]], linewidth = 1.2) +
  geom_point(data = dp, aes(x = odsetek, colour = grupa, shape = grupa), size = 3.2) +
  geom_text(aes(x = 92, label = etykieta), colour = "grey20", size = 3.6, hjust = 1) +
  scale_colour_manual(values = c("Kobiety" = oi[["kobiety"]], "Mężczyźni" = oi[["mezczyzni"]])) +
  scale_shape_manual(values = c("Kobiety" = 16, "Mężczyźni" = 17)) +
  scale_x_continuous(limits = c(20, 92), breaks = seq(20, 80, 20)) +
  labs(title = "B. Hantle, sortowanie według różnicy", subtitle = "Po prawej: różnica K − M w p.p.",
       x = "Odsetek „zgadzam się” (%)", y = NULL, colour = NULL, shape = NULL)
p1 <- (pA + pB + plot_layout(widths = c(1, 1.1))) & motyw
p1
Wynik w R
                          pozycja    K    M roznica dolna gorna
        Sam(a) rozwiązuję zadania 49.2 56.2    -7.1 -17.0   2.9
                   Rozumiem wzory 45.8 50.0    -4.2 -14.2   5.8
 Statystyka przyda mi się w pracy 60.4 64.4    -4.0 -13.6   5.7
                    Korzystam z R 28.3 31.9    -3.5 -12.7   5.7
      Lubię zajęcia ze statystyki 36.2 35.0     1.2  -8.3  10.8
  Sprawdzam wyniki w kalkulatorze 48.3 42.5     5.8  -4.1  15.8
                Czytam podręcznik 38.3 28.1    10.2   0.9  19.5
        Oglądam nagrania wykładów 63.3 48.1    15.2   5.4  25.1
                Boję się egzaminu 66.7 45.0    21.7  11.9  31.4
                Uczę się w grupie 57.5 34.4    23.1  13.5  32.8
      Proszę prowadzącego o pomoc 55.4 23.1    32.3  23.2  41.4
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie i przedziały – funkcje bazowe rbinom(), qnorm(); rysunek – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym wykres hantlowy różni się od wykresu nachyleń?
Oba pokazują dwie wartości i różnicę między nimi. W wykresie hantlowym kategorie leżą w wierszach, a obie wartości na jednej poziomej osi, więc łatwo posortować wiele kategorii według różnicy. Wykres nachyleń stawia dwie pionowe osie (np. przed i po) i łączy je liniami, co lepiej pokazuje zmianę rang i pojedyncze jednostki.
Kiedy wybrać wykres hantlowy zamiast słupków grupowanych?
Gdy pytanie dotyczy różnicy między dwiema seriami w wielu kategoriach. Słupki grupowane każą porównywać końce sąsiednich słupków i muszą zaczynać się od zera, a hantla pokazuje różnicę jako odcinek na jednej osi, którą można przyciąć do zakresu danych.
Jak narysować wykres hantlowy w ggplot2?
Dane w układzie szerokim: geom_segment() z x = pierwsza wartość i xend = druga rysuje odcinek, a geom_point() na danych w układzie długim dodaje dwa punkty o różnym kształcie i kolorze. Kolejność wierszy ustala factor() lub reorder() według różnicy.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wykresy w pracy dyplomowej
Jaki wykres do jakich danych, błędy źle → dobrze, podpis rysunku i gotowe zdania opisu wykresu w rozdziale wyników.
Czytaj →PoradnikBadanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →PoradnikPorównanie grup na wykresie: od słupka do raincloud
Jeden zbiór na pięciu wykresach w R: słupek ± SE i ± SD, pudełko, skrzypce, punkty z 95% CI i raincloud – co każdy ukrywa, podpisy i zdania do Wyników.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cleveland, W. S. (1984). Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging. The American Statistician, 38(4), 270–280. https://doi.org/10.1080/00031305.1984.10483224
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
Cytowania BibTeX
@article{cleveland1984dot, author={Cleveland, William S.}, title={{Graphical methods for data presentation: Full scale breaks, dot charts, and multibased logging}}, journal={The American Statistician}, year={1984}, volume={38}, number={4}, pages={270--280}, doi={10.1080/00031305.1984.10483224}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}