Co to jest wykres nachyleń?
Wykres nachyleń (ang. slopegraph, slope chart) pokazuje dwa pomiary tych samych jednostek – osób, szkół, krajów – na dwóch pionowych osiach o tej samej skali. Wartości jednej jednostki łączy odcinek: jego kierunek i nachylenie to zmiana, a przecięcie z innym odcinkiem oznacza, że dwie jednostki zamieniły się miejscami. Ten typ wykresu jest kojarzony z Edwardem Tuftem, autorem klasycznej książki o graficznym przedstawianiu danych ilościowych (Tufte, 1983). Sprawdza się przy danych sparowanych: przed i po, w dwóch latach, w dwóch warunkach eksperymentu.
Jak czytać wykres
- Nachylenie odcinka to zmiana jednostki. Odcinek poziomy – brak zmiany.
- Przecinające się odcinki to zmiana kolejności. Wiele przecięć oznacza słabą zgodność rankingów; tę zgodność opisuje korelacja rang (rangowanie).
- Odcinki prawie równoległe oznaczają podobną zmianę u wszystkich – wtedy wystarczy podać średnią zmianę.
- Skrajne wartości na lewej osi warto obejrzeć osobno: często przesuwają się w stronę środka, czyli działa regresja do średniej.
Przykład
Symulowano średnie wyniki egzaminu 12 szkół w latach 2024 i 2025. Każda szkoła ma stały poziom, a wynik w danym roku to ten poziom plus losowa zmienność rocznika – w danych nie ma więc żadnej prawdziwej poprawy ani pogorszenia. Mimo to 5 szkół „poprawiło się”, a 7 „pogorszyło”, a 5 szkół przesunęło się w rankingu o co najmniej 3 miejsca. Korelacja wyników z obu lat wyniosła r = .69, a rang – ρ = .73. Trzy najlepsze szkoły z 2024 roku straciły średnio 5.2 punktu procentowego. Parametry (rozrzut poziomów szkół i zmienność rocznika) ustawiono ręcznie tak, by zmienność między latami była wyraźna; ziarna 738 nie zmieniano.
Na rysunku
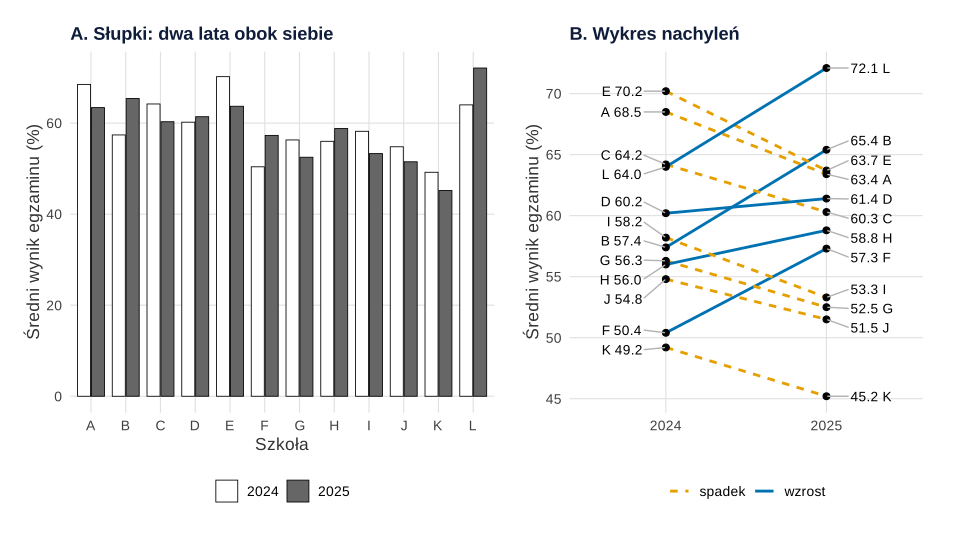
set.seed(738)).Co widać. Na słupkach (A) zmianę trzeba ocenić, porównując wysokości dwóch sąsiednich słupków, a kolejności szkół w każdym roku praktycznie nie da się odczytać. Weissgerber i in. (2015) przypominają, że wykresy słupkowe i liniowe średnich pokazują tylko podsumowanie, a różne dane mogą dać ten sam obraz. Na wykresie nachyleń (B) widać od razu kierunek zmiany, jej wielkość i przetasowania: szkoła L awansowała z 64.0 na 72.1 i na pierwsze miejsce, a szkoły E i A, najlepsze w 2024 roku, straciły 6.5 i 5.1 punktu i spadły na 3. i 4. miejsce.
Na co uważać. Wykres nie odróżnia prawdziwej zmiany od losowej zmienności. W przykładzie żadna szkoła się nie zmieniła, a linie i tak wyglądają na „historie sukcesu i porażki”. Wnioski o zmianie wymagają modelu i przedziałów ufności; dla osób – testu dla par (test t dla prób zależnych) albo analizy wyniku różnicowego. Jak duża jest pozorna zmiana skrajnych wyników przy różnej korelacji pomiarów, pokazuje wpis Regresja do średniej – wizualizacja.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Kolor nie może być jedynym nośnikiem kierunku. Dodaj rodzaj linii albo podpisy wartości.
- Za dużo jednostek. Przy kilkudziesięciu liniach podpisy się nakładają – wtedy lepszy jest wykres rozrzutu pomiaru 2 względem pomiaru 1 albo wykres spaghetti z wyróżnionymi jednostkami.
- Ranking z małych prób jest niestabilny. Przy kilkunastu jednostkach przesunięcia o kilka miejsc mogą być czystym przypadkiem. Rozkład różnic osób przed i po oraz wpływ korelacji pomiarów pokazuje wpis Próby zależne w obrazkach.
- Słupki nadal mają sens, gdy liczy się wielkość bezwzględna od zera, np. liczebności (wykres słupkowy).
Wykres nachyleń w R
Kod symuluje wyniki szkół, liczy korelacje, zmiany rang i średnią zmianę skrajnych szkół, a potem rysuje rysunek 1. Wykres nachyleń w ggplot2 to geom_line() z group = szkola na osi z dwiema kategoriami; podpisy rozsuwa geom_text_repel() z pakietu ggrepel (z ustalonym seed, żeby układ był powtarzalny). Rysunek na stronie powstał z obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Słupki a wykres nachyleń
R
# Wykres nachyleń (slopegraph) a słupki: 12 szkół w dwóch latach (dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(ggrepel)})
kol <- c(wzrost = "#0072B2", spadek = "#E69F00")      # Okabe–Ito; kierunek także rodzajem linii
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(738)
k <- 12
poziom <- rnorm(k, 60, 6)                             # stały „prawdziwy” poziom szkoły
d <- data.frame(szkola = LETTERS[1:k],
                r2024 = round(poziom + rnorm(k, 0, 4), 1),   # wynik = poziom + losowa zmienność rocznika
                r2025 = round(poziom + rnorm(k, 0, 4), 1))
d$zmiana <- d$r2025 - d$r2024
d$kierunek <- ifelse(d$zmiana > 0, "wzrost", "spadek")
d$ranga24 <- rank(-d$r2024); d$ranga25 <- rank(-d$r2025)
round(c(r = cor(d$r2024, d$r2025), rho_spearmana = cor(d$ranga24, d$ranga25)), 2)
c(wzrosty = sum(d$zmiana > 0), zmiana_rangi_o_3_i_wiecej = sum(abs(d$ranga24 - d$ranga25) >= 3))
gora <- d$ranga24 <= 3; dol <- d$ranga24 >= k - 2     # 3 najlepsze i 3 najsłabsze w 2024
round(c(srednia_zmiana_top3 = mean(d$zmiana[gora]), srednia_zmiana_dol3 = mean(d$zmiana[dol])), 1)
dl <- rbind(data.frame(szkola = d$szkola, rok = "2024", wynik = d$r2024, kierunek = d$kierunek),
            data.frame(szkola = d$szkola, rok = "2025", wynik = d$r2025, kierunek = d$kierunek))
pA <- ggplot(dl, aes(szkola, wynik, fill = rok)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75, colour = "black", linewidth = 0.3) +
  scale_fill_manual(values = c("2024" = "white", "2025" = "grey40"), name = NULL) +
  labs(title = "A. Słupki: dwa lata obok siebie", x = "Szkoła", y = "Średni wynik egzaminu (%)") +
  theme(legend.position = "bottom")
pB <- ggplot(dl, aes(rok, wynik, group = szkola)) +
  geom_line(aes(colour = kierunek, linetype = kierunek), linewidth = 1) + geom_point(size = 2) +
  geom_text_repel(data = subset(dl, rok == "2024"), aes(label = paste(szkola, sprintf("%.1f", wynik))),
                  nudge_x = -0.15, direction = "y", hjust = 1, size = 3.6, segment.colour = "grey70", seed = 738) +
  geom_text_repel(data = subset(dl, rok == "2025"), aes(label = paste(sprintf("%.1f", wynik), szkola)),
                  nudge_x = 0.15, direction = "y", hjust = 0, size = 3.6, segment.colour = "grey70", seed = 738) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c(wzrost = "solid", spadek = "22"), name = NULL) +
  scale_x_discrete(expand = expansion(add = 0.6)) +
  labs(title = "B. Wykres nachyleń", x = NULL, y = "Średni wynik egzaminu (%)") +
  theme(legend.position = "bottom")
p1 <- (pA + pB + plot_layout(widths = c(1.2, 1))) & motyw & theme(legend.position = "bottom")
p1
Wynik w R
            r rho_spearmana
         0.69          0.73
                  wzrosty zmiana_rangi_o_3_i_wiecej
                        5                         5
srednia_zmiana_top3 srednia_zmiana_dol3
               -5.2                -0.1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe cor(), rank(), rnorm(); rysunek – pakiety ggplot2, ggrepel i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym wykres nachyleń różni się od wykresu spaghetti?
Wykres nachyleń ma dwa pomiary i zwykle podpisane jednostki, więc da się odczytać wartości i zmianę kolejności. Wykres spaghetti obejmuje wiele pomiarów i służy raczej do oglądania kształtu trajektorii niż do odczytu konkretnych jednostek.
Ile jednostek zmieści się na wykresie nachyleń?
Z podpisami – zwykle do 15–20. Przy większej liczbie podpisy nachodzą na siebie; wtedy rysuje się linie bez podpisów (szare, z wyróżnieniem kilku jednostek) albo zamiast tego wykres rozrzutu pomiaru drugiego względem pierwszego.
Czy oś wykresu nachyleń musi zaczynać się od zera?
Nie. Wartości są zaznaczone położeniem punktów, a nie długością słupków, więc oś może obejmować tylko zakres danych. Obie kolumny muszą jednak mieć tę samą skalę, bo inaczej nachylenia nic nie znaczą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Próby zależne w obrazkach
Te same 30 par dwoma testami, rozkład różnic, korelacja pomiarów od −.5 do .8, moc z symulacji i regresja do średniej – pięć rysunków z kodem R.
Czytaj →PoradnikRegresja do średniej – wizualizacja na obrazkach
Wynik prawdziwy i błąd, strzałki przed–po, chmura pomiarów w przód i wstecz, korelacja test–retest i 1000 badań kursu bez efektu – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Tufte, E. R. (1983). The visual display of quantitative information. Graphics Press.
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@book{tufte1983visual, author={Tufte, Edward R.}, title={{The visual display of quantitative information}}, year={1983}, publisher={Graphics Press}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}