Co to jest wykres spaghetti?
Wykres spaghetti (ang. spaghetti plot) to wykres danych z powtarzanymi pomiarami, w którym wyniki każdej osoby łączy osobna linia. Na osi poziomej jest czas (tydzień, fala badania, wiek), na pionowej – wynik. Swihart i in. (2010) nazywają go standardowym sposobem pokazywania surowych danych podłużnych. Do wykresu potrzebne są dane w formacie długim: jeden wiersz to jeden pomiar jednej osoby.
Jak czytać wykres
- Kierunek linii – czy większość osób rośnie, spada, czy kierunki są mieszane.
- Kształt linii – stopniowa zmiana czy nagły skok, a jeśli skok, to w którym momencie.
- Rozrzut na starcie i na końcu – czy linie się rozchodzą (różne tempo zmiany, czyli losowe nachylenie), czy biegną równolegle.
- Linie krótsze od innych – osoby, które odpadły z badania. Ich brak może zmieniać średnią w późnych pomiarach.
Przykład
Symulowano 40 osób mierzonych co dwa tygodnie przez 10 tygodni. Każda osoba ma przez pewien czas stały wynik, potem jednorazowo spada o około 9 punktów i dalej utrzymuje nowy poziom. Moment spadku jest u każdego inny. Średnia grupy spadła z 29.82 do 20.88 punktu, w kolejnych odstępach o 2.29, 2.59, 1.25, 2.61 i 0.20 punktu. Wygląda to na stopniową poprawę, a żadna osoba tak się nie zmieniała: u typowej osoby jeden odstęp między pomiarami obejmował całą zmianę (mediana ilorazu największego spadku do zmiany całkowitej = 1.04). W 6. tygodniu tylko 38% osób miało wynik w odległości 2 punktów od średniej (23.69). Na ten problem – wnioskowanie o przebiegu zmiany u osoby z krzywej średniej grupy – zwracał uwagę już Estes (1956). Parametry symulacji (wielkość i rozkład momentu spadku) ustawiono ręcznie tak, by skoki były wyraźne; ziaren 737 i 7370 nie zmieniano.
Na rysunku
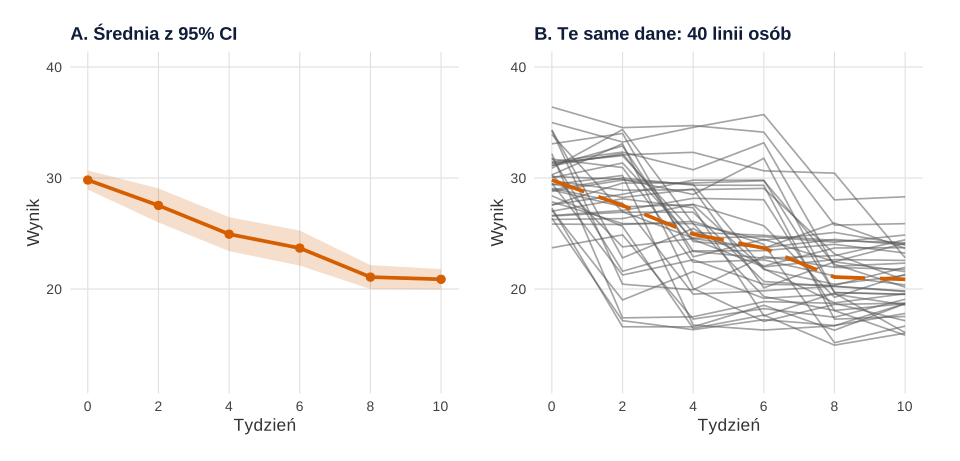
set.seed(737)).Co widać. Panel A sugeruje równomierny spadek o około 2 punkty na dwa tygodnie. Panel B pokazuje, że spadek był skokowy u każdej osoby, a gładkość średniej bierze się z tego, że skoki wypadały w różnych tygodniach.
Na co uważać. Wykres spaghetti nie mówi, skąd biorą się różnice między liniami, ani czy są większe niż błąd pomiaru. Do tego służy model wielopoziomowy albo krzywa wzrostu; podgrupy trajektorii opisuje model mieszanin wzrostu. Inny przypadek – płaską średnią złożoną z osób, które zmieniają się w przeciwnych kierunkach – oraz wykres średnich z liczbą osób pod osią pokazuje wpis Dane podłużne na wykresie.
Podpis do pracy:
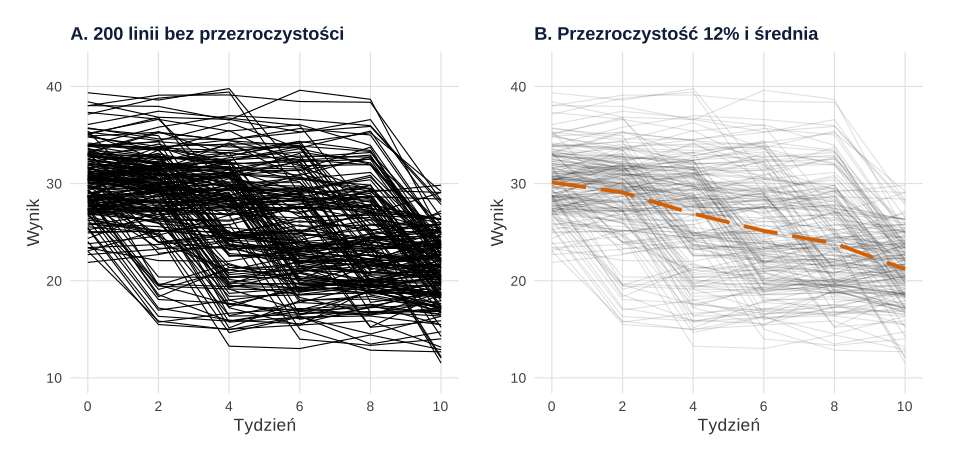
set.seed(7370)).Co widać. Przy 200 osobach pełne linie tworzą plamę (A). Po zmniejszeniu krycia (B) ciemniejsze są miejsca, przez które przechodzi wiele linii: widać dwa pasma, „przed spadkiem” i „po spadku”, a średnia biegnie przez przerwę między nimi. Swihart i in. (2010) opisują to nakładanie się linii jako główną słabość wykresu przy dużych próbach i proponują wykres lasagna (mapę ciepła, w której każda osoba to jeden wiersz).
Na co uważać. Pojedyncza nietypowa osoba przy niskim kryciu prawie znika. Gdy chodzi o osoby, a nie o gęstość, lepiej dodać kilka wyróżnionych trajektorii albo panele z wybranymi osobami.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Kolor osób nie niesie informacji. Czterdzieści różnych barw to szum; osoby rysuj na szaro, a kolor zostaw dla średniej albo dla grup.
- Oś czasu w rzeczywistych odstępach. Pomiary w tygodniach 0, 1, 2, 4 i 8 rozmieszczone równo zniekształcają tempo zmiany.
- Linia łączy tylko zmierzone punkty. Odcinek między pomiarami nie jest obserwacją. Dla dwóch pomiarów lepszy bywa wykres nachyleń.
Wykres spaghetti w R
Kod symuluje dane w formacie długim, liczy średnie z przedziałami ufności i rysuje oba rysunki w ggplot2. Linie osób rysuje geom_line() z group = id; przezroczystość ustawia argument alpha. Rysunki na stronie powstały z obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Średnia grupy a linie osób
R
# Wykres spaghetti: średnia grupy a linie osób (dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(srednia = "#D55E00", osoby = "grey35")       # Okabe–Ito + szarość
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
tygodnie <- c(0, 2, 4, 6, 8, 10)
symuluj <- function(n) {                              # każda osoba: płasko, jeden skok w dół, znowu płasko
  b <- rnorm(n, 30, 3)                                # poziom wyjściowy
  skok <- sample(2:6, n, replace = TRUE)              # numer pomiaru, od którego wynik jest niższy
  d <- rnorm(n, 9, 1.5)                               # wielkość spadku
  do.call(rbind, lapply(seq_len(n), function(i)
    data.frame(id = i, tydzien = tygodnie,
               wynik = b[i] - d[i] * (seq_along(tygodnie) >= skok[i]) + rnorm(6, 0, 1))))
}
set.seed(737)                                         # rysunek 1: 40 osób
d40 <- symuluj(40)
sr <- aggregate(wynik ~ tydzien, d40, function(x) c(m = mean(x), se = sd(x) / sqrt(length(x))))
sr <- data.frame(tydzien = sr$tydzien, m = sr$wynik[, "m"], se = sr$wynik[, "se"])
zm <- setNames(diff(sr$m), paste0("t", tygodnie[-6], "-", tygodnie[-1]))  # zmiana średniej między pomiarami
skoki <- sapply(split(d40$wynik, d40$id), function(y) min(diff(y)) / (y[6] - y[1]))
round(c(srednia_t0 = sr$m[1], srednia_t10 = sr$m[6]), 2)
round(zm, 2)
round(c(udzial_najwiekszego_skoku = median(skoki)), 2)  # mediana: największy spadek / cała zmiana osoby
w6 <- d40$wynik[d40$tydzien == 6]                     # tydzień 6: ile osób jest blisko średniej?
round(c(srednia_t6 = mean(w6), odsetek_w_pasie_2pkt = mean(abs(w6 - mean(w6)) < 2)), 2)
pA <- ggplot(sr, aes(tydzien, m)) +
  geom_ribbon(aes(ymin = m - 1.96 * se, ymax = m + 1.96 * se), fill = kol[["srednia"]], alpha = 0.2) +
  geom_line(colour = kol[["srednia"]], linewidth = 1.3) + geom_point(colour = kol[["srednia"]], size = 2.5) +
  scale_x_continuous(breaks = tygodnie) + coord_cartesian(ylim = c(12, 40)) +
  labs(title = "A. Średnia z 95% CI", x = "Tydzień", y = "Wynik")
pB <- ggplot(d40, aes(tydzien, wynik, group = id)) +
  geom_line(colour = kol[["osoby"]], alpha = 0.55) +
  geom_line(data = sr, aes(tydzien, m), inherit.aes = FALSE, colour = kol[["srednia"]],
            linewidth = 1.3, linetype = "longdash") +
  scale_x_continuous(breaks = tygodnie) + coord_cartesian(ylim = c(12, 40)) +
  labs(title = "B. Te same dane: 40 linii osób", x = "Tydzień", y = "Wynik")
p1 <- (pA + pB) & motyw
set.seed(7370)                                        # rysunek 2: 200 osób, ten sam mechanizm
d200 <- symuluj(200)
sr200 <- aggregate(wynik ~ tydzien, d200, mean)
pC <- ggplot(d200, aes(tydzien, wynik, group = id)) + geom_line(colour = "black", linewidth = 0.4) +
  scale_x_continuous(breaks = tygodnie) + coord_cartesian(ylim = c(10, 42)) +
  labs(title = "A. 200 linii bez przezroczystości", x = "Tydzień", y = "Wynik")
pD <- ggplot(d200, aes(tydzien, wynik, group = id)) +
  geom_line(colour = "black", linewidth = 0.4, alpha = 0.12) +
  geom_line(data = sr200, aes(tydzien, wynik), inherit.aes = FALSE, colour = kol[["srednia"]],
            linewidth = 1.3, linetype = "longdash") +
  scale_x_continuous(breaks = tygodnie) + coord_cartesian(ylim = c(10, 42)) +
  labs(title = "B. Przezroczystość 12% i średnia", x = "Tydzień", y = "Wynik")
p2 <- (pC + pD) & motyw
p1
p2
Wynik w R
 srednia_t0 srednia_t10
      29.82       20.88
 t0-2  t2-4  t4-6  t6-8 t8-10
-2.29 -2.59 -1.25 -2.61 -0.20
udzial_najwiekszego_skoku
                     1.04
          srednia_t6 odsetek_w_pasie_2pkt
               23.69                 0.38
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe aggregate(), rnorm(), sample(); rysunki – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Ile linii można pokazać na wykresie spaghetti?
Kilkadziesiąt linii zwykle da się czytać bez zabiegów. Przy kilkuset liniach trzeba zmniejszyć krycie (przezroczystość), pokazać losową próbkę osób albo rozdzielić je na panele według grupy. W przykładzie 200 nieprzezroczystych linii zlewa się w jedną plamę.
Czy na wykresie spaghetti rysować także średnią?
Tak, ale tak, żeby się wyróżniała: grubsza linia, inny kolor i inny rodzaj linii. Średnia odpowiada na pytanie o grupę, linie osób – o to, jak różnie zmieniają się osoby. Dopiero razem pokazują, czy średnia jest typowa.
Jak przygotować dane do wykresu spaghetti w R?
Dane muszą być w formacie długim: jeden wiersz to jeden pomiar jednej osoby, z kolumnami identyfikatora, czasu i wyniku. W ggplot2 linię każdej osoby rysuje geom_line() z argumentem group = id.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Dane podłużne na wykresie
Wykres spaghetti, średnie z 95% CI i liczbą osób, rzeczywista oś czasu i trajektorie z modelu mieszanego – sześć rysunków z kodem R i podpisami.
Czytaj →PoradnikModel mieszany w obrazkach
Strzałki od średnich szkół do modelu, kurczenie a liczebność i ICC, wachlarz losowych nachyleń i wykres gąsienicowy – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Estes, W. K. (1956). The problem of inference from curves based on group data. Psychological Bulletin, 53(2), 134–140. https://doi.org/10.1037/h0045156
- Swihart, B. J., Caffo, B., James, B. D., Strand, M., Schwartz, B. S., & Punjabi, N. M. (2010). Lasagna plots: A saucy alternative to spaghetti plots. Epidemiology, 21(5), 621–625. https://doi.org/10.1097/ede.0b013e3181e5b06a ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{estes1956problem, author={Estes, W. K.}, title={{The problem of inference from curves based on group data}}, journal={Psychological Bulletin}, year={1956}, volume={53}, number={2}, pages={134--140}, doi={10.1037/h0045156}}@article{swihart2010lasagna, author={Swihart, Bruce J. and Caffo, Brian and James, Bryan D. and Strand, Matthew and Schwartz, Brian S. and Punjabi, Naresh M.}, title={{Lasagna plots: A saucy alternative to spaghetti plots}}, journal={Epidemiology}, year={2010}, volume={21}, number={5}, pages={621--625}, doi={10.1097/ede.0b013e3181e5b06a}}