Co to są małe wielokrotności?
Małe wielokrotności (ang. small multiples; także wykres panelowy, siatka paneli, w ggplot2 – facety) to seria małych wykresów tego samego typu, w tym samym układzie i zwykle na tych samych osiach, z których każdy pokazuje inny podzbiór danych: ośrodek, kraj, grupę wieku. Nazwę spopularyzował Tufte (1983). Zamiast upychać dwanaście linii na jednym wykresie, dostajemy dwanaście czytelnych paneli, które oko porównuje jak klatki filmu.
Kiedy go użyć
- Wiele serii, które się nakładają – np. trajektorie w kilkunastu ośrodkach albo krajach. Javed, McDonnel i Elmqvist (2010) stwierdzili w badaniu z użytkownikami, że osobne wykresy dla każdej serii (m.in. małe wielokrotności) są zwykle sprawniejsze przy porównaniach serii w szerokim zakresie, a wspólny wykres liniowy – przy porównaniach na małym fragmencie, gdzie nakładanie się linii mniej przeszkadza.
- Ten sam wykres dla podgrup – histogram, wykres spaghetti albo wykres rozrzutu osobno dla każdej grupy.
- Zamiast warstw i kolorów, gdy kategorii jest więcej niż 4–5 i legenda przestaje wystarczać – np. zamiast wykresu warstwowego.
Trzy decyzje przesądzają o czytelności: wspólna czy wolna skala osi, kolejność paneli i tło (pozostałe serie na szaro w każdym panelu, żeby było z czym porównać).
Przykład
Symulowano średnie nasilenie lęku (skala 0–40) w 12 ośrodkach prowadzących ten sam program terapii, z pomiarami w tygodniach 0, 2, 4, 8 i 12. Ośrodki liczyły od 8 do 27 osób; wynik początkowy i tempo spadku różniły się między ośrodkami (parametry ustawione ręcznie, ziarno 776). Spadek od tygodnia 0 do 12 wyniósł od 12.3 punktu (ośrodek O05) do 5.1 punktu (O08).
Na rysunku
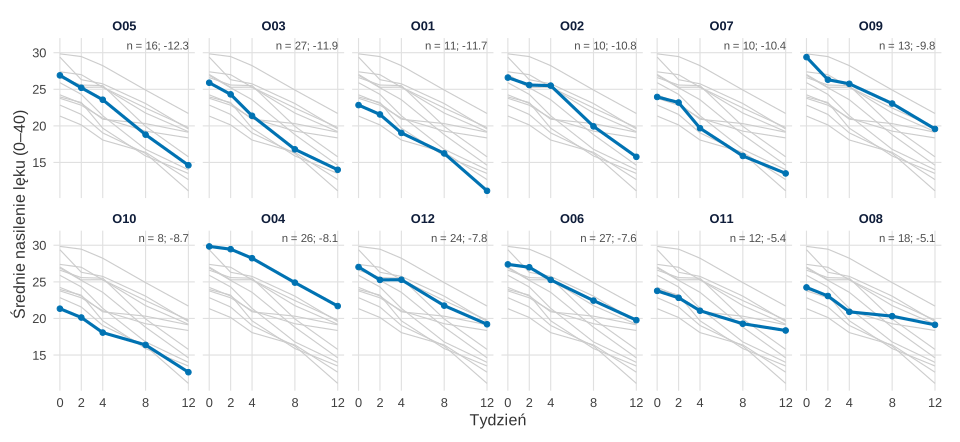
set.seed(776)).Co widać. Wspólna skala pozwala porównać i poziom, i nachylenie: O09 i O04 zaczynają najwyżej (29.4 i 29.8 punktu) i kończą powyżej większości ośrodków, a O01 i O10 zaczynają nisko. Sortowanie według zmiany robi z siatki ranking – górny rząd to ośrodki z największym spadkiem. Szare tło mówi, czy dany ośrodek odstaje od reszty, bez szukania w sąsiednich panelach.
Na co uważać. Panele pokazują średnie, a ośrodki mają od 8 do 27 osób – średnia z ośmiu osób jest dużo mniej pewna. Ranking z takich średnich trzeba sprawdzić modelem, np. wielopoziomowym z wykresem gąsienicowym efektów losowych.
Podpis do pracy:
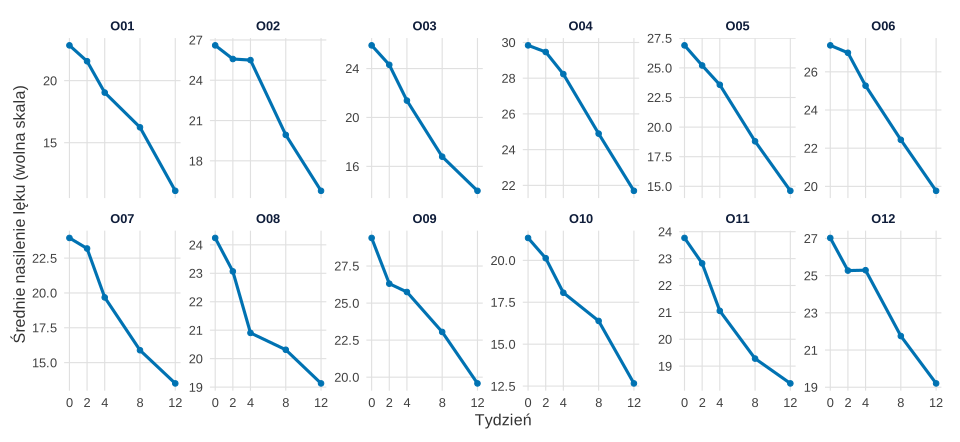
set.seed(776)).Co widać. Każdy panel rozciąga się na całą wysokość, więc spadek o 5.1 punktu w O08 wygląda tak samo dramatycznie jak spadek o 12.3 punktu w O05. Kolejność alfabetyczna nie niesie informacji, więc oko nie ma od czego zacząć.
Na co uważać. Wolna skala ma sens, gdy panele mierzą różne zmienne (np. wzrost, waga i ciśnienie) albo interesuje nas wyłącznie kształt przebiegu. Jeśli jej używasz, napisz to w podpisie – czytelnik zakłada skalę wspólną.
Podpis do pracy:
Jak opisać w pracy
Podaj, co jest jednym panelem, czy skale są wspólne, jak uporządkowano panele i co jest w tle. Liczby z wykresu przytocz w tekście.
Na co uważać
- Za dużo paneli. Powyżej 20–30 paneli nie da się ich porównać; lepiej pokazać jedną miarę na wykresie punktowym.
- Różne osie X. Inne zakresy czasu w panelach psują porównanie tak samo jak wolna oś Y.
- Tylko średnie. Przy danych podłużnych pokaż też osoby – jak we wpisie dane podłużne na wykresie.
Małe wielokrotności w R
W ggplot2 panele tworzy facet_wrap(); argument scales = "free_y" uwalnia oś Y, a kolejność paneli ustala się poziomami czynnika. Tło z pozostałych serii to osobna warstwa z danymi bez zmiennej panelowej – ggplot2 rysuje ją wtedy w każdym panelu. Rysunki na stronie powstały z obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Panele ze wspólną i wolną skalą, sortowanie i tło
R
# Małe wielokrotności (small multiples): 12 ośrodków, wspólna vs wolna skala osi Y, kolejność paneli
suppressPackageStartupMessages({library(ggplot2)})
kol <- c(osrodek = "#0072B2", tlo = "grey80")   # Okabe–Ito; tło (inne ośrodki) różni się też grubością linii
motyw <- theme_minimal(base_size = 12) + theme(panel.grid.minor = element_blank(), legend.position = "none")
# Nasilenie lęku (0–40) w 12 ośrodkach: pomiar w tygodniach 0, 2, 4, 8, 12; różne liczebności ośrodków
set.seed(776)
tyg <- c(0, 2, 4, 8, 12)
osrodki <- data.frame(osrodek = sprintf("O%02d", 1:12), n = sample(8:30, 12, replace = TRUE),
                      start = rnorm(12, 26, 2.5), spadek = rnorm(12, -0.6, 0.3))
dane <- do.call(rbind, lapply(seq_len(nrow(osrodki)), function(i) {
  o <- osrodki[i, ]; id <- rep(seq_len(o$n), each = length(tyg))
  data.frame(osrodek = o$osrodek, osoba = id, tydzien = rep(tyg, o$n),
             lek = o$start + rnorm(o$n, 0, 4)[id] + o$spadek * rep(tyg, o$n) + rnorm(o$n * length(tyg), 0, 3))
}))
# Średnie ośrodków w każdym tygodniu
sr <- aggregate(lek ~ osrodek + tydzien, data = dane, FUN = mean)
zmiana <- sapply(split(sr, sr$osrodek), function(d) d$lek[d$tydzien == 12] - d$lek[d$tydzien == 0])
# Kolejność paneli: od największego spadku; tło = średnie wszystkich ośrodków; etykieta = n i zmiana 0→12 tyg.
sr$panel <- factor(sr$osrodek, levels = names(sort(zmiana)))
tlo <- transform(sr, grupa = osrodek)[, c("grupa", "tydzien", "lek")]
etyk <- data.frame(panel = factor(names(zmiana), levels = levels(sr$panel)),
                   tekst = sprintf("n = %d; %.1f", osrodki$n[match(names(zmiana), osrodki$osrodek)], zmiana))
p1 <- ggplot(sr, aes(tydzien, lek)) +
  geom_line(data = tlo, aes(group = grupa), colour = kol[["tlo"]], linewidth = 0.4) +
  geom_line(colour = kol[["osrodek"]], linewidth = 1.1) + geom_point(colour = kol[["osrodek"]], size = 1.6) +
  geom_text(data = etyk, aes(x = 12, y = 31, label = tekst), hjust = 1, size = 3, colour = "grey30") +
  facet_wrap(~ panel, ncol = 6) + scale_x_continuous(breaks = tyg) +
  labs(x = "Tydzień", y = "Średnie nasilenie lęku (0–40)") + motyw
# Te same dane: wolna skala osi Y i kolejność alfabetyczna
sr$alfabet <- factor(sr$osrodek)
p2 <- ggplot(sr, aes(tydzien, lek)) +
  geom_line(colour = kol[["osrodek"]], linewidth = 1.1) + geom_point(colour = kol[["osrodek"]], size = 1.6) +
  facet_wrap(~ alfabet, ncol = 6, scales = "free_y") + scale_x_continuous(breaks = tyg) +
  labs(x = "Tydzień", y = "Średnie nasilenie lęku (wolna skala)") + motyw
# Wyniki: liczebność, średnia w tygodniu 0 i 12, zmiana – w kolejności paneli rysunku 1
tab <- data.frame(osrodek = names(zmiana), n = osrodki$n[match(names(zmiana), osrodki$osrodek)],
                  tydz0 = sr$lek[sr$tydzien == 0][match(names(zmiana), sr$osrodek[sr$tydzien == 0])],
                  tydz12 = sr$lek[sr$tydzien == 12][match(names(zmiana), sr$osrodek[sr$tydzien == 12])],
                  zmiana = zmiana)
tab <- tab[order(tab$zmiana), ]
print(transform(tab, tydz0 = round(tydz0, 1), tydz12 = round(tydz12, 1), zmiana = round(zmiana, 1)), row.names = FALSE)
round(range(sr$lek), 1)
p1
Wynik w R
 osrodek  n tydz0 tydz12 zmiana
     O05 16  26.9   14.6  -12.3
     O03 27  25.9   14.0  -11.9
     O01 11  22.8   11.1  -11.7
     O02 10  26.6   15.8  -10.8
     O07 10  23.9   13.5  -10.4
     O09 13  29.4   19.6   -9.8
     O10  8  21.3   12.7   -8.7
     O04 26  29.8   21.7   -8.1
     O12 24  27.0   19.2   -7.8
     O06 27  27.4   19.8   -7.6
     O11 12  23.8   18.4   -5.4
     O08 18  24.2   19.1   -5.1
[1] 11.1 29.8
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe rnorm(), aggregate(); rysunki – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy panele w małych wielokrotnościach powinny mieć wspólną skalę?
Zwykle tak. Wspólna skala pozwala porównać poziom i nachylenie między panelami. Wolna skala ma sens, gdy panele pokazują różne zmienne albo liczy się tylko kształt przebiegu – i trzeba to napisać w podpisie.
W jakiej kolejności ułożyć panele?
Według czegoś, co ma znaczenie: wielkości efektu, średniej, liczebności albo naturalnego porządku (wiek, czas, region). Kolejność alfabetyczna jest dobra tylko wtedy, gdy czytelnik szuka konkretnej grupy po nazwie.
Ile paneli to za dużo?
Kilkanaście paneli da się porównać wzrokiem; przy kilkudziesięciu siatka staje się katalogiem. Wtedy lepiej streścić każdą grupę jedną liczbą z przedziałem ufności i pokazać je na wykresie punktowym albo gąsienicowym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Javed, W., McDonnel, B., & Elmqvist, N. (2010). Graphical perception of multiple time series. IEEE Transactions on Visualization and Computer Graphics, 16(6), 927–934. https://doi.org/10.1109/tvcg.2010.162
- Tufte, E. R. (1983). The visual display of quantitative information. Graphics Press.
Cytowania BibTeX
@article{javed2010graphical, author={Javed, Waqas and McDonnel, Bryan and Elmqvist, Niklas}, title={{Graphical perception of multiple time series}}, journal={IEEE Transactions on Visualization and Computer Graphics}, year={2010}, volume={16}, number={6}, pages={927--934}, doi={10.1109/tvcg.2010.162}}@book{tufte1983visual, author={Tufte, Edward R.}, title={{The visual display of quantitative information}}, year={1983}, publisher={Graphics Press}}