Co to jest wykres gąsienicowy?
Wykres gąsienicowy (ang. caterpillar plot) pokazuje przewidywane efekty losowe wszystkich grup z modelu wielopoziomowego, np. odchylenia szkół, oddziałów czy poradni od średniej ogólnej. Każda grupa to punkt z przedziałem, a grupy są posortowane od najniższego do najwyższego oszacowania. Punkty to przewidywania BLUP (ang. best linear unbiased predictions), w pakiecie lme4 zwracane przez funkcję ranef() (Bates i in., 2015). Czym efekty losowe różnią się od stałych, wyjaśnia hasło efekty stałe i losowe.
Jak czytać wykres
- Zero to średnia ogólna (efekt stały). Punkt po prawej – grupa powyżej przeciętnej, po lewej – poniżej.
- Odcinek to zwykle ±1.96 warunkowego błędu standardowego. Grupy, których odcinek nie obejmuje zera, odróżniają się od średniej ogólnej.
- Rozpiętość „gąsienicy” mówi o wariancji między grupami. Pozioma, płaska gąsienica oznacza niski ICC.
- Kurczenie. Oszacowania małych grup są przyciągnięte do zera mocniej niż dużych, bo model łączy średnią grupy ze średnią ogólną proporcjonalnie do ilości informacji.
Przykład
W symulowanych danych 512 pacjentów 30 poradni oceniło satysfakcję z opieki (0–100). Poradnie liczyły od 3 do 50 pacjentów. Parametry ustawiono ręcznie (średnia 70, SD między poradniami 4, wewnątrz poradni 12), by kurczenie było wyraźne; ziarna (752) nie zmieniano. Model z losowym wyrazem wolnym oszacował średnią ogólną na 70.44, odchylenie standardowe efektów poradni na 4.01, a resztowe na 12.01, ICC = .10.
Na rysunku
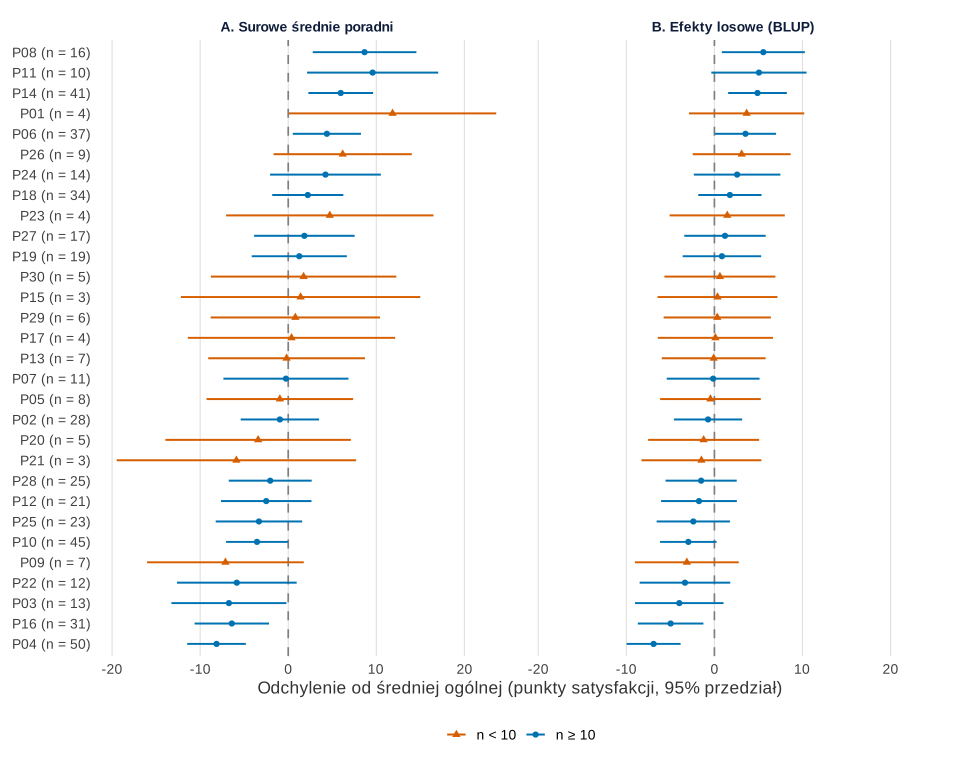
set.seed(752)).Co widać. Panel B to właściwy wykres gąsienicowy, a panel A pokazuje, co dałyby osobne średnie poradni. Rozstęp surowych odchyleń wynosi 19.99 punktu, a efektów losowych – 12.46. Najwyższą surową średnią ma poradnia P01 z 4 pacjentami (+11.85), ale jej efekt losowy to tylko +3.66 – czwarte miejsce od góry. Duża poradnia P04 (50 pacjentów) prawie zachowuje swoje odchylenie: −8.14 surowo i −6.90 w modelu. Przedziały surowe nie obejmują zera w 9 poradniach, przedziały efektów losowych – w 5.
Na co uważać. Przedziały w panelu B opierają się na warunkowych błędach standardowych i nie uwzględniają niepewności średniej ogólnej ani wariancji, więc są raczej za wąskie. Kolejność wierszy służy czytelności, a nie jest rankingiem. Leckie i Goldstein (2009) pokazali na rankingach szkół, że po uwzględnieniu niepewności tylko nieliczne szkoły da się wiarygodnie odróżnić od średniej i od siebie nawzajem. Więcej o tym w haśle ranking a ocena pozycji. Strzałki od średnich surowych do oszacowań z modelu, kurczenie przy dwóch poziomach ICC i niepewność miejsca w rankingu pokazuje wpis model mieszany w obrazkach.
Podpis do pracy:
Kod rysunku zawiera sekcja Wykres gąsienicowy w R. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Jak opisać w pracy
Na co uważać
- Ranking z wykresu. Sąsiednie poradnie mają zwykle nakładające się przedziały; „pierwsze miejsce” niewiele znaczy.
- Surowe średnie zamiast efektów losowych. Skrajne wartości najczęściej należą do najmniejszych grup – to efekt małej próby, nie jakości.
- Losowe nachylenia. Przy losowym nachyleniu narysuj osobną gąsienicę dla wyrazu wolnego i dla nachylenia; ich kolejność może się różnić.
Wykres gąsienicowy w R
Kod symuluje dane, dopasowuje model z losowym wyrazem wolnym funkcją lmer(), wyciąga efekty losowe z warunkowymi błędami standardowymi (ranef(…, condVar = TRUE)) i porównuje je z surowymi odchyleniami średnich poradni.
Efekty losowe 30 poradni i surowe średnie
R
# Wykres gąsienicowy: surowe odchylenia średnich poradni (A) i efekty losowe z modelu mieszanego (B)
suppressPackageStartupMessages({library(ggplot2); library(lme4)})
kol <- c("n < 10" = "#D55E00", "n ≥ 10" = "#0072B2")  # Okabe–Ito
ksz <- c("n < 10" = 17, "n ≥ 10" = 16)                # wielkość poradni też kształtem
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), panel.grid.major.y = element_blank(),
        legend.position = "bottom")
set.seed(752)                                       # 30 poradni, dane symulowane
J <- 30
n_j <- sample(round(exp(seq(log(3), log(50), length.out = J))))  # od 3 do 50 pacjentów
u <- rnorm(J, 0, 4)                                 # prawdziwe efekty poradni
d <- data.frame(poradnia = factor(rep(sprintf("P%02d", 1:J), n_j)))
d$wynik <- 70 + rep(u, n_j) + rnorm(nrow(d), 0, 12) # satysfakcja pacjenta (0–100)
m <- lmer(wynik ~ 1 + (1 | poradnia), data = d)
re <- ranef(m, condVar = TRUE)$poradnia
se_blup <- sqrt(attr(re, "postVar")[1, 1, ])
srednie <- tapply(d$wynik, d$poradnia, mean)
tab <- data.frame(poradnia = rownames(re), n = as.vector(table(d$poradnia)),
                  surowe = as.vector(srednie) - fixef(m)[[1]], blup = re[, 1])
tab$se_surowe <- sigma(m) / sqrt(tab$n)
tab$grupa <- ifelse(tab$n < 10, "n < 10", "n ≥ 10")
tab$etykieta <- sprintf("%s (n = %d)", tab$poradnia, tab$n)
tab$etykieta <- factor(tab$etykieta, levels = tab$etykieta[order(tab$blup)])  # kolejność wg BLUP
dl <- rbind(data.frame(tab, panel = "A. Surowe średnie poradni", est = tab$surowe,
                       dolna = tab$surowe - 1.96 * tab$se_surowe, gorna = tab$surowe + 1.96 * tab$se_surowe),
            data.frame(tab, panel = "B. Efekty losowe (BLUP)", est = tab$blup,
                       dolna = tab$blup - 1.96 * se_blup, gorna = tab$blup + 1.96 * se_blup))
p1 <- ggplot(dl, aes(est, etykieta, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey50") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), size = 0.35, linewidth = 0.7) +
  facet_wrap(~ panel) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  labs(x = "Odchylenie od średniej ogólnej (punkty satysfakcji, 95% przedział)", y = NULL) + motyw
vc <- as.data.frame(VarCorr(m))$vcov
round(c(srednia_ogolna = fixef(m)[[1]], tau = sqrt(vc[1]), sigma = sqrt(vc[2]), ICC = vc[1] / sum(vc)), 2)
c(N = nrow(d), CI_bez_zera_surowe = sum(abs(tab$surowe) > 1.96 * tab$se_surowe),
  CI_bez_zera_blup = sum(abs(tab$blup) > 1.96 * se_blup))
round(c(rozstep_surowe = diff(range(tab$surowe)), rozstep_blup = diff(range(tab$blup))), 2)
skrajne <- tab[c(which.max(tab$surowe), which.min(tab$surowe), which.max(tab$blup), which.min(tab$blup)),
               c("poradnia", "n", "surowe", "blup")]
skrajne[, 3:4] <- round(skrajne[, 3:4], 2)
print(skrajne, row.names = FALSE)
p1
Wynik w R
srednia_ogolna            tau          sigma            ICC
         70.44           4.01          12.01           0.10
                 N CI_bez_zera_surowe   CI_bez_zera_blup
               512                  9                  5
rozstep_surowe   rozstep_blup
         19.99          12.46
 poradnia  n surowe  blup
      P01  4  11.85  3.66
      P04 50  -8.14 -6.90
      P08 16   8.67  5.56
      P04 50  -8.14 -6.90
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (model – pakiet lme4; rysunek – pakiet ggplot2). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Skąd nazwa wykres gąsienicowy?
Posortowane punkty z poziomymi odcinkami układają się w wygięty pas, który przypomina gąsienicę: odcinki są „nóżkami”, a punkty – „tułowiem”. Nazwa nie ma znaczenia technicznego; ten sam wykres bywa nazywany wykresem efektów losowych.
Dlaczego efekty losowe małych grup są bliżej zera niż ich surowe średnie?
Model mieszany łączy średnią grupy ze średnią ogólną, a waga średniej grupy rośnie z jej liczebnością. Grupa z czterema osobami ma niepewną średnią, więc jej oszacowanie zostaje mocno przyciągnięte do średniej ogólnej; duża grupa prawie zachowuje własną średnią.
Jak narysować wykres gąsienicowy w R?
Dopasuj model funkcją lmer() z pakietu lme4, a następnie wywołaj ranef(model, condVar = TRUE). Wartości dają punkty, a pierwiastki z atrybutu postVar – warunkowe błędy standardowe do przedziałów. Gotowy szkic daje lattice::dotplot() na wyniku ranef(); własny – ggplot2 z geom_pointrange().
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model mieszany w obrazkach
Strzałki od średnich szkół do modelu, kurczenie a liczebność i ICC, wachlarz losowych nachyleń i wykres gąsienicowy – pięć rysunków z kodem R.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikPromocje w sieci sklepów: model mieszany
Efekt promocji w 40 sklepach: fałszywe alarmy testu t, losowe nachylenie w lme4, wykres gąsienicowy i wielkość miasta z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}