Przykład: 40 sklepów, 52 tygodnie i pytanie „ile daje promocja?”
Fikcyjna sieć 40 sklepów spożywczych prowadzi promocję „druga butelka napoju za pół ceny” – w roku sklep miał od 6 do 18 tygodni z promocją. Dane to tygodniowa sprzedaż napojów w tys. zł – 40 sklepów × 52 tygodnie = 2080 wierszy, w tym 464 tygodnie z promocją. Dział marketingu pyta: o ile promocja podnosi sprzedaż, czy działa wszędzie tak samo i gdzie warto ją powtarzać?
Odpowiedzią jest model wielopoziomowy (mieszany). Pełną procedurę opisuje wpis model wielopoziomowy krok po kroku w R; tu – co ten model zmienia w analizie marketingowej.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: 14 sklepów w małych miastach, 14 w średnich i 12 w dużych; sprzedaż bez promocji 28, 36 i 46 tys. zł; przyrost w tygodniu promocji 2.0, 3.5 i 5.5 tys. zł; SD sklepów 5 (poziom) i 1 (efekt promocji), SD tygodni 3.5. Sklepy w dużych miastach dostały więcej tygodni z promocją (12–18 wobec 6–11 w małych). Średni efekt promocji w 40 sklepach wynosi więc 3.575 tys. zł. Ziarno 631 ustalono raz i nie zmieniano go. Dane pobierzesz jako promocje-w-sieci-sklepow-dane.csv (wiersz = sklep w tygodniu).
Rysunek 1: dane mają dwa poziomy
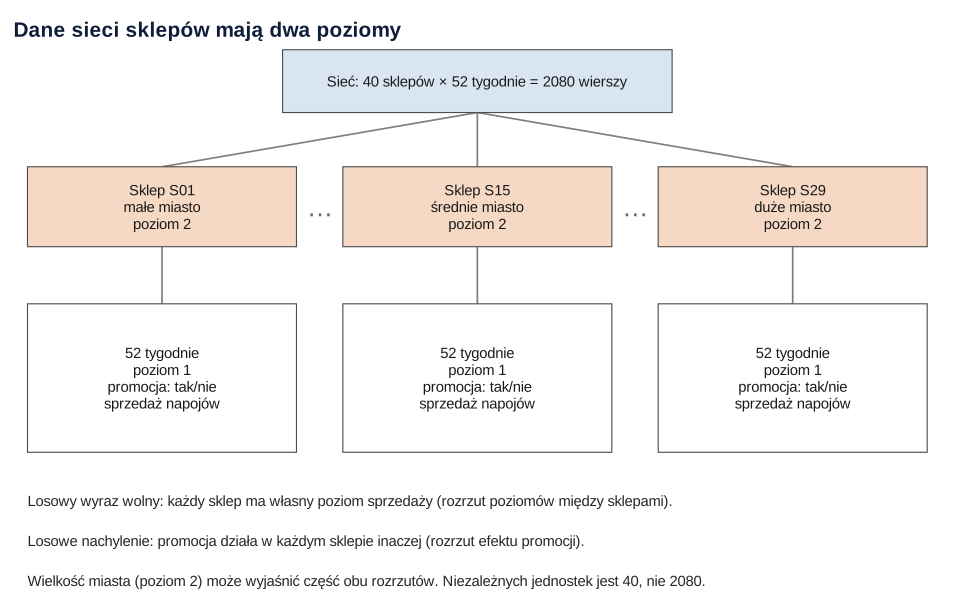
Co widać. Tygodnie (poziom 1) są zagnieżdżone w sklepach (poziom 2). Promocja i sprzedaż zmieniają się z tygodnia na tydzień, a wielkość miasta – tylko między sklepami. Tygodnie jednego sklepu są do siebie podobne: ten sam lokal, klienci i konkurencja.
Jak może zmylić. Schemat pomija czas: sąsiednie tygodnie bywają podobniejsze niż odległe (sezon, pogoda) – zob. pułapki.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: sześć sklepów tydzień po tygodniu
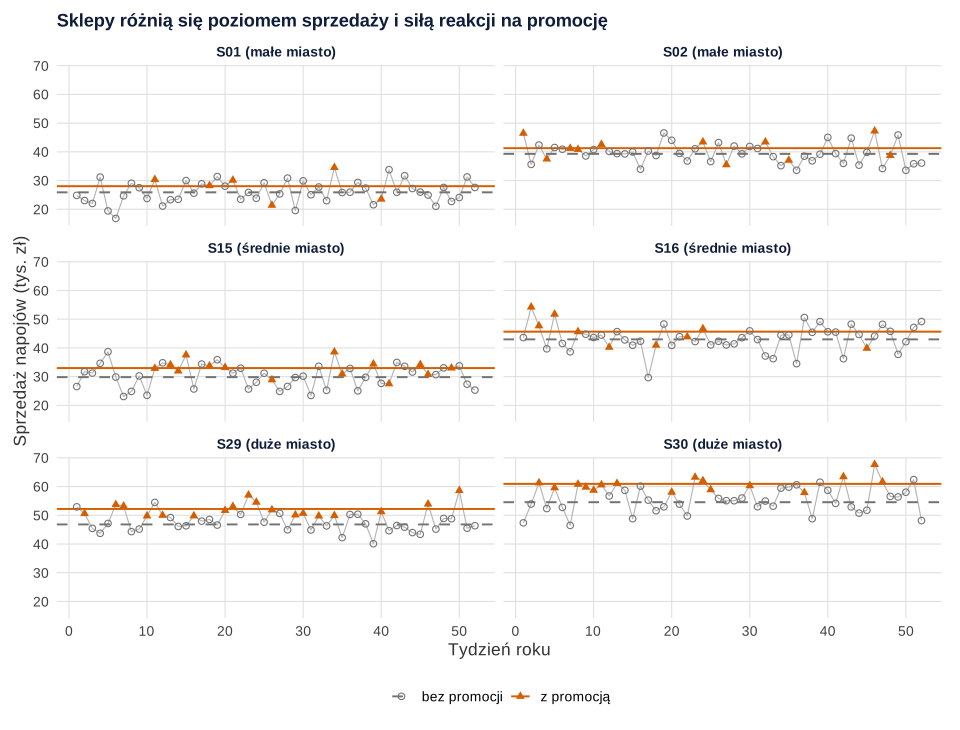
set.seed(631)).Co widać. Sklepy różnią się poziomem (bez promocji S01 sprzedaje średnio 25.91 tys. zł tygodniowo, S30 – 54.55) i reakcją na promocję: w S01 średnia rośnie o 2.12 tys. zł, w S30 o 6.40. Sprzedaż waha się z tygodnia na tydzień o kilka tysięcy złotych.
Jak może zmylić. To po dwa pierwsze sklepy każdej wielkości miasta, wybrane z góry. Sześć sklepów to nie sieć – wszystkie 40 pokazuje rysunek 4.
Podpis do pracy:
Zdanie do Wyników:
Dlaczego nie średnie i test t na 2080 tygodniach
Najprostsza analiza: średnia tygodni z promocją (42.10 tys. zł) minus średnia bez promocji (36.38) = 5.72 tys. zł; test t na 2080 tygodniach daje p < .001. Ma to dwie wady.
- Miesza sklepy. Sklepy w dużych miastach miały więcej tygodni z promocją, więc część z 5.72 tys. zł to różnica między sklepami, a nie efekt promocji.
- Udaje, że ma 2080 niezależnych obserwacji. Tygodnie jednego sklepu nie są niezależne, a efekt promocji ma uogólniać się na sklepy. To pseudoreplikacja: test z niewłaściwym członem błędu (Hurlbert, 1984).
| Analiza | Efekt promocji (tys. zł) | SE | df |
|---|---|---|---|
| test t na tygodniach | 5.72 | 0.53 | 2078 |
| model z losowym wyrazem wolnym | 3.65 | 0.19 | 2039.3 |
| model z losowym wyrazem wolnym i losowym nachyleniem | 3.42 | 0.34 | 37.7 |
Losowy wyraz wolny usuwa pierwszą wadę (porównuje tygodnie w obrębie sklepu: 3.65 tys. zł), ale SE = 0.19 przy ok. 2000 stopniach swobody zakłada, że promocja działa wszędzie tak samo. Dopiero model z losowym nachyleniem przyznaje, że efekt różni się między sklepami. Jego SE jest prawie dwa razy większy, a stopni swobody – 37.7, tyle, ile wynika z 40 sklepów. Czy to ma znaczenie, pokazuje symulacja.
Rysunek 3: ile fałszywych alarmów?
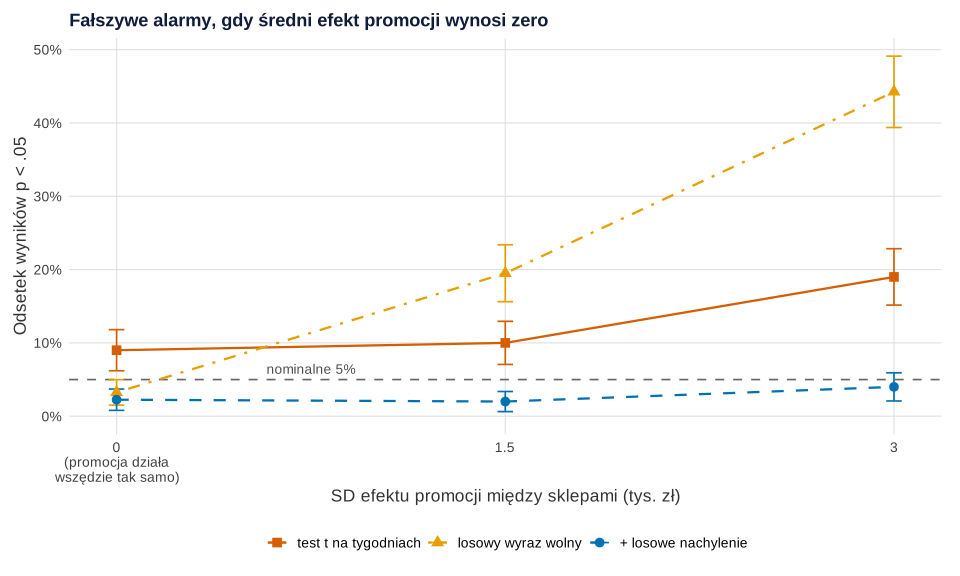
set.seed(631)).Symulujemy po 400 sieci o tym samym schemacie (40 sklepów, 52 tygodnie, 6–18 tygodni promocji), ale ze średnim efektem promocji równym zero: w części sklepów promocja podnosi sprzedaż, w części obniża. SD tego efektu między sklepami wynosi 0, 1.5 albo 3 tys. zł. Każde p < .05 to fałszywy alarm.
Co widać. Model z losowym nachyleniem daje od 2.0% do 4.0% fałszywych alarmów – nie więcej niż nominalne 5%. Model z samym losowym wyrazem wolnym działa tylko wtedy, gdy promocja działa wszędzie tak samo (3.2%); przy SD = 1.5 daje 19.5%, przy SD = 3 – 44.2% fałszywych alarmów. Test t na tygodniach ma 9.0% już przy SD = 0 (sklepy z różną liczbą promocji różnie „ważą” w obu średnich) i 19.0% przy SD = 3. Błąd Monte Carlo odsetków nie przekracza 2.5 punktu procentowego. Model z samymi losowymi wyrazami wolnymi źle uogólnia wynik, gdy jednostki różnią się wrażliwością na manipulację (Barr i in., 2013), a ignorowanie zależności może podnieść odsetek fałszywie istotnych wyników nawet do 80% (Aarts i in., 2014).
Jak może zmylić. Test t wypada „lepiej” niż model z losowym wyrazem wolnym tylko dlatego, że różnice między sklepami zawyżają jego błąd – to przypadek, nie zaleta. Gdy promocje częściej trafiają do dużych sklepów, test t jest też obciążony. Symulacja nie pokazuje mocy – o precyzji w sekcji o liczbie sklepów.
Podpis do pracy:
Zdanie do Metody:
Model mieszany: losowy wyraz wolny i losowe nachylenie
Model dla tygodnia t w sklepie j zapisujemy tak:
Słowami: β0 to średnia sprzedaż sieci bez promocji, β1 – średni efekt promocji. Każdy sklep ma własne odchylenie poziomu (u0j, efekt losowy) i własne odchylenie efektu promocji (u1j, losowe nachylenie). Model szacuje średnią i rozrzut tych odchyleń. W R to jedna linia pakietu lme4 (Bates i in., 2015): lmer(sprzedaz ~ promocja + (1 + promocja | sklep)). Wartości p liczymy z przybliżeniem stopni swobody Satterthwaite’a, które w symulacjach najlepiej trzymało poziom błędu I rodzaju (Luke, 2017).
Wynik. Średni efekt promocji: b = 3.42 tys. zł, SE = 0.34, 95% CI [2.76, 4.08] – blisko prawdziwych 3.575 tys. zł. Odchylenie standardowe efektu promocji między sklepami wynosi 1.75 tys. zł, a poziomu sprzedaży – 9.31 tys. zł (tygodni: 3.57). Model z losowym nachyleniem pasuje lepiej niż bez niego: test ilorazu wiarygodności χ²(2) = 50.36, p < .001.
Najważniejsza liczba dla marketingu to nie średnia, lecz zakres: β1 ± 1.96 × 1.75, czyli od −0.02 do 6.85 tys. zł. Tyle wynosi efekt promocji w 95% sklepów takiej sieci: w części prawie nic, w innych blisko 7 tys. zł tygodniowo.
Rysunek 4: wykres gąsienicowy sklepów
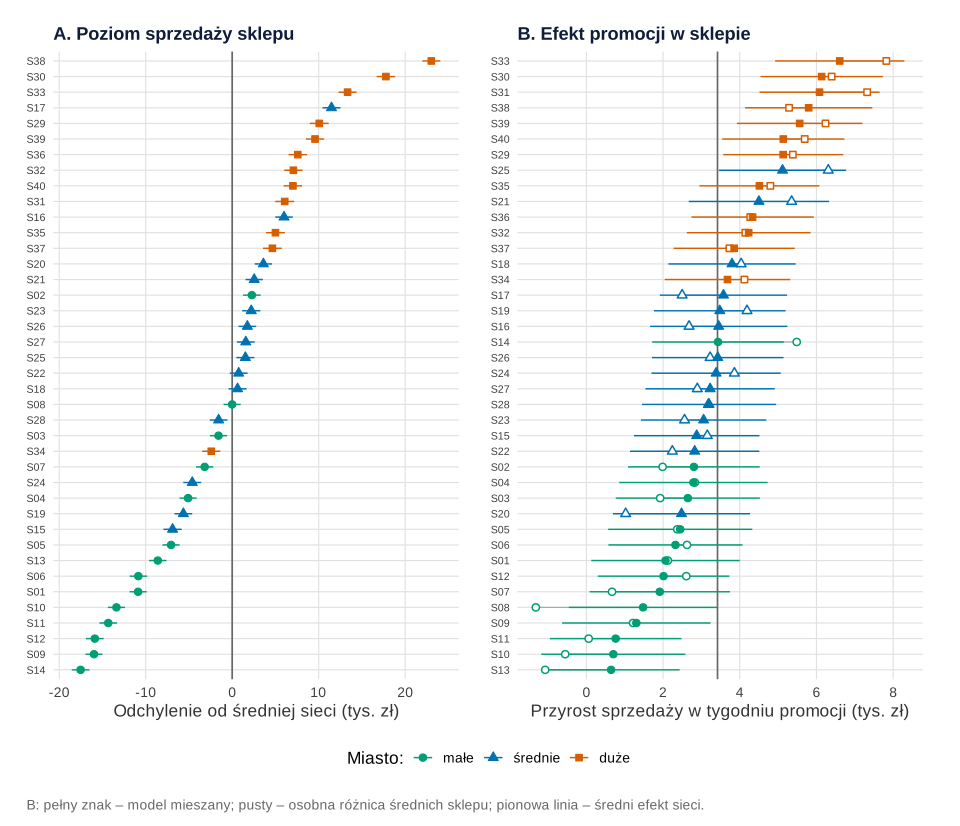
Co widać. Wykres gąsienicowy pokazuje przewidywane efekty losowe sklepów z przedziałami. Panel A: poziomy sprzedaży różnią się od −17.52 do +23.02 tys. zł względem średniej sieci, przy wąskich przedziałach (52 tygodnie na sklep). Panel B: efekt promocji w sklepie według modelu (pełne znaki) wynosi od 0.64 do 6.61 tys. zł. Przedział 13 z 40 sklepów nie obejmuje średniej sieci.
Ściąganie do średniej. Puste znaki to osobne różnice średnich każdego sklepu – od −1.32 do 7.82 tys. zł, SD = 2.18. W modelu rozrzut maleje do SD = 1.52, bo model łączy informację sklepu ze średnią sieci. Najmocniej przesuwa sklepy z małą liczbą promocji: przy 6–9 tygodniach średnio o 0.92 tys. zł, przy 14–18 – o 0.40. Sklep S08 (6 tygodni promocji) „tracił” na promocji 1.32 tys. zł, według modelu zyskuje 1.48. Mechanizm opisuje wpis model mieszany w obrazkach.
Jak może zmylić. Kolejność sklepów to nie ranking: sąsiednie przedziały w panelu B prawie się pokrywają. Przy rankingach szkół po uwzględnieniu niepewności tylko nieliczne dawały się wiarygodnie odróżnić od średniej (Leckie i Goldstein, 2009). Przedziały pomijają niepewność średniej, więc są raczej za wąskie.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: czy wielkość miasta wyjaśnia różnice?
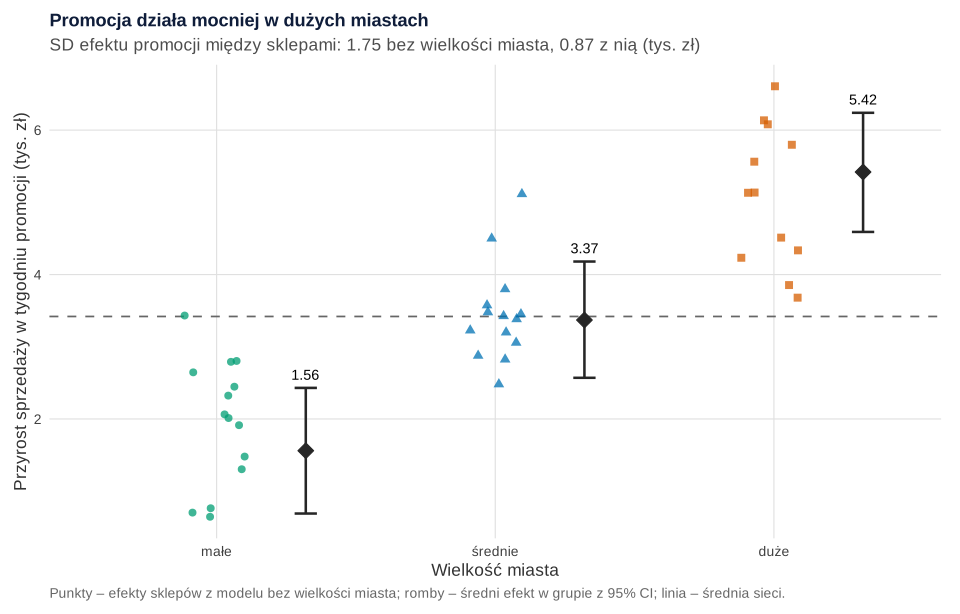
Dodajemy zmienną poziomu sklepu – wielkość miasta – i interakcję międzypoziomową promocja × miasto. Losowe nachylenie zostaje: bez niego test takiej interakcji jest zbyt liberalny (Heisig i Schaeffer, 2019).
Co widać. Promocja podnosi sprzedaż o 1.56 tys. zł w małych miastach, 95% CI [0.69, 2.43], o 3.37 [2.57, 4.18] w średnich i o 5.42 [4.59, 6.24] w dużych (prawdziwe wartości: 2.0, 3.5 i 5.5). Interakcja: F(2, 35.8) = 21.43, p < .001. SD efektu promocji spada z 1.75 do 0.87 tys. zł – wielkość miasta wyjaśnia 75.4% jego wariancji. Bez losowego nachylenia błąd standardowy różnicy „duże vs małe” wynosiłby 0.48 zamiast 0.59.
Jak może zmylić. Wielkości miasta nie przydzielono losowo – za różnicą może stać konkurencja czy zamożność klientów. Model mówi, gdzie promocja działa mocniej, a nie dlaczego.
Podpis do pracy:
Zdanie do Wyników:
Liczba sklepów a precyzja
Symulacja z parametrami naszego modelu (100 powtórzeń na plan):
| Sklepy × tygodnie | Średni SE efektu promocji | Połowa szerokości 95% CI (tys. zł) |
|---|---|---|
| 10 × 52 | 0.65 | ±1.46 |
| 20 × 52 | 0.48 | ±1.00 |
| 40 × 52 | 0.34 | ±0.68 |
| 80 × 52 | 0.24 | ±0.47 |
| 40 × 26 | 0.39 | ±0.79 |
| 40 × 104 | 0.31 | ±0.62 |
Podwojenie liczby sklepów zawęża przedział o ok. 30%, podwojenie liczby tygodni (z 52 do 104) – tylko o 9%, bo niepewność średniego efektu zależy głównie od różnic między sklepami. Symulacje dla modeli dwupoziomowych pokazują, że nawet przy wielu jednostkach drugiego poziomu małych interakcji międzypoziomowych nie da się wiarygodnie wykryć (Arend i Schäfer, 2019). Planowanie mocy symulacją opisuje wpis analiza mocy dla modelu mieszanego.
Co z tym zrobić w marketingu
- Raportuj zakres, nie tylko średnią. „Średnio 3.42 tys. zł, w sklepach od ok. 0 do 6.85 tys. zł” to inna decyzja niż „+5.72 tys. zł” z prostych średnich.
- Kieruj promocję tam, gdzie działa. W dużych miastach przyrost jest ponad trzy razy większy; w małych sprawdź, czy 1.56 tys. zł pokrywa koszt rabatu.
- Nie wybieraj „najlepszych” sklepów po surowych średnich – sklep z kilkoma tygodniami promocji trafia na szczyt lub dno listy przypadkiem.
- Następną akcję zaplanuj jak eksperyment. Losuj tygodnie promocji w obrębie sklepów, zamiast zostawiać wybór kierownikom.
- Łącz z innymi analizami serii. Długoterminowy wpływ promocji i reklamy na sprzedaż całej sieci mierzy marketing mix modeling, a gdy wynikiem jest liczba zakupów klienta z wieloma zerami – modele dla zliczeń z nadmiarem zer.
Jak opisać w pracy
W Metodzie podaj strukturę danych, zmienne każdego poziomu, efekty losowe z uzasadnieniem, estymację (REML) i sposób liczenia p; w Wynikach – efekty stałe z CI i SD efektów losowych. Więcej wzorów zdań: jak opisać wyniki modelu mieszanego.
Alternatywą z ekonometrii są efekty stałe sklepów z błędami odpornymi na klastrowanie – zob. dane panelowe: FE, RE i test Hausmana.
Kod R: dane, model mieszany, symulacje i rysunki
Kod odtwarza wszystkie liczby z tekstu, obie tabele i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 3 (symulacja), 5 (tylko rozsunięcie punktów) i 6 (symulacja); każdy zaczyna losowanie od własnego set.seed(631). Ziarno 631 ustalono raz i nie zmieniano go. Ręcznie ustalono: 40 sklepów (14, 14 i 12 w małych, średnich i dużych miastach), poziomy sprzedaży (28, 36, 46 tys. zł) i efekty promocji (2.0, 3.5, 5.5 tys. zł) według wielkości miasta, SD sklepów (5 i 1) i tygodni (3.5), liczbę tygodni promocji (6–11, 8–14, 12–18), a w symulacji fałszywych alarmów SD poziomu sklepów 9, SD tygodni 3.5, SD efektu promocji 0, 1.5 i 3 oraz 400 powtórzeń w warunku. W symulacji wartości p modelu z losowym nachyleniem liczymy z rozkładu t z 39 stopniami swobody (liczba sklepów minus 1; w modelu dla prawdziwych danych przybliżenie Satterthwaite’a dało 37.7), a modelu z samym losowym wyrazem wolnym – z rozkładu normalnego (ok. 2000 stopni swobody); to przyspiesza 2400 dopasowań.
1. Paleta, dane i rysunki 1–2
R
# Rysunki 1 i 2. Fikcyjna sieć 40 sklepów: struktura danych i tygodniowa sprzedaż napojów (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
kol_miasto <- c("małe" = "#009E73", "średnie" = "#0072B2", "duże" = "#D55E00")
ksztalt_miasto <- c("małe" = 16, "średnie" = 17, "duże" = 15)
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (tys. zł tygodniowo): poziom sprzedaży i efekt promocji zależą od wielkości miasta
J <- 40; T <- 52
miasto <- factor(rep(c("małe", "średnie", "duże"), times = c(14, 14, 12)), levels = c("małe", "średnie", "duże"))
poziom   <- c("małe" = 28, "średnie" = 36, "duże" = 46)    # średnia sprzedaż bez promocji
efekt    <- c("małe" = 2.0, "średnie" = 3.5, "duże" = 5.5) # średni przyrost w tygodniu promocji
sd_poziom <- 5; sd_efekt <- 1; sd_tydzien <- 3.5            # SD sklepów (poziom, efekt) i tygodni
k_min <- c("małe" = 6, "średnie" = 8, "duże" = 12)          # sklepy w dużych miastach mają więcej promocji

set.seed(631)                                   # ziarno ustalone raz, bez dobierania pod wynik
sklepy <- data.frame(sklep = sprintf("S%02d", 1:J), miasto = miasto)
sklepy$u0 <- rnorm(J, 0, sd_poziom)
sklepy$u1 <- rnorm(J, 0, sd_efekt)
sklepy$k  <- k_min[as.character(miasto)] + sample(0:6, J, replace = TRUE)   # liczba tygodni z promocją
dane <- do.call(rbind, lapply(1:J, function(j) {
  s <- sklepy[j, ]
  promo <- integer(T); promo[sample(T, s$k)] <- 1L
  data.frame(sklep = s$sklep, miasto = s$miasto, tydzien = 1:T, promocja = promo,
             sprzedaz = round(poziom[as.character(s$miasto)] + s$u0 +
                              (efekt[as.character(s$miasto)] + s$u1) * promo + rnorm(T, 0, sd_tydzien), 2))
}))
write.csv(dane, "promocje-w-sieci-sklepow-dane.csv", row.names = FALSE)

c(sklepy = J, tygodnie = T, wiersze = nrow(dane), tygodnie_z_promocja = sum(dane$promocja))
table(miasto = sklepy$miasto)
tapply(sklepy$k, sklepy$miasto, range)          # tygodnie z promocją na sklep
mean(efekt[as.character(sklepy$miasto)])    # prawdziwy średni efekt promocji w 40 sklepach (bez u1)
round(aggregate(sprzedaz ~ promocja, dane, mean), 2)

# Rysunek 1. Grafika: struktura danych – dwa poziomy (sklep, tydzień) i co szacuje model mieszany
pud <- data.frame(
  x = c(5, 1.6, 5, 8.4, 1.6, 5, 8.4), y = c(9.1, 6.9, 6.9, 6.9, 3.9, 3.9, 3.9),
  w = c(4.2, 2.9, 2.9, 2.9, 2.9, 2.9, 2.9), h = c(1.1, 1.4, 1.4, 1.4, 2.6, 2.6, 2.6),
  typ = c("siec", "sklep", "sklep", "sklep", "tydzien", "tydzien", "tydzien"),
  tekst = c("Sieć: 40 sklepów × 52 tygodnie = 2080 wierszy",
            "Sklep S01\nmałe miasto\npoziom 2", "Sklep S15\nśrednie miasto\npoziom 2", "Sklep S29\nduże miasto\npoziom 2",
            "52 tygodnie\npoziom 1\npromocja: tak/nie\nsprzedaż napojów", "52 tygodnie\npoziom 1\npromocja: tak/nie\nsprzedaż napojów",
            "52 tygodnie\npoziom 1\npromocja: tak/nie\nsprzedaż napojów"))
odc <- data.frame(x = c(5, 5, 5, 1.6, 5, 8.4), y = c(8.55, 8.55, 8.55, 6.2, 6.2, 6.2),
                  xend = c(1.6, 5, 8.4, 1.6, 5, 8.4), yend = c(7.6, 7.6, 7.6, 5.2, 5.2, 5.2))
opis <- data.frame(x = 0.15, y = c(1.75, 1.05, 0.35), hjust = 0,
  tekst = c("Losowy wyraz wolny: każdy sklep ma własny poziom sprzedaży (rozrzut poziomów między sklepami).",
            "Losowe nachylenie: promocja działa w każdym sklepie inaczej (rozrzut efektu promocji).",
            "Wielkość miasta (poziom 2) może wyjaśnić część obu rozrzutów. Niezależnych jednostek jest 40, nie 2080."))
p1 <- ggplot() +
  geom_segment(data = odc, aes(x, y, xend = xend, yend = yend), colour = "grey50", linewidth = 0.6) +
  geom_tile(data = pud, aes(x, y, width = w, height = h, fill = typ), colour = "grey30", linewidth = 0.4) +
  geom_text(data = pud, aes(x, y, label = tekst), size = 3.9, lineheight = 0.95, colour = "grey10") +
  annotate("text", x = 3.3, y = 6.9, label = "…", size = 7, colour = "grey40") +
  annotate("text", x = 6.7, y = 6.9, label = "…", size = 7, colour = "grey40") +
  geom_text(data = opis, aes(x, y, label = tekst, hjust = hjust), size = 3.9, colour = "grey15") +
  scale_fill_manual(values = c(siec = "#D9E6F2", sklep = "#F6D9C4", tydzien = "#FFFFFF"), guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 9.8), expand = FALSE) +
  labs(title = "Dane sieci sklepów mają dwa poziomy") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p1   # zapis: ggsave("promocje-sklepy-schemat-danych.svg", p1, width = 10, height = 6.4)

# Rysunek 2. Sprzedaż sześciu sklepów (po dwa z każdej wielkości miasta) tydzień po tygodniu
wybrane <- c("S01", "S02", "S15", "S16", "S29", "S30")
d6 <- subset(dane, sklep %in% wybrane)
d6$panel <- factor(paste0(d6$sklep, " (", d6$miasto, " miasto)"), levels = unique(paste0(d6$sklep, " (", d6$miasto, " miasto)")))
d6$Tydzień <- factor(ifelse(d6$promocja == 1, "z promocją", "bez promocji"), levels = c("bez promocji", "z promocją"))
sr6 <- aggregate(sprzedaz ~ panel + Tydzień, d6, mean)
p2 <- ggplot(d6, aes(tydzien, sprzedaz)) +
  geom_line(colour = "grey70", linewidth = 0.4) +
  geom_hline(data = sr6, aes(yintercept = sprzedaz, colour = Tydzień, linetype = Tydzień), linewidth = 0.7) +
  geom_point(aes(colour = Tydzień, shape = Tydzień), size = 1.9) +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(values = c("bez promocji" = "grey45", "z promocją" = kol[["cynober"]])) +
  scale_shape_manual(values = c("bez promocji" = 1, "z promocją" = 17)) +
  scale_linetype_manual(values = c("bez promocji" = "dashed", "z promocją" = "solid")) +
  labs(title = "Sklepy różnią się poziomem sprzedaży i siłą reakcji na promocję",
       x = "Tydzień roku", y = "Sprzedaż napojów (tys. zł)", colour = NULL, shape = NULL, linetype = NULL) +
  motyw
p2   # zapis: ggsave("promocje-sklepy-szesc-sklepow.svg", p2, width = 10, height = 7.6)
round(with(sr6, tapply(sprzedaz, list(panel, Tydzień), mean)), 2)
Wynik w R
             sklepy            tygodnie             wiersze tygodnie_z_promocja
                 40                  52                2080                 464
miasto
   małe średnie    duże
     14      14      12
$małe
[1]  6 11

$średnie
[1]  8 14

$duże
[1] 12 18

[1] 3.575
  promocja sprzedaz
1        0    36.38
2        1    42.10
                     bez promocji z promocją
S01 (małe miasto)           25.91      28.03
S02 (małe miasto)           39.29      41.28
S15 (średnie miasto)        29.83      32.98
S16 (średnie miasto)        42.98      45.66
S29 (duże miasto)           46.82      52.20
S30 (duże miasto)           54.55      60.95
2. Test t, model z losowym wyrazem wolnym i z losowym nachyleniem: Tabela 1
R
# Tabela 1. Średnie tygodni a model mieszany: to samo pytanie, inne odpowiedzi (dane z przepisu 1)
library(lme4); library(lmerTest)                # lmerTest dodaje wartości p (stopnie swobody Satterthwaite’a)

# (a) „Średnie”: wszystkie 2080 tygodni jak niezależne obserwacje – test t
tt <- t.test(sprzedaz ~ factor(promocja, levels = c(1, 0)), data = dane, var.equal = TRUE)
round(tt$estimate, 2)                         # średnia sprzedaż w tygodniach z promocją i bez

# (b) Model z losowym wyrazem wolnym: każdy sklep ma własny poziom, efekt promocji wspólny
m_ri <- lmer(sprzedaz ~ promocja + (1 | sklep), data = dane)
# (c) Model z losowym wyrazem wolnym i losowym nachyleniem promocji (REML)
m_rs <- lmer(sprzedaz ~ promocja + (1 + promocja | sklep), data = dane)
tab <- rbind("test t na tygodniach"        = c(diff(rev(tt$estimate)), tt$stderr, tt$parameter, tt$p.value),
             "losowy wyraz wolny"          = summary(m_ri)$coefficients["promocja", c(1, 2, 3, 5)],
             "+ losowe nachylenie promocji" = summary(m_rs)$coefficients["promocja", c(1, 2, 3, 5)])
colnames(tab) <- c("efekt", "SE", "df", "p"); data.frame(round(tab[, 1:3], 3), p = signif(tab[, 4], 3))
round(confint(m_rs, parm = "promocja", method = "Wald"), 2)            # 95% CI średniego efektu promocji

# Składniki wariancji modelu (c): SD poziomu sklepów, SD efektu promocji, korelacja, SD tygodni
print(VarCorr(m_rs), comp = "Std.Dev.", digits = 3)
vc <- as.data.frame(VarCorr(m_rs))
tau1 <- vc$sdcor[which(vc$var1 == "promocja" & is.na(vc$var2))]
b1 <- fixef(m_rs)[["promocja"]]
c(efekt_sredni = b1, sd_efektu = tau1, od_95 = b1 - 1.96 * tau1, do_95 = b1 + 1.96 * tau1)   # zakres efektu w 95% sklepów
# Czy efekt promocji różni się między sklepami? Test ilorazu wiarygodności (b) vs (c)
anova(m_ri, m_rs, refit = FALSE)
Wynik w R
mean in group 1 mean in group 0
          42.10           36.38
                             efekt    SE       df        p
test t na tygodniach         5.723 0.532 2078.000 2.48e-26
losowy wyraz wolny           3.648 0.194 2039.305 9.38e-73
+ losowe nachylenie promocji 3.419 0.338   37.709 2.67e-12
         2.5 % 97.5 %
promocja  2.76   4.08
 Groups   Name        Std.Dev. Corr
 sklep    (Intercept) 9.31
          promocja    1.75     0.67
 Residual             3.57
efekt_sredni    sd_efektu        od_95        do_95
  3.41937217   1.75276016  -0.01603774   6.85478208
Data: dane
Models:
m_ri: sprzedaz ~ promocja + (1 | sklep)
m_rs: sprzedaz ~ promocja + (1 + promocja | sklep)
     npar   AIC   BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m_ri    4 11516 11538 -5753.9     11508
m_rs    6 11469 11503 -5728.7     11457 50.359  2   1.16e-11 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
3. Symulacja fałszywych alarmów: Rysunek 3
R
# Rysunek 3. Pseudoreplikacja: ile „istotnych” promocji, gdy średni efekt promocji wynosi zero?
library(lme4); library(ggplot2)                 # paleta kol i motyw z przepisu 1

symuluj <- function(sd_efektu, J = 40, T = 52) {
  u0 <- rnorm(J, 0, 9); u1 <- rnorm(J, 0, sd_efektu)       # średni efekt promocji = 0
  k <- sample(6:18, J, replace = TRUE)                       # tygodnie z promocją, niezależnie od poziomu sklepu
  promo <- unlist(lapply(k, function(kj) { x <- integer(T); x[sample(T, kj)] <- 1L; x }))
  sklep <- rep(1:J, each = T)
  y <- 36 + u0[sklep] + u1[sklep] * promo + rnorm(J * T, 0, 3.5)
  d <- data.frame(y, promo, sklep = factor(sklep))
  # lme4::lmer bez sprawdzania zbieżności i wartości p z lmerTest – szybciej przy 2400 dopasowaniach
  kontrola <- lmerControl(calc.derivs = FALSE, check.conv.singular = "ignore", check.conv.hess = "ignore")
  t_ri <- coef(summary(lme4::lmer(y ~ promo + (1 | sklep), d, control = kontrola)))["promo", "t value"]
  t_rs <- coef(summary(lme4::lmer(y ~ promo + (1 + promo | sklep), d, control = kontrola)))["promo", "t value"]
  c("test t na tygodniach" = t.test(y ~ promo, d, var.equal = TRUE)$p.value,
    "losowy wyraz wolny" = 2 * pnorm(-abs(t_ri)),                 # ok. 2000 stopni swobody: rozkład normalny
    "+ losowe nachylenie" = 2 * pt(-abs(t_rs), df = J - 1))       # efekt średni szacowany z 40 sklepów
}

set.seed(631)
R <- 400                                         # powtórzeń w każdym warunku
wyniki <- do.call(rbind, lapply(c(0, 1.5, 3), function(s) {
  p <- replicate(R, symuluj(s))
  data.frame(sd_efektu = s, metoda = rownames(p), odsetek = rowMeans(p < .05), row.names = NULL)
}))
wyniki$blad_mc <- sqrt(wyniki$odsetek * (1 - wyniki$odsetek) / R)     # błąd Monte Carlo odsetka
wyniki$metoda <- factor(wyniki$metoda, levels = c("test t na tygodniach", "losowy wyraz wolny", "+ losowe nachylenie"))
data.frame(wyniki[, 1:2], procent = round(100 * wyniki$odsetek, 1), blad_mc_pp = round(100 * wyniki$blad_mc, 1))

p3 <- ggplot(wyniki, aes(sd_efektu, odsetek, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_hline(yintercept = .05, linetype = "dashed", colour = "grey40") +
  annotate("text", x = 0.75, y = .05, label = "nominalne 5%", vjust = -0.6, size = 3.6, colour = "grey30") +
  geom_line(linewidth = 0.8) +
  geom_errorbar(aes(ymin = odsetek - 1.96 * blad_mc, ymax = odsetek + 1.96 * blad_mc), width = 0.06, linetype = "solid") +
  geom_point(size = 3) +
  scale_x_continuous(breaks = c(0, 1.5, 3), labels = c("0\n(promocja działa\nwszędzie tak samo)", "1.5", "3")) +
  scale_y_continuous(labels = scales::percent, limits = c(0, NA)) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["pomarancz"]], kol[["niebieski"]])) +
  scale_shape_manual(values = c(15, 17, 16)) +
  scale_linetype_manual(values = c("solid", "dotdash", "dashed")) +
  labs(title = "Fałszywe alarmy, gdy średni efekt promocji wynosi zero",
       x = "SD efektu promocji między sklepami (tys. zł)", y = "Odsetek wyników p < .05",
       colour = NULL, shape = NULL, linetype = NULL) +
  motyw
p3   # zapis: ggsave("promocje-sklepy-falszywe-alarmy.svg", p3, width = 10, height = 6)
Wynik w R
  sd_efektu               metoda procent blad_mc_pp
1       0.0 test t na tygodniach     9.0        1.4
2       0.0   losowy wyraz wolny     3.2        0.9
3       0.0  + losowe nachylenie     2.2        0.7
4       1.5 test t na tygodniach    10.0        1.5
5       1.5   losowy wyraz wolny    19.5        2.0
6       1.5  + losowe nachylenie     2.0        0.7
7       3.0 test t na tygodniach    19.0        2.0
8       3.0   losowy wyraz wolny    44.2        2.5
9       3.0  + losowe nachylenie     4.0        1.0
4. Efekty losowe sklepów i wykres gąsienicowy: Rysunek 4
R
# Rysunek 4. Wykres gąsienicowy: poziom sprzedaży i efekt promocji w 40 sklepach (model m_rs z przepisu 2)
library(ggplot2); library(patchwork)

re <- ranef(m_rs, condVar = TRUE)$sklep          # przewidywane efekty losowe (BLUP) z warunkowymi wariancjami
pv <- attr(re, "postVar")                        # macierz 2 × 2 × 40
sk <- data.frame(sklep = rownames(re), u0 = re[, 1], u1 = re[, 2],
                 se0 = sqrt(pv[1, 1, ]), se1 = sqrt(pv[2, 2, ]))
sk <- merge(sk, sklepy[, c("sklep", "miasto", "k")], by = "sklep")
sk$efekt_model <- fixef(m_rs)[["promocja"]] + sk$u1        # efekt promocji w sklepie według modelu
# Osobne oszacowanie dla każdego sklepu (bez łączenia informacji): różnica średnich tygodni z promocją i bez
osobno <- t(sapply(split(dane, dane$sklep), function(d) coef(summary(lm(sprzedaz ~ promocja, d)))["promocja", 1:2]))
sk$efekt_osobno <- osobno[sk$sklep, 1]; sk$se_osobno <- osobno[sk$sklep, 2]

b1 <- fixef(m_rs)[["promocja"]]
round(range(sk$u0), 2)                           # odchylenia poziomu sprzedaży sklepów od średniej sieci
c(sd_osobno = sd(sk$efekt_osobno), sd_model = sd(sk$efekt_model))      # rozrzut efektów: osobno vs model
rbind(osobno = range(sk$efekt_osobno), model = range(sk$efekt_model))
sum(abs(sk$u1) > 1.96 * sk$se1)                   # sklepy, których przedział nie obejmuje średniego efektu
sk$przesuniecie <- abs(sk$efekt_osobno - sk$efekt_model)
round(tapply(sk$przesuniecie, cut(sk$k, c(5, 9, 13, 18), labels = c("6–9", "10–13", "14–18")), mean), 2)  # wg liczby promocji
head(sk[order(sk$efekt_osobno), c("sklep", "miasto", "k", "efekt_osobno", "efekt_model")], 2)
tail(sk[order(sk$efekt_osobno), c("sklep", "miasto", "k", "efekt_osobno", "efekt_model")], 2)

sk$kol0 <- factor(sk$sklep, levels = sk$sklep[order(sk$u0)])
sk$kol1 <- factor(sk$sklep, levels = sk$sklep[order(sk$efekt_model)])
ksztalt_pelny <- c("małe" = 21, "średnie" = 24, "duże" = 22)   # kształty z wypełnieniem: pełne = model, puste = osobno
pA <- ggplot(sk, aes(u0, kol0, colour = miasto, fill = miasto, shape = miasto)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = u0 - 1.96 * se0, xmax = u0 + 1.96 * se0), width = 0, linewidth = 0.5, orientation = "y") +
  geom_point(size = 2.2) +
  labs(title = "A. Poziom sprzedaży sklepu", x = "Odchylenie od średniej sieci (tys. zł)", y = NULL)
pB <- ggplot(sk, aes(y = kol1, colour = miasto, fill = miasto, shape = miasto)) +
  geom_vline(xintercept = b1, colour = "grey40") +
  geom_segment(aes(x = efekt_osobno, xend = efekt_model, yend = kol1), colour = "grey65", linewidth = 0.4,
               show.legend = FALSE) +
  geom_errorbar(aes(xmin = efekt_model - 1.96 * se1, xmax = efekt_model + 1.96 * se1), width = 0, linewidth = 0.5,
                orientation = "y") +
  geom_point(aes(x = efekt_osobno), size = 2, fill = "white", stroke = 0.8, show.legend = FALSE) +
  geom_point(aes(x = efekt_model), size = 2.2) +
  labs(title = "B. Efekt promocji w sklepie", x = "Przyrost sprzedaży w tygodniu promocji (tys. zł)", y = NULL)
skale <- list(scale_colour_manual(values = kol_miasto, name = "Miasto:"), scale_fill_manual(values = kol_miasto, name = "Miasto:"),
              scale_shape_manual(values = ksztalt_pelny, name = "Miasto:"), motyw, theme(axis.text.y = element_text(size = 8)))
p4 <- (pA + skale) + (pB + skale) + plot_layout(guides = "collect") +
  plot_annotation(caption = "B: pełny znak – model mieszany; pusty – osobna różnica średnich sklepu; pionowa linia – średni efekt sieci.") &
  theme(legend.position = "bottom")
p4   # zapis: ggsave("promocje-sklepy-wykres-gasienicowy.svg", p4, width = 10, height = 8.6)
Wynik w R
[1] -17.52  23.02
sd_osobno  sd_model
 2.180668  1.516149
             [,1]     [,2]
osobno -1.3190580 7.821833
model   0.6448067 6.607307
[1] 13
  6–9 10–13 14–18
 0.92  0.69  0.40
   sklep miasto k efekt_osobno efekt_model
8    S08   małe 6    -1.319058   1.4788879
13   S13   małe 9    -1.074522   0.6448067
   sklep miasto  k efekt_osobno efekt_model
31   S31   duże 18     7.321765    6.080680
33   S33   duże 12     7.821833    6.607307
5. Wielkość miasta i interakcja międzypoziomowa: Rysunek 5
R
# Rysunek 5. Czy wielkość miasta (zmienna poziomu sklepu) wyjaśnia, dlaczego promocja działa różnie?
library(lme4); library(lmerTest); library(ggplot2)

# Interakcja międzypoziomowa promocja × miasto, z losowym nachyleniem promocji (m_rs z przepisu 2 bez miasta)
m_miasto <- lmer(sprzedaz ~ promocja * miasto + (1 + promocja | sklep), data = dane)
anova(m_miasto)                                  # testy F (Satterthwaite) – wiersz promocja:miasto
print(VarCorr(m_miasto), comp = "Std.Dev.", digits = 3)
sd_efektu <- function(m) { v <- as.data.frame(VarCorr(m)); v$sdcor[which(v$var1 == "promocja" & is.na(v$var2))] }
c(sd_bez_miasta = sd_efektu(m_rs), sd_z_miastem = sd_efektu(m_miasto),
  wyjasniona_wariancja = 1 - sd_efektu(m_miasto)^2 / sd_efektu(m_rs)^2)

# Ten sam model w parametryzacji „efekt promocji w każdej wielkości miasta”
m_efekty <- lmer(sprzedaz ~ 0 + miasto + miasto:promocja + (1 + promocja | sklep), data = dane)
ef <- data.frame(miasto = factor(levels(dane$miasto), levels = levels(dane$miasto)),
                 coef(summary(m_efekty))[paste0("miasto", levels(dane$miasto), ":promocja"), c(1, 2, 3)])
names(ef)[2:4] <- c("efekt", "SE", "df")
ef$od <- ef$efekt - qt(.975, ef$df) * ef$SE; ef$do <- ef$efekt + qt(.975, ef$df) * ef$SE
rownames(ef) <- NULL; ef[, -1] <- round(ef[, -1], 2); ef

# Bez losowego nachylenia interakcja wygląda na znacznie pewniejszą (zbyt mały SE)
bez_nachylenia <- lmer(sprzedaz ~ promocja * miasto + (1 | sklep), data = dane)
rbind(z_nachyleniem = coef(summary(m_miasto))["promocja:miastoduże", c(1, 2, 4)],
      bez_nachylenia = coef(summary(bez_nachylenia))["promocja:miastoduże", c(1, 2, 4)])

set.seed(631)                                    # tylko rozsunięcie punktów w poziomie
p5 <- ggplot(sk, aes(miasto, efekt_model)) +
  geom_hline(yintercept = fixef(m_rs)[["promocja"]], linetype = "dashed", colour = "grey40") +
  geom_jitter(aes(colour = miasto, shape = miasto), width = 0.12, height = 0, size = 2.4, alpha = 0.75) +
  geom_errorbar(data = ef, aes(y = efekt, ymin = od, ymax = do), width = 0.08, linewidth = 0.9, colour = "grey15",
                position = position_nudge(x = 0.32)) +
  geom_point(data = ef, aes(y = efekt), shape = 23, size = 4, fill = "grey15", colour = "grey15",
             position = position_nudge(x = 0.32)) +
  geom_text(data = ef, aes(y = do, label = sprintf("%.2f", efekt)), nudge_x = 0.32, vjust = -0.8, size = 3.8) +
  scale_colour_manual(values = kol_miasto, guide = "none") +
  scale_shape_manual(values = ksztalt_miasto, guide = "none") +
  labs(title = "Promocja działa mocniej w dużych miastach",
       subtitle = sprintf("SD efektu promocji między sklepami: %.2f bez wielkości miasta, %.2f z nią (tys. zł)",
                         sd_efektu(m_rs), sd_efektu(m_miasto)),
       x = "Wielkość miasta", y = "Przyrost sprzedaży w tygodniu promocji (tys. zł)",
       caption = "Punkty – efekty sklepów z modelu bez wielkości miasta; romby – średni efekt w grupie z 95% CI; linia – średnia sieci.") +
  motyw
p5   # zapis: ggsave("promocje-sklepy-wielkosc-miasta.svg", p5, width = 10, height = 6.4)
Wynik w R
Type III Analysis of Variance Table with Satterthwaite's method
                 Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
promocja        2697.80 2697.80     1 36.367 211.936 < 2.2e-16 ***
miasto           705.49  352.74     2 37.006  27.711 4.410e-08 ***
promocja:miasto  545.56  272.78     2 35.798  21.429 7.599e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 Groups   Name        Std.Dev. Corr
 sklep    (Intercept) 6.03
          promocja    0.87     -0.06
 Residual             3.57
       sd_bez_miasta         sd_z_miastem wyjasniona_wariancja
           1.7527602            0.8697994            0.7537403
   miasto efekt   SE    df   od   do
1    małe  1.56 0.43 49.14 0.69 2.43
2 średnie  3.37 0.40 35.28 2.57 4.18
3    duże  5.42 0.40 27.58 4.59 6.24
               Estimate Std. Error  t value
z_nachyleniem  3.853243  0.5905246 6.525118
bez_nachylenia 3.812547  0.4817130 7.914562
6. Liczba sklepów a precyzja: Tabela 2
R
# Tabela 2. Liczba sklepów a precyzja średniego efektu promocji (symulacja z parametrów modelu m_rs)
library(lme4)

vc <- as.data.frame(VarCorr(m_rs))
sd0 <- vc$sdcor[1]; sd1 <- vc$sdcor[2]; rho <- vc$sdcor[3]; sde <- vc$sdcor[4]; b1 <- fixef(m_rs)[["promocja"]]
precyzja <- function(J, T, R = 100) {
  se <- est <- numeric(R)
  for (r in 1:R) {
    z0 <- rnorm(J); z1 <- rho * z0 + sqrt(1 - rho^2) * rnorm(J)          # skorelowane efekty losowe sklepów
    u0 <- sd0 * z0; u1 <- sd1 * z1
    k <- round(sample(6:18, J, replace = TRUE) * T / 52)                  # ten sam odsetek tygodni z promocją
    promo <- unlist(lapply(k, function(kj) { x <- integer(T); x[sample(T, kj)] <- 1L; x }))
    sklep <- rep(1:J, each = T)
    y <- 40 + u0[sklep] + (b1 + u1[sklep]) * promo + rnorm(J * T, 0, sde)
    m <- lme4::lmer(y ~ promo + (1 + promo | sklep),
                    control = lmerControl(calc.derivs = FALSE, check.conv.singular = "ignore", check.conv.hess = "ignore"))
    est[r] <- fixef(m)[["promo"]]; se[r] <- coef(summary(m))["promo", "Std. Error"]
  }
  c(sklepy = J, tygodnie = T, sredni_SE = mean(se), polowa_95CI = mean(qt(.975, J - 1) * se), SD_oszacowan = sd(est))
}
set.seed(631)
plany <- rbind(c(10, 52), c(20, 52), c(40, 52), c(80, 52), c(40, 26), c(40, 104))
round(t(apply(plany, 1, function(p) precyzja(p[1], p[2]))), 2)
Wynik w R
     sklepy tygodnie sredni_SE polowa_95CI SD_oszacowan
[1,]     10       52      0.65        1.46         0.69
[2,]     20       52      0.48        1.00         0.46
[3,]     40       52      0.34        0.68         0.31
[4,]     80       52      0.24        0.47         0.23
[5,]     40       26      0.39        0.79         0.35
[6,]     40      104      0.31        0.62         0.30
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("zielony – niebieski (małe / średnie miasto)" = c("#009E73", "#0072B2"),
             "zielony – cynober (małe / duże miasto)" = c("#009E73", "#D55E00"),
             "niebieski – cynober (średnie / duże miasto; metody)" = c("#0072B2", "#D55E00"),
             "pomarańczowy – cynober (dwie metody na rysunku 3)" = c("#E69F00", "#D55E00"),
             "szary – cynober (tydzień bez / z promocją)" = c("#737373", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                    widzenie_typowe
zielony – niebieski (małe / średnie miasto)                    70.1
zielony – cynober (małe / duże miasto)                        102.4
niebieski – cynober (średnie / duże miasto; metody)           114.6
pomarańczowy – cynober (dwie metody na rysunku 3)              33.4
szary – cynober (tydzień bez / z promocją)                     76.9
czerwony – zielony (do unikania)                              121.7
                                                    deuteranopia protanopia
zielony – niebieski (małe / średnie miasto)                 55.4       58.0
zielony – cynober (małe / duże miasto)                      53.5       37.3
niebieski – cynober (średnie / duże miasto; metody)        108.3       91.9
pomarańczowy – cynober (dwie metody na rysunku 3)           18.4       24.9
szary – cynober (tydzień bez / z promocją)                  63.4       53.8
czerwony – zielony (do unikania)                            21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test t, regresja – pakiety base i stats). Modele mieszane dopasowano pakietem lme4, a wartości p i tabelę ANOVA z przybliżeniem Satterthwaite’a dał pakiet lmerTest. Rysunki wykonano w ggplot2 (oś procentowa – pakiet scales, zestawienie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Test t na wszystkich tygodniach. Pseudoreplikacja i mieszanie sklepów: 5.72 zamiast 3.42 tys. zł i błąd standardowy niezgodny ze strukturą danych.
- Losowy wyraz wolny bez losowego nachylenia, gdy pytasz o efekt zmiennej poziomu tygodnia – do 44.2% fałszywych alarmów w symulacji. Gdy pełny model się nie zbiega, zob. singular fit i brak zbieżności.
- Sezon i święta. Jeśli promocje skupiają się latem, a latem sprzedaje się więcej napojów, efekt promocji przejmie sezonowość. Dodaj efekty tygodnia lub miesiąca (zob. prognoza sprzedaży z sezonowością i promocjami) i sprawdź autokorelację reszt.
- Promocje wybierane przez kierowników, np. gdy sprzedaż akurat spada – oszacowanie jest obciążone niezależnie od modelu.
- Zapasy. Tydzień po promocji bywa słabszy – dodaj zmienną „tydzień po promocji”.
- Ranking sklepów z wykresu gąsienicowego – przedziały się nakładają (rysunek 4).
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Dlaczego nie można porównać średniej sprzedaży z tygodni z promocją i bez testem t?
Tygodnie jednego sklepu nie są niezależnymi obserwacjami, a promocje często trafiają częściej do określonych sklepów. Test t na wszystkich tygodniach miesza wtedy różnice między sklepami z efektem promocji i liczy błąd standardowy tak, jakby tygodnie były niezależne – to pseudoreplikacja. W przykładzie dał 5.72 tys. zł zamiast 3.42 tys. zł z modelu mieszanego, a w symulacji bez prawdziwego efektu nawet 19.0% wyników istotnych.
Kiedy w modelu mieszanym dodać losowe nachylenie?
Gdy pytasz o efekt zmiennej, która zmienia się wewnątrz jednostek (np. promocja w tygodniach jednego sklepu), a ten efekt może różnić się między jednostkami. Bez losowego nachylenia model zakłada jeden efekt dla wszystkich i daje zbyt mały błąd standardowy: w symulacji z SD efektu 3 tys. zł odsetek fałszywych alarmów wyniósł 44.2% zamiast 5%. Losowe nachylenie jest też konieczne przy interakcji międzypoziomowej (Heisig i Schaeffer, 2019).
Jak interpretować odchylenie standardowe losowego nachylenia?
To rozrzut efektu między jednostkami wokół efektu średniego. Przy średnim efekcie promocji 3.42 tys. zł i SD 1.75 tys. zł efekt w 95% sklepów mieści się w przybliżeniu między −0.02 a 6.85 tys. zł (średnia ± 1.96 SD). Ten zakres zakłada rozkład normalny efektów i pomija niepewność samych oszacowań.
Ile sklepów potrzeba do modelu mieszanego?
O precyzji średniego efektu decyduje głównie liczba sklepów, a nie tygodni. W symulacji z parametrami przykładu połowa szerokości 95% CI wynosiła ±1.46 tys. zł przy 10 sklepach, ±0.68 przy 40 i ±0.47 przy 80, a wydłużenie obserwacji z 52 do 104 tygodni zawęziło ją tylko z ±0.68 do ±0.62.
Czy można zrobić ranking sklepów z wykresu gąsienicowego?
Ostrożnie. Efekty losowe sklepów są ściągnięte do średniej i mają szerokie przedziały, które się nakładają, więc sąsiednie miejsca w rankingu niewiele znaczą. W przykładzie przedział 13 z 40 sklepów nie obejmował średniego efektu promocji – tylko te sklepy można opisać jako wyraźnie słabsze lub mocniejsze od średniej.
Powiązane hasła
Przeczytaj też
Model wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikMarketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikLiczba zakupów: zliczenia z zerami
2000 kont sklepu dla zwierząt: Poisson, NB, ZINB i hurdle, rootogram, wagi Akaikego, offset i co naprawdę zmienia karta stałego klienta – z kodem R.
Czytaj →Poradnik„2 za 1” czy −50%? Forma promocji
Sieć sklepów papierniczych: eksperyment z trzema formami promocji, sztuki na paragon, model mieszany, kanibalizacja, dołek i bilans marży – z kodem R.
Czytaj →Masz w pracy dane ze sklepów, oddziałów albo regionów?
Pomożemy dobrać strukturę modelu mieszanego, policzyć efekt promocji lub kampanii z losowymi nachyleniami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aarts, E., Verhage, M., Veenvliet, J. V., Dolan, C. V., & van der Sluis, S. (2014). A solution to dependency: Using multilevel analysis to accommodate nested data. Nature Neuroscience, 17(4), 491–496. https://doi.org/10.1038/nn.3648
- Arend, M. G., & Schäfer, T. (2019). Statistical power in two-level models: A tutorial based on Monte Carlo simulation. Psychological Methods, 24(1), 1–19. https://doi.org/10.1037/met0000195
- Barr, D. J., Levy, R., Scheepers, C., & Tily, H. J. (2013). Random effects structure for confirmatory hypothesis testing: Keep it maximal. Journal of Memory and Language, 68(3), 255–278. https://doi.org/10.1016/j.jml.2012.11.001 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Heisig, J. P., & Schaeffer, M. (2019). Why you should always include a random slope for the lower-level variable involved in a cross-level interaction. European Sociological Review, 35(2), 258–279. https://doi.org/10.1093/esr/jcy053 ● Otwarty dostęp
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
Cytowania BibTeX
@article{aarts2014solution, author={Aarts, Emmeke and Verhage, Matthijs and Veenvliet, Jesse V. and Dolan, Conor V. and van der Sluis, Sophie}, title={{A solution to dependency: Using multilevel analysis to accommodate nested data}}, journal={Nature Neuroscience}, year={2014}, volume={17}, number={4}, pages={491--496}, doi={10.1038/nn.3648}}@article{arend2019statistical, author={Arend, Matthias G. and Schäfer, Thomas}, title={{Statistical power in two-level models: A tutorial based on Monte Carlo simulation}}, journal={Psychological Methods}, year={2019}, volume={24}, number={1}, pages={1--19}, doi={10.1037/met0000195}}@article{barr2013random, author={Barr, Dale J. and Levy, Roger and Scheepers, Christoph and Tily, Harry J.}, title={{Random effects structure for confirmatory hypothesis testing: Keep it maximal}}, journal={Journal of Memory and Language}, year={2013}, volume={68}, number={3}, pages={255--278}, doi={10.1016/j.jml.2012.11.001}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{heisig2019why, author={Heisig, Jan Paul and Schaeffer, Merlin}, title={{Why you should always include a random slope for the lower-level variable involved in a cross-level interaction}}, journal={European Sociological Review}, year={2019}, volume={35}, number={2}, pages={258--279}, doi={10.1093/esr/jcy053}}@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}