Przykład: kto w ogóle kupuje i ile razy?
Fikcyjny sklep internetowy z karmą i akcesoriami dla zwierząt ma 2000 kont klientów. Dla każdego konta znamy liczbę zamówień w 2025 roku, to, czy klient ma kartę stałego klienta (39.9%) i zgodę na newsletter (54.4%), liczbę zwierząt w domu oraz liczbę miesięcy, przez które konto było aktywne. 68.3% kont działało cały rok, resztę założono w trakcie roku.
Dział marketingu pyta: czy karta stałego klienta sprawia, że klienci kupują częściej? Średnio klienci z kartą złożyli 2.72 zamówienia, a bez karty – 1.37. Wygląda na to, że karta podwaja zakupy. Ten wpis pokazuje, że w tych danych karta działa inaczej: zmienia to, czy klient w ogóle kupi, a nie to, ile razy kupuje ktoś, kto już kupuje. Do takiego rozdzielenia służą modele dla zliczeń z nadmiarem zer.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy dwa procesy. Pierwszy decyduje, czy klient kupił choć raz: karta podnosi logit o 1.3, newsletter o 0.5, a krótszy staż konta obniża szansę. Drugi – ile razy kupił klient, który kupuje: karta prawie nic nie zmienia (+0.05 w skali logarytmu), każde kolejne zwierzę dodaje 0.3, a rozproszenie theta = 1.5. Wszystkie parametry są w przepisie 1 kodu, a ziarno 632 ustalono raz i nie zmieniano go. Dane pobierzesz jako liczba-zakupow-sklep-zoologiczny.csv.
Mechanikę zliczeń (prosta na zliczeniach, nadmierna dyspersja w 1000 badaniach, IRR na osi logarytmicznej) pokazuje wpis regresja Poissona – wizualizacja, a pełną procedurę z tabelą APA – regresja dla zliczeń krok po kroku. Tu chodzi o decyzję marketingową: który proces zmienia dane działanie.
Rysunek 1: ile razy klienci zamówili
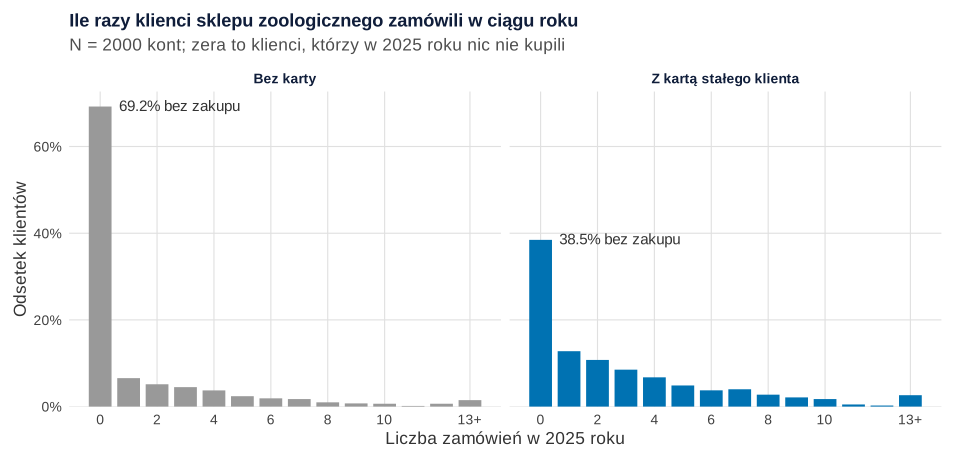
set.seed(632)).Co widać. Najwyższy słupek to zero. W 2025 roku nic nie kupiło 1139 z 2000 klientów (57.0%). Średnia liczba zamówień wynosi 1.91, a wariancja 11.03 – prawie sześć razy więcej. Zer jest dużo w obu grupach, ale bez karty (69.2%) znacznie więcej niż z kartą (38.5%). Prawy ogon jest długi: najaktywniejszy klient zamówił 31 razy.
Jak może zmylić. Wśród klientów, którzy kupili choć raz, średnia jest prawie taka sama: 4.45 zamówienia bez karty i 4.42 z kartą. Różnica średnich ogółem (1.37 wobec 2.72) bierze się więc prawie w całości z zer. Wykres nie mówi jednak, czy to karta zachęca do zakupu, czy aktywni klienci chętniej ją zakładają. Rysunek opisuje dane, a nie przyczynę.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: dwa procesy – czy kupuje i ile kupuje
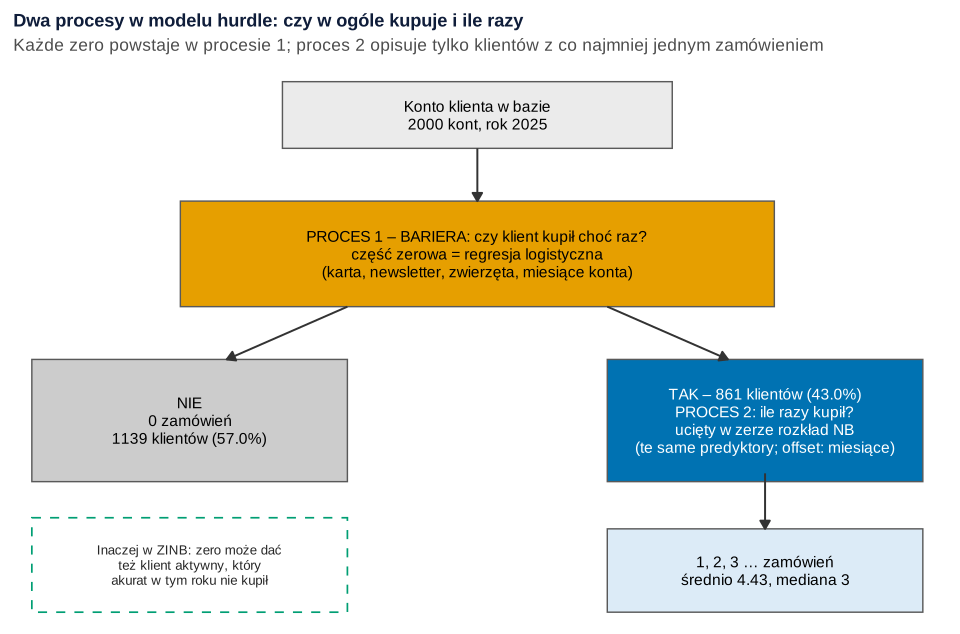
Co widać. Model hurdle (z barierą) dzieli zakupy na dwa pytania. Najpierw: czy klient przekroczył barierę zera, czyli kupił choć raz? Tę część opisuje regresja logistyczna. Kupiło 861 klientów (43.0%). Potem: ile razy kupił ten, kto kupuje? Tę część opisuje rozkład ujemny dwumianowy ucięty w zerze, bo u kupujących zera już nie ma. Kupujący złożyli średnio 4.43 zamówienia (mediana 3), a 21.0% z nich kupiło tylko raz. Takie zmodyfikowane modele dla zliczeń opisał Mullahy (1986). Obie części mogą mieć własne predyktory i własne współczynniki. Definicję znajdziesz w haśle model hurdle.
Jak może zmylić. Hurdle to nie jedyna historia o zerach. W modelu z nadmiarem zer (ZINB) zero ma dwa źródła: „uśpionego” klienta, który na pewno nie kupi, i aktywnego klienta, który akurat w tym roku nie kupił (przerywana ramka; zob. model z nadmiarem zer i Lambert, 1992). Która historia pasuje, zależy od tego, co zero znaczy w Twoich danych, a nie od samego rysunku.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: wiszące słupki dla czterech modeli
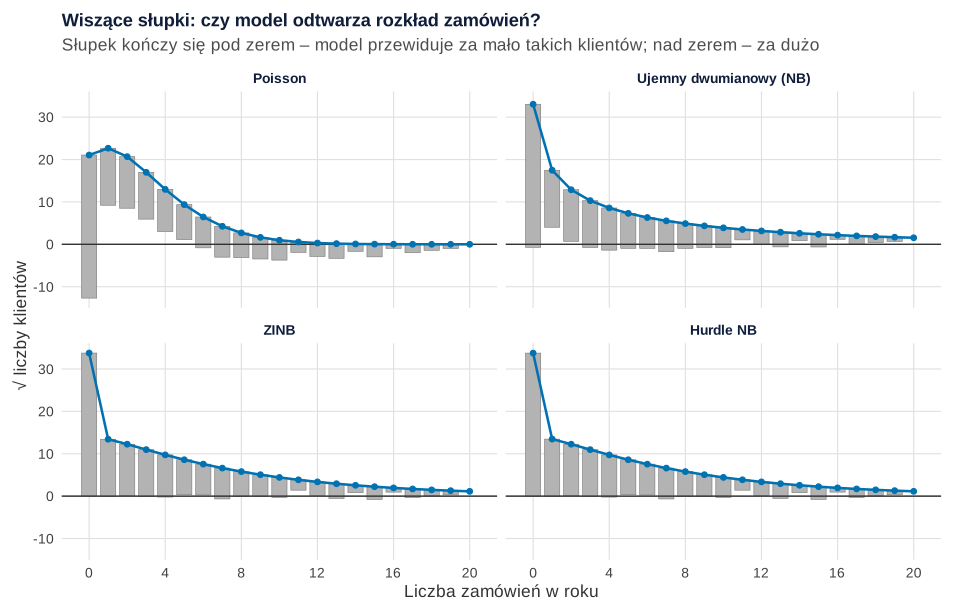
Co widać. Dopasowaliśmy cztery modele z tymi samymi predyktorami (karta, newsletter, liczba zwierząt) i z offsetem dla liczby miesięcy konta. Niebieska krzywa to pierwiastek z oczekiwanej liczby klientów z daną liczbą zamówień, a szary słupek – pierwiastek z liczby obserwowanej, zawieszony na krzywej (Kleiber i Zeileis, 2016). Gdy model pasuje, dół słupka leży przy zerze. Rozkład Poissona przewiduje 443.4 klientów bez zamówienia zamiast 1139, za to 513.9 klientów z jednym zamówieniem zamiast 181. Jego współczynnik dyspersji wynosi 4.90, czyli to klasyczna nadmierna dyspersja. Regresja ujemna dwumianowa (theta = 0.366) prawie trafia w zera (1092.0), ale przewiduje 305.4 klientów z jednym zamówieniem zamiast 181. ZINB i hurdle NB trafiają w zera (1139.6 i 1139.0) i w jedynki (180.2 i 181.1).
Jak może zmylić. Patrząc tylko na zera, uznałbyś model ujemny dwumianowy za wystarczający – brakuje mu 47 zer na 1139. Problem widać dopiero przy jednym zamówieniu. Jeden rozkład musi tu objąć i masę zer, i kupujących, którzy zwykle kupują kilka razy, więc „rozmazuje” prawdopodobieństwo na jedynki. Rootogram ocenia rozkład łącznie, a nie to, czy dobrze opisano wpływ karty. Rysowaliśmy go ręcznie w ggplot2 z sum przewidywanych prawdopodobieństw.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: AIC, wagi Akaikego i remis ZINB z hurdle
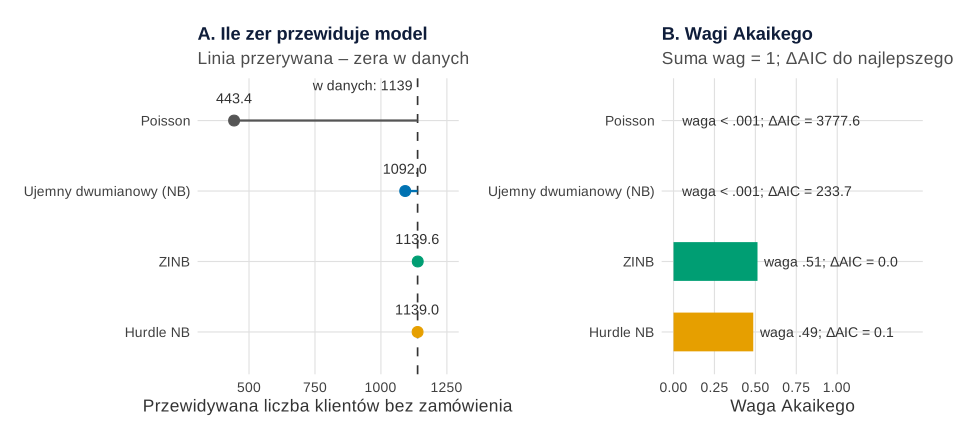
Co widać. Panel A powtarza wniosek z rysunku 3 jedną liczbą: ile zer przewiduje model. Panel B porównuje modele kryterium AIC (zob. AIC i BIC w regresji). AIC wynosi 10216.5 dla modelu Poissona, 6672.6 dla ujemnego dwumianowego, 6438.9 dla ZINB i 6439.0 dla hurdle NB. Różnice AIC przeliczyliśmy na wagi Akaikego, które można czytać jako warunkowe prawdopodobieństwo, że dany model jest najlepszy w porównywanym zestawie (Wagenmakers i Farrell, 2004). Poisson i ujemny dwumianowy mają wagi poniżej .001, ZINB – .51, a hurdle NB – .49. BIC daje ten sam obraz (6494.9 i 6495.0).
Jak może zmylić. Wagi .51 i .49 to remis, a nie zwycięstwo ZINB. Oba modele mają po 10 parametrów i prawie identyczny logarytm wiarygodności (−3209.45 i −3209.51). Statystyka nie rozstrzygnie tu, skąd biorą się zera – musi to zrobić wiedza o procesie. W sklepie zero oznacza „w tym roku nie kupił”, a każdy, kto kupuje, ma co najmniej jedno zamówienie, więc wybieramy hurdle: jest prostszy w interpretacji. Nie rozstrzygaj tego testem Vuonga – jego popularne użycie do testowania nadmiaru zer jest błędne (Wilson, 2015).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: co naprawdę zmienia karta
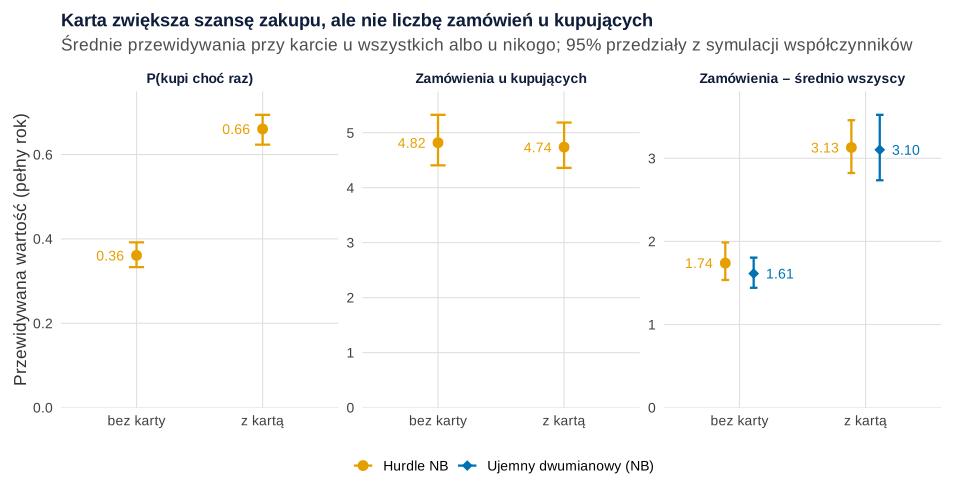
set.seed(632)).Co widać. W części zerowej modelu hurdle karta zwiększa szanse złożenia choć jednego zamówienia: iloraz szans OR = 3.52, 95% CI [2.90, 4.28], p < .001 (w danych ukryliśmy exp(1.3) ≈ 3.67). Newsletter też: OR = 1.70, 95% CI [1.40, 2.07], p < .001. W części zliczeń karta nie zmienia liczby zamówień u kupujących: IRR = 0.98, 95% CI [0.85, 1.12], p = .731. Tu liczy się liczba zwierząt: każde kolejne to o 25% więcej zamówień, IRR = 1.25, 95% CI [1.13, 1.38], p < .001. Rysunek przekłada to na liczby, czyli średnie przewidywania jak przy efektach krańcowych: „gdyby wszyscy mieli kartę” i „gdyby nikt jej nie miał” przy pełnym roku konta. Prawdopodobieństwo zakupu rośnie z 0.36 do 0.66. Liczba zamówień u kupujących zostaje na tym samym poziomie: 4.82 i 4.74. Średnia wszystkich klientów rośnie z 1.74 do 3.13.
Jak może zmylić. Zwykła regresja ujemna dwumianowa daje dla karty IRR = 1.92, 95% CI [1.63, 2.27], i prawie te same średnie (1.61 i 3.10). Kusi, by przeczytać go jako „posiadacze karty kupują dwa razy częściej”. Model hurdle pokazuje, że różnica bierze się z tego, że więcej posiadaczy karty w ogóle kupuje. Oba modele opisują związek, nie przyczynę: aktywni klienci mogą chętniej zakładać kartę. Przedziały policzyliśmy z 2000 losowań współczynników z ich przybliżonego rozkładu normalnego.
Podpis do pracy:
Zdanie do Wyników:
Offset: różna długość obserwacji
Konta założone w trakcie roku miały mniej czasu na zakupy: średnio 0.93 zamówienia wobec 2.36 u kont aktywnych cały rok. Miały też rzadziej kartę (32% wobec 44%). W części zliczeń dodaliśmy więc offset – logarytm liczby miesięcy ze współczynnikiem 1, czyli model opisuje zamówienia na miesiąc. W części zerowej logarytm miesięcy jest zwykłym predyktorem (OR = 2.56 na jednostkę logarytmu), bo szansa „choć jednego zakupu” nie musi rosnąć proporcjonalnie do czasu. Bez tego model ma wyraźnie gorsze AIC (6593.47 wobec 6439.01), a iloraz szans dla karty rośnie z 3.52 do 3.73 – część efektu stażu przypisuje karcie.
Co z tym zrobić w marketingu
- Karta i newsletter to narzędzia aktywacji. Mierz je odsetkiem klientów, którzy złożyli pierwsze zamówienie w okresie, a nie średnią liczbą zamówień.
- Częstotliwość zakupów u aktywnych zależy od potrzeb (tu: liczby zwierząt). Przypomnienia o kończącej się karmie i subskrypcję kieruj do kupujących z kilkoma zwierzętami.
- Klienci bez zakupu w roku to osobna grupa. Kampania reaktywacyjna (kod na pierwsze zamówienie) to inne działanie niż program dla stałych klientów. Liczba zamówień zasila też modele wartości klienta – zob. wartość klienta w czasie (CLV) i częstość zakupów w segmentacji RFM we wpisie analiza skupień w marketingu.
- Zanim przypiszesz karcie przyczynę, sprawdź to w eksperymencie: losowo zaproponuj kartę części klientów i porównaj odsetek kupujących, jak w teście A/B. Komu kartę proponować, podpowie modelowanie uplift.
Pułapki
- Model z nadmiarem zer „bo jest dużo zer”. Najpierw sprawdź, ile zer przewiduje zwykły model ujemny dwumianowy, i obejrzyj cały rootogram. Czasem NB wystarcza. Modele z nadmiarem zer i hurdle z kodem w kilku programach omawia tutorial Atkinsa i in. (2013).
- Wybór ZINB czy hurdle samym AIC. Przy remisie (rysunek 4) decyduje znaczenie zera.
- Odwrócony znak w części zerowej ZINB. W pakiecie pscl część zerowa ZINB modeluje szansę bycia zerem strukturalnym, a w hurdle – szansę przekroczenia bariery. Ten sam predyktor ma więc w obu modelach przeciwne znaki.
- IRR z części zliczeń jako efekt dla wszystkich. Dotyczy tylko kupujących. Średnią dla całej bazy licz z obu części (rysunek 5).
- Pominięty offset – staż konta miesza się z efektem karty.
- Kilka lat danych tego samego klienta albo klienci z różnych sklepów sieci to obserwacje zależne. Potrzebny jest wtedy GLMM z częścią zerową, np. w pakiecie glmmTMB – zob. promocje w sieci sklepów.
Jak opisać w pracy
W Metodzie podaj zmienną zależną i okres, offset, porównane modele, kryterium wyboru i uzasadnienie wyboru między ZINB a hurdle. W Wynikach – tabelę modeli, ilorazy z obu części i przewidywania. Inne analizy typowe dla tego kierunku opisuje wpis statystyka w pracy z marketingu.
| Model | logL | Parametry | AIC | BIC | Waga Akaikego | Przewidywane zera |
|---|---|---|---|---|---|---|
| Poisson | −5104.27 | 4 | 10216.5 | 10238.9 | < .001 | 443.4 |
| Ujemny dwumianowy | −3331.32 | 5 | 6672.6 | 6700.7 | < .001 | 1092.0 |
| ZINB | −3209.45 | 10 | 6438.9 | 6494.9 | .51 | 1139.6 |
| Hurdle NB | −3209.51 | 10 | 6439.0 | 6495.0 | .49 | 1139.0 |
Podpis tabeli:
Do Metody:
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu, tabelę i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, a przepis 3 – modele, z których korzystają następne. Każdy przepis z rysunkiem kończy się nazwą wykresu, co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Przepisy, które losują (1 i 5), mają własne set.seed(632). Ziarno 632 ustalono raz i nie zmieniano go. Ręcznie ustalono: 2000 kont; 70% kont aktywnych cały rok, reszta 1–11 miesięcy; liczba zwierząt 1, 2 albo 3 z prawdopodobieństwami .6, .3 i .1; 55% zgód na newsletter; szansa posiadania karty plogis(−1.2 + 0.08 × miesiące); część „czy kupił” plogis(−0.9 + 1.3 × karta + 0.5 × newsletter + 0.9 × log(miesiące/12)); część „ile razy” – ucięty w zerze rozkład ujemny dwumianowy ze średnią (miesiące/12) × exp(1.2 + 0.05 × karta + 0.30 × (zwierzęta − 1)) i theta = 1.5; 2000 losowań współczynników w przepisie 5. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Paleta, dane i rozkład zamówień: Rysunek 1
R
# Rysunek 1. Ile razy klienci kupili w ciągu roku? Rozkład zakupów z kartą i bez karty (dane fikcyjne)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(bez_karty = "grey60", karta = "#0072B2", poisson = "#555555", nb = "#0072B2",
         zinb = "#009E73", hurdle = "#E69F00", ciemny = "grey20", linia = "#0072B2")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Fikcyjny sklep internetowy z karmą i akcesoriami dla zwierząt: 2000 kont klientów,
# liczba zamówień w 2025 roku. Część kont założono w trakcie roku (miesiace < 12).
set.seed(632)                                     # ziarno ustalone raz, bez dobierania pod wynik
N <- 2000
miesiace <- ifelse(runif(N) < .7, 12, sample(1:11, N, replace = TRUE))   # ile miesięcy konto było aktywne
zwierzeta <- sample(1:3, N, replace = TRUE, prob = c(.6, .3, .1))         # liczba zwierząt w domu
newsletter <- rbinom(N, 1, .55)                                           # zgoda na newsletter
karta <- rbinom(N, 1, plogis(-1.2 + 0.08 * miesiace))                     # karta stałego klienta
# Proces 1 – czy klient kupił choć raz (logity ustalone ręcznie)
kupuje <- rbinom(N, 1, plogis(-0.9 + 1.3 * karta + 0.5 * newsletter + 0.9 * log(miesiace / 12)))
# Proces 2 – ile razy kupił, jeśli kupił: ucięty w zerze rozkład ujemny dwumianowy (theta = 1.5)
mu <- (miesiace / 12) * exp(1.2 + 0.05 * karta + 0.30 * (zwierzeta - 1))
ile_razy <- function(m) { repeat { y <- rnbinom(1, mu = m, size = 1.5); if (y > 0) return(y) } }
zakupy <- ifelse(kupuje == 1, sapply(mu, ile_razy), 0)
dane <- data.frame(id = 1:N, zakupy, karta, newsletter, zwierzeta, miesiace)
write.csv(dane, "liczba-zakupow-sklep-zoologiczny.csv", row.names = FALSE)

c(N = N, srednia = round(mean(zakupy), 2), wariancja = round(var(zakupy), 2),
  zera = sum(zakupy == 0), zera_proc = round(100 * mean(zakupy == 0), 1), maks = max(zakupy))
c(karta_proc = round(100 * mean(karta), 1), newsletter_proc = round(100 * mean(newsletter), 1),
  pelny_rok_proc = round(100 * mean(miesiace == 12), 1))
# Zera i średnia w grupach karty
grupy <- aggregate(zakupy ~ karta, dane, function(y) c(n = length(y), zera_proc = 100 * mean(y == 0),
                                                       srednia = mean(y), srednia_kupujacych = mean(y[y > 0])))
round(do.call(cbind, grupy), 2)

# Rysunek: odsetek klientów z daną liczbą zamówień (13 i więcej w jednym słupku)
dane$zakupy_s <- pmin(dane$zakupy, 13)
dane$grupa <- factor(ifelse(dane$karta == 1, "Z kartą stałego klienta", "Bez karty"),
                     levels = c("Bez karty", "Z kartą stałego klienta"))
rozklad <- as.data.frame(prop.table(table(grupa = dane$grupa, zakupy = dane$zakupy_s), 1))
rozklad$zakupy <- as.numeric(as.character(rozklad$zakupy))
zera_et <- subset(rozklad, zakupy == 0)
p1 <- ggplot(rozklad, aes(zakupy, Freq, fill = grupa)) +
  geom_col(width = 0.8) +
  geom_text(data = zera_et, aes(label = sprintf("%.1f%% bez zakupu", 100 * Freq)),
            hjust = -0.15, vjust = 0.4, size = 4, colour = kol[["ciemny"]]) +
  facet_wrap(~ grupa, ncol = 2) +
  scale_fill_manual(values = c(kol[["bez_karty"]], kol[["karta"]]), guide = "none") +
  scale_x_continuous(breaks = c(0, 2, 4, 6, 8, 10, 13), labels = c(0, 2, 4, 6, 8, 10, "13+")) +
  scale_y_continuous(labels = scales::label_percent(accuracy = 1), expand = expansion(mult = c(0, 0.05))) +
  labs(x = "Liczba zamówień w 2025 roku", y = "Odsetek klientów",
       title = "Ile razy klienci sklepu zoologicznego zamówili w ciągu roku",
       subtitle = sprintf("N = %d kont; zera to klienci, którzy w 2025 roku nic nie kupili", N)) + motyw
p1   # ggsave("zakupy-rozklad.svg", p1, width = 10, height = 4.8)
Wynik w R
        N   srednia wariancja      zera zera_proc      maks
  2000.00      1.91     11.03   1139.00     57.00     31.00
     karta_proc newsletter_proc  pelny_rok_proc
           39.9            54.4            68.3
     karta    n zera_proc srednia srednia_kupujacych
[1,]     0 1202     69.22    1.37               4.45
[2,]     1  798     38.47    2.72               4.42
2. Schemat dwóch procesów: Rysunek 2
R
# Rysunek 2. Schemat dwóch procesów (model hurdle) – grafika narysowana w ggplot2
# Dane wejściowe: dane, kol i motyw z przepisu 1. Liczby w ramkach pochodzą z danych.
n_zero <- sum(dane$zakupy == 0); n_plus <- sum(dane$zakupy > 0)
kupujacy <- dane$zakupy[dane$zakupy > 0]
c(bez_zakupu = n_zero, kupujacy = n_plus, kupujacy_proc = round(100 * n_plus / nrow(dane), 1),
  srednia_u_kupujacych = round(mean(kupujacy), 2), mediana_u_kupujacych = median(kupujacy),
  kupujacy_1_raz_proc = round(100 * mean(kupujacy == 1), 1))

ramki <- data.frame(
  x = c(5, 5, 1.9, 8.1, 8.1),
  y = c(9.1, 6.6, 3.6, 3.6, 0.9),
  szer = c(4.2, 6.4, 3.4, 3.4, 3.4), wys = c(1.2, 1.9, 2.2, 2.2, 1.5),
  typ = c("start", "bariera", "zero", "ile", "wynik"),
  tekst = c(sprintf("Konto klienta w bazie\n%d kont, rok 2025", nrow(dane)),
            "PROCES 1 – BARIERA: czy klient kupił choć raz?\nczęść zerowa = regresja logistyczna\n(karta, newsletter, zwierzęta, miesiące konta)",
            sprintf("NIE\n0 zamówień\n%d klientów (%.1f%%)", n_zero, 100 * n_zero / nrow(dane)),
            sprintf("TAK – %d klientów (%.1f%%)\nPROCES 2: ile razy kupił?\nucięty w zerze rozkład NB\n(te same predyktory; offset: miesiące)", n_plus, 100 * n_plus / nrow(dane)),
            sprintf("1, 2, 3 … zamówień\nśrednio %.2f, mediana %d", mean(kupujacy), median(kupujacy))))
strzalki <- data.frame(x = c(5, 3.6, 6.4, 8.1), y = c(8.5, 5.65, 5.65, 2.65),
                       xend = c(5, 2.3, 7.7, 8.1), yend = c(7.55, 4.7, 4.7, 1.65))
p_schemat <- ggplot() +
  geom_rect(data = ramki, aes(xmin = x - szer / 2, xmax = x + szer / 2, ymin = y - wys / 2, ymax = y + wys / 2, fill = typ),
            colour = "grey35", linewidth = 0.5) +
  geom_text(data = ramki, aes(x, y, label = tekst, colour = typ), size = 4.1, lineheight = 0.95) +
  geom_segment(data = strzalki, aes(x, y, xend = xend, yend = yend), linewidth = 0.7, colour = kol[["ciemny"]],
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  annotate("rect", xmin = 0.2, xmax = 3.6, ymin = 0.15, ymax = 1.85, fill = "white", colour = kol[["zinb"]],
           linetype = "dashed", linewidth = 0.6) +
  annotate("text", x = 1.9, y = 1, size = 3.5, lineheight = 0.95, colour = "grey15",
           label = "Inaczej w ZINB: zero może dać\nteż klient aktywny, który\nakurat w tym roku nie kupił") +
  scale_fill_manual(values = c(start = "grey92", bariera = "#E69F00", zero = "grey80", ile = "#0072B2", wynik = "#DCEBF7"),
                    guide = "none") +
  scale_colour_manual(values = c(start = "black", bariera = "black", zero = "black", ile = "white", wynik = "black"),
                      guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 10), expand = FALSE) +
  labs(title = "Dwa procesy w modelu hurdle: czy w ogóle kupuje i ile razy",
       subtitle = "Każde zero powstaje w procesie 1; proces 2 opisuje tylko klientów z co najmniej jednym zamówieniem") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(),
                panel.grid.major = element_blank(), panel.grid.minor = element_blank())
p_schemat   # ggsave("zakupy-schemat-hurdle.svg", p_schemat, width = 10, height = 6.6)
Wynik w R
          bez_zakupu             kupujacy        kupujacy_proc
             1139.00               861.00                43.00
srednia_u_kupujacych mediana_u_kupujacych  kupujacy_1_raz_proc
                4.43                 3.00                21.00
3. Cztery modele i wiszące słupki: Rysunek 3
R
# Rysunek 3. Wiszące słupki (rootogram) dla czterech modeli – narysowane ręcznie w ggplot2
# Dane wejściowe: dane, kol i motyw z przepisu 1.
library(MASS)                                    # glm.nb – regresja ujemna dwumianowa
library(pscl)                                    # zeroinfl i hurdle – modele z nadmiarem zer i hurdle

# Ten sam zestaw predyktorów we wszystkich modelach; offset = log(liczby miesięcy aktywnego konta)
f_licz <- zakupy ~ karta + newsletter + zwierzeta + offset(log(miesiace))
f_dwie <- zakupy ~ karta + newsletter + zwierzeta + offset(log(miesiace)) |
                   karta + newsletter + zwierzeta + log(miesiace)
m_pois <- glm(f_licz, family = poisson, data = dane)
m_nb   <- glm.nb(f_licz, data = dane)
m_zinb <- zeroinfl(f_dwie, dist = "negbin", data = dane)
m_hnb  <- hurdle(f_dwie, dist = "negbin", zero.dist = "binomial", data = dane)
modele <- list("Poisson" = m_pois, "Ujemny dwumianowy (NB)" = m_nb, "ZINB" = m_zinb, "Hurdle NB" = m_hnb)

# Współczynnik dyspersji modelu Poissona: suma kwadratów reszt Pearsona / df
c(dyspersja_poisson = round(sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois), 2),
  theta_nb = round(m_nb$theta, 3))

# Oczekiwana liczba klientów z k zamówieniami = suma prawdopodobieństw P(Y = k) po wszystkich klientach
K <- 0:20
oczekiwane <- list(
  "Poisson" = sapply(K, function(k) sum(dpois(k, fitted(m_pois)))),
  "Ujemny dwumianowy (NB)" = sapply(K, function(k) sum(dnbinom(k, mu = fitted(m_nb), size = m_nb$theta))),
  "ZINB" = colSums(predict(m_zinb, type = "prob", at = K)),
  "Hurdle NB" = colSums(predict(m_hnb, type = "prob", at = K)))
obserwowane <- sapply(K, function(k) sum(dane$zakupy == k))
round(cbind(k = K, obserwowane, sapply(oczekiwane, function(e) e))[1:9, ], 1)   # wiersze = 0–8 zamówień
round(t(sapply(oczekiwane, function(e) c(zera = e[1], jedno = e[2], od_10_do_20 = sum(e[11:21])))), 1)
c(obserwowane_zera = obserwowane[1], obserwowane_jedno = obserwowane[2],
  obserwowane_10_20 = sum(obserwowane[11:21]))

# Wiszące słupki: słupek o wysokości √obserwowanych zawieszony na krzywej √oczekiwanych
rg <- do.call(rbind, lapply(names(oczekiwane), function(m)
  data.frame(model = m, k = K, ocz = sqrt(oczekiwane[[m]]), obs = sqrt(obserwowane))))
rg$model <- factor(rg$model, levels = names(modele))
rg$dol <- rg$ocz - rg$obs
p2 <- ggplot(rg) +
  geom_rect(aes(xmin = k - 0.4, xmax = k + 0.4, ymin = dol, ymax = ocz), fill = "grey70", colour = "grey45", linewidth = 0.2) +
  geom_hline(yintercept = 0, colour = kol[["ciemny"]], linewidth = 0.5) +
  geom_line(aes(k, ocz), colour = kol[["linia"]], linewidth = 0.9) +
  geom_point(aes(k, ocz), colour = kol[["linia"]], size = 1.6) +
  facet_wrap(~ model, ncol = 2) +
  scale_x_continuous(breaks = seq(0, 20, 4)) +
  labs(x = "Liczba zamówień w roku", y = "√ liczby klientów",
       title = "Wiszące słupki: czy model odtwarza rozkład zamówień?",
       subtitle = "Słupek kończy się pod zerem – model przewiduje za mało takich klientów; nad zerem – za dużo") + motyw
p2   # ggsave("zakupy-rootogram.svg", p2, width = 10, height = 6.4)
Wynik w R
dyspersja_poisson          theta_nb
            4.900             0.366
      k obserwowane Poisson Ujemny dwumianowy (NB)   ZINB Hurdle NB
 [1,] 0        1139   443.4                 1092.0 1139.6    1139.0
 [2,] 1         181   513.9                  305.4  180.2     181.1
 [3,] 2         148   427.6                  165.7  150.1     150.1
 [4,] 3         122   288.4                  106.1  120.4     120.2
 [5,] 4          99   168.0                   73.5   94.7      94.6
 [6,] 5          68    87.6                   53.4   73.7      73.6
 [7,] 6          53    41.6                   40.0   57.0      56.9
 [8,] 7          53    18.1                   30.6   43.8      43.7
 [9,] 8          34     7.2                   23.9   33.5      33.5
                         zera jedno od_10_do_20
Poisson                 443.4 513.9         1.3
Ujemny dwumianowy (NB) 1092.0 305.4        75.0
ZINB                   1139.6 180.2        77.4
Hurdle NB              1139.0 181.1        77.6
 obserwowane_zera obserwowane_jedno obserwowane_10_20
             1139               181                70
4. AIC, BIC i wagi Akaikego: Rysunek 4
R
# Rysunek 4. Porównanie modeli: AIC, BIC, wagi Akaikego i przewidywana liczba zer
# Dane wejściowe: dane, modele, oczekiwane, obserwowane, kol i motyw z przepisów 1 i 3.
library(patchwork)
porownanie <- data.frame(model = names(modele),
                         logL = sapply(modele, function(m) as.numeric(logLik(m))),
                         parametry = sapply(modele, function(m) attr(logLik(m), "df")),
                         AIC = sapply(modele, AIC), BIC = sapply(modele, BIC),
                         zera_ocz = sapply(oczekiwane, function(e) e[1]))
porownanie$dAIC <- porownanie$AIC - min(porownanie$AIC)
porownanie$waga <- exp(-porownanie$dAIC / 2) / sum(exp(-porownanie$dAIC / 2))   # wagi Akaikego
print(cbind(porownanie[1], round(porownanie[2], 2), porownanie[3], round(porownanie[4:7], 1),
            waga = signif(porownanie$waga, 3)), row.names = FALSE)
c(obserwowane_zera = obserwowane[1])

porownanie$model <- factor(porownanie$model, levels = rev(names(modele)))
kolory_modeli <- c("Poisson" = kol[["poisson"]], "Ujemny dwumianowy (NB)" = kol[["nb"]],
                   "ZINB" = kol[["zinb"]], "Hurdle NB" = kol[["hurdle"]])
p3a <- ggplot(porownanie, aes(zera_ocz, model, colour = model)) +
  geom_vline(xintercept = obserwowane[1], linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_segment(aes(x = obserwowane[1], xend = zera_ocz, yend = model), linewidth = 0.8) +
  geom_point(size = 3.4) +
  geom_text(aes(label = sprintf("%.1f", zera_ocz)), nudge_y = 0.32, size = 3.8, colour = kol[["ciemny"]]) +
  annotate("text", x = obserwowane[1], y = 4.5, label = sprintf("w danych: %d", obserwowane[1]),
           hjust = 1.05, size = 3.7, colour = kol[["ciemny"]]) +
  scale_colour_manual(values = kolory_modeli, guide = "none") +
  scale_x_continuous(limits = c(350, 1250)) +
  labs(x = "Przewidywana liczba klientów bez zamówienia", y = NULL,
       title = "A. Ile zer przewiduje model", subtitle = "Linia przerywana – zera w danych") + motyw
p3b <- ggplot(porownanie, aes(waga, model, fill = model)) +
  geom_col(width = 0.55) +
  geom_text(aes(label = sprintf("waga %s; ΔAIC = %.1f", ifelse(waga < .001, "< .001", sub("^0", "", sprintf("%.2f", waga))), dAIC)),
            hjust = -0.05, size = 3.7, colour = kol[["ciemny"]]) +
  scale_fill_manual(values = kolory_modeli, guide = "none") +
  scale_x_continuous(limits = c(0, 1.45), breaks = c(0, .25, .5, .75, 1)) +
  labs(x = "Waga Akaikego", y = NULL,
       title = "B. Wagi Akaikego", subtitle = "Suma wag = 1; ΔAIC do najlepszego") + motyw +
  theme(axis.text.y = element_blank())
p3 <- p3a + p3b
p3   # ggsave("zakupy-aic.svg", p3, width = 10, height = 4.6)
Wynik w R
                  model     logL parametry     AIC     BIC zera_ocz   dAIC
                Poisson -5104.27         4 10216.5 10238.9    443.4 3777.6
 Ujemny dwumianowy (NB) -3331.32         5  6672.6  6700.7   1092.0  233.7
                   ZINB -3209.45        10  6438.9  6494.9   1139.6    0.0
              Hurdle NB -3209.51        10  6439.0  6495.0   1139.0    0.1
     waga
 0.00e+00
 9.00e-52
 5.13e-01
 4.87e-01
obserwowane_zera
            1139
5. Ilorazy z modelu hurdle i przewidywania dla karty: Rysunek 5
R
# Rysunek 5. Co zmienia karta stałego klienta: szansa zakupu, liczba zamówień u kupujących i średnia ogółem
# Dane wejściowe: dane, m_nb, m_hnb, kol i motyw z przepisów 1 i 3.
library(patchwork)
# Ilorazy z modelu hurdle: OR – część zerowa (czy kupił), IRR – część zliczeń (ile razy, jeśli kupił)
wsp <- summary(m_hnb)$coefficients
tab <- function(w, nazwa) {
  w <- w[rownames(w) != "Log(theta)" & rownames(w) != "(Intercept)", , drop = FALSE]
  data.frame(czesc = nazwa, zmienna = rownames(w), iloraz = exp(w[, 1]),
             dolna = exp(w[, 1] - 1.96 * w[, 2]), gorna = exp(w[, 1] + 1.96 * w[, 2]), p = w[, 4])
}
ilorazy <- rbind(tab(wsp$zero, "OR (czy kupił)"), tab(wsp$count, "IRR (ile razy)"))
print(cbind(ilorazy[1:2], round(ilorazy[3:5], 2), p = round(ilorazy$p, 3)), row.names = FALSE)
c(theta = round(unname(m_hnb$theta), 2), IRR_karta_NB = round(exp(coef(m_nb)[["karta"]]), 2),
  IRR_karta_NB_dolna = round(exp(confint.default(m_nb)["karta", 1]), 2),
  IRR_karta_NB_gorna = round(exp(confint.default(m_nb)["karta", 2]), 2))

# Średnie przewidywania „gdyby wszyscy mieli kartę / nikt nie miał karty” (pełny rok konta,
# pozostałe cechy jak w danych) i 95% przedziały z 2000 losowań współczynników z ich rozkładu normalnego
przewiduj <- function(b, log_theta, karta, model = "hurdle") {
  Xz <- cbind(1, karta, dane$newsletter, dane$zwierzeta, log(12))
  Xc <- cbind(1, karta, dane$newsletter, dane$zwierzeta)
  if (model == "nb") {                                 # NB: jedna część, offset log(12)
    return(c(NA, NA, mean(exp(Xc %*% b + log(12)))))
  }
  p_plus <- plogis(Xz %*% b[5:9])                      # P(Y > 0)
  mu <- exp(Xc %*% b[1:4] + log(12)); th <- exp(log_theta)
  sr_kup <- mu / (1 - (th / (th + mu))^th)             # średnia uciętego NB = średnia u kupujących
  c(mean(p_plus), sum(p_plus * sr_kup) / sum(p_plus), mean(p_plus * sr_kup))
}
set.seed(632)
B <- MASS::mvrnorm(2000, coef(m_hnb), vcov(m_hnb))
lt <- rnorm(2000, log(m_hnb$theta), m_hnb$SE.logtheta)      # log(theta) losowany osobno
Bnb <- MASS::mvrnorm(2000, coef(m_nb), vcov(m_nb))
miary <- c("P(kupi choć raz)", "Zamówienia u kupujących", "Zamówienia – średnio wszyscy")
wyniki <- do.call(rbind, lapply(0:1, function(k) {
  pkt <- przewiduj(coef(m_hnb), log(m_hnb$theta), k)
  sym <- sapply(1:2000, function(i) przewiduj(B[i, ], lt[i], k))
  pkt_nb <- przewiduj(coef(m_nb), NA, k, "nb")[3]
  sym_nb <- sapply(1:2000, function(i) przewiduj(Bnb[i, ], NA, k, "nb")[3])
  rbind(data.frame(model = "Hurdle NB", karta = k, miara = miary, wartosc = pkt,
                   dolna = apply(sym, 1, quantile, .025), gorna = apply(sym, 1, quantile, .975)),
        data.frame(model = "Ujemny dwumianowy (NB)", karta = k, miara = miary[3], wartosc = pkt_nb,
                   dolna = quantile(sym_nb, .025), gorna = quantile(sym_nb, .975)))
}))
print(cbind(wyniki[1:3], round(wyniki[4:6], 3)), row.names = FALSE)

wyniki$karta <- factor(ifelse(wyniki$karta == 1, "z kartą", "bez karty"), levels = c("bez karty", "z kartą"))
wyniki$miara <- factor(wyniki$miara, levels = miary)
wyniki$model <- factor(wyniki$model, levels = c("Hurdle NB", "Ujemny dwumianowy (NB)"))
p5 <- ggplot(wyniki, aes(karta, wartosc, colour = model, shape = model)) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.12, linewidth = 0.8,
                position = position_dodge(width = 0.45)) +
  geom_point(size = 3.4, position = position_dodge(width = 0.45)) +
  geom_text(aes(label = sprintf("%.2f", wartosc), hjust = ifelse(model == "Hurdle NB", 1.45, -0.45)),
            position = position_dodge(width = 0.45), size = 3.7, show.legend = FALSE) +
  facet_wrap(~ miara, scales = "free_y", ncol = 3) +
  scale_colour_manual(values = c("Hurdle NB" = kol[["hurdle"]], "Ujemny dwumianowy (NB)" = kol[["nb"]]), name = NULL) +
  scale_shape_manual(values = c("Hurdle NB" = 16, "Ujemny dwumianowy (NB)" = 18), name = NULL) +
  scale_y_continuous(limits = c(0, NA), expand = expansion(mult = c(0, 0.08))) +
  labs(x = NULL, y = "Przewidywana wartość (pełny rok)",
       title = "Karta zwiększa szansę zakupu, ale nie liczbę zamówień u kupujących",
       subtitle = "Średnie przewidywania przy karcie u wszystkich albo u nikogo; 95% przedziały z symulacji współczynników") + motyw
p5   # ggsave("zakupy-karta-przewidywania.svg", p5, width = 10, height = 5)
Wynik w R
          czesc       zmienna iloraz dolna gorna     p
 OR (czy kupił)         karta   3.52  2.90  4.28 0.000
 OR (czy kupił)    newsletter   1.70  1.40  2.07 0.000
 OR (czy kupił)     zwierzeta   1.01  0.88  1.17 0.857
 OR (czy kupił) log(miesiace)   2.56  2.05  3.19 0.000
 IRR (ile razy)         karta   0.98  0.85  1.12 0.731
 IRR (ile razy)    newsletter   0.91  0.79  1.04 0.158
 IRR (ile razy)     zwierzeta   1.25  1.13  1.38 0.000
             theta       IRR_karta_NB IRR_karta_NB_dolna IRR_karta_NB_gorna
              1.51               1.92               1.63               2.27
                  model karta                        miara wartosc dolna gorna
              Hurdle NB     0             P(kupi choć raz)   0.361 0.333 0.392
              Hurdle NB     0      Zamówienia u kupujących   4.818 4.407 5.325
              Hurdle NB     0 Zamówienia – średnio wszyscy   1.739 1.536 1.987
 Ujemny dwumianowy (NB)     0 Zamówienia – średnio wszyscy   1.613 1.442 1.805
              Hurdle NB     1             P(kupi choć raz)   0.661 0.624 0.694
              Hurdle NB     1      Zamówienia u kupujących   4.738 4.360 5.185
              Hurdle NB     1 Zamówienia – średnio wszyscy   3.130 2.824 3.458
 Ujemny dwumianowy (NB)     1 Zamówienia – średnio wszyscy   3.102 2.736 3.523
6. Offset: model z offsetem i bez niego
R
# Offset: konta założone w trakcie roku miały mniej czasu na zakupy (bez rysunku)
# Dane wejściowe: dane i m_hnb z przepisów 1 i 3.
library(pscl)
# Klienci z pełnym rokiem i z kontem założonym w trakcie roku
aggregate(cbind(zakupy, karta) ~ pelny_rok, transform(dane, pelny_rok = miesiace == 12),
          function(x) round(mean(x), 2))
# Ten sam model hurdle bez offsetu i bez liczby miesięcy w części zerowej
m_bez <- hurdle(zakupy ~ karta + newsletter + zwierzeta | karta + newsletter + zwierzeta,
                dist = "negbin", zero.dist = "binomial", data = dane)
porownaj <- function(m) c(OR_karta = exp(coef(m)[["zero_karta"]]), IRR_karta = exp(coef(m)[["count_karta"]]),
                          IRR_zwierzeta = exp(coef(m)[["count_zwierzeta"]]), AIC = AIC(m))
round(rbind(z_offsetem = porownaj(m_hnb), bez_offsetu = porownaj(m_bez)), 2)
Wynik w R
  pelny_rok zakupy karta
1     FALSE   0.93  0.32
2      TRUE   2.36  0.44
            OR_karta IRR_karta IRR_zwierzeta     AIC
z_offsetem      3.52      0.98          1.25 6439.01
bez_offsetu     3.73      1.00          1.24 6593.47
7. Kontrola palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("szary – niebieski (bez karty / z kartą)" = c("grey60", "#0072B2"),
             "pomarańczowy – niebieski (hurdle / NB)" = c("#E69F00", "#0072B2"),
             "grafit – niebieski (Poisson / NB)" = c("#555555", "#0072B2"),
             "grafit – zielony (Poisson / ZINB)" = c("#555555", "#009E73"),
             "zielony – pomarańczowy (ZINB / hurdle)" = c("#009E73", "#E69F00"),
             "niebieski – zielony (NB / ZINB)" = c("#0072B2", "#009E73"),
             "grafit – pomarańczowy (Poisson / hurdle)" = c("#555555", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
hex <- function(k) sapply(k, function(x) if (substr(x, 1, 1) == "#") x else rgb(t(col2rgb(x)), maxColorValue = 255))
round(t(sapply(pary, function(k) { k <- hex(k)
  c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)), protanopia = roznica(protan(k))) })), 1)
Wynik w R
                                         widzenie_typowe deuteranopia
szary – niebieski (bez karty / z kartą)             44.9         48.9
pomarańczowy – niebieski (hurdle / NB)             120.2        121.5
grafit – niebieski (Poisson / NB)                   42.6         45.6
grafit – zielony (Poisson / ZINB)                   52.2         21.8
zielony – pomarańczowy (ZINB / hurdle)              88.7         66.3
niebieski – zielony (NB / ZINB)                     70.1         55.4
grafit – pomarańczowy (Poisson / hurdle)            83.9         82.1
czerwony – zielony (do unikania)                   121.7         21.1
                                         protanopia
szary – niebieski (bez karty / z kartą)        40.6
pomarańczowy – niebieski (hurdle / NB)        109.3
grafit – niebieski (Poisson / NB)              40.4
grafit – zielony (Poisson / ZINB)              30.7
zielony – pomarańczowy (ZINB / hurdle)         51.5
niebieski – zielony (NB / ZINB)                58.0
grafit – pomarańczowy (Poisson / hurdle)       76.3
czerwony – zielony (do unikania)               31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Regresję Poissona oszacowano funkcją glm() (pakiet stats), regresję ujemną dwumianową – funkcją glm.nb() z pakietu MASS, a modele ZINB i hurdle – funkcjami zeroinfl() i hurdle() z pakietu pscl; współczynniki do przedziałów przewidywań losowano funkcją mvrnorm() z pakietu MASS. Rysunki wykonano w ggplot2 z pakietem scales, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pscl (wersja 1.5.9): Jackman, S. (2024). pscl: Classes and methods for R developed in the Political Science Computational Laboratory (R package version 1.5.9) [Computer software]. University of Sydney. https://github.com/atahk/pscl/; Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8). https://doi.org/10.18637/jss.v027.i08
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Kiedy użyć modelu hurdle, a kiedy ZINB dla liczby zakupów?
Model hurdle pasuje, gdy zero oznacza decyzję „nie kupił w tym okresie”, a każdy kupujący ma co najmniej jedno zamówienie. ZINB zakłada dwa źródła zer: klientów, którzy na pewno nie kupią, i aktywnych, którzy akurat nie kupili. W przykładzie oba modele miały prawie to samo AIC (6438.9 i 6439.0), więc o wyborze zdecydowało znaczenie zera, a nie kryterium.
Czy dużo zer zawsze oznacza model z nadmiarem zer?
Nie. Najpierw sprawdź, ile zer przewiduje zwykła regresja ujemna dwumianowa, i obejrzyj cały rozkład na rootogramie. W przykładzie NB przewidział 1092 zera przy 1139 obserwowanych, ale przeszacował liczbę klientów z jednym zamówieniem (305.4 wobec 181) – dopiero to przesądziło o modelu dwuczęściowym.
Jak odczytać wpływ karty lojalnościowej z dwóch części modelu hurdle?
Część zerowa (regresja logistyczna) mówi, czy karta zmienia szanse złożenia choć jednego zamówienia – w przykładzie OR = 3.52. Część zliczeń mówi, czy zmienia liczbę zamówień u kupujących – tu IRR = 0.98, czyli nie. Efekt dla całej bazy klientów policz z obu części naraz, np. jako średnie przewidywania przy karcie u wszystkich i u nikogo.
Co to są wagi Akaikego i jak je czytać?
To różnice AIC przeliczone na liczby od 0 do 1, sumujące się do 1 w porównywanym zestawie modeli. Czyta się je jako warunkowe prawdopodobieństwo, że dany model jest najlepszy w tym zestawie (Wagenmakers i Farrell, 2004). Wagi .51 i .49 oznaczają remis, a nie przewagę pierwszego modelu.
Po co offset w modelu liczby zakupów?
Gdy klienci byli obserwowani przez różny czas, np. konto założono w trakcie roku, offset log(czasu) sprawia, że model opisuje zakupy na jednostkę czasu. Bez niego staż konta miesza się z innymi efektami: w przykładzie iloraz szans dla karty wzrósł z 3.52 do 3.73, a AIC pogorszyło się o ponad 150 punktów.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikRegresja Poissona – wizualizacja
Zliczenia a prosta, krzywa w skali logarytmu, nadmierna dyspersja w 1000 badaniach i IRR na osi logarytmicznej – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikWartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →PoradnikPromocje w sieci sklepów: model mieszany
Efekt promocji w 40 sklepach: fałszywe alarmy testu t, losowe nachylenie w lme4, wykres gąsienicowy i wielkość miasta z kodem R.
Czytaj →PoradnikPrawo podwójnego zagrożenia
Osiem marek makaronu w panelu 3000 gospodarstw: penetracja i częstość, NBD, model Dirichleta ręcznie, marki niszowe i „na zmianę” – z kodem R.
Czytaj →PoradnikAbsencja chorobowa: model zliczeń i wskaźnik Bradforda
Zakład opakowań, 650 osób: ujemny dwumianowy z offsetem, efekt poniedziałku, wydziały z korektą i pułapki wskaźnika Bradforda.
Czytaj →Analizujesz liczbę zakupów albo wizyt w pracy z marketingu?
Pomożemy dobrać model dla zliczeń z wieloma zerami, porównać go z alternatywami, zinterpretować obie części modelu i opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Atkins, D. C., Baldwin, S. A., Zheng, C., Gallop, R. J., & Neighbors, C. (2013). A tutorial on count regression and zero-altered count models for longitudinal substance use data. Psychology of Addictive Behaviors, 27(1), 166–177. https://doi.org/10.1037/a0029508 ● Otwarty dostęp: pełny tekst
- Kleiber, C., & Zeileis, A. (2016). Visualizing count data regressions using rootograms. The American Statistician, 70(3), 296–303. https://doi.org/10.1080/00031305.2016.1173590 ● Otwarty dostęp: pełny tekst
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- Mullahy, J. (1986). Specification and testing of some modified count data models. Journal of Econometrics, 33(3), 341–365. https://doi.org/10.1016/0304-4076(86)90002-3 ● Otwarty dostęp
- Wagenmakers, E.-J., & Farrell, S. (2004). AIC model selection using Akaike weights. Psychonomic Bulletin & Review, 11(1), 192–196. https://doi.org/10.3758/bf03206482 ● Otwarty dostęp
- Wilson, P. (2015). The misuse of the Vuong test for non-nested models to test for zero-inflation. Economics Letters, 127, 51–53. https://doi.org/10.1016/j.econlet.2014.12.029 ● Otwarty dostęp: pełny tekst
- Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{atkins2013tutorial, author={Atkins, David C. and Baldwin, Scott A. and Zheng, Cheng and Gallop, Robert J. and Neighbors, Clayton}, title={{A tutorial on count regression and zero-altered count models for longitudinal substance use data}}, journal={Psychology of Addictive Behaviors}, year={2013}, volume={27}, number={1}, pages={166--177}, doi={10.1037/a0029508}}@article{kleiber2016visualizing, author={Kleiber, Christian and Zeileis, Achim}, title={{Visualizing count data regressions using rootograms}}, journal={The American Statistician}, year={2016}, volume={70}, number={3}, pages={296--303}, doi={10.1080/00031305.2016.1173590}}@article{lambert1992zero, author={Lambert, Diane}, title={{Zero-inflated Poisson regression, with an application to defects in manufacturing}}, journal={Technometrics}, year={1992}, volume={34}, number={1}, pages={1--14}, doi={10.2307/1269547}}@article{mullahy1986specification, author={Mullahy, John}, title={{Specification and testing of some modified count data models}}, journal={Journal of Econometrics}, year={1986}, volume={33}, number={3}, pages={341--365}, doi={10.1016/0304-4076(86)90002-3}}@article{wagenmakers2004aic, author={Wagenmakers, Eric-Jan and Farrell, Simon}, title={{AIC model selection using Akaike weights}}, journal={Psychonomic Bulletin \& Review}, year={2004}, volume={11}, number={1}, pages={192--196}, doi={10.3758/bf03206482}}@article{wilson2015misuse, author={Wilson, Paul}, title={{The misuse of the Vuong test for non-nested models to test for zero-inflation}}, journal={Economics Letters}, year={2015}, volume={127}, pages={51--53}, doi={10.1016/j.econlet.2014.12.029}}@article{zeileis2008regression, author={Zeileis, Achim and Kleiber, Christian and Jackman, Simon}, title={{Regression models for count data in R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={8}, pages={1--25}, doi={10.18637/jss.v027.i08}}