Co to jest AICc i wagi Akaikego?
AICc (ang. corrected Akaike information criterion) to kryterium AIC z poprawką na małą próbę: AICc = AIC + 2k(k + 1)/(n − k − 1), gdzie k to liczba szacowanych parametrów (z wyrazem wolnym i wariancją reszt), a n – liczebność próby. Hurvich i Tsai (1989) wyprowadzili tę poprawkę obciążenia dla modeli regresji i autoregresji szeregów czasowych, szczególnie przydatną, gdy liczba parametrów stanowi sporą część n. Przy dużym n poprawka znika i AICc praktycznie równa się AIC. Same wzory AIC i BIC omawiają hasła AIC i BIC w regresji oraz AIC i BIC w SEM.
Wagi Akaikego (ang. Akaike weights) zamieniają różnice Δi = AICci − AICcmin na liczby sumujące się do 1: wi = exp(−Δi/2) / Σ exp(−Δj/2). Wagenmakers i Farrell (2004) pokazują, że można je czytać jako warunkowe prawdopodobieństwa modeli w porównywanym zestawie.
Przykład
W symulowanych danych 18 osób (prawdziwy model: y zależy od x1 i x2) porównano cztery modele regresji liniowej z jednym do czterech predyktorów. Zwykłe AIC wskazało model z trzema predyktorami (AIC = 46.77, waga .52). Po poprawce kolejność się zmieniła: najniższe AICc miał model z x1 i x2 (AICc = 51.49, waga .41), tuż przed modelem z trzema predyktorami (ΔAICc = 0.29, waga .35). Przy n = 18 poprawka dla modelu z pięcioma parametrami wyniosła 5.00, a z sześcioma – 7.64. Iloraz wag 1.15 oznacza, że dane tylko nieznacznie bardziej wspierają model prostszy.
Na rysunku
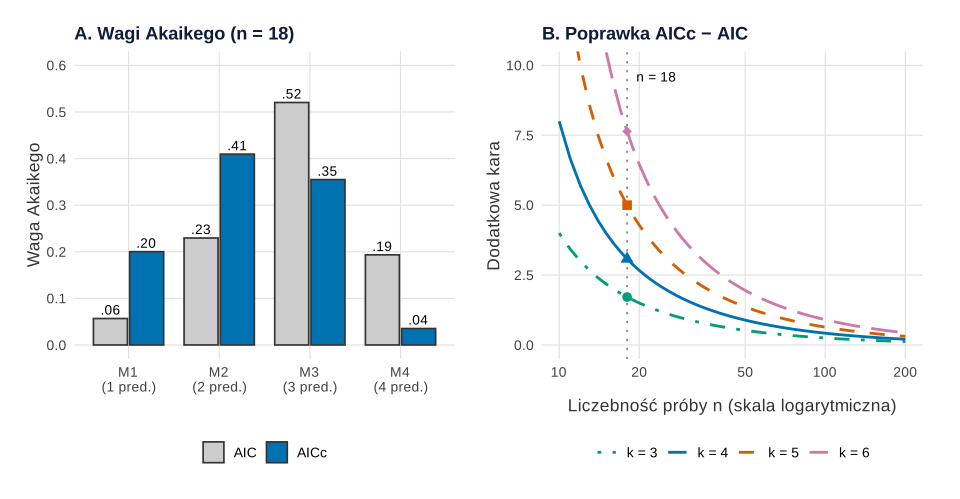
set.seed(31)).Co widać. Panel A to te same cztery modele co w przykładzie. Według AIC największą wagę ma model z trzema predyktorami (.52), według AICc – model z x1 i x2 (.41), a model z trzema predyktorami spada do .35. Najwięcej traci model z czterema predyktorami: jego waga maleje z .19 do .04. Panel B wyjaśnia dlaczego: dodatkowa kara AICc − AIC przy n = 18 wynosi 1.71, 3.08, 5.00 i 7.64 dla k = 3, 4, 5 i 6 parametrów, a przy n = 100 tylko od 0.25 do 0.90. Kara rośnie z k szybciej niż liniowo i maleje z n, więc w małej próbie AICc karze duże modele znacznie mocniej niż AIC.
Na co uważać. Wagi sumują się do 1 tylko w obrębie porównywanego zestawu – piąty kandydat zmieniłby wszystkie słupki. Wysoka waga nie znaczy, że model dobrze opisuje dane; mówi tylko, że jest najlepszy spośród tych czterech. Różnica .41 vs .35 to praktycznie remis, a w innej próbie 18 osób kolejność mogłaby się odwrócić – rysunek pokazuje jedną próbę, nie zmienność wag. Panel B nie zależy od danych, tylko od wzoru, i zakłada, że k obejmuje wyraz wolny i wariancję reszt. Porównanie AIC z silniej karzącym BIC pokazuje hasło AIC i BIC w regresji.
Podpis do pracy:
Ziarno set.seed(31) to ziarno danych z przykładu; nie było zmieniane. Panel B nie losuje – to wartości wzoru. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Wagi Akaikego według AIC i AICc (A) oraz poprawka AICc w funkcji n (B)
library(ggplot2)
library(patchwork)

motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold", size = 12))

# A: te same dane i modele co w przykładzie (n = 18, prawdziwy model y ~ x1 + x2)
set.seed(31)
n <- 18
d <- data.frame(x1 = rnorm(n), x2 = rnorm(n), x3 = rnorm(n), x4 = rnorm(n))
d$y <- 0.6 * d$x1 + 0.3 * d$x2 + rnorm(n)
modele <- list(M1 = lm(y ~ x1, d), M2 = lm(y ~ x1 + x2, d),
               M3 = lm(y ~ x1 + x2 + x3, d), M4 = lm(y ~ x1 + x2 + x3 + x4, d))
k    <- sapply(modele, function(m) attr(logLik(m), "df"))
aic  <- sapply(modele, AIC)
aicc <- aic + 2 * k * (k + 1) / (n - k - 1)
wagi <- function(ic) { delta <- ic - min(ic); exp(-delta / 2) / sum(exp(-delta / 2)) }
dA <- data.frame(model = rep(paste0(names(modele), "\n(", 0:3 + 1, " pred.)"), 2),
                 kryterium = rep(c("AIC", "AICc"), each = 4), waga = c(wagi(aic), wagi(aicc)))
print(data.frame(dA[, 2:3], model = names(modele)), digits = 2, row.names = FALSE)

pA <- ggplot(dA, aes(model, waga, fill = kryterium)) +
  geom_col(position = position_dodge(0.8), width = 0.75, colour = "grey20") +
  geom_text(aes(label = sub("^0\\.", ".", sprintf("%.2f", waga))), position = position_dodge(0.8),
            vjust = -0.4, size = 3.6) +
  scale_fill_manual(NULL, values = c(AIC = "grey80", AICc = "#0072B2")) +
  scale_y_continuous(limits = c(0, 0.6), breaks = seq(0, 0.6, 0.1)) +
  labs(title = "A. Wagi Akaikego (n = 18)", x = NULL, y = "Waga Akaikego") + motyw

# B: poprawka AICc − AIC = 2k(k + 1)/(n − k − 1) dla k = 3–6 parametrów
dB <- expand.grid(n = 10:200, k = 3:6)
dB <- subset(dB, n - dB$k - 1 > 0)
dB$kara <- 2 * dB$k * (dB$k + 1) / (dB$n - dB$k - 1)
dB$k <- factor(paste("k =", dB$k))
przy18 <- subset(dB, n == 18)
print(data.frame(k = przy18$k, poprawka_n18 = round(przy18$kara, 2),
                 poprawka_n100 = round(subset(dB, n == 100)$kara, 2)), row.names = FALSE)
pB <- ggplot(dB, aes(n, kara, colour = k, linetype = k)) +
  geom_vline(xintercept = 18, colour = "grey50", linetype = "dotted") +
  geom_line(linewidth = 1) +
  geom_point(data = przy18, aes(shape = k), size = 3, show.legend = FALSE) +
  annotate("text", x = 19.5, y = 9.6, label = "n = 18", hjust = 0, size = 3.6) +
  scale_colour_manual(NULL, values = c("#009E73", "#0072B2", "#D55E00", "#CC79A7")) +
  scale_linetype_manual(NULL, values = c("dotdash", "solid", "dashed", "longdash")) +
  scale_shape_manual(values = c(16, 17, 15, 18)) +
  scale_x_log10(breaks = c(10, 20, 50, 100, 200)) +
  coord_cartesian(ylim = c(0, 10)) +
  labs(title = "B. Poprawka AICc − AIC", x = "Liczebność próby n (skala logarytmiczna)",
       y = "Dodatkowa kara") + motyw

p1 <- pA + pB
p1   # zapis: ggsave("aicc-wagi-akaikego-wagi-i-poprawka.svg", p1, width = 10, height = 5.2)
Wynik w R (rysunek 1)
 kryterium  waga model
       AIC 0.057    M1
       AIC 0.230    M2
       AIC 0.520    M3
       AIC 0.193    M4
      AICc 0.200    M1
      AICc 0.409    M2
      AICc 0.355    M3
      AICc 0.035    M4
     k poprawka_n18 poprawka_n100
 k = 3         1.71          0.25
 k = 4         3.08          0.42
 k = 5         5.00          0.64
 k = 6         7.64          0.90
Jak opisać w pracy
Na co uważać
- k to wszystkie parametry. Funkcja
logLik()dlalm()dolicza wariancję reszt; pominięcie jej zaniża poprawkę. - Waga nie mówi, że model jest prawdziwy. Odnosi się tylko do zestawu porównywanych modeli – dodanie nowego kandydata zmienia wszystkie wagi.
- Bez wyraźnego zwycięzcy lepiej uśredniać modele niż ogłaszać jeden wynik; Burnham i Anderson (2004) omawiają takie wnioskowanie wielomodelowe.
- Kryterium nie chroni przed przeuczeniem, gdy kandydatów jest wielu, np. w metodzie krokowej. Liczbę predyktorów planuj z góry (zob. ile predyktorów w regresji).
AICc i wagi Akaikego w R
Kod dopasowuje cztery modele lm(), liczy AICc ręcznie z AIC() i logLik(), a następnie wagi Akaikego i sprawdza wynik funkcją AICcmodavg::aictab(). Liczby w tekście pochodzą z tego kodu.
AIC, AICc, różnice i wagi dla czterech modeli
R
set.seed(31)                                        # dane symulowane: n = 18, prawdziwy model y ~ x1 + x2
n <- 18
d <- data.frame(x1 = rnorm(n), x2 = rnorm(n), x3 = rnorm(n), x4 = rnorm(n))
d$y <- 0.6 * d$x1 + 0.3 * d$x2 + rnorm(n)
modele <- list(M1 = lm(y ~ x1, d), M2 = lm(y ~ x1 + x2, d),
               M3 = lm(y ~ x1 + x2 + x3, d), M4 = lm(y ~ x1 + x2 + x3 + x4, d))
k    <- sapply(modele, function(m) attr(logLik(m), "df"))   # parametry z wariancją reszt
aic  <- sapply(modele, AIC)
aicc <- aic + 2 * k * (k + 1) / (n - k - 1)                 # poprawka Hurvicha i Tsaia
wagi <- function(ic) { delta <- ic - min(ic); exp(-delta / 2) / sum(exp(-delta / 2)) }
tab <- data.frame(k, AIC = aic, dAIC = aic - min(aic), w_AIC = wagi(aic),
                  AICc = aicc, dAICc = aicc - min(aicc), w_AICc = wagi(aicc))
print(round(tab, 3))
round(c(kara_M3 = 2 * 5 * 6 / (n - 5 - 1), kara_M4 = 2 * 6 * 7 / (n - 6 - 1),
        iloraz_wag_M2_M3 = tab["M2", "w_AICc"] / tab["M3", "w_AICc"]), 3)
suppressPackageStartupMessages(library(AICcmodavg))
print(aictab(modele), digits = 3)                    # ten sam ranking z pakietu AICcmodavg
Wynik w R
   k    AIC  dAIC w_AIC   AICc dAICc w_AICc
M1 3 51.205 4.430 0.057 52.919 1.431  0.200
M2 4 48.411 1.637 0.230 51.488 0.000  0.409
M3 5 46.774 0.000 0.520 51.774 0.286  0.355
M4 6 48.754 1.980 0.193 56.390 4.902  0.035
         kara_M3          kara_M4 iloraz_wag_M2_M3
           5.000            7.636            1.154

Model selection based on AICc:

   K   AICc Delta_AICc AICcWt Cum.Wt      LL
M2 4 51.488      0.000  0.409  0.409 -20.206
M3 5 51.774      0.286  0.355  0.764 -18.387
M1 3 52.919      1.431  0.200  0.965 -22.602
M4 6 56.390      4.902  0.035  1.000 -18.377
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet AICcmodavg 2.3.4). Rysunek 1 wykonano w pakiecie ggplot2 4.0.2, a panele złożono pakietem patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- AICcmodavg (wersja 2.3.4): Mazerolle, M. J. (2023). AICcmodavg: Model selection and multimodel inference based on (Q)AIC(c) (R package version 2.3.4) [Computer software]. https://CRAN.R-project.org/package=AICcmodavg
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy używać AICc zamiast zwykłego AIC?
Gdy próba jest mała względem liczby parametrów modelu. Przy dużym n poprawka jest bliska zera, więc AICc i AIC dają praktycznie to samo; dlatego wielu badaczy stosuje AICc domyślnie.
Jak interpretować wagi Akaikego?
Waga .41 oznacza, że w porównywanym zestawie model ma 41% wsparcia. Iloraz wag dwóch modeli mówi, ile razy dane bardziej wspierają jeden niż drugi. Wagi dotyczą tylko modeli w zestawie.
Czy AICc można liczyć dla regresji logistycznej?
W praktyce tak – wzór stosuje się też do uogólnionych modeli liniowych. Hurvich i Tsai wyprowadzili go jednak dla regresji i autoregresji, więc w innych modelach poprawka jest przybliżeniem.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Burnham, K. P., & Anderson, D. R. (2004). Multimodel inference: Understanding AIC and BIC in model selection. Sociological Methods & Research, 33(2), 261–304. https://doi.org/10.1177/0049124104268644
- Hurvich, C. M., & Tsai, C.-L. (1989). Regression and time series model selection in small samples. Biometrika, 76(2), 297–307. https://doi.org/10.1093/biomet/76.2.297
- Wagenmakers, E.-J., & Farrell, S. (2004). AIC model selection using Akaike weights. Psychonomic Bulletin & Review, 11(1), 192–196. https://doi.org/10.3758/bf03206482 ● Otwarty dostęp
Cytowania BibTeX
@article{burnham2004multimodel, author={Burnham, Kenneth P. and Anderson, David R.}, title={{Multimodel inference: Understanding AIC and BIC in model selection}}, journal={Sociological Methods \& Research}, year={2004}, volume={33}, number={2}, pages={261--304}, doi={10.1177/0049124104268644}}@article{hurvich1989regression, author={Hurvich, Clifford M. and Tsai, Chih-Ling}, title={{Regression and time series model selection in small samples}}, journal={Biometrika}, year={1989}, volume={76}, number={2}, pages={297--307}, doi={10.1093/biomet/76.2.297}}@article{wagenmakers2004aic, author={Wagenmakers, Eric-Jan and Farrell, Simon}, title={{AIC model selection using Akaike weights}}, journal={Psychonomic Bulletin \& Review}, year={2004}, volume={11}, number={1}, pages={192--196}, doi={10.3758/bf03206482}}