Przykład: osiem marek makaronu w panelu 3000 gospodarstw
Fikcyjna marka makaronu Semolin ma 8.0% udziału w zakupach. Jej klienci kupują ją rzadziej niż klienci lidera, więc dział marketingu chce programu lojalnościowego. Analityk najpierw sprawdza dane z panelu konsumenckiego: 3000 gospodarstw domowych, 52 tygodnie, każdy zakup makaronu zapisany z marką. Na półce jest 8 marek (wszystkie nazwy zmyślone): Pastovia, Durello, Kłosiak, Rigatka, Semolin, Fusetta, Tagliora i Bezglutka. Pytanie brzmi: czy mała marka ma problem z lojalnością, czy po prostu z liczbą klientów?
Z panelu liczymy dwie miary każdej marki. Penetracja (b) to odsetek gospodarstw, które kupiły markę co najmniej raz w roku. Częstość zakupu (w) to średnia liczba zakupów marki na jednego jej nabywcę. Udział w zakupach jest iloczynem obu: więcej nabywców albo częstsze zakupy. Makaron kupiło 2875 z 3000 gospodarstw, łącznie 38839 razy, średnio 12.95 zakupu na gospodarstwo.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy mechanizm: tempo zakupów makaronu różni się między gospodarstwami (rozkład gamma o kształcie 1.3 i średniej 13 zakupów w roku), a preferencje marek – według rozkładu Dirichleta z parametrem S = 1.1. Ukryliśmy dwa odstępstwa. Bezglutkę kupuje głównie 2.5% gospodarstw na diecie bezglutenowej (85% ich zakupów). Tagliorę każde gospodarstwo wybiera czasem „dla odmiany” – ze stałym prawdopodobieństwem 2% na zakup. Po pierwszym uruchomieniu zmieniliśmy parametry Tagliory (stałe prawdopodobieństwo z 5% na 2%, jej udział w części „dirichletowej” z 1.5% na 4%, a Pastovii z 34% na 31.5%), bo Tagliora miała penetrację 43.9% przy udziale 6.2% – odchylenie nierealnie duże. Ziarna 671 nie zmienialiśmy. Dane pobierzesz jako prawo-podwojnego-zagrozenia-panel.csv (wiersz = gospodarstwo, kolumny = liczba zakupów każdej marki).
Rysunek 1: mniej nabywców i rzadsze zakupy
Ehrenberg i in. (1990) opisali regułę: mała marka ma w danym okresie znacznie mniej nabywców niż duża, a jej nabywcy kupują ją rzadziej. To zjawisko nazywa się podwójnym zagrożeniem (ang. double jeopardy).
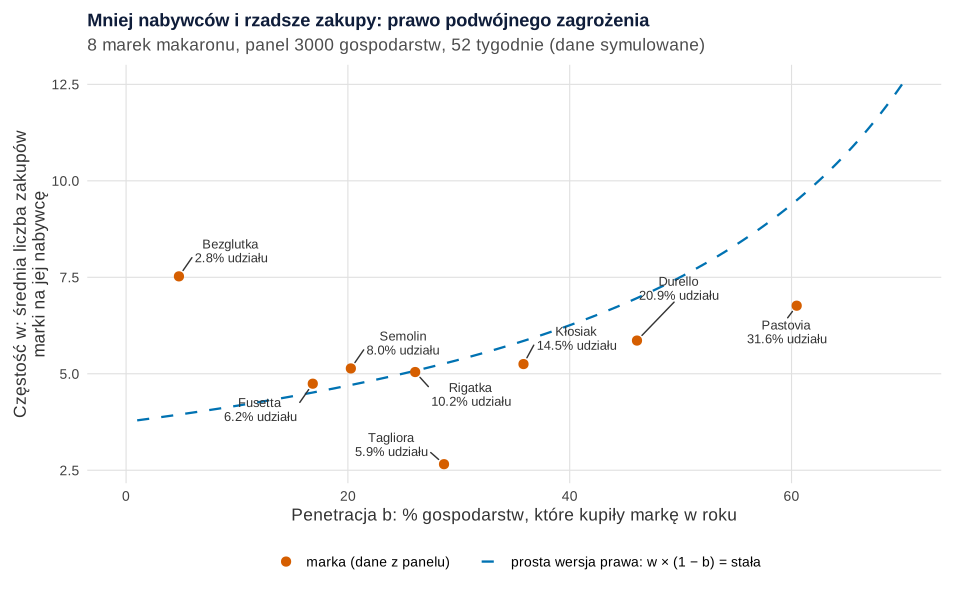
set.seed(671)).Co widać. Sześć marek układa się w rosnący szereg. Pastovia (31.6% udziału) ma 60.5% nabywców i 6.76 zakupu na nabywcę, Fusetta (6.2%) – 16.8% nabywców i 4.74 zakupu. Przerywana linia to najprostsza wersja prawa: w × (1 − b) jest w przybliżeniu stałe (tu średnio 3.76), czyli częstość rośnie dopiero przy dużej penetracji.
Jak może zmylić. Dwie marki wyłamują się z szeregu: Bezglutka ma mało nabywców, ale kupują ją często (7.52 razy), a Tagliora ma dużo nabywców, którzy kupują ją rzadko (2.66 razy). Przez nie korelacja penetracji i częstości wśród ośmiu marek wynosi tylko r = .06 – licząc samą korelację, prawa byś nie zauważył. Dokładniejszy punkt odniesienia daje model Dirichleta (Rysunek 3).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: ile razy gospodarstwa kupują makaron
Model marek zaczyna się od kategorii. Gdyby każde gospodarstwo kupowało makaron w tym samym tempie, liczba zakupów w roku miałaby rozkład Poissona, z wariancją równą średniej. Gospodarstwa różnią się jednak tempem zakupów. Gdy tempo zakupów pochodzi z rozkładu gamma, liczba zakupów ma rozkład ujemny dwumianowy (NBD) – ten sam, na którym opiera się regresja ujemna dwumianowa. Ehrenberg (1959) analizował właśnie dopasowanie NBD do liczby zakupów w panelach konsumenckich.
m to średnia liczba zakupów, a k mówi, jak bardzo gospodarstwa się różnią (im mniejsze, tym większe różnice). Oba parametry szacujemy metodą największej wiarygodności (optim()).
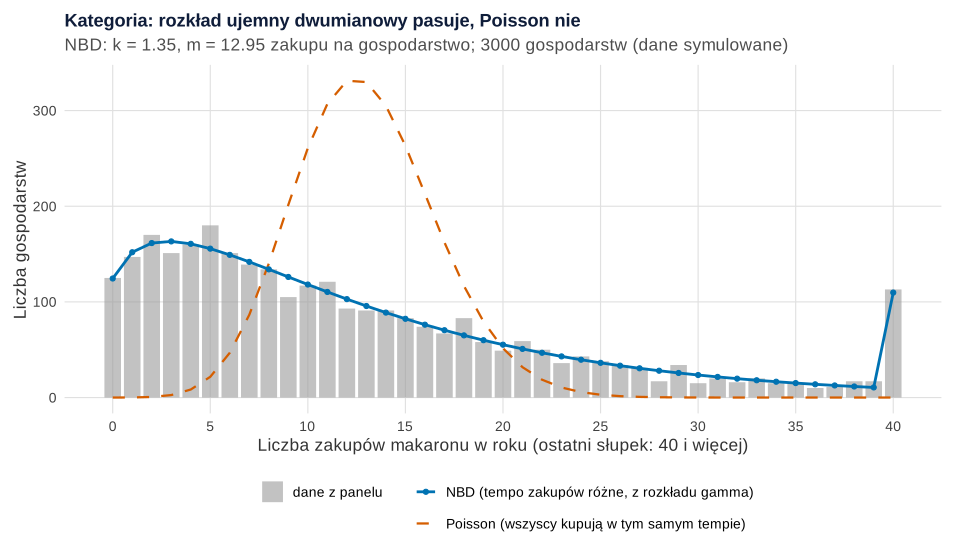
Co widać. NBD (k = 1.35, 95% CI [1.28, 1.42]; m = 12.95 [12.54, 13.37]) trafia w kształt rozkładu: przewiduje 4.1% gospodarstw bez zakupu (w danych 4.2%) i 14.2% z 25 lub więcej zakupami (w danych 14.1%). Poisson przewiduje 0.0% i 0.2%. Wariancja (136.5) jest wielokrotnie większa od średniej (12.9) – to nadmierna dyspersja. AIC wynosi 21485.2 dla NBD i 40212.9 dla Poissona.
Jak może zmylić. Model zakłada rynek stabilny w czasie (Goodhardt i in., 1984). Gdy zer jest więcej, niż przewiduje NBD, potrzebny bywa model z nadmiarem zer (zob. liczba zakupów – zliczenia z zerami).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: model Dirichleta – ile nabywców „należy się” marce
Model Dirichleta (Goodhardt i in., 1984) łączy NBD z Rysunku 2 (zakupy kategorii) z wyborem marek: każde gospodarstwo wybiera marki losowo z własnymi prawdopodobieństwami, a te prawdopodobieństwa mają rozkład Dirichleta. Na wejściu wystarczą udziały marek i dwa parametry różnorodności: k z NBD i S – jak bardzo gospodarstwa różnią się upodobaniami do marek (małe S: każdy ma „swoją” markę, duże S: wszyscy kupują podobnie).
Liczymy go ręcznie w trzech krokach. (1) S szacujemy metodą największej wiarygodności z rozkładu Dirichleta-wielomianowego. (2) Dla marki o udziale s liczba jej zakupów przy n zakupach kategorii ma rozkład beta-dwumianowy z parametrami S × s i S × (1 − s). (3) Sumujemy po n z wagami z NBD i dostajemy teoretyczną penetrację, częstość i odsetek nabywców lojalnych w 100%.
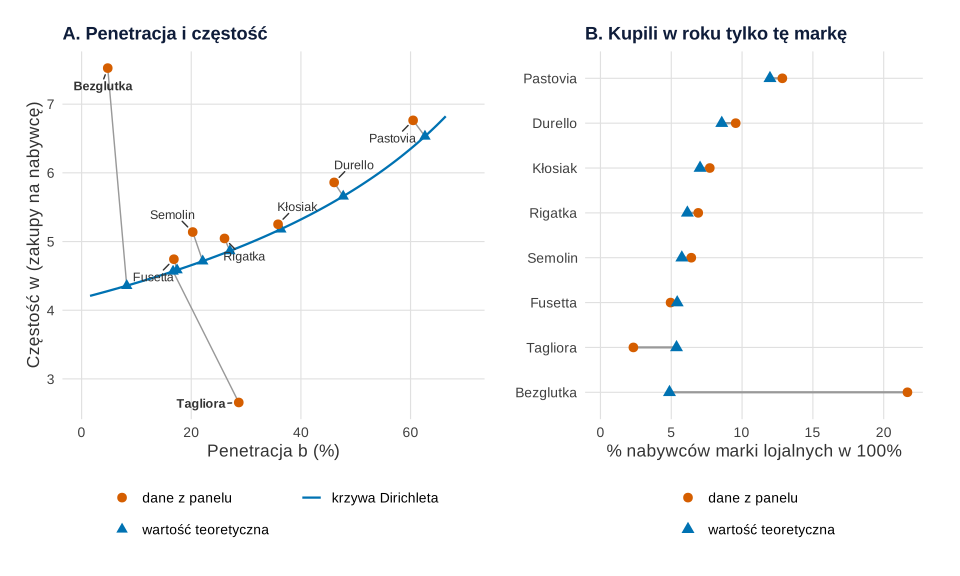
Co widać. S = 1.28. Dla sześciu zwykłych marek model myli się średnio o 1.28 punktu procentowego (pp) penetracji i 0.21 zakupu częstości – na przykład Semolin: 20.3% nabywców wobec 22.1% w modelu, 5.14 zakupu wobec 4.71. Panel B pokazuje drugą twarz podwójnego zagrożenia: klientów lojalnych w 100% jest mało i jest ich tym mniej, im mniejsza marka – 12.8% nabywców Pastovii i 6.4% nabywców Semolinu kupiło w roku wyłącznie tę markę. Mała marka nie ma więc „bardziej wiernych” klientów.
Jak może zmylić. Dwie odstające marki zawyżają S: bez nich S wynosi 1.05 (prawdziwe w części „dirichletowej” 1.1). Dlatego model lekko przecenia penetrację i nie docenia częstości wszystkich zwykłych marek. Podobny kierunek – większą lojalność dużych marek, niż przewiduje model – Fader i Schmittlein (1993) opisali w prawdziwych danych, ale tam z innego powodu (odrębnych segmentów klientów). Zanim nazwiesz małe odchylenie „przewagą lidera”, sprawdź, czy nie wywołują go inne marki w modelu.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: marki odstające – nisza czy „na zmianę”?
Kahn i in. (1988) użyli odchyleń od reguły w(1 − b) = stała do odróżniania dwóch typów małych marek. Marka niszowa ma mniej nabywców, niż „należy się” jej udziałowi, ale kupują ją częściej – obsługuje wąską grupę. Marka „na zmianę” (ang. change-of-pace) ma więcej nabywców, którzy sięgają po nią rzadko, dla odmiany. Scriven i in. (2017) dodają trzecią przyczynę: marka, której wyniki zmieniają się w czasie (rośnie albo traci), też odstaje, bo model zakłada stabilny rynek.
Panel to próba gospodarstw, więc każda liczba ma niepewność. Liczymy ją bootstrapem (Efron, 1979): 1000 razy losujemy 3000 gospodarstw ze zwracaniem i w każdej próbie liczymy od nowa miary marek, NBD, S i wartości teoretyczne. Losujemy całe gospodarstwa, bo zakupy jednego domu są powiązane (zob. bootstrap na obrazkach).
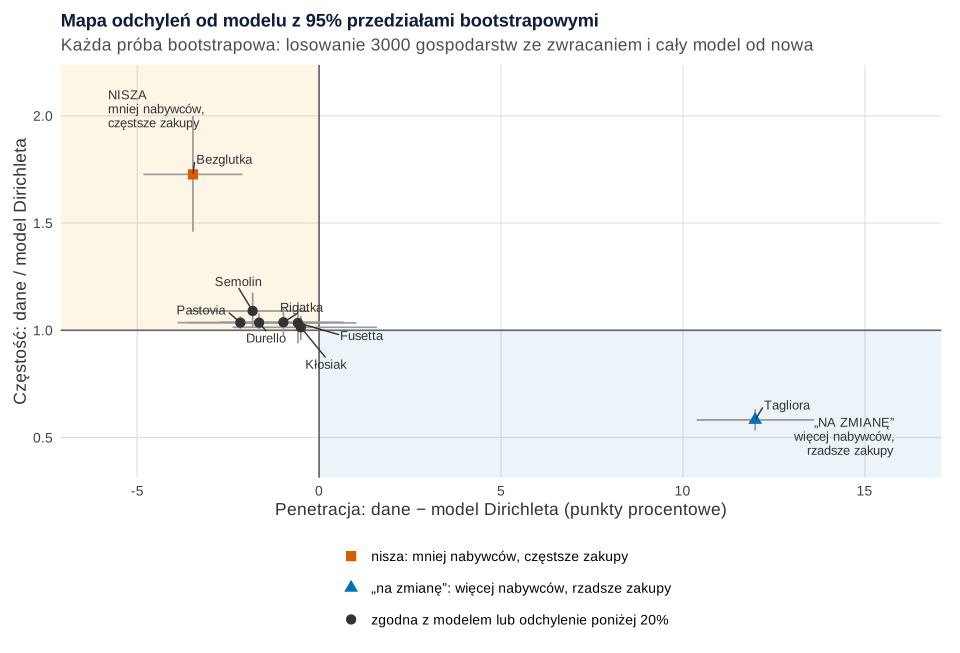
set.seed(671)).Co widać. Bezglutka ma o 3.5 pp mniej nabywców niż w modelu, 95% CI [−4.8, −2.1], i 1.73 raza wyższą częstość [1.46, 2.00]; kupiło ją wyłącznie 21.7% jej nabywców, o 16.8 pp więcej niż w modelu [10.3, 23.7]. To nisza – i rzeczywiście ukryliśmy w danych grupę gospodarstw bezglutenowych. Tagliora ma o 12.0 pp więcej nabywców [10.4, 13.6] i częstość 0.58 wartości z modelu [0.53, 0.63]: marka „na zmianę”. Pozostałe sześć marek mieści się w odchyleniu poniżej 20%. Pastovia ma częstość 1.04 raza wyższą [1.01, 1.07], a Semolin 1.09 raza [1.01, 1.18] – przedział wyklucza 1, ale różnica jest mała.
Jak może zmylić. Próg 20% ustaliliśmy ręcznie, bo przy 3000 gospodarstwach nawet drobne odchylenia bywają „istotne”. Niepewność częstości jest największa dla najmniejszej marki: szerokość przedziału to 2.54 zakupu dla Bezglutki i 0.70 dla Pastovii, bo Bezglutkę kupiło tylko 4.8% gospodarstw. Wykres nie mówi, dlaczego marka odstaje: sprawdź, kto ją kupuje (np. analizą skupień) i jak zmieniał się jej udział w kwartałach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: większa marka = więcej klientów, nie tylko wierniejszych
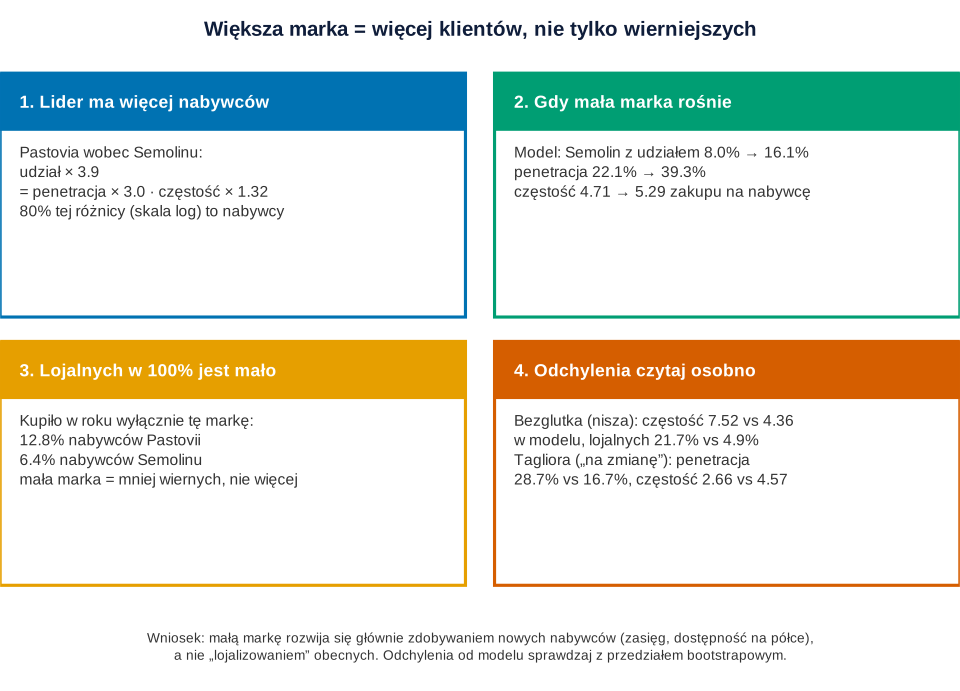
Co widać. Pastovia ma 3.93 raza większy udział niż Semolin. Rozkłada się to na 2.98 raza więcej nabywców i 1.32 raza częstsze zakupy, więc 80% różnicy udziałów (na skali logarytmu) to liczba nabywców. Model podpowiada też drogę wzrostu: gdyby Semolin podwoił udział z 8.0% do 16.1%, penetracja wzrosłaby z 22.1% do 39.3%, a częstość tylko z 4.71 do 5.29.
Jak może zmylić. Scenariusz opisuje markę o większym udziale na rynku w równowadze, a nie efekt konkretnej kampanii.
Co z tym zrobić w marketingu
- Nie lecz „niskiej lojalności” małej marki programem lojalnościowym. Częstość Semolinu (5.14) jest nawet nieco wyższa od wartości z modelu dla marki z 8% udziału (4.71). Wzrost przyjdzie głównie z nowych nabywców: zasięgu reklamy, dostępności na półce, obecności w większej liczbie sklepów. Jak ocenić, czy program w ogóle coś daje, pokazuje wpis efekt programu lojalnościowego.
- Porównuj markę z jej wartością teoretyczną, a nie z liderem.
- Odchylenie wyjaśnij, zanim je zmienisz. Niszy (Bezglutka) nie trzeba „naprawiać” – jej siłą jest wierna grupa; jej sufit wyznacza wielkość tej grupy. Marce „na zmianę” (Tagliora) można szukać okazji zakupu (nowe dania, sezon), bo nabywców już ma.
- Wskaźniki zdrowia marki czytaj przez pryzmat udziału. Przy budowie wskaźników złożonych (zob. indeks zdrowia marki) uwzględnij, że penetracja i lojalność rosną z udziałem same z siebie.
- Do prognozy aktywności pojedynczego klienta potrzebny jest inny model – BG/NBD, a do jego wartości – CLV. Model Dirichleta opisuje rynek, nie klienta. Inne zastosowania statystyki w tej dziedzinie zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj źródło danych (panel, liczba gospodarstw, okres), definicje penetracji i częstości, sposób dopasowania NBD i parametru S, liczbę prób bootstrapowych i kryterium odchylenia. W Ograniczeniach napisz, że model zakłada rynek stabilny i niesegmentowany. Wartości teoretyczne podaj w tabeli obok obserwowanych.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: panel, NBD, model Dirichleta i bootstrap
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, dane i funkcję miary(), z których korzystają kolejne. Model Dirichleta jest napisany ręcznie w bazowym R (optim(), optimize(), lgamma(), lbeta(), dnbinom()) – bez pakietów do modeli zakupowych. Przepisy z rysunkiem kończą się nazwą wykresu (p1–p5); zapis do SVG – ggsave() z komentarza. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane) i 4 (bootstrap, 1000 prób, ok. 35 s); oba zaczynają się od własnego set.seed(671). Ziarno 671 ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę gospodarstw (3000), parametry kategorii (kształt gamma 1.3, średnio 13 zakupów), S = 1.1, udziały marek w części „dirichletowej”, segment bezglutenowy (2.5% gospodarstw, 85% zakupów Bezglutki), stałe prawdopodobieństwo wyboru Tagliory (2%) i próg praktyczny odchylenia (20%). Po pierwszym uruchomieniu zmieniono tylko parametry Tagliory i Pastovii (opis w sekcji z przykładem).
1. Panel 3000 gospodarstw, miary marek i prosta wersja prawa: Rysunek 1
R
# Rysunek 1. Panel 3000 gospodarstw i 8 marek makaronu: penetracja i częstość zakupu
library(ggplot2)
library(ggrepel)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (fikcyjny rynek makaronu, rok = 52 tygodnie)
marki <- c("Pastovia", "Durello", "Kłosiak", "Rigatka", "Semolin", "Fusetta", "Tagliora", "Bezglutka")
N <- 3000                        # gospodarstwa w panelu
K <- 1.3; M <- 13                # kategoria: liczba zakupów ~ Poisson(λ), λ ~ Gamma(kształt K, średnia M)
S <- 1.1                         # rozrzut preferencji marek w części „dirichletowej”
a <- c(.315, .22, .16, .11, .08, .065, .04, .01)    # udziały w części „dirichletowej”
q_tagliora <- 0.02               # Tagliora: każdy kupuje ją z małym, stałym prawdopodobieństwem („na zmianę”)
seg_bez <- 0.025                 # Bezglutka: 2.5% gospodarstw na diecie bezglutenowej (nisza)
p_bez_seg <- 0.85                # ... które wybierają ją w 85% zakupów

rdirichlet <- function(n, alfa) {                   # losowanie z rozkładu Dirichleta przez rozkład gamma
  g <- matrix(rgamma(n * length(alfa), shape = alfa), n, byrow = TRUE)
  g / rowSums(g)
}

set.seed(671)                                       # ziarno ustalone raz, bez dobierania pod wynik
lambda <- rgamma(N, shape = K, rate = K / M)        # tempo zakupów kategorii w gospodarstwie
bezgl <- rbinom(N, 1, seg_bez) == 1                 # gospodarstwa bezglutenowe
p <- rdirichlet(N, S * a)
p[!bezgl, ] <- (1 - q_tagliora) * p[!bezgl, ]; p[!bezgl, 7] <- p[!bezgl, 7] + q_tagliora
p[bezgl, ] <- (1 - p_bez_seg) * p[bezgl, ];   p[bezgl, 8] <- p[bezgl, 8] + p_bez_seg
n_kat <- rpois(N, lambda)                           # liczba zakupów makaronu w roku
X <- t(sapply(1:N, function(h) rmultinom(1, n_kat[h], p[h, ])))
colnames(X) <- marki
panel <- data.frame(gospodarstwo = 1:N, zakupy_kategorii = n_kat, X, check.names = FALSE)
write.csv(panel, "prawo-podwojnego-zagrozenia-panel.csv", row.names = FALSE)

# Miary marek: udział w zakupach, penetracja b (% gospodarstw z co najmniej 1 zakupem marki),
# częstość w (średnia liczba zakupów marki wśród jej nabywców), % lojalnych w 100% (kupili tylko tę markę)
miary <- function(X) {
  kup <- X > 0; n <- rowSums(X)
  data.frame(marka = colnames(X), udzial = 100 * colSums(X) / sum(X), b = 100 * colMeans(kup),
             w = colSums(X) / colSums(kup),
             tylko = 100 * colSums(kup & X == n) / colSums(kup), row.names = NULL)
}
obs <- miary(X)
c(gospodarstwa = N, kupujace_makaron = sum(n_kat > 0), zakupy = sum(n_kat), srednio = round(mean(n_kat), 2))
print(transform(obs, udzial = round(udzial, 1), b = round(b, 1), w = round(w, 2), tylko = round(tylko, 1)),
      row.names = FALSE)

# Najprostsza wersja prawa (Ehrenberg): w × (1 − b) ≈ stała w0, czyli w = w0 / (1 − b)
w0 <- mean(obs$w * (1 - obs$b / 100))
round(c(w0 = w0, kor_b_w = cor(obs$b, obs$w)), 3)
siatka <- data.frame(b = seq(1, 70, by = 0.5)); siatka$w <- w0 / (1 - siatka$b / 100)

p1 <- ggplot(obs, aes(b, w)) +
  geom_line(data = siatka, aes(linetype = "prosta wersja prawa: w × (1 − b) = stała"),
            colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_point(aes(shape = "marka (dane z panelu)"), colour = kol[["cynober"]], size = 3.2) +
  geom_text_repel(aes(label = sprintf("%s\n%.1f%% udziału", marka, udzial)), size = 3.4, seed = 1,
                  colour = kol[["ciemny"]], lineheight = 0.9, min.segment.length = 0, box.padding = 0.7,
                  point.padding = 0.3) +
  scale_x_continuous("Penetracja b: % gospodarstw, które kupiły markę w roku", limits = c(0, 70)) +
  scale_y_continuous("Częstość w: średnia liczba zakupów\nmarki na jej nabywcę") +
  scale_linetype_manual(NULL, values = "dashed") + scale_shape_manual(NULL, values = 16) +
  labs(title = "Mniej nabywców i rzadsze zakupy: prawo podwójnego zagrożenia",
       subtitle = "8 marek makaronu, panel 3000 gospodarstw, 52 tygodnie (dane symulowane)") +
  motyw
p1
# ggsave("pdz-penetracja-czestosc.svg", p1, width = 10, height = 6.2)
Wynik w R
    gospodarstwa kupujace_makaron           zakupy          srednio
         3000.00          2875.00         38839.00            12.95
     marka udzial    b    w tylko
  Pastovia   31.6 60.5 6.76  12.8
   Durello   20.9 46.1 5.86   9.6
   Kłosiak   14.5 35.8 5.25   7.7
   Rigatka   10.2 26.1 5.04   6.9
   Semolin    8.0 20.3 5.14   6.4
   Fusetta    6.2 16.8 4.74   5.0
  Tagliora    5.9 28.7 2.66   2.3
 Bezglutka    2.8  4.8 7.52  21.7
     w0 kor_b_w
  3.755   0.060
2. Rozkład zakupów kategorii – NBD i Poisson: Rysunek 2
R
# Rysunek 2. Ile razy gospodarstwa kupują makaron: rozkład ujemny dwumianowy (NBD) vs Poisson
# Dane wejściowe: wektor n_kat z przepisu 1 (liczba zakupów kategorii w roku, 3000 gospodarstw)
nbd_dopasuj <- function(x) {                        # metoda największej wiarygodności, parametry na skali log
  nll <- function(th) -sum(dnbinom(x, size = exp(th[1]), mu = exp(th[2]), log = TRUE))
  o <- optim(c(0, log(mean(x))), nll, hessian = TRUE)
  list(k = exp(o$par[1]), m = exp(o$par[2]), se_log = sqrt(diag(solve(o$hessian))), logL = -o$value, par = o$par)
}
nbd <- nbd_dopasuj(n_kat)
ci <- function(est, se) exp(est + c(-1, 1) * qnorm(.975) * se)
logL_pois <- sum(dpois(n_kat, mean(n_kat), log = TRUE))
round(rbind(k = c(nbd$k, ci(nbd$par[1], nbd$se_log[1])), m = c(nbd$m, ci(nbd$par[2], nbd$se_log[2]))), 2)
round(c(AIC_NBD = 2 * 2 - 2 * nbd$logL, AIC_Poisson = 2 * 1 - 2 * logL_pois,
        srednia = mean(n_kat), wariancja = var(n_kat)), 1)

# Odsetek gospodarstw z 0, 1–3 i 25+ zakupami: dane, NBD, Poisson
grupy <- function(f0, f13, f25) round(100 * c(zero = f0, od_1_do_3 = f13, od_25 = f25), 1)
rbind(dane = grupy(mean(n_kat == 0), mean(n_kat %in% 1:3), mean(n_kat >= 25)),
      NBD = grupy(dnbinom(0, size = nbd$k, mu = nbd$m), sum(dnbinom(1:3, size = nbd$k, mu = nbd$m)),
                  pnbinom(24, size = nbd$k, mu = nbd$m, lower.tail = FALSE)),
      Poisson = grupy(dpois(0, mean(n_kat)), sum(dpois(1:3, mean(n_kat))), ppois(24, mean(n_kat), lower.tail = FALSE)))

# Rozkład do rysunku: 0–39 osobno, 40+ razem
r <- 0:40
obs_r <- c(sapply(0:39, function(i) sum(n_kat == i)), sum(n_kat >= 40))
nbd_r <- N * c(dnbinom(0:39, size = nbd$k, mu = nbd$m), pnbinom(39, size = nbd$k, mu = nbd$m, lower.tail = FALSE))
poi_r <- N * c(dpois(0:39, mean(n_kat)), ppois(39, mean(n_kat), lower.tail = FALSE))
d2 <- data.frame(r, obs_r, nbd_r, poi_r)
p2 <- ggplot(d2, aes(r)) +
  geom_col(aes(y = obs_r, fill = "dane z panelu"), width = 0.85, alpha = 0.6) +
  geom_line(aes(y = poi_r, colour = "Poisson (wszyscy kupują w tym samym tempie)", linetype = "Poisson (wszyscy kupują w tym samym tempie)"),
            linewidth = 0.8) +
  geom_line(aes(y = nbd_r, colour = "NBD (tempo zakupów różne, z rozkładu gamma)", linetype = "NBD (tempo zakupów różne, z rozkładu gamma)"),
            linewidth = 1) +
  geom_point(aes(y = nbd_r, colour = "NBD (tempo zakupów różne, z rozkładu gamma)"), size = 1.4) +
  scale_fill_manual(NULL, values = kol[["szary"]]) +
  scale_colour_manual(NULL, values = c(kol[["niebieski"]], kol[["cynober"]])) +
  scale_linetype_manual(NULL, values = c("solid", "dashed")) +
  scale_x_continuous("Liczba zakupów makaronu w roku (ostatni słupek: 40 i więcej)", breaks = seq(0, 40, 5)) +
  scale_y_continuous("Liczba gospodarstw") +
  labs(title = "Kategoria: rozkład ujemny dwumianowy pasuje, Poisson nie",
       subtitle = sprintf("NBD: k = %.2f, m = %.2f zakupu na gospodarstwo; 3000 gospodarstw (dane symulowane)", nbd$k, nbd$m)) +
  guides(fill = guide_legend(order = 1), colour = guide_legend(nrow = 2, order = 2),
         linetype = guide_legend(nrow = 2, order = 2)) +
  motyw
p2
# ggsave("pdz-rozklad-nbd.svg", p2, width = 10, height = 5.8)
Wynik w R
   [,1]  [,2]  [,3]
k  1.35  1.28  1.42
m 12.95 12.54 13.37
    AIC_NBD AIC_Poisson     srednia   wariancja
    21485.2     40212.9        12.9       136.5
        zero od_1_do_3 od_25
dane     4.2      15.6  14.1
NBD      4.1      15.9  14.2
Poisson  0.0       0.1   0.2
3. Model Dirichleta – parametr S i wartości teoretyczne: Rysunek 3
R
# Rysunek 3. Model Dirichleta liczony ręcznie: wartości teoretyczne vs obserwowane
library(patchwork)
# Dane wejściowe: macierz X (gospodarstwo × marka) i obs z przepisu 1, nbd (k, m) z przepisu 2

# Krok 1. Parametr S z rozkładu Dirichleta-wielomianowego: jak bardzo gospodarstwa różnią się
# preferencjami marek. Udziały marek s_j są wejściem (jak w praktyce modelu), S szacujemy metodą NW.
dir_S <- function(X) {
  X <- X[rowSums(X) > 0, , drop = FALSE]; n <- rowSums(X); s <- colSums(X) / sum(X)
  ll <- function(S) sum(lgamma(S) - lgamma(S + n)) +
    sum(lgamma(sweep(X, 2, S * s, "+")) - matrix(lgamma(S * s), nrow(X), ncol(X), byrow = TRUE))
  optimize(ll, c(0.01, 50), maximum = TRUE)$maximum
}
S_hat <- dir_S(X)
# S ze wszystkich 8 marek i – dla porównania – z 6 marek bez Tagliory i Bezglutki
round(c(S_8_marek = S_hat, S_6_marek = dir_S(X[, !colnames(X) %in% c("Tagliora", "Bezglutka")])), 3)

# Krok 2. Wartości teoretyczne marki o udziale s: sumujemy po liczbie zakupów kategorii n (rozkład NBD),
# a wybór marki w n zakupach opisuje rozkład beta-dwumianowy z α = S × s, β = S × (1 − s)
teoria <- function(s, k, m, S, n_max = 400) {
  n <- 0:n_max; pn <- dnbinom(n, size = k, mu = m)
  t(sapply(s, function(sj) {
    al <- S * sj; be <- S * (1 - sj)
    p0 <- exp(lbeta(al, be + n) - lbeta(al, be))        # P(ani razu tej marki | n zakupów)
    pn_all <- exp(lbeta(al + n, be) - lbeta(al, be))    # P(tylko ta marka | n zakupów)
    b <- 1 - sum(pn * p0)
    c(b = 100 * b, w = m * sj / b, tylko = 100 * sum((pn * pn_all)[-1]) / b)
  }))
}
teo <- data.frame(marka = obs$marka, teoria(obs$udzial / 100, nbd$k, nbd$m, S_hat))
por <- data.frame(marka = obs$marka, udzial = round(obs$udzial, 1),
                  b_obs = round(obs$b, 1), b_teo = round(teo$b, 1),
                  w_obs = round(obs$w, 2), w_teo = round(teo$w, 2),
                  tylko_obs = round(obs$tylko, 1), tylko_teo = round(teo$tylko, 1))
print(por, row.names = FALSE)
# Średni błąd bezwzględny modelu dla 6 marek bez odchyleń (bez Tagliory i Bezglutki)
zwykle <- !obs$marka %in% c("Tagliora", "Bezglutka")
round(c(b_pp = mean(abs(obs$b - teo$b)[zwykle]), w = mean(abs(obs$w - teo$w)[zwykle])), 2)

# Scenariusz: co przewiduje model, gdy Semolin podwoi udział (z 8.0% do 16.0%)?
s_sem <- obs$udzial[obs$marka == "Semolin"] / 100
round(teoria(c(s_sem, 2 * s_sem), nbd$k, nbd$m, S_hat), 2)

# Krzywa Dirichleta: penetracja i częstość dla udziałów od 0.5% do 40%
krzywa <- data.frame(teoria(seq(0.005, 0.35, by = 0.005), nbd$k, nbd$m, S_hat))
odch <- c("Tagliora", "Bezglutka")
d3 <- merge(obs, teo, by = "marka", suffixes = c("", "_teo"))
d3$typ <- ifelse(d3$marka %in% odch, "odchylenie", "zgodna")
pA <- ggplot(d3, aes(b, w)) +
  geom_path(data = krzywa, aes(linetype = "krzywa Dirichleta"), colour = kol[["niebieski"]], linewidth = 0.8) +
  geom_segment(aes(xend = b_teo, yend = w_teo), colour = kol[["szary"]], linewidth = 0.5) +
  geom_point(aes(x = b_teo, y = w_teo, shape = "wartość teoretyczna"), colour = kol[["niebieski"]], size = 2.6) +
  geom_point(aes(shape = "dane z panelu"), colour = kol[["cynober"]], size = 3) +
  geom_text_repel(aes(label = marka, fontface = ifelse(typ == "odchylenie", "bold", "plain")), size = 3.3,
                  seed = 2, colour = kol[["ciemny"]], min.segment.length = 0, box.padding = 0.6,
                  point.padding = 0.3) +
  scale_shape_manual(NULL, values = c("dane z panelu" = 16, "wartość teoretyczna" = 17)) +
  scale_linetype_manual(NULL, values = "solid") +
  scale_x_continuous("Penetracja b (%)", limits = c(0, 70)) +
  scale_y_continuous("Częstość w (zakupy na nabywcę)") +
  labs(title = "A. Penetracja i częstość") + motyw +
  guides(shape = guide_legend(nrow = 2, order = 1), linetype = guide_legend(order = 2))
d3l <- rbind(data.frame(marka = d3$marka, rodzaj = "dane z panelu", tylko = d3$tylko),
             data.frame(marka = d3$marka, rodzaj = "wartość teoretyczna", tylko = d3$tylko_teo))
d3l$marka <- factor(d3l$marka, rev(obs$marka))
pB <- ggplot(d3l, aes(tylko, marka)) +
  geom_line(aes(group = marka), colour = kol[["szary"]], linewidth = 0.8) +
  geom_point(aes(colour = rodzaj, shape = rodzaj), size = 3) +
  scale_colour_manual(NULL, values = c(kol[["cynober"]], kol[["niebieski"]])) +
  scale_shape_manual(NULL, values = c(16, 17)) +
  scale_x_continuous("% nabywców marki lojalnych w 100%", limits = c(0, NA)) +
  labs(title = "B. Kupili w roku tylko tę markę", y = NULL) + motyw +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2))
p3 <- pA + pB + plot_layout(widths = c(1.25, 1))
p3
# ggsave("pdz-dirichlet-teoria-dane.svg", p3, width = 10, height = 6)
Wynik w R
S_8_marek S_6_marek
    1.276     1.051
     marka udzial b_obs b_teo w_obs w_teo tylko_obs tylko_teo
  Pastovia   31.6  60.5  62.6  6.76  6.53      12.8      12.0
   Durello   20.9  46.1  47.7  5.86  5.66       9.6       8.6
   Kłosiak   14.5  35.8  36.3  5.25  5.18       7.7       7.0
   Rigatka   10.2  26.1  27.0  5.04  4.86       6.9       6.1
   Semolin    8.0  20.3  22.1  5.14  4.71       6.4       5.7
   Fusetta    6.2  16.8  17.4  4.74  4.59       5.0       5.4
  Tagliora    5.9  28.7  16.7  2.66  4.57       2.3       5.4
 Bezglutka    2.8   4.8   8.2  7.52  4.36      21.7       4.9
b_pp    w
1.28 0.21
         b    w tylko
[1,] 22.09 4.71  5.75
[2,] 39.34 5.29  7.38
4. Bootstrap gospodarstw i mapa odchyleń: Rysunek 4
R
# Rysunek 4. Które marki naprawdę odstają? Bootstrap gospodarstw (1000 prób)
# Dane wejściowe: X, n_kat, miary() z przepisu 1; nbd_dopasuj() z przepisu 2; dir_S(), teoria() z przepisu 3
odchylenia <- function(X, n) {               # cały model od nowa: miary, NBD, S, wartości teoretyczne
  o <- miary(X); f <- nbd_dopasuj(n); t <- teoria(o$udzial / 100, f$k, f$m, dir_S(X))
  c(o$b, o$w, o$b - t[, "b"], o$w / t[, "w"], o$tylko - t[, "tylko"])
}
B <- 1000
set.seed(671)                                # to samo ziarno co w przepisie 1, ustalone raz
t0 <- Sys.time()
boot <- t(replicate(B, { i <- sample(N, N, replace = TRUE); odchylenia(X[i, ], n_kat[i]) }))
cat("czas:", round(as.numeric(Sys.time() - t0, units = "secs")), "s\n")
J <- length(marki)
ocena <- odchylenia(X, n_kat)
przedzial <- function(kol_od) {              # 95% przedział percentylowy dla 8 marek
  t(apply(boot[, kol_od + 0:(J - 1)], 2, quantile, c(.025, .975)))
}
wyn <- data.frame(marka = marki,
                  b = ocena[1:J], b_ci = przedzial(1),
                  w = ocena[J + 1:J], w_ci = przedzial(J + 1),
                  db = ocena[2 * J + 1:J], db_ci = przedzial(2 * J + 1),
                  rw = ocena[3 * J + 1:J], rw_ci = przedzial(3 * J + 1),
                  dt = ocena[4 * J + 1:J], dt_ci = przedzial(4 * J + 1))
names(wyn) <- gsub("\\.(2\\.5|97\\.5)\\.", "_\\1", names(wyn))
print(data.frame(marka = wyn$marka, lapply(wyn[-1], round, 2)), row.names = FALSE)
# Szerokość 95% CI penetracji (pp) i częstości – od najmniejszej do największej marki
round(rbind(b_pp = wyn$`b_ci_97.5` - wyn$`b_ci_2.5`, w = wyn$`w_ci_97.5` - wyn$`w_ci_2.5`), 2)

# Odstaje: cały 95% CI częstości co najmniej 20% od modelu (próg praktyczny, ustalony ręcznie) i penetracja w drugą stronę
wyn$typ <- ifelse(wyn$`db_ci_97.5` < 0 & wyn$`rw_ci_2.5` > 1.2, "nisza: mniej nabywców, częstsze zakupy",
                  ifelse(wyn$`db_ci_2.5` > 0 & wyn$`rw_ci_97.5` < 0.8, "„na zmianę”: więcej nabywców, rzadsze zakupy",
                         "zgodna z modelem lub odchylenie poniżej 20%"))
wyn$typ <- factor(wyn$typ, c("nisza: mniej nabywców, częstsze zakupy", "„na zmianę”: więcej nabywców, rzadsze zakupy",
                             "zgodna z modelem lub odchylenie poniżej 20%"))
print(data.frame(marka = wyn$marka, typ = wyn$typ), row.names = FALSE)
p4 <- ggplot(wyn, aes(db, rw)) +
  annotate("rect", xmin = -Inf, xmax = 0, ymin = 1, ymax = Inf, fill = kol[["pomarancz"]], alpha = 0.10) +
  annotate("rect", xmin = 0, xmax = Inf, ymin = -Inf, ymax = 1, fill = kol[["niebieski"]], alpha = 0.08) +
  annotate("text", x = -5.8, y = 2.12, label = "NISZA\nmniej nabywców,\nczęstsze zakupy", hjust = 0, vjust = 1,
           size = 3.4, colour = kol[["ciemny"]], lineheight = 0.9) +
  annotate("text", x = 15.8, y = 0.42, label = "„NA ZMIANĘ”\nwięcej nabywców,\nrzadsze zakupy", hjust = 1, vjust = 0,
           size = 3.4, colour = kol[["ciemny"]], lineheight = 0.9) +
  geom_hline(yintercept = 1, colour = "grey40") + geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = `rw_ci_2.5`, ymax = `rw_ci_97.5`), width = 0, colour = kol[["szary"]], linewidth = 0.6) +
  geom_errorbar(aes(xmin = `db_ci_2.5`, xmax = `db_ci_97.5`), orientation = "y", width = 0, colour = kol[["szary"]],
                linewidth = 0.6) +
  geom_point(aes(colour = typ, shape = typ), size = 3.2) +
  geom_text_repel(aes(label = marka), size = 3.4, seed = 3, colour = kol[["ciemny"]], min.segment.length = 0,
                  box.padding = 0.5) +
  scale_colour_manual(NULL, values = c(kol[["cynober"]], kol[["niebieski"]], kol[["ciemny"]])) +
  scale_shape_manual(NULL, values = c(15, 17, 16)) +
  scale_x_continuous("Penetracja: dane − model Dirichleta (punkty procentowe)", limits = c(-6, 16), breaks = seq(-5, 15, 5)) +
  scale_y_continuous("Częstość: dane / model Dirichleta", limits = c(0.4, 2.15)) +
  labs(title = "Mapa odchyleń od modelu z 95% przedziałami bootstrapowymi",
       subtitle = "Każda próba bootstrapowa: losowanie 3000 gospodarstw ze zwracaniem i cały model od nowa") +
  guides(colour = guide_legend(nrow = 3), shape = guide_legend(nrow = 3)) + motyw
p4
# ggsave("pdz-mapa-odchylen-bootstrap.svg", p4, width = 10, height = 6.6)
Wynik w R
czas: 33 s
     marka     b b_ci_2.5 b_ci_97.5    w w_ci_2.5 w_ci_97.5    db db_ci_2.5
  Pastovia 60.47    58.87     62.23 6.76     6.42      7.11 -2.16     -3.89
   Durello 46.07    44.37     47.90 5.86     5.52      6.22 -1.65     -3.61
   Kłosiak 35.83    34.23     37.60 5.25     4.86      5.64 -0.50     -2.38
   Rigatka 26.07    24.43     27.67 5.04     4.65      5.46 -0.98     -2.73
   Semolin 20.27    18.83     21.67 5.14     4.71      5.62 -1.83     -3.59
   Fusetta 16.83    15.47     18.07 4.74     4.25      5.25 -0.58     -2.21
  Tagliora 28.67    27.10     30.37 2.66     2.41      2.92 11.98     10.38
 Bezglutka  4.77     4.10      5.53 7.52     6.26      8.80 -3.47     -4.83
 db_ci_97.5   rw rw_ci_2.5 rw_ci_97.5    dt dt_ci_2.5 dt_ci_97.5
      -0.41 1.04      1.01       1.07  0.88     -0.46       2.41
       0.26 1.04      0.99       1.08  0.99     -0.42       2.45
       1.59 1.01      0.95       1.07  0.69     -0.80       2.33
       0.67 1.04      0.97       1.11  0.77     -0.86       2.62
      -0.27 1.09      1.01       1.18  0.67     -1.30       2.54
       1.03 1.03      0.94       1.13 -0.47     -2.21       1.54
      13.61 0.58      0.53       0.63 -3.05     -4.01      -1.92
      -2.11 1.73      1.46       2.00 16.80     10.31      23.66
     [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8]
b_pp 3.37 3.53 3.37 3.23 2.83  2.6 3.27 1.43
w    0.70 0.70 0.78 0.82 0.91  1.0 0.51 2.54
     marka                                          typ
  Pastovia  zgodna z modelem lub odchylenie poniżej 20%
   Durello  zgodna z modelem lub odchylenie poniżej 20%
   Kłosiak  zgodna z modelem lub odchylenie poniżej 20%
   Rigatka  zgodna z modelem lub odchylenie poniżej 20%
   Semolin  zgodna z modelem lub odchylenie poniżej 20%
   Fusetta  zgodna z modelem lub odchylenie poniżej 20%
  Tagliora „na zmianę”: więcej nabywców, rzadsze zakupy
 Bezglutka       nisza: mniej nabywców, częstsze zakupy
5. Karta „większa marka = więcej klientów”: Rysunek 5
R
# Rysunek 5. Karta „większa marka = więcej klientów, nie tylko wierniejszych” (liczby wstawia kod)
# Dane wejściowe: obs (przepis 1), nbd (przepis 2), teo, s_sem, teoria() i S_hat (przepis 3)
duza <- obs[obs$marka == "Pastovia", ]; mala <- obs[obs$marka == "Semolin", ]
iloraz <- c(udzial = duza$udzial / mala$udzial, b = duza$b / mala$b, w = duza$w / mala$w)
# Udział w zakupach = penetracja × częstość (× stała), więc ln(iloraz udziałów) = ln(iloraz b) + ln(iloraz w)
cz_b <- 100 * log(iloraz[["b"]]) / log(iloraz[["udzial"]])
round(c(iloraz, czesc_z_penetracji = cz_b), 2)
scen <- teoria(c(s_sem, 2 * s_sem), nbd$k, nbd$m, S_hat)
bez <- obs$marka == "Bezglutka"; tag <- obs$marka == "Tagliora"

karty <- data.frame(
  x = c(0, 5.1, 0, 5.1), y = c(4.9, 4.9, 1.6, 1.6),
  naglowek = c("1. Lider ma więcej nabywców", "2. Gdy mała marka rośnie",
               "3. Lojalnych w 100% jest mało", "4. Odchylenia czytaj osobno"),
  tresc = c(sprintf("Pastovia wobec Semolinu:\nudział × %.1f\n= penetracja × %.1f · częstość × %.2f\n%.0f%% tej różnicy (skala log) to nabywcy",
                    iloraz[["udzial"]], iloraz[["b"]], iloraz[["w"]], cz_b),
            sprintf("Model: Semolin z udziałem %.1f%% → %.1f%%\npenetracja %.1f%% → %.1f%%\nczęstość %.2f → %.2f zakupu na nabywcę",
                    100 * s_sem, 200 * s_sem, scen[1, "b"], scen[2, "b"], scen[1, "w"], scen[2, "w"]),
            sprintf("Kupiło w roku wyłącznie tę markę:\n%.1f%% nabywców Pastovii\n%.1f%% nabywców Semolinu\nmała marka = mniej wiernych, nie więcej",
                    duza$tylko, mala$tylko),
            sprintf("Bezglutka (nisza): częstość %.2f vs %.2f\nw modelu, lojalnych %.1f%% vs %.1f%%\nTagliora („na zmianę”): penetracja\n%.1f%% vs %.1f%%, częstość %.2f vs %.2f",
                    obs$w[bez], teo$w[bez], obs$tylko[bez], teo$tylko[bez], obs$b[tag], teo$b[tag], obs$w[tag], teo$w[tag])),
  kolor = c(kol[["niebieski"]], kol[["zielony"]], kol[["pomarancz"]], kol[["cynober"]]))
p5 <- ggplot(karty) +
  geom_rect(aes(xmin = x, xmax = x + 4.8, ymin = y, ymax = y + 3.0), fill = "white", colour = karty$kolor,
            linewidth = 1.1) +
  geom_rect(aes(xmin = x, xmax = x + 4.8, ymin = y + 2.3, ymax = y + 3.0), fill = karty$kolor, colour = karty$kolor) +
  geom_text(aes(x = x + 0.2, y = y + 2.65, label = naglowek), hjust = 0, colour = "white", fontface = "bold", size = 4.6) +
  geom_text(aes(x = x + 0.2, y = y + 2.1, label = tresc), hjust = 0, vjust = 1, colour = kol[["ciemny"]], size = 4.1,
            lineheight = 1.05) +
  annotate("text", x = 4.95, y = 8.45, label = "Większa marka = więcej klientów, nie tylko wierniejszych",
           fontface = "bold", size = 5.4, colour = "#0f1d3a") +
  annotate("text", x = 4.95, y = 0.85,
           label = "Wniosek: małą markę rozwija się głównie zdobywaniem nowych nabywców (zasięg, dostępność na półce),\na nie „lojalizowaniem” obecnych. Odchylenia od modelu sprawdzaj z przedziałem bootstrapowym.",
           size = 3.6, colour = kol[["ciemny"]], lineheight = 1.05) +
  coord_cartesian(xlim = c(0, 9.9), ylim = c(0.3, 8.8), expand = FALSE) +
  theme_void() + theme(plot.background = element_rect(fill = "white", colour = NA))
p5
# ggsave("pdz-karta-wieksza-marka.svg", p5, width = 10, height = 7.2)
Wynik w R
            udzial                  b                  w czesc_z_penetracji
              3.93               2.98               1.32              79.90
6. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (dane / model; nisza / „na zmianę”)" = c("#D55E00", "#0072B2"),
             "niebieski – zielony (karty 1 i 2)" = c("#0072B2", "#009E73"),
             "pomarańczowy – cynober (karty 3 i 4)" = c("#E69F00", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                        widzenie_typowe
cynober – niebieski (dane / model; nisza / „na zmianę”)           114.6
niebieski – zielony (karty 1 i 2)                                  70.1
pomarańczowy – cynober (karty 3 i 4)                               33.4
czerwony – zielony (do unikania)                                  121.7
                                                        deuteranopia protanopia
cynober – niebieski (dane / model; nisza / „na zmianę”)        108.3       91.9
niebieski – zielony (karty 1 i 2)                               55.4       58.0
pomarańczowy – cynober (karty 3 i 4)                            18.4       24.9
czerwony – zielony (do unikania)                                21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Symulację, dopasowanie NBD, model Dirichleta i bootstrap policzono w bazowym R (pakiety base i stats). Rysunki wykonano w ggplot2 (etykiety – ggrepel, złożenie paneli – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (packageVersion()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2025). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Klienci małej marki są mniej lojalni” jako diagnoza problemu – to przeważnie norma wynikająca z udziału (tu: 6.4% lojalnych w 100% przy Semolinie wobec 5.7% w modelu).
- Każde odchylenie jako sygnał – przy dużym panelu drobne różnice mają przedziały wykluczające zero (Pastovia, Semolin); ustal próg praktyczny przed analizą. Model pomija też zmiany w czasie, więc sprawdź, czy marka nie rośnie lub nie traci w trakcie roku.
- Bootstrap zakupów zamiast gospodarstw – przedziały wyszłyby za wąskie.
- Odczytywanie przyczyny z mapy – mapa wskazuje, które marki odstają, ale wyjaśnienie (nisza, „na zmianę”, wzrost) wymaga dodatkowych danych. Gdy chcesz wiedzieć, jak klienci postrzegają marki, sięgnij po mapę percepcji marek.
Najczęstsze pytania
Co to jest prawo podwójnego zagrożenia w marketingu?
To prawidłowość opisana przez Ehrenberga i współpracowników: mała marka ma w danym okresie znacznie mniej nabywców niż duża, a jej nabywcy kupują ją nieco rzadziej. Małe marki tracą więc „podwójnie”. W przykładzie lider miał 60.5% nabywców i 6.76 zakupu na nabywcę, a marka z 8.0% udziału – 20.3% nabywców i 5.14 zakupu.
Jak policzyć penetrację i częstość zakupu marki z danych panelowych?
Penetracja to odsetek gospodarstw (lub osób), które kupiły markę co najmniej raz w okresie. Częstość to łączna liczba zakupów marki podzielona przez liczbę jej nabywców. Iloczyn obu miar wyznacza sprzedaż marki, więc udział w rynku rozkłada się na „ilu kupuje” i „jak często”.
Do czego służy model Dirichleta (NBD-Dirichlet)?
Przewiduje, jaką penetrację, częstość zakupu i odsetek klientów lojalnych w 100% powinna mieć marka o danym udziale na stabilnym rynku. Potrzebuje tylko udziałów marek i dwóch parametrów: zróżnicowania tempa zakupów kategorii (rozkład ujemny dwumianowy) i zróżnicowania preferencji marek (S). Wartości teoretyczne są punktem odniesienia do oceny marki.
Czy odchylenie marki od modelu Dirichleta oznacza problem?
Nie zawsze. Mniej nabywców i częstsze zakupy wskazują zwykle markę niszową, więcej nabywców i rzadsze zakupy – markę kupowaną dla odmiany, a odchylenie może też wynikać ze zmiany udziału w czasie. Sprawdź najpierw przedział bootstrapowy i próg praktyczny, a potem przyczynę.
Jak ocenić niepewność wskaźników marki z panelu konsumenckiego?
Użyj bootstrapu gospodarstw: losuj całe gospodarstwa ze zwracaniem, w każdej próbie licz miary i model od nowa i weź percentyle 2.5 i 97.5. Losowanie pojedynczych zakupów dałoby za wąskie przedziały, bo zakupy jednego domu są zależne. Najmniej precyzyjne są miary najmniejszych marek.
Powiązane hasła
Przeczytaj też
Model BG/NBD – aktywni klienci
Sklep z przyprawami: BG/NBD napisany ręcznie w R, P(aktywny), prognoza zakupów na rok 2 i porównanie z regułą 180 dni – sześć rysunków.
Czytaj →PoradnikEfekt programu lojalnościowego
Sieć sklepów dziecięcych i program punktowy: samoselekcja, propensity score, różnica w różnicach z kohortami zapisu i symulacja – pięć rysunków z kodem R.
Czytaj →PoradnikLiczba zakupów: zliczenia z zerami
2000 kont sklepu dla zwierząt: Poisson, NB, ZINB i hurdle, rootogram, wagi Akaikego, offset i co naprawdę zmienia karta stałego klienta – z kodem R.
Czytaj →PoradnikPrzechodzenie klientów między markami
Macierz przejść z panelu 2500 gospodarstw: lojalność, odchylenia od niezależności, łańcuch Markowa, bootstrap i promocja – z kodem R.
Czytaj →Masz w pracy dane z panelu konsumenckiego?
Pomożemy policzyć penetrację i częstość zakupu marek, dopasować model Dirichleta, ocenić niepewność bootstrapem i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Ehrenberg, A. S. C. (1959). The pattern of consumer purchases. Applied Statistics, 8(1), 26–41. https://doi.org/10.2307/2985810
- Ehrenberg, A. S. C., Goodhardt, G. J., & Barwise, T. P. (1990). Double jeopardy revisited. Journal of Marketing, 54(3), 82–91. https://doi.org/10.1177/002224299005400307
- Fader, P. S., & Schmittlein, D. C. (1993). Excess behavioral loyalty for high-share brands: Deviations from the Dirichlet model for repeat purchasing. Journal of Marketing Research, 30(4), 478–493. https://doi.org/10.1177/002224379303000407
- Goodhardt, G. J., Ehrenberg, A. S. C., & Chatfield, C. (1984). The Dirichlet: A comprehensive model of buying behaviour. Journal of the Royal Statistical Society. Series A (General), 147(5), 621–655. https://doi.org/10.2307/2981696
- Kahn, B. E., Kalwani, M. U., & Morrison, D. G. (1988). Niching versus change-of-pace brands: Using purchase frequencies and penetration rates to infer brand positionings. Journal of Marketing Research, 25(4), 384–390. https://doi.org/10.1177/002224378802500406
- Scriven, J., Bound, J., & Graham, C. (2017). Making sense of common Dirichlet deviations. Australasian Marketing Journal, 25(4), 294–308. https://doi.org/10.1016/j.ausmj.2017.10.007 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{ehrenberg1959pattern, author={Ehrenberg, A. S. C.}, title={{The pattern of consumer purchases}}, journal={Applied Statistics}, year={1959}, volume={8}, number={1}, pages={26--41}, doi={10.2307/2985810}}@article{ehrenberg1990double, author={Ehrenberg, Andrew S. C. and Goodhardt, Gerald J. and Barwise, T. Patrick}, title={{Double jeopardy revisited}}, journal={Journal of Marketing}, year={1990}, volume={54}, number={3}, pages={82--91}, doi={10.1177/002224299005400307}}@article{fader1993excess, author={Fader, Peter S. and Schmittlein, David C.}, title={{Excess behavioral loyalty for high-share brands: Deviations from the Dirichlet model for repeat purchasing}}, journal={Journal of Marketing Research}, year={1993}, volume={30}, number={4}, pages={478--493}, doi={10.1177/002224379303000407}}@article{goodhardt1984dirichlet, author={Goodhardt, G. J. and Ehrenberg, A. S. C. and Chatfield, C.}, title={{The Dirichlet: A comprehensive model of buying behaviour}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1984}, volume={147}, number={5}, pages={621--655}, doi={10.2307/2981696}}@article{kahn1988niching, author={Kahn, Barbara E. and Kalwani, Manohar U. and Morrison, Donald G.}, title={{Niching versus change-of-pace brands: Using purchase frequencies and penetration rates to infer brand positionings}}, journal={Journal of Marketing Research}, year={1988}, volume={25}, number={4}, pages={384--390}, doi={10.1177/002224378802500406}}@article{scriven2017making, author={Scriven, John and Bound, John and Graham, Charles}, title={{Making sense of common Dirichlet deviations}}, journal={Australasian Marketing Journal}, year={2017}, volume={25}, number={4}, pages={294--308}, doi={10.1016/j.ausmj.2017.10.007}}