Przykład: sześć marek płatków śniadaniowych i jedno pytanie zarządu
Producent fikcyjnej marki płatków Brzask zlecił badanie marki: 1500 osób kupujących płatki do domu odpowiadało na pytania o sześć marek: Arnikę, Brzask, Chrupkę, Dziewannę, Estragon i Fiołek (wszystkie nazwy są fikcyjne). Z ankiety powstaje pięć wskaźników: świadomość (zna markę choćby ze słyszenia), rozważanie (kupiłby ją przy najbliższych zakupach), preferencja (to jego ulubiona marka), NPS wśród osób, które jadły markę w ostatnich trzech miesiącach, i akceptowana cena – ile najwyżej zapłaciłby za opakowanie 500 g (pytamy znających markę).
Zarząd chce jednej liczby: indeksu zdrowia marki i miejsca w rankingu. To wskaźnik złożony: kilka miar sprowadzonych do wspólnej skali i zsumowanych z wagami. Keller (1993) wiąże wartość marki z wiedzą konsumenta o niej, na którą składają się świadomość marki i jej wizerunek – dlatego badania marki mierzą kilka rzeczy naraz. Diamantopoulos i Winklhofer (2001) opisują budowę indeksu ze wskaźników formatywnych jako alternatywę dla skali: wskaźniki nie są wymiennymi pomiarami jednej cechy, tylko składnikami, które razem ją tworzą. Wybór wskaźników i wag jest więc częścią definicji, a nie szczegółem technicznym.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy: świadomość od 90% (Arnika) do 38% (Fiołek), szansę rozważania wśród znających od 50% do 68%, siłę marki przy wyborze ulubionej, średnią ocen polecenia (najniższą, 5.9, dla Brzasku – marka znana, ale rozczarowuje) i akceptowaną cenę od 12.0 do 15.5 zł. Pełna lista parametrów jest przy kodzie. Ziarno 683 ustalono raz; ani ziarna, ani parametrów nie zmienialiśmy po pierwszym uruchomieniu (poprawialiśmy tylko wygląd rysunków). Dane pobierzesz jako indeks-zdrowia-marki-ankieta.csv (wiersz = respondent × marka).
Rysunek 1: pięć wskaźników, pięć różnych skal
Najpierw surowe wskaźniki z 95% przedziałami ufności. Świadomość, rozważanie i preferencja to odsetki wszystkich 1500 respondentów (przedział jak dla proporcji). NPS liczymy wśród używających – od 256 osób dla Fiołka do 519 dla Arniki – a cenę wśród znających markę.
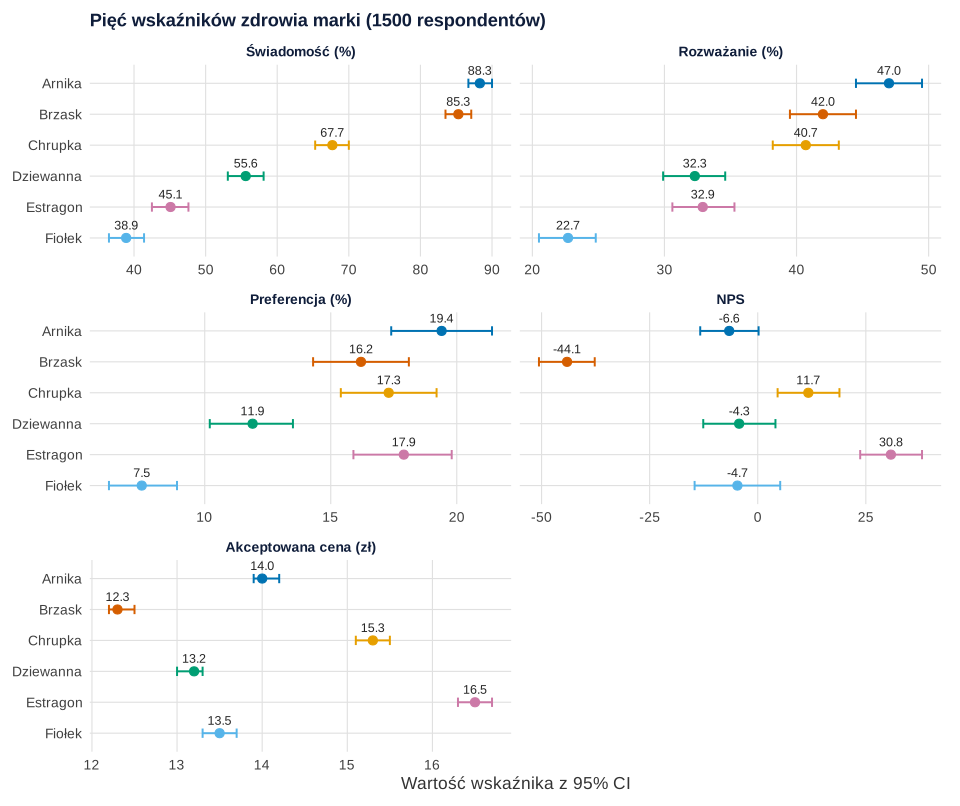
set.seed(683)).Co widać. Arnika i Brzask są najbardziej znane (88.3% i 85.3%), ale na tym podobieństwo się kończy. NPS Brzasku to −44.1, 95% CI [−50.6, −37.7]: krytyków jest 55.7%, promotorów 11.5%. Estragon zna mniej niż połowa badanych (45.1%), lecz ma on najwyższy NPS, 30.8 [23.7, 38.0], i najwyższą akceptowaną cenę, 16.5 zł. Preferencja Arniki, Estragonu i Chrupki (19.4%, 17.9%, 17.3%) mieści się w granicach błędu.
Jak może zmylić. Wskaźniki mają różne jednostki i precyzję: przedział ceny ma ok. 0.3 zł, a NPS – kilkanaście punktów. Przed sumowaniem trzeba je sprowadzić do wspólnej skali (rysunek 3). O szerokich przedziałach NPS pisze wpis o przedziale ufności i porównaniach NPS.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: trzy wskaźniki mierzą prawie to samo
Świadomość, rozważanie i preferencja to kolejne etapy lejka marki: rozważać można tylko markę, którą się zna. Dlatego są silnie skorelowane – w macierzy korelacji sześciu marek świadomość i rozważanie mają r = .93. NPS i cena tworzą drugą parę (r = .92), a ze świadomością NPS koreluje ujemnie (r = −.59). Dlaczego duże marki mają po prostu więcej klientów, pokazuje wpis o prawie podwójnego zagrożenia.
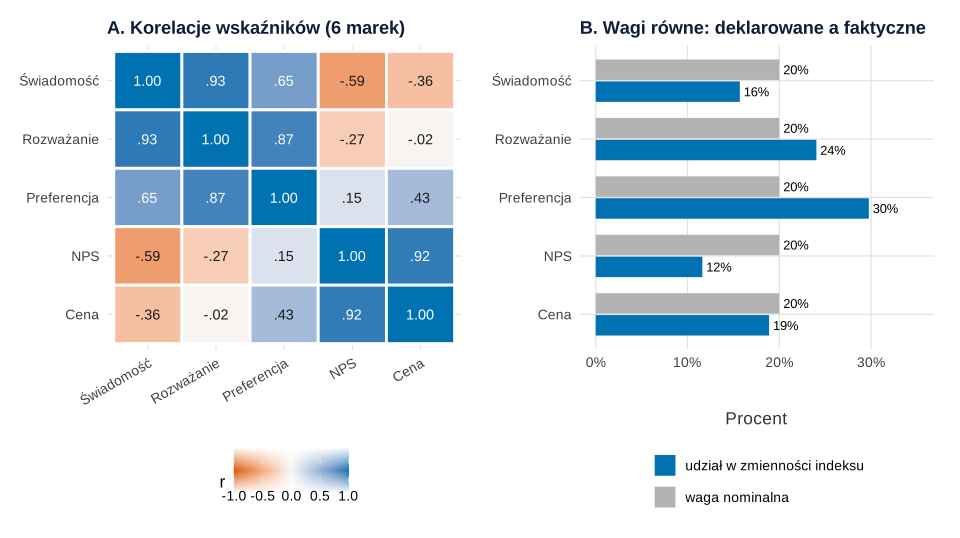
set.seed(683)).Co widać. Panel A: dwie grupy wskaźników – „zasięg” (lejek) i „jakość” (NPS i cena). PCA to potwierdza: pierwsza składowa wyjaśnia 56.0% wariancji, druga 42.3%. Panel B: przy wagach równych (po 20%) trzy wskaźniki lejka mają łącznie 60% wagi deklarowanej, ale 69.5% udziału w zmienności indeksu, a NPS – 11.6% zamiast 20%. Udział liczymy jako wj × cov(zj, I) / var(I); udziały sumują się do 100%. Paruolo i in. (2013) pokazali na znanych rankingach, że przy skorelowanych zmiennych nominalne wagi rzadko odpowiadają faktycznemu wpływowi wskaźników na indeks.
Wagi z PCA pogłębiają problem. Popularny przepis bierze kwadraty ładunków pierwszej składowej jako wagi. Tu dają one świadomości 35.4%, rozważaniu 31.3%, preferencji 16.4%, NPS 12.4% i cenie 4.4%, a faktyczny udział NPS w indeksie spada do −2.2% – indeks z wagami PCA praktycznie nie widzi zadowolenia klientów. PCA nagradza wskaźniki skorelowane z innymi, nie ważne dla marki; Jolliffe i Cadima (2016) przypominają, że składowe wynikają z danych, a nie z założonego modelu.
Jak może zmylić. Korelacja z sześciu marek jest bardzo niepewna, ale nadreprezentacja lejka wynika z konstrukcji pytań (rozważa tylko ten, kto zna).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: dziewięć wariantów indeksu, dziewięć rankingów
Indeks to I = w1s1 + … + w5s5, gdzie s to wskaźnik po standaryzacji, a w – jego waga (suma wag = 1). Porównaliśmy trzy standaryzacje: wynik z (odległość od średniej sześciu marek w odchyleniach standardowych), min–max (0 = najsłabsza marka, 100 = najlepsza) i rangi (od 1 do 6), oraz trzy schematy wag: równe, eksperckie (świadomość 15%, rozważanie 20%, preferencja 25%, NPS 25%, cena 15% – ustalone przez nas jako przykład opinii działu marketingu) i PCA. To prosta analiza wrażliwości. Saisana i in. (2005) zalecają ją już przy budowie wskaźnika złożonego.
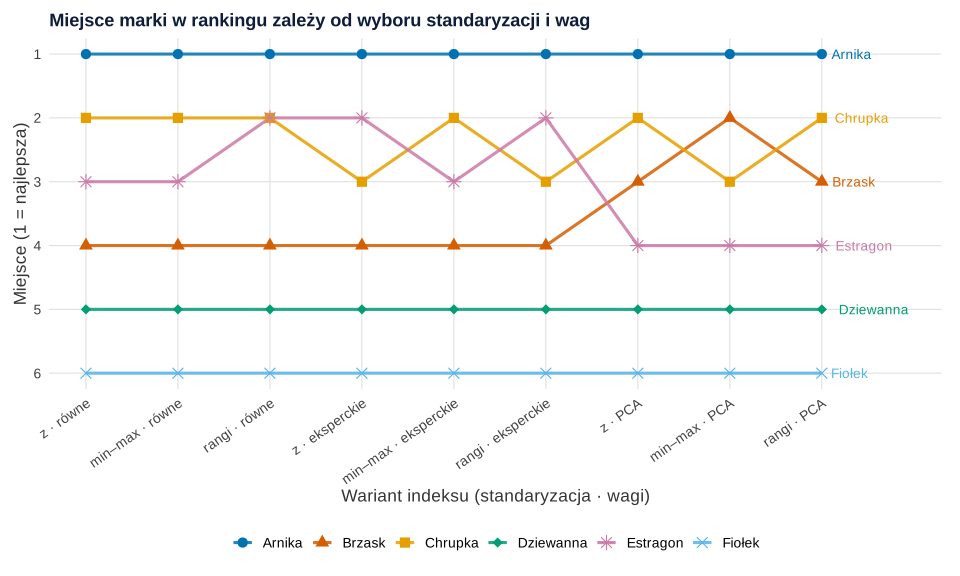
set.seed(683)).Co widać. Arnika jest pierwsza we wszystkich 9 wariantach, Dziewanna piąta, a Fiołek szósty. Środek rankingu się przestawia: Chrupka zajmuje miejsca 2–3, Estragon 2–4, a Brzask 2–4 – z wagami PCA awansuje z 4. na 3. miejsce (wynik z, rangi), a przy min–max nawet na 2. Zgodność z wariantem podstawowym (z · równe) mierzona tau Kendalla wynosi od .73 do 1.00.
Jak może zmylić. Rangi gubią odległości: NPS Brzasku −44.1 liczy się tak samo jak ostatnie miejsce „o włos”, a Chrupka i Estragon remisują (średnia ranga 4.4). Min–max zależy od marek skrajnych, a wynik z – od średniej i SD z sześciu liczb.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: jak pewne jest miejsce w rankingu
Rysunek 3 pokazuje niepewność decyzji analityka, a inne 1500 osób dałoby też trochę inne wskaźniki. Niepewność próby mierzymy bootstrapem: losujemy respondentów ze zwracaniem (całe osoby, ze wszystkimi odpowiedziami o sześciu markach), liczymy od nowa wskaźniki, standaryzację, wagi i ranking – 1000 razy. W panelu B w każdej próbie losujemy też jeden z 9 wariantów indeksu, czyli łączymy oba źródła niepewności, jak w analizie niepewności proponowanej przez Saisanę i in. (2005).
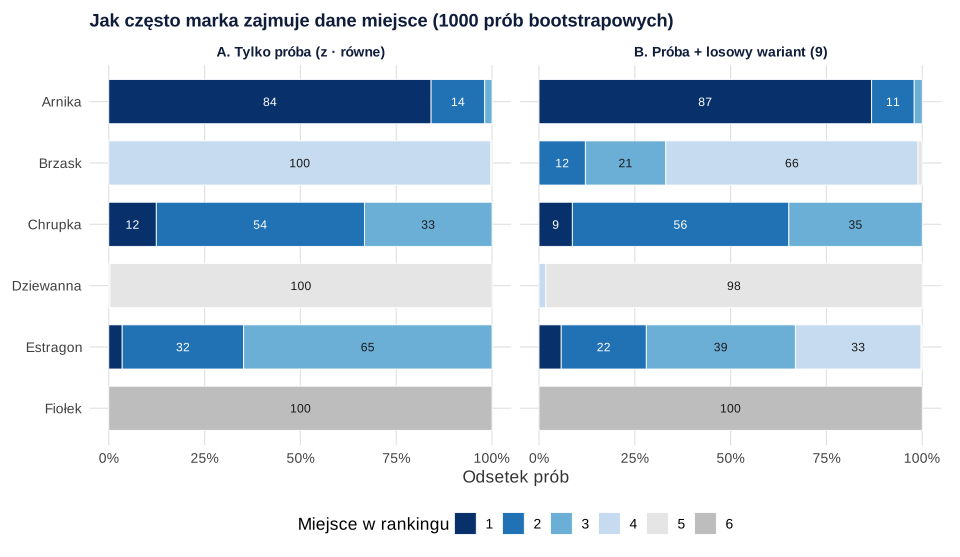
set.seed(683)).Co widać. Panel A (z · równe): Arnika jest pierwsza w 84.1% prób (błąd Monte Carlo ±1.2 pp), Chrupka w 12.4%, Estragon w 3.5%. 95% przedział miejsca to 1–2 dla Arniki oraz 1–3 dla Chrupki i Estragonu; Brzask jest czwarty w 99.7% prób. Panel B: gdy dochodzi wybór wariantu, przedział miejsca Brzasku rozszerza się do 2–4, a Estragonu do 1–4. Dziewanna i Fiołek mają pewne miejsca, ale o kolejności na miejscach 2–4 rozstrzyga w dużej mierze wybór metody, a nie dane.
Jak może zmylić. Hall i Miller (2009) pokazali, że zwykły bootstrap rang bywa niezgodny: przy pozycjach o niemal równych wynikach przedziały mają właściwy rząd wielkości, ale nie dokładną długość. Traktuj przedziały miejsc jako przybliżenie, nie dokładne 95%.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: co ukrywa indeks
Podobny indeks może oznaczać różne marki, a zły wynik jednego wskaźnika może zniknąć w średniej.
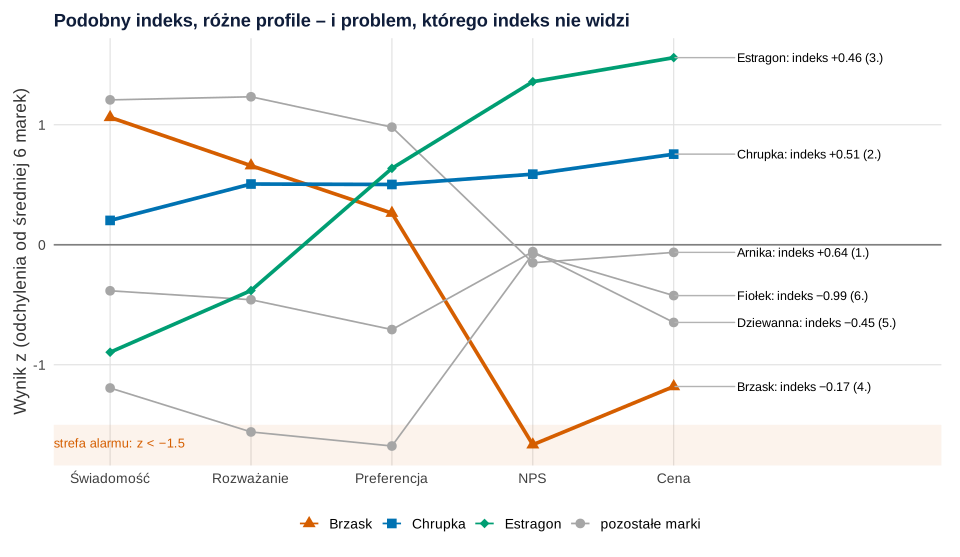
set.seed(683)).Co widać. Chrupka (+0.51) i Estragon (+0.46) mają prawie ten sam indeks. Chrupka jest „średnio dobra we wszystkim”, a Estragon to mała marka (świadomość z = −0.90) z bardzo zadowolonymi klientami (NPS z = 1.36, cena z = 1.56) – potrzebuje zasięgu, nie poprawy produktu. Brzask ma NPS w strefie alarmu (z = −1.67), a mimo to indeks −0.17 i 4. miejsce, przed Dziewanną i Fiołkiem. Test wrażliwości: gdyby NPS Brzasku spadł o kolejne 20 punktów (do −64.1), indeks zmieniłby się z −0.17 na −0.20 przy wagach równych, z −0.24 na −0.28 przy eksperckich i z 0.37 na 0.35 przy wagach PCA, a miejsce – wcale.
Jak może zmylić. Indeks prawie nie reaguje, bo standaryzacja z dopasowuje się do danych: im bardziej skrajny wynik Brzasku, tym większe SD NPS i tym mniej waży każdy punkt różnicy. Do tego słaby NPS „spłaca” wysoka świadomość – tak działa każda suma ważona; średnia geometryczna kompensuje słabiej. Greco i in. (2019) wskazują ważenie i agregację jako etapy budowy wskaźników złożonych, które budzą najwięcej krytyki.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: karta marki zamiast jednej liczby
Do raportu dla zarządu proponujemy kartę: indeks i miejsce z przedziałem (próba i wariant), a pod nimi pięć wskaźników z paskiem pozycji wśród sześciu marek i sygnałem, gdy wynik z spada poniżej −1.5 (próg ustalony przez nas, do dostosowania).
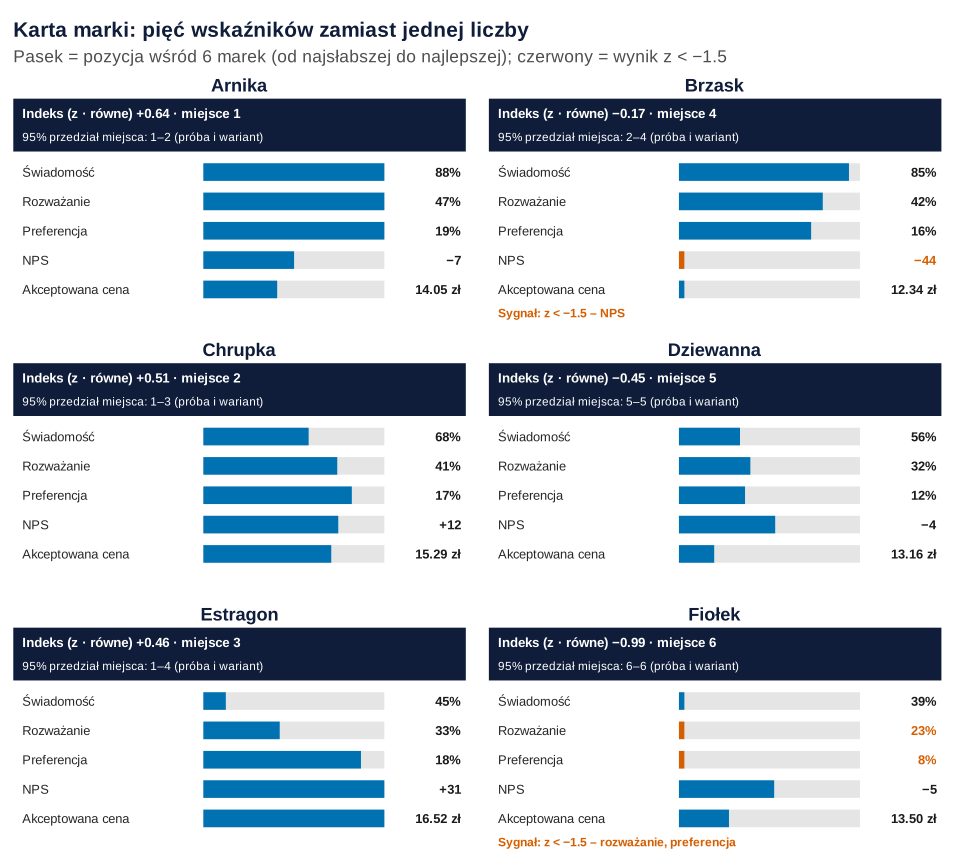
set.seed(683)).Co widać. Karta Brzasku mówi więcej niż „miejsce 4”: marka jest znana i rozważana, ale ma najniższy NPS (−44) i najniższą akceptowaną cenę (12.34 zł). Karta Fiołka sygnalizuje słabe rozważanie i preferencję przy przeciętnym NPS – problem zasięgu, nie produktu.
Jak może zmylić. Paski są względne – pełny pasek to najlepszy wynik wśród sześciu marek, a nie wynik dobry sam w sobie. Próg −1.5 jest umowny: przy sześciu markach największy możliwy wynik z to ok. 2.04 co do wartości bezwzględnej.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Raportuj indeks razem z kartą wskaźników. Indeks służy do krótkiej informacji, karta – do decyzji: Brzask potrzebuje pracy nad produktem, a nie kampanii zasięgowej; Estragon odwrotnie.
- Ustal wagi przed obejrzeniem wyników i zapisz uzasadnienie. Po fakcie łatwo wybrać wariant, w którym „nasza” marka wypada lepiej – Brzask może być czwarty albo drugi.
- Nie licz lejka trzy razy. Użyj jednego wskaźnika lejka albo daj trzem etapom łącznie tyle wagi, ile chcesz dać zasięgowi, i sprawdź ich udział w zmienności indeksu.
- Pokazuj miejsce z przedziałem. „Miejsce 2–4” jest uczciwsze niż „miejsce 4”. Zmiany między falami porównuj jak we wpisie o badaniu trackingowym marki, a skoki w rankingu czytaj z myślą o regresji do średniej w rankingu kampanii.
- Dopracuj pomiar składników. Akceptowaną cenę lepiej mierzyć metodami z wpisu o badaniu ceny; jak wydatki na reklamę wiążą się z udziałem w rynku, opisuje wpis o udziale w reklamie a udziale w rynku.
Pułapki
- Skorelowane wskaźniki – ukryta nadwaga lejka (69.5% zamiast 60%).
- Wagi z PCA jako „obiektywne” – tu NPS znika z indeksu.
- Min–max i rangi przy kilku markach – zależność od marki skrajnej, utrata odległości.
- Ranking bez przedziału miejsca.
- Indeks bez karty wskaźników – kompensacja ukrywa alarm.
- Wskaźniki z różnych podgrup – NPS liczony wśród używających małej marki ma mniejsze n i szerszy przedział.
Jak opisać w pracy
W Metodzie opisz wskaźniki (treść pytania i podstawę procentowania), sposób standaryzacji, wagi z uzasadnieniem, analizę wrażliwości i bootstrap. W Wynikach podaj tabelę wskaźników z CI, ranking z przedziałem miejsc i zakres miejsc w wariantach. Szerszy kontekst daje wpis statystyka w pracy z marketingu; porównanie marek na mapie zamiast w rankingu – wpis o mapie percepcji marek, a ranking z małej liczby ocen – wpis o ocenach gwiazdkowych i rankingu produktów.
Kod R: wskaźniki, standaryzacja, wagi, warianty, bootstrap i karta marki
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, przepis 2 – funkcję wskazniki() i macierz W, przepis 3 – funkcje standaryzuj() i wagi(), przepis 4 – warianty i miejsca, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane) i 5 (bootstrap); każdy zaczyna losowanie od własnego set.seed(683). Ziarno 683 ustalono raz i nie zmieniano go. Ręcznie ustalono: 1500 respondentów i 6 marek; świadomość (0.90, 0.86, 0.68, 0.55, 0.44, 0.38 dla marek od Arniki do Fiołka), szansę rozważania wśród znających (0.52, 0.50, 0.58, 0.56, 0.68, 0.52), siłę przy wyborze marki ulubionej (1.0, 0.9, 1.2, 1.0, 1.5, 0.9), średnią ocen polecenia 0–10 wśród używających (7.0, 5.9, 7.6, 7.2, 8.1, 7.1; SD 2, +0.6 dla marki ulubionej) i akceptowaną cenę 500 g (13.5, 12.0, 14.5, 12.5, 15.5, 13.0 zł; SD logarytmu 0.18, +8% dla marki ulubionej), wpływ wspólnego zaangażowania w kategorię (0.6 na logit świadomości, 0.4 na logit rozważania, 4% ceny na 1 SD), szansę używania rozważanej marki 0.55 (marka ulubiona – zawsze), wagi eksperckie (0.15, 0.20, 0.25, 0.25, 0.15), próg alarmu z < −1.5, spadek NPS o 20 punktów w teście wrażliwości i 1000 prób bootstrapowych. Parametrów nie zmienialiśmy po pierwszym uruchomieniu; po obejrzeniu rysunków poprawiliśmy tylko ich wygląd (kolory na rysunku 5, minimalna długość paska i teksty sygnałów na karcie).
1. Paleta, motyw i dane: 1500 respondentów, 6 marek
R
# Ankieta o 6 fikcyjnych markach płatków śniadaniowych: 1500 osób, 5 wskaźników zdrowia marki (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey55", ciemny = "grey20")
kol_marki <- c(Arnika = "#0072B2", Brzask = "#D55E00", Chrupka = "#E69F00",
               Dziewanna = "#009E73", Estragon = "#CC79A7", Fiołek = "#56B4E9")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie („prawda” o markach)
marki <- c("Arnika", "Brzask", "Chrupka", "Dziewanna", "Estragon", "Fiołek")
p_zna      <- c(.90, .86, .68, .55, .44, .38)   # świadomość wspomagana
p_rozwaza  <- c(.52, .50, .58, .56, .68, .52)   # rozważanie wśród znających
atrakcyjn  <- c(1.0, 0.9, 1.2, 1.0, 1.5, 0.9)   # siła marki przy wyborze preferowanej spośród rozważanych
nps_sr     <- c(7.0, 5.9, 7.6, 7.2, 8.1, 7.1)   # średnia ocen 0–10 „czy polecisz” wśród używających
cena_sr    <- c(13.5, 12.0, 14.5, 12.5, 15.5, 13.0)  # akceptowana cena opakowania 500 g (zł) wśród znających
n <- 1500

set.seed(683)                                    # ziarno ustalone raz, bez dobierania pod wynik
u <- rnorm(n)                                    # zaangażowanie w kategorię (wspólne dla wszystkich marek)
lp <- function(p, b) plogis(outer(u, rep(b, length(p))) + matrix(qlogis(p), n, length(p), byrow = TRUE))
zna     <- matrix(rbinom(n * 6, 1, lp(p_zna, 0.6)), n, 6, dimnames = list(NULL, marki))
rozwaza <- zna * matrix(rbinom(n * 6, 1, lp(p_rozwaza, 0.4)), n, 6)
# Marka preferowana: jedna spośród rozważanych, z szansą proporcjonalną do atrakcyjności
pref_marka <- apply(rozwaza, 1, function(r) if (sum(r) == 0) NA else
  marki[r == 1][sample.int(sum(r), 1, prob = atrakcyjn[r == 1])])
preferuje <- outer(pref_marka, marki, "==") * 1; preferuje[is.na(preferuje)] <- 0
uzywa <- pmax(preferuje, rozwaza * matrix(rbinom(n * 6, 1, .55), n, 6))
# Ocena polecenia 0–10 (tylko używający) i akceptowana cena (tylko znający)
nps_ocena <- round(pmin(pmax(matrix(nps_sr, n, 6, byrow = TRUE) + 0.6 * preferuje + rnorm(n * 6, 0, 2), 0), 10))
nps_ocena[uzywa == 0] <- NA
cena <- round(2 * exp(matrix(log(cena_sr), n, 6, byrow = TRUE) + 0.04 * u + 0.08 * preferuje +
                        rnorm(n * 6, 0, .18))) / 2
cena[zna == 0] <- NA
for (nm in c("rozwaza", "preferuje", "uzywa", "nps_ocena", "cena")) assign(nm, `colnames<-`(get(nm), marki))

ankieta <- data.frame(id = rep(1:n, 6), marka = factor(rep(marki, each = n), levels = marki),
                      zna = c(zna), rozwaza = c(rozwaza), preferuje = c(preferuje), uzywa = c(uzywa),
                      nps_ocena = c(nps_ocena), cena_akceptowana = c(cena))
write.csv(ankieta, "indeks-zdrowia-marki-ankieta.csv", row.names = FALSE)

# Opis próby
c(respondentow = n, wierszy = nrow(ankieta), bez_rozwazanej_marki = sum(is.na(pref_marka)))
round(colMeans(zna), 3)
colSums(uzywa)
Wynik w R
        respondentow              wierszy bez_rozwazanej_marki
                1500                 9000                  148
   Arnika    Brzask   Chrupka Dziewanna  Estragon    Fiołek
    0.883     0.853     0.677     0.556     0.451     0.389
   Arnika    Brzask   Chrupka Dziewanna  Estragon    Fiołek
      519       442       443       352       399       256
2. Pięć wskaźników z 95% CI: rysunek 1
R
# Rysunek 1. Pięć wskaźników zdrowia marki z 95% CI (macierze zna, rozwaza, preferuje, uzywa, nps_ocena, cena z przepisu 1)
nazwy_w <- c("Świadomość (%)", "Rozważanie (%)", "Preferencja (%)", "NPS", "Akceptowana cena (zł)")
# Wskaźniki marek z dowolnego podzbioru respondentów (i – numery wierszy; przyda się w bootstrapie)
wskazniki <- function(i = seq_len(n)) {
  s <- nps_ocena[i, , drop = FALSE]
  cbind(swiadomosc  = 100 * colMeans(zna[i, ]),
        rozwazanie  = 100 * colMeans(rozwaza[i, ]),
        preferencja = 100 * colMeans(preferuje[i, ]),
        nps         = 100 * (colMeans(s >= 9, na.rm = TRUE) - colMeans(s <= 6, na.rm = TRUE)),
        cena        = colMeans(cena[i, ], na.rm = TRUE))
}
W <- wskazniki()
round(W, 1)

# 95% CI: odsetki i NPS ze wzoru na błąd standardowy, cena – średnia z błędem standardowym
se_odsetek <- function(p) 100 * sqrt(p / 100 * (1 - p / 100) / n)
n_uz <- colSums(uzywa); p_pro <- colMeans(nps_ocena >= 9, na.rm = TRUE); p_kry <- colMeans(nps_ocena <= 6, na.rm = TRUE)
SE <- cbind(se_odsetek(W[, 1]), se_odsetek(W[, 2]), se_odsetek(W[, 3]),
            100 * sqrt((p_pro + p_kry - (p_pro - p_kry)^2) / n_uz),
            apply(cena, 2, sd, na.rm = TRUE) / sqrt(colSums(zna)))
n_uz                                     # liczba używających (oceniali polecenie)
round(cbind(promotorzy = 100 * p_pro, krytycy = 100 * p_kry), 1)
tab1 <- data.frame(marka = factor(rep(marki, 5), levels = rev(marki)), wskaznik = factor(rep(nazwy_w, each = 6), levels = nazwy_w),
                   wartosc = c(W), dolna = c(W - 1.96 * SE), gorna = c(W + 1.96 * SE))
tab1[, 3:5] <- round(tab1[, 3:5], 1); tab1

p1 <- ggplot(tab1, aes(wartosc, marka, colour = marka)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.3, linewidth = 0.7, orientation = "y") +
  geom_point(size = 2.8) +
  geom_text(aes(label = format(wartosc, nsmall = 1)), nudge_y = 0.42, size = 3.3, colour = "grey15") +
  facet_wrap(~ wskaznik, ncol = 2, scales = "free_x") +
  scale_colour_manual(values = kol_marki, guide = "none") +
  labs(title = "Pięć wskaźników zdrowia marki (1500 respondentów)", x = "Wartość wskaźnika z 95% CI", y = NULL) +
  motyw
p1   # zapis: ggsave("indeks-zdrowia-marki-wskazniki.svg", p1, width = 10, height = 8.4)
Wynik w R
          swiadomosc rozwazanie preferencja   nps cena
Arnika          88.3       47.0        19.4  -6.6 14.0
Brzask          85.3       42.0        16.2 -44.1 12.3
Chrupka         67.7       40.7        17.3  11.7 15.3
Dziewanna       55.6       32.3        11.9  -4.3 13.2
Estragon        45.1       32.9        17.9  30.8 16.5
Fiołek          38.9       22.7         7.5  -4.7 13.5
   Arnika    Brzask   Chrupka Dziewanna  Estragon    Fiołek
      519       442       443       352       399       256
          promotorzy krytycy
Arnika          27.6    34.1
Brzask          11.5    55.7
Chrupka         36.3    24.6
Dziewanna       30.1    34.4
Estragon        46.6    15.8
Fiołek          30.5    35.2
       marka              wskaznik wartosc dolna gorna
1     Arnika        Świadomość (%)    88.3  86.7  90.0
2     Brzask        Świadomość (%)    85.3  83.5  87.1
3    Chrupka        Świadomość (%)    67.7  65.3  70.0
4  Dziewanna        Świadomość (%)    55.6  53.1  58.1
5   Estragon        Świadomość (%)    45.1  42.5  47.6
6     Fiołek        Świadomość (%)    38.9  36.5  41.4
7     Arnika        Rozważanie (%)    47.0  44.5  49.5
8     Brzask        Rozważanie (%)    42.0  39.5  44.5
9    Chrupka        Rozważanie (%)    40.7  38.2  43.2
10 Dziewanna        Rozważanie (%)    32.3  29.9  34.6
11  Estragon        Rozważanie (%)    32.9  30.6  35.3
12    Fiołek        Rozważanie (%)    22.7  20.5  24.8
13    Arnika       Preferencja (%)    19.4  17.4  21.4
14    Brzask       Preferencja (%)    16.2  14.3  18.1
15   Chrupka       Preferencja (%)    17.3  15.4  19.2
16 Dziewanna       Preferencja (%)    11.9  10.2  13.5
17  Estragon       Preferencja (%)    17.9  15.9  19.8
18    Fiołek       Preferencja (%)     7.5   6.2   8.9
19    Arnika                   NPS    -6.6 -13.3   0.2
20    Brzask                   NPS   -44.1 -50.6 -37.7
21   Chrupka                   NPS    11.7   4.6  18.9
22 Dziewanna                   NPS    -4.3 -12.6   4.1
23  Estragon                   NPS    30.8  23.7  38.0
24    Fiołek                   NPS    -4.7 -14.6   5.2
25    Arnika Akceptowana cena (zł)    14.0  13.9  14.2
26    Brzask Akceptowana cena (zł)    12.3  12.2  12.5
27   Chrupka Akceptowana cena (zł)    15.3  15.1  15.5
28 Dziewanna Akceptowana cena (zł)    13.2  13.0  13.3
29  Estragon Akceptowana cena (zł)    16.5  16.3  16.7
30    Fiołek Akceptowana cena (zł)    13.5  13.3  13.7
3. Korelacje, wagi PCA i udział w zmienności indeksu: rysunek 2
R
# Rysunek 2. Korelacje wskaźników i rzeczywisty udział wskaźników w indeksie (macierz W z przepisu 2)
library(patchwork)
krotkie <- c("Świadomość", "Rozważanie", "Preferencja", "NPS", "Cena")
# Standaryzacja (z, min–max, rangi) i wagi (równe, eksperckie, PCA) – funkcje dla kolejnych przepisów
standaryzuj <- function(W, typ) switch(typ,
  z      = scale(W),
  minmax = apply(W, 2, function(x) 100 * (x - min(x)) / (max(x) - min(x))),
  rangi  = apply(W, 2, rank))                       # 6 = najlepsza marka w danym wskaźniku
wagi_pca <- function(W) { a <- prcomp(W, scale. = TRUE)$rotation[, 1]; a^2 }   # kwadraty ładunków PC1, suma = 1
wagi <- function(W, typ) switch(typ,
  rowne      = rep(1 / 5, 5),
  eksperckie = c(.15, .20, .25, .25, .15),
  pca        = wagi_pca(W))

R <- cor(W); dimnames(R) <- list(krotkie, krotkie)
round(R, 2)
pc <- prcomp(W, scale. = TRUE)
round(rbind(ladunki_PC1 = pc$rotation[, 1], wagi_PCA = wagi_pca(W)), 3)
round(100 * pc$sdev^2 / sum(pc$sdev^2), 1)        # % wariancji wyjaśnianej przez składowe

# Udział wskaźnika j w zmienności indeksu: w_j × cov(z_j, I) / var(I) (sumuje się do 100%)
udzial <- function(W, w) { Z <- scale(W); I <- Z %*% w; 100 * w * cov(Z, I)[, 1] / var(I)[1, 1] }
ud <- sapply(c("rowne", "eksperckie", "pca"), function(t) udzial(W, wagi(W, t)))
nom <- sapply(c("rowne", "eksperckie", "pca"), function(t) 100 * wagi(W, t))
rownames(ud) <- rownames(nom) <- krotkie
round(cbind(nom, ud), 1)
round(c(lejek_rowne_nominalnie = sum(nom[1:3, "rowne"]), lejek_rowne_udzial = sum(ud[1:3, "rowne"]),
        lejek_pca_udzial = sum(ud[1:3, "pca"])), 1)

kd <- expand.grid(w1 = factor(krotkie, levels = krotkie), w2 = factor(krotkie, levels = rev(krotkie)))
kd$r <- R[cbind(as.integer(kd$w1), match(as.character(kd$w2), krotkie))]
pA <- ggplot(kd, aes(w1, w2, fill = r)) + geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = sub("^(-?)0\\.", "\\1.", sprintf("%.2f", r))), size = 3.8,
            colour = ifelse(abs(kd$r) > .6, "white", "grey10")) +
  scale_fill_gradient2(low = kol[["cynober"]], mid = "grey97", high = kol[["niebieski"]], limits = c(-1, 1), name = "r") +
  labs(title = "A. Korelacje wskaźników (6 marek)", x = NULL, y = NULL) + motyw +
  theme(axis.text.x = element_text(angle = 30, hjust = 1), panel.grid = element_blank())
ub <- data.frame(wskaznik = factor(rep(krotkie, 2), levels = rev(krotkie)),
                 rodzaj = rep(c("waga nominalna", "udział w zmienności indeksu"), each = 5),
                 proc = c(nom[, "rowne"], ud[, "rowne"]))
pB <- ggplot(ub, aes(proc, wskaznik, fill = rodzaj)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.0f%%", proc)), position = position_dodge(width = 0.75), hjust = -0.15, size = 3.4) +
  scale_fill_manual(values = c("waga nominalna" = "grey70", "udział w zmienności indeksu" = kol[["niebieski"]]), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), limits = c(0, max(ub$proc) * 1.18)) +
  labs(title = "B. Wagi równe: deklarowane a faktyczne", x = "Procent", y = NULL) + motyw +
  guides(fill = guide_legend(nrow = 2))
p2 <- pA + pB
p2   # zapis: ggsave("indeks-zdrowia-marki-korelacje-wagi.svg", p2, width = 10, height = 5.6)
Wynik w R
            Świadomość Rozważanie Preferencja   NPS  Cena
Świadomość        1.00       0.93        0.65 -0.59 -0.36
Rozważanie        0.93       1.00        0.87 -0.27 -0.02
Preferencja       0.65       0.87        1.00  0.15  0.43
NPS              -0.59      -0.27        0.15  1.00  0.92
Cena             -0.36      -0.02        0.43  0.92  1.00
            swiadomosc rozwazanie preferencja   nps  cena
ladunki_PC1     -0.595     -0.560      -0.406 0.353 0.210
wagi_PCA         0.354      0.313       0.164 0.124 0.044
[1] 56.0 42.3  1.3  0.3  0.0
            rowne eksperckie  pca rowne eksperckie  pca
Świadomość     20         15 35.4  15.7       10.4 40.7
Rozważanie     20         20 31.3  24.0       22.4 40.7
Preferencja    20         25 16.4  29.8       36.0 20.1
NPS            20         25 12.4  11.6       16.3 -2.2
Cena           20         15  4.4  18.9       14.9  0.7
lejek_rowne_nominalnie     lejek_rowne_udzial       lejek_pca_udzial
                  60.0                   69.5                  101.5
4. Dziewięć wariantów indeksu: rysunek 3
R
# Rysunek 3. Ranking marek w 9 wariantach indeksu: 3 standaryzacje × 3 schematy wag (funkcje z przepisu 3)
warianty <- expand.grid(stand = c("z", "minmax", "rangi"), wagi = c("rowne", "eksperckie", "pca"), stringsAsFactors = FALSE)
warianty$nazwa <- paste(c(z = "z", minmax = "min–max", rangi = "rangi")[warianty$stand],
                        c(rowne = "równe", eksperckie = "eksperckie", pca = "PCA")[warianty$wagi], sep = " · ")
ranking <- function(W, stand, typ_wag) {
  I <- drop(standaryzuj(W, stand) %*% wagi(W, typ_wag))
  rank(-I, ties.method = "min")                      # 1 = najlepsza marka
}
indeksy <- sapply(seq_len(nrow(warianty)), function(k) drop(standaryzuj(W, warianty$stand[k]) %*% wagi(W, warianty$wagi[k])))
miejsca <- sapply(seq_len(nrow(warianty)), function(k) ranking(W, warianty$stand[k], warianty$wagi[k]))
dimnames(indeksy) <- dimnames(miejsca) <- list(marki, warianty$nazwa)
round(indeksy[, 1:3], 2)
miejsca
# Zakres miejsc każdej marki i zgodność wariantów (tau Kendalla z wariantem podstawowym z · równe)
cbind(najlepsze = apply(miejsca, 1, min), najgorsze = apply(miejsca, 1, max))
round(apply(miejsca, 2, function(m) cor(m, miejsca[, 1], method = "kendall")), 2)
table(lider = marki[apply(miejsca, 2, which.min)])

md <- data.frame(marka = factor(rep(marki, 9), levels = marki), wariant = factor(rep(warianty$nazwa, each = 6), levels = warianty$nazwa),
                 miejsce = c(miejsca))
p3 <- ggplot(md, aes(wariant, miejsce, group = marka, colour = marka)) +
  geom_line(linewidth = 1.1, alpha = 0.85) + geom_point(aes(shape = marka), size = 3.2) +
  geom_text(data = subset(md, wariant == levels(md$wariant)[9]), aes(label = marka), hjust = -0.25, size = 3.6, show.legend = FALSE) +
  scale_y_reverse(breaks = 1:6) +
  scale_x_discrete(expand = expansion(add = c(0.4, 1.3))) +
  scale_colour_manual(values = kol_marki) + scale_shape_manual(values = c(16, 17, 15, 18, 8, 4)) +
  labs(title = "Miejsce marki w rankingu zależy od wyboru standaryzacji i wag",
       x = "Wariant indeksu (standaryzacja · wagi)", y = "Miejsce (1 = najlepsza)", colour = NULL, shape = NULL) +
  motyw + theme(axis.text.x = element_text(angle = 35, hjust = 1)) + guides(colour = guide_legend(nrow = 1))
p3   # zapis: ggsave("indeks-zdrowia-marki-stabilnosc-rankingu.svg", p3, width = 10, height = 6)
Wynik w R
          z · równe min–max · równe rangi · równe
Arnika         0.64           78.18           4.8
Brzask        -0.17           49.28           3.0
Chrupka        0.51           71.87           4.4
Dziewanna     -0.45           36.47           2.6
Estragon       0.46           68.34           4.4
Fiołek        -0.99           16.05           1.8
          z · równe min–max · równe rangi · równe z · eksperckie
Arnika            1               1             1              1
Brzask            4               4             4              4
Chrupka           2               2             2              3
Dziewanna         5               5             5              5
Estragon          3               3             2              2
Fiołek            6               6             6              6
          min–max · eksperckie rangi · eksperckie z · PCA min–max · PCA
Arnika                       1                  1       1             1
Brzask                       4                  4       3             2
Chrupka                      2                  3       2             3
Dziewanna                    5                  5       5             5
Estragon                     3                  2       4             4
Fiołek                       6                  6       6             6
          rangi · PCA
Arnika              1
Brzask              3
Chrupka             2
Dziewanna           5
Estragon            4
Fiołek              6
          najlepsze najgorsze
Arnika            1         1
Brzask            2         4
Chrupka           2         3
Dziewanna         5         5
Estragon          2         4
Fiołek            6         6
           z · równe      min–max · równe        rangi · równe
                1.00                 1.00                 0.97
      z · eksperckie min–max · eksperckie   rangi · eksperckie
                0.87                 1.00                 0.87
             z · PCA        min–max · PCA          rangi · PCA
                0.87                 0.73                 0.87
lider
Arnika
     9
5. Bootstrap respondentów: rysunek 4
R
# Rysunek 4. Niepewność rankingu: bootstrap respondentów (funkcje z przepisów 2–4)
B <- 1000
set.seed(683)
boot <- replicate(B, {
  i <- sample.int(n, n, replace = TRUE)              # losujemy respondentów ze zwracaniem
  Wb <- wskazniki(i)
  k <- sample.int(nrow(warianty), 1)                 # do panelu B: losowy wariant indeksu
  c(ranking(Wb, "z", "rowne"), ranking(Wb, warianty$stand[k], warianty$wagi[k]))
})
m_a <- boot[1:6, ]; m_b <- boot[7:12, ]
rozklad <- function(m) t(sapply(1:6, function(j) tabulate(m[j, ], 6) / B))
ra <- rozklad(m_a); rb <- rozklad(m_b); dimnames(ra) <- dimnames(rb) <- list(marki, paste0("miejsce_", 1:6))
round(100 * ra, 1)
round(100 * rb, 1)
# 95% przedział miejsca i szansa na 1. miejsce z błędem Monte Carlo
przedzial <- function(m) t(apply(m, 1, quantile, c(.025, .975), type = 1))
pa <- przedzial(m_a); pb <- przedzial(m_b)
cbind(miejsce = miejsca[, 1], A_dolna = pa[, 1], A_gorna = pa[, 2], B_dolna = pb[, 1], B_gorna = pb[, 2])
p1a <- ra[, 1]; round(cbind(P_lider_A = 100 * p1a, blad_MC_pp = 100 * sqrt(p1a * (1 - p1a) / B), P_lider_B = 100 * rb[, 1]), 1)

rd <- rbind(data.frame(panel = "A. Tylko próba (z · równe)", marka = rep(marki, 6), miejsce = rep(1:6, each = 6), p = c(ra)),
            data.frame(panel = "B. Próba + losowy wariant (9)", marka = rep(marki, 6), miejsce = rep(1:6, each = 6), p = c(rb)))
rd$marka <- factor(rd$marka, levels = rev(marki)); rd$miejsce <- factor(rd$miejsce, levels = 6:1)
p4 <- ggplot(rd, aes(100 * p, marka, fill = miejsce)) +
  geom_col(width = 0.72, colour = "white", linewidth = 0.3) +
  geom_text(aes(label = ifelse(p >= .08, sprintf("%.0f", 100 * p), "")), position = position_stack(vjust = 0.5),
            size = 3.2, colour = ifelse(as.integer(as.character(rd$miejsce)) <= 2, "white", "grey10")) +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_manual(values = setNames(c("#08306B", "#2171B5", "#6BAED6", "#C6DBEF", "#E5E5E5", "#BDBDBD"), 1:6),
                    breaks = 1:6, name = "Miejsce w rankingu") +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "Jak często marka zajmuje dane miejsce (1000 prób bootstrapowych)", x = "Odsetek prób", y = NULL) +
  motyw + guides(fill = guide_legend(nrow = 1))
p4   # zapis: ggsave("indeks-zdrowia-marki-bootstrap-miejsc.svg", p4, width = 10, height = 5.8)
Wynik w R
          miejsce_1 miejsce_2 miejsce_3 miejsce_4 miejsce_5 miejsce_6
Arnika         84.1      14.0       1.9       0.0       0.0         0
Brzask          0.0       0.0       0.0      99.7       0.3         0
Chrupka        12.4      54.3      33.3       0.0       0.0         0
Dziewanna       0.0       0.0       0.0       0.3      99.7         0
Estragon        3.5      31.7      64.8       0.0       0.0         0
Fiołek          0.0       0.0       0.0       0.0       0.0       100
          miejsce_1 miejsce_2 miejsce_3 miejsce_4 miejsce_5 miejsce_6
Arnika         86.8      11.1       2.1       0.0       0.0         0
Brzask          0.0      12.1      21.0      65.8       1.1         0
Chrupka         8.7      56.5      34.8       0.0       0.0         0
Dziewanna       0.0       0.0       0.0       1.8      98.2         0
Estragon        5.8      22.2      38.9      32.8       0.3         0
Fiołek          0.0       0.0       0.0       0.0       0.0       100
          miejsce A_dolna A_gorna B_dolna B_gorna
Arnika          1       1       2       1       2
Brzask          4       4       4       2       4
Chrupka         2       1       3       1       3
Dziewanna       5       5       5       5       5
Estragon        3       1       3       1       4
Fiołek          6       6       6       6       6
          P_lider_A blad_MC_pp P_lider_B
Arnika         84.1        1.2      86.8
Brzask          0.0        0.0       0.0
Chrupka        12.4        1.0       8.7
Dziewanna       0.0        0.0       0.0
Estragon        3.5        0.6       5.8
Fiołek          0.0        0.0       0.0
6. Profile marek i test wrażliwości: rysunek 5
R
# Rysunek 5. Co ukrywa indeks: profile marek w wynikach z i test „co, jeśli NPS spadnie” (przepisy 2–4)
Z <- scale(W); colnames(Z) <- krotkie
round(cbind(Z, indeks_z_rowne = indeksy[, 1]), 2)
# Sygnał alarmowy: wskaźnik co najmniej 1.5 SD poniżej średniej marek (albo NPS poniżej zera)
alarm <- which(Z < -1.5, arr.ind = TRUE); data.frame(marka = marki[alarm[, 1]], wskaznik = krotkie[alarm[, 2]], z = round(Z[alarm], 2))
marki[W[, "nps"] < 0]

# Analiza wrażliwości: NPS Brzasku spada o kolejne 20 punktów (z −44.1 do −64.1)
W2 <- W; W2["Brzask", "nps"] <- W2["Brzask", "nps"] - 20
zmiana <- sapply(c("rowne", "eksperckie", "pca"), function(t) {
  i1 <- drop(scale(W) %*% wagi(W, t)); i2 <- drop(scale(W2) %*% wagi(W2, t))
  c(indeks_przed = i1[["Brzask"]], indeks_po = i2[["Brzask"]], miejsce_przed = rank(-i1)[["Brzask"]], miejsce_po = rank(-i2)[["Brzask"]])
})
round(zmiana, 2)

pd <- data.frame(marka = factor(rep(marki, 5), levels = marki), wskaznik = factor(rep(krotkie, each = 6), levels = krotkie), z = c(Z))
pd$wyroznij <- ifelse(pd$marka %in% c("Brzask", "Chrupka", "Estragon"), as.character(pd$marka), "pozostałe marki")
etyk <- data.frame(marka = marki, z = Z[, 5], wskaznik = "Cena", indeks = indeksy[, 1], miejsce = miejsca[, 1])
etyk$tekst <- sub("-", "−", sprintf("%s: indeks %+.2f (%d.)", etyk$marka, etyk$indeks, etyk$miejsce))
p5 <- ggplot(pd, aes(wskaznik, z, group = marka)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -Inf, ymax = -1.5, fill = kol[["cynober"]], alpha = 0.08) +
  annotate("text", x = 0.6, y = -1.65, label = "strefa alarmu: z < −1.5", hjust = 0, size = 3.4, colour = kol[["cynober"]]) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_line(aes(colour = wyroznij, linewidth = wyroznij != "pozostałe marki")) +
  geom_point(aes(colour = wyroznij, shape = wyroznij), size = 3) +
  ggrepel::geom_text_repel(data = etyk, aes(label = tekst), nudge_x = 0.45, hjust = 0, direction = "y", size = 3.3,
                           segment.colour = "grey70", min.segment.length = 0, seed = 683) +
  scale_colour_manual(values = c(Brzask = kol[["cynober"]], Chrupka = kol[["niebieski"]], Estragon = kol[["zielony"]], "pozostałe marki" = "grey65"), name = NULL) +
  scale_shape_manual(values = c(Brzask = 17, Chrupka = 15, Estragon = 18, "pozostałe marki" = 16), name = NULL) +
  scale_linewidth_manual(values = c(0.6, 1.3), guide = "none") +
  scale_x_discrete(expand = expansion(add = c(0.4, 1.9))) +
  labs(title = "Podobny indeks, różne profile – i problem, którego indeks nie widzi",
       x = NULL, y = "Wynik z (odchylenia od średniej 6 marek)") + motyw
p5   # zapis: ggsave("indeks-zdrowia-marki-profil-pulapka.svg", p5, width = 10, height = 5.8)
Wynik w R
          Świadomość Rozważanie Preferencja   NPS  Cena indeks_z_rowne
Arnika          1.21       1.23        0.98 -0.15 -0.06           0.64
Brzask          1.06       0.66        0.26 -1.67 -1.18          -0.17
Chrupka         0.20       0.51        0.50  0.59  0.76           0.51
Dziewanna      -0.38      -0.46       -0.71 -0.06 -0.65          -0.45
Estragon       -0.90      -0.38        0.64  1.36  1.56           0.46
Fiołek         -1.19      -1.56       -1.68 -0.07 -0.42          -0.99
   marka    wskaznik     z
1 Fiołek  Rozważanie -1.56
2 Fiołek Preferencja -1.68
3 Brzask         NPS -1.67
[1] "Arnika"    "Brzask"    "Dziewanna" "Fiołek"
              rowne eksperckie  pca
indeks_przed  -0.17      -0.24 0.37
indeks_po     -0.20      -0.28 0.35
miejsce_przed  4.00       4.00 3.00
miejsce_po     4.00       4.00 3.00
7. Karta marki: rysunek 6
R
# Rysunek 6. Grafika: karta marki – 5 wskaźników, indeks, miejsce z przedziałem i sygnał alarmowy (przepisy 2–6)
pozycja <- apply(W, 2, function(x) (x - min(x)) / (max(x) - min(x)))   # 0 = najsłabsza, 1 = najlepsza z 6 marek
fmt <- cbind(sprintf("%.0f%%", W[, 1]), sprintf("%.0f%%", W[, 2]), sprintf("%.0f%%", W[, 3]),
             sub("-", "−", sprintf("%+.0f", W[, 4])), sprintf("%.2f zł", W[, 5]))
karta <- data.frame(marka = factor(rep(marki, 5), levels = marki), wiersz = rep(5:1, each = 6),
                    wskaznik = rep(c("Świadomość", "Rozważanie", "Preferencja", "NPS", "Akceptowana cena"), each = 6),
                    pozycja = c(pozycja), tekst = c(fmt), alarm = c(Z < -1.5))
naglowek <- data.frame(marka = factor(marki, levels = marki),
                       tekst = sub("-", "−", sprintf("Indeks (z · równe) %+.2f  ·  miejsce %d", indeksy[, 1], miejsca[, 1])),
                       przedzial = sprintf("95%% przedział miejsca: %d–%d (próba i wariant)", pb[, 1], pb[, 2]),
                       sygnal = apply(Z < -1.5, 1, function(a) if (any(a)) paste("Sygnał: z < −1.5 –", sub("nps", "NPS", tolower(paste(krotkie[a], collapse = ", ")))) else ""))
naglowek[, c("marka", "sygnal")]
p6 <- ggplot(karta) +
  geom_rect(aes(xmin = 4.2, xmax = 8.2, ymin = wiersz - 0.3, ymax = wiersz + 0.3), fill = "grey90") +
  geom_rect(aes(xmin = 4.2, xmax = 4.2 + 4 * pmax(pozycja, .03), ymin = wiersz - 0.3, ymax = wiersz + 0.3,
                fill = ifelse(alarm, "alarm", "ok"))) +
  geom_text(aes(x = 0.2, y = wiersz, label = wskaznik), hjust = 0, size = 3.4, colour = "grey15") +
  geom_text(aes(x = 9.9, y = wiersz, label = tekst, colour = ifelse(alarm, "alarm", "ok")), hjust = 1, size = 3.4, fontface = "bold") +
  annotate("rect", xmin = 0, xmax = 10, ymin = 5.7, ymax = 7.5, fill = "#0f1d3a") +
  geom_text(data = naglowek, aes(x = 0.2, y = 7.0, label = tekst), hjust = 0, size = 3.5, colour = "white", fontface = "bold") +
  geom_text(data = naglowek, aes(x = 0.2, y = 6.2, label = przedzial), hjust = 0, size = 3.1, colour = "white") +
  geom_text(data = naglowek, aes(x = 0.2, y = 0.2, label = sygnal), hjust = 0, size = 3.2, colour = kol[["cynober"]], fontface = "bold") +
  facet_wrap(~ marka, ncol = 2) +
  scale_fill_manual(values = c(ok = kol[["niebieski"]], alarm = kol[["cynober"]]), guide = "none") +
  scale_colour_manual(values = c(ok = "grey10", alarm = kol[["cynober"]]), guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(-0.1, 7.5), expand = FALSE) +
  labs(title = "Karta marki: pięć wskaźników zamiast jednej liczby",
       subtitle = "Pasek = pozycja wśród 6 marek (od najsłabszej do najlepszej); czerwony = wynik z < −1.5") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05), margin = margin(b = 4, t = 8)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10),
        panel.spacing.x = unit(1.2, "lines"))
p6   # zapis: ggsave("indeks-zdrowia-marki-karta-marki.svg", p6, width = 10, height = 9)
Wynik w R
              marka                                     sygnal
Arnika       Arnika
Brzask       Brzask                     Sygnał: z < −1.5 – NPS
Chrupka     Chrupka
Dziewanna Dziewanna
Estragon   Estragon
Fiołek       Fiołek Sygnał: z < −1.5 – rozważanie, preferencja
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("Arnika – Fiołek (niebieski – błękitny)" = c("#0072B2", "#56B4E9"),
             "Brzask – Chrupka (cynober – pomarańczowy)" = c("#D55E00", "#E69F00"),
             "Dziewanna – Estragon (zielony – różowy)" = c("#009E73", "#CC79A7"),
             "Brzask – Chrupka (rysunek 5: cynober – niebieski)" = c("#D55E00", "#0072B2"),
             "Brzask – Estragon (rysunek 5: cynober – zielony)" = c("#D55E00", "#009E73"),
             "Chrupka – Estragon (rysunek 5: niebieski – zielony)" = c("#0072B2", "#009E73"),
             "pasek: zwykły – alarm (rysunek 6)" = c("#0072B2", "#D55E00"),
             "miejsce 2 – miejsce 3 (rysunek 4)" = c("#2171B5", "#6BAED6"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                    widzenie_typowe
Arnika – Fiołek (niebieski – błękitny)                         26.4
Brzask – Chrupka (cynober – pomarańczowy)                      33.4
Dziewanna – Estragon (zielony – różowy)                        87.5
Brzask – Chrupka (rysunek 5: cynober – niebieski)             114.6
Brzask – Estragon (rysunek 5: cynober – zielony)              102.4
Chrupka – Estragon (rysunek 5: niebieski – zielony)            70.1
pasek: zwykły – alarm (rysunek 6)                             114.6
miejsce 2 – miejsce 3 (rysunek 4)                              29.3
czerwony – zielony (do unikania)                              121.7
                                                    deuteranopia protanopia
Arnika – Fiołek (niebieski – błękitny)                      24.7       24.6
Brzask – Chrupka (cynober – pomarańczowy)                   18.4       24.9
Dziewanna – Estragon (zielony – różowy)                     18.1       36.2
Brzask – Chrupka (rysunek 5: cynober – niebieski)          108.3       91.9
Brzask – Estragon (rysunek 5: cynober – zielony)            53.5       37.3
Chrupka – Estragon (rysunek 5: niebieski – zielony)         55.4       58.0
pasek: zwykły – alarm (rysunek 6)                          108.3       91.9
miejsce 2 – miejsce 3 (rysunek 4)                           27.8       26.7
czerwony – zielony (do unikania)                            21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, odsetki, korelacje, PCA funkcją prcomp() i bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2 (zestawienie paneli – patchwork, etykiety bez nakładania – ggrepel); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak zbudować indeks zdrowia marki z kilku wskaźników?
Wybierz wskaźniki (np. świadomość, rozważanie, preferencję, NPS i akceptowaną cenę), sprowadź je do wspólnej skali – wynikami z, min–max albo rangami – i policz średnią ważoną. Wagi ustal przed obejrzeniem wyników i uzasadnij. Potem sprawdź korelacje wskaźników i to, czy ranking marek nie zmienia się przy innych wariantach standaryzacji i wag.
Czy wagi z PCA są lepsze od wag równych w indeksie złożonym?
Nie z definicji. Kwadraty ładunków pierwszej składowej nagradzają wskaźniki skorelowane z innymi, a nie najważniejsze. W przykładzie wagi PCA dały 83% wagi trzem wskaźnikom lejka, a faktyczny udział NPS w indeksie spadł do −2.2%. PCA przydaje się do sprawdzenia struktury wskaźników, a wagi lepiej ustalić merytorycznie i porównać w analizie wrażliwości.
Dlaczego skorelowane wskaźniki zniekształcają indeks?
Bo razem ważą więcej, niż mówią wagi. Udział wskaźnika w zmienności indeksu zależy od wagi i od jego kowariancji z resztą: w przykładzie świadomość, rozważanie i preferencja miały po 20% wagi, ale łącznie 69.5% udziału, a NPS 11.6%. Policz udziały albo połącz silnie skorelowane wskaźniki w jeden.
Jak pokazać niepewność miejsca marki w rankingu?
Bootstrapem respondentów: losuj osoby ze zwracaniem, licz wskaźniki, indeks i ranking od nowa (np. 1000 razy) i podaj odsetek prób, w których marka zajmuje każde miejsce, oraz 95% przedział miejsca. Gdy w każdej próbie losujesz też wariant indeksu, łączysz niepewność próby i metody – w przykładzie przedział miejsca jednej marki rozszerzył się z 4–4 do 2–4.
Czy indeks zdrowia marki może ukryć problem marki?
Tak, bo suma ważona kompensuje słabe wyniki mocnymi. W przykładzie marka o NPS −44.1 była czwarta z sześciu dzięki wysokiej świadomości, a spadek NPS o kolejne 20 punktów nie zmienił jej miejsca w żadnym schemacie wag. Dlatego indeks warto raportować razem z kartą pięciu wskaźników i sygnałem dla wyników skrajnie niskich.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikBadanie trackingowe marki
Osiem fal badania marki: odsetki z wagami i deff, różnica fala do fali, trend, średnia krocząca i fałszywe alarmy przy wielu wskaźnikach – z kodem R.
Czytaj →PoradnikPrawo podwójnego zagrożenia
Osiem marek makaronu w panelu 3000 gospodarstw: penetracja i częstość, NBD, model Dirichleta ręcznie, marki niszowe i „na zmianę” – z kodem R.
Czytaj →PoradnikUdział w reklamie a udział w rynku (ESOV)
Osiem marek past do zębów: SOV, SOM i ESOV, regresja zmiany udziału, efekty stałe i symulacja, w której reklama nie działa, a wykres rośnie – z kodem R.
Czytaj →PoradnikŚwiadomość marki i lejek marki
Top of mind, świadomość spontaniczna i wspomagana, konwersje lejka i zmiana między falami z przedziałami – na fikcyjnym rynku ubezpieczeń, z kodem R.
Czytaj →Budujesz indeks marki w pracy z marketingu?
Pomożemy dobrać wskaźniki, ustalić standaryzację i wagi, sprawdzić stabilność rankingu w analizie wrażliwości i bootstrapie oraz opisać wyniki z tabelą i rysunkami – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Diamantopoulos, A., & Winklhofer, H. M. (2001). Index construction with formative indicators: An alternative to scale development. Journal of Marketing Research, 38(2), 269–277. https://doi.org/10.1509/jmkr.38.2.269.18845
- Greco, S., Ishizaka, A., Tasiou, M., & Torrisi, G. (2019). On the methodological framework of composite indices: A review of the issues of weighting, aggregation, and robustness. Social Indicators Research, 141(1), 61–94. https://doi.org/10.1007/s11205-017-1832-9 ● Otwarty dostęp
- Hall, P., & Miller, H. (2009). Using the bootstrap to quantify the authority of an empirical ranking. The Annals of Statistics, 37(6B), 3929–3959. https://doi.org/10.1214/09-aos699 ● Otwarty dostęp
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences, 374(2065), Article 20150202. https://doi.org/10.1098/rsta.2015.0202 ● Otwarty dostęp: pełny tekst
- Keller, K. L. (1993). Conceptualizing, measuring, and managing customer-based brand equity. Journal of Marketing, 57(1), 1–22. https://doi.org/10.1177/002224299305700101 ● Otwarty dostęp: pełny tekst
- Paruolo, P., Saisana, M., & Saltelli, A. (2013). Ratings and rankings: Voodoo or science? Journal of the Royal Statistical Society Series A: Statistics in Society, 176(3), 609–634. https://doi.org/10.1111/j.1467-985x.2012.01059.x ● Otwarty dostęp: pełny tekst
- Saisana, M., Saltelli, A., & Tarantola, S. (2005). Uncertainty and sensitivity analysis techniques as tools for the quality assessment of composite indicators. Journal of the Royal Statistical Society Series A: Statistics in Society, 168(2), 307–323. https://doi.org/10.1111/j.1467-985x.2005.00350.x
Cytowania BibTeX
@article{diamantopoulos2001index, author={Diamantopoulos, Adamantios and Winklhofer, Heidi M.}, title={{Index construction with formative indicators: An alternative to scale development}}, journal={Journal of Marketing Research}, year={2001}, volume={38}, number={2}, pages={269--277}, doi={10.1509/jmkr.38.2.269.18845}}@article{greco2019methodological, author={Greco, Salvatore and Ishizaka, Alessio and Tasiou, Menelaos and Torrisi, Gianpiero}, title={{On the methodological framework of composite indices: A review of the issues of weighting, aggregation, and robustness}}, journal={Social Indicators Research}, year={2019}, volume={141}, number={1}, pages={61--94}, doi={10.1007/s11205-017-1832-9}}@article{hall2009using, author={Hall, Peter and Miller, Hugh}, title={{Using the bootstrap to quantify the authority of an empirical ranking}}, journal={The Annals of Statistics}, year={2009}, volume={37}, number={6B}, pages={3929--3959}, doi={10.1214/09-aos699}}@article{jolliffe2016principal, author={Jolliffe, Ian T. and Cadima, Jorge}, title={{Principal component analysis: A review and recent developments}}, journal={Philosophical Transactions of the Royal Society A: Mathematical, Physical and Engineering Sciences}, year={2016}, volume={374}, number={2065}, eid={20150202}, doi={10.1098/rsta.2015.0202}}@article{keller1993conceptualizing, author={Keller, Kevin Lane}, title={{Conceptualizing, measuring, and managing customer-based brand equity}}, journal={Journal of Marketing}, year={1993}, volume={57}, number={1}, pages={1--22}, doi={10.1177/002224299305700101}}@article{paruolo2013ratings, author={Paruolo, Paolo and Saisana, Michaela and Saltelli, Andrea}, title={{Ratings and rankings: Voodoo or science?}}, journal={Journal of the Royal Statistical Society Series A: Statistics in Society}, year={2013}, volume={176}, number={3}, pages={609--634}, doi={10.1111/j.1467-985x.2012.01059.x}}@article{saisana2005uncertainty, author={Saisana, Michaela and Saltelli, Andrea and Tarantola, Stefano}, title={{Uncertainty and sensitivity analysis techniques as tools for the quality assessment of composite indicators}}, journal={Journal of the Royal Statistical Society Series A: Statistics in Society}, year={2005}, volume={168}, number={2}, pages={307--323}, doi={10.1111/j.1467-985x.2005.00350.x}}