Przykład: sklep z artykułami kuchennymi i pytanie „co pokazać na górze listy?”
Fikcyjny sklep internetowy sprzedaje 80 artykułów kuchennych: patelnie, garnki, noże, deski, blachy, czajniki, wagi, tarki, miski i pojemniki (po osiem wariantów, oznaczonych literami A–H). Po zakupie klient może wystawić ocenę od 1 do 5 gwiazdek. Dział marketingu chce dodać sortowanie „najlepiej oceniane” i pyta: czy wyżej postawić garnek ze średnią 5.0 z trzech opinii, czy tarkę ze średnią 4.6 z 397 opinii? W tytule pada 4.9 z trzech opinii i 4.6 z 800 – u nas tarka ma 397 opinii, a 4.9 z trzech opinii to skrót myślowy: trzy oceny dają średnią 4.67 albo 5.0, nic pomiędzy. Już to pokazuje problem: przy kilku opiniach średnia skacze dużymi krokami.
Dane są fikcyjne, więc znamy prawdziwą jakość każdego produktu. Ręcznie ustaliliśmy model: jakość produktu przesuwa rozkład ocen wszystkich kupujących (model porządkowy z progami −1.5, −0.5, 0.5, 1.5; jakość z rozkładu normalnego o średniej 1.5 i SD 0.8). Lepsze produkty sprzedają się trochę lepiej. Opinię pisze tylko część kupujących: 15% niezadowolonych na 1 gwiazdkę, 9% zachwyconych na 5 i tylko 2.5–5% osób z ocenami środkowymi. „Prawdziwa jakość” to średnia ocena, jaką dałby każdy kupujący. Ziarno 627 ustaliliśmy raz i nie zmienialiśmy. Dane pobierzesz jako oceny-gwiazdkowe-sklep-kuchenny.csv (wiersz = produkt, kolumny gw1–gw5 = liczba opinii z daną liczbą gwiazdek).
Sklep zebrał 2812 opinii od 39 207 kupujących. Jeden produkt nie ma żadnej. Mediana to 18 opinii na produkt, a 29 z 79 ocenianych produktów ma ich mniej niż 10. Średnia wszystkich opinii w sklepie wynosi 4.26 (SD = 1.35). Inne projekty z ocenami klientów opisują wpisy NPS na obrazkach i statystyka w pracy z marketingu.
Rysunek 1: dlaczego opinie mają kształt litery J
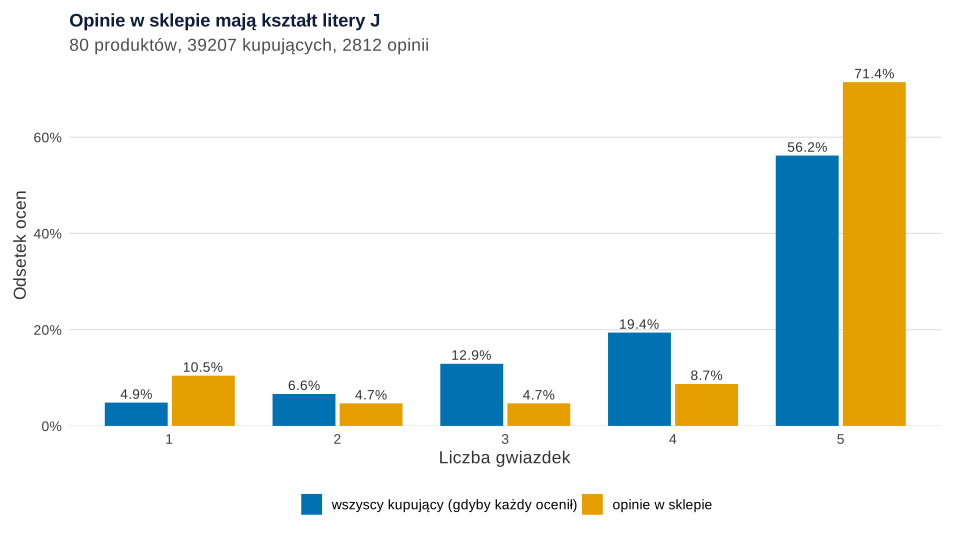
set.seed(627)).Co widać. Wśród opinii 71.4% to piątki, a jedynek (10.5%) jest więcej niż czwórek (8.7%) i ponad dwa razy więcej niż dwójek czy trójek (po 4.7%). Kupujący, gdyby każdy wystawił ocenę, dają rozkład łagodniejszy: 56.2% piątek i tylko 4.9% jedynek. Opinię napisało 7.2% kupujących. Hu i in. (2017) nazywają to rozkładem w kształcie litery J i tłumaczą samoselekcją: opinie częściej piszą klienci skrajnie zadowoleni i skrajnie niezadowoleni, a produkt kupują głównie ci, którzy byli do niego przychylnie nastawieni. To szczególny przypadek błędu selekcji i samoselekcji opisanej we wpisie dobór nielosowy w obrazkach.
Jak może zmylić. Niebieskie słupki znamy tylko dlatego, że dane są symulowane. W prawdziwym sklepie widzisz wyłącznie opinie. Średnia opinii (4.26) jest wyższa niż średnia kupujących (4.15), a przy tak skośnym rozkładzie jedna jedynka mocno ciągnie średnią małego produktu w dół.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: średnia z kilku opinii skacze – wykres lejkowy
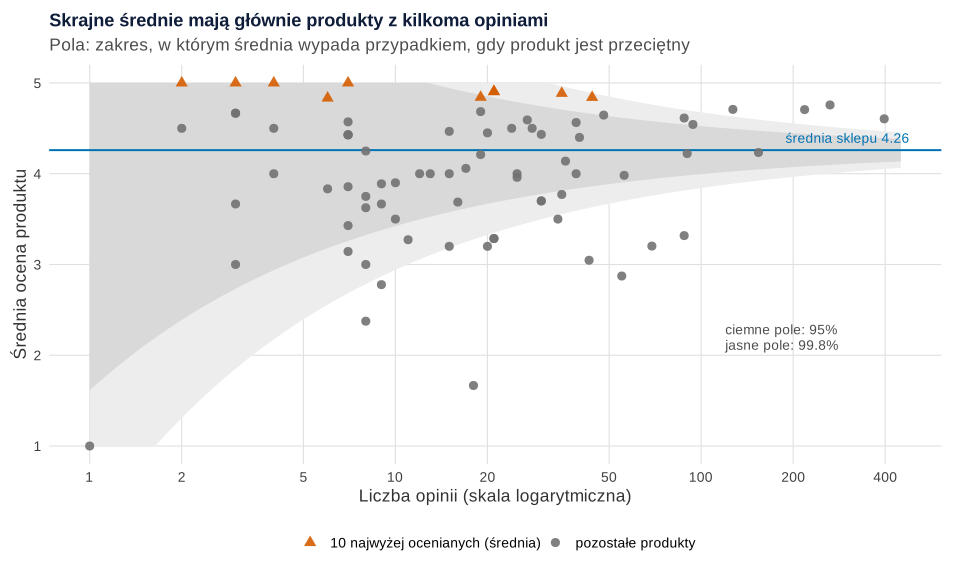
Co widać. Produkty z mniej niż 10 opiniami mają średnie od 1.00 do 5.00, a produkty z co najmniej 100 opiniami – od 4.23 do 4.76. Dziesiątka najwyżej ocenianych (trójkąty) ma medianę 13 opinii. Cztery produkty mają średnią 5.0 i żaden nie ma więcej niż 7 opinii. Szare pola to granice: średnia sklepu ± 1.96 i ± 3.09 błędu standardowego (SD / √n). Taki wykres lejkowy Spiegelhalter (2005) zaproponował zamiast rankingów instytucji: wynik rysuje się względem precyzji, a granice zwężają się z liczbą obserwacji. Poza granice 99.8% wychodzi 15 produktów – przy tak dużych różnicach między produktami to sygnał prawdziwej różnicy, a nie przypadek.
Jak może zmylić. Punkt w szerokiej części lejka nie jest „przeciętny” – po prostu za mało o nim wiemy. Granice z błędu standardowego traktują oceny jak liczby i przy kilku opiniach wychodzą poza skalę 1–5 (dlatego je ucięliśmy).
Podpis do pracy:
Zdanie do Wyników:
Trzy sposoby układania rankingu
1. Średnia. Najprostsza i najczęściej spotykana. Nie widzi liczby opinii, więc nagradza szczęściarzy z kilkoma piątkami.
2. Dolna granica przedziału Wilsona. Zamiast średniej liczysz odsetek ocen 4–5 gwiazdek, czyli „klientów zadowolonych”, i jego przedział ufności dla proporcji. Ranking układasz według dolnej granicy: „co najmniej tyle klientów jest zadowolonych”. Przedział Wilsona ma pokrycie bliskie 95% nawet przy bardzo małych próbach (Agresti i Coull, 1998), dlatego zaleca się go przy małym n zamiast podręcznikowego przedziału Walda (Brown i in., 2001). Przy trzech opiniach i trzech zadowolonych klientach dolna granica wynosi 43.8%.
3. Średnia wygładzona. Do opinii produktu dokładasz m „opinii pozornych” równych średniej sklepu C i liczysz średnią ważoną:
Przy trzech opiniach i m = 3.9 wynik w ponad połowie pochodzi ze średniej sklepu; przy 400 opiniach średnia sklepu prawie nic nie zmienia. To proste ściąganie do średniej, ten sam mechanizm co w modelu mieszanym (kurczenie do średniej). m nie bierzemy z sufitu: to iloraz wariancji ocen w obrębie produktu (1.509) i wariancji prawdziwych średnich między produktami (0.384, z produktów z co najmniej 10 opiniami, po odjęciu szumu). Wychodzi m = 3.9. Gdy produkty różnią się mało, m rośnie i ściąganie jest silniejsze.
Rysunek 3: 5.0 z trzech opinii czy 4.6 z 397?
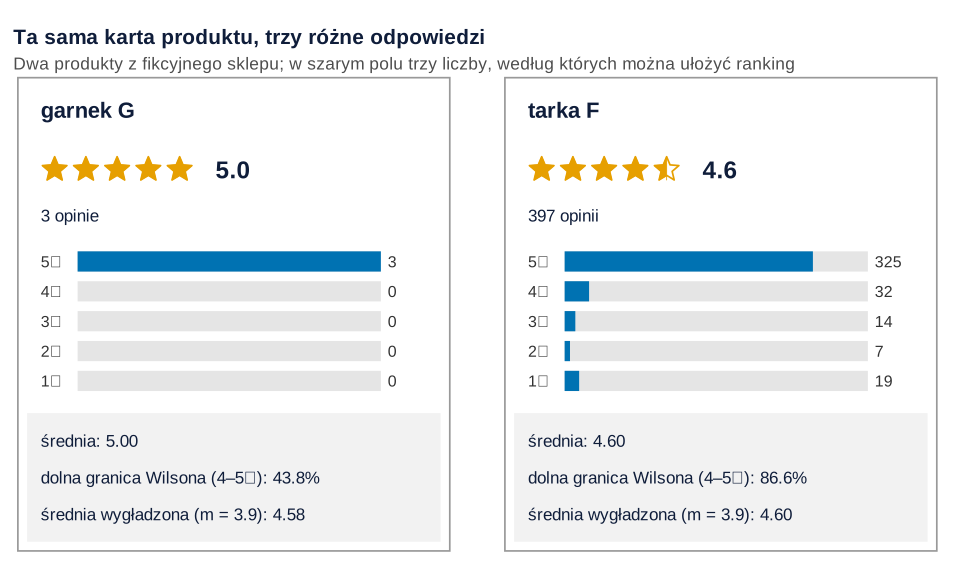
Co widać. Garnek G ma trzy piątki, tarka F – 397 opinii, z czego 89.9% to oceny 4–5. Po średniej wygrywa garnek (1. miejsce wobec 19.). Po dolnej granicy Wilsona wygrywa tarka: 86.6% wobec 43.8% (4. miejsce wobec 45.). Średnia wygładzona daje prawie remis: 4.60 wobec 4.58 (14. i 16. miejsce). Prawdziwa jakość, znana tylko w symulacji: tarka 4.38, garnek 3.98.
Jak może zmylić. Garnek nie jest „gorszy” – jest nieznany. Trzy piątki zgadzają się i z produktem świetnym, i z przeciętnym. Wilson karze ten brak wiedzy najmocniej, średnia wygładzona – łagodniej.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: kto trafia do pierwszej dziesiątki
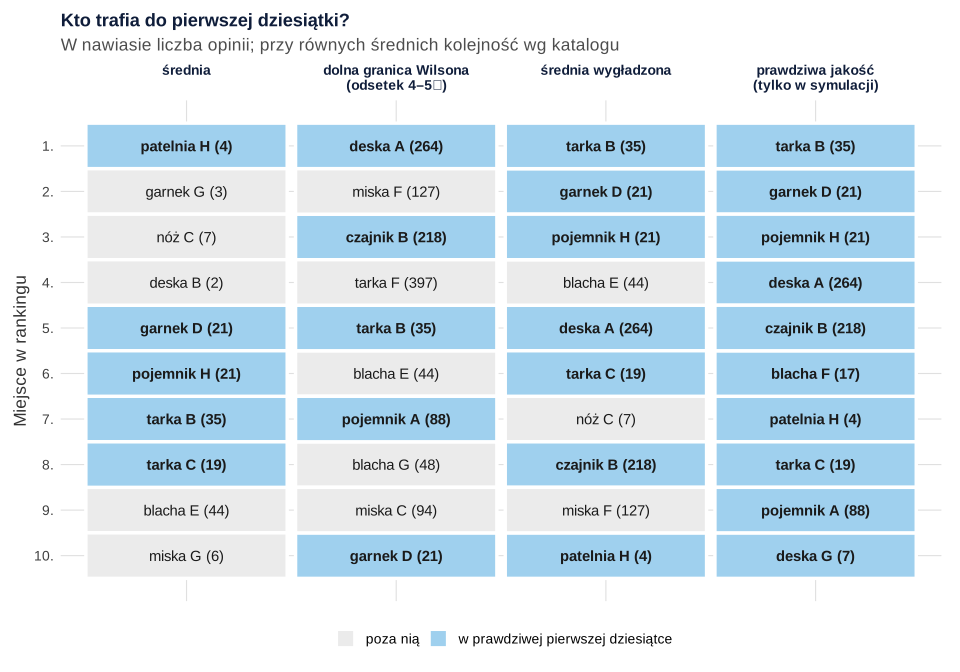
Co widać. Prawdziwym liderem jest tarka B (35 opinii, średnia 4.89). Średnia daje na górze cztery produkty z kompletem piątek i 2–7 opiniami; najlepszy z nich zajmuje dopiero 7. miejsce w prawdziwym rankingu. Wilson stawia na górze deskę A z 264 opiniami (prawdziwe 4. miejsce) i wyraźnie faworyzuje produkty z setkami opinii. Średnia wygładzona trafia w lidera. Z prawdziwej pierwszej dziesiątki każda metoda łapie odpowiednio 5, 6 i 7 produktów, a korelacja Spearmana z prawdziwą jakością wynosi .806, .791 i .829.
Jak może zmylić. To jeden sklep – wygrana jednej metody może być przypadkiem. Dlatego niżej powtarzamy całość na 1000 sklepach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: symulacja 1000 sklepów
Powtarzamy losowanie sklepu 1000 razy tym samym modelem (pierwszy sklep to ten z rysunków 1–4) i liczymy, jak często lider rankingu jest naprawdę najlepszym produktem oraz ilu z prawdziwej pierwszej dziesiątki trafia do top 10. Do trzech metod dokładamy dwie popularne: średnią tylko dla produktów z co najmniej 10 opiniami i dolną granicę przedziału dla średniej (średnia − 1.96 × SD sklepu / √n). Remisy rozstrzyga losowanie. Losowo wybrany produkt byłby liderem w ok. 1.3% sklepów (1 z 79).
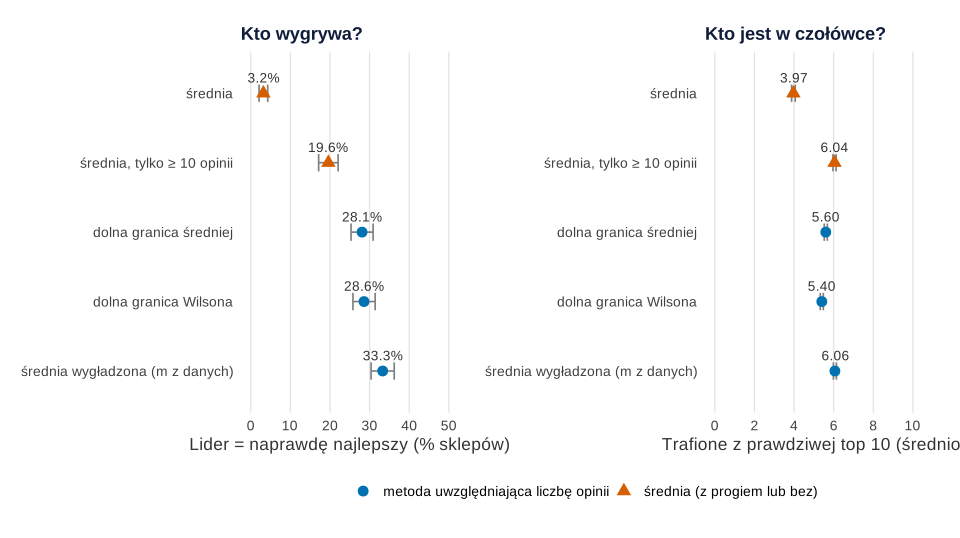
set.seed(627)).Co widać. Zwykła średnia wskazuje prawdziwego lidera tylko w 3.2% sklepów (błąd Monte Carlo 0.6 pp). Próg 10 opinii podnosi to do 19.6%, dolne granice (średniej i Wilsona) do 28.1% i 28.6%, a średnia wygładzona z m szacowanym z danych – do 33.3% (błąd MC 1.5 pp). W pierwszej dziesiątce różnice są mniejsze: średnia trafia średnio 3.97 produktu, pozostałe metody 5.40–6.06.
Jak może zmylić. Wynik zależy od modelu danych. Gdy produkty prawie się nie różnią, żadna metoda nie znajdzie lidera. Gdy liczba opinii silniej zależy od jakości, może zyskać Wilson, który faworyzuje popularne produkty – sprawdzisz to, zmieniając w kodzie współczynnik 0.4. Próg 10 opinii wygląda dobrze w top 10, ale całkowicie wyklucza nowości.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: ile opinii pozornych dodać?
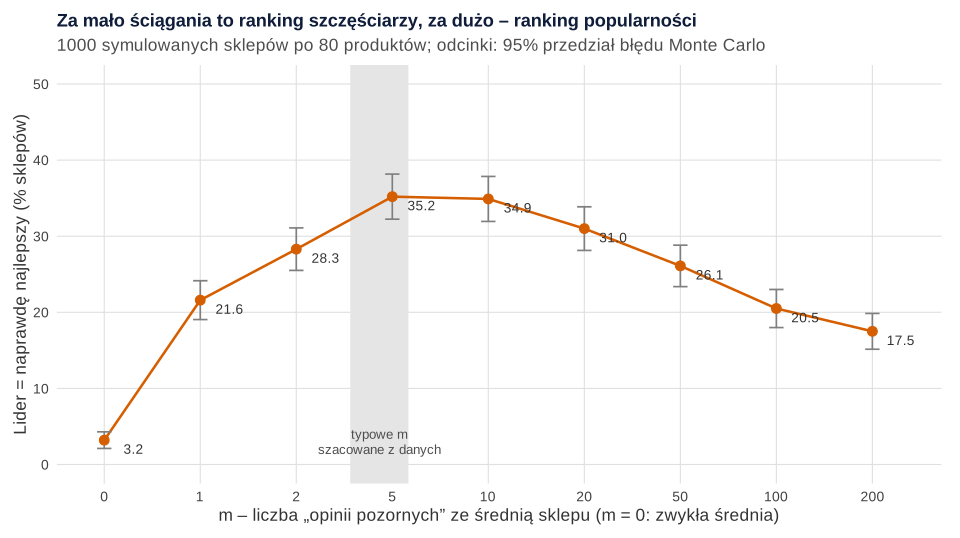
set.seed(627)).Co widać. Krzywa ma szczyt przy m = 5–10 (35.2% i 34.9%). Za małe m zostawia ranking szczęściarzy (m = 1: 21.6%), za duże zamienia go w ranking popularności (m = 200: 17.5%), bo wtedy wygrywa produkt, który ma dużo opinii trochę powyżej średniej. m szacowane z danych wynosiło w połowie sklepów od 3.7 do 5.8 (mediana 4.6) – blisko szczytu.
Jak może zmylić. Szczyt jest płaski, więc nie szukaj „idealnego” m co do jednostki. Ważniejsze, żeby było dodatnie i uzasadnione danymi albo podane z góry.
Zdanie do Metody:
Co z tym zrobić w marketingu
- Sortowanie „najlepiej oceniane”: układaj według średniej wygładzonej albo dolnej granicy Wilsona, a nie według surowej średniej. Na karcie produktu możesz dalej pokazywać zwykłą średnią i liczbę opinii.
- Produkty z kilkoma opiniami: poproś kupujących o ocenę (e-mail po dostawie), zamiast awansować je w rankingu. Każda nowa opinia zmniejsza niepewność.
- Kampania „bestsellery”: pamiętaj, że klienci sami przeceniają liczbę opinii – w eksperymentach Powella i in. (2017) ludzie woleli produkt z większą liczbą opinii nawet wtedy, gdy model statystyczny wskazywał, że lepszy jest prawdopodobnie ten z mniejszą.
- Porównanie dwóch produktów lub dwóch kwartałów: podawaj przedziały, nie same średnie. Gdy pytasz o polecenie marki, a nie o produkt, użyj NPS.
- Zmiana sortowania to decyzja biznesowa: czy nowy ranking zwiększa sprzedaż, sprawdzisz w teście A/B.
Jak opisać w pracy
W Metodzie podaj liczbę produktów i opinii, rozkład liczby opinii (mediana, odsetek produktów z mniej niż 10 opiniami), sposób tworzenia rankingu z uzasadnieniem i wartość m albo poziom przedziału. Napisz, że oceny pochodzą od osób, które zdecydowały się je wystawić.
W Wynikach pokaż wykres lejkowy (rysunek 2) zamiast tabeli „top 10” albo obok niej. Rankingi bez niepewności są zwodnicze także poza handlem: w rankingach szkół po uwzględnieniu niepewności tylko nieliczne szkoły dało się wiarygodnie odróżnić od średniej (Leckie i Goldstein, 2009). Różnicę między rankingiem a oceną pozycji opisuje hasło ranking a ocena pozycji.
Kod R: rankingi z gwiazdek i symulacja
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, model ocen i dane, z których korzystają kolejne. Wszystko liczy bazowy R (rmultinom(), rbinom(), rank()) – bez pakietów do rekomendacji. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane sklepu) i 4 (1000 sklepów, także losowe rozstrzyganie remisów); oba zaczynają się od własnego set.seed(627). Ziarno 627 ustalono raz i nie zmieniano go. Ręcznie ustalono: 80 produktów, progi modelu ocen (−1.5, −0.5, 0.5, 1.5), jakość produktów z rozkładu normalnego (średnia 1.5, SD 0.8), liczbę kupujących 20 + lognormalny (parametry 5.4 i 1.4, z zależnością od jakości o sile 0.4), szanse napisania opinii (.15, .05, .025, .03, .09 dla 1–5 gwiazdek), próg 10 opinii przy szacowaniu m oraz siatkę m na rysunku 6. Parametrów nie zmieniano po obejrzeniu wyników; jedyna poprawka dotyczyła rysunku 6 (zwykła średnia jako punkt m = 0 zamiast osobnego losowania remisów). Symulacja 1000 sklepów liczy się w ok. 1 s.
1. Paleta, model ocen, dane sklepu i rozkład gwiazdek: Rysunek 1
R
# Rysunek 1. Fikcyjny sklep internetowy z artykułami kuchennymi: kupujący, opinie i rozkład gwiazdek (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Model ocen (ustalony ręcznie): jakość produktu theta przesuwa rozkład ocen 1–5 kupujących
# (model porządkowy logitowy z progami -1.5, -0.5, 0.5, 1.5); opinię pisze tylko część kupujących,
# chętniej bardzo zadowoleni i bardzo niezadowoleni (samoselekcja)
progi <- c(-1.5, -0.5, 0.5, 1.5)
p_oceny <- function(theta) {                  # P(ocena = 1, …, 5) dla każdego kupującego
  sk <- plogis(outer(theta, progi, function(t, c) c - t))
  cbind(sk, 1) - cbind(0, sk)
}
p_opinii <- c(.15, .05, .025, .03, .09)       # szansa napisania opinii przy ocenie 1, 2, 3, 4, 5

# Jeden sklep: 80 produktów (10 rodzajów × 8 wariantów); liczba kupujących zależy trochę od jakości
symuluj_sklep <- function(J = 80) {
  theta <- rnorm(J, 1.5, 0.8)
  kupujacy <- 20 + round(rlnorm(J, 5.4 + 0.4 * (theta - 1.5), 1.4))
  P <- p_oceny(theta)
  oceny_kup <- t(sapply(seq_len(J), function(j) rmultinom(1, kupujacy[j], P[j, ])))
  opinie <- matrix(rbinom(length(oceny_kup), oceny_kup, rep(p_opinii, each = J)), J, 5)
  list(theta = theta, jakosc = drop(P %*% 1:5), kupujacy = kupujacy, oceny_kup = oceny_kup, opinie = opinie)
}

set.seed(627)                                   # ziarno ustalone raz, bez dobierania pod wynik
s <- symuluj_sklep()
rodzaje <- c("patelnia", "garnek", "nóż", "deska", "blacha", "czajnik", "waga", "tarka", "miska", "pojemnik")
sklep <- data.frame(produkt = paste(rep(rodzaje, each = 8), rep(LETTERS[1:8], 10)),
                    kupujacy = s$kupujacy, jakosc_prawdziwa = round(s$jakosc, 3),
                    n_opinii = rowSums(s$opinie), s$opinie)
names(sklep)[5:9] <- paste0("gw", 1:5)
write.csv(sklep, "oceny-gwiazdkowe-sklep-kuchenny.csv", row.names = FALSE)

oc <- sklep[sklep$n_opinii > 0, ]               # produkty z co najmniej jedną opinią
wszystkie <- rep(rep(1:5, nrow(oc)), as.vector(t(as.matrix(oc[, paste0("gw", 1:5)]))))
C <- mean(wszystkie); S <- sd(wszystkie)        # średnia i SD wszystkich opinii w sklepie
c(produkty = nrow(sklep), bez_opinii = sum(sklep$n_opinii == 0), opinie = sum(sklep$n_opinii),
  kupujacy = sum(sklep$kupujacy), mediana_opinii = median(oc$n_opinii),
  ponizej_10 = sum(oc$n_opinii < 10), max_opinii = max(oc$n_opinii),
  srednia_sklepu = round(C, 3), sd_ocen = round(S, 3))

# Rozkład gwiazdek: wszyscy kupujący (znany tylko w symulacji) vs opinie w sklepie
rozklad <- data.frame(
  gwiazdki = factor(rep(1:5, 2)),
  kto = factor(rep(c("wszyscy kupujący (gdyby każdy ocenił)", "opinie w sklepie"), each = 5),
               levels = c("wszyscy kupujący (gdyby każdy ocenił)", "opinie w sklepie")),
  odsetek = c(colSums(s$oceny_kup) / sum(s$oceny_kup), colSums(s$opinie) / sum(s$opinie)))
print(transform(rozklad, odsetek = round(100 * odsetek, 1)), row.names = FALSE)
c(srednia_kupujacych = round(sum(colSums(s$oceny_kup) * 1:5) / sum(s$oceny_kup), 2),
  srednia_opinii = round(C, 2), odsetek_kupujacych_z_opinia = round(100 * sum(s$opinie) / sum(s$oceny_kup), 1))

p1 <- ggplot(rozklad, aes(gwiazdki, odsetek, fill = kto)) +
  geom_col(position = position_dodge(width = 0.8), width = 0.75) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * odsetek)), position = position_dodge(width = 0.8),
            vjust = -0.4, size = 3.6, colour = "grey20") +
  scale_fill_manual(values = c(kol[["niebieski"]], kol[["pomarancz"]]), name = NULL) +
  scale_y_continuous(labels = scales::percent, limits = c(0, 0.75), expand = c(0, 0)) +
  labs(x = "Liczba gwiazdek", y = "Odsetek ocen",
       title = "Opinie w sklepie mają kształt litery J",
       subtitle = sprintf("%d produktów, %d kupujących, %d opinii", nrow(sklep), sum(sklep$kupujacy),
                          sum(sklep$n_opinii))) +
  motyw + theme(panel.grid.major.x = element_blank())
p1   # zapis: ggsave("oceny-gwiazdkowe-rozklad-j.svg", p1, width = 10, height = 5.6)
Wynik w R
      produkty     bez_opinii         opinie       kupujacy mediana_opinii
         80.00           1.00        2812.00       39207.00          18.00
    ponizej_10     max_opinii srednia_sklepu        sd_ocen
         29.00         397.00           4.26           1.35
 gwiazdki                                   kto odsetek
        1 wszyscy kupujący (gdyby każdy ocenił)     4.9
        2 wszyscy kupujący (gdyby każdy ocenił)     6.6
        3 wszyscy kupujący (gdyby każdy ocenił)    12.9
        4 wszyscy kupujący (gdyby każdy ocenił)    19.4
        5 wszyscy kupujący (gdyby każdy ocenił)    56.2
        1                      opinie w sklepie    10.5
        2                      opinie w sklepie     4.7
        3                      opinie w sklepie     4.7
        4                      opinie w sklepie     8.7
        5                      opinie w sklepie    71.4
         srednia_kupujacych              srednia_opinii
                       4.15                        4.26
odsetek_kupujacych_z_opinia
                       7.20
2. Wykres lejkowy średnich: Rysunek 2
R
# Rysunek 2. Średnia ocena produktu a liczba opinii: wykres lejkowy wokół średniej sklepu
# Korzysta z obiektów przepisu 1: oc (produkty z opiniami), C, S, kol, motyw. Niczego nie losuje.
library(ggplot2)

oc$srednia <- with(oc, (gw1 + 2 * gw2 + 3 * gw3 + 4 * gw4 + 5 * gw5) / n_opinii)
oc$miejsce_srednia <- rank(-oc$srednia, ties.method = "min")      # ranking po samej średniej
oc$top10 <- ifelse(oc$miejsce_srednia <= 10, "10 najwyżej ocenianych (średnia)", "pozostałe produkty")

# Granice lejka: średnia sklepu ± z · SD / √n (SD wszystkich opinii), obcięte do skali 1–5
siatka <- data.frame(n = exp(seq(log(1), log(450), length.out = 300)))
for (z in c(1.96, 3.09)) {
  siatka[[paste0("dol_", z)]] <- pmax(1, C - z * S / sqrt(siatka$n))
  siatka[[paste0("gora_", z)]] <- pmin(5, C + z * S / sqrt(siatka$n))
}
oc$poza95 <- abs(oc$srednia - C) > 1.96 * S / sqrt(oc$n_opinii)
oc$poza998 <- abs(oc$srednia - C) > 3.09 * S / sqrt(oc$n_opinii)
print(oc[oc$top10 == "10 najwyżej ocenianych (średnia)", c("produkt", "n_opinii", "srednia", "jakosc_prawdziwa")][
  order(oc$miejsce_srednia[oc$top10 == "10 najwyżej ocenianych (średnia)"]), ], row.names = FALSE, digits = 3)
c(top10_mediana_opinii = median(oc$n_opinii[oc$miejsce_srednia <= 10]),
  srednie_5_0 = sum(oc$srednia == 5), z_nich_max_opinii = max(oc$n_opinii[oc$srednia == 5]),
  poza_95 = sum(oc$poza95), poza_998 = sum(oc$poza998),
  min_srednia_n_ponizej_10 = round(min(oc$srednia[oc$n_opinii < 10]), 2),
  max_srednia_n_ponizej_10 = round(max(oc$srednia[oc$n_opinii < 10]), 2),
  min_srednia_n_100_plus = round(min(oc$srednia[oc$n_opinii >= 100]), 2),
  max_srednia_n_100_plus = round(max(oc$srednia[oc$n_opinii >= 100]), 2))
print(oc[oc$poza998, c("produkt", "n_opinii", "srednia", "jakosc_prawdziwa")], row.names = FALSE, digits = 3)

p2 <- ggplot(oc, aes(n_opinii, srednia)) +
  geom_ribbon(data = siatka, aes(x = n, ymin = dol_3.09, ymax = gora_3.09), inherit.aes = FALSE,
              fill = "grey93") +
  geom_ribbon(data = siatka, aes(x = n, ymin = dol_1.96, ymax = gora_1.96), inherit.aes = FALSE,
              fill = "grey85") +
  geom_hline(yintercept = C, colour = kol[["niebieski"]], linewidth = 0.7) +
  geom_point(aes(colour = top10, shape = top10), size = 2.8, alpha = 0.9) +
  annotate("text", x = 300, y = C + 0.08, label = sprintf("średnia sklepu %.2f", C), size = 3.6,
           colour = kol[["niebieski"]], vjust = 0) +
  annotate("text", x = 120, y = 2.2, label = "ciemne pole: 95%\njasne pole: 99.8%", size = 3.6,
           hjust = 0, colour = "grey30", lineheight = 0.95) +
  scale_x_log10(breaks = c(1, 2, 5, 10, 20, 50, 100, 200, 400)) +
  scale_y_continuous(limits = c(1, 5), breaks = 1:5) +
  scale_colour_manual(values = c(kol[["cynober"]], "grey45"), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  labs(x = "Liczba opinii (skala logarytmiczna)", y = "Średnia ocena produktu",
       title = "Skrajne średnie mają głównie produkty z kilkoma opiniami",
       subtitle = "Pola: zakres, w którym średnia wypada przypadkiem, gdy produkt jest przeciętny") +
  motyw
p2   # zapis: ggsave("oceny-gwiazdkowe-lejek.svg", p2, width = 10, height = 6)
Wynik w R
    produkt n_opinii srednia jakosc_prawdziwa
 patelnia H        4    5.00             4.49
   garnek G        3    5.00             3.98
      nóż C        7    5.00             4.47
    deska B        2    5.00             4.04
   garnek D       21    4.90             4.82
 pojemnik H       21    4.90             4.73
    tarka B       35    4.89             4.85
    tarka C       19    4.84             4.49
   blacha E       44    4.84             4.42
    miska G        6    4.83             4.46
    top10_mediana_opinii              srednie_5_0        z_nich_max_opinii
                   13.00                     4.00                     7.00
                 poza_95                 poza_998 min_srednia_n_ponizej_10
                   30.00                    15.00                     1.00
max_srednia_n_ponizej_10   min_srednia_n_100_plus   max_srednia_n_100_plus
                    5.00                     4.23                     4.76
    produkt n_opinii srednia jakosc_prawdziwa
 patelnia E       21    3.29             3.54
      nóż F       55    2.87             3.19
      nóż G       88    3.32             3.58
    deska A      264    4.76             4.69
   blacha B       34    3.50             3.82
   blacha C       69    3.20             3.55
   blacha D       21    3.29             3.52
  czajnik B      218    4.71             4.59
     waga C        8    2.38             3.52
     waga D       43    3.05             3.48
    tarka D       20    3.20             3.61
    tarka F      397    4.60             4.38
    miska F      127    4.71             4.41
 pojemnik D       18    1.67             2.23
 pojemnik G        9    2.78             3.48
3. Wilson, średnia wygładzona i trzy rankingi: Rysunki 3 i 4
R
# Rysunki 3 i 4. Trzy sposoby układania rankingu: średnia, dolna granica Wilsona, średnia wygładzona
# Korzysta z obiektów przepisów 1–2: oc (ze średnią), C, S, kol, motyw. Niczego nie losuje.
library(ggplot2)

# Dolna granica 95% przedziału Wilsona dla odsetka ocen 4–5 gwiazdek
wilson_dol <- function(x, n, z = 1.96) {
  p <- x / n
  (p + z^2 / (2 * n) - z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))) / (1 + z^2 / n)
}
oc$dobre <- oc$gw4 + oc$gw5
oc$wilson <- wilson_dol(oc$dobre, oc$n_opinii)

# Ile „opinii pozornych” m: wariancja ocen w obrębie produktu / wariancja prawdziwych średnich między produktami
G <- as.matrix(oc[, paste0("gw", 1:5)])
ss_w <- sum(G * (matrix(1:5, nrow(G), 5, byrow = TRUE) - oc$srednia)^2)    # suma kwadratów w produktach
s2_w <- ss_w / (sum(oc$n_opinii) - nrow(oc))
duze <- oc$n_opinii >= 10                                                  # produkty z co najmniej 10 opiniami
tau2 <- var(oc$srednia[duze]) - mean(s2_w / oc$n_opinii[duze])
m <- s2_w / tau2
oc$wygladzona <- (oc$n_opinii * oc$srednia + m * C) / (oc$n_opinii + m)
c(wariancja_w_produkcie = round(s2_w, 3), wariancja_miedzy_produktami = round(tau2, 4), m = round(m, 1))

# Rankingi i zgodność z prawdziwą jakością (znaną tylko w symulacji)
oc$miejsce_prawda <- rank(-oc$jakosc_prawdziwa)
metody <- c(srednia = "średnia", wilson = "dolna granica Wilsona\n(odsetek 4–5★)",
            wygladzona = "średnia wygładzona", jakosc_prawdziwa = "prawdziwa jakość\n(tylko w symulacji)")
podsum <- sapply(names(metody)[1:3], function(k) {
  r <- rank(-oc[[k]], ties.method = "min")
  c(prawdziwe_miejsce_lidera = min(oc$miejsce_prawda[r == 1]),
    trafione_z_top10 = sum(r <= 10 & oc$miejsce_prawda <= 10),
    rho_spearmana = round(cor(oc[[k]], oc$jakosc_prawdziwa, method = "spearman"), 3))
})
podsum
lider_prawda <- oc[which.max(oc$jakosc_prawdziwa), c("produkt", "n_opinii", "srednia", "jakosc_prawdziwa")]
lider_prawda

# Dwie karty produktu: 5.0 z trzech opinii i produkt z największą liczbą opinii
A <- oc[oc$srednia == 5 & oc$n_opinii == 3, ][1, ]
B <- oc[which.max(oc$n_opinii), ]
karty <- rbind(A, B)
print(data.frame(produkt = karty$produkt, opinie = karty$n_opinii, srednia = round(karty$srednia, 2),
                 odsetek_4_5 = round(100 * karty$dobre / karty$n_opinii, 1), wilson = round(100 * karty$wilson, 1),
                 wygladzona = round(karty$wygladzona, 2), prawdziwa = karty$jakosc_prawdziwa,
                 miejsce_srednia = rank(-oc$srednia, ties.method = "min")[match(karty$produkt, oc$produkt)],
                 miejsce_wilson = rank(-oc$wilson)[match(karty$produkt, oc$produkt)],
                 miejsce_wygladzona = rank(-oc$wygladzona)[match(karty$produkt, oc$produkt)]), row.names = FALSE)

# --- Rysunek 3: grafika „karta produktu z gwiazdkami” (prostokąty, wielokąty i tekst w ggplot2) ---
gwiazda <- function(x0, y0, pr = 0.28, wypel = 1) {       # gwiazda pięcioramienna; wypel = 1 lub 0.5
  kat <- pi / 2 + seq(0, 2 * pi, length.out = 11)[-11]
  promien <- rep(c(pr, pr * 0.45), 5)
  d <- data.frame(x = x0 + promien * cos(kat), y = y0 + promien * sin(kat))
  if (wypel == 0.5) d$x <- pmin(d$x, x0)                # lewa połowa gwiazdy
  d
}
gwiazdki <- function(sr, x0, y0, id) {
  pelne <- round(sr * 2) / 2
  do.call(rbind, lapply(1:5, function(i) {
    obrys <- gwiazda(x0 + (i - 1) * 0.68, y0); obrys$czesc <- "obrys"
    w <- if (i <= floor(pelne)) 1 else if (i - 0.5 == pelne) 0.5 else 0
    wyp <- if (w > 0) cbind(gwiazda(x0 + (i - 1) * 0.68, y0, wypel = w), czesc = "wypelnienie") else NULL
    out <- rbind(obrys, wyp); out$id <- paste(id, i, out$czesc); out
  }))
}
el <- list(); tx <- list(); sl <- list()
for (k in 1:2) {
  d <- karty[k, ]; x0 <- c(0, 10.6)[k]
  el[[k]] <- gwiazdki(d$srednia, x0 + 0.8, 8.9, k)
  tx[[k]] <- data.frame(
    x = x0 + c(0.5, 4.3, 0.5, 0.5, 0.5, 0.5),
    y = c(10.2, 8.9, 7.9, 3.0, 2.2, 1.4),
    tekst = c(d$produkt, sprintf("%.1f", d$srednia),
              sprintf("%d %s", d$n_opinii, ifelse(d$n_opinii == 3, "opinie", "opinii")),
              sprintf("średnia: %.2f", d$srednia),
              sprintf("dolna granica Wilsona (4–5★): %.1f%%", 100 * d$wilson),
              sprintf("średnia wygładzona (m = %.1f): %.2f", m, d$wygladzona)),
    rozmiar = c(5.8, 6.4, 4.5, 4.5, 4.5, 4.5), gruby = c("bold", "bold", "plain", "plain", "plain", "plain"))
  licz <- unlist(d[paste0("gw", 5:1)])
  sl[[k]] <- data.frame(x0 = x0 + 1.3, y = 6.9 - 0.65 * (0:4), dl = 6.6 * licz / d$n_opinii,
                        etyk = paste0(5:1, "★"), n = licz, xk = x0)
}
el <- do.call(rbind, el); tx <- do.call(rbind, tx); sl <- do.call(rbind, sl)
p3 <- ggplot() +
  geom_rect(aes(xmin = c(0, 10.6), xmax = c(9.4, 20), ymin = 0.6, ymax = 10.9),
            fill = "white", colour = "grey60", linewidth = 0.6) +
  geom_rect(aes(xmin = c(0.2, 10.8), xmax = c(9.2, 19.8), ymin = 0.8, ymax = 3.6), fill = "grey95", colour = NA) +
  geom_polygon(data = el[grepl("obrys", el$id), ], aes(x, y, group = id), fill = "white",
               colour = kol[["pomarancz"]], linewidth = 0.6) +
  geom_polygon(data = el[grepl("wypelnienie", el$id), ], aes(x, y, group = id), fill = kol[["pomarancz"]],
               colour = kol[["pomarancz"]], linewidth = 0.3) +
  geom_rect(data = sl, aes(xmin = x0, xmax = x0 + 6.6, ymin = y - 0.22, ymax = y + 0.22), fill = "grey90") +
  geom_rect(data = sl, aes(xmin = x0, xmax = x0 + dl, ymin = y - 0.22, ymax = y + 0.22), fill = kol[["niebieski"]]) +
  geom_text(data = sl, aes(x = xk + 0.5, y = y, label = etyk), hjust = 0, size = 4.2, colour = "grey20") +
  geom_text(data = sl, aes(x = x0 + 6.75, y = y, label = n), hjust = 0, size = 4.2, colour = "grey20") +
  geom_text(data = tx, aes(x, y, label = tekst, size = rozmiar, fontface = gruby), hjust = 0, colour = "#0f1d3a") +
  scale_size_identity() +
  coord_equal(xlim = c(-0.1, 20.1), ylim = c(0.5, 11), expand = FALSE) +
  labs(title = "Ta sama karta produktu, trzy różne odpowiedzi",
       subtitle = "Dwa produkty z fikcyjnego sklepu; w szarym polu trzy liczby, według których można ułożyć ranking") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p3   # zapis: ggsave("oceny-gwiazdkowe-karta-produktu.svg", p3, width = 10, height = 6)

# --- Rysunek 4: pierwsza dziesiątka według trzech metod i według prawdziwej jakości ---
siatka_r <- do.call(rbind, lapply(names(metody), function(k) {
  r <- rank(-oc[[k]], ties.method = "first")
  d <- oc[r <= 10, ]; d$miejsce <- r[r <= 10]
  data.frame(metoda = metody[[k]], miejsce = d$miejsce,
             etykieta = sprintf("%s (%d)", d$produkt, d$n_opinii),
             w_prawdziwej_10 = ifelse(d$miejsce_prawda <= 10, "w prawdziwej pierwszej dziesiątce", "poza nią"))
}))
siatka_r$metoda <- factor(siatka_r$metoda, levels = metody)
p4 <- ggplot(siatka_r, aes(metoda, miejsce)) +
  geom_tile(aes(fill = w_prawdziwej_10), colour = "white", linewidth = 1.2, width = 0.96) +
  geom_text(aes(label = etykieta, fontface = ifelse(w_prawdziwej_10 == "poza nią", "plain", "bold")),
            size = 3.9, colour = "grey10") +
  scale_y_reverse(breaks = 1:10, labels = paste0(1:10, ".")) +
  scale_x_discrete(position = "top") +
  scale_fill_manual(values = c("w prawdziwej pierwszej dziesiątce" = "#9FD0EE", "poza nią" = "grey92"), name = NULL) +
  labs(x = NULL, y = "Miejsce w rankingu",
       title = "Kto trafia do pierwszej dziesiątki?",
       subtitle = "W nawiasie liczba opinii; przy równych średnich kolejność wg katalogu") +
  motyw + theme(panel.grid = element_blank(), axis.text.x = element_text(face = "bold", colour = "#0f1d3a"))
p4   # zapis: ggsave("oceny-gwiazdkowe-trzy-rankingi.svg", p4, width = 10, height = 7)
Wynik w R
      wariancja_w_produkcie wariancja_miedzy_produktami
                     1.5090                      0.3844
                          m
                     3.9000
                         srednia wilson wygladzona
prawdziwe_miejsce_lidera   7.000  4.000      1.000
trafione_z_top10           5.000  6.000      7.000
rho_spearmana              0.806  0.791      0.829
   produkt n_opinii  srednia jakosc_prawdziwa
58 tarka B       35 4.885714            4.847
  produkt opinie srednia odsetek_4_5 wilson wygladzona prawdziwa
 garnek G      3     5.0       100.0   43.8       4.58     3.981
  tarka F    397     4.6        89.9   86.6       4.60     4.376
 miejsce_srednia miejsce_wilson miejsce_wygladzona
               1             45                 16
              19              4                 14
4. Symulacja 1000 sklepów: Rysunki 5 i 6
R
# Rysunki 5 i 6. Symulacja 1000 sklepów: który ranking częściej wskazuje produkt naprawdę najlepszy?
# Korzysta z obiektów przepisów 1 i 3: symuluj_sklep(), wilson_dol(), kol, motyw.
library(ggplot2)
library(patchwork)

oceny_metod <- function(s, m_siatka) {
  ok <- rowSums(s$opinie) > 0                          # produkty bez opinii nie wchodzą do rankingu
  G <- s$opinie[ok, ]; n <- rowSums(G); jak <- s$jakosc[ok]
  sr <- drop(G %*% 1:5) / n
  C <- sum(G %*% 1:5) / sum(n)                         # średnia sklepu
  S <- sqrt((sum(G %*% (1:5)^2) - sum(n) * C^2) / (sum(n) - 1))
  s2_w <- sum(G * (matrix(1:5, nrow(G), 5, byrow = TRUE) - sr)^2) / (sum(n) - nrow(G))
  duze <- n >= 10
  tau2 <- max(var(sr[duze]) - mean(s2_w / n[duze]), 1e-3)
  m <- s2_w / tau2
  wyniki <- list(
    "średnia" = sr,
    "średnia, tylko ≥ 10 opinii" = ifelse(n >= 10, sr, -Inf),
    "dolna granica średniej" = sr - 1.96 * S / sqrt(n),
    "dolna granica Wilsona" = wilson_dol(G[, 4] + G[, 5], n),
    "średnia wygładzona (m z danych)" = (n * sr + m * C) / (n + m))
  for (mm in m_siatka) wyniki[[paste0("m=", mm)]] <- (n * sr + mm * C) / (n + mm)
  prawda10 <- rank(-jak) <= 10
  t(sapply(wyniki, function(w) {
    r <- rank(-w, ties.method = "random")              # remisy rozstrzyga losowanie
    c(lider = as.numeric(which(r == 1) == which.max(jak)), top10 = sum(r <= 10 & prawda10))
  })) |> cbind(m = m)
}

m_siatka <- c(1, 2, 5, 10, 20, 50, 100, 200)       # m = 0 to zwykła średnia
set.seed(627)                                          # to samo ziarno co w przepisie 1
R <- 1000
t0 <- Sys.time()
wyn <- replicate(R, oceny_metod(symuluj_sklep(), m_siatka), simplify = FALSE)
lider <- sapply(wyn, function(w) w[, "lider"]); top10 <- sapply(wyn, function(w) w[, "top10"])
m_est <- sapply(wyn, function(w) w[1, "m"])
podsumowanie <- data.frame(metoda = rownames(lider), lider = rowMeans(lider),
                           blad_mc = sqrt(rowMeans(lider) * (1 - rowMeans(lider)) / R),
                           top10 = rowMeans(top10), top10_sd = apply(top10, 1, sd) / sqrt(R))
print(transform(podsumowanie, lider = round(100 * lider, 1), blad_mc = round(100 * blad_mc, 1),
                top10 = round(top10, 2), top10_sd = round(top10_sd, 2)), row.names = FALSE)
c(m_mediana = round(median(m_est), 1), m_kwartyl_1 = round(unname(quantile(m_est, .25)), 1),
  m_kwartyl_3 = round(unname(quantile(m_est, .75)), 1),
  sekundy = round(as.numeric(difftime(Sys.time(), t0, units = "secs"))))

# Rysunek 5: pięć metod, dwie miary
pm <- podsumowanie[1:5, ]
pm$metoda <- factor(pm$metoda, levels = rev(pm$metoda))
pm$typ <- ifelse(grepl("^średnia$|≥ 10", pm$metoda), "średnia (z progiem lub bez)", "metoda uwzględniająca liczbę opinii")
wsp <- list(geom_point(aes(colour = typ, shape = typ), size = 3.4),
            scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), name = NULL),
            scale_shape_manual(values = c(16, 17), name = NULL), motyw,
            theme(panel.grid.major.y = element_blank()))
p5a <- ggplot(pm, aes(100 * lider, metoda)) +
  geom_errorbar(orientation = "y", aes(xmin = 100 * (lider - 1.96 * blad_mc), xmax = 100 * (lider + 1.96 * blad_mc)),
                 width = 0.25, colour = "grey50") + wsp +
  geom_text(aes(label = sprintf("%.1f%%", 100 * lider)), vjust = -1.1, size = 3.6, colour = "grey20") +
  scale_x_continuous(limits = c(0, 50)) +
  labs(x = "Lider = naprawdę najlepszy (% sklepów)", y = NULL, title = "Kto wygrywa?")
p5b <- ggplot(pm, aes(top10, metoda)) +
  geom_errorbar(orientation = "y", aes(xmin = top10 - 1.96 * top10_sd, xmax = top10 + 1.96 * top10_sd),
                 width = 0.25, colour = "grey50") + wsp +
  geom_text(aes(label = sprintf("%.2f", top10)), vjust = -1.1, size = 3.6, colour = "grey20") +
  scale_x_continuous(limits = c(0, 10), breaks = seq(0, 10, 2)) +
  labs(x = "Trafione z prawdziwej top 10 (średnio)", y = NULL, title = "Kto jest w czołówce?") +
  theme(axis.text.y = element_blank())
p5 <- (p5a | p5b) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p5   # zapis: ggsave("oceny-gwiazdkowe-symulacja-1000-sklepow.svg", p5, width = 10, height = 5.6)

# Rysunek 6: ile opinii pozornych dodać? Trafność w funkcji m
pg <- podsumowanie[c(1, grep("^m=", podsumowanie$metoda)), ]     # pierwszy wiersz: zwykła średnia (m = 0)
pg$m <- c(0, m_siatka)
pg$x <- seq_len(nrow(pg))
p6 <- ggplot(pg, aes(x, 100 * lider)) +
  annotate("rect", xmin = approx(pg$m, pg$x, quantile(m_est, .25))$y,
           xmax = approx(pg$m, pg$x, quantile(m_est, .75))$y, ymin = -Inf, ymax = Inf, fill = "grey90") +
  annotate("text", x = approx(pg$m, pg$x, median(m_est))$y, y = 3,
           label = "typowe m\nszacowane z danych", size = 3.5, colour = "grey30", lineheight = 0.95) +
  geom_line(colour = kol[["cynober"]], linewidth = 0.9) +
  geom_errorbar(aes(ymin = 100 * (lider - 1.96 * blad_mc), ymax = 100 * (lider + 1.96 * blad_mc)),
                width = 0.15, colour = "grey50") +
  geom_point(colour = kol[["cynober"]], size = 3) +
  geom_text(aes(label = sprintf("%.1f", 100 * lider)), nudge_x = 0.3, vjust = 1.4, size = 3.6, colour = "grey20") +
  scale_x_continuous(breaks = pg$x, labels = pg$m) +
  scale_y_continuous(limits = c(0, 50)) +
  labs(x = "m – liczba „opinii pozornych” ze średnią sklepu (m = 0: zwykła średnia)",
       y = "Lider = naprawdę najlepszy (% sklepów)",
       title = "Za mało ściągania to ranking szczęściarzy, za dużo – ranking popularności",
       subtitle = sprintf("%d symulowanych sklepów po 80 produktów; odcinki: 95%% przedział błędu Monte Carlo", R)) +
  motyw
p6   # zapis: ggsave("oceny-gwiazdkowe-ile-wygladzania.svg", p6, width = 10, height = 5.6)
Wynik w R
                          metoda lider blad_mc top10 top10_sd
                         średnia   3.2     0.6  3.97     0.05
      średnia, tylko ≥ 10 opinii  19.6     1.3  6.04     0.04
          dolna granica średniej  28.1     1.4  5.60     0.04
           dolna granica Wilsona  28.6     1.4  5.40     0.04
 średnia wygładzona (m z danych)  33.3     1.5  6.06     0.04
                             m=1  21.6     1.3  5.18     0.04
                             m=2  28.3     1.4  5.69     0.04
                             m=5  35.2     1.5  6.16     0.04
                            m=10  34.9     1.5  6.16     0.04
                            m=20  31.0     1.5  5.97     0.04
                            m=50  26.1     1.4  5.58     0.04
                           m=100  20.5     1.3  5.32     0.04
                           m=200  17.5     1.2  5.16     0.04
  m_mediana m_kwartyl_1 m_kwartyl_3     sekundy
        4.6         3.7         5.8         1.0
5. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy (kupujący / opinie; słupki / gwiazdki)" = c("#0072B2", "#E69F00"),
             "cynober – szary (top 10 wg średniej / pozostałe)" = c("#D55E00", "#737373"),
             "niebieski – cynober (metody w symulacji)" = c("#0072B2", "#D55E00"),
             "jasnoniebieski – jasnoszary (w prawdziwej top 10 / poza)" = c("#9FD0EE", "#EBEBEB"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                widzenie_typowe
niebieski – pomarańczowy (kupujący / opinie; słupki / gwiazdki)           120.2
cynober – szary (top 10 wg średniej / pozostałe)                           76.9
niebieski – cynober (metody w symulacji)                                  114.6
jasnoniebieski – jasnoszary (w prawdziwej top 10 / poza)                   24.8
czerwony – zielony (do unikania)                                          121.7
                                                                deuteranopia
niebieski – pomarańczowy (kupujący / opinie; słupki / gwiazdki)        121.5
cynober – szary (top 10 wg średniej / pozostałe)                        63.4
niebieski – cynober (metody w symulacji)                               108.3
jasnoniebieski – jasnoszary (w prawdziwej top 10 / poza)                25.4
czerwony – zielony (do unikania)                                        21.1
                                                                protanopia
niebieski – pomarańczowy (kupujący / opinie; słupki / gwiazdki)      109.3
cynober – szary (top 10 wg średniej / pozostałe)                      53.8
niebieski – cynober (metody w symulacji)                              91.9
jasnoniebieski – jasnoszary (w prawdziwej top 10 / poza)              21.0
czerwony – zielony (do unikania)                                      31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, rozkłady, rangi i korelacja Spearmana – pakiety base i stats). Rysunki wykonano w ggplot2 (osie procentowe – pakiet scales, panele rysunku 5 – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking według surowej średniej. Wygrywają produkty z jedną–trzema piątkami. Następne opinie zwykle sprowadzą je w dół – to regresja do średniej, a nie „pogorszenie jakości”.
- Opinie jako głos wszystkich klientów. Piszą głównie zachwyceni i rozczarowani (rysunek 1). Średnia opinii jest obciążonym estymatorem jakości, a klienci tylko częściowo to korygują (Hu i in., 2017).
- Fałszywe opinie. Kilka opinii wystawionych przez sprzedawcę lub konkurencję najmocniej zmienia średnią małych produktów – średnia wygładzona trochę to tłumi, ale nie zastąpi weryfikacji zakupu.
- Gwiazdki jak liczby. Oceny 1–5 to skala porządkowa: średnia 4.0 może oznaczać same czwórki albo 75% piątek i 25% jedynek. Traktowanie danych porządkowych jak metrycznych bywa źródłem fałszywych alarmów, a nawet odwrócenia kierunku efektów (Liddell i Kruschke, 2018). Pokazuj cały rozkład gwiazdek, a w pracy rozważ odsetek ocen 4–5 albo regresję porządkową. Dyskusję „średnia czy mediana” streszcza wpis skala Likerta: średnia czy mediana?.
- Wiele porównań naraz. Przy 80 produktach kilka wyjdzie poza granice 95% przypadkiem – to problem wielokrotnych porównań. Używaj granic 99.8% albo poprawki.
Jeśli oprócz gwiazdek masz oceny marek na wielu cechach, zajrzyj do wpisu mapa percepcji marek. Pomoc w takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak porównać produkty z różną liczbą opinii?
Nie porównuj samych średnich. Użyj miary, która uwzględnia liczbę opinii: dolnej granicy przedziału Wilsona dla odsetka ocen 4–5 albo średniej wygładzonej do średniej sklepu. W przykładzie garnek z trzema piątkami był 1. według średniej, ale 45. według dolnej granicy Wilsona (43.8% wobec 86.6% dla tarki z 397 opiniami).
Co to jest dolna granica przedziału Wilsona w rankingu ocen?
To dolny koniec 95% przedziału ufności Wilsona dla odsetka zadowolonych klientów, np. ocen 4–5 gwiazdek. Mówi: „co najmniej tyle klientów jest zadowolonych”. Przy kilku opiniach przedział jest szeroki, więc dolna granica jest niska, a przy setkach opinii zbliża się do zaobserwowanego odsetka. Przedział Wilsona ma dobre pokrycie także przy małych próbach (Agresti i Coull, 1998).
Ile opinii pozornych dodać w średniej wygładzonej?
Liczbę m można oszacować z danych jako iloraz wariancji ocen w obrębie produktów i wariancji średnich między produktami – w przykładzie wyszło m = 3.9. W symulacji najlepiej działało m od 5 do 10, ale szczyt był płaski. Zbyt małe m nagradza produkty z kilkoma piątkami, zbyt duże – produkty po prostu popularne.
Dlaczego opinie w sklepach internetowych są prawie same pięciogwiazdkowe?
Opinie piszą głównie klienci bardzo zadowoleni i bardzo niezadowoleni, a produkt kupują częściej osoby do niego przychylnie nastawione. Daje to rozkład w kształcie litery J i średnią, która nie jest wiernym obrazem jakości (Hu i in., 2017). W przykładzie wśród opinii było 71.4% piątek, a wśród wszystkich kupujących 56.2%.
Czy można liczyć średnią z ocen gwiazdkowych?
Oceny 1–5 to skala porządkowa, więc średnia zakłada równe odstępy między gwiazdkami. Do opisu pokazuj cały rozkład i odsetek ocen 4–5; do porównań grup rozważ regresję porządkową. Traktowanie danych porządkowych jak metrycznych może dawać fałszywe alarmy, a nawet odwrócić kierunek efektu (Liddell i Kruschke, 2018).
Powiązane hasła
Przeczytaj też
NPS – przedział ufności i porównania
Przedział ufności NPS ze wzoru i bootstrapu, liczba ankiet do wykrycia zmiany i porównanie dwóch NPS na przykładzie salonów optycznych – z kodem R.
Czytaj →PoradnikMapa percepcji marek
Sześć marek, 10 cech: analiza korespondencji, pułapka wielkości marki, indeksy, biplot PCA z efektem halo i bootstrap mapy – sześć rysunków z kodem R.
Czytaj →PoradnikModel mieszany w obrazkach
Strzałki od średnich szkół do modelu, kurczenie a liczebność i ICC, wachlarz losowych nachyleń i wykres gąsienicowy – pięć rysunków z kodem R.
Czytaj →PoradnikCzas dostawy a ocena i ponowny zakup
Sklep z oświetleniem i 15 000 zamówień: opóźnienie względem obietnicy, GAM, próg z bootstrapu i koszt dnia opóźnienia – sześć rysunków z kodem R.
Czytaj →Masz w pracy oceny klientów albo opinie o produktach?
Pomożemy opisać rozkład ocen, porównać produkty z różną liczbą opinii, policzyć przedziały i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A., & Coull, B. A. (1998). Approximate is better than “exact” for interval estimation of binomial proportions. The American Statistician, 52(2), 119–126. https://doi.org/10.1080/00031305.1998.10480550
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Hu, N., Pavlou, P. A., & Zhang, J. (2017). On self-selection biases in online product reviews. MIS Quarterly, 41(2), 449–471. https://doi.org/10.25300/misq/2017/41.2.06
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- Powell, D., Yu, J., DeWolf, M., & Holyoak, K. J. (2017). The love of large numbers: A popularity bias in consumer choice. Psychological Science, 28(10), 1432–1442. https://doi.org/10.1177/0956797617711291
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
Cytowania BibTeX
@article{agresti1998approximate, author={Agresti, Alan and Coull, Brent A.}, title={{Approximate is better than “exact” for interval estimation of binomial proportions}}, journal={The American Statistician}, year={1998}, volume={52}, number={2}, pages={119--126}, doi={10.1080/00031305.1998.10480550}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{hu2017self, author={Hu, Nan and Pavlou, Paul A. and Zhang, Jie}, title={{On self-selection biases in online product reviews}}, journal={MIS Quarterly}, year={2017}, volume={41}, number={2}, pages={449--471}, doi={10.25300/misq/2017/41.2.06}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{powell2017love, author={Powell, Derek and Yu, Jingqi and DeWolf, Melissa and Holyoak, Keith J.}, title={{The love of large numbers: A popularity bias in consumer choice}}, journal={Psychological Science}, year={2017}, volume={28}, number={10}, pages={1432--1442}, doi={10.1177/0956797617711291}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}