Przykład: 15 000 zamówień lamp i opraw
Fikcyjny sklep internetowy z oświetleniem sprzedaje lampy, plafony, kinkiety, żyrandole i taśmy LED. Przy produkcie podaje termin dostawy: 2 dni dla towaru z magazynu, 5 dni dla towaru od dostawcy i 10 dni dla lamp robionych na zamówienie. Duże paczki (gabaryty, np. lampy podłogowe i żyrandole) jadą kurierem paletowym, więc dostają o dzień więcej. Dział e-commerce ma 15 000 zamówień z roku: obiecany i rzeczywisty czas dostawy, ocenę w gwiazdkach (1–5) i to, czy klient kupił ponownie w ciągu 6 miesięcy. Pytanie biznesowe: ile kosztuje spóźniona dostawa i od ilu dni opóźnienia robi się „za długo”?
Kluczowa zmienna to opóźnienie względem obietnicy: dzień dostawy minus obiecany dzień. Wartość ujemna oznacza dostawę przed terminem. To podejście wynika z modelu niepotwierdzenia oczekiwań: zadowolenie zależy od oczekiwań i od tego, czy rzeczywistość je potwierdziła (Oliver, 1980).
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy: 18% gabarytów; odsetki dostępności 70/22/8%; szansę spóźnienia rosnącą dla gabarytów i towaru spoza magazynu; ukryte zadowolenie klienta, które spada łagodnie przy 1 dniu opóźnienia, najszybciej przy 2 dniach i wypłaszcza się po około 5 dniach; ocenę wystawianą częściej przy skrajnym zadowoleniu lub niezadowoleniu; ponowny zakup zależny od zadowolenia, rzadszy u klientów gabarytów. Po pierwszym uruchomieniu wzmocniliśmy wpływ zadowolenia na ponowny zakup i różnicę między gabarytami a paczkami (wartości podajemy przy kodzie), bo krzywa była prawie prosta, a zakłócenie ledwo widoczne. Ziarna 708 nie zmienialiśmy. Dane pobierzesz jako dostawy-oswietlenie-15000-zamowien.csv.
Rysunek 1: obietnica kontra rzeczywistość
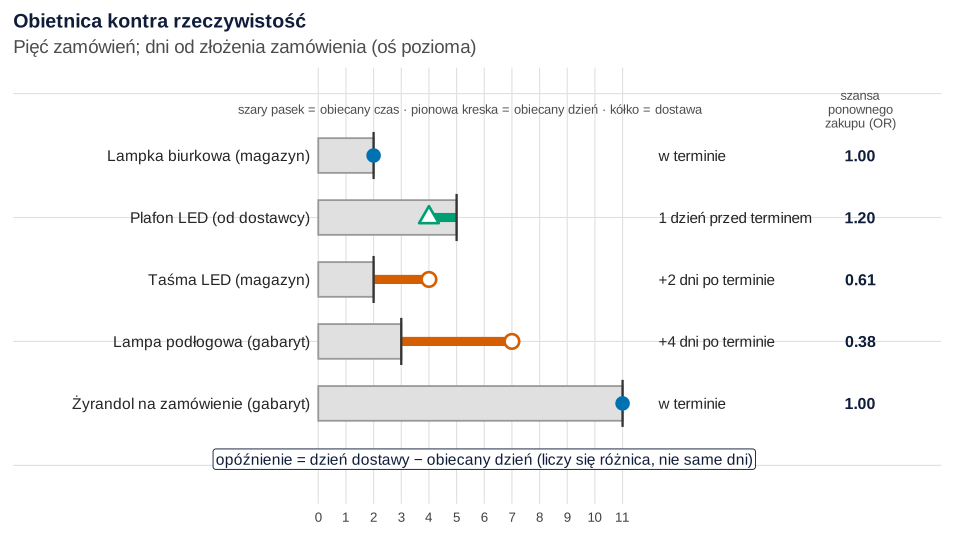
Co widać. Żyrandol jechał 11 dni, a taśma LED 4 dni, a mimo to to taśma jest porażką: przekroczyła obietnicę o 2 dni. Ostatnia kolumna pokazuje, co to znaczy dla sklepu. Przy 2 dniach spóźnienia szansa ponownego zakupu spada do 0.61 szansy przy dostawie w terminie, przy 4 dniach – do 0.38.
Jak może zmylić. Ilorazy szans dotyczą klienta „przeciętnego” po uwzględnieniu rodzaju paczki i dostępności. Pojedynczy klient może zareagować zupełnie inaczej.
Podpis do pracy:
Rysunek 2: kto się spóźnia
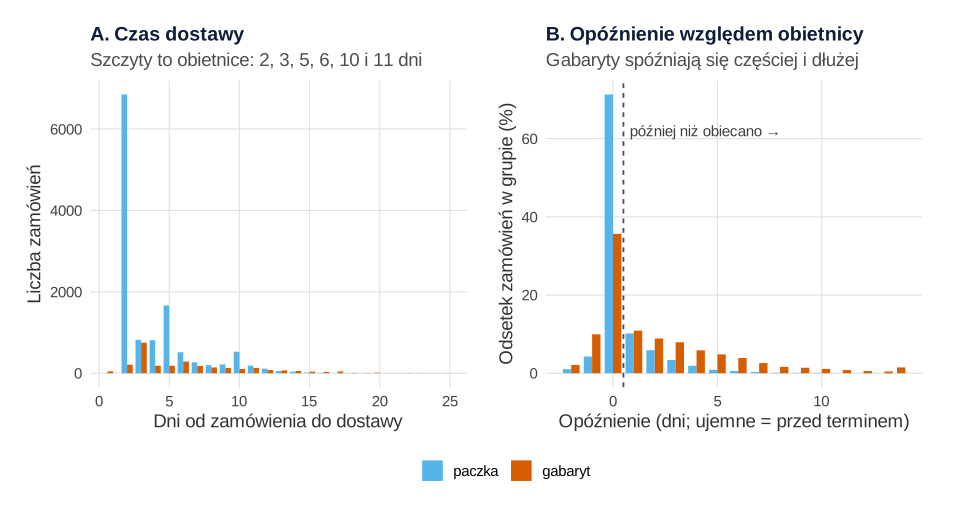
set.seed(708)).Co widać. Mediana czasu dostawy to 3 dni, średnia 4.27, zakres od 1 do 25 dni. W terminie doszło 64.9% zamówień, przed terminem 6.5%, a po terminie 28.6%; o co najmniej 3 dni spóźniło się 11.9%. Gabaryty spóźniają się ponad dwa razy częściej niż paczki (52.3% wobec 23.4%). Ocenę wystawiło tylko 3204 klientów (21.4%). Ponownie kupiło 23.8%: 26.4% klientów paczek i 12.1% klientów gabarytów.
Jak może zmylić. Z panelu A „długie dostawy” to zamówienia na 10–11 dni, choć większość z nich doszła w terminie. Zawód klienta pokazuje panel B. Druga pułapka: gabaryty i spóźniają się częściej, i kupują ponownie rzadziej. Porównanie bez ich uwzględnienia przypisze opóźnieniom część różnicy, która wynika z rodzaju klienta (rysunek 4).
Rysunek 3: ocena – i kto ją wystawia
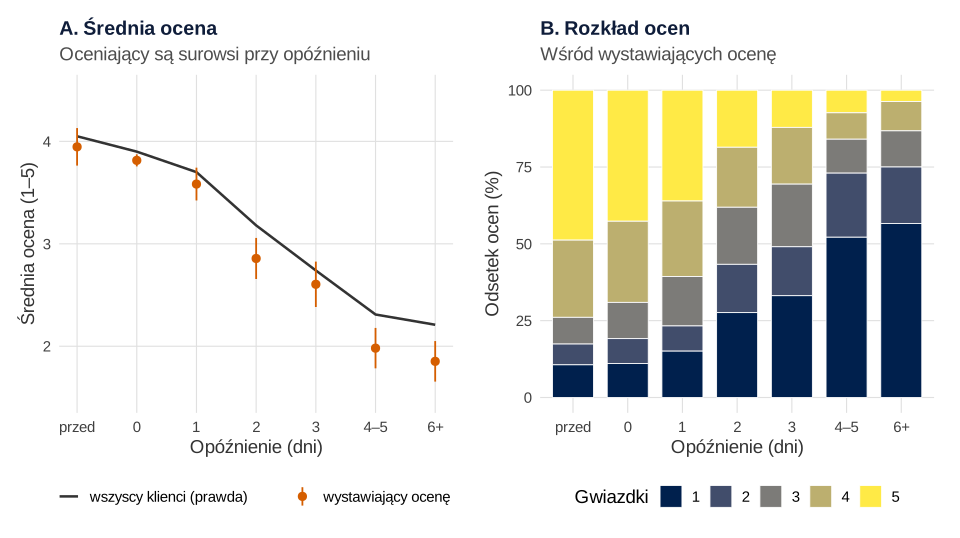
Co widać. Przy dostawie w terminie oceniający dają średnio 3.81, przy 2 dniach opóźnienia 2.86, a przy 6 i więcej dniach 1.85. Ocena 1–5 jest porządkowa, dlatego dopasowaliśmy GAM z rodziną porządkową (ocat w pakiecie mgcv), czyli regresję porządkową (McCullagh, 1980) ze splajnem opóźnienia. Dla paczki z magazynu przewidywana średnia spada z 3.82 (w terminie) do 3.49 (1 dzień), 3.00 (2 dni) i 2.50 (3 dni), a dalej zwalnia (1.87 przy 6 dniach). Szansa na 1–2 gwiazdki rośnie z 19% do 40% przy 2 dniach i 74% przy 6 dniach. Zwykły GAM liniowy daje prawie te same średnie (2.51 zamiast 2.50 przy 3 dniach), ale tylko porządkowy poda odsetek ocen 1–2.
Jak może zmylić. Ocenę wystawia mniejszość, a średnia z opinii to obciążony obraz jakości (Hu i in., 2017). Tu oceniający mają średnio 3.50, a wszyscy klienci 3.67. Przy 6+ dniach jedną gwiazdkę dało 56.6% oceniających, choć dałoby 43.1% wszystkich, bo zawiedzeni częściej piszą. Spadek oceny z opóźnieniem jest więc wśród oceniających wyraźniejszy niż w całej bazie. Więcej o tym zjawisku piszemy przy rankingu produktów z ocen gwiazdkowych i braku odpowiedzi w ankiecie po zakupie. Ponowny zakup widać za to u wszystkich 15 000 klientów, więc to on jest lepszą miarą skutków.
Zdanie do Wyników:
Rysunek 4: ponowny zakup i zakłócenie przez gabaryty
Ponowny zakup (tak/nie) modelujemy regresją logistyczną, w której opóźnienie wchodzi jako splajn. Model GAM to regresja z karanymi splajnami, która sama dobiera kształt krzywej (Wood, 2017); siłę kary za krzywiznę wybieramy metodą REML. Procedurę krok po kroku opisuje wpis splajny i GAM. Rodzaj paczki i dostępność dodajemy jako zmienne kontrolne.
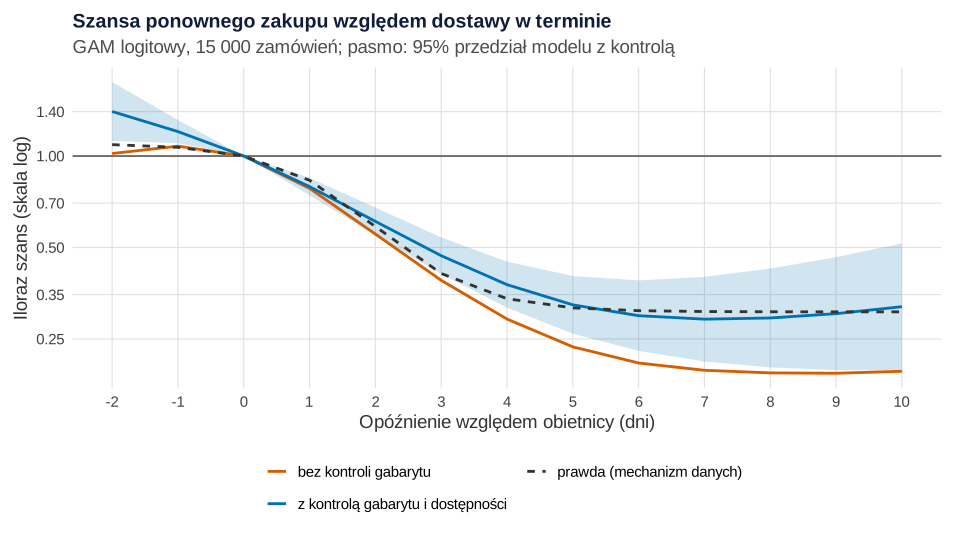
set.seed(7081)).Co widać. Splajn ma edf = 3.67 (p < .001), więc zależność wyraźnie nie jest prosta. Już 1 dzień opóźnienia obniża szansę ponownego zakupu: iloraz szans OR = 0.79 [0.74, 0.85]. Przy 2 dniach OR = 0.61 [0.55, 0.68], przy 4 dniach 0.38 [0.32, 0.45]. Od około 6 dni krzywa jest płaska (0.30). Dla paczki z magazynu to spadek z 28.9% przy dostawie w terminie do 19.9% przy 2 dniach i 13.3% przy 4 dniach. Dostawa dzień przed terminem daje OR = 1.20 [1.10, 1.31].
Jak może zmylić. Model bez kontroli gabarytu pokazuje OR = 0.29 przy 4 dniach i 0.21 przy 6, czyli za duży spadek. Prawda z mechanizmu danych to 0.34 i 0.31, a model z kontrolą daje 0.38 i 0.30. Rodzaj paczki jest tu zmienną zakłócającą: gabaryty częściej się spóźniają, a ich klienci i tak rzadziej wracają (OR = 0.46 dla gabarytu w modelu). Druga decyzja to sama miara. Model z czasem dostawy w dniach zamiast opóźnienia (z tymi samymi kontrolami) ma AIC = 16 010.8, a model z opóźnieniem 15 993.9 – lepszy o 17 punktów (AIC). Klient reaguje na złamaną obietnicę, nie na liczbę dni. Kontrola nie usuwa zakłóceń, których nie zmierzono, np. dodatkowego kontaktu z obsługą przy opóźnieniu.
Zdanie do Wyników:
Rysunek 5: próg „za długo” – dwa odcinki czy splajn
Zarząd chce jednej liczby: „ile dni spóźnienia klient jeszcze wybacza?”. Typową odpowiedzią jest regresja segmentowa: dwa proste odcinki połączone w punkcie załamania. Punkt ten szacuje się z danych (Muggeo, 2003). Pakiet segmented robi to automatycznie. My przeszukaliśmy siatkę punktów od 0 do 8 dni co 0.25 dnia i wybraliśmy ten o najmniejszej dewiancji, a niepewność oszacowaliśmy bootstrapem: 500 razy losowaliśmy zamówienia ze zwracaniem i od nowa szukaliśmy punktu.
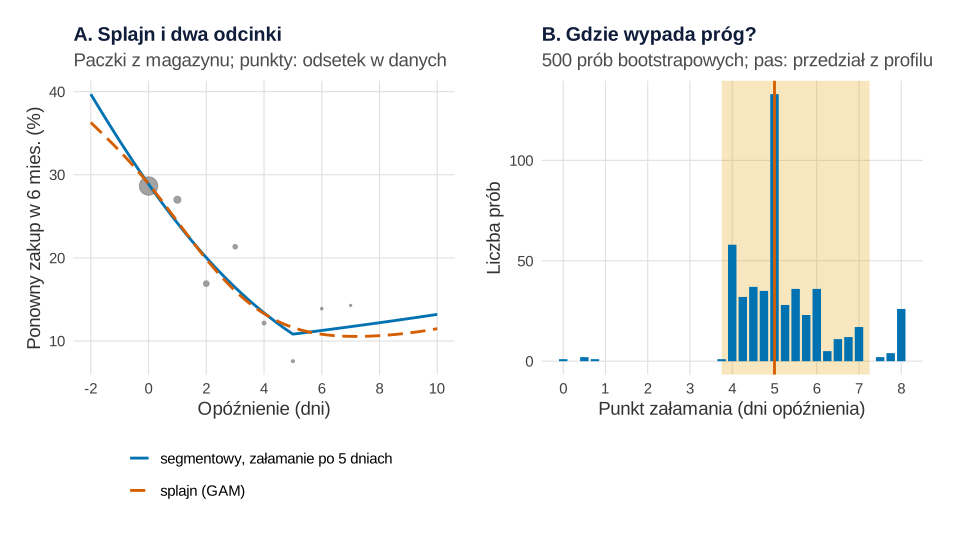
set.seed(7082)).Co widać. Model segmentowy postawił załamanie przy 5 dniach. Przedział z profilu wiarygodności to 3.75–7.25 dnia, a 95% przedział percentylowy z bootstrapu – od 4 do 8 dni (dokładniejsze odmiany, np. BCa, omawiają DiCiccio i Efron, 1996). Przed punktem załamania każdy dzień obniża szanse: OR = 0.785 na dzień. Po nim spadku już nie ma (1.046 na dzień). Dwa odcinki opisują dane lepiej niż jedna prosta (AIC 333.0 wobec 350.3, z karą za szacowany punkt).
Jak może zmylić. To nie jest „ile dni klient wybacza”. Pięć dni to miejsce, w którym szkoda się kończy, bo klient jest już stracony, a nie miejsce, gdzie się zaczyna. Splajn spada najszybciej przy 1.9 dnia, a już 1 dzień kosztuje (rysunek 4). Prawdziwa zależność jest gładka, więc „próg” zależy od kształtu modelu: dwa odcinki muszą gdzieś postawić załamanie, nawet gdy go nie ma. Bezpiecznego zapasu po obiecanym terminie dane nie pokazują. Podając próg, podaj przedział i pokaż splajn obok. O regresji segmentowej w czasie piszemy przy przerwanym szeregu czasowym.
Podpis do pracy:
Rysunek 6: ile kosztuje dzień opóźnienia
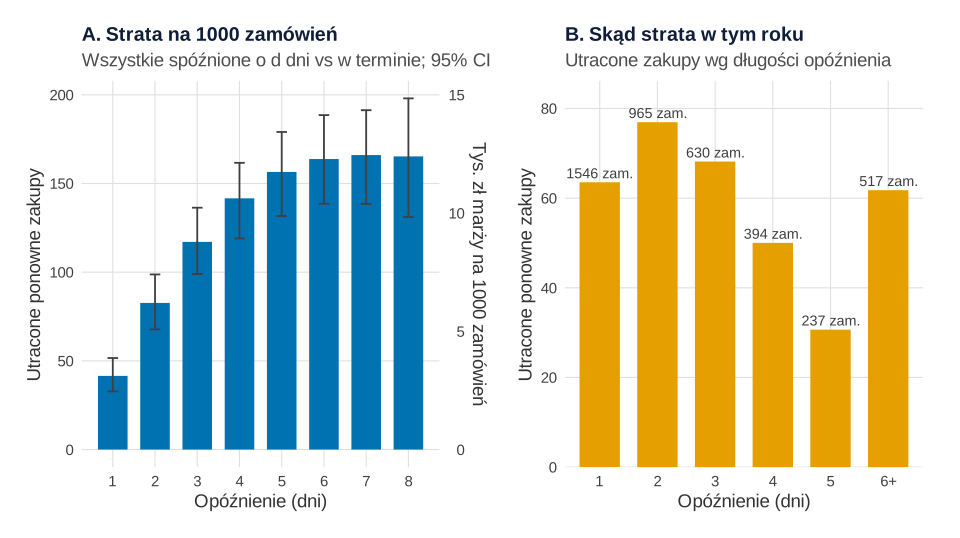
set.seed(7083)).Co widać. Z modelu z rysunku 4 liczymy scenariusze: wszystkie zamówienia dochodzą w terminie albo spóźniają się o d dni. Różnica to utracone ponowne zakupy. Jeden dzień kosztuje 41.5 [32.8, 51.6] zakupu na 1000 zamówień, trzy dni – 117.1 [99.0, 136.4]. Pierwsze dwa dni są najdroższe (po ok. 41 zakupów), czwarty – już 24.6, a po szóstym kolejne dni prawie nic nie zmieniają. Przy ręcznie przyjętej marży 75 zł z ponownego zamówienia pierwszy dzień to ok. 3.1 tys. zł na 1000 zamówień. W danych spóźniło się 4289 zamówień. Kosztowało to 351 [301, 405] ponownych zakupów, czyli ok. 26.3 tys. zł marży [22.6, 30.4] w skali roku. Ten wynik dotyczy tylko pierwszego ponownego zakupu, bez dalszej wartości klienta (CLV).
Jak może zmylić. Panel A kusi, by walczyć z długimi opóźnieniami, bo każde boli najbardziej. Panel B pokazuje jednak, że 59% strat (18.1 + 21.9 + 19.4%) dały opóźnienia o 1–3 dni, bo jest ich dużo. Koszt to wynik modelu obserwacyjnego, a nie eksperymentu. Jeśli opóźnienia zbiegają się z czymś niezmierzonym, np. awarią strony albo zmianą kuriera w sezonie, część straty wynika z tej drugiej przyczyny. Rao i in. (2011) na danych sklepu internetowego pokazali, że po opóźnieniu realizacji lojalni klienci zamawiają rzadziej i mniej.
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Obiecuj termin, który dotrzymasz. Klient ocenia rozbieżność, nie dni: żyrandol w 11 dni zgodnie z obietnicą nie szkodzi, taśma LED 2 dni po terminie szkodzi. Dla gabarytów (52.3% spóźnionych) uczciwsza obietnica to pierwszy kandydat do zmiany. Krótsza obietnica może jednak zmniejszyć sprzedaż, więc sprawdź ją w teście A/B.
- Walcz z małymi opóźnieniami. Opóźnienia o 1–3 dni dały 59% strat. Wybór kuriera i godzina zamknięcia magazynu mogą dać więcej niż gaszenie pojedynczych skrajnych przypadków.
- Przy opóźnieniu reaguj od pierwszego dnia. Dane nie pokazują bezpiecznego zapasu. Wiadomość z nowym terminem albo kupon testuj na losowej połowie spóźnionych zamówień. Komu kupon się opłaca, pokazuje modelowanie uplift.
- Nie mierz skutków samą średnią z gwiazdek. Ocenia 21% klientów i to nie przypadkowych. Do raportów weź ponowny zakup lub krótką ankietę z kontrolą braków odpowiedzi; to, który wskaźnik zadowolenia lepiej przewiduje odejście, porównujemy we wpisie CSAT, CES czy NPS.
- Licz koszt w złotówkach. 26 tys. zł marży rocznie z pierwszego ponownego zakupu to dolna granica straty. Porównaj ją z kosztem szybszego kuriera, podobnie jak koszt zwrotów w modelu odsetka zwrotów.
Inne tematy na pracę z tej dziedziny zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie zdefiniuj opóźnienie, modele, zmienne kontrolne i sposób szukania progu. W Wynikach podaj edf, ilorazy szans z przedziałami, próg z przedziałem i koszt. W Dyskusji wymień ograniczenia: dane obserwacyjne, oceny od części klientów, próg zależny od modelu.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 3 – model m_kontr i tabelę siatka, przepis 4 – funkcję agreguj() i dane zagregowane a. Przepisy z rysunkami kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki) – dane, geometrie i skale są identyczne.
Każdy losujący blok zaczyna od własnego ziarna: 708 (dane, przepis 1), 7081 (prawdziwa krzywa uśredniona po 200 000 losowaniach, przepis 3), 7082 (500 prób bootstrapowych progu, przepis 4) i 7083 (200 prób bootstrapowych kosztu, przepis 5). Ziaren nie dobieraliśmy pod wynik. Ręcznie ustalono (przepis 1): 15 000 zamówień, 18% gabarytów, dostępność 70/22/8%, obietnice 2/5/10 dni (+1 dla gabarytów), szansę spóźnienia (logit −1.4 + 1.3 dla gabarytu + 0.6 od dostawcy + 0.8 na zamówienie), długość spóźnienia (1 dzień + rozkład ujemny dwumianowy o średniej 1.3, a dla gabarytów 3.3; najwyżej 14 dni), dostawy przed terminem (25% zamówień z obietnicą powyżej 2 dni), krzywą zadowolenia g_ocena() i progi skali, skłonność do wystawienia oceny oraz model ponownego zakupu (logit −1.1 + 0.6 · zadowolenie − 0.9 dla gabarytu − 0.3 dla zamówień na zamówienie). Po pierwszym uruchomieniu zmieniono cztery wartości: wpływ zadowolenia na ponowny zakup (0.4 → 0.6), stałą (−1.0 → −1.1), efekt gabarytu na ponowny zakup (−0.7 → −0.9) oraz szansę i długość spóźnień gabarytów (0.9 → 1.3 w logicie i 1.5 → 2.0 dnia dodatku do średniej). Ręcznie przyjęto też siatkę punktów załamania (0–8 dni co 0.25), liczbę prób bootstrapowych (500 i 200) i marżę 75 zł z ponownego zamówienia. W jednej z 200 prób w przepisie 5 pakiet mgcv zgłosił ostrzeżenie o zbieżności; wynik tej próby zostawiliśmy. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około pół minuty.
1. Dane: 15 000 zamówień i rozkład opóźnień: Rysunek 2
R
# Przepis 1. Fikcyjny sklep internetowy z oświetleniem: 15 000 zamówień, obiecany termin, czas dostawy,
# ocena (1–5, tylko część klientów) i ponowny zakup w ciągu 6 miesięcy
library(ggplot2); library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", blekit = "#56B4E9",
         zielony = "#009E73", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Ręczne parametry (ustalone przed pierwszym uruchomieniem, opisane na stronie)
n <- 15000
g_ocena <- function(d) -2.5 * (plogis((d - 2) / 0.8) - plogis(-2 / 0.8))  # spadek zadowolenia z opóźnieniem (0 przy d = 0)
progi <- c(-2.6, -1.8, -0.9, 0.4)                    # progi skali 1–5 dla ukrytego zadowolenia
set.seed(708)                                        # ziarno ustalone raz, bez dobierania pod wynik
z <- data.frame(id = sprintf("Z%05d", 1:n),
                gabaryt = rbinom(n, 1, 0.18),        # 1 = duża paczka (lampa podłogowa, żyrandol), kurier paletowy
                dostepnosc = sample(c("magazyn", "dostawca", "na zamówienie"), n, TRUE, c(0.70, 0.22, 0.08)))
z$obietnica <- c(magazyn = 2, dostawca = 5, `na zamówienie` = 10)[z$dostepnosc] + z$gabaryt   # obiecane dni
z$wartosc <- round(exp(rnorm(n, log(ifelse(z$gabaryt == 1, 650, 180)), 0.55)))                 # wartość zamówienia (zł)
p_spoz <- plogis(-1.4 + 1.3 * z$gabaryt + 0.6 * (z$dostepnosc == "dostawca") + 0.8 * (z$dostepnosc == "na zamówienie"))
spoz <- rbinom(n, 1, p_spoz) == 1
wczes <- ifelse(runif(n) < 0.25 & z$obietnica > 2, -sample(1:2, n, TRUE, c(0.8, 0.2)), 0)    # dostawa przed terminem
z$opoznienie <- ifelse(spoz, pmin(14, 1 + rnbinom(n, mu = 1.3 + 2.0 * z$gabaryt, size = 1.2)), wczes)
z$dni <- z$obietnica + z$opoznienie                  # rzeczywisty czas dostawy w dniach

# Ukryte zadowolenie każdego klienta i ocena, którą by wystawił (znamy ją dla wszystkich, bo dane są fikcyjne)
z$zadow <- g_ocena(z$opoznienie) + 0.3 * (z$dostepnosc == "na zamówienie") + rlogis(n)
z$ocena_kazdego <- findInterval(z$zadow, progi) + 1
# Ocenę wystawia mniejszość, częściej przy skrajnym zadowoleniu lub niezadowoleniu
p_ocena <- plogis(-1.6 + c(0.9, 0.5, 0, 0, 0.4)[z$ocena_kazdego])
z$ocena <- ifelse(runif(n) < p_ocena, z$ocena_kazdego, NA)
# Ponowny zakup w ciągu 6 miesięcy: zależy od zadowolenia; klienci gabarytów i zamówień na zamówienie kupują rzadziej
z$ponowny <- rbinom(n, 1, plogis(-1.1 + 0.6 * z$zadow - 0.9 * z$gabaryt - 0.3 * (z$dostepnosc == "na zamówienie")))
z$zadow <- NULL
write.csv(z[, setdiff(names(z), "ocena_kazdego")], "dostawy-oswietlenie-15000-zamowien.csv", row.names = FALSE)

cat("Zamówień:", n, "| gabaryty:", sum(z$gabaryt), sprintf("(%.1f%%)", 100 * mean(z$gabaryt)), "\n")
print(table(dostepnosc = z$dostepnosc, obietnica_dni = z$obietnica))
cat(sprintf("Opóźnionych: %.1f%% | przed terminem: %.1f%% | dokładnie w terminie: %.1f%%\n",
            100 * mean(z$opoznienie > 0), 100 * mean(z$opoznienie < 0), 100 * mean(z$opoznienie == 0)))
cat(sprintf("Opóźnionych o 3 dni lub więcej: %.1f%% | maksimum: %d dni\n", 100 * mean(z$opoznienie >= 3), max(z$opoznienie)))
cat(sprintf("Odsetek opóźnionych: paczki %.1f%%, gabaryty %.1f%%\n",
            100 * mean(z$opoznienie[z$gabaryt == 0] > 0), 100 * mean(z$opoznienie[z$gabaryt == 1] > 0)))
cat("Czas dostawy (dni): mediana", median(z$dni), "| średnia", round(mean(z$dni), 2), "| zakres", range(z$dni), "\n")
cat(sprintf("Ocenę wystawiło: %d klientów (%.1f%%)\n", sum(!is.na(z$ocena)), 100 * mean(!is.na(z$ocena))))
cat(sprintf("Ponowny zakup w 6 mies.: %.1f%% (paczki %.1f%%, gabaryty %.1f%%)\n", 100 * mean(z$ponowny),
            100 * mean(z$ponowny[z$gabaryt == 0]), 100 * mean(z$ponowny[z$gabaryt == 1])))

# Rysunek 2: rozkład czasu dostawy i opóźnienia względem obietnicy
z$rodzaj <- factor(ifelse(z$gabaryt == 1, "gabaryt", "paczka"), c("paczka", "gabaryt"))
p2a <- ggplot(z, aes(dni, fill = rodzaj)) +
  geom_bar(position = position_dodge(preserve = "single"), width = 0.8) +
  scale_fill_manual(values = c(paczka = kol[["blekit"]], gabaryt = kol[["cynober"]]), name = NULL) +
  labs(title = "A. Czas dostawy", subtitle = "Szczyty to obietnice: 2, 3, 5, 6, 10 i 11 dni",
       x = "Dni od zamówienia do dostawy", y = "Liczba zamówień") + motyw
odsetki <- aggregate(list(n = z$id), list(rodzaj = z$rodzaj, opoznienie = z$opoznienie), length)
odsetki$proc <- 100 * odsetki$n / ave(odsetki$n, odsetki$rodzaj, FUN = sum)
p2b <- ggplot(odsetki, aes(opoznienie, proc, fill = rodzaj)) +
  geom_col(position = position_dodge(preserve = "single"), width = 0.8) +
  geom_vline(xintercept = 0.5, linetype = "22", colour = "grey30") +
  annotate("text", x = 0.8, y = 62, label = "później niż obiecano →", hjust = 0, size = 4, colour = "grey25") +
  scale_fill_manual(values = c(paczka = kol[["blekit"]], gabaryt = kol[["cynober"]]), name = NULL) +
  labs(title = "B. Opóźnienie względem obietnicy", subtitle = "Gabaryty spóźniają się częściej i dłużej",
       x = "Opóźnienie (dni; ujemne = przed terminem)", y = "Odsetek zamówień w grupie (%)") + motyw
p2 <- p2a + p2b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p2   # zapis: ggsave("oswietlenie-rozklady.svg", p2, width = 10, height = 5.4)
Wynik w R
Zamówień: 15000 | gabaryty: 2701 (18.0%)
               obietnica_dni
dostepnosc         2    3    5    6   10   11
  dostawca         0    0 2741  584    0    0
  magazyn       8527 1873    0    0    0    0
  na zamówienie    0    0    0    0 1031  244
Opóźnionych: 28.6% | przed terminem: 6.5% | dokładnie w terminie: 64.9%
Opóźnionych o 3 dni lub więcej: 11.9% | maksimum: 14 dni
Odsetek opóźnionych: paczki 23.4%, gabaryty 52.3%
Czas dostawy (dni): mediana 3 | średnia 4.27 | zakres 1 25
Ocenę wystawiło: 3204 klientów (21.4%)
Ponowny zakup w 6 mies.: 23.8% (paczki 26.4%, gabaryty 12.1%)
2. Ocena zamówienia: kto ocenia, GAM porządkowy i liniowy: Rysunek 3
R
# Przepis 2. Ocena zamówienia (1–5) a opóźnienie: kto ocenia, GAM porządkowy i liniowy
library(mgcv)
oc <- subset(z, !is.na(ocena))                       # tylko klienci, którzy wystawili ocenę
z$grupa <- cut(z$opoznienie, c(-Inf, -1, 0, 1, 2, 3, 5, Inf),
               labels = c("przed", "0", "1", "2", "3", "4–5", "6+"))
oc$grupa <- z$grupa[!is.na(z$ocena)]

# Kto ocenia? Odsetek wystawiających i średnia ocena: oceniający vs wszyscy klienci (znamy ją, bo dane są fikcyjne)
tab <- do.call(rbind, lapply(split(z, z$grupa), function(d) data.frame(
  grupa = d$grupa[1], zamowien = nrow(d), ocenilo_proc = round(100 * mean(!is.na(d$ocena)), 1),
  srednia_ocen = round(mean(d$ocena, na.rm = TRUE), 2), srednia_wszystkich = round(mean(d$ocena_kazdego), 2),
  proc_1_gw_oceniajacy = round(100 * mean(d$ocena == 1, na.rm = TRUE), 1),
  proc_1_gw_wszyscy = round(100 * mean(d$ocena_kazdego == 1), 1))))
print(tab, row.names = FALSE)
cat(sprintf("Średnia ocena: oceniający %.2f, wszyscy klienci %.2f\n", mean(oc$ocena), mean(z$ocena_kazdego)))

# GAM porządkowy (family = ocat, 5 kategorii) i zwykły GAM liniowy na tych samych danych
m_ocat <- gam(ocena ~ s(opoznienie, k = 8) + gabaryt + dostepnosc, family = ocat(R = 5), data = oc, method = "REML")
m_lin  <- gam(ocena ~ s(opoznienie, k = 8) + gabaryt + dostepnosc, data = oc, method = "REML")
cat(sprintf("Porządkowy: edf = %.2f, p dla s(opóźnienie) %s | liniowy: edf = %.2f\n",
            summary(m_ocat)$s.table[1, "edf"], format.pval(summary(m_ocat)$s.table[1, "p-value"], eps = 0.001),
            summary(m_lin)$s.table[1, "edf"]))
nowe <- data.frame(opoznienie = -2:10, gabaryt = 0, dostepnosc = "magazyn")   # paczka z magazynu
pr <- predict(m_ocat, nowe, type = "response")       # prawdopodobieństwa 1–5 gwiazdek
nowe$sr_porzadkowy <- as.numeric(pr %*% 1:5)
nowe$p_1_2_gw <- pr[, 1] + pr[, 2]
nowe$sr_liniowy <- as.numeric(predict(m_lin, nowe))
print(round(nowe[nowe$opoznienie %in% c(-1, 0, 1, 2, 3, 4, 6, 10), c("opoznienie", "sr_porzadkowy", "sr_liniowy", "p_1_2_gw")], 2),
      row.names = FALSE)

# Rysunek 3: A – średnie ocen (oceniający z 95% CI, wszyscy klienci, dwa modele); B – rozkład gwiazdek wśród oceniających
sr <- do.call(rbind, lapply(split(oc, oc$grupa), function(d) {
  s <- sd(d$ocena) / sqrt(nrow(d)); data.frame(grupa = d$grupa[1], m = mean(d$ocena), d = mean(d$ocena) - 1.96 * s,
                                               g = mean(d$ocena) + 1.96 * s) }))
sr$wszyscy <- tab$srednia_wszystkich
p3a <- ggplot(sr, aes(as.numeric(grupa))) +
  geom_line(aes(y = wszyscy, linetype = "wszyscy klienci (prawda)"), colour = kol[["ciemny"]], linewidth = 0.9) +
  geom_pointrange(aes(y = m, ymin = d, ymax = g, shape = "wystawiający ocenę"), colour = kol[["cynober"]], size = 0.6) +
  scale_x_continuous(breaks = 1:7, labels = levels(sr$grupa)) +
  scale_shape_manual(values = c(`wystawiający ocenę` = 16), name = NULL) +
  scale_linetype_manual(values = c(`wszyscy klienci (prawda)` = "solid"), name = NULL) +
  coord_cartesian(ylim = c(1.5, 4.5)) +
  labs(title = "A. Średnia ocena", subtitle = "Oceniający są surowsi przy opóźnieniu",
       x = "Opóźnienie (dni)", y = "Średnia ocena (1–5)") + motyw + theme(legend.direction = "vertical")
rozk <- as.data.frame(prop.table(table(grupa = oc$grupa, gwiazdki = factor(oc$ocena, 5:1)), 1))
p3b <- ggplot(rozk, aes(grupa, 100 * Freq, fill = gwiazdki)) + geom_col(width = 0.75, colour = "white", linewidth = 0.3) +
  scale_fill_manual(values = setNames(viridisLite::cividis(5, direction = -1), 5:1), name = "Gwiazdki") +
  guides(fill = guide_legend(nrow = 1, reverse = TRUE)) +
  labs(title = "B. Rozkład ocen", subtitle = "Wśród wystawiających ocenę",
       x = "Opóźnienie (dni)", y = "Odsetek ocen (%)") + motyw
p3 <- p3a + p3b
p3   # zapis: ggsave("oswietlenie-oceny.svg", p3, width = 10, height = 5.6)
Wynik w R
 grupa zamowien ocenilo_proc srednia_ocen srednia_wszystkich proc_1_gw_oceniajacy proc_1_gw_wszyscy
 przed      979         21.1         3.95               4.05                 10.6               6.3
     0     9732         20.8         3.81               3.90                 11.1               7.1
     1     1546         19.7         3.58               3.70                 15.1               9.2
     2      965         21.8         2.86               3.18                 27.6              17.3
     3      630         24.9         2.61               2.74                 33.1              27.0
   4–5      631         25.8         1.98               2.31                 52.1              40.6
    6+      517         26.3         1.85               2.21                 56.6              43.1
Średnia ocena: oceniający 3.50, wszyscy klienci 3.67
Porządkowy: edf = 4.87, p dla s(opóźnienie) < 0.001 | liniowy: edf = 5.11
 opoznienie sr_porzadkowy sr_liniowy p_1_2_gw
         -1          3.96       3.96     0.16
          0          3.82       3.82     0.19
          1          3.49       3.49     0.26
          2          3.00       3.00     0.40
          3          2.50       2.51     0.54
          4          2.15       2.14     0.65
          6          1.87       1.83     0.74
         10          1.81       1.82     0.76
3. Ponowny zakup: GAM logitowy, zakłócenie i dni zamiast opóźnienia: Rysunek 4
R
# Przepis 3. Ponowny zakup w 6 miesięcy a opóźnienie: GAM logitowy, zakłócenie przez gabaryty, dni czy opóźnienie
library(mgcv)
m_naiwny <- gam(ponowny ~ s(opoznienie, k = 10), family = binomial, data = z, method = "REML")
m_kontr  <- gam(ponowny ~ s(opoznienie, k = 10) + gabaryt + dostepnosc, family = binomial, data = z, method = "REML")
m_dni    <- gam(ponowny ~ s(dni, k = 10) + gabaryt + dostepnosc, family = binomial, data = z, method = "REML")
print(round(summary(m_kontr)$p.table, 3))
cat(sprintf("s(opóźnienie): edf = %.2f, %s\n", summary(m_kontr)$s.table[1, "edf"],
            format.pval(summary(m_kontr)$s.table[1, "p-value"], eps = 0.001)))
cat("AIC: model z opóźnieniem", round(AIC(m_kontr), 1), "| model z dniami dostawy", round(AIC(m_dni), 1),
    sprintf("| s(dni): edf = %.2f\n", summary(m_dni)$s.table[1, "edf"]))
# Modelu z oboma splajnami nie dopasowujemy: dni = obietnica + opóźnienie, a obietnicę wyznaczają gabaryt i dostępność

# Iloraz szans ponownego zakupu względem dostawy w terminie (opóźnienie 0) z 95% przedziałem
siatka <- data.frame(opoznienie = -2:10, gabaryt = 0, dostepnosc = "magazyn")
X <- predict(m_kontr, siatka, type = "lpmatrix"); X0 <- X[siatka$opoznienie == 0, ]
Xr <- sweep(X, 2, X0)                                # różnica logitów względem d = 0
siatka$lor <- as.numeric(Xr %*% coef(m_kontr))
siatka$se <- sqrt(rowSums((Xr %*% vcov(m_kontr)) * Xr))
siatka$lor_naiwny <- as.numeric(predict(m_naiwny, siatka)) - as.numeric(predict(m_naiwny, data.frame(opoznienie = 0)))
# Prawda z mechanizmu generującego (paczka z magazynu), uśredniona po ukrytym zadowoleniu
set.seed(7081)
e <- rlogis(2e5)
p_prawda <- sapply(-2:10, function(d) mean(plogis(-1.1 + 0.6 * (g_ocena(d) + e))))
siatka$lor_prawda <- qlogis(p_prawda) - qlogis(p_prawda[3])
siatka$p_model <- as.numeric(predict(m_kontr, siatka, type = "response"))
print(round(data.frame(opoznienie = siatka$opoznienie, OR_model = exp(siatka$lor),
                       OR_d = exp(siatka$lor - 1.96 * siatka$se), OR_g = exp(siatka$lor + 1.96 * siatka$se),
                       OR_naiwny = exp(siatka$lor_naiwny), OR_prawda = exp(siatka$lor_prawda),
                       p_paczka_magazyn = siatka$p_model)[siatka$opoznienie %in% c(-1, 0, 1:6, 8, 10), ], 3), row.names = FALSE)

# Rysunek 4: krzywa ilorazu szans – model z kontrolą, model naiwny i prawda
dl <- rbind(data.frame(opoznienie = siatka$opoznienie, y = exp(siatka$lor_naiwny), model = "bez kontroli gabarytu"),
            data.frame(opoznienie = siatka$opoznienie, y = exp(siatka$lor), model = "z kontrolą gabarytu i dostępności"),
            data.frame(opoznienie = siatka$opoznienie, y = exp(siatka$lor_prawda), model = "prawda (mechanizm danych)"))
dl$model <- factor(dl$model, unique(dl$model))
p4 <- ggplot(dl, aes(opoznienie, y)) +
  geom_ribbon(data = siatka, aes(opoznienie, ymin = exp(lor - 1.96 * se), ymax = exp(lor + 1.96 * se)),
              inherit.aes = FALSE, fill = kol[["niebieski"]], alpha = 0.18) +
  geom_hline(yintercept = 1, colour = "grey40") +
  geom_line(aes(colour = model, linetype = model), linewidth = 1) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]], kol[["ciemny"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "22"), name = NULL) +
  scale_y_log10(breaks = c(0.25, 0.35, 0.5, 0.7, 1, 1.4)) + scale_x_continuous(breaks = -2:10) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Szansa ponownego zakupu względem dostawy w terminie",
       subtitle = "GAM logitowy, 15 000 zamówień; pasmo: 95% przedział modelu z kontrolą",
       x = "Opóźnienie względem obietnicy (dni)", y = "Iloraz szans (skala log)") + motyw
p4   # zapis: ggsave("oswietlenie-ponowny-zakup.svg", p4, width = 10, height = 5.6)
Wynik w R
                        Estimate Std. Error z value Pr(>|z|)
(Intercept)               -1.160      0.043 -26.674    0.000
gabaryt                   -0.766      0.065 -11.734    0.000
dostepnoscmagazyn          0.103      0.049   2.094    0.036
dostepnoscna zamówienie   -0.031      0.081  -0.384    0.701
s(opóźnienie): edf = 3.67, < 0.001
AIC: model z opóźnieniem 15993.9 | model z dniami dostawy 16010.8 | s(dni): edf = 1.15
 opoznienie OR_model  OR_d  OR_g OR_naiwny OR_prawda p_paczka_magazyn
         -1    1.203 1.102 1.314     1.078     1.068            0.328
          0    1.000 1.000 1.000     1.000     1.000            0.289
          1    0.793 0.742 0.847     0.782     0.832            0.244
          2    0.609 0.549 0.677     0.553     0.586            0.199
          3    0.470 0.409 0.540     0.390     0.410            0.160
          4    0.377 0.317 0.449     0.291     0.339            0.133
          5    0.324 0.260 0.403     0.235     0.316            0.116
          6    0.298 0.228 0.390     0.208     0.310            0.108
          8    0.293 0.201 0.426     0.193     0.307            0.106
         10    0.319 0.197 0.516     0.196     0.307            0.115
4. Próg: regresja segmentowa, profil i bootstrap: Rysunek 5
R
# Przepis 4. Próg „za długo”: regresja segmentowa (siatka punktów załamania) kontra splajn, przedział z bootstrapu
# Dane zagregowane do komórek (opóźnienie × gabaryt × dostępność) – ta sama wiarygodność co dla 15 000 wierszy, ale szybciej
komorka <- interaction(z$opoznienie, z$gabaryt, z$dostepnosc, drop = TRUE)
agreguj <- function(i) {                             # i – numery zamówień (w bootstrapie losowane ze zwracaniem)
  k <- komorka[i]
  a <- data.frame(n = as.numeric(table(k)), tak = as.numeric(tapply(z$ponowny[i], k, sum)))
  a <- cbind(a, z[match(levels(k), komorka), c("opoznienie", "gabaryt", "dostepnosc")])
  a[a$n > 0, ]
}
dopasuj <- function(a, c) glm(cbind(tak, n - tak) ~ opoznienie + pmax(opoznienie - c, 0) + gabaryt + dostepnosc,
                              family = binomial, data = a)
kandydaci <- seq(0, 8, by = 0.25)                    # możliwe punkty załamania (dni opóźnienia)
a <- agreguj(seq_len(nrow(z)))
dev <- sapply(kandydaci, function(c) deviance(dopasuj(a, c)))
c_hat <- kandydaci[which.min(dev)]
prof <- kandydaci[dev <= min(dev) + qchisq(0.95, 1)] # przedział z profilu wiarygodności
m_seg <- dopasuj(a, c_hat)
b <- coef(m_seg)
cat(sprintf("Punkt załamania: %.2f dnia | przedział z profilu: %.2f–%.2f\n", c_hat, min(prof), max(prof)))
cat(sprintf("Nachylenie przed progiem: OR = %.3f na dzień | po progu: OR = %.3f na dzień\n",
            exp(b[2]), exp(b[2] + b[3])))
cat("Dewiancja przy progach 1, 2, 3, 4, 5 dni:", round(dev[match(1:5, kandydaci)] - min(dev), 1), "(różnica do minimum)\n")
m_lin <- glm(cbind(tak, n - tak) ~ opoznienie + gabaryt + dostepnosc, family = binomial, data = a)
cat(sprintf("AIC: prosta %.1f | segmentowa %.1f (+1 parametr za próg)\n", AIC(m_lin), AIC(m_seg) + 2))

# Bootstrap: 500 prób zamówień ze zwracaniem; w każdej od nowa szukamy progu
set.seed(7082)
c_boot <- replicate(500, { ab <- agreguj(sample(nrow(z), replace = TRUE))
  kandydaci[which.min(sapply(kandydaci, function(c) deviance(dopasuj(ab, c))))] })
cat(sprintf("Bootstrap (500 prób): mediana %.2f, 95%% przedział percentylowy %.2f–%.2f\n",
            median(c_boot), quantile(c_boot, 0.025), quantile(c_boot, 0.975)))
print(round(100 * prop.table(table(cut(c_boot, c(-0.1, 0.9, 1.9, 2.9, 3.9, 8.1),
                                       labels = c("0–0.75", "1–1.75", "2–2.75", "3–3.75", "4–8")))), 1))

# Splajn: gdzie krzywa GAM z przepisu 3 spada najszybciej?
gest <- data.frame(opoznienie = seq(-2, 10, by = 0.05), gabaryt = 0, dostepnosc = "magazyn")
lp <- as.numeric(predict(m_kontr, gest))
nachyl <- diff(lp) / 0.05
cat(sprintf("GAM: najszybszy spadek przy opóźnieniu %.2f dnia (%.3f logitu na dzień)\n",
            gest$opoznienie[which.min(nachyl)], min(nachyl)))

# Rysunek 5: A – odsetki ponownych zakupów (paczki z magazynu), splajn i model segmentowy; B – progi z bootstrapu
obs <- aggregate(cbind(tak = ponowny, n = 1) ~ opoznienie, data = subset(z, gabaryt == 0 & dostepnosc == "magazyn"), sum)
obs$p <- obs$tak / obs$n
krzywe <- rbind(data.frame(opoznienie = gest$opoznienie, p = plogis(lp), model = "splajn (GAM)"),
                data.frame(opoznienie = gest$opoznienie, p = as.numeric(predict(m_seg, gest, type = "response")),
                           model = paste("segmentowy, załamanie po", format(c_hat), "dniach")))
p5a <- ggplot(krzywe, aes(opoznienie, 100 * p)) +
  geom_point(data = subset(obs, n >= 20), aes(size = n), colour = kol[["szary"]], alpha = 0.8) +
  geom_line(aes(colour = model, linetype = model), linewidth = 1) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "42"), name = NULL) +
  scale_size_area(max_size = 6, guide = "none") + scale_x_continuous(breaks = seq(-2, 10, 2)) +
  coord_cartesian(xlim = c(-2, 10)) + guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "A. Splajn i dwa odcinki", subtitle = "Paczki z magazynu; punkty: odsetek w danych",
       x = "Opóźnienie (dni)", y = "Ponowny zakup w 6 mies. (%)") + motyw
p5b <- ggplot(data.frame(c = c_boot), aes(c)) +
  annotate("rect", xmin = min(prof), xmax = max(prof), ymin = -Inf, ymax = Inf, fill = kol[["pomaranczowy"]], alpha = 0.25) +
  geom_bar(fill = kol[["niebieski"]], width = 0.2) +
  geom_vline(xintercept = c_hat, colour = kol[["cynober"]], linewidth = 1) +
  scale_x_continuous(breaks = 0:8) +
  labs(title = "B. Gdzie wypada próg?", subtitle = "500 prób bootstrapowych; pas: przedział z profilu",
       x = "Punkt załamania (dni opóźnienia)", y = "Liczba prób") + motyw
p5 <- p5a + p5b
p5   # zapis: ggsave("oswietlenie-prog.svg", p5, width = 10, height = 5.6)
Wynik w R
Punkt załamania: 5.00 dnia | przedział z profilu: 3.75–7.25
Nachylenie przed progiem: OR = 0.785 na dzień | po progu: OR = 1.046 na dzień
Dewiancja przy progach 1, 2, 3, 4, 5 dni: 20.3 12.7 8.8 1.8 0 (różnica do minimum)
AIC: prosta 350.3 | segmentowa 333.0 (+1 parametr za próg)
Bootstrap (500 prób): mediana 5.00, 95% przedział percentylowy 4.00–8.00

0–0.75 1–1.75 2–2.75 3–3.75    4–8
   0.8    0.0    0.0    0.2   99.0
GAM: najszybszy spadek przy opóźnieniu 1.90 dnia (-0.268 logitu na dzień)
5. Koszt dnia opóźnienia: Rysunek 6
R
# Przepis 5. Koszt opóźnienia w utraconych ponownych zakupach (GAM z przepisu 3, przedziały z bootstrapu)
marza <- 75                                          # ręcznie: średnia marża brutto z ponownego zamówienia (zł)
# Liczymy na komórkach `a` z przepisu 4 (opóźnienie × gabaryt × dostępność) z wagą liczby zamówień – to samo co na 15 000 wierszy
# Ile ponownych zakupów na 1000 zamówień traci sklep, gdy wszystkie zamówienia spóźnią się o d dni zamiast dojść w terminie
strata_1000 <- function(m, dni = 1:8) {
  p0 <- weighted.mean(predict(m, transform(a, opoznienie = 0), type = "response"), a$n)
  sapply(dni, function(d) 1000 * (p0 - weighted.mean(predict(m, transform(a, opoznienie = d), type = "response"), a$n)))
}
# Ile ponownych zakupów stracono przez opóźnienia, które naprawdę się zdarzyły (każde spóźnione zamówienie vs w terminie)
spoz <- subset(a, opoznienie > 0)
strata_fakt <- function(m) spoz$n * (predict(m, transform(spoz, opoznienie = 0), type = "response") -
                                       predict(m, spoz, type = "response"))
s1000 <- strata_1000(m_kontr)
sf <- strata_fakt(m_kontr)

# Bootstrap: 200 prób zamówień, GAM dopasowany do danych zagregowanych (ta sama wiarygodność co dla wierszy)
set.seed(7083)
ostrzezenia <- 0                                     # liczymy próby, w których mgcv zgłosiło ostrzeżenie o zbieżności
boot <- replicate(200, {
  ab <- agreguj(sample(nrow(z), replace = TRUE))
  mb <- withCallingHandlers(
    gam(cbind(tak, n - tak) ~ s(opoznienie, k = 10) + gabaryt + dostepnosc, family = binomial, data = ab, method = "REML"),
    warning = function(w) { ostrzezenia <<- ostrzezenia + 1; invokeRestart("muffleWarning") })
  c(strata_1000(mb), sum(strata_fakt(mb))) })
cat("Próby z ostrzeżeniem o zbieżności:", ostrzezenia, "z 200\n")
ci <- apply(boot, 1, quantile, c(0.025, 0.975))
wynik <- data.frame(opoznienie = 1:8, strata_na_1000 = s1000, d = ci[1, 1:8], g = ci[2, 1:8],
                    kolejny_dzien = c(s1000[1], diff(s1000)), zl_na_1000 = s1000 * marza)
print(round(wynik, 1), row.names = FALSE)
cat(sprintf("Spóźnionych zamówień: %d | utracone ponowne zakupy: %.0f [%.0f, %.0f] | marża: %.0f zł [%.0f, %.0f]\n",
            sum(spoz$n), sum(sf), ci[1, 9], ci[2, 9], marza * sum(sf), marza * ci[1, 9], marza * ci[2, 9]))
spoz$strata <- sf
udzial <- aggregate(strata ~ pmin(opoznienie, 6), data = spoz, sum); names(udzial) <- c("opoznienie", "strata")
udzial$zamowien <- aggregate(n ~ pmin(opoznienie, 6), data = spoz, sum)$n
udzial$proc_straty <- round(100 * udzial$strata / sum(udzial$strata), 1)
print(transform(udzial, strata = round(strata, 1)), row.names = FALSE)

# Rysunek 6: A – strata na 1000 zamówień przy opóźnieniu o d dni; B – skąd wzięła się strata w danych
p6a <- ggplot(wynik, aes(opoznienie, strata_na_1000)) +
  geom_col(fill = kol[["niebieski"]], width = 0.7) + geom_errorbar(aes(ymin = d, ymax = g), width = 0.25, colour = "grey25") +
  scale_x_continuous(breaks = 1:8) +
  scale_y_continuous(sec.axis = sec_axis(~ . * marza / 1000, name = "Tys. zł marży na 1000 zamówień")) +
  labs(title = "A. Strata na 1000 zamówień", subtitle = "Wszystkie spóźnione o d dni vs w terminie; 95% CI",
       x = "Opóźnienie (dni)", y = "Utracone ponowne zakupy") + motyw
p6b <- ggplot(udzial, aes(factor(opoznienie, labels = c(1:5, "6+")), strata)) +
  geom_col(fill = kol[["pomaranczowy"]], width = 0.7) +
  geom_text(aes(label = paste0(zamowien, " zam.")), vjust = -0.4, size = 3.8, colour = "grey25") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "B. Skąd strata w tym roku", subtitle = "Utracone zakupy wg długości opóźnienia",
       x = "Opóźnienie (dni)", y = "Utracone ponowne zakupy") + motyw
p6 <- p6a + p6b
p6   # zapis: ggsave("oswietlenie-koszt-opoznienia.svg", p6, width = 10, height = 5.6)
Wynik w R
Próby z ostrzeżeniem o zbieżności: 1 z 200
 opoznienie strata_na_1000     d     g kolejny_dzien zl_na_1000
          1           41.5  32.8  51.6          41.5     3115.2
          2           82.7  67.8  98.7          41.1     6199.8
          3          117.1  99.0 136.4          34.4     8781.4
          4          141.6 119.0 161.6          24.6    10623.5
          5          156.5 131.7 179.1          14.9    11739.8
          6          163.8 138.6 188.6           7.3    12285.0
          7          166.0 138.5 191.3           2.2    12452.7
          8          165.3 131.1 198.0          -0.8    12396.0
Spóźnionych zamówień: 4289 | utracone ponowne zakupy: 351 [301, 405] | marża: 26336 zł [22600, 30369]
 opoznienie strata zamowien proc_straty
          1   63.5     1546        18.1
          2   77.0      965        21.9
          3   68.2      630        19.4
          4   50.0      394        14.2
          5   30.7      237         8.7
          6   61.8      517        17.6
6. Grafika: obietnica kontra rzeczywistość (Rysunek 1)
R
# Przepis 6. Grafika: obietnica kontra rzeczywistość (Rysunek 1). Ilorazy szans pochodzą z obiektu siatka (przepis 3)
or_d <- function(d) sprintf("%.2f", exp(siatka$lor[siatka$opoznienie == d]))
s <- data.frame(y = 5:1,
                co = c("Lampka biurkowa (magazyn)", "Plafon LED (od dostawcy)", "Taśma LED (magazyn)",
                       "Lampa podłogowa (gabaryt)", "Żyrandol na zamówienie (gabaryt)"),
                obiecane = c(2, 5, 2, 3, 11), dostawa = c(2, 4, 4, 7, 11))
s$opozn <- s$dostawa - s$obiecane
s$opis <- ifelse(s$opozn == 0, "w terminie", ifelse(s$opozn < 0, paste(-s$opozn, "dzień przed terminem"),
                                                     paste0("+", s$opozn, " dni po terminie")))
s$or <- sapply(s$opozn, or_d)
s$kolor <- ifelse(s$opozn > 0, "spóźnienie", ifelse(s$opozn < 0, "przed terminem", "w terminie"))
p1 <- ggplot(s) +
  geom_rect(aes(xmin = 0, xmax = obiecane, ymin = y - 0.28, ymax = y + 0.28), fill = "grey88", colour = "grey60") +
  geom_segment(aes(x = pmin(obiecane, dostawa), xend = pmax(obiecane, dostawa), y = y, yend = y, colour = kolor),
               linewidth = 3.2, data = subset(s, opozn != 0)) +
  geom_segment(aes(x = obiecane, xend = obiecane, y = y - 0.38, yend = y + 0.38), colour = "grey20", linewidth = 0.8) +
  geom_point(aes(dostawa, y, colour = kolor, shape = kolor), size = 4.2, stroke = 1.4, fill = "white") +
  geom_text(aes(-0.3, y, label = co), hjust = 1, size = 4.1, colour = "grey15") +
  geom_text(aes(12.3, y, label = opis), hjust = 0, size = 4, colour = "grey15") +
  geom_text(aes(19.6, y, label = or), hjust = 0.5, size = 4.2, fontface = "bold", colour = "#0f1d3a") +
  annotate("text", x = 19.6, y = 5.75, label = "szansa\nponownego\nzakupu (OR)", size = 3.4, lineheight = 0.9, colour = "grey30") +
  annotate("text", x = 5.5, y = 5.75, label = "szary pasek = obiecany czas  ·  pionowa kreska = obiecany dzień  ·  kółko = dostawa",
           size = 3.4, colour = "grey30") +
  annotate("label", x = 6, y = 0.1, size = 4.1, fill = "white", colour = "#0f1d3a",
           label = "opóźnienie = dzień dostawy − obiecany dzień (liczy się różnica, nie same dni)") +
  scale_colour_manual(values = c(`spóźnienie` = kol[["cynober"]], `przed terminem` = kol[["zielony"]], `w terminie` = kol[["niebieski"]]),
                      guide = "none") +
  scale_shape_manual(values = c(`spóźnienie` = 21, `przed terminem` = 24, `w terminie` = 16), guide = "none") +
  scale_x_continuous(breaks = 0:11, limits = c(-9.5, 21)) + scale_y_continuous(limits = c(-0.3, 6.1)) +
  labs(title = "Obietnica kontra rzeczywistość", subtitle = "Pięć zamówień; dni od złożenia zamówienia (oś pozioma)",
       x = NULL, y = NULL) +
  motyw + theme(panel.grid = element_blank(), axis.text.y = element_blank(), axis.text.x = element_text(size = 10))
p1   # zapis: ggsave("oswietlenie-obietnica-schemat.svg", p1, width = 10, height = 5.6)
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("błękitny – cynober (rys. 2)" = c("#56B4E9", "#D55E00"),
             "cynober – ciemnoszary (rys. 3A)" = c("#D55E00", "grey20"),
             "cynober – niebieski (rys. 4, 5A)" = c("#D55E00", "#0072B2"),
             "niebieski – ciemnoszary (rys. 4)" = c("#0072B2", "grey20"),
             "cynober – zielony (rys. 1)" = c("#D55E00", "#009E73"),
             "zielony – niebieski (rys. 1)" = c("#009E73", "#0072B2"),
             "cividis: 1 – 5 gwiazdek (rys. 3B)" = viridisLite::cividis(5)[c(1, 5)],
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                  widzenie_typowe deuteranopia protanopia
błękitny – cynober (rys. 2)                 113.6        101.1       89.0
cynober – ciemnoszary (rys. 3A)              83.4         72.7       59.9
cynober – niebieski (rys. 4, 5A)            114.6        108.3       91.9
niebieski – ciemnoszary (rys. 4)             48.3         50.3       47.4
cynober – zielony (rys. 1)                  102.4         53.5       37.3
zielony – niebieski (rys. 1)                 70.1         55.4       58.0
cividis: 1 – 5 gwiazdek (rys. 3B)           135.2        134.0      136.7
czerwony – zielony (do unikania)            121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele addytywne (dwumianowy, porządkowy ocat i liniowy) dopasowano pakietem mgcv, a regresję segmentową, losowanie danych i bootstrap – funkcjami glm(), sample() i replicate() z pakietów stats i base. Rysunki wykonano w pakiecie ggplot2 (skala cividis z pakietu viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9-4): Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Dni zamiast opóźnienia. Model z czasem dostawy pomija obietnicę i myli długie, ale zapowiedziane dostawy z porażkami.
- Brak kontroli rodzaju zamówienia. Bez niej spadek przy 6 dniach wyszedł OR = 0.21 zamiast około 0.30.
- Oceny jako miara wszystkich klientów. Ocenia mniejszość, częściej zawiedziona lub zachwycona (błąd selekcji).
- Próg jako fakt. Punkt załamania przy gładkiej zależności to artefakt modelu. Podawaj przedział i pokazuj splajn.
- Dzielenie opóźnienia na „w terminie / spóźnione”. Traci informację o tym, że 1 dzień i 6 dni to zupełnie inne straty (dychotomizacja zmiennych ciągłych).
- Ekstrapolacja splajnu. Opóźnień powyżej 8 dni jest mało, a przedział szeroki (rysunek 4).
Najczęstsze pytania
Jak sprawdzić, czy czas dostawy wpływa na ponowny zakup klienta?
Zdefiniuj opóźnienie jako dzień dostawy minus obiecany dzień i wprowadź je do regresji logistycznej jako splajn (model GAM), z kontrolą rodzaju zamówienia. W przykładzie 15 000 zamówień 1 dzień opóźnienia dał OR = 0.79, a 4 dni OR = 0.38 względem dostawy w terminie. To zależność z danych obserwacyjnych – działania naprawcze najlepiej sprawdzić eksperymentem.
Czas dostawy w dniach czy opóźnienie względem obietnicy?
Opóźnienie względem obietnicy. Klient porównuje dostawę z tym, co mu obiecano: 11 dni dla żyrandola na zamówienie zgodnie z terminem nie szkodzi, a 4 dni dla towaru z magazynu obiecanego na 2 dni – szkodzi. W przykładzie model z opóźnieniem miał AIC niższe o 17 punktów niż model z czasem dostawy.
Jak wyznaczyć próg opóźnienia, po którym klienci odchodzą?
Dopasuj regresję segmentową (dwa odcinki z punktem załamania szacowanym z danych) i porównaj ją ze splajnem. Niepewność progu oszacuj bootstrapem: w przykładzie punkt załamania wypadł przy 5 dniach z przedziałem 4–8 dni, ale oznaczał koniec spadku, a nie jego początek – szkoda zaczynała się od pierwszego dnia. Przy gładkiej zależności próg jest artefaktem modelu.
Czy oceny w gwiazdkach wystarczą, by ocenić skutki opóźnień?
Nie. Ocenę wystawia mniejszość, częściej klienci bardzo zadowoleni albo zawiedzeni. W przykładzie oceniło 21.4% klientów, a przy opóźnieniu o 6 i więcej dni jedną gwiazdkę dało 56.6% oceniających wobec 43.1% wszystkich klientów. Lepszą miarą skutków jest ponowny zakup, który widać u wszystkich.
Jak policzyć koszt jednego dnia opóźnienia dostawy?
Z modelu policz scenariusze: wszystkie zamówienia w terminie i wszystkie spóźnione o d dni, a różnicę przewidywanych ponownych zakupów pomnóż przez marżę. W przykładzie 1 dzień kosztował 41.5 ponownego zakupu na 1000 zamówień [32.8, 51.6], czyli ok. 3.1 tys. zł marży przy 75 zł na zamówienie. Przedziały uzyskaj bootstrapem.
Powiązane hasła
Przeczytaj też
Nieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikCSAT, CES czy NPS – który przewiduje odejście
8000 kontaktów z obsługą światłowodu: krzywe ROC, test DeLonga, kalibracja i przyrost AUC trzech wskaźników – z kodem R.
Czytaj →Analizujesz dane o dostawach, ocenach lub ponownych zakupach?
Pomożemy dobrać model nieliniowy (GAM, regresja segmentowa), uwzględnić zmienne zakłócające, oszacować próg z przedziałem i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- DiCiccio, T. J., & Efron, B. (1996). Bootstrap confidence intervals. Statistical Science, 11(3), 189–228. https://doi.org/10.1214/ss/1032280214 ● Otwarty dostęp
- Hu, N., Pavlou, P. A., & Zhang, J. (2017). On self-selection biases in online product reviews. MIS Quarterly, 41(2), 449–471. https://doi.org/10.25300/misq/2017/41.2.06
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Muggeo, V. M. R. (2003). Estimating regression models with unknown break-points. Statistics in Medicine, 22(19), 3055–3071. https://doi.org/10.1002/sim.1545
- Oliver, R. L. (1980). A cognitive model of the antecedents and consequences of satisfaction decisions. Journal of Marketing Research, 17(4), 460–469. https://doi.org/10.1177/002224378001700405 ● Otwarty dostęp: pełny tekst
- Rao, S., Griffis, S. E., & Goldsby, T. J. (2011). Failure to deliver? Linking online order fulfillment glitches with future purchase behavior. Journal of Operations Management, 29(7–8), 692–703. https://doi.org/10.1016/j.jom.2011.04.001
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
Cytowania BibTeX
@article{diciccio1996bootstrap, author={DiCiccio, Thomas J. and Efron, Bradley}, title={{Bootstrap confidence intervals}}, journal={Statistical Science}, year={1996}, volume={11}, number={3}, pages={189--228}, doi={10.1214/ss/1032280214}}@article{hu2017self, author={Hu, Nan and Pavlou, Paul A. and Zhang, Jie}, title={{On self-selection biases in online product reviews}}, journal={MIS Quarterly}, year={2017}, volume={41}, number={2}, pages={449--471}, doi={10.25300/misq/2017/41.2.06}}@article{mccullagh1980regression, author={McCullagh, Peter}, title={{Regression models for ordinal data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1980}, volume={42}, number={2}, pages={109--127}, doi={10.1111/j.2517-6161.1980.tb01109.x}}@article{muggeo2003estimating, author={Muggeo, Vito M. R.}, title={{Estimating regression models with unknown break-points}}, journal={Statistics in Medicine}, year={2003}, volume={22}, number={19}, pages={3055--3071}, doi={10.1002/sim.1545}}@article{oliver1980cognitive, author={Oliver, Richard L.}, title={{A cognitive model of the antecedents and consequences of satisfaction decisions}}, journal={Journal of Marketing Research}, year={1980}, volume={17}, number={4}, pages={460--469}, doi={10.1177/002224378001700405}}@article{rao2011failure, author={Rao, Shashank and Griffis, Stanley E. and Goldsby, Thomas J.}, title={{Failure to deliver? Linking online order fulfillment glitches with future purchase behavior}}, journal={Journal of Operations Management}, year={2011}, volume={29}, number={7–8}, pages={692--703}, doi={10.1016/j.jom.2011.04.001}}@book{wood2017generalized, author={Wood, Simon N.}, title={{Generalized additive models: An introduction with R (2nd ed.)}}, year={2017}, publisher={Chapman and Hall/CRC}, doi={10.1201/9781315370279}}