Przykład: sklep z butami i pytanie „które modele zjadają marżę?”
Fikcyjny sklep internetowy z obuwiem sprzedaje 200 modeli w pięciu kategoriach: sneakersy, buty do biegania, botki i kozaki, półbuty oraz sandały. W ciągu roku przyjął 11 000 zamówień na 11 851 par od 3696 klientów, a 3593 pary wróciły do magazynu (30.3%). W 7.7% zamówień klient wziął ten sam model w dwóch rozmiarach. Od 1 lipca sklep zmienił regulamin: zwrot, za który wcześniej płacił klient, stał się darmowy.
Dział e-commerce pyta: gdzie zwrotów jest najwięcej, które modele naprawdę mają problem (np. z rozmiarówką) i ile zwroty kosztują w marży? Zwroty są nieodłączną częścią zakupów i nie muszą być tylko stratą (Petersen i Kumar, 2009). Przegląd badań o politykach zwrotów porządkuje decyzje sklepów i reakcje klientów na te decyzje (Abdulla i in., 2019).
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy prawdopodobieństwo zwrotu w sytuacji odniesienia (jeden rozmiar 38–40, strona www, płatny zwrot, typowy klient): od 11% dla sandałów do 30% dla botków; ilorazy szans dla rozmiarów, kanału i darmowego zwrotu (1.30); losowe różnice modeli i klientów; nierówną sprzedaż i sezon (sandały latem, botki jesienią). W zamówieniu z dwoma rozmiarami jedna para pasuje w 85% przypadków. Pełna lista – przy kodzie. Ziarno 673 ustalono raz; po pierwszym uruchomieniu nie zmienialiśmy ani ziarna, ani parametrów danych (poprawialiśmy tylko wygląd rysunków i poziom odniesienia rozmiaru w modelu). Dane: zwroty-obuwia-sklep-internetowy.csv (wiersz = para butów w zamówieniu).
Rysunek 1: odsetek zwrotów według kategorii, rozmiaru i kanału
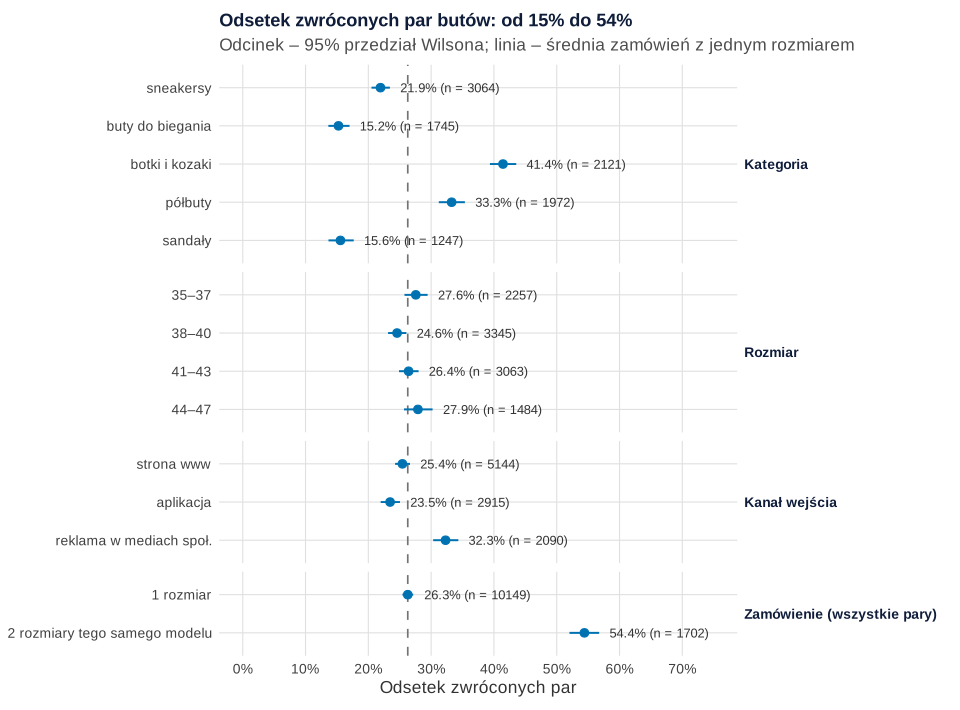
set.seed(673)).Co widać. Trzy górne panele dotyczą zamówień z jednym rozmiarem (10 149 par, 26.3% zwrotów). Najwięcej wraca botków i kozaków (41.4%, 95% CI [39.4, 43.6]) i półbutów (33.3%), najmniej butów do biegania (15.2%) i sandałów (15.6%). Pary kupione po kliknięciu reklamy w mediach społecznościowych wracają częściej (32.3%) niż kupione na stronie (25.4%). Różnice między rozmiarami są małe: od 24.6% do 27.9%. W zamówieniach z dwoma rozmiarami wraca 54.4% par – jedna z dwóch par to „zaplanowany” zwrot. Przedziały to przedziały ufności dla proporcji metodą Wilsona.
Jak może zmylić. Zmienne się przenikają: botki sprzedają się jesienią, czyli po wprowadzeniu darmowych zwrotów. Surowe odsetki mieszają te wpływy – rozdzieli je model. Przedziały Wilsona traktują też pary jednego klienta jak niezależne.
Podpis do pracy:
Regresja logistyczna mieszana: produkt i klient jednocześnie
Zwrot to wynik tak/nie, więc punktem wyjścia jest regresja logistyczna. Dane mają jednak dwa źródła podobieństwa: pary tego samego modelu (rozmiarówka, materiał, zdjęcia w sklepie) i pary tego samego klienta (niektórzy zwracają prawie wszystko). Model nie jest zagnieżdżony w kliencie ani odwrotnie – to efekty skrzyżowane, jak osoby i bodźce w eksperymentach (Baayen i in., 2008). Dlatego dopasowujemy uogólniony liniowy model mieszany z losowym wyrazem wolnym produktu i klienta w pakiecie lme4 (Bates i in., 2015). Model obejmuje zamówienia z jednym rozmiarem; zamówienia z dwoma rozmiarami opisujemy osobno niżej, bo tam zwroty dwóch par są ze sobą powiązane.
| Predyktor (poziom odniesienia) | OR | 95% CI | p |
|---|---|---|---|
| buty do biegania (sneakersy) | 0.62 | [0.46, 0.85] | .003 |
| botki i kozaki (sneakersy) | 2.42 | [1.84, 3.19] | < .001 |
| półbuty (sneakersy) | 1.70 | [1.26, 2.29] | < .001 |
| sandały (sneakersy) | 0.69 | [0.49, 0.95] | .025 |
| rozmiar 35–37 (38–40) | 1.20 | [1.05, 1.37] | .009 |
| rozmiar 41–43 (38–40) | 1.09 | [0.97, 1.24] | .161 |
| rozmiar 44–47 (38–40) | 1.23 | [1.06, 1.43] | .008 |
| aplikacja (strona www) | 0.90 | [0.80, 1.01] | .064 |
| reklama w mediach społ. (strona www) | 1.46 | [1.29, 1.65] | < .001 |
| darmowy zwrot (zwrot płatny) | 1.23 | [1.11, 1.36] | < .001 |
Jak to czytać. Iloraz szans 2.42 dla botków oznacza, że szansa zwrotu pary botków jest 2.42 razy większa niż sneakersów przy tym samym rozmiarze, kanale, okresie, a także dla tego samego klienta i modelu o przeciętnym efekcie. Wejście z reklamy w mediach społecznościowych zwiększa szansę zwrotu o 46% (prawda: 1.45), a skrajne rozmiary – o ok. 20%. Ilorazy z takiego modelu są warunkowe – dotyczą porównania w obrębie modelu i klienta; różnicę wobec ilorazów uśrednionych w populacji wyjaśnia wpis o wielopoziomowej regresji logistycznej.
Ile różnic to modele, a ile klienci? Wariancja efektów losowych wynosi 0.249 dla modeli (SD = 0.50) i 0.348 dla klientów (SD = 0.59). Na skali latentnej daje to ICC .064 dla modeli i .090 dla klientów, a medianowe ilorazy szans 1.61 i 1.76: szansa zwrotu tego samego buta u dwóch losowych klientów różni się typowo 1.76 razy. Model zaniżył SD klientów (prawda: 0.75), bo większość ma jedno–dwa zamówienia. Pominięcie któregokolwiek efektu losowego zaniża błędy standardowe (pseudoreplikacja); dopasowanie i wnioskowanie w takich modelach omawia przegląd Bolkera i in. (2009).
Rysunek 2: lista „najczęściej zwracanych” – surowo i z modelu
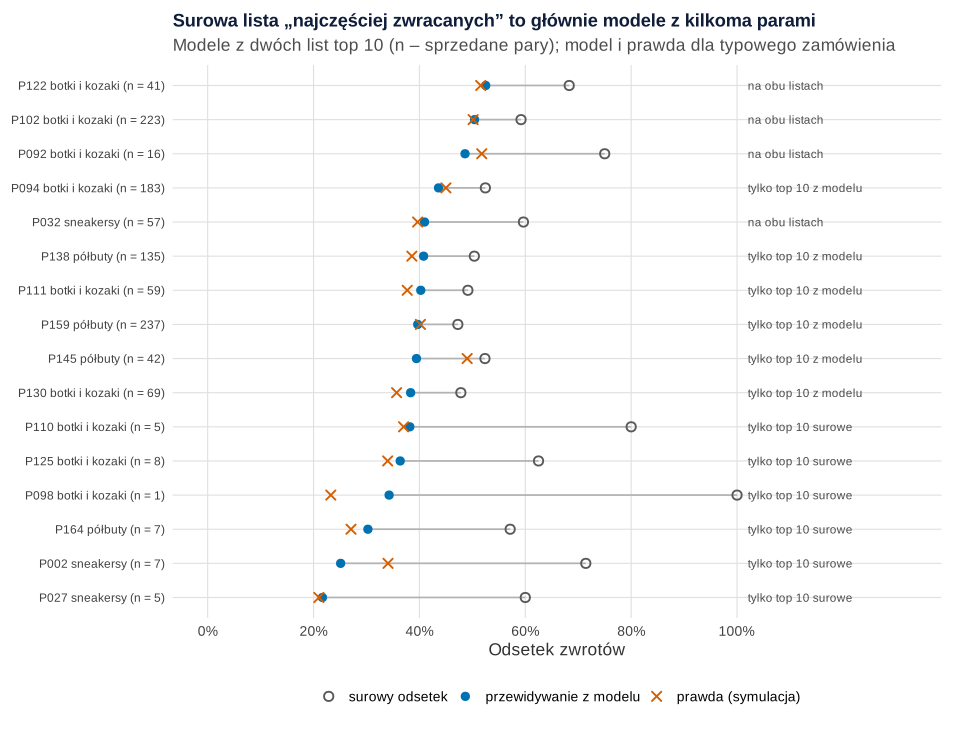
Mediana sprzedaży to 26 par na model, ale 35 modeli sprzedało mniej niż 10 par, a 20 – co najmniej 100. Surowy odsetek modelu, który sprzedał jedną parę, wynosi 0% albo 100%. Model mieszany łączy dane modelu ze średnią jego kategorii proporcjonalnie do liczby sprzedanych par – ściąga do średniej wyniki modeli z małą sprzedażą. Mechanizm pokazuje wpis model mieszany w obrazkach, a ten sam problem przy ocenach gwiazdkowych – oceny gwiazdkowe i ranking produktów.
Co widać. Surowa lista top 10 to w połowie modele z 1–8 sprzedanymi parami (mediana 7.5 pary); lista z modelu ma medianę 64 par. P098 (jedna para botków, jeden zwrot) jest na surowej liście pierwszy ze 100%, choć jego prawdziwy odsetek w sytuacji odniesienia to 23%. Z prawdziwej dziesiątki najczęściej zwracanych modeli surowa lista trafia 4, a lista z modelu 7. Zgodność całej kolejności 199 modeli z prawdą (korelacja Spearmana) wynosi .772 dla surowych odsetków i .844 dla modelu. Przewidywania i prawdę liczymy dla „typowego” zamówienia: jeden rozmiar 38–40, strona www, zwrot płatny, przeciętny klient.
Jak może zmylić. Model zakłada przeciętność z braku danych, więc prawdziwy problem mniejszego modelu (P145, 42 pary: prawda 49%, model 39%) zostaje częściowo schowany. To wynik jednego zbioru danych. Przedziały dla poszczególnych modeli (wykres gąsienicowy) są szerokie i dużej części kolejności nie da się odróżnić od szumu – podobnie jak w rankingach szkół (Leckie i Goldstein, 2009). Różnicę między miejscem a oceną opisuje hasło ranking a ocena pozycji.
Podpis do pracy:
Zdanie do Metody:
Klienci zamawiający dwa rozmiary
Zamówienie modelu w dwóch rozmiarach to świadoma strategia: klient przymierzy oba i jeden odeśle. W danych zrobiło tak 562 z 3696 klientów (15.2%). Odpowiadają za 26.7% wszystkich par, ale za 36.4% zwrotów. Same zamówienia z dwoma rozmiarami dały 25.8% wszystkich zwróconych par. Z 851 takich zamówień w 712 wróciła jedna para, w 107 obie, a w 32 żadna.
Dlatego nie wrzucaj takich par do jednego worka z resztą. Zwroty dwóch par z jednego zamówienia nie są niezależne. Licz dla nich wynik na poziomie zamówienia: odsetek zamówień, w których klient zatrzymał co najmniej jedną parę (tu 744 z 851, czyli 87.4%), i oddziel ten wskaźnik od odsetka zwrotów „prawdziwych”. Częste zamawianie dwóch rozmiarów jednego modelu sygnalizuje słaby opis rozmiarówki.
Rysunek 3: ile zwroty kosztują w marży
Zwrócona para wraca na półkę, więc stratą nie jest jej cena (cofnięta sprzedaż: 1338.8 tys. zł), lecz koszty zwrotu. Ustaliliśmy je ręcznie: obsługa i kontrola pary 9 zł; wysyłka zwrotna 16 zł za paczkę, którą od lipca płaci sklep; 10% zwróconych par nie da się sprzedać jako nowe i trafia do outletu za pół ceny; prowizja operatora płatności (1.5% ceny) nie wraca.
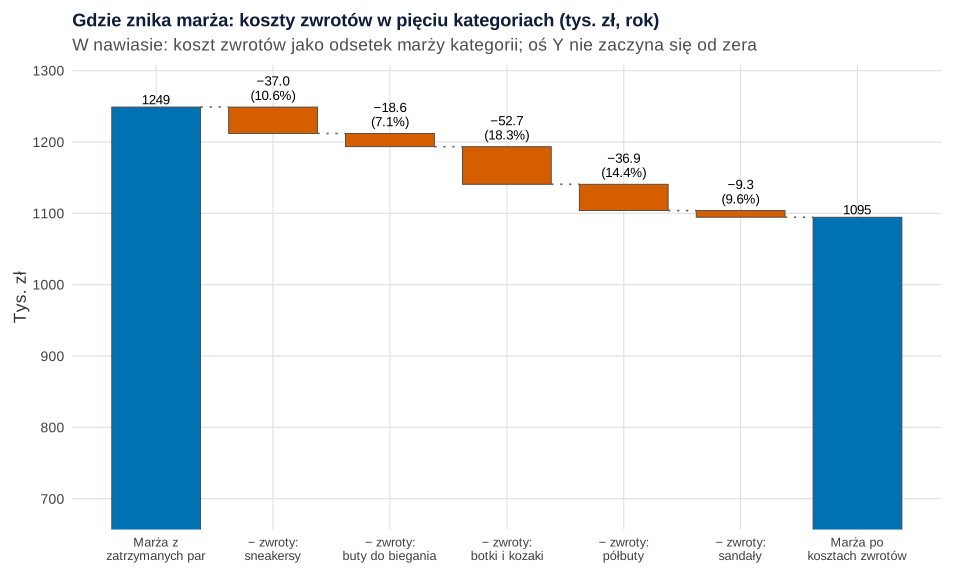
Co widać. Zwroty kosztowały sklep 154.4 tys. zł, czyli 12.4% marży brutto z zatrzymanych par (1248.9 tys. zł). Najwięcej tracą botki i kozaki: 52.7 tys. zł, 18.3% marży kategorii i 37.16 zł na każdą zatrzymaną parę. Półbuty tracą 14.4% marży, sneakersy 10.6%, sandały 9.6%, buty do biegania 7.1%. Koszt jednego zwrotu rośnie z ceną pary: od 31.3 zł (sandały) do 48.8 zł (botki).
Jak może zmylić. Oś Y nie zaczyna się od zera – powiedz to wprost. Koszty jednostkowe są założeniami; z liczbami z własnego magazynu proporcje się zmienią. Pominięto wysyłkę do klienta, infolinię i czas, gdy para nie jest w sprzedaży.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: karta „koszt jednego zwrotu”
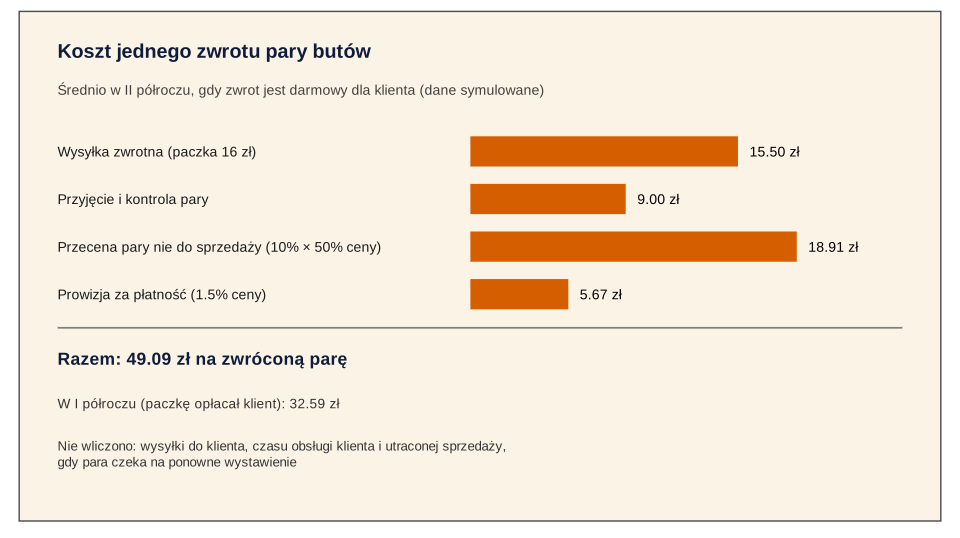
Co widać. Przy darmowym zwrocie jedna zwrócona para kosztuje średnio 49.09 zł, a przed zmianą 32.59 zł. Największy składnik to nie paczka (15.50 zł – mniej niż 16 zł, bo dwie pary z jednego zamówienia wracają w jednej paczce), tylko przecena par, których nie da się sprzedać jako nowe (18.91 zł). Zwrot pary botków za 449 zł kosztuje ok. 54.19 zł.
Jak może zmylić. To średnie z założonych kosztów, a nie pomiar; karta pomija skutki zwrotu dla dalszych zakupów klienta.
Rysunek 5: darmowe zwroty – porównanie przed i po
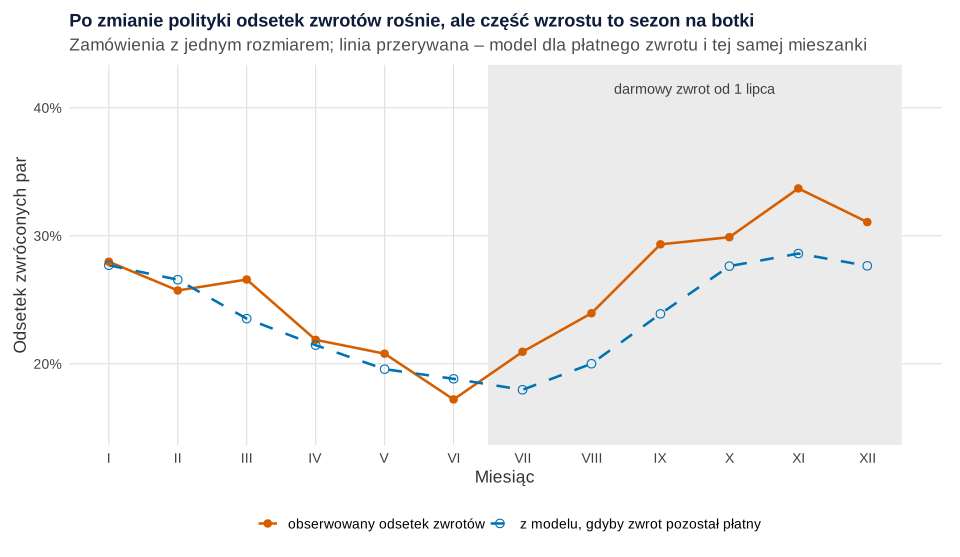
Co widać. Naiwne porównanie półroczy: odsetek zwrotów wzrósł z 23.02% do 28.96%, o 5.94 punktu procentowego. Model przewiduje, że przy płatnym zwrocie w II półroczu byłoby 25.05% – bo jesienią sprzedaje się więcej botków (37–41% zamówień w październiku–grudniu wobec 0.4% w czerwcu). Około 2.03 pp wzrostu to więc mieszanka kategorii, a 3.91 pp – zmiana polityki. Iloraz szans dla darmowego zwrotu wynosi 1.23, 95% CI [1.11, 1.36] (prawda: 1.30). Udział zamówień z dwoma rozmiarami wzrósł z 5.2% do 9.7%, dlatego odsetek zwrotów wszystkich par skoczył mocniej: z 26.2% do 33.4%.
Jak może zmylić. Model uwzględnia tylko zmienne z danych; inną jesienną zmianę (nowa kolekcja, inni klienci) przypisze polityce. To porównanie przed–po, a nie eksperyment; lepsze byłoby porównanie z tymi samymi miesiącami roku poprzedniego, przerwany szereg czasowy z dłuższej historii albo test A/B z darmowym zwrotem dla losowej części klientów. Wzrost zwrotów to też nie cały rachunek: w badaniu terenowym klienci po darmowym zwrocie wydawali później więcej, a po płatnym – mniej (Bower i Maxham, 2012).
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Zacznij od botków i kozaków (18.3% marży kategorii): tabele rozmiarów z obwodem cholewki, zdjęcia na nodze, opinie o rozmiarówce.
- Listę modeli „do poprawy” buduj z modelu, nie z surowych odsetków. Surowa lista trafiła 4 z 10 prawdziwie problematycznych modeli, lista z modelu 7.
- Licz koszt kampanii po zwrotach. Pary z reklamy w mediach społecznościowych mają o 46% większą szansę zwrotu; koszt pozyskania przelicz na pary zatrzymane, a nie wysłane. Podobnie przychód z klienta – zob. przychód na klienta.
- Zamówienia z dwoma rozmiarami raportuj osobno. Po zmianie polityki ich udział prawie się podwoił (5.2% → 9.7%). Doradca rozmiaru w sklepie może zmniejszyć ich liczbę – sprawdź to testem A/B.
- Nie wycofuj darmowych zwrotów na podstawie samego odsetka. Zysk z utrzymanych klientów może przewyższyć koszt 49 zł na zwrot (Bower i Maxham, 2012); porównaj wydatki klientów w obu wariantach w eksperymencie.
Klienci, którzy porzucają koszyk zamiast zwracać towar, to temat wpisu porzucone koszyki – eksperyment z przypomnieniem. Szerzej o miejscu takich analiz w pracy dyplomowej: statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie podaj jednostkę analizy (para w zamówieniu), wykluczenie zamówień z dwoma rozmiarami z modelu i powód, strukturę efektów losowych (skrzyżowane: produkt i klient), metodę estymacji i poziomy odniesienia. W Wynikach – ilorazy szans z 95% CI, wariancje efektów losowych i założenia rachunku kosztów. Wzory zdań dla modeli mieszanych: jak opisać wyniki modelu mieszanego.
Kod R: dane, odsetki, model mieszany, marża i polityka zwrotów
Kod odtwarza wszystkie liczby z tekstu, tabelę i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 i zaczyna od set.seed(673); ziarno ustalono raz i nie zmieniano go. Ręcznie ustalono: liczbę modeli w kategoriach (50, 35, 45, 40, 30), ceny i marże kategorii, prawdopodobieństwa zwrotu w sytuacji odniesienia, ilorazy szans rozmiaru, kanału i darmowego zwrotu, SD efektów produktu (0.55) i klienta (0.75), wagi sezonowe kategorii i miesięcy, 15% klientów z nawykiem zamawiania dwóch rozmiarów (30% ich zamówień przed lipcem, 45% po; u pozostałych 1% i 4%), 85% szans, że jeden z dwóch rozmiarów pasuje, oraz koszty jednego zwrotu z przepisu 4. Parametrów danych nie zmieniano po pierwszym uruchomieniu.
1. Paleta, motyw i dane
R
# Dane. Fikcyjny sklep internetowy z obuwiem: rok zamówień i zwrotów (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie
kat <- c("sneakersy", "buty do biegania", "botki i kozaki", "półbuty", "sandały")
n_mod   <- c(50, 35, 45, 40, 30)              # liczba modeli w kategorii (razem 200)
cena    <- c(329, 399, 449, 389, 219)         # typowa cena pary (zł netto)
marza   <- c(0.42, 0.40, 0.46, 0.44, 0.38)    # marża brutto: (cena − koszt zakupu) / cena
p_bazowe <- c(0.15, 0.13, 0.30, 0.24, 0.11)   # P(zwrot): 1 rozmiar, 38–40, strona www, płatny zwrot, typowy klient
or_rozm  <- c("35–37" = 1.25, "38–40" = 1, "41–43" = 1.05, "44–47" = 1.40)
p_rozm   <- c(0.22, 0.33, 0.30, 0.15)
or_kanal <- c("strona www" = 1, "aplikacja" = 0.85, "reklama w mediach społ." = 1.45)
p_kanal  <- c(0.50, 0.30, 0.20)
or_darmowe <- 1.30                            # darmowy zwrot od 1 lipca (zamówienia z 1 rozmiarem)
sd_produkt <- 0.55; sd_klient <- 0.75         # SD efektów losowych na skali logitu
n_klientow <- 6000; n_zamowien <- 11000
# Sezon: udział kategorii w zamówieniach w miesiącach 1–12 (wagi względne)
sezon <- rbind(sneakersy          = rep(1, 12),
               `buty do biegania` = c(.6, .6, .9, 1, 1, .9, .8, .8, 1, .9, .7, .6),
               `botki i kozaki`   = c(1.3, 1.0, .5, .2, .05, .02, .02, .1, .9, 1.6, 1.8, 1.5),
               półbuty            = c(.7, .7, .8, .9, .9, .8, .6, .6, .8, .9, .9, 1.0),
               sandały            = c(.02, .05, .3, .9, 1.6, 2.0, 2.0, 1.3, .3, .05, .02, .02))
wolumen <- c(.8, .7, .8, .9, 1, 1, .9, .9, 1, 1.1, 1.5, 1.4)   # względna liczba zamówień w miesiącu

set.seed(673)                                 # ziarno ustalone raz, bez dobierania pod wynik
produkty <- data.frame(produkt = sprintf("P%03d", 1:200), kategoria = rep(kat, n_mod))
k <- match(produkty$kategoria, kat)
produkty$cena  <- round(cena[k] * runif(200, 0.8, 1.2)) - 1   # ceny „na 9”
produkty$koszt <- round(produkty$cena * (1 - marza[k]), 2)
produkty$popularnosc <- rlnorm(200, 0, 1.2)                  # mocno nierówna sprzedaż modeli
produkty$u <- rnorm(200, 0, sd_produkt)
produkty$p_prawdziwe <- plogis(qlogis(p_bazowe[k]) + produkty$u)   # prawdziwy odsetek w sytuacji odniesienia
klienci <- data.frame(klient = sprintf("K%04d", 1:n_klientow), aktywnosc = rgamma(n_klientow, 0.8, 1),
                      v = rnorm(n_klientow, 0, sd_klient),
                      dwa_rozmiary_nawyk = rbinom(n_klientow, 1, 0.15))      # 15% klientów lubi zamawiać 2 rozmiary

miesiac <- sample(1:12, n_zamowien, replace = TRUE, prob = wolumen)
zam <- data.frame(zamowienie = sprintf("Z%05d", 1:n_zamowien), miesiac = miesiac,
                  klient = sample(klienci$klient, n_zamowien, replace = TRUE, prob = klienci$aktywnosc))
zam$kategoria <- sapply(miesiac, function(m) sample(kat, 1, prob = n_mod * sezon[, m]))
zam$produkt <- sapply(zam$kategoria, function(kk) {
  pr <- produkty[produkty$kategoria == kk, ]; sample(pr$produkt, 1, prob = pr$popularnosc) })
zam$rozmiar <- sample(names(or_rozm), n_zamowien, replace = TRUE, prob = p_rozm)
zam$kanal <- sample(names(or_kanal), n_zamowien, replace = TRUE, prob = p_kanal)
zam$darmowe <- as.integer(zam$miesiac >= 7)
kl <- klienci[match(zam$klient, klienci$klient), ]
p_dwa <- ifelse(kl$dwa_rozmiary_nawyk == 1, ifelse(zam$darmowe == 1, 0.45, 0.30), ifelse(zam$darmowe == 1, 0.04, 0.01))
zam$dwa_rozmiary <- rbinom(n_zamowien, 1, p_dwa)

# Pary w zamówieniu z jednym rozmiarem: zwrot z modelu logistycznego z efektami produktu i klienta
pr <- produkty[match(zam$produkt, produkty$produkt), ]
eta <- qlogis(p_bazowe[match(zam$kategoria, kat)]) + log(or_rozm[zam$rozmiar]) + log(or_kanal[zam$kanal]) +
       log(or_darmowe) * zam$darmowe + pr$u + kl$v
jeden <- zam$dwa_rozmiary == 0
linie1 <- data.frame(zam[jeden, ], para = 1, zwrot = rbinom(sum(jeden), 1, plogis(eta[jeden])))
# Zamówienie z dwoma rozmiarami: zwykle jeden pasuje (85%) i druga para wraca; gdy nie pasuje żaden – wracają obie
z2 <- zam[!jeden, ]
pasuje <- rbinom(nrow(z2), 1, 0.85)
zatrzymane_obie <- pasuje * rbinom(nrow(z2), 1, 0.04)
linie2 <- rbind(data.frame(z2, para = 1, zwrot = 1 - pasuje),
                data.frame(z2, para = 2, zwrot = 1 - zatrzymane_obie))
dane <- rbind(linie1, linie2)
dane <- dane[order(dane$zamowienie, dane$para), ]
dane$cena <- produkty$cena[match(dane$produkt, produkty$produkt)]
dane$koszt <- produkty$koszt[match(dane$produkt, produkty$produkt)]
rownames(dane) <- NULL
dane$kategoria <- factor(dane$kategoria, levels = kat)
dane$rozmiar <- factor(dane$rozmiar, levels = names(or_rozm))
dane$kanal <- factor(dane$kanal, levels = names(or_kanal))
write.csv(dane[, c("zamowienie", "para", "miesiac", "klient", "produkt", "kategoria", "rozmiar", "kanal",
                   "darmowe", "dwa_rozmiary", "cena", "koszt", "zwrot")],
          "zwroty-obuwia-sklep-internetowy.csv", row.names = FALSE)

c(zamowienia = n_zamowien, pary = nrow(dane), klienci = length(unique(dane$klient)),
  modele = length(unique(dane$produkt)), zwroty = sum(dane$zwrot))
round(100 * c(odsetek_zwrotow = mean(dane$zwrot), zamowienia_2_rozmiary = mean(zam$dwa_rozmiary)), 1)
sprzedaz_modelu <- table(factor(dane$produkt[dane$dwa_rozmiary == 0], levels = produkty$produkt))
summary(as.numeric(sprzedaz_modelu))                    # sprzedane pary na model (zamówienia z 1 rozmiarem)
c(modele_ponizej_10_par = sum(sprzedaz_modelu < 10), modele_100_i_wiecej = sum(sprzedaz_modelu >= 100))
Wynik w R
zamowienia       pary    klienci     modele     zwroty
     11000      11851       3696        200       3593
      odsetek_zwrotow zamowienia_2_rozmiary
                 30.3                   7.7
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
   0.00   12.00   25.50   50.74   58.25  689.00
modele_ponizej_10_par   modele_100_i_wiecej
                   35                    20
2. Odsetki z przedziałami Wilsona i rysunek 1
R
# Rysunek 1. Odsetek zwrotów według kategorii, rozmiaru, kanału i liczby rozmiarów w zamówieniu (dane z przepisu 1)
wilson <- function(x, n, z = 1.96) {          # 95% przedział Wilsona dla odsetka
  p <- x / n; s <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  data.frame(n = n, zwroty = x, odsetek = p, dolna = srodek - s, gorna = srodek + s)
}
odsetki <- function(d, zmienna, panel) {
  x <- tapply(d$zwrot, d[[zmienna]], sum); n <- tapply(d$zwrot, d[[zmienna]], length)
  data.frame(panel = panel, poziom = names(x), wilson(as.numeric(x), as.numeric(n)))
}
d1 <- subset(dane, dwa_rozmiary == 0)          # kategoria, rozmiar i kanał: tylko zamówienia z jednym rozmiarem
dane$zamowienie_typ <- ifelse(dane$dwa_rozmiary == 1, "2 rozmiary tego samego modelu", "1 rozmiar")
tab <- rbind(odsetki(d1, "kategoria", "Kategoria"), odsetki(d1, "rozmiar", "Rozmiar"),
             odsetki(d1, "kanal", "Kanał wejścia"), odsetki(dane, "zamowienie_typ", "Zamówienie (wszystkie pary)"))
tab$panel <- factor(tab$panel, levels = unique(tab$panel))
tab$poziom <- factor(tab$poziom, levels = rev(unique(tab$poziom)))
srednia_1 <- mean(d1$zwrot)

p1 <- ggplot(tab, aes(odsetek, poziom)) +
  geom_vline(xintercept = srednia_1, linetype = "dashed", colour = "grey45") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0, linewidth = 0.7, colour = kol[["niebieski"]], orientation = "y") +
  geom_point(size = 2.6, colour = kol[["niebieski"]]) +
  geom_text(aes(x = gorna, label = paste0(sprintf("%.1f", 100 * odsetek), "%  (n = ", n, ")")),
            hjust = -0.1, size = 3.4, colour = "grey20") +
  facet_grid(panel ~ ., scales = "free_y", space = "free_y") +
  scale_x_continuous(labels = scales::percent, limits = c(0, 0.75), breaks = seq(0, 0.7, 0.1)) +
  labs(title = "Odsetek zwróconych par butów: od 15% do 54%",
       subtitle = "Odcinek – 95% przedział Wilsona; linia – średnia zamówień z jednym rozmiarem",
       x = "Odsetek zwróconych par", y = NULL) +
  motyw + theme(strip.text.y = element_text(angle = 0, hjust = 0), panel.spacing = unit(0.8, "lines"))
p1   # zapis: ggsave("zwroty-odsetki-kategoria-rozmiar-kanal.svg", p1, width = 10, height = 7.4)
print(transform(tab, odsetek = round(100 * odsetek, 1), dolna = round(100 * dolna, 1), gorna = round(100 * gorna, 1)),
      row.names = FALSE)
round(100 * srednia_1, 1)

# Klienci zamawiający dwa rozmiary
zam1 <- dane[dane$para == 1, ]
kl_dwa <- unique(zam1$klient[zam1$dwa_rozmiary == 1])
c(klienci = length(unique(dane$klient)), klienci_z_zamowieniem_2_rozmiarow = length(kl_dwa))
round(100 * c(udzial_klientow = length(kl_dwa) / length(unique(dane$klient)),
              udzial_w_parach = mean(dane$klient %in% kl_dwa),
              udzial_w_zwrotach = sum(dane$zwrot[dane$klient %in% kl_dwa]) / sum(dane$zwrot),
              zwroty_z_zamowien_2_rozm = sum(dane$zwrot[dane$dwa_rozmiary == 1]) / sum(dane$zwrot)), 1)
# Zamówienia z dwoma rozmiarami: ile par wróciło w zamówieniu?
z2 <- aggregate(zwrot ~ zamowienie, subset(dane, dwa_rozmiary == 1), sum)
table(wrocilo_par = z2$zwrot)
c(zamowienia = nrow(z2), zatrzymana_co_najmniej_1_para = sum(z2$zwrot < 2), procent = round(100 * mean(z2$zwrot < 2), 1))
Wynik w R
                       panel                        poziom     n zwroty odsetek
                   Kategoria                     sneakersy  3064    672    21.9
                   Kategoria              buty do biegania  1745    266    15.2
                   Kategoria                botki i kozaki  2121    879    41.4
                   Kategoria                       półbuty  1972    656    33.3
                   Kategoria                       sandały  1247    194    15.6
                     Rozmiar                         35–37  2257    622    27.6
                     Rozmiar                         38–40  3345    822    24.6
                     Rozmiar                         41–43  3063    809    26.4
                     Rozmiar                         44–47  1484    414    27.9
               Kanał wejścia                    strona www  5144   1308    25.4
               Kanał wejścia                     aplikacja  2915    684    23.5
               Kanał wejścia       reklama w mediach społ.  2090    675    32.3
 Zamówienie (wszystkie pary)                     1 rozmiar 10149   2667    26.3
 Zamówienie (wszystkie pary) 2 rozmiary tego samego modelu  1702    926    54.4
 dolna gorna
  20.5  23.4
  13.6  17.0
  39.4  43.6
  31.2  35.4
  13.7  17.7
  25.8  29.4
  23.1  26.1
  24.9  28.0
  25.7  30.2
  24.3  26.6
  22.0  25.0
  30.3  34.3
  25.4  27.1
  52.0  56.8
[1] 26.3
                          klienci klienci_z_zamowieniem_2_rozmiarow
                             3696                               562
         udzial_klientow          udzial_w_parach        udzial_w_zwrotach
                    15.2                     26.7                     36.4
zwroty_z_zamowien_2_rozm
                    25.8
wrocilo_par
  0   1   2
 32 712 107
                   zamowienia zatrzymana_co_najmniej_1_para
                        851.0                         744.0
                      procent
                         87.4
3. Regresja logistyczna mieszana i rysunek 2
R
# Regresja logistyczna mieszana i rysunek 2: ranking „najczęściej zwracanych” modeli (dane z przepisów 1–2)
suppressPackageStartupMessages(library(lme4))
d1$rozmiar <- relevel(d1$rozmiar, ref = "38–40")   # najczęstszy rozmiar jako poziom odniesienia
# Losowe efekty produktu i klienta są skrzyżowane: klient kupuje różne modele, model kupują różni klienci
m <- glmer(zwrot ~ kategoria + rozmiar + kanal + darmowe + (1 | produkt) + (1 | klient),
           data = d1, family = binomial, control = glmerControl(optimizer = "bobyqa"))
wsp <- summary(m)$coefficients
ci <- confint(m, method = "Wald", parm = "beta_")
round(cbind(OR = exp(wsp[, 1]), dolna = exp(ci[, 1]), gorna = exp(ci[, 2]), p = wsp[, 4]), 3)
vc <- as.data.frame(VarCorr(m))[, c("grp", "vcov", "sdcor")]
vc
tau <- setNames(vc$vcov, vc$grp)
round(c(ICC_produkt = tau[["produkt"]] / (sum(tau) + pi^2 / 3),        # ICC na skali latentnej
        ICC_klient = tau[["klient"]] / (sum(tau) + pi^2 / 3)), 3)
round(c(MOR_produkt = exp(sqrt(2 * tau[["produkt"]]) * qnorm(0.75)),  # medianowy iloraz szans
        MOR_klient = exp(sqrt(2 * tau[["klient"]]) * qnorm(0.75))), 2)

# Ranking modeli: surowy odsetek vs przewidywanie z modelu dla tej samej sytuacji odniesienia
# (1 rozmiar, 38–40, strona www, płatny zwrot, typowy klient) vs prawda znana z symulacji
re <- ranef(m)$produkt
b <- fixef(m)
sprzed <- aggregate(zwrot ~ produkt + kategoria, d1, function(x) c(n = length(x), zwroty = sum(x)))
rk <- data.frame(produkt = sprzed$produkt, kategoria = sprzed$kategoria,
                 n = sprzed$zwrot[, "n"], zwroty = sprzed$zwrot[, "zwroty"])
rk$surowy <- rk$zwroty / rk$n
efekt_kat <- c(0, b[paste0("kategoria", levels(d1$kategoria)[-1])])
names(efekt_kat) <- levels(d1$kategoria)
rk$model <- plogis(b[["(Intercept)"]] + efekt_kat[as.character(rk$kategoria)] + re[rk$produkt, 1])
rk$prawda <- produkty$p_prawdziwe[match(rk$produkt, produkty$produkt)]
c(modele_ze_sprzedaza = nrow(rk))
top <- function(x, k = 10) rank(-x, ties.method = "first") <= k
rk$top_surowy <- top(rk$surowy); rk$top_model <- top(rk$model); rk$top_prawda <- top(rk$prawda)
c(trafione_w_top10_surowy = sum(rk$top_surowy & rk$top_prawda), trafione_w_top10_model = sum(rk$top_model & rk$top_prawda))
round(c(spearman_surowy = cor(rk$surowy, rk$prawda, method = "spearman"),
        spearman_model = cor(rk$model, rk$prawda, method = "spearman")), 3)
cat("Top 10 według surowego odsetka:\n")
print(transform(rk[order(-rk$surowy), ][1:10, c("produkt", "kategoria", "n", "zwroty", "surowy", "model", "prawda")],
                surowy = round(surowy, 3), model = round(model, 3), prawda = round(prawda, 3)), row.names = FALSE)
cat("Top 10 według modelu:\n")
print(transform(rk[order(-rk$model), ][1:10, c("produkt", "kategoria", "n", "zwroty", "surowy", "model", "prawda")],
                surowy = round(surowy, 3), model = round(model, 3), prawda = round(prawda, 3)), row.names = FALSE)
c(mediana_n_top_surowy = median(rk$n[rk$top_surowy]), mediana_n_top_model = median(rk$n[rk$top_model]),
  mediana_n_wszystkie = median(rk$n))

# Rysunek 2. Modele z obu list „top 10”
wyb <- rk[rk$top_surowy | rk$top_model, ]
wyb <- wyb[order(wyb$model), ]
wyb$etykieta <- factor(paste0(wyb$produkt, " ", wyb$kategoria, " (n = ", wyb$n, ")"),
                       levels = paste0(wyb$produkt, " ", wyb$kategoria, " (n = ", wyb$n, ")"))
wyb$lista <- ifelse(wyb$top_surowy & wyb$top_model, "na obu listach",
                    ifelse(wyb$top_surowy, "tylko top 10 surowe", "tylko top 10 z modelu"))
dl <- rbind(data.frame(etykieta = wyb$etykieta, wartosc = wyb$surowy, miara = "surowy odsetek"),
            data.frame(etykieta = wyb$etykieta, wartosc = wyb$model, miara = "przewidywanie z modelu"),
            data.frame(etykieta = wyb$etykieta, wartosc = wyb$prawda, miara = "prawda (symulacja)"))
dl$miara <- factor(dl$miara, levels = c("surowy odsetek", "przewidywanie z modelu", "prawda (symulacja)"))
p2 <- ggplot(wyb, aes(y = etykieta)) +
  geom_segment(aes(x = surowy, xend = model, yend = etykieta), colour = "grey70", linewidth = 0.6) +
  geom_point(data = dl, aes(x = wartosc, shape = miara, colour = miara), size = 2.6, stroke = 1) +
  geom_text(aes(x = 1.02, label = lista), hjust = 0, size = 3.1, colour = "grey30") +
  scale_shape_manual(values = c("surowy odsetek" = 1, "przewidywanie z modelu" = 16, "prawda (symulacja)" = 4), name = NULL) +
  scale_colour_manual(values = c("surowy odsetek" = "grey35", "przewidywanie z modelu" = kol[["niebieski"]],
                                 "prawda (symulacja)" = kol[["cynober"]]), name = NULL) +
  scale_x_continuous(labels = scales::percent, breaks = seq(0, 1, 0.2)) +
  coord_cartesian(xlim = c(0, 1.32), clip = "off") +
  labs(title = "Surowa lista „najczęściej zwracanych” to głównie modele z kilkoma parami",
       subtitle = "Modele z dwóch list top 10 (n – sprzedane pary); model i prawda dla typowego zamówienia",
       x = "Odsetek zwrotów", y = NULL) +
  motyw + theme(axis.text.y = element_text(size = 9))
p2   # zapis: ggsave("zwroty-ranking-modeli-surowy-vs-model.svg", p2, width = 10, height = 7.6)
Wynik w R
                                OR dolna gorna     p
(Intercept)                  0.183 0.146 0.229 0.000
kategoriabuty do biegania    0.623 0.457 0.849 0.003
kategoriabotki i kozaki      2.423 1.838 3.193 0.000
kategoriapółbuty             1.699 1.261 2.291 0.000
kategoriasandały             0.685 0.492 0.953 0.025
rozmiar35–37                 1.195 1.046 1.365 0.009
rozmiar41–43                 1.092 0.966 1.235 0.161
rozmiar44–47                 1.227 1.055 1.428 0.008
kanalaplikacja               0.896 0.798 1.006 0.064
kanalreklama w mediach społ. 1.459 1.292 1.648 0.000
darmowe                      1.230 1.114 1.359 0.000
      grp     vcov     sdcor
1  klient 0.347839 0.5897788
2 produkt 0.248744 0.4987425
ICC_produkt  ICC_klient
      0.064       0.090
MOR_produkt  MOR_klient
       1.61        1.76
modele_ze_sprzedaza
                199
trafione_w_top10_surowy  trafione_w_top10_model
                      4                       7
spearman_surowy  spearman_model
          0.772           0.844
Top 10 według surowego odsetka:
 produkt      kategoria   n zwroty surowy model prawda
    P098 botki i kozaki   1      1  1.000 0.343  0.233
    P110 botki i kozaki   5      4  0.800 0.382  0.370
    P092 botki i kozaki  16     12  0.750 0.486  0.518
    P002      sneakersy   7      5  0.714 0.251  0.341
    P122 botki i kozaki  41     28  0.683 0.525  0.516
    P125 botki i kozaki   8      5  0.625 0.364  0.340
    P027      sneakersy   5      3  0.600 0.217  0.210
    P032      sneakersy  57     34  0.596 0.410  0.397
    P102 botki i kozaki 223    132  0.592 0.504  0.501
    P164        półbuty   7      4  0.571 0.303  0.271
Top 10 według modelu:
 produkt      kategoria   n zwroty surowy model prawda
    P122 botki i kozaki  41     28  0.683 0.525  0.516
    P102 botki i kozaki 223    132  0.592 0.504  0.501
    P092 botki i kozaki  16     12  0.750 0.486  0.518
    P094 botki i kozaki 183     96  0.525 0.436  0.450
    P032      sneakersy  57     34  0.596 0.410  0.397
    P138        półbuty 135     68  0.504 0.408  0.386
    P111 botki i kozaki  59     29  0.492 0.403  0.377
    P159        półbuty 237    112  0.473 0.397  0.402
    P145        półbuty  42     22  0.524 0.394  0.490
    P130 botki i kozaki  69     33  0.478 0.383  0.357
mediana_n_top_surowy  mediana_n_top_model  mediana_n_wszystkie
                 7.5                 64.0                 26.0
4. Koszt zwrotów w marży: rysunki 3 i 4
R
# Rysunki 3 i 4. Koszt zwrotów w marży według kategorii i karta „koszt jednego zwrotu” (dane z przepisu 1)
# Koszty jednego zwrotu ustalone ręcznie (zł; wartości oczekiwane, bez losowania)
obsluga <- 9          # przyjęcie, kontrola, ponowne pakowanie pary
paczka <- 16          # wysyłka zwrotna – od 1 lipca płaci sklep (jedna paczka na zamówienie)
uszkodzone <- 0.10    # odsetek zwróconych par, których nie da się sprzedać jako nowe
przecena <- 0.50      # takie pary idą do outletu za połowę ceny
prowizja <- 0.015     # prowizja operatora płatności nie wraca przy zwrocie pieniędzy

z <- dane[dane$zwrot == 1, ]
z$pary_w_paczce <- ave(z$zwrot, z$zamowienie, FUN = sum)
z$k_wysylka <- paczka * z$darmowe / z$pary_w_paczce
z$k_obsluga <- obsluga
z$k_przecena <- uszkodzone * przecena * z$cena
z$k_prowizja <- prowizja * z$cena
z$koszt_zwrotu <- z$k_wysylka + z$k_obsluga + z$k_przecena + z$k_prowizja
zatrz <- dane[dane$zwrot == 0, ]
marza_kat <- tapply(zatrz$cena - zatrz$koszt, zatrz$kategoria, sum)
koszt_kat <- tapply(z$koszt_zwrotu, z$kategoria, sum)
podsum <- data.frame(kategoria = names(marza_kat), marza_tys = marza_kat / 1000, koszt_zwrotow_tys = koszt_kat / 1000,
                     procent_marzy = 100 * koszt_kat / marza_kat,
                     koszt_na_zwrot = koszt_kat / tapply(z$zwrot, z$kategoria, length),
                     koszt_na_zatrzymana_pare = koszt_kat / tapply(zatrz$zwrot, zatrz$kategoria, length))
print(podsum, digits = 3, row.names = FALSE)
round(c(marza_tys = sum(marza_kat) / 1000, koszt_tys = sum(koszt_kat) / 1000,
        procent_marzy = 100 * sum(koszt_kat) / sum(marza_kat),
        cofnieta_sprzedaz_tys = sum(z$cena) / 1000, sprzedaz_netto_tys = sum(zatrz$cena) / 1000), 1)

# Rysunek 3. Wykres wodospadowy: od marży z zatrzymanych par do marży po kosztach zwrotów
kroki <- data.frame(etykieta = c("Marża z\nzatrzymanych par", paste0("− zwroty:\n", names(koszt_kat)), "Marża po\nkosztach zwrotów"),
                    zmiana = c(sum(marza_kat), -koszt_kat, NA) / 1000)
kroki$koniec <- cumsum(ifelse(is.na(kroki$zmiana), 0, kroki$zmiana))
kroki$poczatek <- c(0, head(kroki$koniec, -1))
n_k <- nrow(kroki)
kroki$poczatek[n_k] <- 0; kroki$koniec[n_k] <- kroki$koniec[n_k - 1]
kroki$typ <- ifelse(seq_len(n_k) %in% c(1, n_k), "marża", "koszt zwrotów")
kroki$x <- seq_len(n_k)
kroki$napis <- ifelse(kroki$typ == "marża", sprintf("%.0f", kroki$koniec),
                      paste0("−", sprintf("%.1f", -kroki$zmiana), "\n(", sprintf("%.1f", c(NA, podsum$procent_marzy, NA)), "%)"))
p3 <- ggplot(kroki) +
  geom_rect(aes(xmin = x - 0.38, xmax = x + 0.38, ymin = poczatek, ymax = koniec, fill = typ), colour = "grey25", linewidth = 0.3) +
  geom_segment(data = kroki[-n_k, ], aes(x = x + 0.38, xend = x + 1 - 0.38, y = koniec, yend = koniec),
               linetype = "dotted", colour = "grey40") +
  geom_text(aes(x = x, y = pmax(poczatek, koniec), label = napis), vjust = -0.3, size = 3.5, lineheight = 0.9) +
  scale_fill_manual(values = c("marża" = kol[["niebieski"]], "koszt zwrotów" = kol[["cynober"]]), name = NULL) +
  scale_x_continuous(breaks = kroki$x, labels = kroki$etykieta) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.1))) +
  coord_cartesian(ylim = c(0.6 * min(kroki$koniec), NA)) +
  labs(title = "Gdzie znika marża: koszty zwrotów w pięciu kategoriach (tys. zł, rok)",
       subtitle = "W nawiasie: koszt zwrotów jako odsetek marży kategorii; oś Y nie zaczyna się od zera",
       x = NULL, y = "Tys. zł") +
  motyw + theme(axis.text.x = element_text(size = 9.5), legend.position = "none")
p3   # zapis: ggsave("zwroty-marza-wykres-wodospadowy.svg", p3, width = 10, height = 6)

# Koszt jednego zwrotu w półroczach (do karty)
z$polrocze <- ifelse(z$darmowe == 1, "II półrocze (darmowy zwrot)", "I półrocze (zwrot płatny)")
karta <- aggregate(cbind(k_wysylka, k_obsluga, k_przecena, k_prowizja, koszt_zwrotu) ~ polrocze, z, mean)
print(karta, digits = 3, row.names = FALSE)
round(c(srednia_cena_zwroconej = mean(z$cena), botki_przyklad = 16 + obsluga + uszkodzone * przecena * 449 + prowizja * 449), 2)

# Rysunek 4. Grafika: karta „koszt jednego zwrotu” (II półrocze)
k2 <- karta[karta$polrocze == "II półrocze (darmowy zwrot)", ]
k1 <- karta[karta$polrocze == "I półrocze (zwrot płatny)", ]
skladniki <- data.frame(nazwa = c("Wysyłka zwrotna (paczka 16 zł)", "Przyjęcie i kontrola pary",
                                  "Przecena pary nie do sprzedaży (10% × 50% ceny)", "Prowizja za płatność (1.5% ceny)"),
                        kwota = c(k2$k_wysylka, k2$k_obsluga, k2$k_przecena, k2$k_prowizja))
skladniki$y <- 6.9 - 0.85 * (seq_len(nrow(skladniki)) - 1)
skladniki$szer <- 3.4 * skladniki$kwota / max(skladniki$kwota)
p4 <- ggplot() +
  annotate("rect", xmin = 0.2, xmax = 9.8, ymin = 0.3, ymax = 9.4, fill = "#FBF3E6", colour = "grey30", linewidth = 0.5) +
  annotate("text", x = 0.6, y = 8.7, hjust = 0, size = 5.2, fontface = "bold", colour = "#0f1d3a",
           label = "Koszt jednego zwrotu pary butów") +
  annotate("text", x = 0.6, y = 8.0, hjust = 0, size = 3.7, colour = "grey25",
           label = "Średnio w II półroczu, gdy zwrot jest darmowy dla klienta (dane symulowane)") +
  geom_rect(data = skladniki, aes(xmin = 4.9, xmax = 4.9 + szer, ymin = y - 0.27, ymax = y + 0.27), fill = kol[["cynober"]]) +
  geom_text(data = skladniki, aes(x = 0.6, y = y, label = nazwa), hjust = 0, size = 3.7, colour = "grey10") +
  geom_text(data = skladniki, aes(x = 4.9 + szer + 0.12, y = y, label = sprintf("%.2f zł", kwota)), hjust = 0, size = 3.7) +
  annotate("segment", x = 0.6, xend = 9.4, y = 3.75, yend = 3.75, colour = "grey50") +
  annotate("text", x = 0.6, y = 3.2, hjust = 0, size = 4.6, fontface = "bold", colour = "#0f1d3a",
           label = sprintf("Razem: %.2f zł na zwróconą parę", k2$koszt_zwrotu)) +
  annotate("text", x = 0.6, y = 2.4, hjust = 0, size = 3.6, colour = "grey20",
           label = sprintf("W I półroczu (paczkę opłacał klient): %.2f zł", k1$koszt_zwrotu)) +
  annotate("text", x = 0.6, y = 1.5, hjust = 0, size = 3.5, colour = "grey20", lineheight = 1.0,
           label = "Nie wliczono: wysyłki do klienta, czasu obsługi klienta i utraconej sprzedaży,\ngdy para czeka na ponowne wystawienie") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0, 9.6), expand = FALSE) +
  theme_void(base_size = 13) + theme(plot.background = element_rect(fill = "white", colour = NA))
p4   # zapis: ggsave("zwroty-karta-koszt-jednego-zwrotu.svg", p4, width = 10, height = 5.6)
Wynik w R
        kategoria marza_tys koszt_zwrotow_tys procent_marzy koszt_na_zwrot
        sneakersy     348.1             37.00         10.63           38.5
 buty do biegania     260.7             18.59          7.13           44.6
   botki i kozaki     287.1             52.66         18.34           48.8
          półbuty     256.2             36.91         14.41           44.0
          sandały      96.9              9.26          9.56           31.3
 koszt_na_zatrzymana_pare
                    14.08
                    11.63
                    37.16
                    25.03
                     8.11
            marza_tys             koszt_tys         procent_marzy
               1248.9                 154.4                  12.4
cofnieta_sprzedaz_tys    sprzedaz_netto_tys
               1338.8                2941.8
                    polrocze k_wysylka k_obsluga k_przecena k_prowizja
   I półrocze (zwrot płatny)       0.0         9       18.1       5.44
 II półrocze (darmowy zwrot)      15.5         9       18.9       5.67
 koszt_zwrotu
         32.6
         49.1
srednia_cena_zwroconej         botki_przyklad
                372.61                  54.19
5. Darmowe zwroty przed i po: rysunek 5
R
# Rysunek 5. Darmowe zwroty od lipca: porównanie przed i po (dane i model m z przepisów 1–3)
d1$p_platne <- predict(m, newdata = transform(d1, darmowe = 0), type = "response")   # gdyby zwrot nadal był płatny
mies <- aggregate(cbind(zwrot, p_platne) ~ miesiac, d1, mean)
mies$udzial_botkow <- tapply(d1$kategoria == "botki i kozaki", d1$miesiac, mean)
mies$udzial_sandalow <- tapply(d1$kategoria == "sandały", d1$miesiac, mean)
print(round(mies, 3), row.names = FALSE)
pol <- function(x) ifelse(x >= 7, "II", "I")
naiwnie <- tapply(d1$zwrot, pol(d1$miesiac), mean)
platne <- tapply(d1$p_platne, pol(d1$miesiac), mean)
round(100 * c(I_obserwowane = naiwnie[["I"]], II_obserwowane = naiwnie[["II"]], roznica_naiwna = naiwnie[["II"]] - naiwnie[["I"]],
              II_gdyby_platne = platne[["II"]], czesc_od_mieszanki = platne[["II"]] - naiwnie[["I"]],
              czesc_od_polityki = naiwnie[["II"]] - platne[["II"]]), 2)
zam1 <- dane[dane$para == 1, ]
round(100 * tapply(zam1$dwa_rozmiary, pol(zam1$miesiac), mean), 1)              # zamówienia z 2 rozmiarami
round(100 * tapply(dane$zwrot, pol(dane$miesiac), mean), 1)                       # wszystkie pary
round(exp(c(OR = fixef(m)[["darmowe"]], confint(m, parm = "darmowe", method = "Wald"))), 2)

dl5 <- rbind(data.frame(miesiac = mies$miesiac, odsetek = mies$zwrot, seria = "obserwowany odsetek zwrotów"),
             data.frame(miesiac = mies$miesiac, odsetek = mies$p_platne, seria = "z modelu, gdyby zwrot pozostał płatny"))
p5 <- ggplot(dl5, aes(miesiac, odsetek, colour = seria, shape = seria, linetype = seria)) +
  annotate("rect", xmin = 6.5, xmax = 12.5, ymin = -Inf, ymax = Inf, fill = "grey92") +
  annotate("text", x = 9.5, y = 0.415, label = "darmowy zwrot od 1 lipca", size = 3.8, colour = "grey25") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c(16, 1), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = 1:12, labels = c("I", "II", "III", "IV", "V", "VI", "VII", "VIII", "IX", "X", "XI", "XII")) +
  scale_y_continuous(labels = scales::percent, limits = c(0.15, 0.42)) +
  labs(title = "Po zmianie polityki odsetek zwrotów rośnie, ale część wzrostu to sezon na botki",
       subtitle = "Zamówienia z jednym rozmiarem; linia przerywana – model dla płatnego zwrotu i tej samej mieszanki",
       x = "Miesiąc", y = "Odsetek zwróconych par") +
  motyw + guides(colour = guide_legend(nrow = 1))
p5   # zapis: ggsave("zwroty-darmowe-zwroty-przed-po.svg", p5, width = 10, height = 5.8)
Wynik w R
 miesiac zwrot p_platne udzial_botkow udzial_sandalow
       1 0.280    0.277         0.373           0.001
       2 0.257    0.266         0.312           0.013
       3 0.266    0.235         0.148           0.066
       4 0.219    0.215         0.064           0.166
       5 0.208    0.196         0.012           0.299
       6 0.172    0.188         0.004           0.320
       7 0.209    0.180         0.006           0.355
       8 0.240    0.200         0.045           0.275
       9 0.293    0.239         0.213           0.061
      10 0.299    0.276         0.384           0.003
      11 0.337    0.286         0.407           0.002
      12 0.311    0.277         0.369           0.003
     I_obserwowane     II_obserwowane     roznica_naiwna    II_gdyby_platne
             23.02              28.96               5.94              25.05
czesc_od_mieszanki  czesc_od_polityki
              2.03               3.91
  I  II
5.2 9.7
   I   II
26.2 33.4
  OR
1.23 1.11 1.36
6. Sprawdzenie palety
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (marża / koszt; dwie serie na rysunku 5)" = c("#0072B2", "#D55E00"),
             "szary – niebieski (surowy odsetek / model)" = c("#595959", "#0072B2"),
             "tło karty – cynober (słupki składników)" = c("#FBF3E6", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                             widzenie_typowe
niebieski – cynober (marża / koszt; dwie serie na rysunku 5)           114.6
szary – niebieski (surowy odsetek / model)                              42.2
tło karty – cynober (słupki składników)                                 82.0
czerwony – zielony (do unikania)                                       121.7
                                                             deuteranopia
niebieski – cynober (marża / koszt; dwie serie na rysunku 5)        108.3
szary – niebieski (surowy odsetek / model)                           45.3
tło karty – cynober (słupki składników)                              67.0
czerwony – zielony (do unikania)                                     21.1
                                                             protanopia
niebieski – cynober (marża / koszt; dwie serie na rysunku 5)       91.9
szary – niebieski (surowy odsetek / model)                         39.9
tło karty – cynober (słupki składników)                            67.0
czerwony – zielony (do unikania)                                   31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, tabele, przedziały Wilsona – pakiety base i stats). Regresję logistyczną mieszaną dopasowano pakietem lme4 (z pakietem Matrix). Rysunki wykonano w ggplot2 (osie procentowe – pakiet scales); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Matrix (wersja 1.7.4): Bates, D., Maechler, M., & Jagan, M. (2025). Matrix: Sparse and dense matrix classes and methods [R package]. https://doi.org/10.32614/CRAN.package.Matrix
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Ranking z surowych odsetków. Model z jedną sprzedaną i zwróconą parą trafia na pierwsze miejsce ze 100%.
- Zamówienia z dwoma rozmiarami w jednym worku. Dają 25.8% zwrotów, a połowa z nich jest zamierzona; zawyżają odsetek modeli, które klienci często biorą w dwóch rozmiarach.
- Pominięcie klienta w modelu. Kilku klientów zwracających prawie wszystko udaje problem produktu.
- Przed–po bez sezonu. Naiwny wzrost o 5.94 pp to w ok. jednej trzeciej sezon na botki.
- Koszt zwrotu = cena pary. Strata to średnio 49.09 zł, nie 372.61 zł średniej ceny zwracanej pary.
Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak policzyć odsetek zwrotów w sklepie internetowym?
Podziel liczbę zwróconych sztuk przez liczbę wysłanych i podaj 95% przedział Wilsona – osobno dla kategorii, rozmiarów i kanałów. Zamówienia tego samego produktu w dwóch rozmiarach licz oddzielnie, bo jeden zwrot jest w nich zaplanowany. W przykładzie odsetek wynosił 26.3% w zamówieniach jednego rozmiaru i 54.4% w zamówieniach dwóch rozmiarów.
Jaki model statystyczny zastosować do zwrotów produktów?
Regresję logistyczną z wynikiem zwrot tak/nie i skrzyżowanymi losowymi efektami produktu i klienta, np. glmer() z pakietu lme4. Model uwzględnia, że pary tego samego produktu i tego samego klienta są do siebie podobne, i daje ilorazy szans dla kategorii, rozmiaru czy kanału z poprawnymi przedziałami.
Dlaczego ranking najczęściej zwracanych produktów jest mylący?
Produkt sprzedany w 1–5 sztukach ma odsetek 0%, 20% albo 100% przez przypadek, więc ląduje na krańcach listy. W przykładzie połowa surowej listy top 10 to modele z 1–8 parami. Przewidywania z modelu mieszanego ściągają takie wyniki do średniej kategorii i lepiej odtwarzają prawdziwą kolejność (Spearman .844 wobec .772).
Ile kosztuje jeden zwrot towaru w sklepie internetowym?
To zależy od wysyłki, obsługi, przeceny towaru, którego nie da się sprzedać jako nowy, i prowizji płatniczej – nie od ceny, bo towar wraca na półkę. W fikcyjnym przykładzie zwrot pary butów kosztował średnio 49.09 zł przy darmowym zwrocie i 32.59 zł, gdy paczkę opłacał klient.
Czy darmowe zwroty zwiększają liczbę zwrotów?
W przykładzie po zmianie odsetek wzrósł o 5.94 punktu procentowego, ale około 2 pp to sezon na botki; model dał OR = 1.23, 95% CI [1.11, 1.36]. Badanie terenowe pokazało jednak, że klienci po darmowym zwrocie później wydają więcej, więc decyzję opieraj na zysku z klienta, najlepiej z eksperymentu.
Powiązane hasła
Przeczytaj też
Wielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →PoradnikOceny gwiazdkowe i ranking produktów
Sklep z artykułami kuchennymi: rozkład J, wykres lejkowy, przedział Wilsona, średnia wygładzona i symulacja 1000 sklepów z kodem R.
Czytaj →PoradnikPorzucone koszyki – mail i czas do powrotu
Sklep fotograficzny: mail po 1 h i po 24 h, odsetek powrotów z CI, Kaplan–Meier, model Coxa, błędy klastrowane i ile koszyków wróciłoby i tak – kod R.
Czytaj →PoradnikCzas dostawy a ocena i ponowny zakup
Sklep z oświetleniem i 15 000 zamówień: opóźnienie względem obietnicy, GAM, próg z bootstrapu i koszt dnia opóźnienia – sześć rysunków z kodem R.
Czytaj →Masz w pracy dane o zwrotach, reklamacjach albo rezygnacjach?
Pomożemy dobrać model dla wyniku tak/nie z powtarzającymi się produktami i klientami, policzyć koszty i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Abdulla, H., Ketzenberg, M., & Abbey, J. D. (2019). Taking stock of consumer returns: A review and classification of the literature. Journal of Operations Management, 65(6), 560–605. https://doi.org/10.1002/joom.1047
- Baayen, R. H., Davidson, D. J., & Bates, D. M. (2008). Mixed-effects modeling with crossed random effects for subjects and items. Journal of Memory and Language, 59(4), 390–412. https://doi.org/10.1016/j.jml.2007.12.005 ● Otwarty dostęp: pełny tekst
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008 ● Otwarty dostęp: pełny tekst
- Bower, A. B., & Maxham, J. G. (2012). Return shipping policies of online retailers: Normative assumptions and the long-term consequences of fee and free returns. Journal of Marketing, 76(5), 110–124. https://doi.org/10.1509/jm.10.0419
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Petersen, J. A., & Kumar, V. (2009). Are product returns a necessary evil? Antecedents and consequences. Journal of Marketing, 73(3), 35–51. https://doi.org/10.1509/jmkg.73.3.035
Cytowania BibTeX
@article{abdulla2019taking, author={Abdulla, Huseyn and Ketzenberg, Michael and Abbey, James D.}, title={{Taking stock of consumer returns: A review and classification of the literature}}, journal={Journal of Operations Management}, year={2019}, volume={65}, number={6}, pages={560--605}, doi={10.1002/joom.1047}}@article{baayen2008mixed, author={Baayen, R. Harald and Davidson, Douglas J. and Bates, Douglas M.}, title={{Mixed-effects modeling with crossed random effects for subjects and items}}, journal={Journal of Memory and Language}, year={2008}, volume={59}, number={4}, pages={390--412}, doi={10.1016/j.jml.2007.12.005}}@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{bolker2009generalized, author={Bolker, Benjamin M. and Brooks, Mollie E. and Clark, Connie J. and Geange, Shane W. and Poulsen, John R. and Stevens, M. Henry H. and White, Jada-Simone S.}, title={{Generalized linear mixed models: A practical guide for ecology and evolution}}, journal={Trends in Ecology \& Evolution}, year={2009}, volume={24}, number={3}, pages={127--135}, doi={10.1016/j.tree.2008.10.008}}@article{bower2012return, author={Bower, Amanda B. and Maxham, James G.}, title={{Return shipping policies of online retailers: Normative assumptions and the long-term consequences of fee and free returns}}, journal={Journal of Marketing}, year={2012}, volume={76}, number={5}, pages={110--124}, doi={10.1509/jm.10.0419}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@article{petersen2009product, author={Petersen, J. Andrew and Kumar, V.}, title={{Are product returns a necessary evil? Antecedents and consequences}}, journal={Journal of Marketing}, year={2009}, volume={73}, number={3}, pages={35--51}, doi={10.1509/jmkg.73.3.035}}