Przykład: sklep z akcesoriami fotograficznymi
Fikcyjny sklep internetowy sprzedaje obiektywy, statywy, karty pamięci i torby fotograficzne. Klient wkłada produkty do koszyka, ale nie kończy zamówienia – to porzucony koszyk, wyciek na jednym z etapów z wpisu lejek konwersji – etapy i test A/B. Dział marketingu pyta: czy wysyłać mail przypominający o koszyku, a jeśli tak – po godzinie czy po dobie?
Sklep zrobił test A/B z trzema grupami. Przez 6 tygodni każdy porzucony koszyk zalogowanego klienta ze zgodą na maile trafiał losowo do jednej z grup: brak maila, mail po 1 h, mail po 24 h. Mail wychodził tylko wtedy, gdy klient do tej pory nie wrócił. Wynik: zakup z tego koszyka w ciągu 7 dni (168 h) i czas od porzucenia do zakupu w godzinach. Losowaliśmy koszyki, nie klientów.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Parametry ustaliliśmy ręcznie (pełna lista przy kodzie): wspólna dla koszyków klienta skłonność do powrotu, ryzyko powrotu wysokie w pierwszych godzinach, rzadsze powroty nowych klientów i droższych koszyków. Mail działa na dwa sposoby: 40% osób, które i tak wróciłyby w ciągu 14 dni, wraca zaraz po mailu (przyspieszenie), a części pozostałych mail daje impuls do powrotu, słabszy po 24 h niż po 1 h. Po pierwszym uruchomieniu zwiększyliśmy wariancję skłonności (z 1.2 do 2) i liczbę koszyków na klienta, żeby problem powtarzających się klientów był widoczny; ziarna 674 nie zmienialiśmy. Dane pobierzesz jako porzucone-koszyki-akcesoria-foto.csv (wiersz = koszyk; kolumna wrocilby_i_tak istnieje tylko w symulacji).
Mamy 11 049 porzuconych koszyków od 5000 klientów; 2289 klientów porzuciło co najmniej dwa koszyki (najwięcej 15). Mediana wartości koszyka to 356 zł. Inne tematy prac zbiera wpis statystyka w pracy z marketingu.
Rysunek 1: lejek z porzuceniem i trzy ścieżki
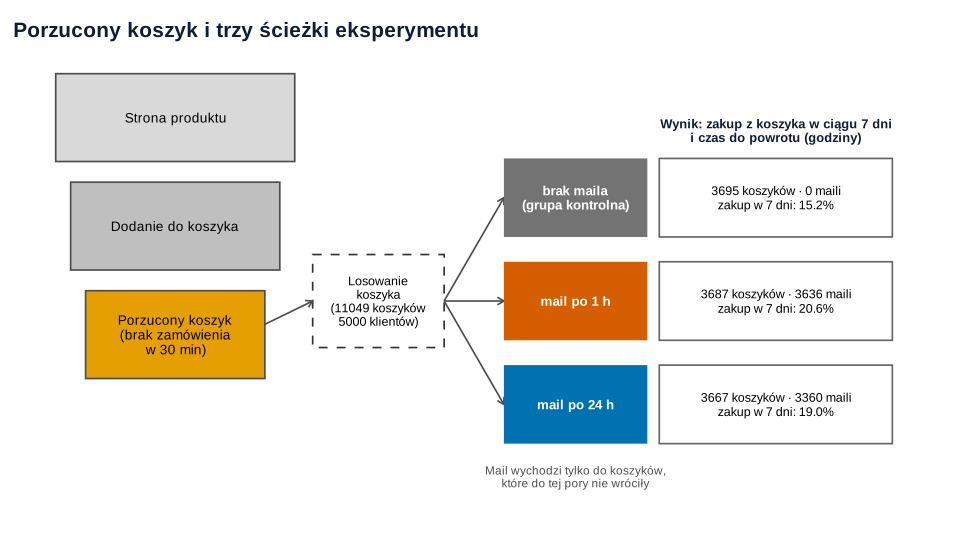
set.seed(674)).Co widać. Grupy są prawie równe (3695, 3687 i 3667 koszyków), bo o przydziale decyduje losowanie. Maili wysłano jednak mniej niż koszyków: 3636 w grupie „po 1 h” (98.6%) i 3360 w grupie „po 24 h” (91.6%). Reszta klientów wróciła sama, zanim mail wyszedł.
Jak może zmylić. Kusi, żeby porównać tylko koszyki, do których mail wyszedł. To błąd: w grupie „po 24 h” odpadają wtedy klienci najszybciej wracający, a w grupie kontrolnej nie. Porównuj całe grupy z losowania – to zasada analizy ITT (intention-to-treat).
Rysunek 2: ile koszyków wróciło w 7 dni
Najprostsza miara to odsetek koszyków kupionych w ciągu 7 dni. Przedział dla odsetka liczymy metodą Wilsona – Brown i in. (2001) pokazali, że zwykły przedział Walda ma nieregularne pokrycie, i polecają m.in. Wilsona (zob. przedział ufności dla proporcji). Przyrost wobec braku maila to różnica odsetków w punktach procentowych (pp).
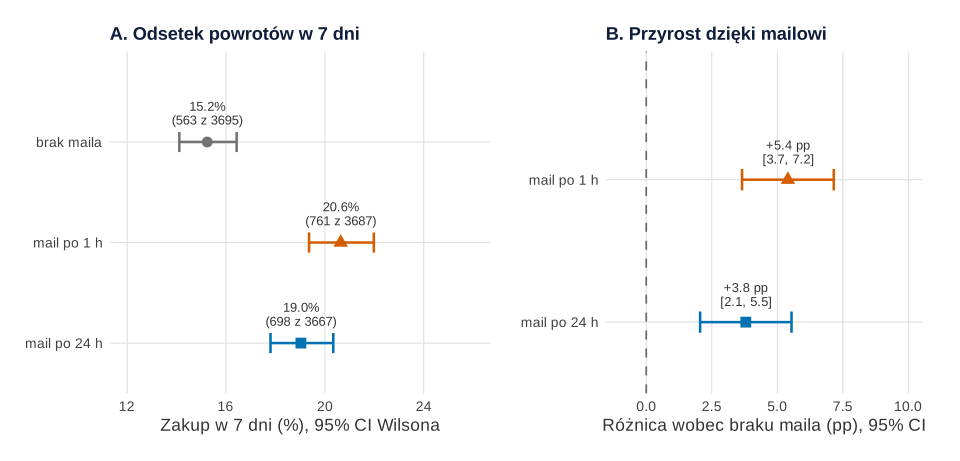
Co widać. Bez maila wróciło 15.24% koszyków (95% CI [14.11, 16.43]), po mailu po 1 h – 20.64% [19.36, 21.98], po mailu po 24 h – 19.03% [17.80, 20.34]; χ²(2) = 38.02, p < .001. Mail po 1 h dodał 5.40 pp (95% CI [3.65, 7.15], p < .001), mail po 24 h – 3.80 pp [2.05, 5.54], p < .001. Różnica między mailami (1.61 pp, 95% CI [−0.26, 3.47], p = .091) nie jest rozstrzygnięta.
Jak może zmylić. Odsetek po 7 dniach mówi „ile”, ale nie „kiedy” (to pokaże rysunek 3). Brak istotnej różnicy między mailami nie znaczy, że są równie dobre.
Koszyki tego samego klienta: błędy klastrowane
Zwykłe przedziały zakładają niezależne obserwacje. Tu 2289 klientów ma po kilka koszyków, a ich zachowanie jest podobne: kto łatwo wraca, wraca przy każdym koszyku. Dlatego liczymy błędy standardowe odporne na klastrowanie po kliencie – Cameron i Miller (2015) pokazują, że domyślne błędy przy danych w klastrach mogą znacznie zawyżać precyzję.
Wynik jest pouczający. Błąd standardowy odsetka w jednej grupie rośnie po uwzględnieniu klastrów o 10–17% (ilorazy 1.103, 1.116 i 1.165). Błąd różnicy między grupami prawie się nie zmienia (1.002 i 1.014). Losowaliśmy koszyki, więc ten sam klient często trafia do obu porównywanych grup i jego skłonność się odejmuje. Przy losowaniu klientów błąd różnicy rósłby jak błąd odsetka.
Rysunek 3: czas do powrotu – Kaplan–Meier
Każdy koszyk ma czas do zakupu albo – gdy przez 7 dni nie wrócił – obserwację cenzurowaną w 168. godzinie. Takie dane opisuje krzywa Kaplana–Meiera (Kaplan i Meier, 1958). Zamiast „przeżycia” rysujemy jej dopełnienie: skumulowany odsetek koszyków, które już wróciły. Procedurę opisuje wpis Kaplan–Meier i model Coxa krok po kroku, a odejścia klientów – churn jako analiza przeżycia.
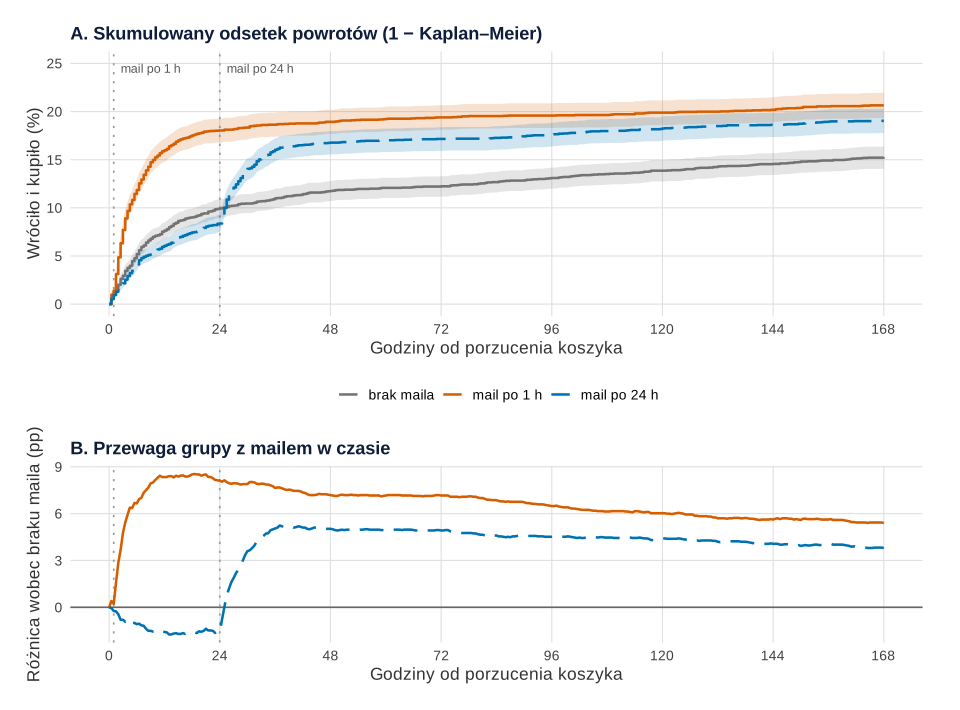
Co widać – panel A. Po 6 h wróciło 5.20% koszyków bez maila i 11.85% po mailu po 1 h; po 24 h – 9.93% i 18.04%. Krzywa maila po 24 h do wysyłki biegnie nieco poniżej kontroli (8.37% wobec 9.93% w 24. godzinie), a potem skacze: 16.77% w 48. godzinie wobec 11.75% bez maila. Wśród koszyków, które wróciły, mediana czasu do zakupu wynosi 4.5 h po mailu po 1 h, 11.9 h bez maila i 24.6 h po mailu po 24 h. Test log-rank: χ²(2) = 45.1, p < .001.
Co widać – panel B. Przewaga maila po 1 h osiąga 8.54 pp w 18.5. godzinie, a po 7 dniach spada do 5.40 pp. Część wczesnej przewagi to przyspieszenie: klienci, którzy wróciliby w 2.–7. dniu, kupili zaraz po mailu, a w grupie bez maila „dogonili” później. Przewaga maila po 24 h ma szczyt 5.24 pp w 37. godzinie i kończy na 3.80 pp.
Jak może zmylić. Odczyt w szczycie („mail daje +8.5 pp”) zawyża efekt – horyzont ustal przed testem. Grupa „po 24 h” jest przed wysyłką poniżej kontroli, choć mail jeszcze nie działał: to przypadek losowania.
Rysunek 4: model Coxa i założenie proporcjonalności
Model Coxa (Cox, 1972) opisuje, ile razy wyższe jest chwilowe ryzyko powrotu w grupie z mailem – to iloraz hazardów (HR). Dodaliśmy nowego klienta i wartość koszyka (log₂, więc HR dotyczy koszyka dwa razy droższego), a błędy policzyliśmy odpornie na klastry po kliencie (estymator „kanapkowy”, Lin i Wei, 1989).
Jeden HR na cały tydzień: mail po 1 h 1.45 (95% CI [1.30, 1.61]), mail po 24 h 1.26 [1.13, 1.41], oba p < .001. Nowi klienci wracają rzadziej (HR = 0.76) – i tu klastry mają znaczenie: przedział [0.69, 0.83] rośnie do [0.67, 0.86], bo „nowy” to cecha klienta, a nie koszyka. Test reszt Schoenfelda dla grupy daje jednak χ²(2) = 251.57, p < .001: hazardy wyraźnie nie są proporcjonalne. Hess (1995) zaleca do oceny naruszeń wygładzone wykresy reszt Schoenfelda, bo pokazują, jak efekt zmienia się w czasie; my po prostu dzielimy obserwację na 0–24 h i 24–168 h.
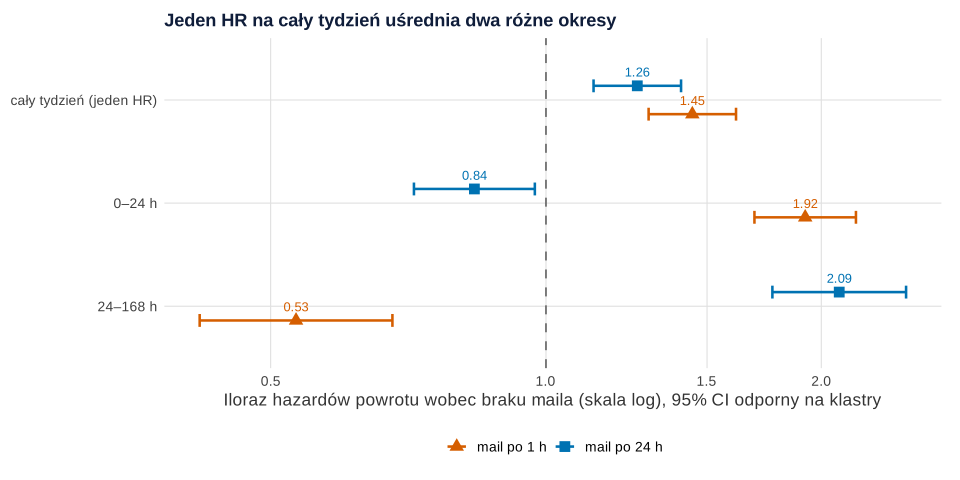
Co widać. Mail po 1 h: HR = 1.92 [1.69, 2.18] w pierwszej dobie i 0.53 [0.42, 0.68] później. Mail po 24 h: 0.84 [0.72, 0.97] przed wysyłką i 2.09 [1.77, 2.48] po niej. Jeden HR z całego tygodnia uśrednia te okresy i nie odpowiada żadnemu z nich.
Jak może zmylić. HR = 0.53 po pierwszej dobie nie znaczy, że mail szkodzi. Po mailu szybko wrócili klienci najbardziej skłonni do powrotu, więc po 24 h w grupie zostają „trudniejsi” niż w kontroli – HR w okresie porównuje już inne grupy ludzi. Z kolei HR = 0.84 przed wysyłką (p = .020) to przypadek: w symulacji mail nie mógł działać przed 24. godziną. Dlatego decyzję opieraj na różnicy odsetków w ustalonym horyzoncie (rysunek 2).
Rysunek 5: część koszyków wróciłaby i tak
System mailingowy raportuje „odzyskane koszyki”: zakupy po kliknięciu w link z maila. Kliknąć może jednak ktoś, kto i tak by wrócił. W symulacji znamy prawdę dla każdego koszyka.
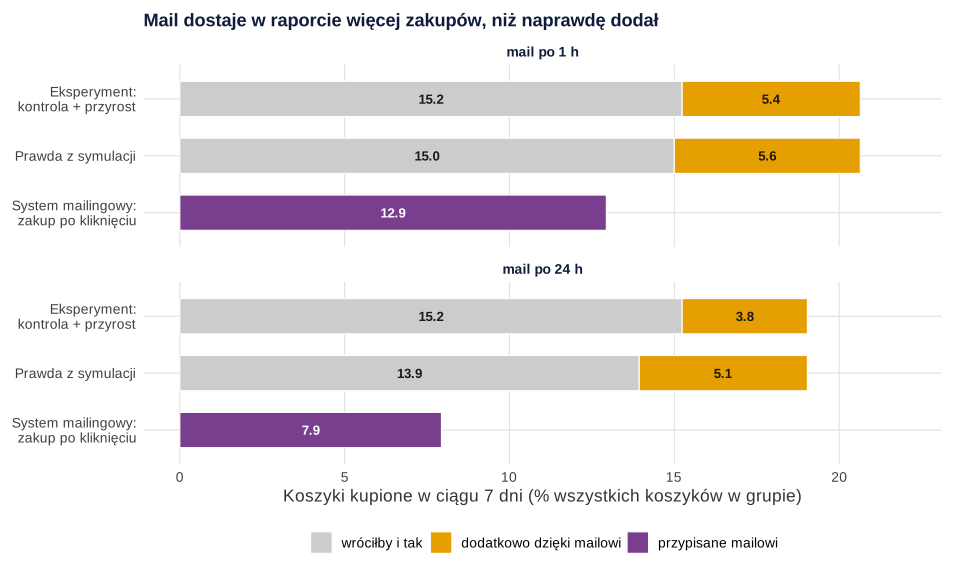
Co widać. Po mailu po 1 h system przypisuje mailowi 12.94% koszyków, a eksperyment pokazuje przyrost 5.40 pp – 2.39 raza mniej. Po mailu po 24 h: 7.94% wobec 3.80 pp (2.09 raza). Wśród zakupów po kliknięciu 64.6% (po 1 h) i 47.1% (po 24 h) to koszyki, które wróciłyby bez maila.
Ile maili na jeden dodatkowy zakup? Przyrost dotyczy całej grupy, a mail dostało 98.6% i 91.6% koszyków. Na koszyk, do którego mail wyszedł, przypada więc 5.48 i 4.14 pp, czyli 18.3 i 24.1 maila na jeden dodatkowy zakup – to marketingowy odpowiednik NNT z badań klinicznych.
Jak może zmylić. W eksperymencie przyrost po 24 h (3.80 pp) jest niższy niż prawda (5.10 pp), bo przez przypadek do tej grupy trafiło mniej koszyków, które wróciłyby same (13.94% wobec 15.24% w kontroli). Przedział [2.05, 5.54] obejmuje jednak prawdę. Ten sam problem przypisywania zakupów kanałom opisuje wpis atrybucja kanałów: łańcuch Markowa.
Rabat w mailu – następny eksperyment
Naturalny pomysł: dodać do maila rabat. To pytanie na osobny eksperyment: mail po 1 h bez rabatu vs ten sam mail z rabatem 5%, znów z losowaniem koszyków. Rabat obniża marżę na każdym zakupie z tego maila, także na tych 20.6%, które zdarzyłyby się bez niego. Przy marży 30% (parametr przyjęty ręcznie) rabat 5% opłaca się dopiero przy przyroście co najmniej 4.13 pp. Wykrycie takiego przyrostu z mocą 80% (α = .05) wymaga 1616 koszyków na grupę. Kilka czynników naraz testuje eksperyment czynnikowy w mailingu, a wybór klientów do rabatu – modelowanie uplift.
Co z tym zrobić w marketingu
- Wysyłaj przypomnienie, raczej po 1 h niż po 24 h. Oba maile dają przyrost, mail po 1 h większy (+5.40 vs +3.80 pp), ale różnica między nimi nie jest rozstrzygnięta (p = .091). Przy tym samym koszcie wybierz wcześniejszy.
- Rozliczaj mail przyrostem z grupy bez maila, a nie kliknięciami. Raport systemu mailingowego zawyża efekt ponad dwukrotnie. Zostaw na stałe małą grupę kontrolną (np. 10% koszyków bez maila), żeby mierzyć przyrost na bieżąco – podobnie działa test wyłączenia reklamy (holdout).
- Raportuj odsetek po 7 dniach, a krzywą czasu jako uzupełnienie – przyspieszenie zakupu to nie dodatkowa sprzedaż.
- Kupiony koszyk to jeszcze nie przychód. Część zamówień wraca – przyrost przelicz na marżę po zwrotach (zob. zwroty produktów w sklepie internetowym).
- Pilnuj metryk ochronnych: wypisania z listy mailowej i skargi. Kohavi i in. (2020) opisują, jak zdefiniować kluczowe metryki i ogólne kryterium oceny eksperymentu.
Jak opisać w pracy
W Metodzie opisz jednostkę losowania, warunek wysyłki, horyzont, cenzurowanie i klastrowanie; w Wynikach najpierw odsetki i różnice, potem model Coxa.
Kod R: dane, odsetki, Kaplan–Meier, Cox i przyrost
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają przepisy 2–6. Analiza czasu to pakiet survival (survfit(), survdiff(), coxph(), cox.zph(), survSplit()), błędy klastrowane – sandwich, reszta – bazowy R. Każdy przepis z rysunkiem kończy się nazwą wykresu (p2–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losuje tylko przepis 1 (set.seed(674)); ziarno ustalono raz i nie zmieniano go. Ręcznie ustalono: 5000 klientów, liczbę koszyków na klienta (1 + ujemny dwumianowy, średnia 1.2, size 0.5, najwyżej 15), skłonność klienta do powrotu (gamma, średnia 1, wariancja 2), 40% nowych klientów (hazard × 0.7), wartość koszyka (lognormalny, mediana 350 zł; hazard × (wartość/350)−0.25), naturalny hazard powrotu 0.012·e−t/10 + 0.0006 na godzinę, horyzont 168 h, przyspieszenie powrotu po mailu u 40% osób, które i tak wróciłyby w 14 dni (powrót średnio 4 h po mailu), impuls nowych powrotów (skumulowany hazard 0.09 po mailu po 1 h i 0.07 po 24 h, stała wygasania 6 h) oraz prawdopodobieństwo kliknięcia w link przy zakupie po mailu (0.85 dla zakupów wywołanych lub przyspieszonych przez mail, 0.45 dla pozostałych). Po pierwszym uruchomieniu zmieniono wariancję skłonności (1.2 → 2) i rozkład liczby koszyków (średnia 0.8 → 1.2, size 0.6 → 0.5, limit 12 → 15), żeby efekt powtarzających się klientów był widoczny, oraz ustawiono minimalny czas 0.01 h (model Coxa z podziałem czasu nie przyjmuje czasu 0). Całość liczy się w kilka sekund.
1. Paleta, motyw i dane
R
# Przepis 1. Fikcyjny sklep internetowy z akcesoriami fotograficznymi: porzucone koszyki
# i eksperyment z mailem przypominającym (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta oparta na Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(brak = "grey45", h1 = "#D55E00", h24 = "#0072B2", pomarancz = "#E69F00",
         fiolet = "#7A3E8E", jasny = "grey80", ciemny = "grey20")
kol_grupy <- c("brak maila" = kol[["brak"]], "mail po 1 h" = kol[["h1"]], "mail po 24 h" = kol[["h24"]])
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie --------------------------------------------------------------
n_klientow <- 5000            # zalogowani klienci ze zgodą na maile, 6 tygodni testu
okno       <- 168             # obserwujemy 7 dni (168 h) od porzucenia koszyka
# Naturalny hazard powrotu (na godzinę): szybki powrót w pierwszych godzinach, potem niski poziom
hazard0    <- function(t) 0.012 * exp(-t / 10) + 0.0006
H0         <- function(t) 0.012 * 10 * (1 - exp(-t / 10)) + 0.0006 * t   # skumulowany hazard
wysylka    <- c("brak maila" = Inf, "mail po 1 h" = 1, "mail po 24 h" = 24)
przyspiesz <- 0.40            # odsetek osób, które i tak by wróciły, a mail przyspiesza ich powrót
nowy_powrot <- c("mail po 1 h" = 0.09, "mail po 24 h" = 0.07)  # siła impulsu „nowych” powrotów (skumulowany hazard)
czas_impulsu <- 6             # impuls po mailu wygasa w ciągu kilkunastu godzin (stała 6 h)

set.seed(674)
klienci <- data.frame(klient = seq_len(n_klientow),
                      nowy = rbinom(n_klientow, 1, 0.40),                       # bez wcześniejszego zakupu
                      sklonnosc = rgamma(n_klientow, shape = 1 / 2, scale = 2),   # wspólna dla koszyków klienta; wariancja 2
                      koszykow = pmin(1 + rnbinom(n_klientow, mu = 1.2, size = 0.5), 15))
koszyki <- klienci[rep(klienci$klient, klienci$koszykow), c("klient", "nowy", "sklonnosc")]
n <- nrow(koszyki)
koszyki$koszyk  <- seq_len(n)
koszyki$wartosc <- round(rlnorm(n, log(350), 0.9))                  # zł; od kart pamięci po obiektywy
koszyki$grupa   <- factor(sample(names(wysylka), n, replace = TRUE), levels = names(wysylka))  # losowanie koszyków
mnoznik <- koszyki$sklonnosc * 0.7^koszyki$nowy * (koszyki$wartosc / 350)^(-0.25)

# Czas powrotu bez maila (T0): odwracamy skumulowany hazard na gęstej siatce czasu
siatka <- seq(0, 2 * okno, by = 0.05)
E0 <- rexp(n) / mnoznik
T0 <- ifelse(E0 < H0(2 * okno), approx(H0(siatka), siatka, E0)$y, Inf)
# Mail wychodzi tylko wtedy, gdy klient nie wrócił przed godziną wysyłki
tau <- wysylka[as.character(koszyki$grupa)]
koszyki$mail <- as.integer(T0 > tau)
# (a) przyspieszenie: część osób, które wróciłyby i tak (w ciągu 14 dni), wraca zaraz po mailu
T_przysp <- ifelse(koszyki$mail == 1 & T0 <= 2 * okno & runif(n) < przyspiesz, tau + rexp(n, 1 / 4), Inf)
# (b) nowe powroty: impuls hazardu po mailu, silniejszy u klientów skłonnych do powrotu
A <- ifelse(koszyki$mail == 1, nowy_powrot[as.character(koszyki$grupa)] * mnoznik, 0)
E1 <- rexp(n)
T1 <- ifelse(koszyki$mail == 1 & E1 < A, tau - czas_impulsu * log(1 - pmin(E1 / A, 0.999999)), Inf)
T <- pmin(T0, T_przysp, T1)
koszyki$powrot <- as.integer(T <= okno)                      # zakup z porzuconego koszyka w ciągu 7 dni
koszyki$czas   <- pmax(round(pmin(T, okno), 2), 0.01)       # godziny od porzucenia (168 = ocenzurowany)
koszyki$wrocilby_i_tak <- as.integer(T0 <= okno)             # prawda znana tylko w symulacji
# Klik w link z maila (to, co raportuje system mailingowy jako „odzyskany koszyk”)
z_maila <- koszyki$powrot == 1 & koszyki$mail == 1 & T > tau
koszyki$klik_z_maila <- as.integer(z_maila & runif(n) < ifelse(T == T0, 0.45, 0.85))
koszyki$sklonnosc <- NULL

write.csv(koszyki, "porzucone-koszyki-akcesoria-foto.csv", row.names = FALSE)

# Opis danych
c(koszykow = n, klientow = n_klientow, klientow_z_2_plus = sum(klienci$koszykow >= 2),
  maks_koszykow = max(klienci$koszykow), mediana_wartosci = median(koszyki$wartosc))
table(koszyki$grupa)
# Ile maili wysłano i ile koszyków wróciło w 7 dni
aggregate(cbind(mail, powrot, klik_z_maila, wrocilby_i_tak) ~ grupa, data = koszyki, FUN = sum)
round(100 * aggregate(cbind(mail, powrot, wrocilby_i_tak) ~ grupa, data = koszyki, FUN = mean)[, -1], 2)
Wynik w R
         koszykow          klientow klientow_z_2_plus     maks_koszykow
            11049              5000              2289                15
 mediana_wartosci
              356

  brak maila  mail po 1 h mail po 24 h
        3695         3687         3667
         grupa mail powrot klik_z_maila wrocilby_i_tak
1   brak maila    0    563            0            563
2  mail po 1 h 3636    761          477            553
3 mail po 24 h 3360    698          291            511
   mail powrot wrocilby_i_tak
1  0.00  15.24          15.24
2 98.62  20.64          15.00
3 91.63  19.03          13.94
2. Odsetki, przyrost i błędy klastrowane: Rysunek 2
R
# Przepis 2. Odsetek powrotów w 7 dni z 95% CI i przyrost wobec braku maila (Rysunek 2)
# Korzysta z obiektów przepisu 1: koszyki, kol_grupy, motyw. Nie losuje.
library(sandwich)

# (a) Odsetek w każdej grupie: przedział Wilsona (prop.test bez poprawki na ciągłość)
odsetki <- do.call(rbind, lapply(split(koszyki, koszyki$grupa), function(d) {
  pt <- prop.test(sum(d$powrot), nrow(d), correct = FALSE)
  data.frame(grupa = d$grupa[1], n = nrow(d), powroty = sum(d$powrot),
             proc = 100 * mean(d$powrot), dolna = 100 * pt$conf.int[1], gorna = 100 * pt$conf.int[2])
}))
odsetki[, 4:6] <- round(odsetki[, 4:6], 2)
odsetki
chisq.test(table(koszyki$grupa, koszyki$powrot))

# (b) Przyrost wobec braku maila: model liniowy prawdopodobieństwa (różnica odsetków w pp)
#     z błędami zwykłymi i odpornymi na klastrowanie po kliencie (ten sam klient ma kilka koszyków)
m <- lm(I(100 * powrot) ~ grupa, data = koszyki)
se_zwykly <- sqrt(diag(vcovHC(m, type = "HC0")))
se_klaster <- sqrt(diag(vcovCL(m, cluster = ~ klient, type = "HC0")))
przyrost <- data.frame(grupa = c("mail po 1 h", "mail po 24 h"), roznica_pp = coef(m)[2:3],
                       se_zwykly = se_zwykly[2:3], se_klaster = se_klaster[2:3])
przyrost$dolna <- przyrost$roznica_pp - 1.96 * przyrost$se_klaster
przyrost$gorna <- przyrost$roznica_pp + 1.96 * przyrost$se_klaster
przyrost$p <- 2 * pnorm(-abs(przyrost$roznica_pp / przyrost$se_klaster))
rownames(przyrost) <- NULL
print(przyrost, digits = 3)
# Różnica między mailem po 1 h i po 24 h (ten sam model, kontrast)
k <- c(0, 1, -1)
r12 <- sum(k * coef(m)); se12 <- sqrt(drop(t(k) %*% vcovCL(m, cluster = ~ klient, type = "HC0") %*% k))
round(c(roznica_1h_vs_24h = r12, dolna = r12 - 1.96 * se12, gorna = r12 + 1.96 * se12,
        p = 2 * pnorm(-abs(r12 / se12))), 3)

# (c) Klastrowanie: o ile rośnie błąd standardowy odsetka w grupie, a o ile błąd różnicy?
m0 <- lm(I(100 * powrot) ~ 0 + grupa, data = koszyki)
round(rbind(odsetek_w_grupie = sqrt(diag(vcovCL(m0, cluster = ~ klient, type = "HC0"))) /
                               sqrt(diag(vcovHC(m0, type = "HC0"))),
            roznica_wobec_braku = c(NA, se_klaster[2:3] / se_zwykly[2:3])), 3)

# Rysunek 2A: odsetki z przedziałami Wilsona; 2B: przyrost w pp z przedziałem odpornym na klastrowanie
pA <- ggplot(odsetki, aes(x = proc, y = grupa, colour = grupa)) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.9, orientation = "y") +
  geom_point(aes(shape = grupa), size = 3.4) +
  geom_text(aes(label = sprintf("%.1f%%\n(%d z %d)", proc, powroty, n)), vjust = -0.75, size = 3.4,
            colour = "grey20", lineheight = 0.9) +
  scale_colour_manual(values = kol_grupy, guide = "none") + scale_shape_manual(values = c(16, 17, 15), guide = "none") +
  scale_y_discrete(limits = rev(levels(koszyki$grupa)), expand = expansion(add = c(0.5, 0.9))) +
  scale_x_continuous(limits = c(12, 26)) +
  labs(x = "Zakup w 7 dni (%), 95% CI Wilsona", y = NULL, title = "A. Odsetek powrotów w 7 dni") + motyw
pB <- ggplot(przyrost, aes(x = roznica_pp, y = grupa, colour = grupa)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.15, linewidth = 0.9, orientation = "y") +
  geom_point(aes(shape = grupa), size = 3.4) +
  geom_text(aes(label = sprintf("+%.1f pp\n[%.1f, %.1f]", roznica_pp, dolna, gorna)), vjust = -0.7, size = 3.4,
            colour = "grey20", lineheight = 0.9) +
  scale_colour_manual(values = kol_grupy, guide = "none") + scale_shape_manual(values = c(17, 15), guide = "none") +
  scale_y_discrete(limits = rev(przyrost$grupa), expand = expansion(add = c(0.5, 0.9))) +
  scale_x_continuous(limits = c(-1, 10)) +
  labs(x = "Różnica wobec braku maila (pp), 95% CI", y = NULL,
       title = "B. Przyrost dzięki mailowi") + motyw + theme(axis.text.y = element_blank())
p2 <- pA + pB + plot_layout(widths = c(1.2, 1))
p2   # zapis: ggsave("porzucone-koszyki-odsetki-przyrost.svg", p2, width = 10, height = 4.8)
Wynik w R
                    grupa    n powroty  proc dolna gorna
brak maila     brak maila 3695     563 15.24 14.11 16.43
mail po 1 h   mail po 1 h 3687     761 20.64 19.36 21.98
mail po 24 h mail po 24 h 3667     698 19.03 17.80 20.34

	Pearson's Chi-squared test

data:  table(koszyki$grupa, koszyki$powrot)
X-squared = 38.017, df = 2, p-value = 5.556e-09

         grupa roznica_pp se_zwykly se_klaster dolna gorna        p
1  mail po 1 h        5.4     0.891      0.893  3.65  7.15 1.42e-09
2 mail po 24 h        3.8     0.877      0.889  2.05  5.54 1.96e-05
roznica_1h_vs_24h             dolna             gorna                 p
            1.605            -0.255             3.466             0.091
                    grupabrak maila grupamail po 1 h grupamail po 24 h
odsetek_w_grupie              1.103            1.116             1.165
roznica_wobec_braku              NA            1.002             1.014
3. Kaplan–Meier i przewaga w czasie: Rysunek 3
R
# Przepis 3. Czas do powrotu: Kaplan–Meier jako skumulowany odsetek powrotów (Rysunek 3)
# Korzysta z obiektów przepisu 1: koszyki, kol_grupy, motyw. Nie losuje.
library(survival)

km <- survfit(Surv(czas, powrot) ~ grupa, data = koszyki)
# Skumulowany odsetek powrotów (1 − S(t)) po 1, 6, 24, 48 i 168 h
s <- summary(km, times = c(1, 6, 24, 48, 168), extend = TRUE)
tab <- data.frame(grupa = sub("grupa=", "", s$strata), godzina = s$time, proc = 100 * (1 - s$surv),
                  dolna = 100 * (1 - s$upper), gorna = 100 * (1 - s$lower))
tab[, 3:5] <- round(tab[, 3:5], 2)
tab
# Test log-rank (zakłada niezależne koszyki – ten sam klient bywa w kilku grupach, więc traktuj orientacyjnie)
survdiff(Surv(czas, powrot) ~ grupa, data = koszyki)
# Wśród koszyków, które wróciły w 7 dni: mediana godzin do powrotu
aggregate(czas ~ grupa, data = koszyki[koszyki$powrot == 1, ], FUN = function(x) round(median(x), 1))

# Dane do rysunku: krzywa K–M z przedziałem odczytana co pół godziny i różnica wobec braku maila
godz <- seq(0, 168, by = 0.5)
sk <- summary(km, times = godz, extend = TRUE)
krzywe <- data.frame(grupa = factor(sub("grupa=", "", sk$strata), levels = levels(koszyki$grupa)), czas = sk$time,
                     proc = 100 * (1 - sk$surv), dolna = 100 * (1 - sk$upper), gorna = 100 * (1 - sk$lower))
roznica <- merge(krzywe[krzywe$grupa != "brak maila", c("grupa", "czas", "proc")],
                 setNames(krzywe[krzywe$grupa == "brak maila", c("czas", "proc")], c("czas", "proc0")), by = "czas")
roznica$pp <- roznica$proc - roznica$proc0
roznica$grupa <- droplevels(roznica$grupa)
# Kiedy przewaga maila po 1 h była największa i ile zostało po 7 dniach?
do.call(rbind, lapply(split(roznica, roznica$grupa), function(d)
  data.frame(grupa = d$grupa[1], maks_pp = round(max(d$pp), 2), w_godzinie = d$czas[which.max(d$pp)],
             po_168h = round(d$pp[d$czas == 168], 2))))

pA <- ggplot(krzywe, aes(czas, proc, colour = grupa)) +
  geom_vline(xintercept = c(1, 24), colour = "grey60", linetype = "dotted") +
  geom_ribbon(aes(ymin = dolna, ymax = gorna, fill = grupa), colour = NA, alpha = 0.18) +
  geom_step(aes(linetype = grupa), linewidth = 0.9) +
  annotate("text", x = c(2.5, 25.5), y = 24.5, label = c("mail po 1 h", "mail po 24 h"), hjust = 0, size = 3.3,
           colour = "grey35") +
  scale_colour_manual(values = kol_grupy, name = NULL) + scale_fill_manual(values = kol_grupy, guide = "none") +
  scale_linetype_manual(values = c("solid", "solid", "longdash"), name = NULL) +
  scale_x_continuous(breaks = c(0, 24, 48, 72, 96, 120, 144, 168)) +
  coord_cartesian(ylim = c(0, 25)) +
  labs(x = "Godziny od porzucenia koszyka", y = "Wróciło i kupiło (%)",
       title = "A. Skumulowany odsetek powrotów (1 − Kaplan–Meier)") + motyw
pB <- ggplot(roznica, aes(czas, pp, colour = grupa, linetype = grupa)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_vline(xintercept = c(1, 24), colour = "grey60", linetype = "dotted") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = kol_grupy[-1], guide = "none") +
  scale_linetype_manual(values = c("solid", "longdash"), guide = "none") +
  scale_x_continuous(breaks = c(0, 24, 48, 72, 96, 120, 144, 168)) +
  labs(x = "Godziny od porzucenia koszyka", y = "Różnica wobec braku maila (pp)",
       title = "B. Przewaga grupy z mailem w czasie") + motyw
p3 <- pA / pB + plot_layout(heights = c(1.5, 1))
p3   # zapis: ggsave("porzucone-koszyki-kaplan-meier.svg", p3, width = 10, height = 7.4)
Wynik w R
          grupa godzina  proc dolna gorna
1    brak maila       1  1.16  0.82  1.51
2    brak maila       6  5.20  4.48  5.91
3    brak maila      24  9.93  8.96 10.89
4    brak maila      48 11.75 10.70 12.78
5    brak maila     168 15.24 14.07 16.39
6   mail po 1 h       1  1.38  1.01  1.76
7   mail po 1 h       6 11.85 10.80 12.89
8   mail po 1 h      24 18.04 16.79 19.27
9   mail po 1 h      48 18.93 17.66 20.19
10  mail po 1 h     168 20.64 19.32 21.94
11 mail po 24 h       1  0.93  0.62  1.24
12 mail po 24 h       6  4.12  3.47  4.76
13 mail po 24 h      24  8.37  7.47  9.26
14 mail po 24 h      48 16.77 15.55 17.97
15 mail po 24 h     168 19.03 17.75 20.30
Call:
survdiff(formula = Surv(czas, powrot) ~ grupa, data = koszyki)

                      N Observed Expected (O-E)^2/E (O-E)^2/V
grupa=brak maila   3695      563      693     24.33    37.018
grupa=mail po 1 h  3687      761      646     20.49    30.118
grupa=mail po 24 h 3667      698      683      0.32     0.483

 Chisq= 45.1  on 2 degrees of freedom, p= 2e-10
         grupa czas
1   brak maila 11.9
2  mail po 1 h  4.5
3 mail po 24 h 24.6
                    grupa maks_pp w_godzinie po_168h
mail po 1 h   mail po 1 h    8.54       18.5     5.4
mail po 24 h mail po 24 h    5.24       37.0     3.8
4. Model Coxa, proporcjonalność i okresy: Rysunek 4
R
# Przepis 4. Model Coxa: iloraz hazardów, błędy odporne na klastrowanie i sprawdzenie
# proporcjonalności (Rysunek 4). Korzysta z obiektów przepisu 1: koszyki, kol, motyw. Nie losuje.
library(survival)

koszyki$log2_wartosc <- log2(koszyki$wartosc / 350)       # +1 = koszyk dwa razy droższy
# (a) Cox bez klastrów i z klastrami po kliencie (estymator „kanapkowy”)
cox_zwykly  <- coxph(Surv(czas, powrot) ~ grupa + nowy + log2_wartosc, data = koszyki)
cox_klaster <- coxph(Surv(czas, powrot) ~ grupa + nowy + log2_wartosc, data = koszyki, cluster = klient)
wynik_cox <- function(m, nazwa) {
  b <- coef(m); se <- sqrt(diag(vcov(m)))
  data.frame(model = nazwa, zmienna = names(b), HR = exp(b), dolna = exp(b - 1.96 * se), gorna = exp(b + 1.96 * se),
             p = 2 * pnorm(-abs(b / se)), row.names = NULL)
}
cox_tab <- rbind(wynik_cox(cox_zwykly, "zwykłe SE"), wynik_cox(cox_klaster, "SE odporne na klastry"))
print(cox_tab, digits = 3)
# (b) Proporcjonalność hazardów: test reszt Schoenfelda
cox.zph(cox_klaster)

# (c) Lepszy opis: osobny HR przed 24. godziną i po niej (podział czasu obserwacji każdego koszyka)
okresy <- survSplit(Surv(czas, powrot) ~ ., data = koszyki, cut = 24, episode = "okres")
okresy$m1_0_24    <- as.integer(okresy$grupa == "mail po 1 h"  & okresy$okres == 1)
okresy$m1_24_168  <- as.integer(okresy$grupa == "mail po 1 h"  & okresy$okres == 2)
okresy$m24_0_24   <- as.integer(okresy$grupa == "mail po 24 h" & okresy$okres == 1)
okresy$m24_24_168 <- as.integer(okresy$grupa == "mail po 24 h" & okresy$okres == 2)
cox_okresy <- coxph(Surv(tstart, czas, powrot) ~ m1_0_24 + m1_24_168 + m24_0_24 + m24_24_168 + nowy + log2_wartosc,
                    data = okresy, cluster = klient)
okr <- wynik_cox(cox_okresy, "podział na okresy")[1:4, ]
okr$grupa <- rep(c("mail po 1 h", "mail po 24 h"), each = 2)
okr$okres <- rep(c("0–24 h", "24–168 h"), 2)
print(okr[, c("grupa", "okres", "HR", "dolna", "gorna", "p")], digits = 3)
cox.zph(cox_okresy)$table[1:4, ]

# Rysunek 4: HR z jednego modelu (cały tydzień) vs HR w dwóch okresach; skala logarytmiczna
rys4 <- rbind(data.frame(grupa = c("mail po 1 h", "mail po 24 h"), okres = "cały tydzień (jeden HR)",
                         cox_tab[cox_tab$model == "SE odporne na klastry", c("HR", "dolna", "gorna")][1:2, ]),
              okr[, c("grupa", "okres", "HR", "dolna", "gorna")])
rys4$okres <- factor(rys4$okres, levels = c("cały tydzień (jeden HR)", "0–24 h", "24–168 h"))
p4 <- ggplot(rys4, aes(x = HR, y = okres, colour = grupa, shape = grupa)) +
  geom_vline(xintercept = 1, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.25, linewidth = 0.9, orientation = "y",
                position = position_dodge(width = 0.55)) +
  geom_point(size = 3.4, position = position_dodge(width = 0.55)) +
  geom_text(aes(label = sprintf("%.2f", HR)), vjust = -1.0, size = 3.4, show.legend = FALSE,
            position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = kol_grupy[-1], name = NULL) + scale_shape_manual(values = c(17, 15), name = NULL) +
  scale_x_log10(breaks = c(0.25, 0.5, 1, 1.5, 2, 3)) +
  scale_y_discrete(limits = rev(levels(rys4$okres))) +
  labs(x = "Iloraz hazardów powrotu wobec braku maila (skala log), 95% CI odporny na klastry", y = NULL,
       title = "Jeden HR na cały tydzień uśrednia dwa różne okresy") + motyw
p4   # zapis: ggsave("porzucone-koszyki-cox-okresy.svg", p4, width = 10, height = 5)
Wynik w R
                  model           zmienna    HR dolna gorna        p
1             zwykłe SE  grupamail po 1 h 1.445 1.296 1.612 3.44e-11
2             zwykłe SE grupamail po 24 h 1.258 1.126 1.406 4.94e-05
3             zwykłe SE              nowy 0.760 0.694 0.832 3.06e-09
4             zwykłe SE      log2_wartosc 0.856 0.828 0.886 1.62e-19
5 SE odporne na klastry  grupamail po 1 h 1.445 1.295 1.614 5.29e-11
6 SE odporne na klastry grupamail po 24 h 1.258 1.127 1.405 4.27e-05
7 SE odporne na klastry              nowy 0.760 0.674 0.857 7.25e-06
8 SE odporne na klastry      log2_wartosc 0.856 0.829 0.885 3.78e-20
               chisq df      p
grupa        251.574  2 <2e-16
nowy           4.558  1  0.033
log2_wartosc   0.481  1  0.488
GLOBAL       255.634  4 <2e-16
         grupa    okres    HR dolna gorna        p
1  mail po 1 h   0–24 h 1.920 1.690 2.182 1.38e-23
2  mail po 1 h 24–168 h 0.533 0.418 0.679 3.72e-07
3 mail po 24 h   0–24 h 0.835 0.717 0.972 2.03e-02
4 mail po 24 h 24–168 h 2.092 1.768 2.476 8.07e-18
               chisq df            p
m1_0_24     33.28394  1 7.963761e-09
m1_24_168   30.21052  1 3.876023e-08
m24_0_24    16.75193  1 4.259900e-05
m24_24_168 158.72950  1 2.144091e-36
5. Przyrost, prawda z symulacji i raport systemu mailingowego: Rysunek 5
R
# Przepis 5. Część koszyków wróciłaby i tak: przyrost z eksperymentu vs „odzyskane” według
# systemu mailingowego (Rysunek 5). Korzysta z obiektów przepisu 1: koszyki, kol, motyw. Nie losuje.
grupy <- split(koszyki, koszyki$grupa)
kontrola <- 100 * mean(grupy[["brak maila"]]$powrot)
przyrost_tab <- do.call(rbind, lapply(c("mail po 1 h", "mail po 24 h"), function(g) {
  d <- grupy[[g]]
  data.frame(grupa = g, wrocilo = 100 * mean(d$powrot), kontrola = kontrola,
             przyrost_pp = 100 * mean(d$powrot) - kontrola,
             wyslano_proc = 100 * mean(d$mail),
             przyrost_na_mail_pp = (100 * mean(d$powrot) - kontrola) / mean(d$mail),   # efekt u tych, którzy dostali mail
             system_mailingowy = 100 * mean(d$klik_z_maila),                          # zakup po kliknięciu w link
             prawda_i_tak = 100 * mean(d$powrot & d$wrocilby_i_tak),                  # znane tylko w symulacji
             prawda_dzieki_mailowi = 100 * mean(d$powrot & !d$wrocilby_i_tak))
}))
przyrost_tab$maili_na_1_dodatkowy <- 100 / przyrost_tab$przyrost_na_mail_pp
przyrost_tab$zawyzenie_systemu <- przyrost_tab$system_mailingowy / przyrost_tab$przyrost_pp
print(przyrost_tab, digits = 3)
# Wśród zakupów po kliknięciu w link z maila: jaka część wróciłaby i tak (prawda z symulacji)?
klik <- koszyki[koszyki$klik_z_maila == 1, ]
round(100 * tapply(klik$wrocilby_i_tak, droplevels(klik$grupa), mean), 1)

# Rysunek 5: trzy słupki na grupę z mailem
rys5 <- do.call(rbind, lapply(seq_len(nrow(przyrost_tab)), function(i) with(przyrost_tab[i, ], data.frame(
  grupa = grupa,
  slupek = factor(c("Eksperyment:\nkontrola + przyrost", "Eksperyment:\nkontrola + przyrost",
                    "Prawda z symulacji", "Prawda z symulacji", "System mailingowy:\nzakup po kliknięciu"),
                  levels = c("System mailingowy:\nzakup po kliknięciu", "Prawda z symulacji", "Eksperyment:\nkontrola + przyrost")),
  czesc = factor(c("wróciłby i tak", "dodatkowo dzięki mailowi", "wróciłby i tak", "dodatkowo dzięki mailowi",
                   "przypisane mailowi"),
                 levels = c("przypisane mailowi", "dodatkowo dzięki mailowi", "wróciłby i tak")),
  proc = c(kontrola, przyrost_pp, prawda_i_tak, prawda_dzieki_mailowi, system_mailingowy)))))
p5 <- ggplot(rys5, aes(x = proc, y = slupek, fill = czesc)) +
  geom_col(width = 0.62, colour = "white", linewidth = 0.4) +
  geom_text(aes(label = sprintf("%.1f", proc), colour = czesc == "przypisane mailowi"),
            position = position_stack(vjust = 0.5), size = 3.5, fontface = "bold", show.legend = FALSE) +
  scale_colour_manual(values = c("FALSE" = "grey10", "TRUE" = "white"), guide = "none") +
  facet_wrap(~ grupa, ncol = 1) +
  scale_fill_manual(values = c("wróciłby i tak" = kol[["jasny"]], "dodatkowo dzięki mailowi" = kol[["pomarancz"]],
                               "przypisane mailowi" = kol[["fiolet"]]), name = NULL,
                    breaks = c("wróciłby i tak", "dodatkowo dzięki mailowi", "przypisane mailowi")) +
  scale_x_continuous(limits = c(0, 22), breaks = seq(0, 20, 5)) +
  labs(x = "Koszyki kupione w ciągu 7 dni (% wszystkich koszyków w grupie)", y = NULL,
       title = "Mail dostaje w raporcie więcej zakupów, niż naprawdę dodał") + motyw
p5   # zapis: ggsave("porzucone-koszyki-przyrost-i-tak.svg", p5, width = 10, height = 6)
Wynik w R
         grupa wrocilo kontrola przyrost_pp wyslano_proc przyrost_na_mail_pp
1  mail po 1 h    20.6     15.2         5.4         98.6                5.48
2 mail po 24 h    19.0     15.2         3.8         91.6                4.14
  system_mailingowy prawda_i_tak prawda_dzieki_mailowi maili_na_1_dodatkowy
1             12.94         15.0                  5.64                 18.3
2              7.94         13.9                  5.10                 24.1
  zawyzenie_systemu
1              2.39
2              2.09
 mail po 1 h mail po 24 h
        64.6         47.1
6. Grafika: lejek i trzy ścieżki (Rysunek 1)
R
# Przepis 6. Grafika: lejek z porzuceniem koszyka i trzy ścieżki eksperymentu (Rysunek 1)
# Korzysta z obiektów przepisu 1: koszyki, kol, kol_grupy. Nie losuje. Liczby z danych.
od <- aggregate(cbind(n = 1, mail, powrot) ~ grupa, data = koszyki, FUN = sum)
od$proc <- 100 * od$powrot / od$n
lejek <- data.frame(x = 1:3, etykieta = c("Strona produktu", "Dodanie do koszyka", "Porzucony koszyk\n(brak zamówienia\nw 30 min)"),
                    szer = c(2.0, 1.75, 1.5))
sciezki <- data.frame(y = c(3, 2, 1), grupa = od$grupa,
                      opis = c("brak maila\n(grupa kontrolna)", "mail po 1 h", "mail po 24 h"),
                      wynik = sprintf("%d koszyków · %d maili\nzakup w 7 dni: %.1f%%", od$n, od$mail, od$proc))
p6 <- ggplot() +
  # lejek (od góry): trzy coraz węższe prostokąty
  geom_rect(data = lejek, aes(xmin = 1.6 - szer / 2, xmax = 1.6 + szer / 2, ymin = 4.4 - x * 1.05, ymax = 4.4 - x * 1.05 + 0.85),
            fill = c("grey85", "grey75", kol[["pomarancz"]]), colour = "grey30") +
  geom_text(data = lejek, aes(x = 1.6, y = 4.4 - x * 1.05 + 0.425, label = etykieta), size = 3.6, lineheight = 0.9) +
  # losowanie
  annotate("rect", xmin = 2.75, xmax = 3.85, ymin = 1.55, ymax = 2.45, fill = "white", colour = "grey20", linetype = "dashed") +
  annotate("text", x = 3.3, y = 2, label = sprintf("Losowanie\nkoszyka\n(%d koszyków\n%d klientów)", nrow(koszyki),
                                                   length(unique(koszyki$klient))), size = 3.3, lineheight = 0.9) +
  annotate("segment", x = 2.35, xend = 2.75, y = 1.775, yend = 2, arrow = arrow(length = unit(2, "mm")), colour = "grey30") +
  geom_segment(data = sciezki, aes(x = 3.85, xend = 4.35, y = 2, yend = y), arrow = arrow(length = unit(2, "mm")), colour = "grey30") +
  geom_rect(data = sciezki, aes(xmin = 4.35, xmax = 5.55, ymin = y - 0.38, ymax = y + 0.38, fill = grupa), colour = NA) +
  geom_text(data = sciezki, aes(x = 4.95, y = y, label = opis), colour = "white", fontface = "bold", size = 3.5, lineheight = 0.9) +
  geom_rect(data = sciezki, aes(xmin = 5.65, xmax = 7.6, ymin = y - 0.38, ymax = y + 0.38), fill = "white", colour = "grey40") +
  geom_text(data = sciezki, aes(x = 6.625, y = y, label = wynik), size = 3.3, lineheight = 0.95) +
  annotate("text", x = 6.625, y = 3.65, label = "Wynik: zakup z koszyka w ciągu 7 dni\ni czas do powrotu (godziny)",
           size = 3.4, fontface = "bold", colour = "#0f1d3a", lineheight = 0.9) +
  annotate("text", x = 4.95, y = 0.3, size = 3.1, colour = "grey30", lineheight = 0.9,
           label = "Mail wychodzi tylko do koszyków,\nktóre do tej pory nie wróciły") +
  scale_fill_manual(values = kol_grupy, guide = "none") +
  coord_cartesian(xlim = c(0.6, 7.7), ylim = c(0.05, 4.3)) +
  labs(title = "Porzucony koszyk i trzy ścieżki eksperymentu") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 10, 10, 10))
p6   # zapis: ggsave("porzucone-koszyki-schemat-lejka.svg", p6, width = 10, height = 5.6)
7. Rabat w mailu: próg opłacalności i liczebność
R
# Przepis 7. Kolejny eksperyment: mail po 1 h bez rabatu vs z rabatem 5%. Liczebność i próg opłacalności.
# Nie losuje. Parametry ustalone ręcznie: marża 30%, rabat 5% wartości koszyka.
p_bez <- 0.2064                    # odsetek zakupów w 7 dni po mailu po 1 h (przepis 2)
marza <- 0.30; rabat <- 0.05
# Rabat obniża marżę na KAŻDYM zakupie z tego maila, także tych, które i tak by się zdarzyły.
# Opłaca się, gdy marża z dodatkowych zakupów pokryje rabat: marza * d >= rabat * (p_bez + d)
d_min <- rabat * p_bez / (marza - rabat)
round(c(prog_oplacalnosci_pp = 100 * d_min), 2)
# Ile koszyków na grupę, by wykryć przyrost równy progowi (moc 80%, alfa .05, test dwustronny)?
n_grupa <- power.prop.test(p1 = p_bez, p2 = p_bez + d_min, power = 0.80, sig.level = 0.05)$n
ceiling(n_grupa)
Wynik w R
prog_oplacalnosci_pp
                4.13
[1] 1616
8. Czy paleta przetrwa zaburzenia widzenia barw?
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("szary – cynober (brak maila / po 1 h)" = c("#737373", "#D55E00"),
             "szary – niebieski (brak maila / po 24 h)" = c("#737373", "#0072B2"),
             "cynober – niebieski (po 1 h / po 24 h)" = c("#D55E00", "#0072B2"),
             "jasnoszary – pomarańczowy (i tak / dzięki mailowi)" = c("#CCCCCC", "#E69F00"),
             "pomarańczowy – fiolet (dzięki mailowi / przypisane)" = c("#E69F00", "#7A3E8E"),
             "jasnoszary – fiolet (i tak / przypisane)" = c("#CCCCCC", "#7A3E8E"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                    widzenie_typowe
szary – cynober (brak maila / po 1 h)                          76.9
szary – niebieski (brak maila / po 24 h)                       41.5
cynober – niebieski (po 1 h / po 24 h)                        114.6
jasnoszary – pomarańczowy (i tak / dzięki mailowi)             77.3
pomarańczowy – fiolet (dzięki mailowi / przypisane)           115.8
jasnoszary – fiolet (i tak / przypisane)                       68.8
czerwony – zielony (do unikania)                              121.7
                                                    deuteranopia protanopia
szary – cynober (brak maila / po 1 h)                       63.4       53.8
szary – niebieski (brak maila / po 24 h)                    45.1       38.2
cynober – niebieski (po 1 h / po 24 h)                     108.3       91.9
jasnoszary – pomarańczowy (i tak / dzięki mailowi)          73.8       71.6
pomarańczowy – fiolet (dzięki mailowi / przypisane)        110.6      113.2
jasnoszary – fiolet (i tak / przypisane)                    54.3       60.8
czerwony – zielony (do unikania)                            21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, przedziały Wilsona, test χ², model liniowy i power.prop.test() – pakiety base i stats; Kaplan–Meier, log-rank i model Coxa – pakiet survival; błędy odporne na klastrowanie – pakiet sandwich). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- „Odzyskane koszyki” z systemu mailingowego jako efekt maila. W przykładzie zawyżają efekt 2.1–2.4 raza.
- Porównanie tylko koszyków, do których mail wyszedł.
- Odczyt w szczycie krzywej zamiast w ustalonym horyzoncie.
- Jeden HR przy nieproporcjonalnych hazardach i HR z późnego okresu czytany jako „mail szkodzi”.
- Kilka koszyków jednego klienta jak niezależne obserwacje. Przy cechach klienta i odsetkach w grupach przedziały są za wąskie.
- Losowanie koszyków, gdy mail wpływa na inne koszyki klienta – wtedy losuj klientów.
Najczęstsze pytania
Jak sprawdzić, czy mail o porzuconym koszyku działa?
Losowo zostaw część porzuconych koszyków bez maila i porównaj odsetek zakupów w ustalonym horyzoncie, np. 7 dni. Różnica to przyrost dzięki mailowi. W przykładzie bez maila kupiono 15.24% koszyków, a po mailu po 1 h 20.64%, czyli +5.40 pp (95% CI [3.65, 7.15]). Porównuj całe grupy z losowania, także koszyki, do których mail nie wyszedł.
Mail o porzuconym koszyku po godzinie czy po dobie?
W przykładzie mail po 1 h dał +5.40 pp, a po 24 h +3.80 pp, ale różnica między nimi (1.61 pp, 95% CI [−0.26, 3.47], p = .091) nie była rozstrzygnięta. Wczesny mail mocniej przyspiesza zakupy, które i tak by się zdarzyły. Jeśli koszt jest ten sam, wybierz wcześniejszy i potwierdź to testem z dwiema grupami mailowymi.
Dlaczego raport systemu mailingowego zawyża odzyskane koszyki?
Liczy zakupy po kliknięciu w link z maila, a klika też ktoś, kto i tak by wrócił. W symulowanym przykładzie raport przypisał mailowi 12.94% koszyków przy przyroście 5.40 pp – 2.39 raza za dużo; 64.6% zakupów po kliknięciu nastąpiłoby bez maila. Efekt mierz grupą kontrolną (Kohavi i in., 2020).
Czy w analizie porzuconych koszyków użyć modelu Coxa?
Model Coxa (Cox, 1972) dobrze opisuje, jak mail zmienia tempo powrotów, ale sprawdź proporcjonalność hazardów resztami Schoenfelda. Mail działa w krótkim oknie po wysyłce, więc hazardy zwykle nie są proporcjonalne: w przykładzie HR maila po 1 h wynosił 1.92 w pierwszej dobie i 0.53 później. Wtedy podaj HR w okresach, a decyzję oprzyj na odsetku po 7 dniach.
Co zrobić, gdy ten sam klient porzuca kilka koszyków?
Licz błędy standardowe odporne na klastrowanie po kliencie – w regresji (sandwich::vcovCL()) i w modelu Coxa (cluster = klient; Lin i Wei, 1989). W przykładzie błąd odsetka w grupie rósł o 10–17%, a błąd różnicy między grupami prawie wcale, bo losowano koszyki. Jeśli mail może wpłynąć na inne koszyki klienta, losuj klientów.
Powiązane hasła
Przeczytaj też
Lejek konwersji – etapy i test A/B
Sklep zoologiczny i nowy koszyk: odsetki od początku i warunkowe, przedziały Wilsona i Newcombe’a, liczebność i symulacja 1000 testów z kodem R.
Czytaj →PoradnikKaplan–Meier i model Coxa krok po kroku
Krzywe Kaplana–Meiera, log-rank, RMST, model Coxa, proporcjonalność hazardów i ryzyka konkurujące w R – z tabelą APA i opisem do artykułu.
Czytaj →PoradnikEksperyment czynnikowy w mailingu
Marketplace z rękodziełem: temat, godzina i personalizacja w kostce 2³, interakcje w punktach procentowych, plan frakcyjny i trzy testy A/B – pięć rysunków z kodem R.
Czytaj →PoradnikPróg darmowej dostawy – metoda bunching
Skupienie koszyków nad progiem, rozkład kontrfaktyczny, bootstrap i rachunek progu – na fikcyjnym sklepie z herbatami, z kodem R.
Czytaj →Analizujesz eksperyment mailowy albo czas do zakupu w pracy?
Pomożemy zaplanować losowanie i horyzont, policzyć odsetki z przedziałami, krzywe Kaplana–Meiera i model Coxa z błędami klastrowanymi oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Hess, K. R. (1995). Graphical methods for assessing violations of the proportional hazards assumption in Cox regression. Statistics in Medicine, 14(15), 1707–1723. https://doi.org/10.1002/sim.4780141510
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Lin, D. Y., & Wei, L. J. (1989). The robust inference for the Cox proportional hazards model. Journal of the American Statistical Association, 84(408), 1074–1078. https://doi.org/10.1080/01621459.1989.10478874
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{hess1995graphical, author={Hess, Kenneth R.}, title={{Graphical methods for assessing violations of the proportional hazards assumption in Cox regression}}, journal={Statistics in Medicine}, year={1995}, volume={14}, number={15}, pages={1707--1723}, doi={10.1002/sim.4780141510}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{lin1989robust, author={Lin, D. Y. and Wei, L. J.}, title={{The robust inference for the Cox proportional hazards model}}, journal={Journal of the American Statistical Association}, year={1989}, volume={84}, number={408}, pages={1074--1078}, doi={10.1080/01621459.1989.10478874}}