Przykład: sklep zoologiczny i nowa strona koszyka
Fikcyjny sklep internetowy sprzedaje karmę i akcesoria dla psów, kotów, ryb, gryzoni i ptaków. Droga klienta do zakupu ma pięć etapów: wejście na stronę produktu → koszyk (dodanie produktu) → dostawa (formularz adresu i sposobu dostawy) → płatność → zakup. To jest lejek konwersji (ang. conversion funnel): na każdym etapie część osób odpada.
Sklep przygotował nową stronę koszyka (wersja B) z paskiem „brakuje X zł do darmowej dostawy” i wyraźniejszym przyciskiem „Przejdź do dostawy”. Przeprowadził test A/B: 16 000 nowych użytkowników losowo trafiło do obecnej wersji A (7965 osób) albo do B (8035). Pytania działu marketingu: na którym etapie odpada najwięcej osób i czy nowy koszyk coś poprawił? Plan i liczebność typowego testu opisuje wpis test A/B – plan i analiza, a inne projekty do pracy z marketingu – statystyka w pracy z marketingu.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Każdy użytkownik ma ukryty zamiar zakupu: wysoki (35%) albo niski (65%). Osoby o wysokim zamiarze częściej przechodzą każdy etap (np. koszyk: .30 wobec .10; płatność po dostawie: .85 wobec .45). Wersja B zmienia tylko przejście koszyk → dostawa: z .75 na .80 przy wysokim zamiarze i z .30 na .50 przy niskim. Dalej osoba o danym zamiarze zachowuje się w obu wersjach tak samo. Prawdziwy odsetek zakupów wynosi więc 6.68% w A i 7.52% w B. Wszystkie parametry ustaliliśmy ręcznie przed pierwszym uruchomieniem i nie zmienialiśmy ich; ziarno 611 też ustalono raz. Dane pobierzesz jako lejek-konwersji-sklep-zoologiczny.csv (wiersz = użytkownik, kolumny 0/1 = etapy). Kolumny zamiar_ukryty w prawdziwych danych nie ma.
Rysunek 1: lejek jako schemat – dwa różne odsetki
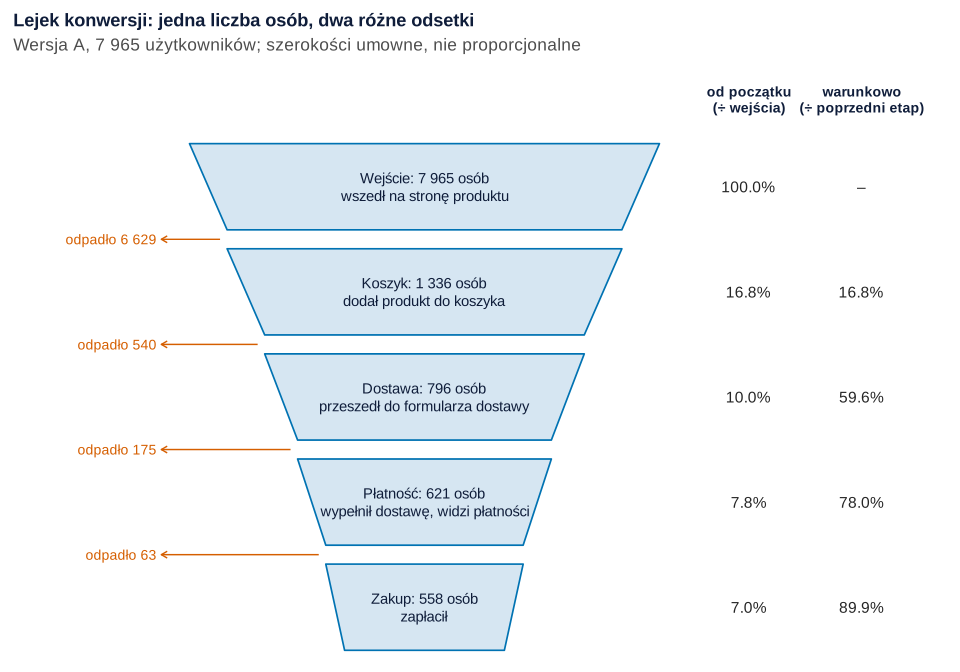
set.seed(611)).Co widać. Z 7965 osób w wersji A 1336 dodało produkt do koszyka, 796 przeszło do dostawy, 621 do płatności, a 558 zapłaciło. Każdy etap można opisać dwoma odsetkami:
- od początku – liczba osób na etapie ÷ wszyscy, którzy weszli (zakup: 558 / 7965 = 7.0%);
- warunkowo (z etapu na etap) – liczba osób na etapie ÷ osoby z poprzedniego etapu (zakup: 558 / 621 = 89.9%).
Odsetek od początku to iloczyn odsetków warunkowych:
Najwięcej osób odpada przed koszykiem (6629), ale z tych, którzy już dodali produkt, najwięcej traci etap dostawy: odpadło 540 z 1336, czyli 40.4%.
Jak może zmylić. Szerokości trapezów są umowne. Lejek narysowany proporcjonalnie zamieniłby ostatnie etapy w kreski. Wysoki odsetek warunkowy (89.9% przy płatności) nie znaczy, że „prawie wszyscy kupują” – kupuje 7.0% wchodzących.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: odsetki etapów z przedziałami Wilsona
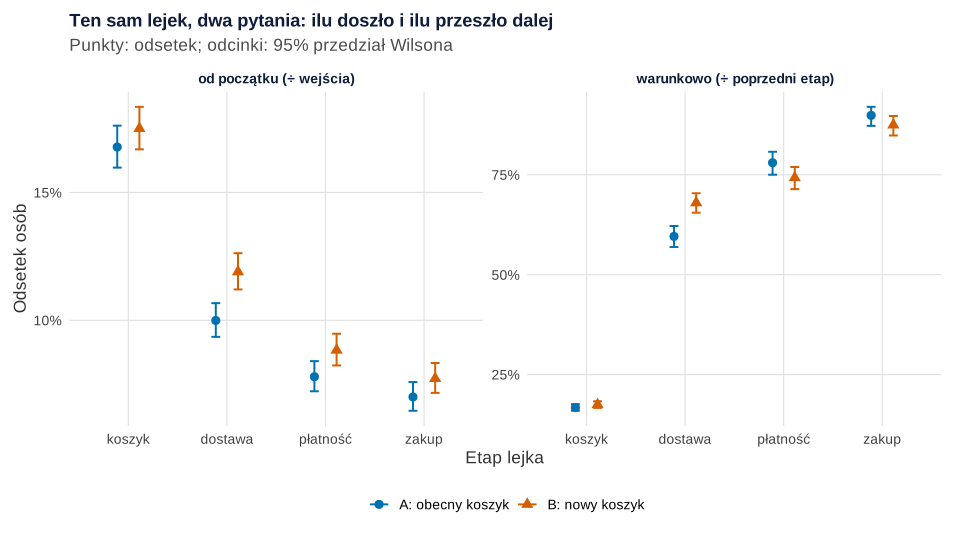
Przy odsetkach używamy przedziału ufności dla proporcji Wilsona. Podręcznikowy przedział Walda ma chaotyczne pokrycie, a Brown i in. (2001) zalecają przy małych próbach właśnie przedział Wilsona. W R daje go prop.test(x, n, correct = FALSE).
Co widać. Od początku wersja B jest nieco wyżej na każdym etapie: zakup 7.7%, 95% CI [7.2, 8.3], wobec 7.0% [6.5, 7.6]. Warunkowo obraz się zmienia. Przejście do dostawy w B jest wyraźnie częstsze (68.0% [65.5, 70.4] wobec 59.6% [56.9, 62.2]), ale przejście do płatności – rzadsze (74.3% [71.4, 76.9] wobec 78.0% [75.0, 80.8]).
Jak może zmylić. Lewy panel ma skalę do 18%, prawy – do 90%, więc odcinki tej samej długości nie oznaczają tej samej niepewności. Przedziały warunkowe są szersze, bo mianownik maleje: przy zakupie w A to 621 osób, a nie 7965. Nakładanie się przedziałów obu wersji nie jest testem różnicy – różnice liczymy osobno (rysunek 3).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: porównanie wersji na każdym etapie
Różnicę odsetków B − A liczymy z przedziałem Newcombe’a, zbudowanym z przedziałów Wilsona obu wersji. W porównaniu jedenastu metod proste przedziały miały słabe pokrycie, a ta metoda działała dobrze niezależnie od liczebności (Newcombe, 1998). Wartość p daje test dla dwóch proporcji.
Ważna decyzja zapadła przed testem: metryka główna to zakup od początku. Kohavi i in. (2020) zalecają zdefiniować kluczowe metryki i najlepiej jedno ogólne kryterium oceny eksperymentu. Pozostałe porównania to jedna rodzina 6 testów (koszyk „warunkowo” to ten sam odsetek co „od początku”, więc liczymy go raz) z poprawką Holma, która chroni przed błędem I rodzaju przy dowolnej kombinacji prawdziwych hipotez (Holm, 1979). Szerzej o wyborze poprawki: poprawki na wielokrotne porównania.
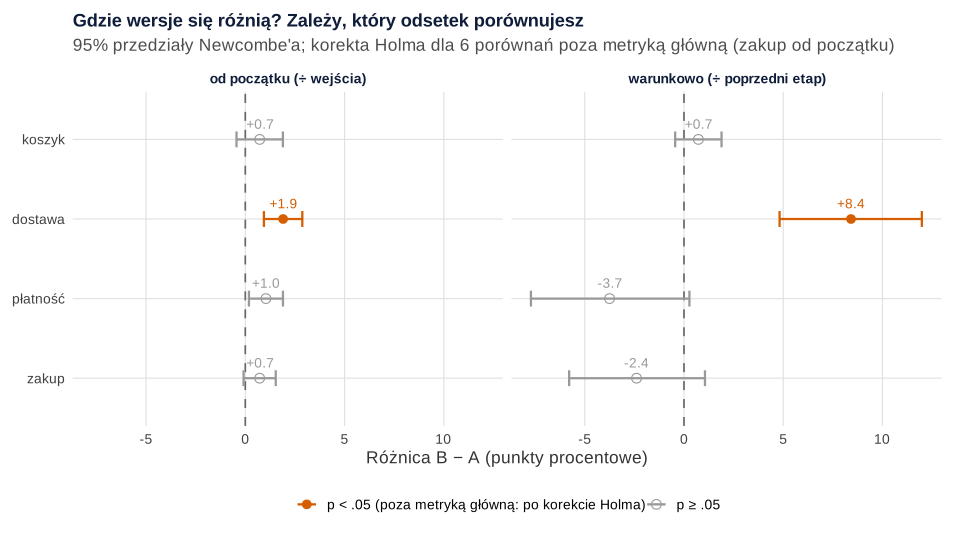
Co widać. Metryka główna: zakup od początku wzrósł o 0.7 punktu procentowego, 95% CI [−0.1, 1.5], p = .080 – przedział obejmuje zero. Po korekcie Holma pewna jest tylko poprawa na etapie dostawy: +1.9 pp od początku [0.9, 2.9] i +8.4 pp warunkowo [4.8, 12.0], oba p < .001. Odsetek warunkowy płatności spadł o 3.7 pp [−7.7, 0.3], p = .068 (po korekcie .203).
Jak może zmylić. Zostają dwie zagadki. Dlaczego wyraźna poprawa na dostawie nie daje pewnego wzrostu zakupów? I czy nowy koszyk „psuje” płatność? Odpowiedzi dają rysunki 4 i 5.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: małe liczby na końcu lejka
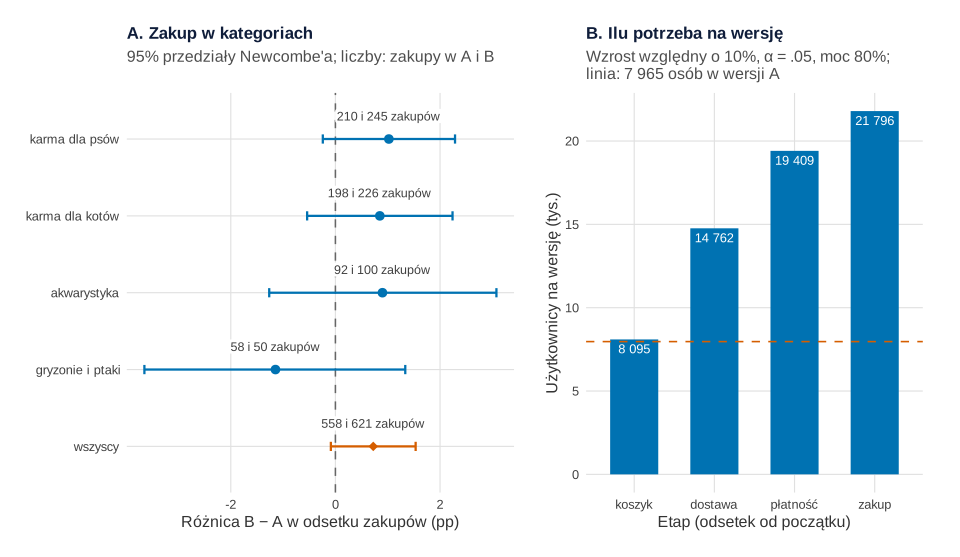
Co widać. Panel A: dział marketingu chciał wiedzieć, gdzie nowy koszyk działa najlepiej. W każdej kategorii przedział obejmuje zero (p po korekcie Holma od .449 do .724), a w kategorii „gryzonie i ptaki” różnica ma nawet przeciwny znak (−1.1 pp, 58 i 50 zakupów). Panel B wyjaśnia, dlaczego: im dalej w lejku, tym rzadsze zdarzenie i tym więcej osób trzeba. Aby wykryć względny wzrost o 10% przy α = .05 i mocy 80%, dla koszyka (16.8%) wystarczy 8095 osób na wersję, a dla zakupu (7.0%) potrzeba 21 796. Sklep miał 7965 osób w wersji A – test był za mały dla metryki głównej, choć prawdziwy wzrost (z 6.68% do 7.52%) wynosi aż 12.6% względnie.
Jak może zmylić. Różne znaki w kategoriach kuszą, by napisać „w kategorii gryzoni nowy koszyk szkodzi”. Ale różnica między wynikiem istotnym i nieistotnym sama nie musi być istotna – porównania trzeba testować bezpośrednio (Gelman i Stern, 2006). Test interakcji wersja × kategoria w regresji logistycznej dał χ²(3) = 2.37, p = .499. Więcej o tym: analiza podgrup.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: odsetek warunkowy porównuje różnych ludzi
Teraz druga zagadka. Wersja B w naszych danych niczego nie zmienia na stronie płatności. Skąd spadek odsetka „płatność ÷ dostawa”? Nowy koszyk przepchnął do dostawy więcej osób o niskim zamiarze zakupu, a one rzadziej płacą. Do etapu dostawy w A i B doszli więc inni ludzie. Randomizacja wyrównuje grupy tylko na starcie – po pierwszym etapie, na który wersja wpływa, porównanie warunkowe przestaje być porównaniem losowych grup. To odmiana błędu selekcji, a zmiana składu grupy przypomina paradoks Simpsona. Sprawdzamy to na 1000 symulowanych testach z tymi samymi parametrami (ziarno 6110) i na 1000 testach A/A, w których B niczym się nie różni.
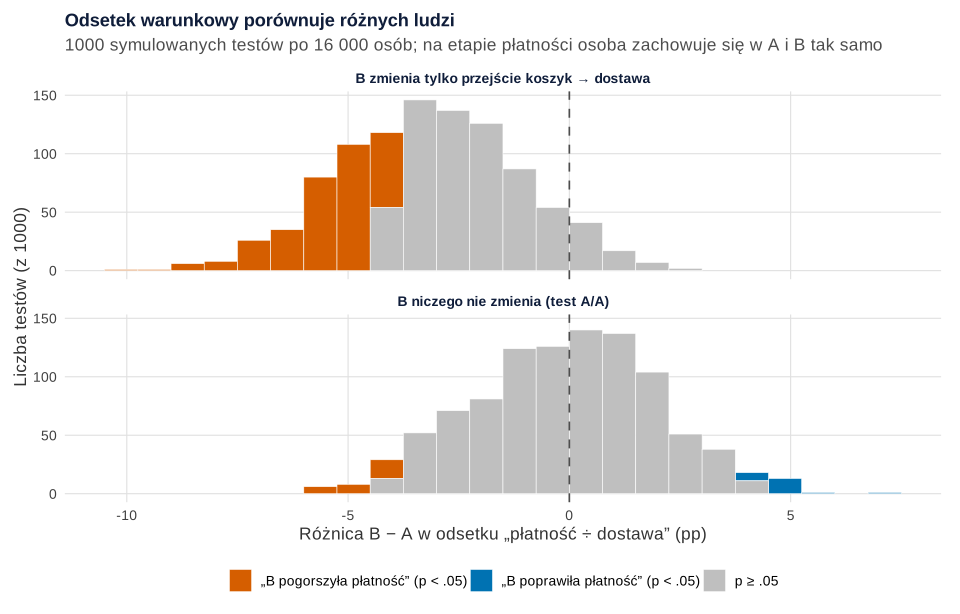
set.seed(6110)).Co widać. Gdy B zmienia tylko przejście do dostawy, różnica „płatność ÷ dostawa” wynosi średnio −3.17 pp, zgodnie z wartością populacyjną (77.1% w A, 73.8% w B). W 32.9% testów (błąd Monte Carlo 1.5 pp) wychodzi istotne „pogorszenie płatności”, choć żadna osoba nie płaci rzadziej przez wersję B. W testach A/A taki alarm pojawia się w 3.0% testów, a istotny wynik w dowolną stronę – w 5.2%, czyli tak, jak powinien. Zakup od początku był istotnie lepszy w B w 54.2% testów – to moc testu z 16 000 osób dla prawdziwego efektu.
Jak może zmylić. Test odsetka warunkowego nie jest błędny – odsetek w populacji naprawdę spada. Błędna jest interpretacja „B pogorszyła stronę płatności”. Odsetki warunkowe służą do diagnozy, gdzie ludzie odpadają; o skutku wersji rozstrzyga porównanie od początku.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Nowy koszyk: wynik jest obiecujący (+0.7 pp, 95% CI [−0.1, 1.5]), ale niepewny. Nie ogłaszaj sukcesu ani porażki – przedłuż test do liczebności policzonej dla zakupu albo powtórz go z planem na ok. 22 000 osób na wersję. Krótszy test przy tej samej mocy daje redukcja wariancji, np. CUPED.
- Etap dostawy: to tu odpada najwięcej osób z koszykiem. Kolejne testy kieruj na formularz dostawy (np. koszty widoczne wcześniej, mniej pól).
- „Spadek” na płatności: nie naprawiaj strony płatności na podstawie odsetka warunkowego – sprawdź najpierw, czy zmienił się skład osób, które do niej doszły.
- Kategorie: jedna kampania dla wszystkich. Różnice między kategoriami są zgodne z przypadkiem.
- Monitoring: lejek z odsetkami od początku sprawdzaj co tydzień – nie po to, by co dzień zatrzymywać test (zob. pułapki testów A/B). Lejek pokazuje etapy na stronie; to, który kanał reklamy przyprowadził klienta, to osobne pytanie (atrybucja kanałów).
Kontrolowane eksperymenty są najlepszym sposobem ustalania, czy zmiana wpływa na zachowanie użytkowników, ale wynik zależy od mocy i poprawnego losowania (Kohavi i in., 2009). Gdy metryką jest iloraz, np. średnia wartość koszyka, potrzebne są inne metody – zob. wskaźniki ilorazowe w testach A/B.
Jak opisać w pracy
W Metodzie podaj definicję każdego etapu (jakie zdarzenie i w jakim oknie czasu), jednostkę losowania (użytkownik), metrykę główną ustaloną przed testem, metodę przedziałów i poprawkę dla porównań dodatkowych. Te decyzje najlepiej zapisać wcześniej w planie analizy statystycznej.
W Wynikach daj tabelę: etap, liczba osób i oba odsetki w każdej wersji, różnica z CI i p. W Ograniczeniach napisz, że test miał za małą moc dla metryki głównej (rysunek 4B), i że odsetki warunkowe nie są porównaniem losowych grup. Pomoc przy takiej analizie: analizy statystyczne dla studentów.
Kod R: lejek, przedziały i symulacja w bazowym R
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Przedziały Wilsona i Newcombe’a, testy i poprawkę Holma liczy bazowy R (prop.test(), p.adjust(), glm(), power.prop.test()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (dane, set.seed(611)) i 6 (symulacja, set.seed(6110)); oba ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: 16 000 użytkowników, udział osób o wysokim zamiarze (.35), prawdopodobieństwa przejść między etapami dla obu typów osób, efekt wersji B tylko na przejściu koszyk → dostawa (.75 → .80 i .30 → .50), udziały kategorii (.40, .35, .15, .10), względny wzrost 10% w obliczeniu liczebności oraz 1000 powtórzeń w każdym scenariuszu symulacji. Parametrów nie zmieniano po obejrzeniu wyników.
1. Paleta, motyw i dane: tabela lejka
R
# Fikcyjny sklep internetowy z karmą i akcesoriami dla zwierząt: test A/B nowej strony koszyka (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(A = "#0072B2", B = "#D55E00", szary = "grey60", ciemny = "#0f1d3a")
ksztalt <- c(A = 16, B = 17)
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

etapy <- c("wejście", "koszyk", "dostawa", "płatność", "zakup")

# Parametry ustalone ręcznie. Każdy użytkownik ma ukryty zamiar zakupu (wysoki: 35%, niski: 65%).
# Wersja B (nowa strona koszyka z paskiem „brakuje X zł do darmowej dostawy”) zmienia TYLKO przejście
# koszyk → dostawa; na dalszych etapach osoba o danym zamiarze zachowuje się w obu wersjach tak samo.
p_wysoki <- 0.35
p_etap <- list(                                   # prawdopodobieństwo przejścia do etapu, gdy osoba doszła do poprzedniego
  koszyk   = c(wysoki = 0.30, niski = 0.10),
  dostawa  = list(A = c(wysoki = 0.75, niski = 0.30), B = c(wysoki = 0.80, niski = 0.50)),
  platnosc = c(wysoki = 0.85, niski = 0.45),
  zakup    = c(wysoki = 0.90, niski = 0.75))
kategorie <- c("karma dla psów", "karma dla kotów", "akwarystyka", "gryzonie i ptaki")

symuluj_lejek <- function(n, p_etap, p_wysoki) {   # jeden test A/B: n użytkowników losowo do A lub B
  wersja <- sample(c("A", "B"), n, replace = TRUE)
  zamiar <- ifelse(runif(n) < p_wysoki, "wysoki", "niski")
  koszyk <- rbinom(n, 1, p_etap$koszyk[zamiar])
  p_dost <- ifelse(wersja == "A", p_etap$dostawa$A[zamiar], p_etap$dostawa$B[zamiar])
  dostawa <- koszyk * rbinom(n, 1, p_dost)
  platnosc <- dostawa * rbinom(n, 1, p_etap$platnosc[zamiar])
  zakup <- platnosc * rbinom(n, 1, p_etap$zakup[zamiar])
  data.frame(wersja, zamiar_ukryty = zamiar, wejscie = 1L, koszyk, dostawa, platnosc, zakup)
}

set.seed(611)                                     # ziarno ustalone raz, bez dobierania pod wynik
d <- symuluj_lejek(16000, p_etap, p_wysoki)
d$kategoria <- sample(kategorie, nrow(d), replace = TRUE, prob = c(.40, .35, .15, .10))
d <- data.frame(uzytkownik = seq_len(nrow(d)), d[, c("wersja", "kategoria", "wejscie", "koszyk", "dostawa",
                                                     "platnosc", "zakup", "zamiar_ukryty")])
write.csv(d, "lejek-konwersji-sklep-zoologiczny.csv", row.names = FALSE)

# Tabela lejka: liczba osób na każdym etapie w każdej wersji
lejek <- aggregate(cbind(wejscie, koszyk, dostawa, platnosc, zakup) ~ wersja, data = d, FUN = sum)
lejek
Wynik w R
  wersja wejscie koszyk dostawa platnosc zakup
1      A    7965   1336     796      621   558
2      B    8035   1406     956      710   621
2. Dwa rodzaje odsetków i schemat lejka: Rysunek 1
R
# Rysunek 1. Lejek jako schemat: liczby osób, dwa rodzaje odsetków i odpływ między etapami (wersja A)
# Korzysta z obiektów przepisu 1: d, lejek, etapy, kol, motyw. Niczego nie losuje.
library(ggplot2)

kolumny <- c("wejscie", "koszyk", "dostawa", "platnosc", "zakup")
lej <- do.call(rbind, lapply(c("A", "B"), function(w) {
  n <- unlist(lejek[lejek$wersja == w, kolumny])
  data.frame(wersja = w, etap = factor(etapy, etapy), nr = 1:5, n = n,
             n_start = n[1], n_poprz = c(n[1], head(n, -1)))
}))
lej$od_poczatku <- lej$n / lej$n_start          # mianownik: wszyscy, którzy weszli do sklepu
lej$warunkowo <- lej$n / lej$n_poprz            # mianownik: ci, którzy doszli do poprzedniego etapu
lej$odpadlo <- lej$n_poprz - lej$n
print(transform(lej[, c("wersja", "etap", "n", "odpadlo")],
                od_poczatku = round(100 * lej$od_poczatku, 1), warunkowo = round(100 * lej$warunkowo, 1)),
      row.names = FALSE)

# Schemat: trapezy o umownych szerokościach (NIE proporcjonalnych do liczebności)
a <- subset(lej, wersja == "A")
opisy <- c("wszedł na stronę produktu", "dodał produkt do koszyka", "przeszedł do formularza dostawy",
           "wypełnił dostawę, widzi płatności", "zapłacił")
szer <- c(1.00, 0.84, 0.68, 0.54, 0.42)
dol <- c(szer[-1], 0.34)
y0 <- 5:1                                         # górna krawędź etapu i
trap <- do.call(rbind, lapply(1:5, function(i) data.frame(
  etap = a$etap[i], x = c(-szer[i], szer[i], dol[i], -dol[i]),
  y = c(y0[i], y0[i], y0[i] - 0.82, y0[i] - 0.82))))
a$y <- y0 - 0.41
a$tekst <- sprintf("%s: %s osób\n%s", c("Wejście", "Koszyk", "Dostawa", "Płatność", "Zakup"),
                   format(a$n, big.mark = " "), opisy)
a$lewa_kol <- sprintf("%.1f%%", 100 * a$od_poczatku)
a$prawa_kol <- ifelse(a$nr == 1, "–", sprintf("%.1f%%", 100 * a$warunkowo))
odp <- subset(a, nr > 1)
p1 <- ggplot() +
  geom_polygon(data = trap, aes(x, y, group = etap), fill = "#D6E6F2", colour = kol[["A"]], linewidth = 0.6) +
  geom_text(data = a, aes(0, y, label = tekst), size = 3.9, lineheight = 1.0, colour = kol[["ciemny"]]) +
  geom_text(data = a, aes(1.38, y, label = lewa_kol), size = 4.1, colour = "grey15") +
  geom_text(data = a, aes(1.86, y, label = prawa_kol), size = 4.1, colour = "grey15") +
  annotate("text", x = c(1.38, 1.86), y = 5.42, size = 3.7, fontface = "bold", colour = kol[["ciemny"]],
           label = c("od początku\n(÷ wejścia)", "warunkowo\n(÷ poprzedni etap)"), lineheight = 0.95) +
  geom_segment(data = odp, aes(x = -dol[nr - 1] - 0.03, xend = -1.12, y = y0[nr] + 0.09, yend = y0[nr] + 0.09),
               arrow = arrow(length = unit(0.18, "cm")), colour = kol[["B"]], linewidth = 0.5) +
  geom_text(data = odp, aes(-1.14, y0[nr] + 0.09, label = sprintf("odpadło %s", format(odpadlo, big.mark = " "))),
            hjust = 1, size = 3.7, colour = kol[["B"]]) +
  coord_cartesian(xlim = c(-1.75, 2.2), ylim = c(0.1, 5.75), expand = FALSE) +
  labs(title = "Lejek konwersji: jedna liczba osób, dwa różne odsetki",
       subtitle = sprintf("Wersja A, %s użytkowników; szerokości umowne, nie proporcjonalne",
                          format(a$n[1], big.mark = " "))) +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("lejek-konwersji-schemat.svg", p1, width = 10, height = 7)
Wynik w R
 wersja     etap    n odpadlo od_poczatku warunkowo
      A  wejście 7965       0       100.0     100.0
      A   koszyk 1336    6629        16.8      16.8
      A  dostawa  796     540        10.0      59.6
      A płatność  621     175         7.8      78.0
      A    zakup  558      63         7.0      89.9
      B  wejście 8035       0       100.0     100.0
      B   koszyk 1406    6629        17.5      17.5
      B  dostawa  956     450        11.9      68.0
      B płatność  710     246         8.8      74.3
      B    zakup  621      89         7.7      87.5
3. Przedziały Wilsona: Rysunek 2
R
# Rysunek 2. Odsetki etapów w obu wersjach z 95% przedziałami Wilsona: od początku i warunkowo
# Korzysta z obiektów przepisów 1–2: lej, etapy, kol, ksztalt, motyw. Niczego nie losuje.
library(ggplot2)

wilson <- function(x, n, z = qnorm(0.975)) {    # przedział Wilsona (to samo daje prop.test(x, n, correct = FALSE))
  p <- x / n
  srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  cbind(dolna = srodek - pol, gorna = srodek + pol)
}
dl <- subset(lej, nr > 1)
od <- data.frame(dl[, c("wersja", "etap", "n")], miara = "od początku (÷ wejścia)",
                 mianownik = dl$n_start, odsetek = dl$od_poczatku, wilson(dl$n, dl$n_start))
wa <- data.frame(dl[, c("wersja", "etap", "n")], miara = "warunkowo (÷ poprzedni etap)",
                 mianownik = dl$n_poprz, odsetek = dl$warunkowo, wilson(dl$n, dl$n_poprz))
ods <- rbind(od, wa)
ods$miara <- factor(ods$miara, c("od początku (÷ wejścia)", "warunkowo (÷ poprzedni etap)"))
print(transform(ods[, c("miara", "etap", "wersja", "n", "mianownik")], odsetek = round(100 * ods$odsetek, 1),
                dolna = round(100 * ods$dolna, 1), gorna = round(100 * ods$gorna, 1)), row.names = FALSE)

p2 <- ggplot(ods, aes(etap, odsetek, colour = wersja, shape = wersja)) +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.18, linewidth = 0.7, position = position_dodge(0.45)) +
  geom_point(size = 2.8, position = position_dodge(0.45)) +
  facet_wrap(~ miara, scales = "free_y") +
  scale_colour_manual(values = kol[c("A", "B")], labels = c("A: obecny koszyk", "B: nowy koszyk"), name = NULL) +
  scale_shape_manual(values = ksztalt, labels = c("A: obecny koszyk", "B: nowy koszyk"), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%")) +
  labs(x = "Etap lejka", y = "Odsetek osób",
       title = "Ten sam lejek, dwa pytania: ilu doszło i ilu przeszło dalej",
       subtitle = "Punkty: odsetek; odcinki: 95% przedział Wilsona") + motyw
p2   # zapis: ggsave("lejek-konwersji-odsetki-etapow.svg", p2, width = 10, height = 5.6)
Wynik w R
                        miara     etap wersja    n mianownik odsetek dolna
      od początku (÷ wejścia)   koszyk      A 1336      7965    16.8  16.0
      od początku (÷ wejścia)  dostawa      A  796      7965    10.0   9.4
      od początku (÷ wejścia) płatność      A  621      7965     7.8   7.2
      od początku (÷ wejścia)    zakup      A  558      7965     7.0   6.5
      od początku (÷ wejścia)   koszyk      B 1406      8035    17.5  16.7
      od początku (÷ wejścia)  dostawa      B  956      8035    11.9  11.2
      od początku (÷ wejścia) płatność      B  710      8035     8.8   8.2
      od początku (÷ wejścia)    zakup      B  621      8035     7.7   7.2
 warunkowo (÷ poprzedni etap)   koszyk      A 1336      7965    16.8  16.0
 warunkowo (÷ poprzedni etap)  dostawa      A  796      1336    59.6  56.9
 warunkowo (÷ poprzedni etap) płatność      A  621       796    78.0  75.0
 warunkowo (÷ poprzedni etap)    zakup      A  558       621    89.9  87.2
 warunkowo (÷ poprzedni etap)   koszyk      B 1406      8035    17.5  16.7
 warunkowo (÷ poprzedni etap)  dostawa      B  956      1406    68.0  65.5
 warunkowo (÷ poprzedni etap) płatność      B  710       956    74.3  71.4
 warunkowo (÷ poprzedni etap)    zakup      B  621       710    87.5  84.8
 gorna
  17.6
  10.7
   8.4
   7.6
  18.3
  12.6
   9.5
   8.3
  17.6
  62.2
  80.8
  92.0
  18.3
  70.4
  76.9
  89.7
4. Różnice B − A, test dla dwóch proporcji i poprawka Holma: Rysunek 3
R
# Rysunek 3. Różnica B − A na każdym etapie: przedział Newcombe'a, test dla dwóch proporcji i poprawka Holma
# Korzysta z obiektów przepisów 1–3: ods, wilson, kol, motyw. Niczego nie losuje.
library(ggplot2)

newcombe <- function(x1, n1, x2, n2) {          # różnica p1 − p2 z 95% przedziałem Newcombe'a (z przedziałów Wilsona)
  p1 <- x1 / n1; p2 <- x2 / n2; w1 <- wilson(x1, n1); w2 <- wilson(x2, n2)
  r <- p1 - p2
  cbind(roznica = r, dolna = r - sqrt((p1 - w1[, 1])^2 + (w2[, 2] - p2)^2),
        gorna = r + sqrt((w1[, 2] - p1)^2 + (p2 - w2[, 1])^2))
}
A <- subset(ods, wersja == "A"); B <- subset(ods, wersja == "B")   # te same wiersze miara × etap
roz <- data.frame(miara = A$miara, etap = A$etap, newcombe(B$n, B$mianownik, A$n, A$mianownik))
roz$p <- mapply(function(xb, nb, xa, na) prop.test(c(xb, xa), c(nb, na), correct = FALSE)$p.value,
                B$n, B$mianownik, A$n, A$mianownik)
# Metryka główna ustalona z góry: zakup od początku (bez poprawki). Koszyk „warunkowo” to ten sam odsetek co
# „od początku” (mianownik = wejścia), więc w rodzinie liczymy go raz. Pozostałe 6 porównań to jedna rodzina – Holm.
glowna <- roz$miara == "od początku (÷ wejścia)" & roz$etap == "zakup"
duplikat <- roz$miara == "warunkowo (÷ poprzedni etap)" & roz$etap == "koszyk"
rodzina <- !glowna & !duplikat
roz$p_holm <- NA
roz$p_holm[rodzina] <- p.adjust(roz$p[rodzina], method = "holm")
roz$p_holm[glowna] <- roz$p[glowna]
roz$p_holm[duplikat] <- roz$p_holm[roz$miara == "od początku (÷ wejścia)" & roz$etap == "koszyk"]
fp <- function(p) ifelse(p < .001, "<.001", sprintf("%.3f", p))   # zapis p do trzech miejsc
roz$wniosek <- ifelse(roz$p_holm < .05, "p < .05 (poza metryką główną: po korekcie Holma)", "p ≥ .05")
print(transform(roz[, c("miara", "etap")], roznica_pp = round(100 * roz$roznica, 1), dolna = round(100 * roz$dolna, 1),
                gorna = round(100 * roz$gorna, 1), p = fp(roz$p), p_holm = fp(roz$p_holm),
                glowna = glowna, w_rodzinie = rodzina), row.names = FALSE)

# Metryka główna w pełnym zapisie: test dla dwóch proporcji (χ², df = 1)
tg <- prop.test(c(B$n[B$miara == "od początku (÷ wejścia)" & B$etap == "zakup"],
                  A$n[A$miara == "od początku (÷ wejścia)" & A$etap == "zakup"]),
                c(B$mianownik[1], A$mianownik[1]), correct = FALSE)
round(c(chi2 = unname(tg$statistic), df = unname(tg$parameter), p = tg$p.value), 3)

p3 <- ggplot(roz, aes(100 * roznica, etap, colour = wniosek, shape = wniosek)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = 100 * dolna, xmax = 100 * gorna), width = 0.2, orientation = "y", linewidth = 0.8) +
  geom_point(size = 3) +
  geom_text(aes(label = sprintf("%+.1f", 100 * roznica)), vjust = -1.1, size = 3.6, show.legend = FALSE) +
  facet_wrap(~ miara) +
  scale_y_discrete(limits = rev) +
  scale_colour_manual(values = c("p < .05 (poza metryką główną: po korekcie Holma)" = kol[["B"]],
                                 "p ≥ .05" = kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c("p < .05 (poza metryką główną: po korekcie Holma)" = 16, "p ≥ .05" = 1),
                     name = NULL) +
  labs(x = "Różnica B − A (punkty procentowe)", y = NULL,
       title = "Gdzie wersje się różnią? Zależy, który odsetek porównujesz",
       subtitle = "95% przedziały Newcombe'a; korekta Holma dla 6 porównań poza metryką główną (zakup od początku)") +
  motyw
p3   # zapis: ggsave("lejek-konwersji-roznice-wersji.svg", p3, width = 10, height = 5.6)
Wynik w R
                        miara     etap roznica_pp dolna gorna     p p_holm
      od początku (÷ wejścia)   koszyk        0.7  -0.4   1.9 0.224  0.343
      od początku (÷ wejścia)  dostawa        1.9   0.9   2.9 <.001  <.001
      od początku (÷ wejścia) płatność        1.0   0.2   1.9 0.017  0.069
      od początku (÷ wejścia)    zakup        0.7  -0.1   1.5 0.080  0.080
 warunkowo (÷ poprzedni etap)   koszyk        0.7  -0.4   1.9 0.224  0.343
 warunkowo (÷ poprzedni etap)  dostawa        8.4   4.8  12.0 <.001  <.001
 warunkowo (÷ poprzedni etap) płatność       -3.7  -7.7   0.3 0.068  0.203
 warunkowo (÷ poprzedni etap)    zakup       -2.4  -5.8   1.1 0.171  0.343
 glowna w_rodzinie
  FALSE       TRUE
  FALSE       TRUE
  FALSE       TRUE
   TRUE      FALSE
  FALSE      FALSE
  FALSE       TRUE
  FALSE       TRUE
  FALSE       TRUE
 chi2    df     p
3.064 1.000 0.080
5. Kategorie, test interakcji i potrzebna liczebność: Rysunek 4
R
# Rysunek 4. Małe liczby na końcu lejka: zakup w podziale na kategorie (A) i liczebność potrzebna na etapach (B)
# Korzysta z obiektów przepisów 1–4: d, lej, newcombe, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

# A. Różnica B − A w odsetku zakupów (od początku) w każdej kategorii produktu i łącznie
grupy <- c(split(d, d$kategoria)[c("karma dla psów", "karma dla kotów", "akwarystyka", "gryzonie i ptaki")],
           list("wszyscy" = d))
seg <- do.call(rbind, lapply(names(grupy), function(g) {
  x <- grupy[[g]]; za <- sum(x$zakup[x$wersja == "A"]); zb <- sum(x$zakup[x$wersja == "B"])
  na <- sum(x$wersja == "A"); nb <- sum(x$wersja == "B")
  data.frame(grupa = g, na, nb, za, zb, newcombe(zb, nb, za, na),
             p = prop.test(c(zb, za), c(nb, na), correct = FALSE)$p.value)
}))
seg$p_holm <- c(p.adjust(seg$p[1:4], method = "holm"), NA)
print(transform(seg[, c("grupa", "na", "nb", "za", "zb")], roznica_pp = round(100 * seg$roznica, 1),
                dolna = round(100 * seg$dolna, 1), gorna = round(100 * seg$gorna, 1),
                p = fp(seg$p), p_holm = fp(seg$p_holm)), row.names = FALSE)
# Czy efekt różni się między kategoriami? Test interakcji wersja × kategoria (regresja logistyczna)
m0 <- glm(zakup ~ wersja + kategoria, family = binomial, data = d)
m1 <- glm(zakup ~ wersja * kategoria, family = binomial, data = d)
anova(m0, m1, test = "Chisq")

seg$grupa <- factor(seg$grupa, rev(seg$grupa))
seg$etykieta <- sprintf("%d i %d zakupów", seg$za, seg$zb)
pa <- ggplot(seg, aes(100 * roznica, grupa)) +
  geom_vline(xintercept = 0, colour = "grey40", linetype = "dashed") +
  geom_errorbar(aes(xmin = 100 * dolna, xmax = 100 * gorna), width = 0.12, orientation = "y", linewidth = 0.8,
                 colour = ifelse(seg$grupa == "wszyscy", kol[["B"]], kol[["A"]])) +
  geom_point(size = 3, shape = ifelse(seg$grupa == "wszyscy", 18, 16),
             colour = ifelse(seg$grupa == "wszyscy", kol[["B"]], kol[["A"]])) +
  geom_label(aes(label = etykieta), nudge_y = 0.3, size = 3.3, colour = "grey25", fill = "white", linewidth = 0, label.padding = unit(0.1, "lines")) +
  labs(x = "Różnica B − A w odsetku zakupów (pp)", y = NULL, title = "A. Zakup w kategoriach",
       subtitle = "95% przedziały Newcombe'a; liczby: zakupy w A i B") + motyw

# B. Ilu użytkowników na wersję potrzeba, by wykryć względny wzrost o 10% (α = .05, moc 80%)?
a <- subset(lej, wersja == "A" & nr > 1)
a$n_potrzebne <- sapply(a$od_poczatku, function(p) ceiling(power.prop.test(p1 = p, p2 = 1.1 * p, power = 0.8)$n))
print(data.frame(etap = a$etap, odsetek_od_poczatku = round(100 * a$od_poczatku, 1), n_na_wersje = a$n_potrzebne),
      row.names = FALSE)
pb <- ggplot(a, aes(etap, n_potrzebne / 1000)) +
  geom_col(fill = kol[["A"]], width = 0.6) +
  geom_hline(yintercept = sum(d$wersja == "A") / 1000, colour = kol[["B"]], linetype = "dashed") +
  geom_text(aes(label = format(n_potrzebne, big.mark = " ")), vjust = 1.5, size = 3.4, colour = "white") +
  labs(x = "Etap (odsetek od początku)", y = "Użytkownicy na wersję (tys.)", title = "B. Ilu potrzeba na wersję",
       subtitle = sprintf("Wzrost względny o 10%%, α = .05, moc 80%%;\nlinia: %s osób w wersji A", format(sum(d$wersja == "A"), big.mark = " "))) + motyw
p4 <- pa + pb + plot_layout(widths = c(1.15, 1))
p4   # zapis: ggsave("lejek-konwersji-male-liczby.svg", p4, width = 10, height = 5.6)
Wynik w R
            grupa   na   nb  za  zb roznica_pp dolna gorna     p p_holm
   karma dla psów 3179 3212 210 245        1.0  -0.2   2.3 0.112  0.449
  karma dla kotów 2770 2826 198 226        0.8  -0.5   2.2 0.230  0.690
      akwarystyka 1226 1190  92 100        0.9  -1.3   3.1 0.414  0.724
 gryzonie i ptaki  790  807  58  50       -1.1  -3.7   1.3 0.362  0.724
          wszyscy 7965 8035 558 621        0.7  -0.1   1.5 0.080   <NA>
Analysis of Deviance Table

Model 1: zakup ~ wersja + kategoria
Model 2: zakup ~ wersja * kategoria
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1     15995     8412.3
2     15992     8409.9  3    2.371   0.4991
     etap odsetek_od_poczatku n_na_wersje
   koszyk                16.8        8095
  dostawa                10.0       14762
 płatność                 7.8       19409
    zakup                 7.0       21796
6. Symulacja 1000 testów: Rysunek 5
R
# Rysunek 5. 1000 testów A/B: odsetek warunkowy „płatność ÷ dostawa” spada, choć wersja B niczego w płatności nie zmienia
# Korzysta z obiektów przepisu 1: symuluj_lejek, p_etap, p_wysoki, kol, motyw.
library(ggplot2)

# Prawdziwe (populacyjne) odsetki warunkowe wynikają z parametrów i mieszanki zamiarów na etapie dostawy
warunkowy_populacyjny <- function(p_dost) {
  w <- c(wysoki = p_wysoki, niski = 1 - p_wysoki) * p_etap$koszyk * p_dost     # kto dochodzi do dostawy
  sum(w * p_etap$platnosc) / sum(w)
}
zakup_populacyjny <- function(p_dost) {         # odsetek zakupów od początku w populacji
  sum(c(wysoki = p_wysoki, niski = 1 - p_wysoki) * p_etap$koszyk * p_dost * p_etap$platnosc * p_etap$zakup)
}
zA <- zakup_populacyjny(p_etap$dostawa$A); zB <- zakup_populacyjny(p_etap$dostawa$B)
round(c(zakup_A = 100 * zA, zakup_B = 100 * zB, wzrost_wzgledny_proc = 100 * (zB / zA - 1)), 2)
prawda <- 100 * (warunkowy_populacyjny(p_etap$dostawa$B) - warunkowy_populacyjny(p_etap$dostawa$A))
round(c(A = 100 * warunkowy_populacyjny(p_etap$dostawa$A), B = 100 * warunkowy_populacyjny(p_etap$dostawa$B),
        roznica_pp = prawda), 1)

jeden_test <- function(pe) {
  x <- symuluj_lejek(16000, pe, p_wysoki)
  ta <- prop.test(c(sum(x$platnosc[x$wersja == "B"]), sum(x$platnosc[x$wersja == "A"])),
                  c(sum(x$dostawa[x$wersja == "B"]), sum(x$dostawa[x$wersja == "A"])), correct = FALSE)
  tz <- prop.test(c(sum(x$zakup[x$wersja == "B"]), sum(x$zakup[x$wersja == "A"])),
                  table(factor(x$wersja, c("B", "A"))), correct = FALSE)
  c(roznica = 100 * unname(-diff(ta$estimate)), p = ta$p.value,
    zakup_roznica = 100 * unname(-diff(tz$estimate)), zakup_p = tz$p.value)
}
bez_efektu <- p_etap; bez_efektu$dostawa$B <- bez_efektu$dostawa$A   # scenariusz kontrolny: B = A wszędzie
set.seed(6110)
sym <- rbind(data.frame(scenariusz = "B zmienia tylko przejście koszyk → dostawa", t(replicate(1000, jeden_test(p_etap)))),
             data.frame(scenariusz = "B niczego nie zmienia (test A/A)", t(replicate(1000, jeden_test(bez_efektu)))))
sym$scenariusz <- factor(sym$scenariusz, unique(sym$scenariusz))
sym$alarm <- ifelse(sym$p < .05 & sym$roznica < 0, "„B pogorszyła płatność” (p < .05)",
                    ifelse(sym$p < .05, "„B poprawiła płatność” (p < .05)", "p ≥ .05"))
podsum <- do.call(rbind, lapply(split(sym, sym$scenariusz), function(s) {
  odsetek <- mean(s$p < .05 & s$roznica < 0)
  data.frame(scenariusz = s$scenariusz[1], srednia_roznica_pp = round(mean(s$roznica), 2),
             alarm_pogorszenie_proc = 100 * odsetek, blad_MC_pp = round(100 * sqrt(odsetek * (1 - odsetek) / nrow(s)), 1),
             istotne_dwustronnie_proc = 100 * mean(s$p < .05),
             zakup_istotnie_lepszy_proc = 100 * mean(s$zakup_p < .05 & s$zakup_roznica > 0))
}))
print(podsum, row.names = FALSE)

p5 <- ggplot(sym, aes(roznica, fill = alarm)) +
  geom_histogram(binwidth = 0.75, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 0, colour = "grey30", linetype = "dashed") +
  facet_wrap(~ scenariusz, ncol = 1) +
  scale_fill_manual(values = c("„B pogorszyła płatność” (p < .05)" = kol[["B"]],
                               "„B poprawiła płatność” (p < .05)" = kol[["A"]], "p ≥ .05" = "grey75"), name = NULL) +
  labs(x = "Różnica B − A w odsetku „płatność ÷ dostawa” (pp)", y = "Liczba testów (z 1000)",
       title = "Odsetek warunkowy porównuje różnych ludzi",
       subtitle = "1000 symulowanych testów po 16 000 osób; na etapie płatności osoba zachowuje się w A i B tak samo") +
  motyw
p5   # zapis: ggsave("lejek-konwersji-symulacja-1000-testow.svg", p5, width = 10, height = 6.4)
Wynik w R
             zakup_A              zakup_B wzrost_wzgledny_proc
                6.68                 7.52                12.58
         A          B roznica_pp
      77.1       73.8       -3.2
                                 scenariusz srednia_roznica_pp
 B zmienia tylko przejście koszyk → dostawa              -3.17
           B niczego nie zmienia (test A/A)              -0.08
 alarm_pogorszenie_proc blad_MC_pp istotne_dwustronnie_proc
                   32.9        1.5                     32.9
                    3.0        0.5                      5.2
 zakup_istotnie_lepszy_proc
                       54.2
                        2.6
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (wersja A / B; alarm „lepiej” / „gorzej”)" = c("#0072B2", "#D55E00"),
             "cynober – szary (istotne / nieistotne)" = c("#D55E00", "#999999"),
             "cynober – jasnoszary (alarm / p ≥ .05 na histogramie)" = c("#D55E00", "#BFBFBF"),
             "niebieski – jasnoniebieski (obrys i wypełnienie schematu)" = c("#0072B2", "#D6E6F2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                              widzenie_typowe
niebieski – cynober (wersja A / B; alarm „lepiej” / „gorzej”)           114.6
cynober – szary (istotne / nieistotne)                                   77.2
cynober – jasnoszary (alarm / p ≥ .05 na histogramie)                    80.1
niebieski – jasnoniebieski (obrys i wypełnienie schematu)                55.8
czerwony – zielony (do unikania)                                        121.7
                                                              deuteranopia
niebieski – cynober (wersja A / B; alarm „lepiej” / „gorzej”)        108.3
cynober – szary (istotne / nieistotne)                                62.9
cynober – jasnoszary (alarm / p ≥ .05 na histogramie)                 65.5
niebieski – jasnoniebieski (obrys i wypełnienie schematu)             58.7
czerwony – zielony (do unikania)                                      21.1
                                                              protanopia
niebieski – cynober (wersja A / B; alarm „lepiej” / „gorzej”)       91.9
cynober – szary (istotne / nieistotne)                              56.0
cynober – jasnoszary (alarm / p ≥ .05 na histogramie)               61.5
niebieski – jasnoniebieski (obrys i wypełnienie schematu)           51.8
czerwony – zielony (do unikania)                                    31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, przedziały, testy dla proporcji, poprawka Holma, regresja logistyczna i liczebność – pakiety base i stats). Rysunki wykonano w ggplot2, panele rysunku 4 połączono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Odsetki warunkowe jako efekt wersji. Po etapie, na który wersja wpływa, porównujesz różnych ludzi (rysunek 5).
- Mieszanie mianowników. „Konwersja 89.9%” i „konwersja 7.0%” to ta sama wersja A. Zawsze pisz, względem czego liczysz.
- Sesje zamiast użytkowników. Ta sama osoba w kilku sesjach to nie kilka niezależnych obserwacji; losuj i licz użytkowników.
- Za mała próba dla końca lejka. Liczebność licz dla metryki głównej, nie dla pierwszego etapu (8095 wobec 21 796 osób na wersję).
- Wiele etapów i podgrup bez korekty. 4 etapy × 2 odsetki × 4 kategorie to kilkadziesiąt testów; któryś „wyjdzie” przypadkiem.
- Przedział Walda przy odsetkach bliskich 0 lub 100%. Na końcu lejka warunkowe odsetki bywają wysokie, a liczby małe – używaj Wilsona.
Najczęstsze pytania
Jak policzyć konwersję na etapach lejka?
Dla każdego etapu policz dwa odsetki: od początku (osoby na etapie ÷ wszyscy, którzy weszli) i warunkowy (osoby na etapie ÷ osoby z poprzedniego etapu). Odsetek od początku to iloczyn odsetków warunkowych – w przykładzie 0.168 × 0.596 × 0.780 × 0.899 = 0.070. Zawsze podawaj, względem czego liczysz.
Jak porównać lejek konwersji dwóch wersji strony?
Dla każdego etapu podaj różnicę odsetków B − A z 95% przedziałem Newcombe’a i test dla dwóch proporcji. Przed testem wybierz jedną metrykę główną (zwykle zakup od początku), a pozostałe porównania skoryguj, np. metodą Holma. W przykładzie zakup wzrósł o 0.7 pp, 95% CI [−0.1, 1.5], p = .080.
Czy można porównywać odsetki warunkowe w teście A/B?
Opisowo tak, jako wskazówkę, gdzie ludzie odpadają. Jako dowód wpływu wersji – nie, jeśli wersja zmienia wcześniejsze etapy: do dalszego etapu dochodzą wtedy w obu wersjach inni ludzie. W symulacji wersja B zmieniała tylko przejście do dostawy, a mimo to w 32.9% testów odsetek płatności był w B istotnie niższy.
Ile osób potrzeba do testu A/B lejka konwersji?
Licz liczebność dla metryki głównej, czyli zwykle dla końca lejka. Do wykrycia wzrostu o 10% względnie (α = .05, moc 80%) przy odsetku koszyka 16.8% wystarczyło 8095 osób na wersję, a przy odsetku zakupu 7.0% potrzeba było 21 796. Im rzadsze zdarzenie, tym większa próba.
Jakiego przedziału ufności użyć dla odsetka konwersji?
Przedziału Wilsona dla jednego odsetka i przedziału Newcombe’a dla różnicy dwóch odsetków. Podręcznikowy przedział Walda ma chaotyczne pokrycie, szczególnie przy małych liczbach i odsetkach bliskich 0 lub 100% – a tak bywa na końcu lejka. W R przedział Wilsona daje prop.test(x, n, correct = FALSE).
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikWskaźniki ilorazowe w testach A/B – CTR i średni koszyk
Losujesz użytkowników, a liczysz wyświetlenia i zamówienia: naiwny przedział, metoda delta, bootstrap po użytkownikach i 1000 testów A/A – z kodem R.
Czytaj →PoradnikPorzucone koszyki – mail i czas do powrotu
Sklep fotograficzny: mail po 1 h i po 24 h, odsetek powrotów z CI, Kaplan–Meier, model Coxa, błędy klastrowane i ile koszyków wróciłoby i tak – kod R.
Czytaj →PoradnikRuch w sklepie a konwersja
Korekta licznika wejść, mały mianownik, model obciążenia obsługi i utracone transakcje – na fikcyjnej sieci salonów optycznych, z kodem R.
Czytaj →Analizujesz lejek konwersji albo test A/B do pracy?
Pomożemy zdefiniować etapy i metrykę główną, policzyć liczebność, przedziały i poprawki oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
Cytowania BibTeX
@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}