Przykład: sieć salonów optycznych i pytanie „czy w szczycie brakuje rąk do pracy?”
Fikcyjna sieć ma 30 salonów optycznych (18 w galeriach, 12 przy ulicy). Licznik przy drzwiach liczy wejścia, kasa – paragony, system – rozmowy z doradcą (dobór opraw, pomiar), a grafik – osoby obsługi w każdej godzinie. Mamy pół roku: 156 dni od poniedziałku do soboty, godziny 10–20, razem 46 800 godzin salonów.
W sobotę o 14:00 salon ma prawie pięć razy większy ruch niż w środę o 10:00, a konwersja jest ponad dwa razy niższa. Kierownik sieci pyta: czy to „gorsi” klienci w szczycie, czy za mało osób, które mogą ich obsłużyć? I ile transakcji tracimy w godzinach, w których obsługi brakuje? Szersze tło dla takich pytań daje wpis statystyka w pracy z marketingu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy (parametry przy kodzie). Klienci przychodzą w grupach, w sobotę częściej z rodziną, a licznik liczy każdą osobę i każde przejście pracownika. Obsadę planuje się pod prognozę ruchu (1 osoba na 3 prognozowane grupy); nieobecności, przerwy i nieprzewidziane wahania ruchu zmieniają rzeczywiste obciążenie. Obciążenie (grupy na osobę obsługi) obniża szansę rozmowy z doradcą, a zakup po rozmowie zależy od salonu i pory – w sobotę i w galeriach w godzinach 12–16 więcej osób „tylko ogląda”. Po pierwszym uruchomieniu wzmocniliśmy tę różnicę w składzie klientów: sobotni efekt (skala logitu) z −0.30 na −0.60 i dodatkowe −0.20 w galeriach w godzinach 12–16. Ziarna 733 nie zmienialiśmy. Dane: ruch-w-sklepie-salony-optyczne.csv (46 800 wierszy).
Konwersja to paragony / wejścia w godzinie. Jak w każdym lejku konwersji wszystko zależy od mianownika – a ten z licznika jest zawyżony.
Rysunek 1: licznik liczy osoby, a kupują grupy
Rodzina z dwójką dzieci to cztery wejścia i najwyżej jeden paragon; pracownik wracający z przerwy – kolejne wejście. To błąd pomiaru mianownika, i to nie losowy: w sobotę rodzin jest więcej. Dlatego sieć zrobiła badanie kalibracyjne: przez dwa tygodnie w 6 salonach (720 godzin) obserwator liczył grupy, osoby i przejścia personelu. W tych godzinach licznik pokazał 6499 przejść, a grup było 3770 – 1.72 razy mniej. Z kalibracji wynika korekta:
0.60 to średnia liczba przejść jednego pracownika w godzinie, a udział grup w osobach liczymy osobno dla dni roboczych i soboty.
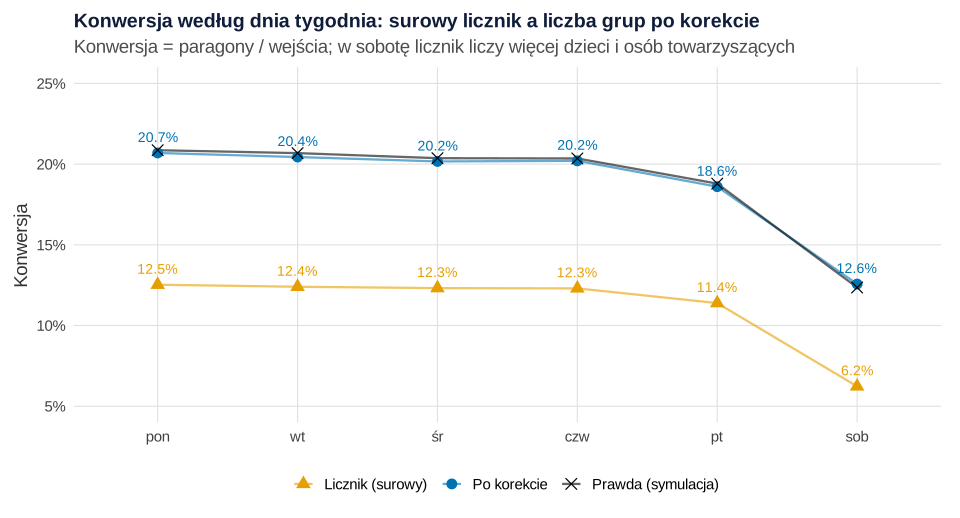
set.seed(733)).Co widać. Surowa konwersja całej sieci to 10.5%, po korekcie 18.2% – tyle samo co prawdziwa (18.2%). W sobotę surowo wychodzi 6.2%, czyli połowa wyniku z poniedziałku; po korekcie 12.6% (prawda: 12.4%). Część „sobotniego dołka” to dzieci i osoby towarzyszące, nie klienci.
Jak może zmylić. Korekta jest tak dobra jak kalibracja: dwa tygodnie w maju nie muszą pasować do grudnia. Powtarzaj ją, zwłaszcza po zmianie licznika lub wejścia. O tym, jak błąd pomiaru przenosi się na wyniki regresji, pisze wpis o błędzie pomiaru w regresji.
Podpis do pracy:
Rysunek 2: ruch, obciążenie i konwersja w tygodniu
Teraz układamy wszystkie 46 800 godzin w siatkę: dzień tygodnia × godzina. W każdej komórce liczymy średni ruch (grupy na salon), obciążenie (grupy na osobę obsługi) i konwersję po korekcie.
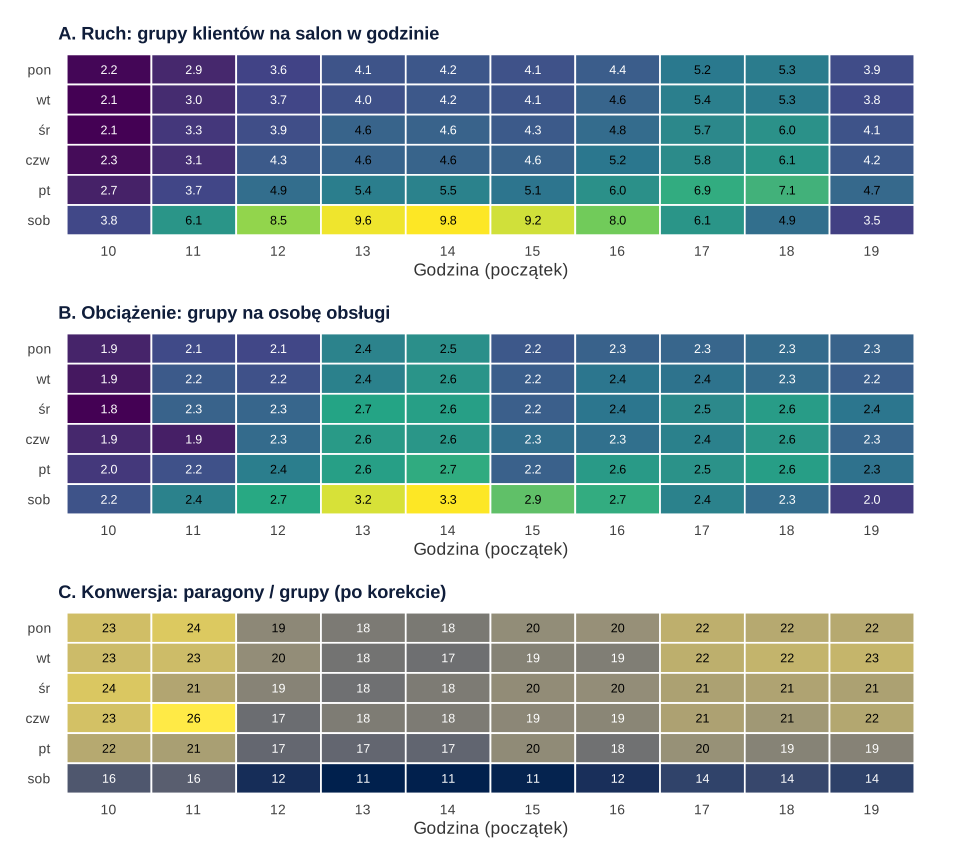
set.seed(733)).Co widać. Najwięcej klientów jest w sobotę o 14:00: 9.8 grupy na salon, 3.3 grupy na osobę obsługi i konwersja 11.0%. Najspokojniej jest w środę o 10:00: 2.1 grupy, 1.8 na osobę i 23.8% konwersji. W 60 komórkach korelacja ruchu i konwersji wynosi −0.71: im tłoczniej, tym mniejszy odsetek kupujących. Ten sam wzór – konwersja spada, gdy rośnie ruch – opisali Perdikaki i in. (2012) w sieci odzieżowej.
Jak może zmylić. Mapa nie mówi, dlaczego konwersja spada: w szczycie rośnie i obciążenie, i udział oglądających. Rozdzieli je model (Rysunek 4).
Podpis do pracy:
Rysunek 3: mały mianownik – godziny z kilkoma wejściami
W 41.1% godzin z jakimkolwiek wejściem salon odwiedziły najwyżej 3 grupy, a przy 2 grupach konwersja może wynieść tylko 0%, 50% albo 100%. Żeby ocenić, czy godzina jest „podejrzanie słaba”, rysujemy wykres lejkowy: konwersja godziny względem liczby grup, z granicami z rozkładu dwumianowego wokół konwersji sieci (Spiegelhalter, 2005).
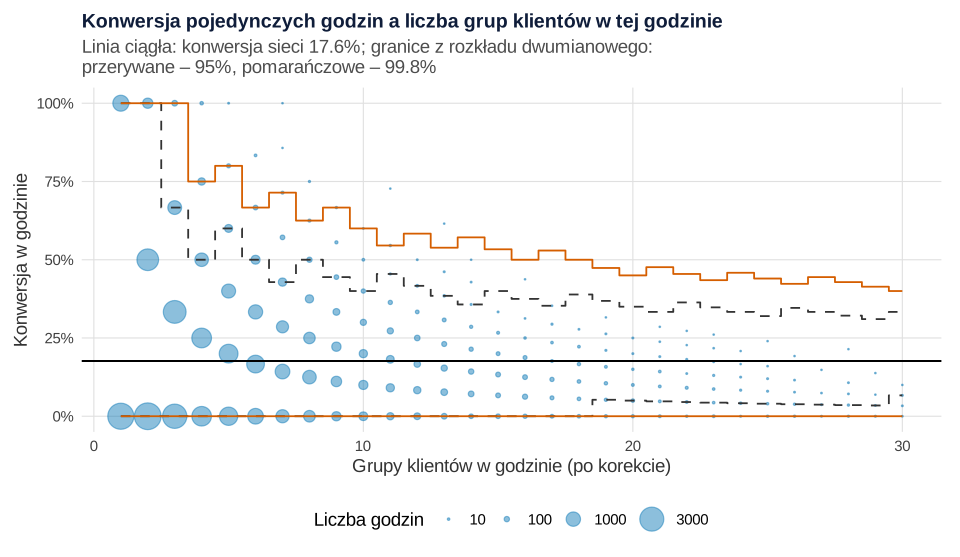
set.seed(733)).Co widać. W godzinach z 1–3 grupami 57.0% ma konwersję 0%, a 28.3% – co najmniej 50%. To mały mianownik, nie „złe” godziny. Poza granicami 95% leży 1.9% godzin, a przy 10 i więcej grupach – 3.8%. Średnia z konwersji godzinowych wynosi 20.9%, a konwersja całej sieci (suma paragonów / suma grup) – 17.6%: średnia z ilorazów daje tyle samo wagi godzinie z jedną grupą co godzinie z dwudziestoma.
Jak może zmylić. Granice zakładają jednakową szansę zakupu w każdej godzinie, a tak nie jest (sobota, salon, obciążenie). Lejek to sito: pokazuje, co obejrzeć, nie kto zawinił.
Podpis do pracy:
Rysunek 4: obsada czy ruch? Model z efektem salonu
Najpierw naiwne porównanie: konwersja według liczby osób obsługi w godzinie. Potem model: regresja logistyczna dla paragonów z liczby grup (model dwumianowy) z trzema składnikami:
- splajn obciążenia – krzywa bez narzuconego kształtu, jak we wpisie o splajnach i modelach GAM (Wood, 2017);
- dzień × godzina – 60 komórek z Rysunku 2, czyli „kto przychodzi o tej porze”;
- losowy efekt salonu – godziny jednego salonu nie są niezależne (zob. wielopoziomowa regresja logistyczna).
W tej samej komórce dzień × godzina obciążenie zmieniają nieobecności, przerwy i wahania ruchu – to one pozwalają oddzielić skutek obsady od pory dnia. Model dopasowujemy funkcją bam() (pakiet mgcv), a krzywa jest standaryzowana: to średnia przewidywana konwersja, gdyby w każdej godzinie obciążenie wynosiło L.
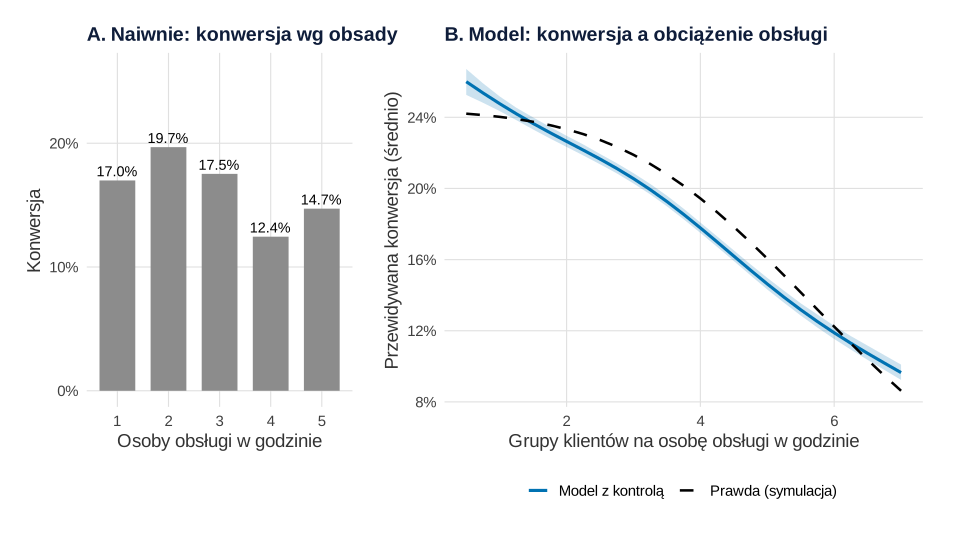
set.seed(733), set.seed(7331)).Co widać. Panel A sugeruje absurd: przy czterech osobach obsługi konwersja jest najniższa (12.4%). To zakłócenie odwrotne: obsadę planuje się pod ruch, więc najwięcej osób pracuje w sobotnim szczycie, gdy przychodzi najwięcej oglądających. Pora dnia jest tu zmienną zakłócającą ukrytą w grafiku.
Panel B pokazuje model. Przy 2 grupach na osobę przewidywana konwersja wynosi 22.6% [22.3, 23.0], przy 4 – 17.8% [17.5, 18.1], a przy 6 – 11.9% [11.5, 12.3]. Spadek od 2 do 5 grup na osobę to 8.0 punktu procentowego (prawda: 7.3). Powyżej ok. 3 grup na osobę krzywa opada szybciej. Podobną zależność od adekwatności obsady (pracy personelu względem ruchu) wykorzystali do planowania grafiku Chuang i in. (2016).
Ile szczytu wyjaśnia obsada? W sobotę w godzinach 12–15 konwersja wynosi 11.1%, w dni robocze o 10–11 – 21.9%. Obciążenie to odpowiednio 2.99 i 2.03 grupy na osobę. Gdyby w sobotnim szczycie obciążenie było takie jak rano w tygodniu, model przewiduje 13.2% (prawda: 13.0%). Obsada wyjaśnia ok. 2 z 11 punktów różnicy; reszta to inni klienci.
Jak może zmylić. Przy obciążeniu 3–5 krzywa leży o ok. 1.5 punktu poniżej prawdy, poza pasmem. Obciążenie i mianownik konwersji pochodzą z tego samego skorygowanego licznika, więc błąd korekty trafia do obu naraz, a pasmo opisuje tylko niepewność z próby.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ile transakcji tracą godziny z za małą obsadą?
Robocza definicja: za mała obsada to ponad 4 grupy klientów na osobę w godzinie (tam krzywa z Rysunku 4 opada najszybciej). Takich godzin było 7665 (16.4%). Dla każdej model przewiduje konwersję przy obecnej obsadzie i przy jednej osobie więcej, przy tym samym ruchu; suma różnic × liczba grup to szacunek utraconych transakcji. Przedział wyznaczamy z 1000 losowań współczynników modelu z ich przybliżonego rozkładu normalnego; przedziały oparte na tej macierzy kowariancji mają dla składników modeli GAM pokrycie bliskie nominalnemu (Marra i Wood, 2012).
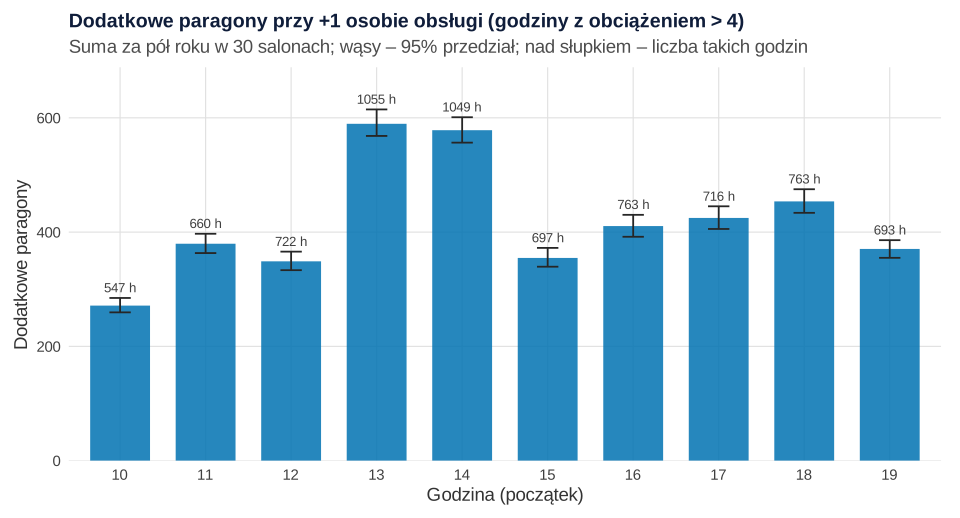
set.seed(7332)).Co widać. Jedna osoba więcej w tych godzinach dałaby 4182 paragony, 95% CI [4035, 4339], czyli 23.2 paragonu na salon miesięcznie i 0.55 paragonu na dodatkową godzinę pracy. Przy średnim paragonie 690 zł to ok. 376 zł przychodu na godzinę pracy. Najwięcej traci się o 13:00 i 14:00, w porze przerw obiadowych. Problem nie dotyczy tylko soboty: 1498 z 7665 takich godzin przypada na soboty, a 6167 – na dni robocze. Mani i in. (2015) znaleźli w 41 sklepach sieci systematycznie za małą obsadę w szczycie, wynikającą m.in. z błędów prognoz ruchu i ograniczeń grafiku.
Jak może zmylić. Prawdziwy zysk z symulacji to 3879 paragonów – mniej niż dolna granica przedziału. Godziny wybieramy po oszacowanym obciążeniu, więc trafiają tu też te, w których korekta zawyżyła ruch – odmiana regresji do średniej. Traktuj wynik jako górny szacunek przychodu, nie zysku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: wejścia → rozmowy → zakup – karta
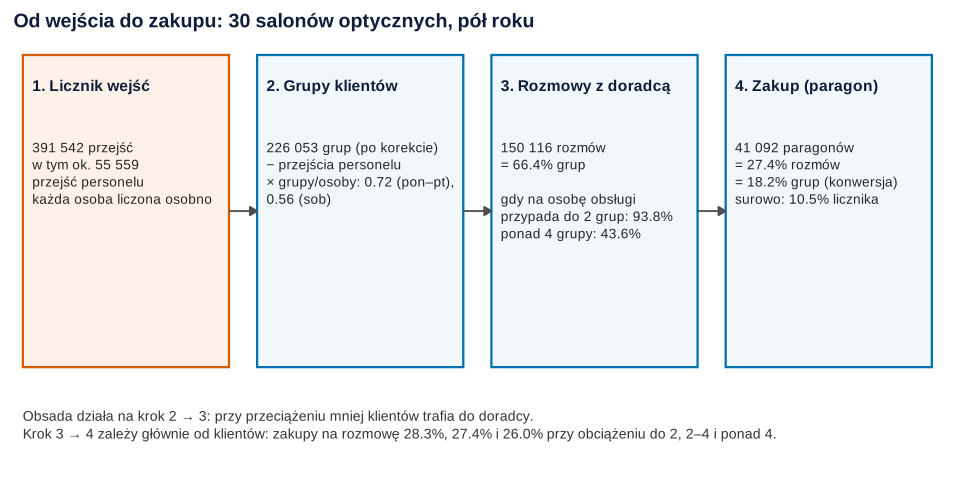
Co widać. Z 391 542 przejść przez licznik zostaje 226 053 grup klientów, 150 116 rozmów i 41 092 paragony. Obsada działa na przejście od grupy do rozmowy: gdy na osobę przypadają najwyżej 2 grupy, rozmowę ma 93.8% z nich, przy ponad 4 – 43.6%. Odsetek zakupów po rozmowie zmienia się mało (28.3% wobec 26.0%) i zależy głównie od tego, kto przyszedł. Rejestr rozmów pokazuje więc, gdzie ginie klient.
Podpis do pracy:
Co z tym zrobić w firmie
- Raportuj konwersję z grup, nie z licznika. Co kwartał powtarzaj kalibrację – bez niej sobota zawsze wygląda na „najgorszy dzień”.
- Nie oceniaj salonów ani pracowników po pojedynczych godzinach. Przy 2–3 grupach konwersja 0% to norma. Porównuj tygodnie, odstające salony szukaj wykresem lejkowym i uważaj na paradoks Simpsona.
- Przesuń przerwy obiadowe. Najwięcej transakcji traci się o 13:00 i 14:00 – rozłożenie przerw jest tańsze niż nowy etat.
- Planuj obsadę z prognozy z zapasem na wahania. Pomaga prognoza ruchu z sezonowością (jak w prognozie sprzedaży) i osoba w gotowości na soboty. Kolejki liczone wzorem opisuje wpis o obsadzie infolinii (Erlang C) – w salonie kolejki nie widać, bo klient po prostu wychodzi.
- Sprawdź wynik eksperymentem. Dodatkową osobę można przydzielić losowo części salonów – jak w eksperymencie w sklepach stacjonarnych.
Jak opisać w pracy
Opisz źródła danych, korektę licznika, model i sposób liczenia utraconych transakcji. Opis niepewności przewidywań modelu pokazuje też wpis o ocenie leadów B2B.
| Grupy klientów na osobę obsługi | Przewidywana konwersja (%) | 95% CI |
|---|---|---|
| 1 | 24.8 | [24.3, 25.2] |
| 2 | 22.6 | [22.3, 23.0] |
| 3 | 20.6 | [20.3, 20.9] |
| 4 | 17.8 | [17.5, 18.1] |
| 5 | 14.6 | [14.3, 15.0] |
| 6 | 11.9 | [11.5, 12.3] |
Kod R: korekta licznika, wykres lejkowy, model z obciążeniem i utracone transakcje
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcje pomocnicze, z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(733)), 5 (set.seed(7331) – podpróba 3000 godzin i 1000 losowań współczynników) i 6 (set.seed(7332) – 1000 losowań współczynników). Ręcznie ustalono: 30 salonów (18 w galeriach, 12 przy ulicy), bazowy ruch 5.0 i 3.0 grupy na godzinę (× losowy mnożnik salonu, odchylenie standardowe logarytmu 0.25), profile ruchu w godzinach (dni robocze i sobota), mnożniki dni (0.9, 0.9, 0.95, 1.0, 1.15 i 1.5 w sobotę w galerii, 1.1 przy ulicy), dzienne wahania ruchu (rozkład gamma o średniej 1, kształt 12) i godzinowe (kształt 20), wielkość grup (dni robocze: 1–4 osoby z prawdopodobieństwami .70, .22, .06, .02; sobota: .50, .30, .13, .07), 0.6 przejścia pracownika na godzinę, plan obsady 1 osoba na 3 prognozowane grupy (najwyżej 4 w galerii i 3 przy ulicy), nieobecność (10% dni salonu) i dodatkową osobę (5%), przerwy obiadowe (25% godzin 13 i 14), szansę rozmowy logit 1.6 − 0.55 · softplus(obciążenie − 2.5), szansę zakupu po rozmowie 0.30 (logit) z efektem salonu (odchylenie standardowe 0.25, +0.2 przy ulicy), sobotą −0.60, piątkiem −0.10, godzinami 10–11 +0.15 i godzinami 12–16 w galeriach −0.20, badanie kalibracyjne (6 salonów, 5–17 maja), próg za małej obsady (4 grupy na osobę) i średni paragon 690 zł. Po pierwszym uruchomieniu zmieniono efekt soboty z −0.30 na −0.60 i dodano efekt −0.20 w galeriach w godzinach 12–16. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 20 sekund.
1. Dane: 30 salonów, 46 800 godzin, licznik, rozmowy i paragony
R
# Przepis 1. Fikcyjna sieć 30 salonów optycznych: licznik wejść, rozmowy, paragony i obsada co godzinę przez pół roku
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Licznik (surowy)" = "#E69F00", "Po korekcie" = "#0072B2", "Prawda (symulacja)" = "#000000",
         "Model naiwny" = "#E69F00", "Model z kontrolą" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków
softplus <- function(x) log1p(exp(x))           # gładkie „kolanko”: ok. 0 dla x < 0, ok. x dla x > 0

# Parametry ustalone ręcznie
n_salonow <- 30; n_galeria <- 18                      # 18 salonów w galeriach handlowych, 12 przy ulicy
godziny <- 10:19                                     # godzina otwarcia 10:00–20:00 (10 godzin)
dni_tyg <- c("pon", "wt", "śr", "czw", "pt", "sob")
prof_tydz <- c(0.5, 0.7, 0.9, 1.0, 1.0, 1.0, 1.1, 1.3, 1.3, 0.9)   # profil ruchu w godzinach, pon–pt
prof_sob  <- c(0.6, 1.0, 1.4, 1.6, 1.6, 1.5, 1.3, 1.0, 0.8, 0.6)   # profil ruchu w godzinach, sobota
mn_dnia <- c(0.9, 0.9, 0.95, 1.0, 1.15, 1.5)          # mnożnik ruchu wg dnia (sobota w galerii; przy ulicy 1.1)
p_grupa_tydz <- c(0.70, 0.22, 0.06, 0.02)             # wielkość grupy 1, 2, 3, 4 osoby: pon–pt
p_grupa_sob  <- c(0.50, 0.30, 0.13, 0.07)             # sobota: więcej rodzin z dziećmi
przejscia_personelu <- 0.6                           # przejścia pracownika przez licznik na godzinę
osoby_na_klienta <- 3                                # plan obsady: 1 osoba na 3 prognozowane grupy klientów

set.seed(733)
salony <- data.frame(salon = sprintf("S%02d", 1:n_salonow),
                     typ = rep(c("galeria", "ulica"), c(n_galeria, n_salonow - n_galeria)))
salony$baza <- ifelse(salony$typ == "galeria", 5.0, 3.0) * exp(rnorm(n_salonow, 0, 0.25))  # grupy na godzinę
salony$maks_obsada <- ifelse(salony$typ == "galeria", 4, 3)
salony$efekt_salonu <- rnorm(n_salonow, 0, 0.25) + ifelse(salony$typ == "ulica", 0.2, 0)  # logit zakupu

daty <- seq(as.Date("2025-03-03"), by = "day", length.out = 26 * 7)
daty <- daty[format(daty, "%u") != "7"]               # bez niedziel: 156 dni
sd_ <- expand.grid(data = daty, salon = salony$salon, stringsAsFactors = FALSE)
sd_$dzien <- factor(dni_tyg[as.integer(format(sd_$data, "%u"))], levels = dni_tyg)
sd_$szum_dnia <- rgamma(nrow(sd_), 12, 12)            # nieprzewidziane wahania ruchu dnia (średnio 1)
sd_$zmiana <- sample(c(-1, 0, 1), nrow(sd_), replace = TRUE, prob = c(0.10, 0.85, 0.05))  # absencja / dodatkowa osoba

d <- merge(sd_[rep(seq_len(nrow(sd_)), each = length(godziny)), ], salony, by = "salon")
d$godzina <- rep(godziny, length.out = nrow(d))
d <- d[order(d$salon, d$data, d$godzina), ]
sob <- d$dzien == "sob"; ih <- d$godzina - 9
mnoz <- mn_dnia[as.integer(d$dzien)]; mnoz[sob & d$typ == "ulica"] <- 1.1
d$prognoza <- d$baza * mnoz * ifelse(sob, prof_sob[ih], prof_tydz[ih])    # prognoza ruchu bez szumu
d$obsada_plan <- pmin(d$maks_obsada, pmax(1, ceiling(d$prognoza / osoby_na_klienta)))
przerwa <- d$godzina %in% c(13, 14) & d$obsada_plan > 1 & runif(nrow(d)) < 0.25    # przerwy obiadowe
d$obsada <- pmax(1, d$obsada_plan + d$zmiana - przerwa)

# Prawdziwy proces (w danych firmy nieobserwowany): grupy klientów, osoby, rozmowy, zakupy
d$grupy <- rpois(nrow(d), d$prognoza * d$szum_dnia * rgamma(nrow(d), 20, 20))
d$osoby <- d$grupy + sapply(seq_len(nrow(d)), function(i) {
  if (d$grupy[i] == 0) 0 else sum(sample(0:3, d$grupy[i], TRUE, if (sob[i]) p_grupa_sob else p_grupa_tydz)) })
d$przejscia <- rpois(nrow(d), przejscia_personelu * d$obsada)
d$obciazenie_prawdziwe <- d$grupy / d$obsada
p_rozmowy <- function(L) plogis(1.6 - 0.55 * softplus(L - 2.5))       # obciążenie obniża szansę rozmowy
d$logit_zakupu <- qlogis(0.30) + d$efekt_salonu - 0.60 * sob - 0.10 * (d$dzien == "pt") + 0.15 * (d$godzina < 12) -
  0.20 * (d$typ == "galeria" & d$godzina %in% 12:16)  # w szczycie więcej osób „tylko ogląda”
d$rozmowy <- rbinom(nrow(d), d$grupy, p_rozmowy(d$obciazenie_prawdziwe))
d$paragony <- rbinom(nrow(d), d$rozmowy, plogis(d$logit_zakupu))

# Dane, które ma firma: licznik (osoby + przejścia personelu), obsada z grafiku, rozmowy i paragony
d$licznik <- d$osoby + d$przejscia
# Badanie kalibracyjne licznika: 2 tygodnie w 6 salonach obserwator liczył grupy, osoby i przejścia personelu
obs <- d$salon %in% c("S02", "S07", "S11", "S20", "S24", "S29") & d$data >= as.Date("2025-05-05") &
  d$data <= as.Date("2025-05-17")
d$obs_grupy <- ifelse(obs, d$grupy, NA); d$obs_osoby <- ifelse(obs, d$osoby, NA)
d$obs_przejscia <- ifelse(obs, d$przejscia, NA)

salon_godz <- d[, c("salon", "typ", "data", "dzien", "godzina", "licznik", "obsada", "rozmowy", "paragony",
                    "obs_grupy", "obs_osoby", "obs_przejscia")]
write.csv(salon_godz, "ruch-w-sklepie-salony-optyczne.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(salony = n_salonow, dni = length(daty), godziny_salonow = nrow(d), licznik = sum(d$licznik),
  rozmowy = sum(d$rozmowy), paragony = sum(d$paragony), godziny_kalibracji = sum(obs))
c(prawdziwe_grupy = sum(d$grupy), osoby = sum(d$osoby), przejscia_personelu = sum(d$przejscia))
table(obsada = d$obsada)
Wynik w R
            salony                dni    godziny_salonow            licznik            rozmowy           paragony
                30                156              46800             391542             150116              41092
godziny_kalibracji
               720
    prawdziwe_grupy               osoby przejscia_personelu
             225374              335559               55983
obsada
    1     2     3     4     5
14303 21672  7853  2809   163
2. Korekta licznika i konwersja według dnia: Rysunek 1
R
# Przepis 2. Korekta licznika: przejścia personelu i grupy klientów (badanie kalibracyjne): Rysunek 1
s <- salon_godz
kal <- subset(s, !is.na(obs_grupy))                  # 720 godzin z obserwatorem
kal$sobota <- kal$dzien == "sob"
przejscia_na_osobe <- sum(kal$obs_przejscia) / sum(kal$obsada)            # przejścia na pracownika na godzinę
grupy_na_osobe <- tapply(kal$obs_grupy, kal$sobota, sum) / tapply(kal$obs_osoby, kal$sobota, sum)
c(przejscia_na_pracownika = przejscia_na_osobe, grupy_na_osobe_pon_pt = grupy_na_osobe[["FALSE"]],
  grupy_na_osobe_sob = grupy_na_osobe[["TRUE"]])
# Sprawdzenie na godzinach kalibracji: ile licznik zawyża liczbę grup?
c(licznik_kal = sum(kal$licznik), grupy_kal = sum(kal$obs_grupy), zawyzenie = sum(kal$licznik) / sum(kal$obs_grupy))

s$grupy_szac <- pmax(0, s$licznik - przejscia_na_osobe * s$obsada) *
  ifelse(s$dzien == "sob", grupy_na_osobe[["TRUE"]], grupy_na_osobe[["FALSE"]])
s$n <- pmax(round(s$grupy_szac), s$rozmowy)          # liczba prób do modelu dwumianowego (całkowita)
s$obciazenie <- s$grupy_szac / s$obsada              # oszacowane grupy klientów na osobę obsługi

konw <- function(x) tapply(s$paragony, s$dzien, sum) / tapply(x, s$dzien, sum)
tab_dzien <- data.frame(dzien = levels(s$dzien), surowa = konw(s$licznik), po_korekcie = konw(s$grupy_szac),
                        prawda = tapply(d$paragony, d$dzien, sum) / tapply(d$grupy, d$dzien, sum))
print(transform(tab_dzien, surowa = round(100 * surowa, 1), po_korekcie = round(100 * po_korekcie, 1),
                prawda = round(100 * prawda, 1)), row.names = FALSE)
round(100 * c(surowa = sum(s$paragony) / sum(s$licznik), po_korekcie = sum(s$paragony) / sum(s$grupy_szac),
              prawda = sum(d$paragony) / sum(d$grupy)), 1)

dl <- data.frame(dzien = factor(rep(tab_dzien$dzien, 3), levels = levels(s$dzien)),
                 miara = factor(rep(c("Licznik (surowy)", "Po korekcie", "Prawda (symulacja)"), each = 6),
                                levels = c("Licznik (surowy)", "Po korekcie", "Prawda (symulacja)")),
                 konwersja = c(tab_dzien$surowa, tab_dzien$po_korekcie, tab_dzien$prawda))
p1 <- ggplot(dl, aes(dzien, konwersja, colour = miara, shape = miara, group = miara)) +
  geom_line(linewidth = 0.8, alpha = 0.6) + geom_point(size = 3.4) +
  geom_text(data = subset(dl, miara != "Prawda (symulacja)"), aes(label = sprintf("%.1f%%", 100 * konwersja)),
            vjust = -1.1, size = 3.7, show.legend = FALSE) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16, 4), name = NULL) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0.05, 0.25)) +
  labs(title = "Konwersja według dnia tygodnia: surowy licznik a liczba grup po korekcie",
       subtitle = "Konwersja = paragony / wejścia; w sobotę licznik liczy więcej dzieci i osób towarzyszących",
       x = NULL, y = "Konwersja") + motyw
p1   # zapis: ggsave("ruch-w-sklepie-korekta-licznika.svg", p1, width = 10, height = 5.4)
Wynik w R
przejscia_na_pracownika   grupy_na_osobe_pon_pt      grupy_na_osobe_sob
              0.5957588               0.7172363               0.5564253
licznik_kal   grupy_kal   zawyzenie
6499.000000 3770.000000    1.723873
 dzien surowa po_korekcie prawda
   pon   12.5        20.7   20.9
    wt   12.4        20.4   20.7
    śr   12.3        20.2   20.4
   czw   12.3        20.2   20.4
    pt   11.4        18.6   18.8
   sob    6.2        12.6   12.4
     surowa po_korekcie      prawda
       10.5        18.2        18.2
3. Ruch, obciążenie i konwersja według dnia i godziny: Rysunek 2
R
# Przepis 3. Ruch, obciążenie i konwersja według dnia i godziny (mapa ciepła): Rysunek 2
library(patchwork)
agr <- aggregate(cbind(grupy_szac, paragony, obsada) ~ dzien + godzina, data = s, FUN = sum)
liczba_godzin <- aggregate(obsada ~ dzien + godzina, data = s, FUN = length)$obsada
agr$ruch <- agr$grupy_szac / liczba_godzin           # średnio grup klientów na salon w tej godzinie
agr$obciazenie <- agr$grupy_szac / agr$obsada        # grupy na osobę obsługi
agr$konwersja <- agr$paragony / agr$grupy_szac
agr[order(-agr$ruch), c("dzien", "godzina", "ruch", "obciazenie", "konwersja")][1:4, ]
agr[order(agr$ruch), c("dzien", "godzina", "ruch", "obciazenie", "konwersja")][1:2, ]
round(cor(agr$ruch, agr$konwersja), 2)               # korelacja ruchu i konwersji w 60 komórkach

mapa <- function(zm, tytul, etyk, opcja) {
  ggplot(agr, aes(factor(godzina), dzien, fill = .data[[zm]])) + geom_tile(colour = "white", linewidth = 0.6) +
    geom_text(aes(label = etyk(.data[[zm]]), colour = .data[[zm]] > median(.data[[zm]])), size = 3.3,
              show.legend = FALSE) +
    scale_colour_manual(values = c("TRUE" = "black", "FALSE" = "white")) +
    scale_fill_viridis_c(option = opcja, guide = "none") + scale_y_discrete(limits = rev) +
    labs(title = tytul, x = "Godzina (początek)", y = NULL) + motyw + theme(panel.grid.major = element_blank())
}
p2 <- mapa("ruch", "A. Ruch: grupy klientów na salon w godzinie", function(x) sprintf("%.1f", x), "D") /
  mapa("obciazenie", "B. Obciążenie: grupy na osobę obsługi", function(x) sprintf("%.1f", x), "D") /
  mapa("konwersja", "C. Konwersja: paragony / grupy (po korekcie)", function(x) sprintf("%.0f", 100 * x), "E")
p2   # zapis: ggsave("ruch-w-sklepie-mapa-godzin.svg", p2, width = 10, height = 9)
Wynik w R
   dzien godzina     ruch obciazenie konwersja
30   sob      14 9.775987   3.268440 0.1095043
24   sob      13 9.595247   3.175347 0.1091619
36   sob      15 9.202970   2.851934 0.1115860
18   sob      12 8.489347   2.686284 0.1202110
  dzien godzina     ruch obciazenie konwersja
3    śr      10 2.120160   1.789746 0.2376453
2    wt      10 2.122273   1.864159 0.2295555
[1] -0.71
4. Mały mianownik – wykres lejkowy godzin: Rysunek 3
R
# Przepis 4. Mały mianownik: konwersja pojedynczych godzin a liczba wejść (wykres lejkowy): Rysunek 3
g <- subset(s, n >= 1)
g$konwersja <- g$paragony / g$n
p0 <- sum(g$paragony) / sum(g$n)                     # konwersja całej sieci (suma paragonów / suma grup)
c(godziny_z_wejsciem = nrow(g), bez_wejscia = sum(s$n == 0))
round(c(odsetek_do_3_grup = mean(g$n <= 3), konwersja_sieci = p0, srednia_z_godzin = mean(g$konwersja)), 3)
# W godzinach z 1–3 grupami: jak często konwersja wynosi 0% albo co najmniej 50%?
with(subset(g, n <= 3), round(c(zero = mean(konwersja == 0), pol_i_wiecej = mean(konwersja >= 0.5)), 3))

granice <- data.frame(n = 1:30)
for (q in c(0.001, 0.025, 0.975, 0.999)) granice[[paste0("q", q)]] <- qbinom(q, granice$n, p0) / granice$n
g$poza95 <- g$konwersja < qbinom(0.025, g$n, p0) / g$n | g$konwersja > qbinom(0.975, g$n, p0) / g$n
round(c(poza_95 = mean(g$poza95), poza_95_n_do_5 = mean(g$poza95[g$n <= 5]),
        poza_95_n_od_10 = mean(g$poza95[g$n >= 10])), 3)

licz <- aggregate(salon ~ n + konwersja, data = subset(g, n <= 30), FUN = length)
names(licz)[3] <- "godzin"
p3 <- ggplot(licz, aes(n, konwersja)) +
  geom_point(aes(size = godzin), colour = "#0072B2", alpha = 0.45) +
  geom_step(data = granice, aes(n, q0.025), direction = "mid", colour = "grey20", linetype = "dashed") +
  geom_step(data = granice, aes(n, q0.975), direction = "mid", colour = "grey20", linetype = "dashed") +
  geom_step(data = granice, aes(n, q0.999), direction = "mid", colour = "#D55E00") +
  geom_step(data = granice, aes(n, q0.001), direction = "mid", colour = "#D55E00") +
  geom_hline(yintercept = p0, colour = "black", linewidth = 0.7) +
  scale_size_area(max_size = 9, name = "Liczba godzin", breaks = c(10, 100, 1000, 3000)) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "Konwersja pojedynczych godzin a liczba grup klientów w tej godzinie",
       subtitle = sprintf("Linia ciągła: konwersja sieci %.1f%%; granice z rozkładu dwumianowego:\nprzerywane – 95%%, pomarańczowe – 99.8%%",
                          100 * p0), x = "Grupy klientów w godzinie (po korekcie)", y = "Konwersja w godzinie") + motyw
p3   # zapis: ggsave("ruch-w-sklepie-lejek-godzin.svg", p3, width = 10, height = 5.8)
Wynik w R
godziny_z_wejsciem        bez_wejscia
             44457               2343
odsetek_do_3_grup   konwersja_sieci  srednia_z_godzin
            0.411             0.176             0.209
        zero pol_i_wiecej
       0.570        0.283
        poza_95  poza_95_n_do_5 poza_95_n_od_10
          0.019           0.015           0.038
5. Model dwumianowy ze splajnem obciążenia i efektem salonu: Rysunek 4
R
# Przepis 5. Obsada czy ruch? Model dwumianowy ze splajnem obciążenia i efektem salonu: Rysunek 4
library(mgcv)
s$salon <- factor(s$salon); s$godz <- factor(s$godzina)
# Naiwnie: konwersja według liczby osób obsługi (więcej osób jest w godzinach szczytu)
naiw <- aggregate(cbind(paragony, n) ~ obsada, data = s, FUN = sum)
naiw$konwersja <- naiw$paragony / naiw$n
print(transform(naiw, konwersja = round(100 * konwersja, 1)), row.names = FALSE)

# Model: splajn obciążenia (grupy na osobę obsługi) + dzień × godzina (skład klientów) + losowy efekt salonu
m1 <- bam(cbind(paragony, n - paragony) ~ s(obciazenie, k = 10) + dzien * godz + s(salon, bs = "re"),
          family = binomial, data = s, method = "fREML", discrete = TRUE)
summary(m1)$s.table

# Krzywa standaryzowana: średnia przewidywana konwersja, gdyby w każdej godzinie obciążenie wynosiło L
set.seed(7331)
wiersze <- sample(nrow(s), 3000)                     # podpróba godzin do uśredniania (szybciej)
siatka <- seq(0.5, 7, by = 0.25)
krzywa <- function(m, B = 1000) {
  bety <- MASS::mvrnorm(B, coef(m), vcov(m))        # przybliżony rozkład współczynników (Vp z mgcv)
  out <- t(sapply(siatka, function(L) {
    nd <- s[wiersze, ]; nd$obciazenie <- L
    X <- predict(m, nd, type = "lpmatrix")
    c(est = mean(plogis(X %*% coef(m))), quantile(colMeans(plogis(X %*% t(bety))), c(0.025, 0.975)))
  }))
  data.frame(L = siatka, est = out[, 1], dol = out[, 2], gora = out[, 3])
}
k1 <- krzywa(m1)
prawda <- sapply(siatka, function(L) mean(p_rozmowy(L) * plogis(d$logit_zakupu[wiersze])))
tab <- data.frame(L = siatka, model = k1$est, dol = k1$dol, gora = k1$gora, prawda = prawda)
tab6 <- subset(tab, L %in% 1:6); tab6[, -1] <- round(100 * tab6[, -1], 1)
print(tab6, row.names = FALSE)            # konwersja w % przy obciążeniu L
spadek <- function(k) k$est[k$L == 2] - k$est[k$L == 5]
round(100 * c(spadek_od_2_do_5_model = spadek(k1), spadek_prawda = prawda[siatka == 2] - prawda[siatka == 5]), 1)

# Rozdzielenie ruchu i obsady: sobotni szczyt (12–15) a godziny spokojne (pon–pt 10–11)
szczyt <- s$dzien == "sob" & s$godzina %in% 12:15; spokoj <- s$dzien != "sob" & s$godzina %in% 10:11
L_spokoj <- sum(s$grupy_szac[spokoj]) / sum(s$obsada[spokoj])      # obciążenie w godzinach spokojnych
nd <- s[szczyt, ]; nd$obciazenie <- nd$obciazenie * L_spokoj / (sum(nd$grupy_szac) / sum(nd$obsada))
konw_n <- function(p, w) sum(p * w) / sum(w)           # konwersja ważona liczbą grup
round(c(szczyt = sum(s$paragony[szczyt]) / sum(s$n[szczyt]), spokoj = sum(s$paragony[spokoj]) / sum(s$n[spokoj]),
        szczyt_model = konw_n(predict(m1, s[szczyt, ], type = "response"), s$n[szczyt]),
        szczyt_przy_obciazeniu_spokoju = konw_n(predict(m1, nd, type = "response"), nd$n),
        obciazenie_szczyt = sum(nd$grupy_szac) / sum(nd$obsada), obciazenie_spokoj = L_spokoj), 3)
# Ta sama zmiana w prawdziwym procesie (znanym z symulacji)
skala <- L_spokoj / (sum(nd$grupy_szac) / sum(nd$obsada)); pb <- plogis(d$logit_zakupu[szczyt]); w <- d$grupy[szczyt]
round(c(prawda_szczyt = konw_n(p_rozmowy(d$obciazenie_prawdziwe[szczyt]) * pb, w),
        prawda_przy_obciazeniu_spokoju = konw_n(p_rozmowy(d$obciazenie_prawdziwe[szczyt] * skala) * pb, w)), 3)

p4a <- ggplot(naiw, aes(factor(obsada), konwersja)) + geom_col(fill = "grey55", width = 0.7) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * konwersja)), vjust = -0.4, size = 3.8) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0, 0.26)) +
  labs(title = "A. Naiwnie: konwersja wg obsady", x = "Osoby obsługi w godzinie", y = "Konwersja") + motyw
p4b <- ggplot(k1, aes(L, est)) +
  geom_ribbon(aes(ymin = dol, ymax = gora), fill = kol[["Model z kontrolą"]], alpha = 0.2) +
  geom_line(aes(colour = "Model z kontrolą"), linewidth = 1.1) +
  geom_line(data = data.frame(L = siatka, est = prawda), aes(colour = "Prawda (symulacja)"),
            linetype = "dashed", linewidth = 0.9) +
  scale_colour_manual(values = kol, name = NULL, breaks = c("Model z kontrolą", "Prawda (symulacja)")) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%")) +
  labs(title = "B. Model: konwersja a obciążenie obsługi", x = "Grupy klientów na osobę obsługi w godzinie",
       y = "Przewidywana konwersja (średnio)") + motyw
p4 <- (p4a | p4b) + plot_layout(widths = c(1, 1.8))
p4   # zapis: ggsave("ruch-w-sklepie-obsada-model.svg", p4, width = 10, height = 5.6)
Wynik w R
 obsada paragony      n konwersja
      1     7385  43458      17.0
      2    19700 100080      19.7
      3     9832  56102      17.5
      4     3910  31408      12.4
      5      265   1801      14.7
                    edf    Ref.df   Chi.sq p-value
s(obciazenie)  5.379117  6.113385 3482.328       0
s(salon)      28.599754 29.000000 2360.576       0
 L model  dol gora prawda
 1  24.8 24.3 25.2   24.0
 2  22.6 22.3 23.0   23.3
 3  20.6 20.3 20.9   21.9
 4  17.8 17.5 18.1   19.4
 5  14.6 14.3 15.0   16.1
 6  11.9 11.5 12.3   12.2
spadek_od_2_do_5_model          spadek_prawda
                   8.0                    7.3
                        szczyt                         spokoj                   szczyt_model
                         0.111                          0.219                          0.111
szczyt_przy_obciazeniu_spokoju              obciazenie_szczyt              obciazenie_spokoj
                         0.132                          2.989                          2.028
                 prawda_szczyt prawda_przy_obciazeniu_spokoju
                         0.111                          0.130
6. Utracone transakcje w godzinach z za małą obsadą: Rysunek 5
R
# Przepis 6. Godziny z za małą obsadą: ile transakcji przyniosłaby jedna osoba więcej? Rysunek 5
prog <- 4                                            # „za mała obsada”: ponad 4 grupy klientów na osobę w godzinie
za_malo <- s$obciazenie > prog & s$obsada < 5
nd <- s[za_malo, ]; nd1 <- nd; nd1$obsada <- nd$obsada + 1
nd1$obciazenie <- nd$grupy_szac / nd1$obsada         # ten sam ruch, jedna osoba obsługi więcej
X0 <- predict(m1, nd, type = "lpmatrix"); X1 <- predict(m1, nd1, type = "lpmatrix")
set.seed(7332)
bety <- MASS::mvrnorm(1000, coef(m1), vcov(m1))      # 1000 losowań współczynników modelu
dodatkowe <- function(b) nd$n * (plogis(X1 %*% b) - plogis(X0 %*% b))   # dodatkowe paragony w każdej godzinie
est <- as.vector(dodatkowe(coef(m1)))
los <- apply(bety, 1, function(b) sum(dodatkowe(b)))
# Prawda z symulacji: te same godziny, prawdziwe grupy i prawdziwe szanse
dz <- d[za_malo, ]
prawda_dod <- sum(dz$grupy * (p_rozmowy(dz$grupy / (dz$obsada + 1)) - p_rozmowy(dz$obciazenie_prawdziwe)) *
                  plogis(dz$logit_zakupu))
miesiace <- 6
wartosc_paragonu <- 690                              # średnia wartość paragonu w zł (ustalona ręcznie)
round(c(godzin_za_malo = sum(za_malo), odsetek_godzin = mean(za_malo), dodatkowe_paragony = sum(est),
        ci_dol = quantile(los, 0.025, names = FALSE), ci_gora = quantile(los, 0.975, names = FALSE),
        prawda = prawda_dod, na_godzine_pracy = sum(est) / sum(za_malo),
        na_salon_miesiecznie = sum(est) / 30 / miesiace,
        przychod_na_godzine_pracy_zl = wartosc_paragonu * sum(est) / sum(za_malo)), 3)

# Podział na godziny dnia z przedziałami
godz_tab <- do.call(rbind, lapply(sort(unique(nd$godzina)), function(h) {
  i <- nd$godzina == h
  l <- apply(bety, 1, function(b) sum(nd$n[i] * (plogis(X1[i, ] %*% b) - plogis(X0[i, ] %*% b))))
  data.frame(godzina = h, godzin = sum(i), dodatkowe = sum(est[i]),
             dol = quantile(l, 0.025, names = FALSE), gora = quantile(l, 0.975, names = FALSE),
             sobota = sum(nd$dzien[i] == "sob"))
}))
print(transform(godz_tab, dodatkowe = round(dodatkowe, 1), dol = round(dol, 1), gora = round(gora, 1)),
      row.names = FALSE)
c(godzin_sobota = sum(godz_tab$sobota), godzin_pon_pt = sum(godz_tab$godzin) - sum(godz_tab$sobota))

p5 <- ggplot(godz_tab, aes(factor(godzina), dodatkowe)) +
  geom_col(fill = "#0072B2", alpha = 0.85, width = 0.7) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0.25, colour = "grey15") +
  geom_text(aes(y = gora, label = paste0(godzin, " h")), vjust = -0.6, size = 3.5, colour = "grey25") +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(title = "Dodatkowe paragony przy +1 osobie obsługi (godziny z obciążeniem > 4)",
       subtitle = "Suma za pół roku w 30 salonach; wąsy – 95% przedział; nad słupkiem – liczba takich godzin",
       x = "Godzina (początek)", y = "Dodatkowe paragony") + motyw
p5   # zapis: ggsave("ruch-w-sklepie-utracone-transakcje.svg", p5, width = 10, height = 5.4)
Wynik w R
              godzin_za_malo               odsetek_godzin           dodatkowe_paragony                       ci_dol
                    7665.000                        0.164                     4181.915                     4034.859
                     ci_gora                       prawda             na_godzine_pracy         na_salon_miesiecznie
                    4338.641                     3879.240                        0.546                       23.233
przychod_na_godzine_pracy_zl
                     376.454
 godzina godzin dodatkowe   dol  gora sobota
      10    547     271.4 259.5 284.7    117
      11    660     379.7 363.3 397.1    134
      12    722     348.8 333.3 365.7    148
      13   1055     589.5 568.3 614.7    230
      14   1049     578.3 556.6 601.1    227
      15    697     354.7 339.4 372.3    165
      16    763     410.5 391.9 430.3    142
      17    716     424.8 405.5 445.1    111
      18    763     453.7 433.7 475.0    124
      19    693     370.5 354.9 385.9    100
godzin_sobota godzin_pon_pt
         1498          6167
7. Grafika: karta „wejścia → rozmowy → zakup”: Rysunek 6
R
# Przepis 7. Grafika: karta „wejścia → rozmowy → zakup” z liczbami całej sieci: Rysunek 6
# Korzysta z s (przepis 2) i przejscia_na_osobe, grupy_na_osobe (przepis 2).
fmt <- function(x) formatC(round(x), format = "d", big.mark = " ")
pr <- function(x) sprintf("%.1f%%", 100 * x)
tot <- c(licznik = sum(s$licznik), personel = przejscia_na_osobe * sum(s$obsada), grupy = sum(s$grupy_szac),
         rozmowy = sum(s$rozmowy), paragony = sum(s$paragony))
klasa <- cut(s$obciazenie, c(-Inf, 2, 4, Inf), labels = c("do 2", "2–4", "ponad 4"))
rozm_kl <- tapply(s$rozmowy, klasa, sum) / tapply(s$grupy_szac, klasa, sum)    # rozmowy na grupę
zak_kl <- tapply(s$paragony, klasa, sum) / tapply(s$rozmowy, klasa, sum)       # zakupy na rozmowę
round(c(tot, rozmowy_na_grupe = tot[["rozmowy"]] / tot[["grupy"]],
        zakup_na_rozmowe = tot[["paragony"]] / tot[["rozmowy"]]), 3)
round(rbind(rozmowy_na_grupe = rozm_kl, zakupy_na_rozmowe = zak_kl), 3)

karty <- data.frame(x = 0:3, y = 1,
  naglowek = c("1. Licznik wejść", "2. Grupy klientów", "3. Rozmowy z doradcą", "4. Zakup (paragon)"),
  tresc = c(sprintf("%s przejść\nw tym ok. %s\nprzejść personelu\nkażda osoba liczona osobno", fmt(tot[["licznik"]]),
                    fmt(tot[["personel"]])),
            sprintf("%s grup (po korekcie)\n− przejścia personelu\n× grupy/osoby: %.2f (pon–pt),\n%.2f (sob)",
                    fmt(tot[["grupy"]]), grupy_na_osobe[["FALSE"]], grupy_na_osobe[["TRUE"]]),
            sprintf("%s rozmów\n= %s grup\n\ngdy na osobę obsługi\nprzypada do 2 grup: %s\nponad 4 grupy: %s", fmt(tot[["rozmowy"]]),
                    pr(tot[["rozmowy"]] / tot[["grupy"]]), pr(rozm_kl[[1]]), pr(rozm_kl[[3]])),
            sprintf("%s paragonów\n= %s rozmów\n= %s grup (konwersja)\nsurowo: %s licznika", fmt(tot[["paragony"]]),
                    pr(tot[["paragony"]] / tot[["rozmowy"]]), pr(tot[["paragony"]] / tot[["grupy"]]),
                    pr(tot[["paragony"]] / tot[["licznik"]]))))
strzalki <- data.frame(x = 0:2 + 0.44, xend = 1:3 - 0.44, y = 1, yend = 1)
p6 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.44, xmax = x + 0.44, ymin = y - 0.5, ymax = y + 0.5),
            fill = c("#FDF1E9", "#F2F7FB", "#F2F7FB", "#F2F7FB"), colour = c("#D55E00", "#0072B2", "#0072B2", "#0072B2"),
            linewidth = 0.8) +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend),
               arrow = arrow(length = unit(0.22, "cm"), type = "closed"), colour = "grey30") +
  geom_text(aes(x = x - 0.4, y = y + 0.42, label = naglowek), hjust = 0, vjust = 1, fontface = "bold",
            size = 4.1, colour = "#0f1d3a") +
  geom_text(aes(x = x - 0.4, y = y + 0.22, label = minus(tresc)), hjust = 0, vjust = 1, size = 3.6,
            lineheight = 1.05, colour = "grey15") +
  annotate("text", x = -0.44, y = 0.36, hjust = 0, vjust = 1, size = 3.7, colour = "grey20", lineheight = 1.05,
           label = paste0("Obsada działa na krok 2 → 3: przy przeciążeniu mniej klientów trafia do doradcy.\n",
                          "Krok 3 → 4 zależy głównie od klientów: zakupy na rozmowę ", pr(zak_kl[[1]]), ", ",
                          pr(zak_kl[[2]]), " i ", pr(zak_kl[[3]]), " przy obciążeniu do 2, 2–4 i ponad 4.")) +
  coord_cartesian(xlim = c(-0.48, 3.48), ylim = c(0.12, 1.55), expand = FALSE) +
  labs(title = "Od wejścia do zakupu: 30 salonów optycznych, pół roku", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("ruch-w-sklepie-karta-lejek.svg", p6, width = 10, height = 5.2)
Wynik w R
         licznik         personel            grupy          rozmowy         paragony rozmowy_na_grupe zakup_na_rozmowe
      391542.000        55558.677       226052.507       150116.000        41092.000            0.664            0.274
                   do 2   2–4 ponad 4
rozmowy_na_grupe  0.938 0.712   0.436
zakupy_na_rozmowe 0.283 0.274   0.260
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("licznik surowy – po korekcie" = c("#E69F00", "#0072B2"),
             "po korekcie – prawda" = c("#0072B2", "#000000"),
             "granice 95% – granice 99.8%" = c("grey20", "#D55E00"),
             "karta: pomarańczowa – niebieska ramka" = c("#D55E00", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                      widzenie_typowe deuteranopia protanopia
licznik surowy – po korekcie                    120.2        121.5      109.3
po korekcie – prawda                             61.9         62.8       62.4
granice 95% – granice 99.8%                      83.4         72.7       59.9
karta: pomarańczowa – niebieska ramka           114.6        108.3       91.9
czerwony – zielony (do unikania)                121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, agregacje i granice z rozkładu dwumianowego (qbinom) – pakiet stats i funkcje podstawowej instalacji R. Model addytywny dopasowano pakietem mgcv (funkcja bam), współczynniki losowano funkcją mvrnorm z pakietu MASS. Rysunki wykonano w pakiecie ggplot2 (mapy ciepła ze skalą viridis z pakietu viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mgcv (wersja 1.9-4): Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, A. P., Sciaini, M., & Scherer, C. (2023). viridisLite: Colorblind-friendly color maps (lite version) [R package]. https://doi.org/10.32614/CRAN.package.viridisLite
- colorspace (wersja 2.1-2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Licznik liczy personel i dzieci. Bez kalibracji konwersja jest prawie dwa razy zaniżona, najbardziej w sobotę.
- Grupa to jedna transakcja. Gdy zmienia się skład klientów (wakacje, przed rokiem szkolnym), zmienia się też poprawny mianownik.
- Obsada planowana pod ruch. Naiwne porównanie odwraca zależność; kontroluj porę dnia, a najlepiej losuj dodatkową obsadę.
- Ten sam błąd w liczniku i mianowniku. Krzywa wyszła nieco zbyt stroma, a utracone transakcje – zawyżone o ok. 8%.
- Średnia z odsetków godzinowych daje 20.9% zamiast 17.6%. Sumuj paragony i grupy albo modeluj liczby.
Najczęstsze pytania
Jak policzyć konwersję w sklepie stacjonarnym?
Podziel liczbę paragonów przez liczbę wejść w tym samym okresie, najlepiej dla każdej godziny, a potem sumuj paragony i wejścia dla dłuższych okresów. Licznik wejść zawyża mianownik (personel, dzieci, rodziny), więc skoryguj go na podstawie krótkiego badania kalibracyjnego. W przykładzie konwersja z surowego licznika wynosiła 10.5%, a po korekcie 18.2%.
Dlaczego konwersja spada, gdy w sklepie jest tłoczno?
Z dwóch powodów naraz: w szczycie przychodzi więcej osób, które tylko oglądają, i na jednego sprzedawcę przypada więcej klientów. Rozdziela je model z porą dnia (dzień × godzina) i obciążeniem obsługi. W przykładzie obsada wyjaśniła ok. 2 z 11 punktów różnicy między sobotnim szczytem a porankiem dni roboczych (Perdikaki i in., 2012, opisali spadek konwersji z ruchem w sieci odzieżowej).
Czy można oceniać konwersję pojedynczych godzin albo dni?
Ostrożnie. Przy 2–3 wejściach konwersja może wynieść tylko 0%, 33–50% albo 100% – w przykładzie 57.0% takich godzin miało konwersję 0%. Godziny lub salony porównuj na wykresie lejkowym z granicami z rozkładu dwumianowego, a do raportów sumuj paragony i wejścia zamiast uśredniać odsetki.
Jak sprawdzić, czy więcej sprzedawców zwiększa sprzedaż?
Nie porównuj konwersji według liczby osób na zmianie – obsadę planuje się pod ruch, więc najwięcej osób pracuje, gdy przychodzi najwięcej oglądających (w przykładzie przy 4 osobach konwersja była najniższa, 12.4%). Użyj modelu z obciążeniem (klienci na osobę obsługi), porą dnia i efektem sklepu, a wynik potwierdź eksperymentem z losowym przydziałem dodatkowej osoby.
Jak oszacować sprzedaż traconą przez za małą obsadę?
Wybierz godziny z dużym obciążeniem (w przykładzie ponad 4 grupy na osobę, 16.4% godzin), przewidź z modelu konwersję przy obecnej obsadzie i przy jednej osobie więcej i zsumuj różnice pomnożone przez liczbę klientów. Podaj przedział (tu 4182 paragony, 95% CI [4035, 4339]) i pamiętaj, że błąd pomiaru licznika może wynik zawyżać – w symulacji o ok. 8%.
Powiązane hasła
Przeczytaj też
Lejek konwersji – etapy i test A/B
Sklep zoologiczny i nowy koszyk: odsetki od początku i warunkowe, przedziały Wilsona i Newcombe’a, liczebność i symulacja 1000 testów z kodem R.
Czytaj →PoradnikObsada infolinii – Erlang C i symulacja
Infolinia dostawcy energii: test Poissona, czas rozmowy, Erlang C ręcznie, symulacja kolejki z rozłączeniami i grafik w kwadransach – sześć rysunków z kodem R.
Czytaj →PoradnikNieliniowe zależności: splajny i GAM
Podział na grupy, parabola, splajn i GAM na jednym zbiorze: edf, REML, wybór k, diagnostyka, wykres krzywej i wzór opisu w R.
Czytaj →Analizujesz ruch i sprzedaż w sklepach albo piszesz o tym pracę?
Pomożemy oczyścić dane z licznika wejść, dobrać model konwersji z efektem sklepu, oddzielić skutek obsady od pory dnia i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Chuang, H. H.-C., Oliva, R., & Perdikaki, O. (2016). Traffic-based labor planning in retail stores. Production and Operations Management, 25(1), 96–113. https://doi.org/10.1111/poms.12403 ● Otwarty dostęp: pełny tekst
- Mani, V., Kesavan, S., & Swaminathan, J. M. (2015). Estimating the impact of understaffing on sales and profitability in retail stores. Production and Operations Management, 24(2), 201–218. https://doi.org/10.1111/poms.12237 ● Otwarty dostęp: pełny tekst
- Marra, G., & Wood, S. N. (2012). Coverage properties of confidence intervals for generalized additive model components. Scandinavian Journal of Statistics, 39(1), 53–74. https://doi.org/10.1111/j.1467-9469.2011.00760.x ● Otwarty dostęp: pełny tekst
- Perdikaki, O., Kesavan, S., & Swaminathan, J. M. (2012). Effect of traffic on sales and conversion rates of retail stores. Manufacturing & Service Operations Management, 14(1), 145–162. https://doi.org/10.1287/msom.1110.0356
- Spiegelhalter, D. J. (2005). Funnel plots for comparing institutional performance. Statistics in Medicine, 24(8), 1185–1202. https://doi.org/10.1002/sim.1970
- Wood, S. N. (2017). Generalized additive models: An introduction with R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781315370279
Cytowania BibTeX
@article{chuang2016traffic, author={Chuang, Howard Hao-Chun and Oliva, Rogelio and Perdikaki, Olga}, title={{Traffic-based labor planning in retail stores}}, journal={Production and Operations Management}, year={2016}, volume={25}, number={1}, pages={96--113}, doi={10.1111/poms.12403}}@article{mani2015estimating, author={Mani, Vidya and Kesavan, Saravanan and Swaminathan, Jayashankar M.}, title={{Estimating the impact of understaffing on sales and profitability in retail stores}}, journal={Production and Operations Management}, year={2015}, volume={24}, number={2}, pages={201--218}, doi={10.1111/poms.12237}}@article{marra2012coverage, author={Marra, Giampiero and Wood, Simon N.}, title={{Coverage properties of confidence intervals for generalized additive model components}}, journal={Scandinavian Journal of Statistics}, year={2012}, volume={39}, number={1}, pages={53--74}, doi={10.1111/j.1467-9469.2011.00760.x}}@article{perdikaki2012effect, author={Perdikaki, Olga and Kesavan, Saravanan and Swaminathan, Jayashankar M.}, title={{Effect of traffic on sales and conversion rates of retail stores}}, journal={Manufacturing \& Service Operations Management}, year={2012}, volume={14}, number={1}, pages={145--162}, doi={10.1287/msom.1110.0356}}@article{spiegelhalter2005funnel, author={Spiegelhalter, David J.}, title={{Funnel plots for comparing institutional performance}}, journal={Statistics in Medicine}, year={2005}, volume={24}, number={8}, pages={1185--1202}, doi={10.1002/sim.1970}}@book{wood2017generalized, author={Wood, Simon N.}, title={{Generalized additive models: An introduction with R (2nd ed.)}}, year={2017}, publisher={Chapman and Hall/CRC}, doi={10.1201/9781315370279}}