Przykład: 36 sklepów i nowa ekspozycja przy kasie
Fikcyjna sieć sklepów z artykułami do domu i dekoracjami ma 36 sklepów stacjonarnych. Dział handlowy przygotował nową ekspozycję przy kasie: niski regał ze świecami, podkładkami i drobnymi dekoracjami do 30 zł. Pytanie zarządu: o ile nowa ekspozycja podnosi średnią wartość paragonu i czy warto ją wprowadzić we wszystkich sklepach?
Test trwał 4 tygodnie. Mamy obroty i średni paragon każdego sklepu z 8 tygodni przed testem oraz losową próbkę 20% paragonów z czasu testu: 20 549 paragonów, od 313 do 768 na sklep, średnio 95.65 zł (SD = 57.54 zł).
Dane są fikcyjne i znamy prawdę: ekspozycja podnosi paragon o 4 zł. Parametry ustawiliśmy ręcznie (lista przy kodzie). Po pierwszym uruchomieniu zmieniliśmy dwie rzeczy. Wzór obrotów sprzed testu zamieniliśmy z liniowego na logarytmiczny, bo dawał sklep z obrotami 4.1 tys. zł tygodniowo. Próbkę paragonów zwiększyliśmy z 5% do 20% (w symulacjach mocy odpowiednio z 143 do 570 paragonów na sklep): przy 5% błąd średniej sklepu zasłaniał różnice między sklepami, a cała sieć i tak ma komplet paragonów. Ziarna 720 nie zmienialiśmy. Dane pobierzesz jako eksperyment-w-sklepach-sklepy.csv (36 sklepów) i eksperyment-w-sklepach-paragony.csv (paragony).
Dlaczego losujemy sklepy, a nie klientów? Regał stoi przy kasie i widzi go każdy klient sklepu, więc nie da się pokazać go co drugiemu. Jednostką losowania jest sklep – to randomizacja klastrowa, ta sama logika co w geo-eksperymencie w regionach. Tamten wpis dotyczy tygodniowej sprzedaży regionów; tu pracujemy na paragonach, czyli na danych dwupoziomowych: paragony w sklepach. O efekcie promocji w danych obserwacyjnych z sieci sklepów piszemy we wpisie o promocjach i modelu mieszanym; tutaj sklep dostaje ekspozycję losowo.
Rysunek 1: losowanie sklepów w parach
Sklepy bardzo różnią się wielkością: najmniejszy miał przed testem 28.4 tys. zł obrotów tygodniowo, największy 101.0 tys. zł. Przy prostym losowaniu 18 z 36 sklepów może się zdarzyć, że duże sklepy trafią głównie do jednej grupy. Dlatego sklepy dobieramy w pary: sortujemy je według obrotów sprzed testu, łączymy kolejne dwa w parę i w każdej parze rzutem monetą wybieramy sklep z nową ekspozycją. To randomizacja blokowa z blokami po dwa.
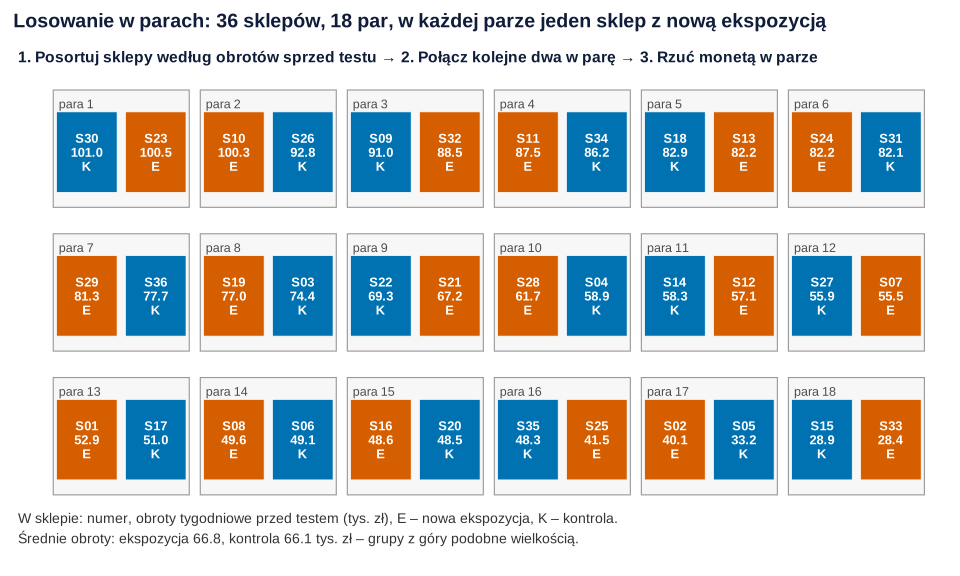
set.seed(720)).Co widać. W parze 1 są dwa największe sklepy (101.0 i 100.5 tys. zł), w parze 18 – dwa najmniejsze. Średnie obroty grup są prawie równe: 66.8 tys. zł w sklepach z ekspozycją i 66.1 w kontrolnych. Przy 36 sklepach takiej równowagi nie zapewni samo prawo wielkich liczb.
Jak może zmylić. Para podobna obrotami nie musi być podobna klientelą – pary nie wyrównają wszystkiego. W analizie trzeba je uwzględnić (różnice w parach albo para jako czynnik).
Podpis do pracy:
Rysunek 2: ile naprawdę mamy obserwacji – ICC i efekt schematu
Paragony z jednego sklepu są do siebie podobne: ta sama okolica, ci sami klienci, ten sam układ sklepu. Miarą tego podobieństwa jest ICC (korelacja wewnątrzklasowa) – udział różnic między sklepami w całej zmienności paragonów. W modelu pustym (lme4, losowy wyraz wolny sklepu) odchylenie standardowe sklepów wynosi 11.96 zł, paragonów w sklepie 56.42 zł, a ICC = .043.
To mała liczba, ale mnoży się przez liczbę paragonów w sklepie. Efekt schematu (design effect) mówi, ile razy wariancja wyniku jest większa niż przy niezależnych paragonach:
m to średnia liczba paragonów na sklep. Sklepy mają nierówną liczbę paragonów (współczynnik zmienności 0.233), co według Eldridge i in. (2006) dodatkowo zmniejsza moc; ich poprawka daje DEFF = 26.82. 20 549 paragonów niesie tyle informacji co ok. 766 niezależnych. Killip i in. (2004) podkreślają wniosek praktyczny: moc podnosi przede wszystkim liczba klastrów, a nie liczba osób w klastrze.
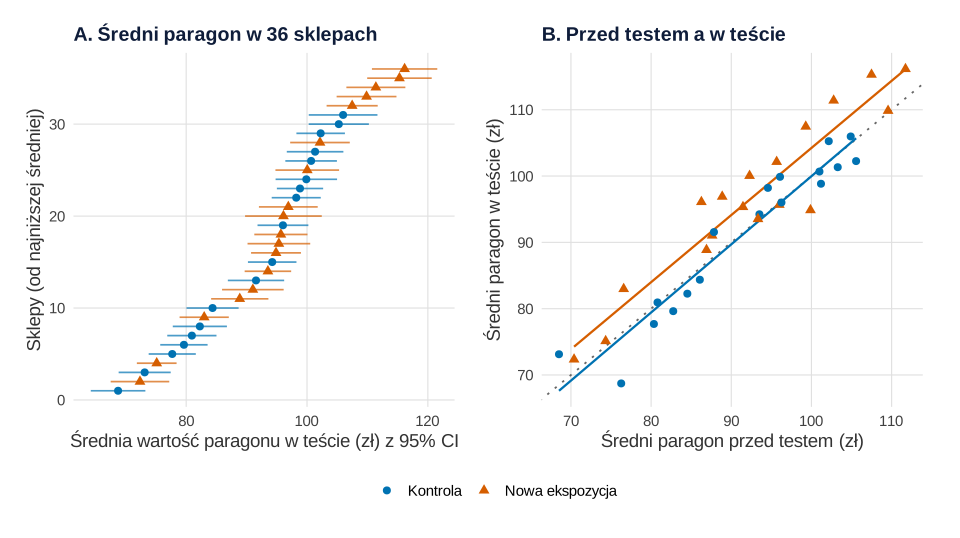
set.seed(720)).Co widać. Średnie sklepów rozciągają się od 68.73 do 116.15 zł, a różnica, której szukamy, to 4 zł. Przedziały pojedynczych sklepów są wąskie – kilkaset paragonów dobrze opisuje sklep – ale to sklepy różnią się między sobą. Panel B pokazuje ratunek: średni paragon sprzed testu przewiduje średnią w teście z korelacją r = .939.
Jak może zmylić. ICC z jednego testu jest niepewny – przy 36 sklepach ma szeroki przedział. Planując następny test, sprawdź kilka wartości ICC (Rysunek 4).
Zdanie do Wyników:
Rysunek 3: ten sam test, siedem analiz
Te same dane policzyliśmy siedmioma sposobami. Pierwszy traktuje 20 549 paragonów jak niezależne obserwacje – to pseudoreplikacja: Hurlbert (1984) opisał ją jako testowanie efektu z niewłaściwym członem błędu, gdy powtórzenia nie są niezależne. Pozostałe uwzględniają sklepy: błędy odporne na klastrowanie (CR2), model mieszany z losowym wyrazem wolnym sklepu, test t na średnich sklepów, test t dla par oraz dwie analizy z parą i średnim paragonem sprzed testu.
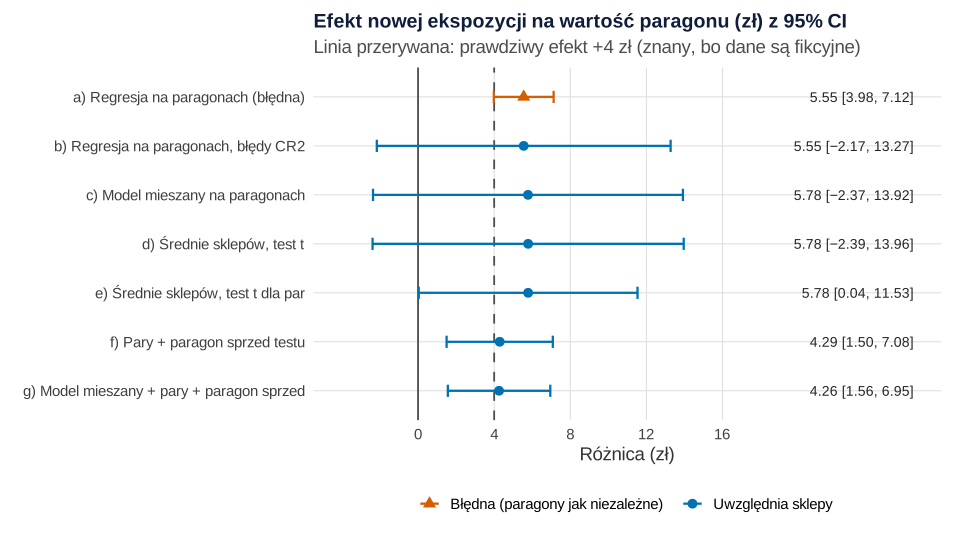
set.seed(720)).Co widać. Regresja na paragonach daje 5.55 zł, 95% CI [3.98, 7.12], p < .001 – wynik pewny jak skała. To złudzenie: błąd standardowy 0.80 zamiast ok. 4 zł. Trzy analizy, które uwzględniają tylko sklepy, mają przedziały od ok. −2.4 do 14 zł i p ≈ .15–.16 – przy 36 sklepach i prostym porównaniu różnicy 4 zł nie widać. Pary zawężają przedział do [0.04, 11.53] (p = .049). Dopiero pary z paragonem sprzed testu dają 4.29 zł, 95% CI [1.50, 7.08], p = .005, a model mieszany z tymi samymi zmiennymi – 4.26 zł [1.56, 6.95], p = .004.
Jak może zmylić. Wąski przedział z analizy (a) nie jest „bardziej precyzyjny”, tylko błędny. W przykładzie przypadkiem obejmuje on prawdziwe 4 zł, ale w symulacji (Rysunek 6) taka analiza alarmuje w 72% testów bez żadnego efektu. Liczba stopni swobody w analizach poprawnych (16–34) to ślad liczby sklepów, nie paragonów – modele mieszane liczą je metodą Satterthwaite’a.
Zdanie do Wyników:
Rysunek 4: moc według liczby sklepów i ICC
Ile sklepów trzeba, żeby wykryć +4 zł? Odpowiedź daje symulacyjna analiza mocy: losujemy sieć sklepów 1000 razy dla każdej liczby sklepów (20–40) i trzech wartości ICC (.01, .025, .05), za każdym razem przeprowadzamy test i liczymy, jak często p < .05. Porównujemy cztery schematy: losowanie proste lub w parach, bez kowariantu albo z paragonem sprzed testu (ANCOVA). Błąd Monte Carlo każdego odsetka nie przekracza 1.6 punktu procentowego.
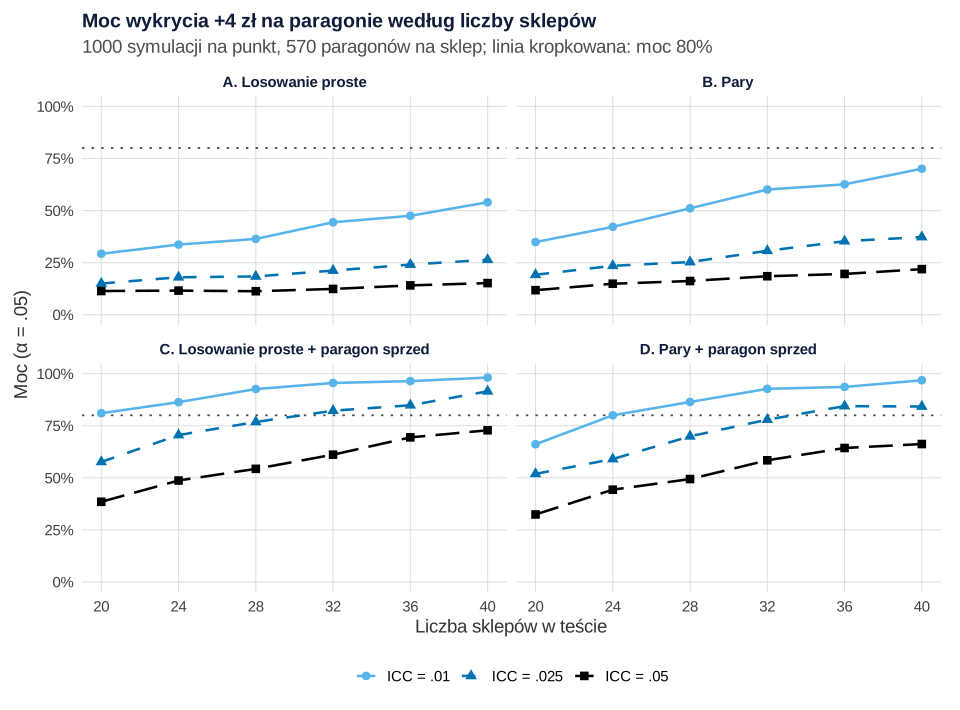
set.seed(7201)).Co widać. Bez kowariantu (panele A i B) nawet 40 sklepów nie wystarcza: przy ICC = .025 moc wynosi 26.4% przy losowaniu prostym i 37.3% w parach. Pary pomagają, ale mało. Ogromną różnicę robi paragon sprzed testu: przy 36 sklepach i ICC = .025 moc rośnie z 24.1% do 84.8%. Przy ICC = .05 nawet z kowariantem 40 sklepów daje 72.8% – sieć musiałaby testować dłużej albo szukać większego efektu.
Jak może zmylić. Kowariant pomaga tak bardzo, bo poziom sklepu prawie się nie zmienia: w symulacji 90% różnic między sklepami jest trwałe. Gdy sklepy zmieniają się szybciej (remont, nowa konkurencja), zysk będzie mniejszy. Ten sam mechanizm wykorzystuje CUPED w testach A/B.
Zdanie do Metody:
Rysunek 5: pary czy kowariant – zysk precyzji
Teraz przy stałych 36 sklepach i ICC = .05 (bliskim wartości z przykładu) powtarzamy test 2000 razy i patrzymy, jak rozrzucone są oszacowania efektu w czterech schematach.
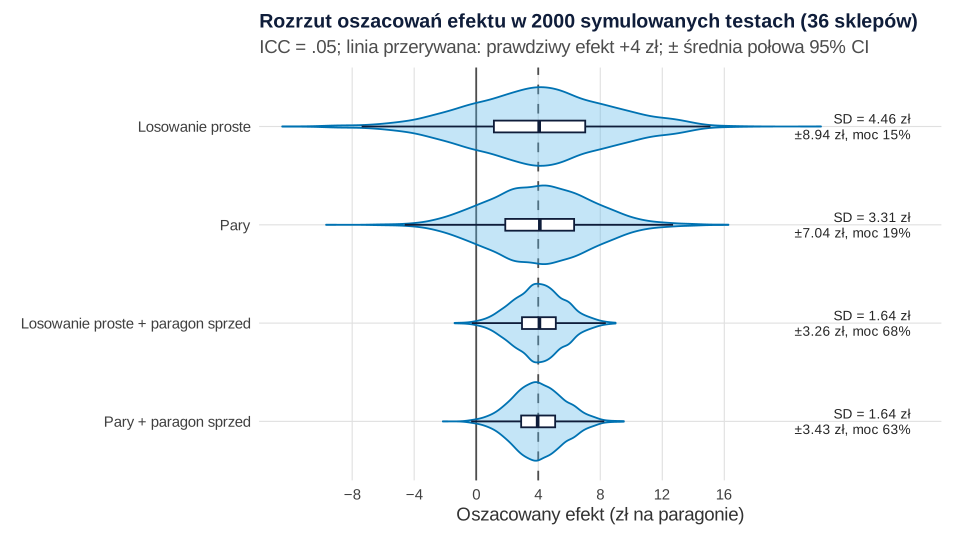
set.seed(7202)).Co widać. Wszystkie cztery schematy są nieobciążone: średnie oszacowania to 4.01–4.08 zł, a pokrycie 95% przedziałów wynosi 94.6–95.7% (błąd Monte Carlo 0.5 punktu procentowego). Różni je precyzja. Pary zmniejszają SD oszacowań z 4.46 do 3.31 zł; kowariant – do 1.64 zł. Gdy kowariant jest w modelu, pary już nic nie dodają (±3.43 wobec ±3.26 zł, bo para zabiera stopnie swobody).
Jak może zmylić. To nie znaczy, że pary są zbędne. Imai i in. (2009) argumentują, że w eksperymentach z losowaniem klastrów dobór w pary warto stosować wszędzie, gdzie to możliwe – ze względu na obciążenie, efektywność, moc, odporność i koszty. Pary chronią też przed pechowym losowaniem i są prostym planem, gdy dobrego kowariantu nie ma. W randomizowanym teście ANCOVA ma większą moc niż analiza samej zmiany (Van Breukelen, 2006), więc paragon sprzed testu wstaw do modelu tak czy inaczej.
Rysunek 6: fałszywe alarmy i mała liczba sklepów
Ostatnia symulacja: ekspozycja nie działa wcale (efekt 0), a my 2000 razy przeprowadzamy test w 20 albo 36 sklepach (ICC = .05). Ile testów da p < .05? Poprawna analiza powinna dać ok. 5%.
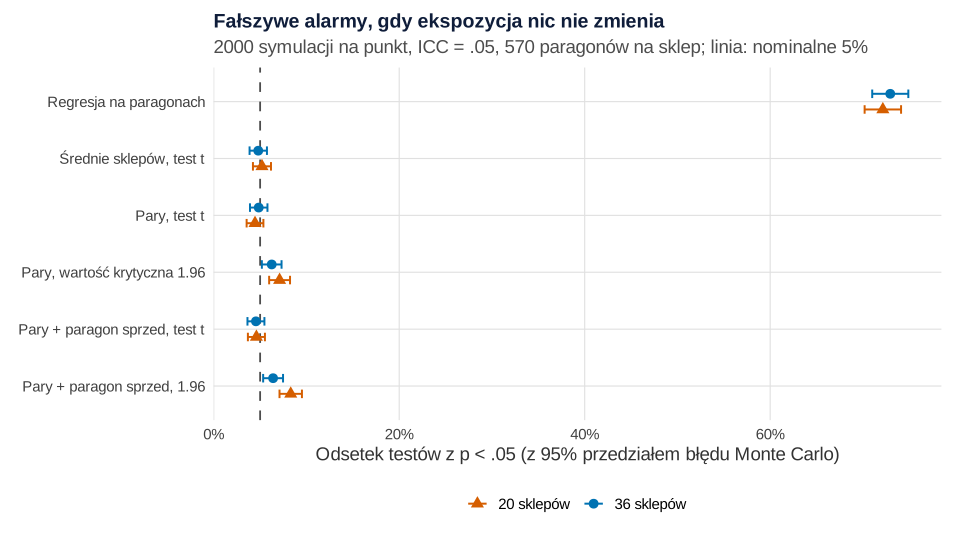
set.seed(7203)).Co widać. Regresja na paragonach daje fałszywy alarm w 72.2% testów przy 20 sklepach i w 73.0% przy 36 – zamiast w 5%. Domyślne błędy standardowe przy danych w klastrach zawyżają precyzję (Cameron i Miller, 2015). Analizy na sklepach z rozkładem t trzymają się 4.4–5.2%. Druga pułapka jest subtelniejsza: gdy przy 10 parach (20 sklepów) użyjesz wartości krytycznej 1.96 z rozkładu normalnego zamiast t z 9 lub 8 stopniami swobody, fałszywych alarmów jest 7.1–8.3%.
Jak może zmylić. Symulacja zakłada równą liczbę paragonów w sklepach i rozkład normalny paragonów. Leyrat i in. (2018) w szerszych symulacjach pokazali, że przy najwyżej 40 klastrach błąd I rodzaju trzymają analizy na poziomie klastrów i modele mieszane z poprawką stopni swobody, a metody bez poprawek go zawyżają.
Zdanie do Metody:
Co z tym zrobić w firmie
- Licz sklepy, nie paragony. 20 549 paragonów to ok. 766 niezależnych obserwacji, a o mocy decyduje 36 sklepów. Więcej paragonów z tych samych sklepów prawie nic nie da.
- Zbierz dane sprzed testu. Średni paragon z 8 tygodni przed testem podniósł moc przy 36 sklepach z 24.1% do 84.8% (ICC = .025). To najtańszy sposób na mniejszy test.
- Losuj w parach podobnych wielkością. Pary wyrównują grupy i chronią przed pechowym losowaniem. Zapisz pary przed losowaniem.
- Zaplanuj liczbę sklepów symulacją dla kilku wartości ICC. Jeśli wychodzi więcej sklepów, niż sieć ma, wydłuż test albo zmień pytanie.
- Raportuj przedział, nie tylko p. Wynik 4.29 zł [1.50, 7.08] mówi zarządowi, że ekspozycja raczej się opłaca, jeśli zysk z 1.50 zł na paragonie pokrywa koszt regału.
- Sprawdź metryki ochronne, np. czas obsługi przy kasie – zob. metryki ochronne w teście A/B.
Jak opisać w pracy
Podaj liczbę sklepów i paragonów, sposób losowania, ICC, analizę na właściwym poziomie i efekt z przedziałem. Ogólne wskazówki znajdziesz we wpisie statystyka w pracy z marketingu.
| Analiza | Efekt (zł) | SE | t | df | 95% CI | p |
|---|---|---|---|---|---|---|
| Regresja na paragonach (błędna) | 5.55 | 0.80 | 6.92 | 20 547 | [3.98, 7.12] | < .001 |
| Model mieszany na paragonach | 5.78 | 4.01 | 1.44 | 33.7 | [−2.37, 13.92] | .159 |
| Średnie sklepów, test t dla par | 5.78 | 2.72 | 2.12 | 17 | [0.04, 11.53] | .049 |
| Pary + paragon sprzed testu | 4.29 | 1.32 | 3.26 | 16 | [1.50, 7.08] | .005 |
| Model mieszany + pary + paragon sprzed | 4.26 | 1.26 | 3.37 | 15.0 | [1.56, 6.95] | .004 |
Kod R: dane, ICC, siedem analiz i symulacje mocy
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), a przepis 5 – funkcje symulacji używane w przepisach 6 i 7. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(720)), 5 (set.seed(7201)), 6 (set.seed(7202)) i 7 (set.seed(7203)); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 36 sklepów, średni paragon 95 zł, efekt ekspozycji +4 zł, różnice sklepów związane z wielkością (SD 6.5 zł) i pozostałe trwałe (SD 6.2 zł), zmianę poziomu sklepu między okresem przed testem a testem (SD 3 zł), rozrzut paragonów w sklepie (SD logarytmu 0.55), obroty sprzed testu 70 · exp(0.3 · wielkość + szum o SD 0.08) tys. zł, próbkę 20% paragonów z 4 tygodni; w symulacjach: ICC .01, .025 i .05, 570 paragonów na sklep o SD 57 zł, podział wariancji sklepów 47% (wielkość) / 43% (inne trwałe) / 10% (zmiana w czasie), szum obrotów 0.27 SD, 20–40 sklepów, 1000 i 2000 powtórzeń. Po pierwszym uruchomieniu zmieniono: wzór obrotów sprzed testu (był liniowy, 70 + 22 · wielkość + szum o SD 6, i dawał sklep z obrotami 4.1 tys. zł) oraz próbkę paragonów z 5% do 20% (w symulacjach z 143 do 570 paragonów na sklep). Przepis 1 zapisuje dwa pliki CSV w katalogu roboczym. Przepis 4 liczy się ok. 30 sekund (błędy CR2 na 20 tysiącach paragonów), reszta – kilka do kilkunastu sekund.
1. Dane: 36 sklepów, 18 par i paragony z testu
R
# Przepis 1. Fikcyjna sieć sklepów z artykułami do domu: 36 sklepów, 18 par i paragony z 4 tygodni testu
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Kontrola" = "#0072B2", "Nowa ekspozycja" = "#D55E00", "ICC = .01" = "#56B4E9",
         "ICC = .025" = "#0072B2", "ICC = .05" = "#000000")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie
K <- 36                    # liczba sklepów
srednia <- 95              # średnia wartość paragonu w sieci (zł)
efekt <- 4                 # prawdziwy efekt nowej ekspozycji przy kasie: +4 zł na paragonie
sd_wielkosc <- 6.5         # różnice poziomu sklepów związane z wielkością sklepu (zł)
sd_inne <- 6.2             # pozostałe trwałe różnice sklepów (okolica, klienci) (zł)
sd_zmiana <- 3             # zmiana poziomu sklepu między okresem przed testem a testem (zł)
sd_log <- 0.55             # rozrzut paragonów w sklepie (odchylenie standardowe logarytmu wartości)
udzial_proby <- 0.20       # do analizy losujemy 20% paragonów z 4 tygodni testu

set.seed(720)
z <- rnorm(K)                                                   # wielkość sklepu (standaryzowana)
sklepy <- data.frame(sklep = sprintf("S%02d", 1:K),
                     obroty_przed = round(70 * exp(0.3 * z + rnorm(K, 0, 0.08)), 1))  # tys. zł tygodniowo, 8 tygodni przed testem
poziom_staly <- sd_wielkosc * z + rnorm(K, 0, sd_inne)
sklepy$paragon_przed <- round(srednia + poziom_staly, 2)        # średni paragon w 8 tygodniach przed testem (zł)
poziom_test <- srednia + poziom_staly + rnorm(K, 0, sd_zmiana)  # poziom sklepu w czasie testu (bez ekspozycji)

# Dobór w pary: sklepy posortowane według obrotów sprzed testu, kolejne dwa tworzą parę; rzut monetą w parze
kolejnosc <- order(sklepy$obroty_przed, decreasing = TRUE)
sklepy$para <- NA
sklepy$para[kolejnosc] <- rep(1:(K / 2), each = 2)
sklepy$ekspozycja <- NA
for (p in 1:(K / 2)) sklepy$ekspozycja[sklepy$para == p] <- sample(c(0, 1))
sklepy$grupa <- factor(ifelse(sklepy$ekspozycja == 1, "Nowa ekspozycja", "Kontrola"),
                       levels = c("Kontrola", "Nowa ekspozycja"))

# Paragony z 4 tygodni testu (losowa próbka 20%): liczba zależy od obrotów, wartość – od poziomu sklepu
sklepy$n_paragonow <- rpois(K, udzial_proby * 4 * 1000 * sklepy$obroty_przed / sklepy$paragon_przed)
paragony <- data.frame(sklep = rep(sklepy$sklep, sklepy$n_paragonow))
i <- match(paragony$sklep, sklepy$sklep)
mu <- poziom_test[i] + efekt * sklepy$ekspozycja[i]
paragony$wartosc <- round(mu * exp(rnorm(nrow(paragony), -sd_log^2 / 2, sd_log)), 2)  # średnia w sklepie = mu
paragony <- cbind(paragony, sklepy[i, c("para", "grupa", "ekspozycja", "obroty_przed", "paragon_przed")])
rownames(paragony) <- NULL
write.csv(sklepy[, c("sklep", "para", "grupa", "obroty_przed", "paragon_przed", "n_paragonow")],
          "eksperyment-w-sklepach-sklepy.csv", row.names = FALSE, fileEncoding = "UTF-8")
write.csv(paragony[, c("sklep", "wartosc")], "eksperyment-w-sklepach-paragony.csv", row.names = FALSE, fileEncoding = "UTF-8")

c(sklepy = K, pary = K / 2, paragony = nrow(paragony), min_na_sklep = min(sklepy$n_paragonow),
  max_na_sklep = max(sklepy$n_paragonow))
aggregate(cbind(obroty_przed, paragon_przed) ~ grupa, data = sklepy, FUN = function(x) round(mean(x), 2))
round(c(srednia_paragonu = mean(paragony$wartosc), sd_paragonu = sd(paragony$wartosc)), 2)
Wynik w R
      sklepy         pary     paragony min_na_sklep max_na_sklep
          36           18        20549          313          768
            grupa obroty_przed paragon_przed
1        Kontrola        66.08         91.42
2 Nowa ekspozycja        66.78         92.80
srednia_paragonu      sd_paragonu
           95.65            57.54
2. Schemat losowania w parach: Rysunek 1
R
# Przepis 2. Grafika: schemat losowania sklepów w parach; Rysunek 1
pary <- sklepy[order(sklepy$para, -sklepy$obroty_przed), ]
pary$poz <- ave(pary$para, pary$para, FUN = seq_along)        # 1 = większy sklep w parze, 2 = mniejszy
pary$kol <- (pary$para - 1) %% 6
pary$wiersz <- 2 - (pary$para - 1) %/% 6
pary$x <- pary$kol * 1.6 + ifelse(pary$poz == 1, 0.4, 1.15)
pary$y <- pary$wiersz * 1.25
pary$etykieta <- sprintf("%s\n%.1f\n%s", pary$sklep, pary$obroty_przed, ifelse(pary$ekspozycja == 1, "E", "K"))
ramki <- aggregate(cbind(x, y) ~ para, data = pary, FUN = mean)
srednie_obrotow <- tapply(sklepy$obroty_przed, sklepy$grupa, mean)
round(srednie_obrotow, 2)

p1 <- ggplot(pary) +
  geom_rect(data = ramki, aes(xmin = x - 0.74, xmax = x + 0.74, ymin = y - 0.56, ymax = y + 0.46),
            fill = "grey97", colour = "grey60", linewidth = 0.4) +
  geom_text(data = ramki, aes(x = x - 0.68, y = y + 0.38, label = paste("para", para)), hjust = 0, vjust = 1,
            size = 3.3, colour = "grey30") +
  geom_tile(aes(x, y - 0.08, fill = grupa), width = 0.66, height = 0.7, colour = "white") +
  geom_text(aes(x, y - 0.08, label = etykieta), size = 3.4, lineheight = 0.9, colour = "white", fontface = "bold") +
  annotate("text", x = -0.35, y = 3.25, hjust = 0, size = 4.1, colour = "#0f1d3a", fontface = "bold",
           label = "1. Posortuj sklepy według obrotów sprzed testu  →  2. Połącz kolejne dwa w parę  →  3. Rzuć monetą w parze") +
  annotate("text", x = -0.35, y = -0.85, hjust = 0, size = 3.7, colour = "grey20",
           label = sprintf("W sklepie: numer, obroty tygodniowe przed testem (tys. zł), E – nowa ekspozycja, K – kontrola.\nŚrednie obroty: ekspozycja %.1f, kontrola %.1f tys. zł – grupy z góry podobne wielkością.",
                           srednie_obrotow["Nowa ekspozycja"], srednie_obrotow["Kontrola"])) +
  scale_fill_manual(values = kol, name = NULL) +
  coord_cartesian(xlim = c(-0.4, 9.7), ylim = c(-1.15, 3.4), expand = FALSE) +
  labs(title = "Losowanie w parach: 36 sklepów, 18 par, w każdej parze jeden sklep z nową ekspozycją",
       x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank(), legend.position = "none")
p1   # zapis: ggsave("eksperyment-w-sklepach-losowanie-w-parach.svg", p1, width = 10, height = 6)
Wynik w R
       Kontrola Nowa ekspozycja
          66.08           66.78
3. ICC i efekt schematu: Rysunek 2
R
# Przepis 3. ICC, efekt schematu i efektywna liczba paragonów; Rysunek 2
library(lme4)
library(patchwork)

# Model pusty na paragonach: losowy wyraz wolny sklepu
m0 <- lmer(wartosc ~ 1 + (1 | sklep), data = paragony)
wariancje <- as.data.frame(VarCorr(m0))$vcov
icc <- wariancje[1] / sum(wariancje)
m_sr <- mean(sklepy$n_paragonow)                     # średnia liczba paragonów na sklep
cv <- sd(sklepy$n_paragonow) / m_sr                  # współczynnik zmienności liczby paragonów
deff <- 1 + (m_sr - 1) * icc                         # efekt schematu przy równych sklepach
deff_cv <- 1 + ((cv^2 + 1) * m_sr - 1) * icc         # wersja dla nierównych sklepów (Eldridge i in., 2006)
round(c(sd_sklepow = sqrt(wariancje[1]), sd_paragonow = sqrt(wariancje[2]), ICC = icc, m = m_sr, CV = cv,
        DEFF = deff, DEFF_CV = deff_cv, n_paragonow = nrow(paragony), n_efektywne = nrow(paragony) / deff_cv), 3)

# Średnie sklepów w teście z 95% CI (rozrzut paragonów w sklepie)
srednie <- aggregate(wartosc ~ sklep, data = paragony, FUN = mean)
names(srednie)[2] <- "srednia_test"
srednie <- merge(sklepy, srednie, by = "sklep")
sd_w <- tapply(paragony$wartosc, paragony$sklep, sd)[srednie$sklep]
srednie$ci_dol <- srednie$srednia_test - qt(.975, srednie$n_paragonow - 1) * sd_w / sqrt(srednie$n_paragonow)
srednie$ci_gora <- srednie$srednia_test + qt(.975, srednie$n_paragonow - 1) * sd_w / sqrt(srednie$n_paragonow)
round(c(min_srednia = min(srednie$srednia_test), max_srednia = max(srednie$srednia_test),
        r_przed_test = cor(srednie$paragon_przed, srednie$srednia_test)), 3)

srednie$kolejnosc <- rank(srednie$srednia_test, ties.method = "first")
pa <- ggplot(srednie, aes(srednia_test, kolejnosc, colour = grupa, shape = grupa)) +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0, linewidth = 0.6, alpha = 0.7, show.legend = FALSE) +
  geom_point(size = 2.4) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "A. Średni paragon w 36 sklepach", x = "Średnia wartość paragonu w teście (zł) z 95% CI",
       y = "Sklepy (od najniższej średniej)") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())
pb <- ggplot(srednie, aes(paragon_przed, srednia_test, colour = grupa, shape = grupa)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dotted", colour = "grey40") +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, linewidth = 0.8, show.legend = FALSE) +
  geom_point(size = 2.4) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  labs(title = "B. Przed testem a w teście", x = "Średni paragon przed testem (zł)",
       y = "Średni paragon w teście (zł)") + motyw
p2 <- (pa | pb) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p2   # zapis: ggsave("eksperyment-w-sklepach-icc-srednie.svg", p2, width = 10, height = 5.6)
Wynik w R
  sd_sklepow sd_paragonow          ICC            m           CV         DEFF      DEFF_CV  n_paragonow  n_efektywne
      11.956       56.420        0.043      570.806        0.233       25.487       26.817    20549.000      766.280
 min_srednia  max_srednia r_przed_test
      68.727      116.150        0.939
4. Siedem analiz tego samego testu: Rysunek 3
R
# Przepis 4. Ten sam test policzony siedmioma sposobami; Rysunek 3
library(lmerTest)        # stopnie swobody Satterthwaite'a w modelu mieszanym
library(clubSandwich)    # odporne błędy klastrowe CR2 dla małej liczby sklepów

wiersz <- function(nazwa, b, se, df) {
  data.frame(analiza = nazwa, efekt = b, se = se, t = b / se, df = df, ci_dol = b - qt(.975, df) * se,
             ci_gora = b + qt(.975, df) * se, p = 2 * pt(-abs(b / se), df))
}
# a) Zwykła regresja na paragonach – jakby 5142 paragony były niezależne (błędna)
a <- summary(lm(wartosc ~ ekspozycja, data = paragony))$coefficients["ekspozycja", ]
# b) Ta sama regresja z odpornym błędem klastrowym CR2 (klaster = sklep)
fit_b <- lm(wartosc ~ ekspozycja, data = paragony)
b <- coef_test(fit_b, vcov = "CR2", cluster = paragony$sklep, test = "Satterthwaite")[2, ]
# c) Model mieszany na paragonach (losowy wyraz wolny sklepu), df Satterthwaite'a
c_ <- summary(lmer(wartosc ~ ekspozycja + (1 | sklep), data = paragony))$coefficients["ekspozycja", ]
# d) Średnie sklepów, test t dla dwóch grup (36 obserwacji)
d <- summary(lm(srednia_test ~ ekspozycja, data = srednie))$coefficients["ekspozycja", ]
# e) Średnie sklepów, test t dla par (18 różnic w parach)
roznice <- with(srednie[order(srednie$para, -srednie$ekspozycja), ],
                data.frame(para = unique(para), d_test = srednia_test[ekspozycja == 1] - srednia_test[ekspozycja == 0],
                           d_przed = paragon_przed[ekspozycja == 1] - paragon_przed[ekspozycja == 0]))
e <- t.test(roznice$d_test)
# f) Pary + średni paragon sprzed testu (różnice w parach regresowane na różnicy sprzed testu)
f <- summary(lm(d_test ~ d_przed, data = roznice))$coefficients["(Intercept)", ]
# g) Model mieszany na paragonach z parą i paragonem sprzed testu, df Satterthwaite'a
g <- summary(lmer(wartosc ~ ekspozycja + paragon_przed + factor(para) + (1 | sklep),
                  data = paragony))$coefficients["ekspozycja", ]

wyniki <- rbind(
  wiersz("a) Regresja na paragonach (błędna)", a[1], a[2], nrow(paragony) - 2),
  wiersz("b) Regresja na paragonach, błędy CR2", b$beta, b$SE, b$df_Satt),
  wiersz("c) Model mieszany na paragonach", c_[1], c_[2], c_["df"]),
  wiersz("d) Średnie sklepów, test t", d[1], d[2], K - 2),
  wiersz("e) Średnie sklepów, test t dla par", unname(e$estimate), unname(e$stderr), unname(e$parameter)),
  wiersz("f) Pary + paragon sprzed testu", f[1], f[2], K / 2 - 2),
  wiersz("g) Model mieszany + pary + paragon sprzed", g[1], g[2], g["df"]))
rownames(wyniki) <- NULL
print(transform(wyniki, efekt = round(efekt, 2), se = round(se, 2), t = round(t, 2), df = round(df, 1), ci_dol = round(ci_dol, 2),
                ci_gora = round(ci_gora, 2), p = round(p, 4)), row.names = FALSE)
round(c(r_roznic = cor(roznice$d_test, roznice$d_przed)), 3)

wyniki$analiza <- factor(wyniki$analiza, levels = rev(wyniki$analiza))
wyniki$typ <- ifelse(grepl("błędna", wyniki$analiza), "Błędna (paragony jak niezależne)", "Uwzględnia sklepy")
p3 <- ggplot(wyniki, aes(efekt, analiza, colour = typ, shape = typ)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_vline(xintercept = efekt, linetype = "dashed", colour = "grey30") +
  geom_errorbar(aes(xmin = ci_dol, xmax = ci_gora), width = 0.25, linewidth = 0.8) +
  geom_point(size = 3) +
  geom_text(aes(x = 26, label = minus(sprintf("%.2f [%.2f, %.2f]", efekt, ci_dol, ci_gora))),
            hjust = 1, size = 3.7, colour = "grey15", show.legend = FALSE) +
  scale_colour_manual(values = c("Błędna (paragony jak niezależne)" = "#D55E00", "Uwzględnia sklepy" = "#0072B2"),
                      name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(limits = c(-4, 26), breaks = seq(0, 16, 4), labels = function(x) minus(x)) +
  labs(title = "Efekt nowej ekspozycji na wartość paragonu (zł) z 95% CI",
       subtitle = "Linia przerywana: prawdziwy efekt +4 zł (znany, bo dane są fikcyjne)", x = "Różnica (zł)", y = NULL) +
  motyw
p3   # zapis: ggsave("eksperyment-w-sklepach-siedem-analiz.svg", p3, width = 10, height = 5.6)
Wynik w R
                                   analiza efekt   se    t      df ci_dol ci_gora      p
        a) Regresja na paragonach (błędna)  5.55 0.80 6.92 20547.0   3.98    7.12 0.0000
      b) Regresja na paragonach, błędy CR2  5.55 3.79 1.46    32.2  -2.17   13.27 0.1527
           c) Model mieszany na paragonach  5.78 4.01 1.44    33.7  -2.37   13.92 0.1585
                d) Średnie sklepów, test t  5.78 4.02 1.44    34.0  -2.39   13.96 0.1596
        e) Średnie sklepów, test t dla par  5.78 2.72 2.12    17.0   0.04   11.53 0.0487
            f) Pary + paragon sprzed testu  4.29 1.32 3.26    16.0   1.50    7.08 0.0049
 g) Model mieszany + pary + paragon sprzed  4.26 1.26 3.37    15.0   1.56    6.95 0.0042
r_roznic
   0.886
5. Moc według liczby sklepów i ICC – symulacja: Rysunek 4
R
# Przepis 5. Moc testu według liczby sklepów i ICC – symulacja; Rysunek 4
# Symulujemy od razu średnie sklepów: poziom sklepu + efekt + błąd średniej z m paragonów.
sim_sklepy <- function(K, icc, efekt, m = 570, sd_e = 57) {
  s2u <- icc / (1 - icc) * sd_e^2                    # wariancja między sklepami wynikająca z ICC
  z <- rnorm(K)                                      # wielkość sklepu
  staly <- sqrt(0.47 * s2u) * z + rnorm(K, 0, sqrt(0.43 * s2u))   # trwały poziom (znany sprzed testu)
  zmiana <- rnorm(K, 0, sqrt(0.10 * s2u))            # zmiana poziomu w czasie testu
  obroty <- z + rnorm(K, 0, 0.27)                    # obroty sprzed testu – podstawa doboru w pary
  para <- integer(K); para[order(obroty)] <- rep(1:(K / 2), each = 2)
  t_pary <- ave(runif(K), para, FUN = function(u) as.numeric(u == max(u)))  # rzut monetą w każdej parze
  t_proste <- sample(rep(0:1, K / 2))                # losowanie proste: połowa sklepów
  blad <- rnorm(K, 0, sd_e / sqrt(m))
  list(K = K, przed = staly, para = para, t_pary = t_pary, t_proste = t_proste,
       y_pary = staly + zmiana + efekt * t_pary + blad, y_proste = staly + zmiana + efekt * t_proste + blad)
}
ols <- function(X, y, j = 2) {                       # oszacowanie, SE i df współczynnika w kolumnie j
  f <- .lm.fit(X, y); s2 <- sum(f$residuals^2) / (nrow(X) - ncol(X))
  c(b = f$coefficients[j], se = sqrt(s2 * solve(crossprod(X))[j, j]), df = nrow(X) - ncol(X))
}
analizy <- function(s) {
  K <- s$K; jeden <- rep(1, K)
  o <- order(s$para, -s$t_pary)
  dy <- s$y_pary[o][c(TRUE, FALSE)] - s$y_pary[o][c(FALSE, TRUE)]     # różnica w parze: ekspozycja − kontrola
  dx <- s$przed[o][c(TRUE, FALSE)] - s$przed[o][c(FALSE, TRUE)]
  rbind("Losowanie proste" = ols(cbind(jeden, s$t_proste), s$y_proste),
        "Losowanie proste + paragon sprzed" = ols(cbind(jeden, s$t_proste, s$przed), s$y_proste),
        "Pary" = c(b = mean(dy), se = sd(dy) / sqrt(K / 2), df = K / 2 - 1),
        "Pary + paragon sprzed" = ols(cbind(1, dx), dy, j = 1))      # wyraz wolny = efekt
}

set.seed(7201)
siatka <- expand.grid(K = seq(20, 40, 4), icc = c(0.01, 0.025, 0.05))
moc <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(i) {
  r <- replicate(1000, { a <- analizy(sim_sklepy(siatka$K[i], siatka$icc[i], efekt = 4))
                          abs(a[, "b"] / a[, "se"]) > qt(.975, a[, "df"]) })
  data.frame(K = siatka$K[i], icc = siatka$icc[i], schemat = rownames(r), moc = rowMeans(r))
}))
moc$blad_mc <- sqrt(moc$moc * (1 - moc$moc) / 1000)
tab_moc <- reshape(moc[, c("K", "icc", "schemat", "moc")], idvar = c("K", "icc"), timevar = "schemat", direction = "wide")
names(tab_moc) <- sub("moc.", "", names(tab_moc), fixed = TRUE)
print(transform(tab_moc, `Losowanie proste` = round(`Losowanie proste`, 3)), row.names = FALSE, digits = 3)
round(max(moc$blad_mc), 4)                           # największy błąd Monte Carlo odsetka

moc$ICC <- factor(sprintf("ICC = %s", sub("^0", "", moc$icc)), levels = c("ICC = .01", "ICC = .025", "ICC = .05"))
moc$schemat <- factor(moc$schemat, levels = c("Losowanie proste", "Pary", "Losowanie proste + paragon sprzed",
                                              "Pary + paragon sprzed"),
                      labels = c("A. Losowanie proste", "B. Pary", "C. Losowanie proste + paragon sprzed",
                                 "D. Pary + paragon sprzed"))
p4 <- ggplot(moc, aes(K, moc, colour = ICC, shape = ICC, linetype = ICC)) +
  geom_hline(yintercept = 0.8, linetype = "dotted", colour = "grey30") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  facet_wrap(~schemat, ncol = 2) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed", "longdash"), name = NULL) +
  scale_x_continuous(breaks = seq(20, 40, 4)) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) paste0(100 * x, "%")) +
  labs(title = "Moc wykrycia +4 zł na paragonie według liczby sklepów",
       subtitle = "1000 symulacji na punkt, 570 paragonów na sklep; linia kropkowana: moc 80%",
       x = "Liczba sklepów w teście", y = "Moc (α = .05)") + motyw
p4   # zapis: ggsave("eksperyment-w-sklepach-moc.svg", p4, width = 10, height = 7.4)
Wynik w R
  K   icc Losowanie proste Losowanie proste + paragon sprzed  Pary Pary + paragon sprzed
 20 0.010            0.293                             0.810 0.349                 0.661
 24 0.010            0.337                             0.863 0.422                 0.800
 28 0.010            0.364                             0.926 0.511                 0.864
 32 0.010            0.444                             0.955 0.601                 0.927
 36 0.010            0.475                             0.964 0.626                 0.936
 40 0.010            0.540                             0.981 0.701                 0.968
 20 0.025            0.150                             0.576 0.192                 0.519
 24 0.025            0.180                             0.705 0.235                 0.590
 28 0.025            0.184                             0.768 0.253                 0.699
 32 0.025            0.212                             0.822 0.307                 0.779
 36 0.025            0.241                             0.848 0.353                 0.844
 40 0.025            0.264                             0.915 0.373                 0.842
 20 0.050            0.114                             0.385 0.118                 0.324
 24 0.050            0.116                             0.487 0.149                 0.443
 28 0.050            0.113                             0.543 0.162                 0.494
 32 0.050            0.124                             0.611 0.185                 0.584
 36 0.050            0.141                             0.694 0.196                 0.643
 40 0.050            0.152                             0.728 0.219                 0.662
[1] 0.0158
6. Precyzja czterech schematów przy 36 sklepach: Rysunek 5
R
# Przepis 6. Pary i paragon sprzed testu: zysk precyzji przy 36 sklepach – symulacja; Rysunek 5
# Korzysta z sim_sklepy() i analizy() z przepisu 5.
set.seed(7202)
R <- 2000
osz <- replicate(R, analizy(sim_sklepy(36, 0.05, efekt = 4)), simplify = FALSE)
precyzja <- do.call(rbind, lapply(osz, function(a) data.frame(schemat = rownames(a), b = a[, "b"], se = a[, "se"],
                                                             df = a[, "df"])))
precyzja$ci_dol <- precyzja$b - qt(.975, precyzja$df) * precyzja$se
precyzja$ci_gora <- precyzja$b + qt(.975, precyzja$df) * precyzja$se
podsum <- do.call(rbind, lapply(split(precyzja, precyzja$schemat), function(d) data.frame(
  schemat = d$schemat[1], srednia = mean(d$b), sd_oszacowan = sd(d$b), polowa_ci = mean((d$ci_gora - d$ci_dol) / 2),
  pokrycie = mean(d$ci_dol < 4 & d$ci_gora > 4), moc = mean(d$ci_dol > 0 | d$ci_gora < 0))))
podsum$schemat <- factor(podsum$schemat, levels = c("Losowanie proste", "Pary", "Losowanie proste + paragon sprzed",
                                                    "Pary + paragon sprzed"))
podsum <- podsum[order(podsum$schemat), ]
print(podsum, row.names = FALSE, digits = 3)
round(sqrt(0.95 * 0.05 / R), 4)                      # błąd Monte Carlo pokrycia

precyzja$schemat <- factor(precyzja$schemat, levels = rev(levels(podsum$schemat)))
podsum$schemat <- factor(podsum$schemat, levels = levels(precyzja$schemat))
p5 <- ggplot(precyzja, aes(b, schemat)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_vline(xintercept = 4, linetype = "dashed", colour = "grey30") +
  geom_violin(fill = "#56B4E9", colour = "#0072B2", alpha = 0.35, scale = "width", width = 0.8) +
  geom_boxplot(width = 0.12, outlier.shape = NA, fill = "white", colour = "#0f1d3a") +
  geom_text(data = podsum, aes(x = 28, label = sprintf("SD = %.2f zł\n±%.2f zł, moc %.0f%%", sd_oszacowan,
                                                         polowa_ci, 100 * moc)),
            hjust = 1, size = 3.6, lineheight = 0.95, colour = "grey15") +
  scale_x_continuous(breaks = seq(-8, 16, 4), labels = function(x) minus(x)) +
  coord_cartesian(xlim = c(-12, 28)) +
  labs(title = "Rozrzut oszacowań efektu w 2000 symulowanych testach (36 sklepów)",
       subtitle = "ICC = .05; linia przerywana: prawdziwy efekt +4 zł; ± średnia połowa 95% CI",
       x = "Oszacowany efekt (zł na paragonie)", y = NULL) + motyw
p5   # zapis: ggsave("eksperyment-w-sklepach-precyzja.svg", p5, width = 10, height = 5.6)
Wynik w R
                           schemat srednia sd_oszacowan polowa_ci pokrycie   moc
                  Losowanie proste    4.06         4.46      8.94    0.948 0.154
                              Pary    4.08         3.31      7.04    0.957 0.194
 Losowanie proste + paragon sprzed    4.05         1.64      3.26    0.946 0.678
             Pary + paragon sprzed    4.01         1.64      3.43    0.950 0.632
[1] 0.0049
7. Fałszywe alarmy przy braku efektu: Rysunek 6
R
# Przepis 7. Fałszywe alarmy, gdy ekspozycja nic nie daje: paragony jak niezależne i mała liczba sklepów; Rysunek 6
# Korzysta z sim_sklepy() i analizy() z przepisu 5. Paragony losujemy wprost (rozkład normalny), m = 570 na sklep.
alarmy_jeden <- function(K, icc = 0.05, m = 570, sd_e = 57) {
  s <- sim_sklepy(K, icc, efekt = 0, m = m, sd_e = sd_e)
  a <- analizy(s)
  # zwykła regresja na K × m paragonach: odchylenia paragonów wokół średniej sklepu (średnia sklepu = s$y_proste)
  id <- rep(1:K, each = m)
  e <- rnorm(K * m, 0, sd_e)
  par <- s$y_proste[id] + e - ave(e, id)
  grp <- rep(s$t_proste, each = m)
  r <- .lm.fit(cbind(1, grp), par)$residuals
  se_n <- sqrt(sum(r^2) / (K * m - 2) * (1 / sum(grp) + 1 / sum(1 - grp)))
  b_n <- mean(par[grp == 1]) - mean(par[grp == 0])
  c("Regresja na paragonach" = abs(b_n / se_n) > qt(.975, K * m - 2),
    "Średnie sklepów, test t" = abs(a[1, "b"] / a[1, "se"]) > qt(.975, a[1, "df"]),
    "Pary, test t" = abs(a[3, "b"] / a[3, "se"]) > qt(.975, a[3, "df"]),
    "Pary, wartość krytyczna 1.96" = abs(a[3, "b"] / a[3, "se"]) > 1.96,
    "Pary + paragon sprzed, test t" = abs(a[4, "b"] / a[4, "se"]) > qt(.975, a[4, "df"]),
    "Pary + paragon sprzed, 1.96" = abs(a[4, "b"] / a[4, "se"]) > 1.96)
}
set.seed(7203)
R <- 2000
alarmy <- do.call(rbind, lapply(c(20, 36), function(K) {
  x <- rowMeans(replicate(R, alarmy_jeden(K)))
  data.frame(K = K, analiza = names(x), odsetek = x)
}))
alarmy$blad_mc <- sqrt(alarmy$odsetek * (1 - alarmy$odsetek) / R)
print(transform(alarmy, odsetek = round(100 * odsetek, 1), blad_mc = round(100 * blad_mc, 2)), row.names = FALSE)

alarmy$analiza <- factor(alarmy$analiza, levels = rev(unique(alarmy$analiza)))
alarmy$sklepy <- factor(paste(alarmy$K, "sklepów"), levels = c("20 sklepów", "36 sklepów"))
p6 <- ggplot(alarmy, aes(100 * odsetek, analiza, colour = sklepy, shape = sklepy)) +
  geom_vline(xintercept = 5, linetype = "dashed", colour = "grey30") +
  geom_errorbar(aes(xmin = 100 * (odsetek - 1.96 * blad_mc), xmax = 100 * (odsetek + 1.96 * blad_mc)),
                width = 0.3, linewidth = 0.7, position = position_dodge(width = 0.55)) +
  geom_point(size = 3, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = c("20 sklepów" = "#D55E00", "36 sklepów" = "#0072B2"), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%")) +
  labs(title = "Fałszywe alarmy, gdy ekspozycja nic nie zmienia",
       subtitle = "2000 symulacji na punkt, ICC = .05, 570 paragonów na sklep; linia: nominalne 5%",
       x = "Odsetek testów z p < .05 (z 95% przedziałem błędu Monte Carlo)", y = NULL) + motyw
p6   # zapis: ggsave("eksperyment-w-sklepach-falszywe-alarmy.svg", p6, width = 10, height = 5.6)
Wynik w R
  K                       analiza odsetek blad_mc
 20        Regresja na paragonach    72.2    1.00
 20       Średnie sklepów, test t     5.2    0.50
 20                  Pary, test t     4.4    0.46
 20  Pary, wartość krytyczna 1.96     7.1    0.57
 20 Pary + paragon sprzed, test t     4.6    0.47
 20   Pary + paragon sprzed, 1.96     8.3    0.62
 36        Regresja na paragonach    73.0    0.99
 36       Średnie sklepów, test t     4.8    0.48
 36                  Pary, test t     4.9    0.48
 36  Pary, wartość krytyczna 1.96     6.2    0.54
 36 Pary + paragon sprzed, test t     4.6    0.47
 36   Pary + paragon sprzed, 1.96     6.4    0.55
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary_kol <- list("kontrola – ekspozycja" = c("#0072B2", "#D55E00"),
                 "ICC .01 – ICC .025" = c("#56B4E9", "#0072B2"), "ICC .025 – ICC .05" = c("#0072B2", "#000000"),
                 "ICC .01 – ICC .05" = c("#56B4E9", "#000000"),
                 "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary_kol, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                       protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
kontrola – ekspozycja                      114.6        108.3       91.9
ICC .01 – ICC .025                          26.4         24.7       24.6
ICC .025 – ICC .05                          61.9         62.8       62.4
ICC .01 – ICC .05                           78.9         77.6       79.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja liniowa, test t i symulacje – pakiet stats i funkcje podstawowej instalacji R. Model mieszany dopasowano pakietem lme4, stopnie swobody Satterthwaite’a policzono pakietem lmerTest, a błędy CR2 – pakietem clubSandwich. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- clubSandwich (wersja 0.7.0): Pustejovsky, J. E. (2025). clubSandwich: Cluster-robust (sandwich) variance estimators with small-sample corrections [R package]. https://doi.org/10.32614/CRAN.package.clubSandwich
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Klienci przechodzą między sklepami. Klient sklepu kontrolnego zrobi zakupy w sąsiednim sklepie z ekspozycją i odwrotnie. Taka kontaminacja zmniejsza oszacowanie efektu i może prowadzić do błędu II rodzaju (Torgerson, 2001). Nie łącz w pary i nie losuj osobno sklepów z tej samej galerii lub ulicy – traktuj je jako jeden klaster.
- Mała liczba sklepów. Przy 10–20 parach używaj rozkładu t z liczbą stopni swobody wynikającą z liczby sklepów, a w modelu mieszanym – poprawki Satterthwaite’a lub Kenwarda–Rogera. Wartość 1.96 dała do 8.3% fałszywych alarmów.
- Kowariant zmierzony po starcie. Do modelu wstawiaj tylko dane sprzed losowania. Średni paragon z pierwszego tygodnia testu jest już skutkiem ekspozycji.
- Sklep wypada z testu (remont, zamknięcie). W parach tracisz wtedy także jego parę; zapisz z góry, co robisz w takiej sytuacji.
- Średni paragon to nie wszystko. Ekspozycja może podnosić paragon, ale zmniejszać liczbę klientów, np. przez kolejki przy kasie. Patrz też na obroty sklepu – to także metryka na poziomie sklepu. Gdy efekt przenosi się między jednostkami w bardziej złożony sposób, zob. eksperymenty z efektem sieciowym.
Najczęstsze pytania
Dlaczego w eksperymencie w sieci sklepów losuje się sklepy, a nie klientów?
Bo zmiana – ekspozycja, układ półek, obsługa – dotyczy całego sklepu i widzi ją każdy klient. Jednostką losowania jest więc sklep, a paragony z jednego sklepu są do siebie podobne. Analiza musi to uwzględnić: liczy się liczba sklepów, nie paragonów.
Ilu sklepów potrzeba do testu zmiany w sklepie?
To zależy od ICC, wielkości efektu i tego, czy masz dane sprzed testu. W symulacji z przykładu wzrost paragonu o 4 zł przy ICC = .025 wykrywało 36 sklepów z mocą 24.1% przy prostym porównaniu i 84.8% po dodaniu średniego paragonu sprzed testu. Liczbę sklepów zaplanuj symulacją dla kilku wartości ICC.
Jak policzyć efekt schematu dla paragonów ze sklepów?
DEFF = 1 + (m − 1) × ICC, gdzie m to średnia liczba paragonów na sklep. Przy 570.8 paragonu i ICC = .043 wychodzi 25.49, a z poprawką na nierówną liczbę paragonów 26.82, czyli 20 549 paragonów odpowiada ok. 766 niezależnym obserwacjom.
Czy dobór sklepów w pary się opłaca?
Tak, wyrównuje grupy pod względem wielkości i chroni przed pechowym losowaniem. W symulacji z 36 sklepami pary zmniejszyły SD oszacowań efektu z 4.46 do 3.31 zł. Jeszcze więcej daje kowariant sprzed testu (1.64 zł); gdy go masz, pary nie dodają już wiele precyzji, ale nadal porządkują plan.
Model mieszany na paragonach czy średnie sklepów – co wybrać?
Oba podejścia są poprawne, jeśli uwzględniają sklep: model mieszany z losowym wyrazem wolnym sklepu i stopniami swobody Satterthwaite’a albo analiza średnich sklepów (np. różnic w parach). Błędna jest zwykła regresja na paragonach – w przykładzie dała SE 0.80 zł zamiast ok. 4 zł.
Powiązane hasła
Przeczytaj też
Randomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →PoradnikGeo-eksperyment – plan testu w regionach
40 regionów, pary z historii sprzedaży, losowanie w parach, analiza z poziomem sprzed testu i krzywe mocy – sześć rysunków z kodem R.
Czytaj →PoradnikMetryki ochronne w teście A/B
Test nie-gorszości z marginesem, symulacja, moc dla rzadkich metryk i reguła decyzji – na fikcyjnym teście serwisu biletowego, z kodem R.
Czytaj →Planujesz test w sklepach albo piszesz o nim pracę?
Pomożemy dobrać sklepy w pary, policzyć liczbę sklepów symulacją, przeanalizować paragony modelem mieszanym i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Eldridge, S. M., Ashby, D., & Kerry, S. (2006). Sample size for cluster randomized trials: Effect of coefficient of variation of cluster size and analysis method. International Journal of Epidemiology, 35(5), 1292–1300. https://doi.org/10.1093/ije/dyl129 ● Otwarty dostęp
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Imai, K., King, G., & Nall, C. (2009). The essential role of pair matching in cluster-randomized experiments, with application to the Mexican Universal Health Insurance Evaluation. Statistical Science, 24(1), 29–53. https://doi.org/10.1214/08-sts274 ● Otwarty dostęp
- Killip, S., Mahfoud, Z., & Pearce, K. (2004). What is an intracluster correlation coefficient? Crucial concepts for primary care researchers. Annals of Family Medicine, 2(3), 204–208. https://doi.org/10.1370/afm.141 ● Otwarty dostęp
- Leyrat, C., Morgan, K. E., Leurent, B., & Kahan, B. C. (2018). Cluster randomized trials with a small number of clusters: Which analyses should be used? International Journal of Epidemiology, 47(1), 321–331. https://doi.org/10.1093/ije/dyx169
- Torgerson, D. J. (2001). Contamination in trials: Is cluster randomisation the answer? BMJ, 322(7282), 355–357. https://doi.org/10.1136/bmj.322.7282.355 ● Otwarty dostęp
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{eldridge2006sample, author={Eldridge, Sandra M. and Ashby, Deborah and Kerry, Sally}, title={{Sample size for cluster randomized trials: Effect of coefficient of variation of cluster size and analysis method}}, journal={International Journal of Epidemiology}, year={2006}, volume={35}, number={5}, pages={1292--1300}, doi={10.1093/ije/dyl129}}@article{hurlbert1984pseudoreplication, author={Hurlbert, Stuart H.}, title={{Pseudoreplication and the design of ecological field experiments}}, journal={Ecological Monographs}, year={1984}, volume={54}, number={2}, pages={187--211}, doi={10.2307/1942661}}@article{imai2009essential, author={Imai, Kosuke and King, Gary and Nall, Clayton}, title={{The essential role of pair matching in cluster-randomized experiments, with application to the Mexican Universal Health Insurance Evaluation}}, journal={Statistical Science}, year={2009}, volume={24}, number={1}, pages={29--53}, doi={10.1214/08-sts274}}@article{killip2004what, author={Killip, Shersten and Mahfoud, Ziyad and Pearce, Kevin}, title={{What is an intracluster correlation coefficient? Crucial concepts for primary care researchers}}, journal={Annals of Family Medicine}, year={2004}, volume={2}, number={3}, pages={204--208}, doi={10.1370/afm.141}}@article{leyrat2018cluster, author={Leyrat, Clémence and Morgan, Katy E. and Leurent, Baptiste and Kahan, Brennan C.}, title={{Cluster randomized trials with a small number of clusters: Which analyses should be used?}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={1}, pages={321--331}, doi={10.1093/ije/dyx169}}@article{torgerson2001contamination, author={Torgerson, David J.}, title={{Contamination in trials: Is cluster randomisation the answer?}}, journal={BMJ}, year={2001}, volume={322}, number={7282}, pages={355--357}, doi={10.1136/bmj.322.7282.355}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}