Przykład: serwis biletowy i nowy proces zakupu
Fikcyjny serwis z biletami na koncerty i wydarzenia przygotował nowy proces zakupu: wybór miejsca, dane i płatność na jednej stronie zamiast czterech kroków. Zespół zaplanował test A/B: przez dwa tygodnie 80 000 użytkowników, którzy weszli na stronę wydarzenia, losowo trafiało do wariantu A (obecny proces) albo B (nowy proces), po 40 000 w każdym.
Pytanie zarządu brzmi: czy nowy proces sprzedaje więcej biletów, nie psując przy tym niczego ważnego? Druga część to pytanie o metryki ochronne – o nich jest ten wpis. Plan całego testu opisuje wpis test A/B – plan i analiza; zaglądanie do wyników, nierówny podział ruchu i efekt nowości omawiają pułapki testów A/B.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (lista przy kodzie): konwersja 6.0% w A i 6.6% w B, zwroty biletów 4.0% i 4.2% kupujących, zgłoszenia do obsługi 2.5% i 3.1% kupujących, średni czas ładowania strony zakupu 2.00 i 2.05 s. Nowy proces naprawdę zwiększa więc zgłoszenia o 0.6 punktu procentowego (pp). Ziarno losowania 719; po pierwszym uruchomieniu żadnego parametru nie zmienialiśmy. Dane: metryki-ochronne-test-ab-bilety.csv (wiersz = użytkownik; zwrot i zgłoszenie puste u osób bez zakupu).
Metryka główna, metryki ochronne i margines
Metryka główna to ta, którą zmiana ma poprawić – tu konwersja, czyli odsetek użytkowników, którzy kupili bilet. Przewodnik po eksperymentach online Kohaviego i in. (2020) zaleca ustalenie kluczowych metryk i jednego ogólnego kryterium oceny przed startem.
Metryki ochronne (ang. guardrail metrics) mają się nie pogorszyć. Nowy formularz może sprzedawać więcej, ale też rodzić pomyłki (zwroty), niejasności (zgłoszenia do obsługi) albo spowolnić stronę. Pytasz tu nie „czy jest różnica?”, tylko „czy nie pogorszyło się o więcej, niż jesteśmy gotowi zaakceptować?”. Tę granicę nazywamy marginesem (Δ).
| Metryka | Rola | Gorzej, gdy | Margines Δ (przed testem) |
|---|---|---|---|
| Konwersja (zakup biletu) | główna | spada | – (test przewagi) |
| Zwroty biletów wśród kupujących | ochronna | rośnie | +1.0 pp |
| Zgłoszenia do obsługi wśród kupujących | ochronna | rośnie | +0.5 pp |
| Czas ładowania strony zakupu | ochronna | rośnie | +0.2 s |
Jak wybrać margines. W badaniach klinicznych to najtrudniejszy krok planu, oparty na przesłankach klinicznych i statystycznych (Althunian i in., 2017); margines trzeba uzasadnić i ustalić przed zebraniem danych (Walker i Nowacki, 2011). W marketingu przesłanki są trzy:
- Rachunek. Margines to największe pogorszenie, przy którym zysk z wyższej konwersji nadal pokrywa koszt dodatkowych zwrotów czy zgłoszeń.
- Możliwości zespołu. W przykładzie +0.5 pp zgłoszeń to tyle, ile obsługa przyjmie bez nowych etatów.
- Zwykłe wahania. Margines węższy niż tygodniowy szum metryki wymaga ogromnej próby; szerszy niż realna szkoda nic nie chroni.
Margines to najmniejszy interesujący efekt (SESOI) po stronie szkody. Zapisz, czy jest bezwzględny (pp) czy względny: +1.0 pp przy 4% zwrotów to wzrost o jedną czwartą.
Rysunek 1: metryka główna – czy nowy proces sprzedaje więcej?
Najpierw zwykłe pytanie o przewagę: test dla dwóch proporcji (test z), dwustronnie, α = .05.
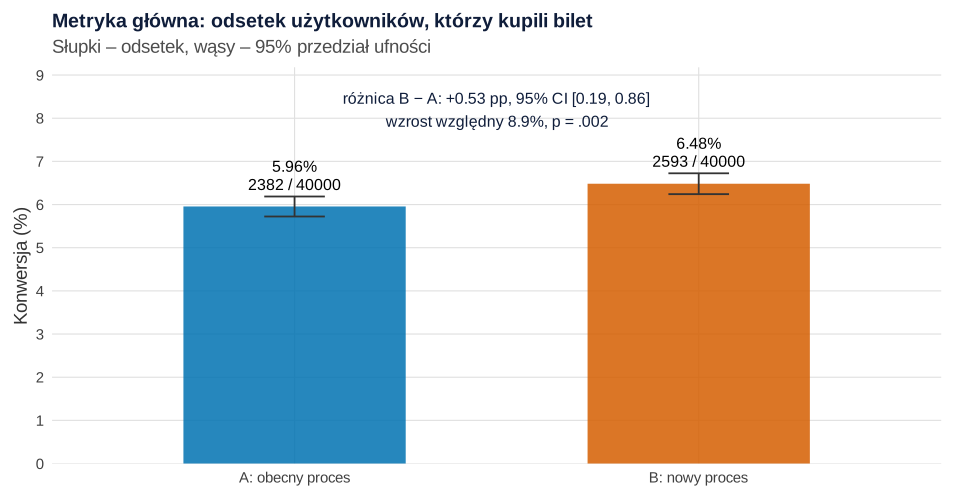
set.seed(719)).Co widać. W wariancie B bilet kupiło 6.48% użytkowników, w A – 5.96%. Różnica wynosi +0.53 pp, 95% CI [0.19, 0.86], z = 3.09, p = .002; względnie to wzrost o 8.9%. Metryka główna jest lepsza.
Jak może zmylić. Wykres nie mówi, ilu kupujących odda potem bilet albo napisze do obsługi.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: test nie-gorszości dla metryk ochronnych
W teście nie-gorszości role hipotez są odwrócone. Hipoteza zerowa mówi: „B jest gorszy o margines lub więcej”, a dowodu wymaga podobieństwo, nie różnica (Schumi i Wittes, 2011). To ta sama logika co w badaniu non-inferiority i połowa procedury TOST. W praktyce wystarczy przedział ufności:
Lewa strona to górna granica dwustronnego 90% CI, czyli test jednostronny z α = .05. Walker i Nowacki (2011) porównują z marginesem granicę przedziału (1 − 2α); w badaniach klinicznych częściej bierze się α = .025, czyli granicę 95% CI – wybór zapisz w planie. Dla zwrotów i zgłoszeń SE liczymy z odsetków wśród kupujących, a dla czasu ładowania używamy testu Welcha z hipotezą zerową przesuniętą o 0.2 s.
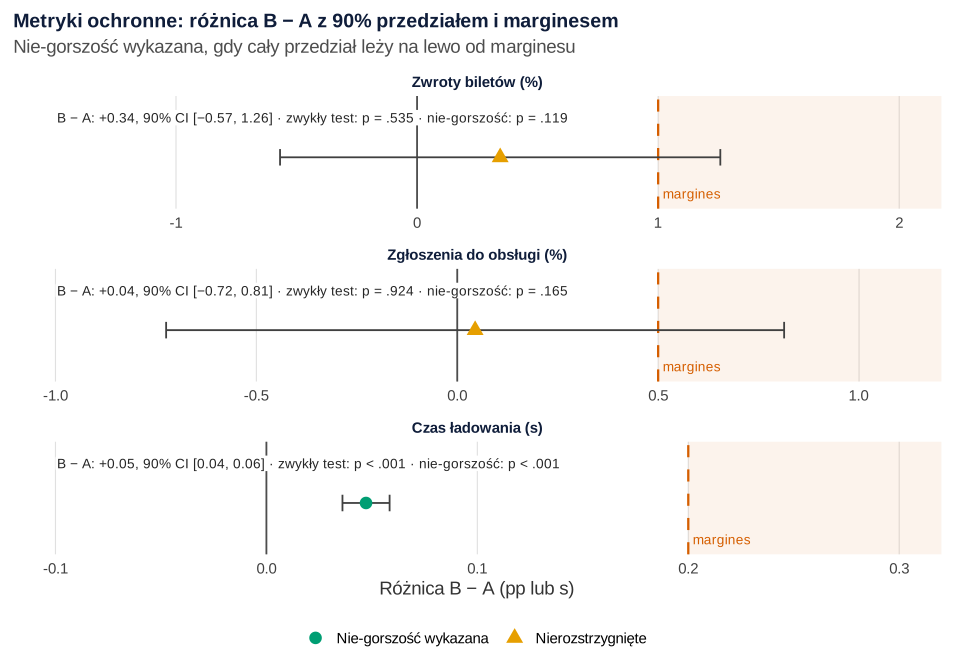
set.seed(719)).Co widać. Zwroty: 4.17% w B wobec 3.82% w A, +0.34 pp, 90% CI [−0.57, 1.26]. Górna granica przekracza margines 1 pp, więc nie-gorszość nie jest wykazana (p = .119), choć zwykły test nie widzi różnicy (p = .535). Zgłoszenia: 2.82% wobec 2.77%, +0.04 pp [−0.72, 0.81] – to samo: p = .924 w zwykłym teście, nie-gorszość niewykazana (p = .165). Czas ładowania: 2.05 s wobec 2.00 s, +0.05 s [0.04, 0.06]. Ta różnica jest istotna (p < .001), a mimo to nie-gorszość jest wykazana: 0.06 s to mniej niż 0.2 s.
Jak może zmylić. Wiemy, że zgłoszeń naprawdę jest o 0.6 pp więcej – ponad margines. W próbie wyszło +0.04 pp. Kto czyta tylko zwykły test, napisze „nowy proces nie zwiększa zgłoszeń”; test nie-gorszości mówi: za mało danych. Zob. też jak opisać wynik nieistotny.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: „brak istotnego pogorszenia” to nie „brak pogorszenia”
Symulujemy 10 000 testów A/B dla każdej liczby użytkowników – od 10 tys. do 320 tys. na wariant – w dwóch światach: zgłoszenia się nie zmieniają (A) albo rosną o 0.6 pp, czyli ponad margines (B). Błąd Monte Carlo każdego odsetka nie przekracza 0.5 pp.
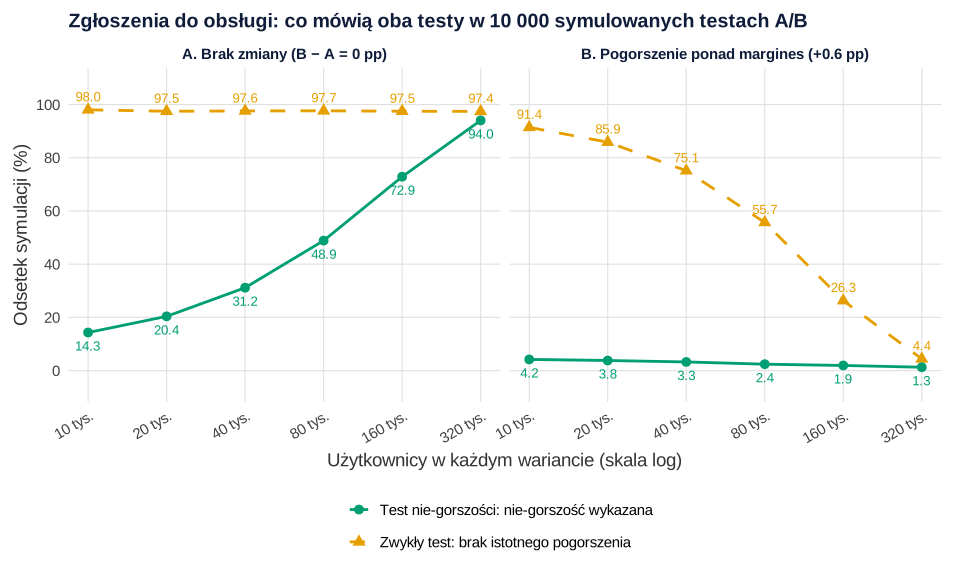
set.seed(7191)).Co widać. W świecie B nowy proces naprawdę szkodzi. Mimo to przy 10 tys. użytkowników na wariant zwykły test nie znajduje istotnego pogorszenia w 91.4% testów, a przy 40 tys. (nasz test) – w 75.1%. Test nie-gorszości w tym samym świecie przepuszcza zmianę najwyżej w 4.2% testów – to jego błąd I rodzaju, trzymany poniżej α = .05.
Jak może zmylić. Cenę tej ochrony widać w panelu A: przy neutralnej zmianie i 40 tys. użytkowników nie-gorszość wychodzi tylko w 31.2% testów. Mała próba daje wynik nierozstrzygnięty, a nie „bezpieczny”.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: moc dla metryki ochronnej – potrzeba większej próby
Moc testu dla metryki ochronnej bywa dużo niższa niż dla głównej: zwroty i zgłoszenia liczy się tylko wśród kupujących (ok. 6% użytkowników), są rzadkie, a margines jest wąski. Rysunek pokazuje moc w zależności od liczby użytkowników, przy założeniu, że metryki ochronne naprawdę się nie zmieniają.
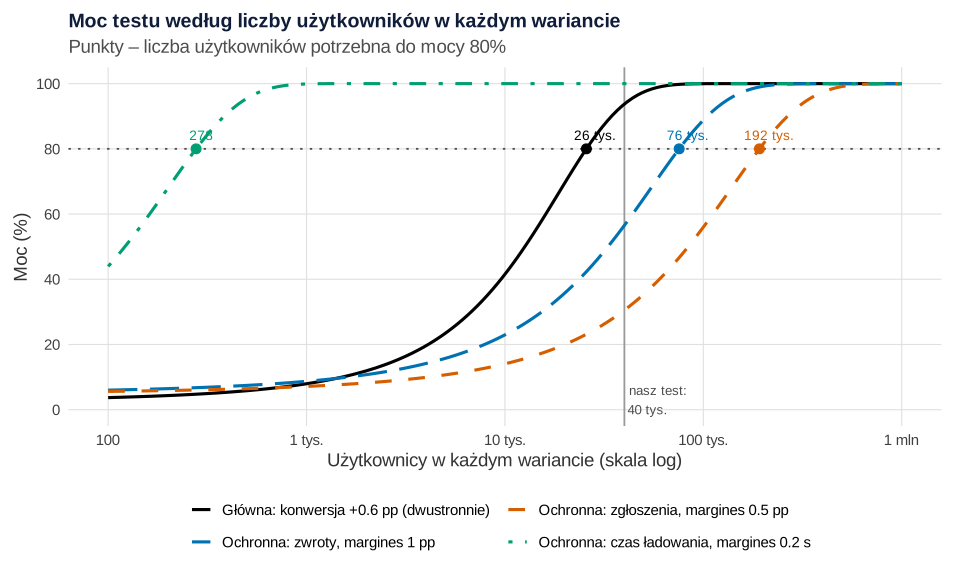
Co widać. Na metrykę główną wystarczy 25 736 użytkowników na wariant. Zwroty wymagają 75 540, a zgłoszenia – 191 800, czyli przy naszym ruchu (20 000 użytkowników na wariant tygodniowo) 9.6 tygodnia zamiast dwóch. Przy 40 000 moc wynosi 93.7% dla konwersji, 56.5% dla zwrotów i 30.5% dla zgłoszeń. Ostatnia liczba zgadza się z symulacją (31.2%). Czasowi ładowania wystarczy 278 osób: mierzymy go u każdego, a margines jest szeroki.
Jak może zmylić. Krzywe zakładają brak prawdziwej zmiany; przy niewielkim pogorszeniu w granicach marginesu potrzeba jeszcze więcej danych.
Podpis do pracy:
Zdanie do Metody:
Kilka metryk naraz: kiedy poprawka Holma
Przy trzech metrykach ochronnych padają dwa różne pytania – i tylko jedno wymaga poprawki (szerzej: poprawki na wielokrotne porównania).
- „Czy któraś metryka się pogorszyła?” To alarm; przy trzech testach rośnie szansa fałszywego alarmu, więc stosujesz poprawkę Holma: najmniejsze p mnożysz przez 3, kolejne przez 2, ostatnie przez 1 i zatrzymujesz się na pierwszym nieistotnym (Holm, 1979). U nas po poprawce zostaje tylko czas ładowania (p < .001); zwroty i zgłoszenia mają p = 1.000.
- „Czy wszystkie metryki są nie-gorsze?” To warunek wdrożenia: przejść muszą wszystkie trzy testy, więc poprawka nie jest potrzebna. Błędne wdrożenie wymagałoby pomyłki testu tej metryki, która naprawdę się pogorszyła – a to zdarza się najwyżej w α przypadków.
Gdy wariantów jest kilka, poprawkę stosuje się do metryki głównej – przykład w artykule test A/B z wieloma wariantami.
Rysunek 5: reguła decyzji testu – karta
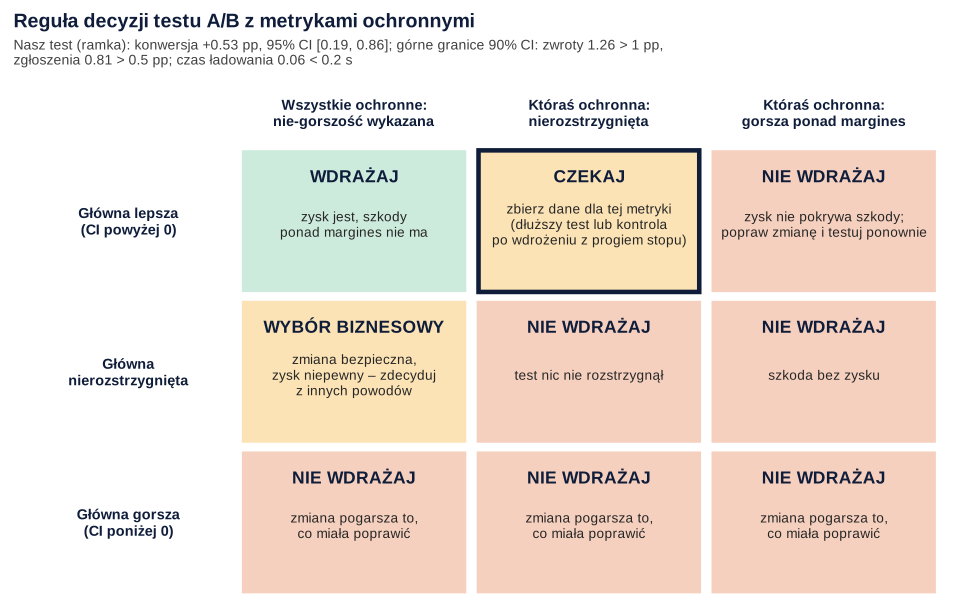
Co widać. Nasz test trafia do pola „czekaj”: sprzedaż rośnie, ale o zwrotach i zgłoszeniach dane nie rozstrzygają.
Jak może zmylić. Regułę przyjmij przed testem; ustalona po wynikach uzasadnia decyzję podjętą z innych powodów.
Podpis do pracy:
Co z tym zrobić w marketingu
- Zapisz metryki ochronne i marginesy przed startem – z kierunkiem „gorzej” i poziomem α.
- Licz moc dla najrzadszej metryki ochronnej. W przykładzie konwersji wystarczyłoby 26 tys. użytkowników na wariant, zgłoszeniom – 192 tys.
- Nie zamieniaj „nierozstrzygnięte” na „bez wpływu”. Serwis biletowy może przedłużyć test (ok. 9.6 tygodnia dla zgłoszeń), wdrożyć zmianę z obserwacją zgłoszeń i ustalonym z góry progiem wycofania albo poprawić formularz. Poszerzanie marginesu, żeby „przeszło”, nie jest wyjściem.
- Istotne pogorszenie w marginesie to nie powód do paniki. Czas ładowania wzrósł istotnie o 0.05 s, ale mieści się w 0.2 s.
- Raportuj każdą metrykę ochronną z przedziałem. Sama etykieta „OK” ukrywa, że przedział sięga 0.81 pp przy marginesie 0.5 pp. Zob. też statystyka w pracy z marketingu.
Jak opisać w pracy
Podaj metryki, marginesy z uzasadnieniem, α i test, a w Wynikach – różnice z przedziałami.
| Metryka | A | B | B − A [CI] | Margines | Wniosek |
|---|---|---|---|---|---|
| Konwersja (%) | 5.96 | 6.48 | 0.53 [0.19, 0.86]a | – | B lepszy, p = .002 |
| Zwroty (% kupujących) | 3.82 | 4.17 | 0.34 [−0.57, 1.26]b | 1 pp | nierozstrzygnięte, p = .119 |
| Zgłoszenia (% kupujących) | 2.77 | 2.82 | 0.04 [−0.72, 0.81]b | 0.5 pp | nierozstrzygnięte, p = .165 |
| Czas ładowania (s) | 2.00 | 2.05 | 0.05 [0.04, 0.06]b | 0.2 s | nie-gorszość, p < .001 |
Kod R: metryka główna, test nie-gorszości, symulacja i moc
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(719)) i 4 (set.seed(7191)); ziarna ustalono raz i nie zmieniano. Przepis 5 liczy moc ze wzorów, bez losowania. Ręcznie ustalono: 40 000 użytkowników na wariant (20 000 tygodniowo), konwersję 6.0% i 6.6%, zwroty 4.0% i 4.2% oraz zgłoszenia 2.5% i 3.1% kupujących, czas ładowania z rozkładu log-normalnego o średniej 2.00 i 2.05 s (sdlog = 0.45), marginesy 1 pp, 0.5 pp i 0.2 s, α = .05 jednostronnie, w symulacji wzrost zgłoszeń 0 i 0.6 pp oraz 10 000 powtórzeń. Po pierwszym uruchomieniu żadnego parametru danych nie zmieniano (poprawiano tylko wygląd rysunków). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: 80 000 użytkowników, dwa warianty, cztery metryki
R
# Przepis 1. Fikcyjny serwis biletowy: test A/B nowego procesu zakupu biletu (2 × 40 000 użytkowników)
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("A: obecny proces" = "#0072B2", "B: nowy proces" = "#D55E00",
         "Nie-gorszość wykazana" = "#009E73", "Nierozstrzygnięte" = "#E69F00", "Gorsza ponad margines" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (prawdziwe wartości w populacji – w danych prawdziwych są nieznane)
n_wariant   <- 40000                                 # użytkowników w każdym wariancie (losowy przydział 1 : 1)
p_zakup     <- c(A = 0.060, B = 0.066)               # metryka główna: zakup biletu (konwersja)
p_zwrot     <- c(A = 0.040, B = 0.042)               # ochronna 1: zwrot biletu wśród kupujących
p_zgloszenie <- c(A = 0.025, B = 0.031)              # ochronna 2: zgłoszenie do obsługi wśród kupujących
sr_czas     <- c(A = 2.00, B = 2.05)                 # ochronna 3: średni czas ładowania strony zakupu (s)
sdlog_czas  <- 0.45                                  # rozrzut czasu ładowania (rozkład log-normalny)

set.seed(719)
bilety <- data.frame(wariant = rep(c("A", "B"), each = n_wariant))
w <- bilety$wariant
bilety$zakup <- rbinom(nrow(bilety), 1, p_zakup[w])
bilety$zwrot <- ifelse(bilety$zakup == 1, rbinom(nrow(bilety), 1, p_zwrot[w]), NA)
bilety$zgloszenie <- ifelse(bilety$zakup == 1, rbinom(nrow(bilety), 1, p_zgloszenie[w]), NA)
bilety$czas_s <- round(rlnorm(nrow(bilety), log(sr_czas[w]) - sdlog_czas^2 / 2, sdlog_czas), 2)

write.csv(bilety, "metryki-ochronne-test-ab-bilety.csv", row.names = FALSE)
podsum <- data.frame(
  uzytkownicy = tapply(bilety$zakup, w, length), kupujacy = tapply(bilety$zakup, w, sum),
  konwersja_proc = 100 * tapply(bilety$zakup, w, mean),
  zwroty = tapply(bilety$zwrot, w, sum, na.rm = TRUE), zwroty_proc = 100 * tapply(bilety$zwrot, w, mean, na.rm = TRUE),
  zgloszenia = tapply(bilety$zgloszenie, w, sum, na.rm = TRUE),
  zgloszenia_proc = 100 * tapply(bilety$zgloszenie, w, mean, na.rm = TRUE),
  czas_srednia_s = tapply(bilety$czas_s, w, mean), czas_mediana_s = tapply(bilety$czas_s, w, median))
round(podsum, 3)
Wynik w R
  uzytkownicy kupujacy konwersja_proc zwroty zwroty_proc zgloszenia zgloszenia_proc czas_srednia_s czas_mediana_s
A       40000     2382          5.955     91       3.820         66           2.771          2.004           1.81
B       40000     2593          6.482    108       4.165         73           2.815          2.051           1.85
2. Metryka główna: Rysunek 1
R
# Przepis 2. Metryka główna: konwersja w wariantach A i B, różnica z 95% CI i test z: Rysunek 1
x <- tapply(bilety$zakup, bilety$wariant, sum); n <- tapply(bilety$zakup, bilety$wariant, length)
glowna_test <- prop.test(x[c("B", "A")], n[c("B", "A")], correct = FALSE)   # test z dla dwóch proporcji
glowna <- data.frame(wariant = names(x), kupujacy = as.vector(x), uzytkownicy = as.vector(n), p = as.vector(x / n))
glowna$ci_dol <- glowna$p - 1.96 * sqrt(glowna$p * (1 - glowna$p) / glowna$uzytkownicy)
glowna$ci_gora <- glowna$p + 1.96 * sqrt(glowna$p * (1 - glowna$p) / glowna$uzytkownicy)
roznica_glowna <- c(roznica_pp = 100 * (glowna$p[2] - glowna$p[1]),
                    ci_dol_pp = 100 * glowna_test$conf.int[1], ci_gora_pp = 100 * glowna_test$conf.int[2],
                    wzrost_wzgl_proc = 100 * (glowna$p[2] / glowna$p[1] - 1),
                    z = sqrt(unname(glowna_test$statistic)), p = glowna_test$p.value)
round(roznica_glowna, 4)

glowna$etykieta <- sprintf("%.2f%%\n%d / %d", 100 * glowna$p, glowna$kupujacy, glowna$uzytkownicy)
glowna$wariant_opis <- factor(c("A: obecny proces", "B: nowy proces"), levels = c("A: obecny proces", "B: nowy proces"))
p1 <- ggplot(glowna, aes(wariant_opis, 100 * p)) +
  geom_col(aes(fill = wariant_opis), width = 0.55, alpha = 0.85) +
  geom_errorbar(aes(ymin = 100 * ci_dol, ymax = 100 * ci_gora), width = 0.15, colour = "grey20") +
  geom_text(aes(y = 100 * ci_gora + 0.15, label = etykieta), vjust = 0, size = 4.2, lineheight = 0.95) +
  annotate("text", x = 1.5, y = 8.2, size = 4.2, colour = "#0f1d3a",
           label = minus(sprintf("różnica B − A: +%.2f pp, 95%% CI [%.2f, %.2f]\nwzrost względny %.1f%%, p = %s",
                                 roznica_glowna["roznica_pp"], roznica_glowna["ci_dol_pp"], roznica_glowna["ci_gora_pp"],
                                 roznica_glowna["wzrost_wzgl_proc"], sub("^0", "", sprintf("%.3f", roznica_glowna["p"]))))) +
  scale_fill_manual(values = kol, guide = "none") +
  scale_y_continuous(limits = c(0, 9), breaks = 0:9, expand = expansion(mult = c(0, 0.02))) +
  labs(title = "Metryka główna: odsetek użytkowników, którzy kupili bilet",
       subtitle = "Słupki – odsetek, wąsy – 95% przedział ufności", x = NULL, y = "Konwersja (%)") +
  motyw
p1   # zapis: ggsave("metryki-ochronne-konwersja.svg", p1, width = 10, height = 5.2)
Wynik w R
      roznica_pp        ci_dol_pp       ci_gora_pp wzrost_wzgl_proc                z                p
          0.5275           0.1928           0.8622           8.8581           3.0891           0.0020
3. Metryki ochronne: test nie-gorszości i poprawka Holma: Rysunek 2
R
# Przepis 3. Metryki ochronne: test nie-gorszości (jednostronny, α = .05) i zwykły test różnicy: Rysunek 2
# Marginesy ustalone i zapisane PRZED testem: o ile metryka może się pogorszyć, by zmiana nadal się opłacała.
margines <- c(zwrot = 1.0, zgloszenie = 0.5, czas_s = 0.20)   # pp, pp, sekundy
alfa <- 0.05                                                  # jednostronnie, czyli górna granica 90% CI

nie_gorszosc_odsetek <- function(y, wariant, delta_pp) {      # większy odsetek = gorzej
  xa <- sum(y[wariant == "A"]); na <- sum(wariant == "A"); xb <- sum(y[wariant == "B"]); nb <- sum(wariant == "B")
  pa <- xa / na; pb <- xb / nb
  roznica <- 100 * (pb - pa)
  se <- 100 * sqrt(pa * (1 - pa) / na + pb * (1 - pb) / nb)  # błąd standardowy Walda (bez łączenia proporcji)
  zwykly <- suppressWarnings(prop.test(c(xb, xa), c(nb, na), correct = FALSE))   # H0: brak różnicy (dwustronnie)
  data.frame(A = 100 * pa, B = 100 * pb, n_A = na, n_B = nb, roznica = roznica,
             ci90_dol = roznica - qnorm(1 - alfa) * se, ci90_gora = roznica + qnorm(1 - alfa) * se,
             margines = delta_pp, p_zwykly = zwykly$p.value,
             p_nie_gorszosc = pnorm((roznica - delta_pp) / se))  # H0: pogorszenie ≥ margines
}
kup <- bilety[bilety$zakup == 1, ]                            # zwroty i zgłoszenia liczymy wśród kupujących
ochronne <- rbind(
  cbind(metryka = "Zwroty biletów (%)", nie_gorszosc_odsetek(kup$zwrot, kup$wariant, margines["zwrot"])),
  cbind(metryka = "Zgłoszenia do obsługi (%)", nie_gorszosc_odsetek(kup$zgloszenie, kup$wariant, margines["zgloszenie"])))

# Czas ładowania: średnie, test Welcha; nie-gorszość = przesunięta hipoteza zerowa (mu = margines)
cz_b <- bilety$czas_s[bilety$wariant == "B"]; cz_a <- bilety$czas_s[bilety$wariant == "A"]
welch_ci <- t.test(cz_b, cz_a, conf.level = 1 - 2 * alfa)                     # dwustronny 90% CI
welch_ng <- t.test(cz_b, cz_a, mu = margines["czas_s"], alternative = "less") # H0: różnica ≥ 0.20 s
ochronne <- rbind(ochronne, data.frame(metryka = "Czas ładowania (s)", A = mean(cz_a), B = mean(cz_b),
  n_A = length(cz_a), n_B = length(cz_b), roznica = mean(cz_b) - mean(cz_a),
  ci90_dol = welch_ci$conf.int[1], ci90_gora = welch_ci$conf.int[2], margines = margines["czas_s"],
  p_zwykly = t.test(cz_b, cz_a)$p.value, p_nie_gorszosc = welch_ng$p.value))
ochronne$p_zwykly_holm <- p.adjust(ochronne$p_zwykly, method = "holm")  # „czy któraś metryka się pogorszyła?”
ochronne$werdykt <- ifelse(ochronne$ci90_gora < ochronne$margines, "Nie-gorszość wykazana",
                    ifelse(ochronne$ci90_dol > ochronne$margines, "Gorsza ponad margines", "Nierozstrzygnięte"))
rownames(ochronne) <- NULL
pokaz <- ochronne; num <- sapply(pokaz, is.numeric); pokaz[num] <- lapply(pokaz[num], signif, 4)
pokaz

ochronne$metryka <- factor(ochronne$metryka, levels = ochronne$metryka)
ochronne$werdykt <- factor(ochronne$werdykt, levels = c("Nie-gorszość wykazana", "Nierozstrzygnięte", "Gorsza ponad margines"))
fp <- function(p) ifelse(p < .001, "p < .001", paste("p =", sub("^0", "", sprintf("%.3f", p))))
ochronne$etykieta <- paste0(minus(sprintf("B − A: %+.2f, 90%% CI [%.2f, %.2f]", ochronne$roznica, ochronne$ci90_dol,
  ochronne$ci90_gora)), " · zwykły test: ", fp(ochronne$p_zwykly), " · nie-gorszość: ", fp(ochronne$p_nie_gorszosc))
granice <- data.frame(metryka = ochronne$metryka, lo = c(-1.5, -1, -0.1), hi = c(2, 1.1, 0.3))
ochronne$lo <- granice$lo
p2 <- ggplot(ochronne, aes(roznica, 1)) +
  geom_blank(data = granice, aes(x = lo, y = 1)) + geom_blank(data = granice, aes(x = hi, y = 1)) +
  geom_rect(aes(xmin = margines, xmax = Inf, ymin = -Inf, ymax = Inf), fill = "#D55E00", alpha = 0.08) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_vline(aes(xintercept = margines), linetype = "dashed", colour = "#D55E00", linewidth = 0.8) +
  geom_errorbar(aes(xmin = ci90_dol, xmax = ci90_gora), width = 0.25, orientation = "y", colour = "grey25") +
  geom_point(aes(colour = werdykt, shape = werdykt), size = 4) +
  geom_label(aes(x = lo, label = etykieta), y = 1.6, hjust = 0, size = 3.6, colour = "grey15", fill = "white",
             border.colour = NA, label.padding = unit(0.1, "lines")) +
  geom_text(aes(x = margines, label = "margines"), y = 0.45, hjust = -0.08, size = 3.6, colour = "#D55E00") +
  facet_wrap(~ metryka, ncol = 1, scales = "free_x") +
  scale_y_continuous(limits = c(0.3, 1.85), breaks = NULL) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c("Nie-gorszość wykazana" = 16,
    "Nierozstrzygnięte" = 17, "Gorsza ponad margines" = 15), name = NULL) +
  labs(title = "Metryki ochronne: różnica B − A z 90% przedziałem i marginesem",
       subtitle = "Nie-gorszość wykazana, gdy cały przedział leży na lewo od marginesu", x = "Różnica B − A (pp lub s)", y = NULL) +
  motyw
p2   # zapis: ggsave("metryki-ochronne-nie-gorszosc.svg", p2, width = 10, height = 7)
Wynik w R
                    metryka     A     B   n_A   n_B roznica ci90_dol ci90_gora margines  p_zwykly p_nie_gorszosc
1        Zwroty biletów (%) 3.820 4.165  2382  2593 0.34470 -0.56840    1.2580      1.0 5.353e-01      1.189e-01
2 Zgłoszenia do obsługi (%) 2.771 2.815  2382  2593 0.04449 -0.72460    0.8136      0.5 9.242e-01      1.650e-01
3        Czas ładowania (s) 2.004 2.051 40000 40000 0.04723  0.03606    0.0584      0.2 3.565e-12     5.191e-112
  p_zwykly_holm               werdykt
1      1.00e+00     Nierozstrzygnięte
2      1.00e+00     Nierozstrzygnięte
3      1.07e-11 Nie-gorszość wykazana
4. Symulacja: zwykły test a test nie-gorszości: Rysunek 3
R
# Przepis 4. Symulacja: „brak istotnego pogorszenia” to nie „brak pogorszenia” (zgłoszenia do obsługi): Rysunek 3
# 10 000 testów A/B dla każdej liczby użytkowników; zgłoszenia liczone wśród kupujących, margines 0.5 pp.
set.seed(7191)
powt <- 10000
n_uzytk <- c(10000, 20000, 40000, 80000, 160000, 320000)        # użytkowników w każdym wariancie
scenariusze <- c("Brak zmiany (B − A = 0 pp)" = 0, "Pogorszenie ponad margines (+0.6 pp)" = 0.006)
symuluj <- function(n, wzrost) {
  kup_a <- rbinom(powt, n, 0.060); kup_b <- rbinom(powt, n, 0.066)          # kupujący w wariantach
  x_a <- rbinom(powt, kup_a, 0.025); x_b <- rbinom(powt, kup_b, 0.025 + wzrost)  # zgłoszenia
  pa <- x_a / kup_a; pb <- x_b / kup_b
  se <- sqrt(pa * (1 - pa) / kup_a + pb * (1 - pb) / kup_b)
  p_wsp <- (x_a + x_b) / (kup_a + kup_b)                                    # zwykły test z (proporcja wspólna)
  z_zwykly <- (pb - pa) / sqrt(p_wsp * (1 - p_wsp) * (1 / kup_a + 1 / kup_b))
  c(brak_istotnego_pogorszenia = mean(!(abs(z_zwykly) > qnorm(0.975) & pb > pa)),
    nie_gorszosc_wykazana = mean(pb - pa + qnorm(0.95) * se < 0.005))
}
sym <- do.call(rbind, lapply(names(scenariusze), function(s) do.call(rbind, lapply(n_uzytk, function(n)
  data.frame(scenariusz = s, uzytkownicy = n, kupujacy_srednio = round(n * 0.063), t(symuluj(n, scenariusze[s])))))))
pokaz <- sym; pokaz[, 4:5] <- round(100 * pokaz[, 4:5], 1)
pokaz                                               # odsetki symulacji (%)
c(najwiekszy_blad_MC_pp = round(100 * sqrt(0.25 / powt), 2))   # błąd Monte Carlo odsetka (najgorszy przypadek)

dl <- rbind(data.frame(sym[, 1:2], wynik = "Zwykły test: brak istotnego pogorszenia", proc = 100 * sym$brak_istotnego_pogorszenia),
            data.frame(sym[, 1:2], wynik = "Test nie-gorszości: nie-gorszość wykazana", proc = 100 * sym$nie_gorszosc_wykazana))
dl$scenariusz <- factor(dl$scenariusz, levels = names(scenariusze), labels = paste0(c("A. ", "B. "), names(scenariusze)))
kol_sym <- c("Zwykły test: brak istotnego pogorszenia" = "#E69F00", "Test nie-gorszości: nie-gorszość wykazana" = "#009E73")
p3 <- ggplot(dl, aes(uzytkownicy, proc, colour = wynik, shape = wynik, linetype = wynik)) +
  geom_line(linewidth = 1) + geom_point(size = 3) +
  geom_text(aes(label = sprintf("%.1f", proc), vjust = ifelse(grepl("^Zwykły", wynik), -0.9, 1.9)), size = 3.5,
            show.legend = FALSE) +
  facet_wrap(~ scenariusz, ncol = 2) +
  scale_x_log10(breaks = n_uzytk, labels = c("10 tys.", "20 tys.", "40 tys.", "80 tys.", "160 tys.", "320 tys.")) +
  scale_y_continuous(limits = c(-6, 108), breaks = seq(0, 100, 20)) +
  scale_colour_manual(values = kol_sym, name = NULL) + scale_shape_manual(values = c("Zwykły test: brak istotnego pogorszenia" = 17,
                                                                       "Test nie-gorszości: nie-gorszość wykazana" = 16), name = NULL) +
  scale_linetype_manual(values = c("Zwykły test: brak istotnego pogorszenia" = "dashed",
                                   "Test nie-gorszości: nie-gorszość wykazana" = "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), shape = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "Zgłoszenia do obsługi: co mówią oba testy w 10 000 symulowanych testach A/B",
       x = "Użytkownicy w każdym wariancie (skala log)", y = "Odsetek symulacji (%)") +
  motyw + theme(axis.text.x = element_text(angle = 30, hjust = 1))
p3   # zapis: ggsave("metryki-ochronne-symulacja.svg", p3, width = 10, height = 6)
Wynik w R
                             scenariusz uzytkownicy kupujacy_srednio brak_istotnego_pogorszenia nie_gorszosc_wykazana
1            Brak zmiany (B − A = 0 pp)       10000              630                       98.0                  14.3
2            Brak zmiany (B − A = 0 pp)       20000             1260                       97.5                  20.4
3            Brak zmiany (B − A = 0 pp)       40000             2520                       97.6                  31.2
4            Brak zmiany (B − A = 0 pp)       80000             5040                       97.7                  48.9
5            Brak zmiany (B − A = 0 pp)      160000            10080                       97.5                  72.9
6            Brak zmiany (B − A = 0 pp)      320000            20160                       97.4                  94.0
7  Pogorszenie ponad margines (+0.6 pp)       10000              630                       91.4                   4.2
8  Pogorszenie ponad margines (+0.6 pp)       20000             1260                       85.9                   3.8
9  Pogorszenie ponad margines (+0.6 pp)       40000             2520                       75.1                   3.3
10 Pogorszenie ponad margines (+0.6 pp)       80000             5040                       55.7                   2.4
11 Pogorszenie ponad margines (+0.6 pp)      160000            10080                       26.3                   1.9
12 Pogorszenie ponad margines (+0.6 pp)      320000            20160                        4.4                   1.3
najwiekszy_blad_MC_pp
                  0.5
5. Moc i liczebność dla metryki głównej i ochronnych: Rysunek 4
R
# Przepis 5. Moc: metryka główna (test przewagi) a metryki ochronne (test nie-gorszości): Rysunek 4
# Wzory przybliżenia normalnego; dla ochronnych zakładamy, że prawdziwej zmiany nie ma (B − A = 0).
moc <- function(n) {                                   # n – użytkowników w każdym wariancie
  kup_a <- n * 0.060; kup_b <- n * 0.066                # oczekiwana liczba kupujących
  se_g <- sqrt(0.060 * 0.940 / n + 0.066 * 0.934 / n)
  se_zw <- sqrt(0.040 * 0.960 * (1 / kup_a + 1 / kup_b))
  se_zg <- sqrt(0.025 * 0.975 * (1 / kup_a + 1 / kup_b))
  sd_czas <- 2 * sqrt(exp(0.45^2) - 1)                  # SD rozkładu log-normalnego o średniej 2 s
  se_cz <- sd_czas * sqrt(2 / n)
  c("Główna: konwersja +0.6 pp (dwustronnie)" = pnorm(0.006 / se_g - qnorm(0.975)),
    "Ochronna: zwroty, margines 1 pp" = pnorm(0.010 / se_zw - qnorm(0.95)),
    "Ochronna: zgłoszenia, margines 0.5 pp" = pnorm(0.005 / se_zg - qnorm(0.95)),
    "Ochronna: czas ładowania, margines 0.2 s" = pnorm(0.20 / se_cz - qnorm(0.95)))
}
potrzeba <- sapply(1:4, function(j) uniroot(function(n) moc(n)[j] - 0.80, c(100, 1e7))$root)
names(potrzeba) <- names(moc(1000))
data.frame(uzytkownicy_na_wariant_dla_mocy_80 = round(potrzeba), kupujacy_na_wariant = round(potrzeba * 0.063),
           tygodnie_testu = round(potrzeba / 20000, 1))   # ruch: 20 000 użytkowników na wariant tygodniowo
round(100 * moc(40000), 1)                             # moc w naszym teście (40 000 na wariant), %

siatka <- 10^seq(log10(100), log10(1e6), length.out = 160)
dm <- do.call(rbind, lapply(siatka, function(n) data.frame(n = n, metryka = names(moc(n)), moc = 100 * moc(n))))
dm$metryka <- factor(dm$metryka, levels = names(potrzeba))
punkty <- data.frame(metryka = factor(names(potrzeba), levels = names(potrzeba)), n = potrzeba,
                     etykieta = ifelse(potrzeba < 1000, sprintf("%.0f", potrzeba), sprintf("%.0f tys.", potrzeba / 1000)))
kol_moc <- setNames(c("#000000", "#0072B2", "#D55E00", "#009E73"), names(potrzeba))
p4 <- ggplot(dm, aes(n, moc, colour = metryka, linetype = metryka)) +
  geom_hline(yintercept = 80, linetype = "dotted", colour = "grey30") +
  geom_vline(xintercept = 40000, colour = "grey60") +
  annotate("text", x = 40000, y = 3, label = "nasz test:\n40 tys.", hjust = -0.08, size = 3.5, colour = "grey30") +
  geom_line(linewidth = 1.1) +
  geom_point(data = punkty, aes(n, 80), size = 3, show.legend = FALSE) +
  geom_text(data = punkty, aes(n, 80, label = etykieta), vjust = -0.9, hjust = 0.3, size = 3.6, show.legend = FALSE) +
  scale_x_log10(breaks = c(100, 1000, 10000, 1e5, 1e6), labels = c("100", "1 tys.", "10 tys.", "100 tys.", "1 mln")) +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) +
  scale_colour_manual(values = kol_moc, name = NULL) +
  scale_linetype_manual(values = setNames(c("solid", "longdash", "dashed", "dotdash"), names(potrzeba)), name = NULL) +
  guides(colour = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2)) +
  labs(title = "Moc testu według liczby użytkowników w każdym wariancie",
       subtitle = "Punkty – liczba użytkowników potrzebna do mocy 80%", x = "Użytkownicy w każdym wariancie (skala log)",
       y = "Moc (%)") +
  motyw
p4   # zapis: ggsave("metryki-ochronne-moc.svg", p4, width = 10, height = 6)
Wynik w R
                                         uzytkownicy_na_wariant_dla_mocy_80 kupujacy_na_wariant tygodnie_testu
Główna: konwersja +0.6 pp (dwustronnie)                               25736                1621            1.3
Ochronna: zwroty, margines 1 pp                                       75540                4759            3.8
Ochronna: zgłoszenia, margines 0.5 pp                                191800               12083            9.6
Ochronna: czas ładowania, margines 0.2 s                                278                  17            0.0
 Główna: konwersja +0.6 pp (dwustronnie)          Ochronna: zwroty, margines 1 pp
                                    93.7                                     56.5
   Ochronna: zgłoszenia, margines 0.5 pp Ochronna: czas ładowania, margines 0.2 s
                                    30.5                                    100.0
6. Grafika: karta „reguła decyzji testu”: Rysunek 5
R
# Przepis 6. Grafika: karta „reguła decyzji testu” (metryka główna × metryki ochronne): Rysunek 5
# Korzysta z roznica_glowna (przepis 2) i ochronne (przepis 3).
kolumny <- c("Wszystkie ochronne:\nnie-gorszość wykazana", "Któraś ochronna:\nnierozstrzygnięta", "Któraś ochronna:\ngorsza ponad margines")
wiersze <- c("Główna lepsza\n(CI powyżej 0)", "Główna\nnierozstrzygnięta", "Główna gorsza\n(CI poniżej 0)")
karta <- expand.grid(k = 1:3, w = 1:3)
karta$decyzja <- c("WDRAŻAJ", "CZEKAJ", "NIE WDRAŻAJ",
                   "WYBÓR BIZNESOWY", "NIE WDRAŻAJ", "NIE WDRAŻAJ",
                   "NIE WDRAŻAJ", "NIE WDRAŻAJ", "NIE WDRAŻAJ")
karta$opis <- c("zysk jest, szkody\nponad margines nie ma",
                "zbierz dane dla tej metryki\n(dłuższy test lub kontrola\npo wdrożeniu z progiem stopu)",
                "zysk nie pokrywa szkody;\npopraw zmianę i testuj ponownie",
                "zmiana bezpieczna,\nzysk niepewny – zdecyduj\nz innych powodów",
                "test nic nie rozstrzygnął", "szkoda bez zysku",
                 rep("zmiana pogarsza to,\nco miała poprawić", 3))
karta$rodzaj <- ifelse(karta$decyzja == "WDRAŻAJ", "tak", ifelse(karta$decyzja == "NIE WDRAŻAJ", "nie", "czekaj"))
karta$x <- karta$k; karta$y <- 4 - karta$w
nasz <- minus(sprintf("Nasz test (ramka): konwersja +%.2f pp, 95%% CI [%.2f, %.2f]; górne granice 90%% CI: zwroty %.2f > 1 pp,\nzgłoszenia %.2f > 0.5 pp; czas ładowania %.2f < 0.2 s",
  roznica_glowna["roznica_pp"], roznica_glowna["ci_dol_pp"], roznica_glowna["ci_gora_pp"],
  ochronne$ci90_gora[1], ochronne$ci90_gora[2], ochronne$ci90_gora[3]))
p5 <- ggplot(karta) +
  geom_tile(aes(x, y, fill = rodzaj), colour = "white", linewidth = 2, width = 0.98, height = 0.98) +
  geom_tile(data = karta[2, ], aes(x, y), fill = NA, colour = "#0f1d3a", linewidth = 1.6, width = 0.94, height = 0.94) +
  geom_text(aes(x, y + 0.3, label = decyzja), fontface = "bold", size = 4.6, colour = "#0f1d3a") +
  geom_text(aes(x, y - 0.02, label = opis), size = 3.6, lineheight = 0.95, colour = "grey15") +
  annotate("text", x = 1:3, y = 3.72, label = kolumny, size = 3.8, fontface = "bold", lineheight = 0.95, colour = "#0f1d3a") +
  annotate("text", x = 0.04, y = 3:1, label = wiersze, size = 3.8, fontface = "bold", lineheight = 0.95, hjust = 0.5,
           colour = "#0f1d3a") +
  scale_fill_manual(values = c(tak = "#CDEBDD", czekaj = "#FBE3B5", nie = "#F6D0BE"), guide = "none") +
  coord_cartesian(xlim = c(-0.45, 3.5), ylim = c(0.48, 3.95), expand = FALSE) +
  labs(title = "Reguła decyzji testu A/B z metrykami ochronnymi", subtitle = nasz, x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank(),
                plot.subtitle = element_text(size = 10.5, colour = "grey25"))
p5   # zapis: ggsave("metryki-ochronne-regula-decyzji.svg", p5, width = 10, height = 6.4)
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("A – B" = c("#0072B2", "#D55E00"), "wykazana – nierozstrzygnięte" = c("#009E73", "#E69F00"),
             "nierozstrzygnięte – gorsza" = c("#E69F00", "#D55E00"), "zwroty – zgłoszenia (moc)" = c("#0072B2", "#D55E00"),
             "główna – czas ładowania (moc)" = c("#000000", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
A – B                                      114.6        108.3       91.9
wykazana – nierozstrzygnięte                88.7         66.3       51.5
nierozstrzygnięte – gorsza                  33.4         18.4       24.9
zwroty – zgłoszenia (moc)                  114.6        108.3       91.9
główna – czas ładowania (moc)               74.8         56.6       63.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, test z (prop.test), test Welcha (t.test), poprawka Holma (p.adjust) i rozkład normalny – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Metryka liczona wśród kupujących. B ma 2593 kupujących, A – 2382. Dodatkowi kupujący mogą być inni (mniej zdecydowani), więc porównanie „na kupującego” nie porównuje już losowych grup. Sprawdź też zwroty na 1000 użytkowników.
- Niestaranny pomiar ułatwia „nie-gorszość”. Błędy w zliczaniu zbliżają warianty do siebie: im mniej starannie prowadzone badanie, tym łatwiej wykazać nie-gorszość (Schumi i Wittes, 2011).
- Mało zdarzeń. Przedział Walda dla różnicy odsetków działa dobrze dopiero przy dużych próbach (Fagerland i in., 2015). Przy kilkunastu zwrotach w wariancie użyj przedziału Newcombe’a.
- Średnia czasu ładowania ukrywa ogon. Czas jest prawostronnie skośny (mediany 1.81 i 1.85 s przy średnich 2.00 i 2.05 s). Gdy zależy Ci na najwolniejszych ładowaniach, zdefiniuj metrykę jako odsetek ładowań powyżej progu – o skośnych metrykach jest wpis czas na stronie.
- Nie-gorszość to nie równoważność. Gdy problemem jest zmiana w obie strony, użyj dwóch testów jednostronnych (Lakens i in., 2018).
- Losowanie całych grup. Gdy losujesz sklepy lub miasta, a nie użytkowników, przedziały muszą uwzględnić skupienie – zob. eksperyment w sklepach stacjonarnych.
Najczęstsze pytania
Co to są metryki ochronne w teście A/B?
To wskaźniki, które zmiana ma nie pogorszyć, choć jej celem jest poprawa innej metryki. W sklepie czy serwisie biletowym to np. odsetek zwrotów, zgłoszenia do obsługi, wypisania z listy albo czas ładowania strony. Ustala się je przed testem razem z marginesem dopuszczalnego pogorszenia.
Czym test nie-gorszości różni się od zwykłego testu?
Zwykły test zakłada w hipotezie zerowej brak różnicy, więc wynik nieistotny nie dowodzi, że nic się nie pogorszyło. Test nie-gorszości zakłada, że wariant jest gorszy o margines lub więcej, i odrzuca to tylko wtedy, gdy górna granica przedziału ufności różnicy leży poniżej marginesu. W przykładzie zgłoszenia miały p = .924 w zwykłym teście, a nie-gorszości nie wykazano.
Jak wybrać margines nie-gorszości w teście A/B?
Przed testem, z rachunku (jakie pogorszenie zjada zysk z metryki głównej), możliwości zespołu (np. ile zgłoszeń przyjmie obsługa) i zwykłych wahań metryki. Zapisz, czy margines jest bezwzględny, czy względny, i nie zmieniaj go po zobaczeniu wyników.
Czy przy kilku metrykach ochronnych trzeba stosować poprawkę Holma?
Zależy od pytania. Jeśli szukasz alarmu „czy któraś metryka się pogorszyła?”, poprawka Holma ogranicza fałszywe alarmy. Jeśli wdrożenie wymaga wykazania nie-gorszości we wszystkich metrykach naraz, poprawka nie jest potrzebna, bo błąd wymagałby pomyłki testu właśnie tej metryki, która naprawdę się pogorszyła.
Dlaczego metryka ochronna potrzebuje większej próby niż metryka główna?
Bo często jest rzadka, liczona tylko wśród części użytkowników (np. kupujących) i ma wąski margines. W przykładzie moc 80% dla konwersji dawało 25 736 użytkowników na wariant, dla zwrotów 75 540, a dla zgłoszeń do obsługi 191 800; przy 40 000 moc dla zgłoszeń wynosiła 30.5%.
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikBadanie non-inferiority i równoważności
Margines Δ, test jednostronny i przedział ufności, ITT i per protocol, TOST, liczebność próby, przykład w R i wzór opisu wyników.
Czytaj →Analizujesz test A/B albo piszesz o nim pracę?
Pomożemy dobrać metryki ochronne i marginesy, policzyć liczebność, przeprowadzić testy nie-gorszości i opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Althunian, T. A., de Boer, A., Groenwold, R. H. H., & Klungel, O. H. (2017). Defining the noninferiority margin and analysing noninferiority: An overview. British Journal of Clinical Pharmacology, 83(8), 1636–1642. https://doi.org/10.1111/bcp.13280 ● Otwarty dostęp
- Fagerland, M. W., Lydersen, S., & Laake, P. (2015). Recommended confidence intervals for two independent binomial proportions. Statistical Methods in Medical Research, 24(2), 224–254. https://doi.org/10.1177/0962280211415469
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Schumi, J., & Wittes, J. T. (2011). Through the looking glass: Understanding non-inferiority. Trials, 12(1), Article 106. https://doi.org/10.1186/1745-6215-12-106 ● Otwarty dostęp
- Walker, E., & Nowacki, A. S. (2011). Understanding equivalence and noninferiority testing. Journal of General Internal Medicine, 26(2), 192–196. https://doi.org/10.1007/s11606-010-1513-8 ● Otwarty dostęp
Cytowania BibTeX
@article{althunian2017defining, author={Althunian, Turki A. and de Boer, Anthonius and Groenwold, Rolf H. H. and Klungel, Olaf H.}, title={{Defining the noninferiority margin and analysing noninferiority: An overview}}, journal={British Journal of Clinical Pharmacology}, year={2017}, volume={83}, number={8}, pages={1636--1642}, doi={10.1111/bcp.13280}}@article{fagerland2015recommended, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{Recommended confidence intervals for two independent binomial proportions}}, journal={Statistical Methods in Medical Research}, year={2015}, volume={24}, number={2}, pages={224--254}, doi={10.1177/0962280211415469}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{schumi2011through, author={Schumi, Jennifer and Wittes, Janet T.}, title={{Through the looking glass: Understanding non-inferiority}}, journal={Trials}, year={2011}, volume={12}, number={1}, eid={106}, doi={10.1186/1745-6215-12-106}}@article{walker2011understanding, author={Walker, Esteban and Nowacki, Amy S.}, title={{Understanding equivalence and noninferiority testing}}, journal={Journal of General Internal Medicine}, year={2011}, volume={26}, number={2}, pages={192--196}, doi={10.1007/s11606-010-1513-8}}