Kiedy pytasz „czy nie gorsza”, a kiedy „czy taka sama”
Klasyczne badanie randomizowane ma wykazać przewagę nowej interwencji. Coraz częściej cel jest jednak inny. Nowa forma terapii ma być tańsza, krótsza, dostępna zdalnie albo lepiej tolerowana i wystarczy, że nie będzie niedopuszczalnie gorsza od standardu. Takie pytanie zadaje badanie non-inferiority (ang. non-inferiority trial). Badanie równoważności (ang. equivalence trial) idzie dalej: sprawdza, czy różnica nie przekracza marginesu w żadną stronę.
W obu schematach role hipotez są odwrócone w stosunku do testu przewagi. Hipoteza zerowa mówi, że nowa interwencja jest gorsza o margines Δ lub więcej. Hipoteza alternatywna, którą chcesz wykazać, mówi, że różnica jest mniejsza niż Δ (Schumi i Wittes, 2011). Ciężar dowodu spoczywa więc na podobieństwie, a nie na różnicy (Walker i Nowacki, 2011). Jeśli potrzebujesz przypomnienia, jak działają hipoteza zerowa i alternatywna, zacznij od hasła w słowniku.
| Schemat | H0 | Co chcesz wykazać | Kryterium przy α = .05 (dwustronnie) lub .025 (jednostronnie) |
|---|---|---|---|
| Przewaga | różnica = 0 | różnica ≠ 0 | 95% CI nie obejmuje 0 |
| Non-inferiority | różnica ≥ Δ | różnica < Δ | górna granica 95% CI < Δ (test jednostronny na poziomie .025) |
| Równoważność | |różnica| ≥ Δ | −Δ < różnica < Δ | cały przedział (1 − 2α) w granicach ±Δ (procedura TOST) |
W tym wpisie przechodzimy przez plan i analizę badania non-inferiority z wynikiem ciągłym: wybór marginesu, test jednostronny i przedział ufności, analizę ITT i per protocol, liczebność oraz raport. Krótszą wersję z wynikiem binarnym znajdziesz w poradniku statystyka dla lekarza, a mechanikę testu równoważności w haśle test równoważności (TOST).
Margines Δ: najważniejsza decyzja w planie
Margines to największa różnica na niekorzyść nowej interwencji, którą jesteś gotów zaakceptować w zamian za jej inne zalety. To od niego zależy wynik testu i wiarygodność całego badania. Walker i Nowacki (2011) nazywają ustalenie marginesu najważniejszym krokiem i podkreślają, że trzeba to zrobić przed zebraniem danych. Althunian i in. (2017) opisują je jako jeden z najtrudniejszych etapów planowania. Regulatorzy zalecają opierać margines na historycznych danych o skuteczności aktywnego komparatora.
W praktyce margines wynika z dwóch przesłanek:
- Statystycznej. Nowa interwencja nie może stracić całej przewagi standardu nad brakiem leczenia. Często bierze się więc ułamek dolnej granicy przedziału ufności dla efektu standardu wobec placebo albo listy oczekujących, oszacowanego w metaanalizie (Walker i Nowacki, 2011).
- Klinicznej. Strata nie może przekraczać różnicy, którą pacjent lub klinicysta uznałby za istotną. Pomocne są tu pojęcia najmniejszego interesującego efektu (SESOI) i minimalnej istotnej klinicznie różnicy (MCID).
Margines, uzasadnienie i miarę efektu (różnica średnich, różnica ryzyk, iloraz) wpisz do rejestracji badania i planu analizy. Margines dobrany po obejrzeniu danych unieważnia test, podobnie jak w każdym teście równoważności (Lakens, 2017).
Przykład: internetowa CBT a terapia stacjonarna
Trzystu dorosłych z objawami depresji wylosowano do 12-tygodniowej terapii poznawczo-behawioralnej w gabinecie (standard, n = 150) albo do internetowej CBT z przewodnikiem (iCBT, n = 150). Objawy mierzono kwestionariuszem PHQ-9 (0–27 pkt, wyższy wynik oznacza silniejsze objawy; sposób liczenia opisujemy we wpisie GAD-7 i PHQ-9) przed terapią i po 12 tygodniach. Na potrzeby przykładu przyjmujemy, że terapia stacjonarna ma przewagę około 4 pkt nad listą oczekujących, a zespół zgodził się, że iCBT może stracić najwyżej połowę tej przewagi. Stąd Δ = 2 pkt. Dane są symulowane (set.seed(1532)) i możesz je pobrać jako plik CSV (300 wierszy: id, grupa, pre, post, odstepstwo).
| Grupa | n | Przed: M (SD) | Po: M (SD) | Odstępstwo od protokołu |
|---|---|---|---|---|
| Terapia stacjonarna | 150 | 15.11 (3.25) | 6.91 (4.85) | 31 |
| iCBT z przewodnikiem | 150 | 14.81 (3.25) | 7.63 (4.46) | 32 |
Odstępstwo oznacza udział w mniej niż połowie sesji lub modułów, co określono z góry w protokole. Wynik po 12 tygodniach zmierzono u wszystkich, także u osób, które przerwały terapię. W analizie, której używamy niżej, różnica oznacza iCBT − terapia stacjonarna, więc wartość dodatnia to wynik gorszy dla iCBT.
Test jednostronny i przedział ufności
Analizą główną jest ANCOVA wyniku po 12 tygodniach z pomiarem wyjściowym jako kowariantem. Daje to nieobciążone i bardziej precyzyjne oszacowanie niż porównanie samych wyników końcowych. Dlaczego, wyjaśniamy we wpisie ANCOVA w badaniu przed i po. W populacji ITT skorygowana różnica wyniosła 0.90 pkt, SE = 0.49, 95% CI [−0.06, 1.86].
Decyzję możesz podjąć na dwa równoważne sposoby:
- Przedział ufności. Górna granica dwustronnego 95% CI (1.86) leży poniżej Δ = 2, więc non-inferiority jest wykazana. Dwustronny 95% CI odpowiada jednostronnemu testowi na poziomie .025 (zob. test jednostronny i dwustronny).
- Test jednostronny. Testujesz H0: różnica ≥ 2. Statystyka to t = (0.90 − 2) / 0.49 = −2.25 przy 297 stopniach swobody, a jednostronne p = .013 jest mniejsze od .025.
Zwróć uwagę na zwykły test przewagi na tych samych danych: p = .065. Wynik nieistotny nie jest dowodem, że iCBT nie jest gorsza. To częsty błąd, który opisujemy we wpisie jak opisać wynik nieistotny. O wniosku decyduje położenie przedziału względem marginesu, a nie względem zera.
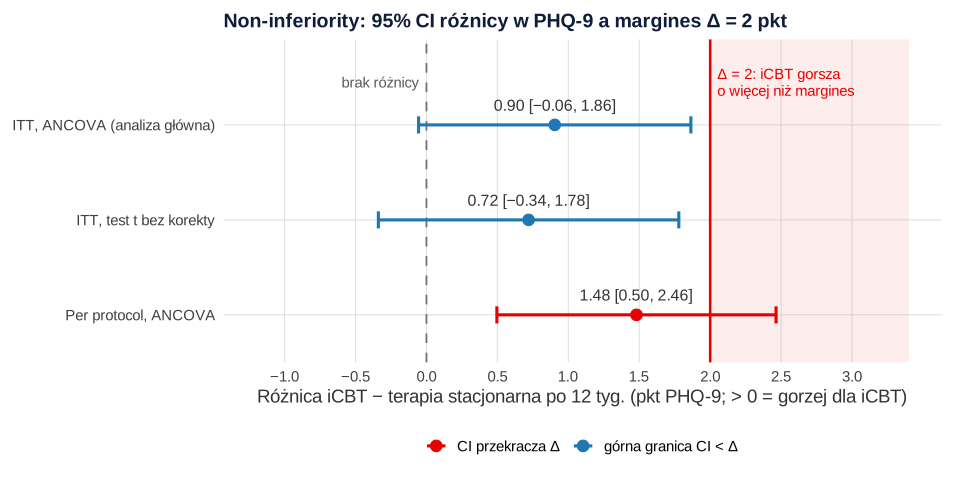
Analiza bez korekty o pomiar wyjściowy (test t Welcha) dała 0.72 pkt, 95% CI [−0.34, 1.78]. Wniosek jest ten sam, ale analizę główną trzeba wskazać w planie. Wybór tej z kilku analiz, która „przechodzi”, to ten sam problem co wybór najkorzystniejszego testu w badaniu przewagi.
ITT i per protocol: tu ITT nie jest ostrożniejsza
W badaniu przewagi analiza ITT obejmuje wszystkich zrandomizowanych według przydziału. Daje zwykle zachowawczą ocenę efektu, bo osoby, które nie przestrzegają protokołu, „rozmywają” różnicę między grupami (Gupta, 2011). W badaniu non-inferiority to rozmycie działa na korzyść tezy autora: mniejsza różnica oznacza, że łatwiej zmieścić się w marginesie. Walker i Nowacki (2011) nazywają ITT w tym kontekście analizą antykonserwatywną. Schumi i Wittes (2011) zauważają, że im mniej starannie prowadzone badanie, tym łatwiej wykazać non-inferiority.
Dlatego obok ITT pokaż analizę per protocol, obejmującą osoby bez odstępstw. W przykładzie z 300 osób zostało 237 (119 i 118):
| Populacja | n | Różnica (SE) | 95% CI | tNI (df) | p jednostronne | Wniosek |
|---|---|---|---|---|---|---|
| ITT (analiza główna) | 300 | 0.90 (0.49) | [−0.06, 1.86] | −2.25 (297) | .013 | górna granica < Δ |
| Per protocol | 237 | 1.48 (0.50) | [0.50, 2.46] | −1.04 (234) | .150 | CI przekracza Δ |
Analizy się rozchodzą. W symulacji iCBT jest u osób przestrzegających protokołu słabsza o 1.1 pkt, a podobny odsetek odstępstw w obu grupach ściąga różnicę ITT bliżej zera. Rozbieżność ITT i PP sugeruje, że to, kto wypadł z analizy, wiąże się z interwencją. Jeśli nie da się jej wyjaśnić, wniosek o non-inferiority jest słabszy (Walker i Nowacki, 2011). Pamiętaj też, że proste PP to porównanie obserwacyjne, które może być obciążone (Hernán i Robins, 2017). Uczciwy wniosek z przykładu brzmi więc: iCBT spełniła kryterium w analizie głównej, ale wynik nie jest odporny na wybór populacji.
Kryterium odstępstwa (np. próg adherencji) zapisz przed badaniem. Gdy brakuje wyników końcowych, ITT wymaga przemyślanego uzupełnienia braków (zob. imputacja wielokrotna w R) i analizy wrażliwości.
Równoważność na tych samych danych
Gdyby celem było wykazanie, że iCBT nie jest ani gorsza, ani lepsza o więcej niż 2 pkt, potrzebujesz dwóch testów jednostronnych (Schuirmann, 1987). Odpowiada to sprawdzeniu, czy 90% CI leży w granicach ±Δ. W ITT 90% CI wynosi [0.10, 1.71], a pTOST = .013, więc równoważność też jest spełniona. Zauważ, że 90% CI nie obejmuje zera: różnica może być jednocześnie „istotna” na poziomie jednostronnym i mieścić się w granicach równoważności. W PP 90% CI [0.66, 2.31] przekracza górną granicę. Szczegóły procedury TOST i jej zastosowania w psychologii opisują Lakens i in. (2018), a my w haśle o TOST.
Dobierz wariant do pytania. Gdy nowa interwencja może być lepsza i nie przeszkadza Ci to, wybierz non-inferiority. Gdy obie strony różnicy są problemem (np. zamiennik leku albo wersja testu, która ma dawać te same wyniki), wybierz równoważność.
Liczebność: margines rządzi próbą
Dla wyniku ciągłego liczebność na grupę liczysz jak w teście t z przesuniętą hipotezą zerową. Zamiast efektu do wykrycia podstawiasz Δ − θ, gdzie θ to prawdziwa różnica, której się spodziewasz. Przy SD = 4.5 pkt, α = .025 jednostronnie, mocy .90 i θ = 0 potrzeba 108 osób na grupę. Tyle samo potrzebowałby test przewagi wykrywający różnicę 2 pkt przy dwustronnym α = .05. Badanie non-inferiority nie jest więc „tańsze” od badania przewagi przy tym samym marginesie.
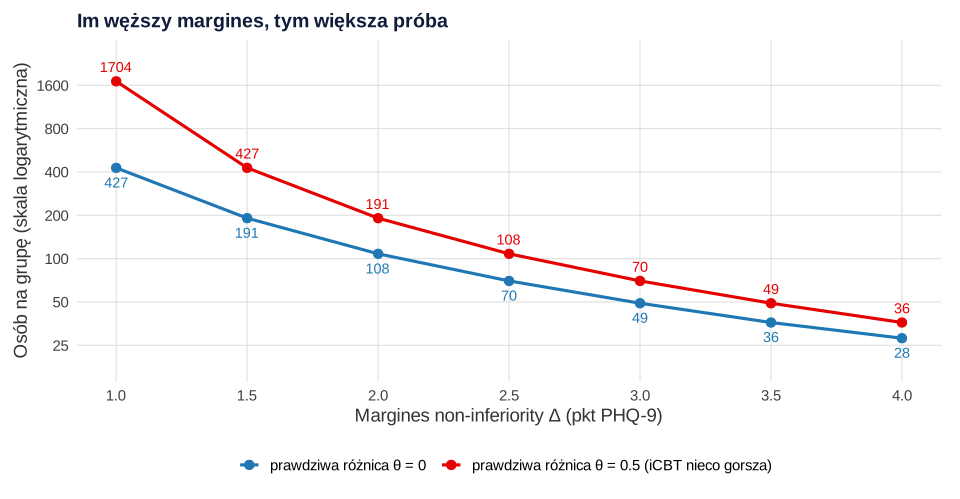
Dwa wnioski z rysunku. Zawężenie marginesu z 2 do 1 pkt zwiększa próbę z 108 do 427 osób na grupę. Jeśli zakładasz, że nowa interwencja jest nieco gorsza (θ = 0.5), przy Δ = 2 potrzeba już 191 osób. ANCOVA z pomiarem wyjściowym zmniejsza wymaganą próbę. Przy założonej korelacji pre–post .45 wystarczy 86 osób na grupę zamiast 108. Do wyniku dolicz odsetek osób, które mogą odpaść. Ogólne zasady planowania próby omawia wpis dobór liczebności próby.
Jak opisać badanie non-inferiority
Raporty takich badań mają rozszerzenie listy CONSORT (Piaggio i in., 2012). Z jego punktami, które różnią się od głównej listy, porównaj swój tekst przed wysłaniem. Ogólne wytyczne raportowania badań klinicznych omawiamy we wpisie statystyka w publikacji medycznej. Walker i Nowacki (2011) wymieniają minimum, którego oczekuje czytelnik:
- uzasadnienie, dlaczego pytasz o non-inferiority, a nie o przewagę;
- wartość marginesu i jego uzasadnienie;
- obliczenie liczebności uwzględniające margines i przewidywane odpadanie;
- populacje analizy oraz wyniki ITT i per protocol;
- informację, czy przedział ufności jest jedno- czy dwustronny, spójną z poziomem α z obliczeń liczebności.
Jeśli planujesz takie badanie albo odpowiadasz recenzentowi, który kwestionuje margines, możemy wspólnie sprawdzić plan analizy i obliczenia liczebności w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei. Pierwszy tworzy dane, zapisuje plik non-inferiority-dane.csv (możesz go pobrać tutaj) i liczy wszystkie analizy z tekstu. Drugi liczy liczebność. Wystarczają funkcje podstawowego R.
1. Analiza ITT, per protocol i TOST
R
# Dane symulowane: randomizowane badanie non-inferiority. Internetowa terapia poznawczo-behawioralna z przewodnikiem (iCBT)
# wobec terapii stacjonarnej (standard) w depresji; PHQ-9 (0–27, wyższy = silniejsze objawy) przed i po 12 tygodniach; N = 300
set.seed(1532)
n <- 150
grupa <- factor(rep(c("standard", "icbt"), each = n), levels = c("standard", "icbt"))
pre <- pmin(pmax(round(rnorm(2 * n, 15, 3.5)), 10), 27)
# odstępstwo od protokołu (np. mniej niż połowa sesji lub modułów) częstsze przy silniejszych objawach na starcie
p_odst <- plogis(qlogis(ifelse(grupa == "icbt", .22, .18)) + 0.12 * (pre - 15))
odstepstwo <- runif(2 * n) < p_odst
# u osób przestrzegających protokołu iCBT obniża objawy nieco słabiej niż terapia stacjonarna
spadek <- ifelse(odstepstwo, 3, ifelse(grupa == "icbt", 5.9, 7))
post <- pmin(pmax(round(4 + 0.6 * pre - spadek + rnorm(2 * n, 0, 4)), 0), 27)
dane <- data.frame(id = sprintf("p%03d", 1:(2 * n)), grupa, pre, post, odstepstwo)
write.csv(dane, "non-inferiority-dane.csv", row.names = FALSE)

margines <- 2        # Δ: iCBT może być gorsza najwyżej o 2 pkt PHQ-9 (ustalone przed badaniem)

# Statystyki opisowe w grupach
opis <- aggregate(cbind(pre, post) ~ grupa, data = dane, FUN = function(x) round(c(M = mean(x), SD = sd(x)), 2))
print(do.call(data.frame, opis), row.names = FALSE)
table(grupa = dane$grupa, odstepstwo = dane$odstepstwo)
round(cor(dane$pre, dane$post), 3)

# Funkcja: różnica iCBT − standard z ANCOVA, 95% CI, test jednostronny H0: różnica ≥ Δ, test przewagi i 90% CI
analiza_ni <- function(d, etykieta) {
  m <- lm(post ~ pre + grupa, data = d)
  est <- coef(m)[["grupaicbt"]]; se <- summary(m)$coefficients["grupaicbt", 2]; df <- df.residual(m)
  data.frame(analiza = etykieta, n = nrow(d), roznica = est, SE = se,
             dolny95 = est - qt(.975, df) * se, gorny95 = est + qt(.975, df) * se,
             t_ni = (est - margines) / se, df = df, p_ni = pt((est - margines) / se, df),
             p_przewaga = 2 * pt(-abs(est / se), df),
             dolny90 = est - qt(.95, df) * se, gorny90 = est + qt(.95, df) * se)
}
wyniki <- rbind(analiza_ni(dane, "ITT"), analiza_ni(dane[!dane$odstepstwo, ], "per protocol"))
wyniki$non_inferiority <- wyniki$gorny95 < margines
print(cbind(wyniki[1:2], round(wyniki[3:12], 3), wyniki[13]), row.names = FALSE)

# Porównanie: ITT bez korekty o pomiar wyjściowy (test t Welcha)
t_itt <- t.test(post ~ grupa, data = dane)
round(c(roznica = unname(t_itt$estimate[2] - t_itt$estimate[1]), dolny95 = -t_itt$conf.int[2], gorny95 = -t_itt$conf.int[1]), 3)

# Równoważność (TOST) w ITT: 90% CI w granicach ±Δ
itt <- wyniki[1, ]
p_tost <- max(pt((itt$roznica - margines) / itt$SE, itt$df), pt((itt$roznica + margines) / itt$SE, itt$df, lower.tail = FALSE))
round(c(dolny90 = itt$dolny90, gorny90 = itt$gorny90, p_TOST = p_tost), 3)
Wynik w R
    grupa pre.M pre.SD post.M post.SD
 standard 15.11   3.25   6.91    4.85
     icbt 14.81   3.25   7.63    4.46
          odstepstwo
grupa      FALSE TRUE
  standard   119   31
  icbt       118   32
[1] 0.423
      analiza   n roznica    SE dolny95 gorny95   t_ni  df  p_ni p_przewaga
          ITT 300   0.904 0.488  -0.056   1.864 -2.247 297 0.013      0.065
 per protocol 237   1.481 0.499   0.497   2.464 -1.040 234 0.150      0.003
 dolny90 gorny90 non_inferiority
   0.100   1.709            TRUE
   0.656   2.305           FALSE
roznica dolny95 gorny95
  0.720  -0.339   1.779
dolny90 gorny90  p_TOST
  0.100   1.709   0.013
2. Liczebność badania non-inferiority
R
# Liczebność badania non-inferiority dla wyniku ciągłego: jednostronne α = .025, moc .90, SD = 4.5 pkt PHQ-9
# Prawdziwa różnica θ (iCBT − standard): 0 albo 0.5 pkt na niekorzyść iCBT
n_ni <- function(margines, theta, sd = 4.5, alfa = .025, moc = .90)
  ceiling(power.t.test(delta = margines - theta, sd = sd, sig.level = alfa, power = moc, alternative = "one.sided")$n)
siatka <- expand.grid(margines = seq(1, 4, by = 0.5), theta = c(0, 0.5))
siatka$n_na_grupe <- mapply(n_ni, siatka$margines, siatka$theta)
print(reshape(siatka, idvar = "margines", timevar = "theta", direction = "wide"), row.names = FALSE)

# Projekt z przykładu: Δ = 2, θ = 0 – test t na wynikach końcowych i ANCOVA z korelacją pre–post .45
n_t <- n_ni(2, 0)
rho <- .45
n_ancova <- ceiling(power.t.test(delta = 2, sd = 4.5 * sqrt(1 - rho^2), sig.level = .025, power = .90,
                                 alternative = "one.sided")$n)
c(n_test_t = n_t, n_ancova = n_ancova)
# Ta sama moc w badaniu przewagi wykrywającym różnicę 2 pkt (dwustronne α = .05) – identyczna liczebność
ceiling(power.t.test(delta = 2, sd = 4.5, sig.level = .05, power = .90)$n)
Wynik w R
 margines n_na_grupe.0 n_na_grupe.0.5
      1.0          427           1704
      1.5          191            427
      2.0          108            191
      2.5           70            108
      3.0           49             70
      3.5           36             49
      4.0           28             36
n_test_t n_ancova
     108       86
[1] 108
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), t.test(), power.t.test()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Wniosek „nie gorsza”, bo test przewagi był nieistotny. Bez marginesu nie ma testu non-inferiority.
- Margines ustalony lub zmieniony po zebraniu danych albo bez uzasadnienia klinicznego i statystycznego.
- 90% CI w badaniu non-inferiority z α = .025. Przy jednostronnym α = .025 używasz górnej granicy 95% CI. 90% CI odpowiada α = .05 i jest typowy dla TOST.
- Tylko ITT. W tym schemacie ITT ułatwia wykazanie tezy. Pokaż też per protocol i wyjaśnij rozbieżności.
- Pomylony kierunek różnicy. Zapisz, czy wyższy wynik oznacza lepszy, czy gorszy stan, i porównuj właściwą granicę przedziału z marginesem.
- Mała próba „bo nie szukamy różnicy”. Liczebność zależy od marginesu i bywa większa niż w badaniu przewagi (zob. kalkulator liczebności próby).
Najczęstsze pytania
Jak ustalić margines non-inferiority?
Połącz przesłankę statystyczną i kliniczną. Nowa interwencja nie może stracić całej przewagi standardu nad placebo lub brakiem leczenia, więc często przyjmuje się ułamek dolnej granicy CI efektu standardu z metaanalizy (Walker i Nowacki, 2011). Strata nie może też przekraczać różnicy istotnej dla pacjenta. Margines i jego uzasadnienie zapisz przed zebraniem danych.
Czy w badaniu non-inferiority analiza ITT jest konserwatywna?
Nie. Osoby, które nie przestrzegają protokołu, zbliżają wyniki grup do siebie, a w badaniu non-inferiority mniejsza różnica ułatwia zmieszczenie się w marginesie. Walker i Nowacki (2011) nazywają ITT w tym schemacie antykonserwatywną. Raportuj ITT i per protocol; rozbieżność obu analiz osłabia wniosek.
Jaki przedział ufności podać w badaniu non-inferiority: 90% czy 95%?
Przy jednostronnym α = .025, typowym w badaniach klinicznych, porównujesz z marginesem odpowiednią granicę dwustronnego 95% CI. 90% CI odpowiada α = .05 i służy w procedurze TOST do badania równoważności. Zapisz w planie, który poziom stosujesz, i użyj tego samego w obliczeniu liczebności.
Czym różni się badanie non-inferiority od badania równoważności?
Non-inferiority wyklucza tylko różnicę na niekorzyść nowej interwencji większą niż Δ, więc nowa interwencja może okazać się lepsza. Równoważność wyklucza różnice większe niż Δ w obie strony i wymaga dwóch testów jednostronnych (TOST). Wybierz ją, gdy problemem jest także przewaga, np. przy zamienniku leku albo nowej wersji testu.
Czy badanie non-inferiority wymaga mniejszej próby niż badanie przewagi?
Nie. Przy tym samym marginesie i założeniu braku prawdziwej różnicy liczebność jest taka sama jak w badaniu przewagi wykrywającym różnicę równą Δ. Węższy margines albo założenie, że nowa interwencja jest nieco gorsza, szybko zwiększa próbę: w przykładzie z 108 do 191 lub 427 osób na grupę.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikStatystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikSchemat naprzemienny (crossover)
AB/BA krok po kroku: okres, sekwencja, przeniesienie i wypłukiwanie, model mieszany w R, symulacja procedury dwuetapowej i wzór opisu.
Czytaj →Planujesz badanie non-inferiority albo bronisz marginesu przed recenzentem?
Pomożemy uzasadnić margines, policzyć liczebność, przeprowadzić analizę ITT i per protocol oraz wyjaśnić wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Althunian, T. A., de Boer, A., Groenwold, R. H. H., & Klungel, O. H. (2017). Defining the noninferiority margin and analysing noninferiority: An overview. British Journal of Clinical Pharmacology, 83(8), 1636–1642. https://doi.org/10.1111/bcp.13280 ● Otwarty dostęp
- Gupta, S. K. (2011). Intention-to-treat concept: A review. Perspectives in Clinical Research, 2(3), 109–112. https://doi.org/10.4103/2229-3485.83221 ● Otwarty dostęp
- Hernán, M. A., & Robins, J. M. (2017). Per-protocol analyses of pragmatic trials. New England Journal of Medicine, 377(14), 1391–1398. https://doi.org/10.1056/nejmsm1605385
- Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Piaggio, G., Elbourne, D. R., Pocock, S. J., Evans, S. J. W., Altman, D. G., & CONSORT Group. (2012). Reporting of noninferiority and equivalence randomized trials: Extension of the CONSORT 2010 statement. JAMA, 308(24), 2594–2604. https://doi.org/10.1001/jama.2012.87802
- Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657–680. https://doi.org/10.1007/BF01068419 ● Otwarty dostęp: pełny tekst
- Schumi, J., & Wittes, J. T. (2011). Through the looking glass: Understanding non-inferiority. Trials, 12(1), Article 106. https://doi.org/10.1186/1745-6215-12-106 ● Otwarty dostęp
- Walker, E., & Nowacki, A. S. (2011). Understanding equivalence and noninferiority testing. Journal of General Internal Medicine, 26(2), 192–196. https://doi.org/10.1007/s11606-010-1513-8 ● Otwarty dostęp
Cytowania BibTeX
@article{althunian2017defining, author={Althunian, Turki A. and de Boer, Anthonius and Groenwold, Rolf H. H. and Klungel, Olaf H.}, title={{Defining the noninferiority margin and analysing noninferiority: An overview}}, journal={British Journal of Clinical Pharmacology}, year={2017}, volume={83}, number={8}, pages={1636--1642}, doi={10.1111/bcp.13280}}@article{gupta2011intention, author={Gupta, Sandeep K.}, title={{Intention-to-treat concept: A review}}, journal={Perspectives in Clinical Research}, year={2011}, volume={2}, number={3}, pages={109--112}, doi={10.4103/2229-3485.83221}}@article{hernan2017per, author={Hernán, Miguel A. and Robins, James M.}, title={{Per-protocol analyses of pragmatic trials}}, journal={New England Journal of Medicine}, year={2017}, volume={377}, number={14}, pages={1391--1398}, doi={10.1056/nejmsm1605385}}@article{lakens2017equivalence, author={Lakens, Daniël}, title={{Equivalence tests: A practical primer for t tests, correlations, and meta-analyses}}, journal={Social Psychological and Personality Science}, year={2017}, volume={8}, number={4}, pages={355--362}, doi={10.1177/1948550617697177}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{piaggio2012reporting, author={Piaggio, Gilda and Elbourne, Diana R. and Pocock, Stuart J. and Evans, Stephen J. W. and Altman, Douglas G. and {CONSORT Group}}, title={{Reporting of noninferiority and equivalence randomized trials: Extension of the CONSORT 2010 statement}}, journal={JAMA}, year={2012}, volume={308}, number={24}, pages={2594--2604}, doi={10.1001/jama.2012.87802}}@article{schuirmann1987comparison, author={Schuirmann, Donald J.}, title={{A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability}}, journal={Journal of Pharmacokinetics and Biopharmaceutics}, year={1987}, volume={15}, number={6}, pages={657--680}, doi={10.1007/bf01068419}}@article{schumi2011through, author={Schumi, Jennifer and Wittes, Janet T.}, title={{Through the looking glass: Understanding non-inferiority}}, journal={Trials}, year={2011}, volume={12}, number={1}, eid={106}, doi={10.1186/1745-6215-12-106}}@article{walker2011understanding, author={Walker, Esteban and Nowacki, Amy S.}, title={{Understanding equivalence and noninferiority testing}}, journal={Journal of General Internal Medicine}, year={2011}, volume={26}, number={2}, pages={192--196}, doi={10.1007/s11606-010-1513-8}}