prop.test(), zwłaszcza przy małych grupach i odsetkach bliskich 0 lub 1, i łatwo go policzyć w R.Co to jest przedział Newcombe’a?
Przedział Newcombe’a (ang. Newcombe hybrid score interval, metoda 10) to przedział ufności dla różnicy dwóch niezależnych proporcji p₁ − p₂, zbudowany z przedziałów Wilsona obu grup. W porównaniu jedenastu metod Newcombe (1998) wykazał, że proste metody mają słabe pokrycie, a ta działa dobrze i łatwo ją policzyć przy każdej liczebności. W badaniach klinicznych różnica proporcji to bezwzględna różnica ryzyka, a jej odwrotność – NNT. Całe porównanie pokazuje wpis Jak porównać odsetki w dwóch grupach?
Jak liczyć
Niech d = p₁ − p₂, a (l₁, u₁) i (l₂, u₂) to 95% przedziały Wilsona obu proporcji. Wtedy:
L = d − √[(p₁ − l₁)² + (u₂ − p₂)²], U = d + √[(u₁ − p₁)² + (p₂ − l₂)²]
Granice nie wychodzą poza [−1, 1], a przedział jest niesymetryczny przy odsetkach bliskich 0 lub 1. Przedziały Wilsona daje prop.test(x, n, correct = FALSE), a cały wynik – BinomDiffCI(method = "score") z pakietu DescTools.
Przykład
Poprawę zaobserwowano u 11 z 20 osób z grupy interwencyjnej (55.0%) i u 4 z 22 z kontrolnej (18.2%). Różnica wynosi 36.8 punktu procentowego, 95% CI Newcombe’a [7.7, 58.9], a przedział Walda [9.7, 63.9]. Przy 4 z 16 wobec 0 z 15 różnica to 25.0 punktu, przedział Newcombe’a [−0.2, 49.5] obejmuje zero, a przedział Walda [3.8, 46.2] – nie, bo grupa z zerem ma w nim zerową wariancję. Przy 15 osobach w grupie i odsetkach 20% i 5% rzeczywiste pokrycie 95% CI wynosi 96.8% (Newcombe) i 91.1% (Wald).
Na rysunku
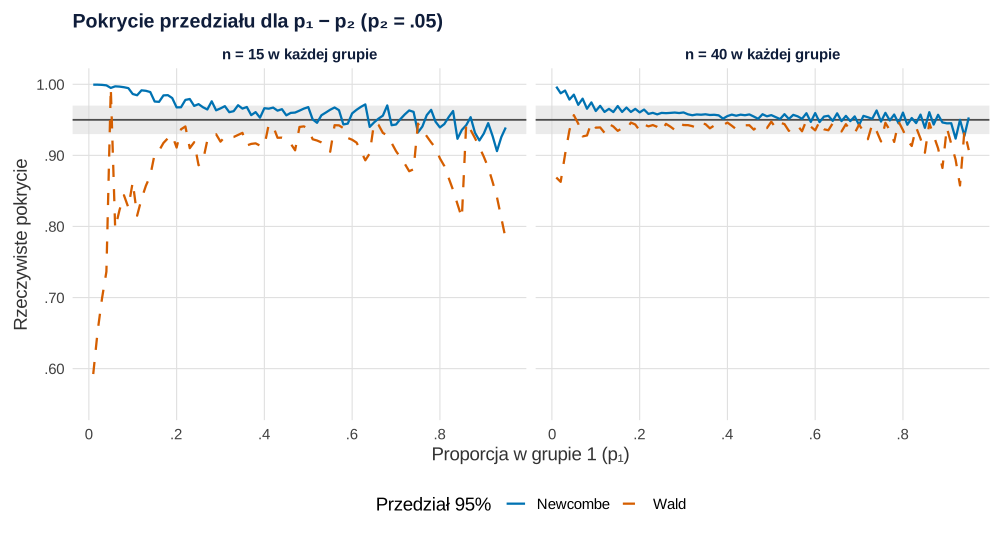
Co widać. Każdy punkt krzywej to prawdopodobieństwo, że przedział obejmie prawdziwą różnicę p₁ − p₂, policzone przez zsumowanie wszystkich możliwych wyników obu grup. Proporcja w grupie 2 jest stała i niska (.05), jak w przykładzie; ta w grupie 1 zmienia się od .01 do .95. Przy 15 osobach w grupie przedział Newcombe’a ma średnie pokrycie .962, a poniżej .93 spada tylko dla 5.3% wartości p₁. Przedział Walda ma średnio .894, przy 80% wartości p₁ jest poniżej .93, a w najgorszym miejscu obejmuje prawdziwą różnicę tylko w 59% prób. Przy 40 osobach w grupie Wald się poprawia (średnio .934), ale na krańcach nadal spada do .858; Newcombe nie schodzi poniżej .924. Dla p₁ = .20 krzywe dają te same .968 i .911 co przykład.
Na co uważać. Krzywe są poszarpane, bo liczby sukcesów są całkowite i przy niewielkiej zmianie p₁ jeden wynik wchodzi do przedziału albo z niego wypada. Nie szukaj więc w nich gładkiego trendu. Pokrycie powyżej .95 też ma cenę: przedział jest szerszy, niż musiałby być, czego wykres nie pokazuje. Rysunek dotyczy jednej proporcji w grupie 2 i równych grup; przy innych proporcjach i nierównych grupach krzywe wyglądają inaczej. Szary pas .93–.97 to umowna granica wybrana ręcznie. Ogólną ideę pokrycia przedziału pokazuje wpis przedział ufności w obrazkach, a pokrycie przedziałów dla jednej proporcji – hasło przedział ufności dla proporcji.
Podpis do pracy:
Kod rysunku nic nie losuje: przedziały liczą te same funkcje co przykład, a pokrycie to suma prawdopodobieństw dwumianowych. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rzeczywiste pokrycie 95% przedziałów Newcombe'a i Walda dla różnicy dwóch proporcji
library(ggplot2)

# Paleta Okabe–Ito i prosty motyw
kol <- c("Newcombe" = "#0072B2", "Wald" = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

newcombe <- function(x1, n1, x2, n2, conf = 0.95) {
  p1 <- x1 / n1; p2 <- x2 / n2; d <- p1 - p2
  w1 <- prop.test(x1, n1, conf.level = conf, correct = FALSE)$conf.int  # Wilson dla grupy 1
  w2 <- prop.test(x2, n2, conf.level = conf, correct = FALSE)$conf.int  # Wilson dla grupy 2
  c(dolna = d - sqrt((p1 - w1[1])^2 + (w2[2] - p2)^2), gorna = d + sqrt((w1[2] - p1)^2 + (p2 - w2[1])^2))
}
wald <- function(x1, n1, x2, n2, z = qnorm(0.975)) {
  p1 <- x1 / n1; p2 <- x2 / n2; se <- sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
  c(dolna = p1 - p2 - z * se, gorna = p1 - p2 + z * se)
}

# Dokładne pokrycie: suma prawdopodobieństw wszystkich wyników (x1, x2), których przedział obejmuje p1 - p2.
# Grupa 2 ma stałą proporcję 0.05, proporcja w grupie 1 zmienia się od .01 do .95; n = 15 i 40 w każdej grupie.
p2 <- 0.05; p1_siatka <- seq(0.01, 0.95, by = 0.01)
pokrycie <- do.call(rbind, lapply(c(15, 40), function(n) {
  wyniki <- expand.grid(x1 = 0:n, x2 = 0:n)
  ci <- list(Newcombe = t(mapply(newcombe, wyniki$x1, n, wyniki$x2, n)),
             Wald = t(mapply(wald, wyniki$x1, n, wyniki$x2, n)))
  do.call(rbind, lapply(names(ci), function(m) {
    data.frame(n = n, metoda = m, p1 = p1_siatka, pokrycie = sapply(p1_siatka, function(p1) {
      obejmuje <- ci[[m]][, "dolna"] <= p1 - p2 & p1 - p2 <= ci[[m]][, "gorna"]
      sum(obejmuje * dbinom(wyniki$x1, n, p1) * dbinom(wyniki$x2, n, p2))
    }))
  }))
}))
pokrycie$metoda <- factor(pokrycie$metoda, levels = names(kol))
pokrycie$panel <- factor(sprintf("n = %d w każdej grupie", pokrycie$n),
                         levels = c("n = 15 w każdej grupie", "n = 40 w każdej grupie"))

# Kontrola z przykładu (p1 = .20, n = 15) i podsumowanie pokrycia na całej siatce p1
round(subset(pokrycie, abs(p1 - 0.20) < 1e-9 & n == 15)$pokrycie, 3)
print(aggregate(pokrycie ~ metoda + n, data = pokrycie,
                FUN = function(x) round(c(srednio = mean(x), min = min(x), ponizej_93 = mean(x < 0.93)), 3)))

p <- ggplot(pokrycie, aes(p1, pokrycie, colour = metoda, linetype = metoda)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 0.93, ymax = 0.97, fill = "grey85", alpha = 0.5) +  # umowny pas .93–.97
  geom_hline(yintercept = 0.95, colour = "grey30") +
  geom_line(linewidth = 0.8) +
  facet_wrap(~ panel) +
  scale_colour_manual(values = kol, name = "Przedział 95%") +
  scale_linetype_manual(values = c("solid", "dashed"), name = "Przedział 95%") +
  scale_x_continuous(breaks = seq(0, 1, 0.2), labels = c("0", ".2", ".4", ".6", ".8", "1")) +
  scale_y_continuous(labels = function(x) sub("^0", "", sprintf("%.2f", x))) +
  coord_cartesian(ylim = c(0.55, 1)) +
  labs(title = "Pokrycie przedziału dla p₁ − p₂ (p₂ = .05)", x = "Proporcja w grupie 1 (p₁)",
       y = "Rzeczywiste pokrycie") +
  motyw
p
Wynik w R
[1] 0.968 0.911
    metoda  n pokrycie.srednio pokrycie.min pokrycie.ponizej_93
1 Newcombe 15            0.962        0.906               0.053
2     Wald 15            0.894        0.592               0.800
3 Newcombe 40            0.957        0.924               0.021
4     Wald 40            0.934        0.858               0.200
Jak opisać w pracy
Na co uważać
- Przedział z
prop.test()dla dwóch grup to przedział Walda (domyślnie z poprawką na ciągłość), a nie Newcombe’a. Fagerland, Lydersen i Laake (2015) pokazują, że przedział Walda dla różnicy działa dobrze dopiero w dużych próbach. Zobacz też test dla dwóch proporcji. - Metoda dotyczy grup niezależnych. Dla tych samych osób zbadanych dwa razy potrzebna jest wersja dla par, liczona razem z testem McNemara.
- Ryzyko względne i iloraz szans mają własne przedziały. Na granicy istotności przedział i test χ² mogą dać różne wnioski, bo opierają się na innych statystykach.
Przedział Newcombe’a w R
Kod definiuje przedział Newcombe’a z przedziałów Wilsona i przedział Walda, sprawdza wynik funkcją BinomDiffCI(), pokazuje przypadek zera w jednej grupie i wylicza dokładne pokrycie obu przedziałów przez sumowanie po wszystkich możliwych wynikach.
Newcombe a Wald dla różnicy dwóch proporcji
R
# Przedział Newcombe'a (metoda 10: hybryda Wilsona) dla różnicy dwóch niezależnych proporcji
newcombe <- function(x1, n1, x2, n2, conf = 0.95) {
  p1 <- x1 / n1; p2 <- x2 / n2; d <- p1 - p2
  w1 <- prop.test(x1, n1, conf.level = conf, correct = FALSE)$conf.int  # Wilson dla grupy 1
  w2 <- prop.test(x2, n2, conf.level = conf, correct = FALSE)$conf.int  # Wilson dla grupy 2
  c(roznica = d,
    dolna = d - sqrt((p1 - w1[1])^2 + (w2[2] - p2)^2),
    gorna = d + sqrt((w1[2] - p1)^2 + (p2 - w2[1])^2))
}
wald <- function(x1, n1, x2, n2, z = qnorm(0.975)) {
  p1 <- x1 / n1; p2 <- x2 / n2; se <- sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
  c(roznica = p1 - p2, dolna = p1 - p2 - z * se, gorna = p1 - p2 + z * se)
}
# Przykład: poprawa u 11 z 20 osób (interwencja) i u 4 z 22 (kontrola)
round(rbind(Newcombe = newcombe(11, 20, 4, 22), Wald = wald(11, 20, 4, 22)), 3)
round(prop.test(c(11, 4), c(20, 22), correct = FALSE)$conf.int, 3)    # prop.test: przedział Walda
suppressPackageStartupMessages(library(DescTools))
round(BinomDiffCI(11, 20, 4, 22, method = "score"), 3)                # kontrola: ta sama metoda
# Przypadek brzegowy: 0 z 15 w jednej grupie
round(rbind(Newcombe = newcombe(4, 16, 0, 15), Wald = wald(4, 16, 0, 15)), 3)
# Rzeczywiste pokrycie 95% CI (dokładne wyliczenie), n1 = n2 = 15, p1 = 0.20, p2 = 0.05
pokrycie <- function(f, n1, n2, p1, p2) {
  s <- 0
  for (x1 in 0:n1) for (x2 in 0:n2) {
    ci <- f(x1, n1, x2, n2)
    s <- s + (ci["dolna"] <= p1 - p2 & p1 - p2 <= ci["gorna"]) * dbinom(x1, n1, p1) * dbinom(x2, n2, p2)
  }
  unname(s)
}
round(c(Newcombe = pokrycie(newcombe, 15, 15, 0.20, 0.05), Wald = pokrycie(wald, 15, 15, 0.20, 0.05)), 3)
Wynik w R
         roznica dolna gorna
Newcombe   0.368 0.077 0.589
Wald       0.368 0.097 0.639
[1] 0.097 0.639
attr(,"conf.level")
[1] 0.95
       est lwr.ci upr.ci
[1,] 0.368  0.077  0.589
         roznica  dolna gorna
Newcombe    0.25 -0.002 0.495
Wald        0.25  0.038 0.462
Newcombe     Wald
   0.968    0.911
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet DescTools). Rysunek 1 wykonano w pakiecie ggplot2, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym przedział Newcombe’a różni się od przedziału Wilsona?
Przedział Wilsona dotyczy jednej proporcji. Przedział Newcombe’a łączy dwa przedziały Wilsona w przedział dla różnicy proporcji w dwóch niezależnych grupach.
Czy przedział Newcombe’a działa, gdy w jednej grupie jest zero zdarzeń?
Tak. Przedział Wilsona dla 0/n ma dodatnią szerokość, więc przedział różnicy nie zawęża się sztucznie jak przedział Walda, w którym wariancja grupy z zerem wynosi 0.
Jak policzyć przedział Newcombe’a w R?
Funkcją BinomDiffCI(x1, n1, x2, n2, method = "score") z pakietu DescTools albo ręcznie: przedziały Wilsona z prop.test(x, n, correct = FALSE) dla każdej grupy i wzór Newcombe’a.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak porównać odsetki w dwóch grupach?
Tabela 2 × 2, test chi-kwadrat lub Fishera i różnica w punktach procentowych z 95% CI Newcombe’a – z przykładem w R i wzorem opisu.
Czytaj →PoradnikKalkulator tabeli 2×2 i r×c
Chi-kwadrat, test dokładny Fishera, V Craméra i reszty dla tabel do 5 × 5, a dla 2 × 2 także OR, RR i różnica odsetków z przedziałami ufności.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Fagerland, M. W., Lydersen, S., & Laake, P. (2015). Recommended confidence intervals for two independent binomial proportions. Statistical Methods in Medical Research, 24(2), 224–254. https://doi.org/10.1177/0962280211415469
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
Cytowania BibTeX
@article{fagerland2015recommended, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{Recommended confidence intervals for two independent binomial proportions}}, journal={Statistical Methods in Medical Research}, year={2015}, volume={24}, number={2}, pages={224--254}, doi={10.1177/0962280211415469}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}