power.prop.test() daje 2507 osób na wersję. Losuj osoby, nie odsłony, sprawdź zgodność podziału z planem i analizuj raz, po zaplanowanym czasie – codzienne podglądanie i zatrzymanie przy pierwszym p < .05 podniosło w symulacji błąd I rodzaju z 5% do 22%. W wynikach podaj test proporcji, różnicę odsetków z 95% CI i względny wzrost razem z odsetkami.Test A/B w pracy dyplomowej
Test A/B to eksperyment: każda osoba odwiedzająca stronę, otwierająca e-mail albo wypełniająca ankietę losowo trafia do wersji A albo B, a potem porównujesz jeden wynik, najczęściej odsetek osób, które coś zrobiły. Dzięki randomizacji różnicę między wersjami możesz przypisać samej zmianie. Kohavi i in. (2009) nazywają kontrolowane eksperymenty w sieci najlepszym schematem do ustalania takich związków przyczynowych. Dodają jednak, że wynik zależy od mocy, liczebności próby i poprawnego losowania, a losowanie bywa w praktyce trudniejsze, niż się zakłada.
Ogólny przykład testu A/B ceny, z interpretacją wyniku nieistotnego, jest w poradniku statystyka w pracy z marketingu. Ten wpis idzie krok dalej i opisuje cały plan: co ustalić przed startem, jak policzyć liczebność i czas trwania, dlaczego nie wolno kończyć testu „na istotności” i jak opisać wynik, gdy wariantów albo metryk jest więcej.
Przykład w tym wpisie (dane symulowane). Studentka pisze pracę magisterską we współpracy ze szkołą językową online. Na stronie zapisu na bezpłatną lekcję próbną porównuje dwa formularze. Wersja A to obecny formularz, a wersja B ma dodatkowo krótką informację, ile osób zapisało się w ostatnim miesiącu. Dane z poprzedniego miesiąca pokazują, że zapisuje się około 10% nowych odwiedzających, a stronę odwiedza około 450 nowych osób dziennie. Dane są w pliku CSV: jedna osoba w wierszu, dzień, wersja i trzy wyniki 0/1.
Krok 1. Hipoteza i metryka główna – przed startem
Najważniejsze decyzje zapadają, zanim pierwsza osoba zobaczy wersję B. Zapisz je w planie analizy statystycznej, najlepiej z datą, np. jako prerejestrację. W planie powinny się znaleźć:
- Hipoteza z kierunkiem i mechanizmem. „Informacja o liczbie zapisanych osób zwiększy odsetek zapisów, bo działa jak dowód społeczny”. Hipotezę statystyczną zapisz jako H0 i H1: H0 – odsetek zapisów w obu wersjach jest taki sam.
- Jedna metryka główna z dokładną definicją: licznik i mianownik. U nas to odsetek nowych odwiedzających (mianownik), którzy w tej samej wizycie wysłali formularz (licznik). Kohavi i in. (2020) zalecają zdefiniowanie kluczowych metryk i najlepiej jednego ogólnego kryterium oceny eksperymentu.
- Metryki dodatkowe i ochronne. Dodatkowe pomagają zrozumieć wynik (np. kliknięcie w cennik), a ochronne sprawdzają, czy zmiana czegoś nie psuje (np. odsetek rezygnacji z lekcji). Zapisz je osobno i od razu ustal, czy stosujesz do nich poprawkę.
- Jednostka randomizacji, liczebność, czas trwania i reguła zakończenia – o nich w kolejnych krokach.
Krok 2. Liczebność próby z power.prop.test
Do liczebności potrzebujesz czterech wartości: odsetka bazowego (10%), najmniejszej różnicy wartej wykrycia, poziomu α i mocy. Najmniejsza różnica (ang. minimum detectable effect, MDE) to decyzja merytoryczna, nie statystyczna. Jaki wzrost miałby znaczenie dla szkoły i uzasadniałby wdrożenie zmiany? Lakens (2022) opisuje kilka sposobów uzasadnienia liczebności, od ograniczeń zasobów po analizę mocy a priori, i przypomina, że trzeba przy tym jasno powiedzieć, jaki efekt uznajemy za ważny. Studentka przyjęła 2.5 punktu procentowego, czyli wzrost z 10% do 12.5%.
Funkcja power.prop.test() z bazowego R daje dla tych założeń (α = .05 dwustronnie, moc 80%) 2507 osób na wersję, czyli 5014 łącznie. Tabela pokazuje, jak szybko liczebność rośnie, gdy chcesz wykryć mniejszą różnicę. Te same obliczenia zrobisz w kalkulatorze liczebności próby.
| Najmniejsza różnica | Odsetek w wersji B | Moc 80% | Moc 90% |
|---|---|---|---|
| 1 pp | 11% | 14 751 | 19 747 |
| 2 pp | 12% | 3841 | 5142 |
| 2.5 pp | 12.5% | 2507 | 3356 |
| 3 pp | 13% | 1774 | 2375 |
| 5 pp | 15% | 686 | 918 |
Zmniejszenie różnicy z 2.5 do 1 punktu procentowego oznacza prawie sześć razy więcej osób. Rysunek 1 pokazuje też, że ta sama różnica w punktach procentowych wymaga więcej osób przy wyższym odsetku bazowym, bo rośnie wariancja wyniku 0/1. Jeśli liczebność jest nierealna dla Twojej strony, nie obniżaj „na papierze” MDE. Zmień metrykę na częstszą, wydłuż test albo napisz w pracy wprost, jaki efekt badanie mogło wykryć.
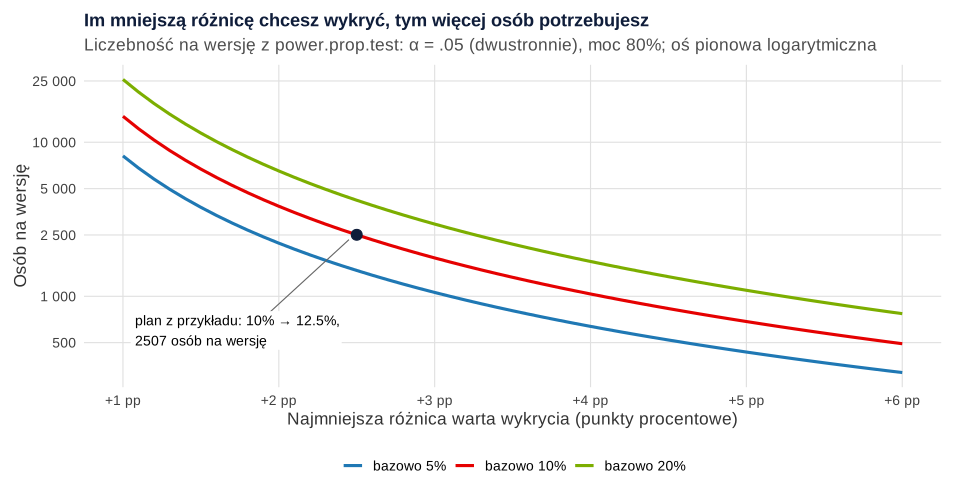
power.prop.test().Krok 3. Jednostka randomizacji i czas trwania
Losuj osoby, nie odsłony. Jeśli wersję losujesz przy każdym wejściu na stronę, ta sama osoba zobaczy raz A, raz B, a obserwacje przestaną być niezależne. Zwykle losuje się użytkownika (np. przez identyfikator w pliku cookie albo numer konta) i pokazuje mu zawsze tę samą wersję. Analizuj w tej samej jednostce, w której losujesz. Gdy losujesz całe grupy, np. klasy, oddziały albo sklepy, to jest już badanie z randomizacją klastrową i wymaga innej analizy.
Czas trwania licz z liczebności, a potem zaokrąglij do pełnych tygodni. Przy 450 nowych osobach dziennie 5014 osób zbierzesz w 11.1 dnia. Studentka zaplanowała 14 dni, żeby objąć dwa pełne cykle tygodniowe, bo w weekend na stronę trafiają inne osoby niż w dni robocze. Test kończy się po 14 dniach, niezależnie od wyniku. W praktyce weszło 6292 osoby, więcej niż minimum, więc moc przy założonym efekcie wzrosła do 88%.
Najpierw sprawdź podział. Do wersji A trafiło 3125 osób, a do B 3167. Czy to zgodne z planem 50/50? Odpowiada na to test chi-kwadrat zgodności: χ²(1) = 0.28, p = .597, więc nic nie wskazuje na problem. Fabijan i in. (2019) nazywają rozbieżność proporcji grup (ang. sample ratio mismatch, SRM) jednym z najbardziej użytecznych sygnałów problemów z jakością danych, np. błędów w przypisywaniu wersji albo w zapisie odwiedzin. Gdy ten test wychodzi wyraźnie istotny, nie interpretuj wyniku głównego, tylko szukaj przyczyny. Zignorowanie SRM może sprawić, że gorsza wersja wyda się lepsza.
Krok 4. Nie kończ testu, gdy tylko „wyjdzie”
Najczęstszy błąd w testach A/B to codzienne sprawdzanie wartości p i zatrzymanie testu przy pierwszym wyniku poniżej .05. Każde spojrzenie to kolejny test na częściowo tych samych danych. Armitage i in. (1969) pokazali, że przy powtarzaniu testu na tym samym nominalnym poziomie prawdopodobieństwo uzyskania wyniku istotnego na którymś etapie może być znacznie wyższe niż poziom nominalny. Simmons i in. (2011) zaliczają taką elastyczność w zbieraniu danych do decyzji, które silnie zwiększają odsetek wyników fałszywie pozytywnych. Ta praktyka to jedna z form p-hackingu.
W symulacji wykonano 10 000 testów A/A, czyli takich, w których obie wersje mają ten sam odsetek zapisów (10%), z planem z przykładu. Jeden test po 14 dniach dał wynik istotny w 4.7% przypadków, zgodnie z α. Przy codziennym podglądzie i zatrzymaniu przy pierwszym p < .05 fałszywy alarm pojawił się w 22.1% testów. Ryzyko błędu I rodzaju wzrosło więc ponad czterokrotnie (rysunek 2A).
Podglądanie ma jeszcze drugi, mniej znany skutek. Gdy efekt naprawdę istnieje (10% wobec 12.5%, czyli wzrost o 25%), zatrzymanie „na istotności” wybiera chwile, w których losowo wypadł on wyjątkowo duży. W symulacji 71.1% testów z codziennym podglądem zatrzymano już w pierwszym tygodniu. Średni oszacowany wzrost wyniósł w nich 50.4%, dwa razy więcej niż prawdziwy. Przy jednym teście po 14 dniach średnia wyniosła 25.4% (rysunek 2B).
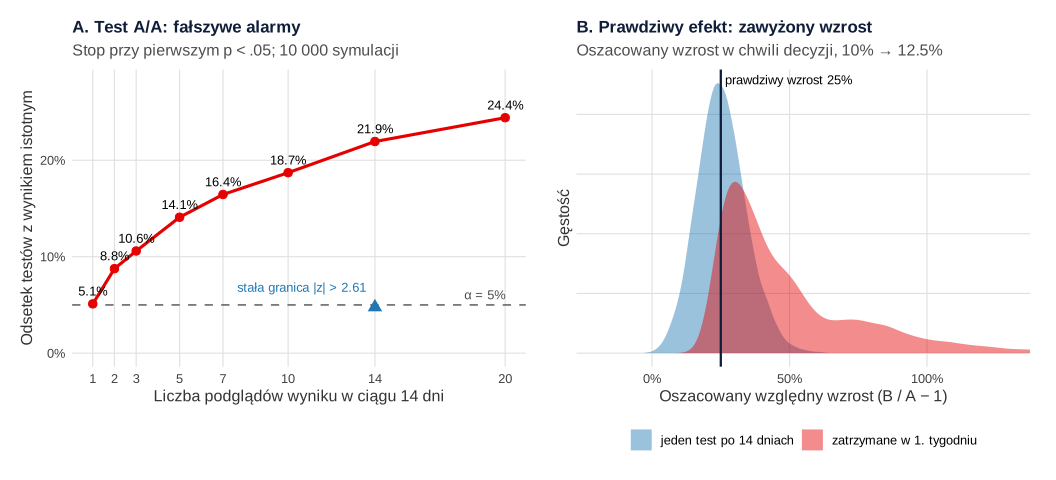
Masz dwa uczciwe wyjścia. Pierwsze to jeden test po zaplanowanym czasie. Dane możesz oglądać po drodze, np. żeby wyłapać awarię, ale nie decydujesz na ich podstawie o końcu testu. Drugie to plan sekwencyjny ustalony z góry: liczba podglądów i surowsza granica. Pocock (1977) zaproponował grupowe plany sekwencyjne z testem po każdej z równych części danych. W naszej symulacji stała granica dla 14 podglądów wyniosła |z| > 2.61, czyli nominalne p < .009, i utrzymała błąd I rodzaju na poziomie 4.8%. Szczegóły granic opisuje hasło analiza pośrednia i reguły zatrzymania. Johari i in. (2022) proponują z kolei „zawsze ważne” wartości p i przedziały ufności, które pozwalają stale monitorować test bez utraty kontroli nad błędem. Tę metodę też trzeba zaplanować od początku.
Krok 5. Analiza: test proporcji, różnica z CI i względny wzrost
Po 14 dniach zapisało się 322 z 3125 osób w wersji A (10.30%) i 408 z 3167 w wersji B (12.88%). Wynik jest dwuwartościowy, a grupy niezależne, więc właściwy jest test dla dwóch proporcji. Bez poprawki na ciągłość jest to ten sam test co chi-kwadrat dla tabeli 2 × 2 (procedurę krok po kroku opisuje test chi-kwadrat krok po kroku). Przy tysiącach osób liczebności oczekiwane są duże, więc test dokładny Fishera nie jest potrzebny. Kiedy jest, wyjaśnia wpis chi-kwadrat czy test Fishera.
| Wersja | Zapis | Brak zapisu | Razem | Odsetek zapisów |
|---|---|---|---|---|
| A (obecny formularz) | 322 | 2803 | 3125 | 10.30% |
| B (z informacją o zapisach) | 408 | 2759 | 3167 | 12.88% |
Podaj trzy liczby:
- Test: χ²(1, N = 6292) = 10.20, p = .001.
- Różnica odsetków z 95% CI: 2.58 punktu procentowego, 95% CI [1.00, 4.16]. Przedział policz metodą Newcombe’a, która łączy przedziały Wilsona obu grup. Newcombe (1998) pokazał, że proste metody mają słabe pokrycie, a ta działa dobrze. Przy tak dużych grupach prosty przedział Walda z
prop.test()daje praktycznie to samo. - Względny wzrost (ang. lift), czyli ryzyko względne minus 1: 25.0%, 95% CI [9.0, 43.5]. Przedział policz na skali logarytmu RR, a nie jako ±. Względny wzrost dobrze brzmi w prezentacji, ale bez odsetka bazowego wprowadza w błąd. Wzrost o 25% to tutaj 2.6 punktu procentowego, czyli około 26 dodatkowych zapisów na 1000 odwiedzających.
Dane są zgodne zarówno z niewielkim wzrostem (1 punkt procentowy), jak i ze sporym (ponad 4). Wszystkie liczby, w tym test Fishera, sprawdzisz w kalkulatorze tabeli 2 × 2, a szerzej o porównaniu dwóch odsetków piszemy w poradniku jak porównać odsetki w dwóch grupach.
Krok 6. Wiele wariantów i wiele metryk
Test A/B/C/D, czyli kontrola i trzy nowe wersje, to trzy porównania z kontrolą. Każde z nich może dać fałszywy alarm, więc rośnie ryzyko, że ogłosisz „zwycięzcę”, który niczym się nie różni. W symulacji 10 000 testów z czterema identycznymi wersjami co najmniej jedno porównanie z kontrolą wyszło istotne w 12.2% testów, a z poprawką Holma w 4.3%. Holm (1979) zaproponował procedurę sekwencyjnego odrzucania hipotez, która kontroluje ten błąd przy dowolnym układzie prawdziwych hipotez. Odrzuca przy tym zawsze co najmniej tyle hipotez co zwykła poprawka Bonferroniego. Teorię opisuje hasło problem wielokrotnych porównań, a wybór poprawki – wpis poprawki na wielokrotne porównania.
To samo dotyczy metryk. W przykładzie metryka główna była jedna i ustalona z góry, więc testujesz ją na poziomie .05. Dwie metryki dodatkowe (kliknięcie w cennik i rozpoczęcie wypełniania formularza) dały p = .312 i p = .046. Po poprawce Holma p = .312 i p = .092, więc żadnej z nich nie przedstawisz jako potwierdzonego efektu. Skorygowane wartości policzysz w kalkulatorze poprawek na wielokrotne porównania. Jeśli rezygnujesz z poprawki, zapisz to w planie i nazwij te analizy eksploracyjnymi.
Jak opisać test A/B w pracy
W metodzie opisz losowanie, jednostkę, metrykę główną, liczebność z założeniami i regułę zakończenia. W wynikach – kontrolę podziału, test, różnicę z CI i metryki dodatkowe z poprawką. W nawiasach kwadratowych wstaw dane własnego badania.
Typowe błędy w testach A/B
- Metryka wybrana po teście. Jeśli główna miara „nie wyszła”, a w pracy pojawia się inna, to wynik eksploracyjny, nie potwierdzenie hipotezy.
- Zatrzymanie przy pierwszym p < .05 albo przedłużanie testu, „aż wyjdzie”. Oba błędy zawyżają ryzyko fałszywego alarmu, a pierwszy dodatkowo zawyża efekt.
- Losowanie odsłon zamiast osób albo analiza w innej jednostce niż randomizacja.
- Brak kontroli podziału grup. Kohavi i in. (2020) podkreślają, że testy wiarygodności, które ostrzegają o naruszonych założeniach, są częścią każdego eksperymentu.
- Sam względny wzrost bez odsetków. „+25%” bez informacji, że chodzi o 10.30% wobec 12.88%, nie pozwala ocenić znaczenia wyniku.
- Wynik nieistotny jako dowód braku różnicy. Przy zbyt małej próbie przedział ufności obejmuje i zero, i efekty ważne w praktyce.
- Kilka wersji lub metryk bez poprawki i wybór „zwycięzcy” spośród wielu porównań.
Test A/B w R: plan, analiza i symulacja podglądania
Trzy przepisy w bazowym R, bez dodatkowych pakietów. Pierwszy liczy liczebność i czas trwania, drugi tworzy dane z przykładu i wykonuje całą analizę, trzeci sprawdza w symulacji skutki podglądania wyników i porównań wielu wariantów. Dane z przepisu 2 są w pliku CSV podlinkowanym na początku wpisu.
1. Liczebność próby i czas trwania
R
# B319 – plan testu A/B: liczebność próby z power.prop.test i czas trwania
# Odsetek zapisów w wersji A (bazowy) = 10% z danych z poprzedniego miesiąca;
# najmniejsza różnica warta wykrycia (MDE) = 2.5 punktu procentowego, czyli 10% -> 12.5%.
plan <- power.prop.test(p1 = 0.10, p2 = 0.125, sig.level = 0.05, power = 0.80)
n_grupa <- ceiling(plan$n)
cat("Osób na wersję:", n_grupa, " razem:", 2 * n_grupa, "\n")

# Jak liczebność zależy od MDE i mocy (odsetek bazowy 10%)
siatka <- expand.grid(mde_pp = c(1, 2, 2.5, 3, 5), moc = c(0.80, 0.90))
siatka$n_na_wersje <- mapply(function(m, w) ceiling(power.prop.test(p1 = 0.10, p2 = 0.10 + m / 100,
                              power = w)$n), siatka$mde_pp, siatka$moc)
print(reshape(siatka, idvar = "mde_pp", timevar = "moc", direction = "wide"), row.names = FALSE)

# Czas trwania: ok. 450 nowych odwiedzających dziennie, podział 50/50
ruch_dziennie <- 450
dni <- 2 * n_grupa / ruch_dziennie
cat("Potrzebne dni:", round(dni, 1), " -> zaokrąglone do pełnych tygodni:", 7 * ceiling(dni / 7), "\n")
Wynik w R
Osób na wersję: 2507  razem: 5014
 mde_pp n_na_wersje.0.8 n_na_wersje.0.9
    1.0           14751           19747
    2.0            3841            5142
    2.5            2507            3356
    3.0            1774            2375
    5.0             686             918
Potrzebne dni: 11.1  -> zaokrąglone do pełnych tygodni: 14
2. Analiza: kontrola podziału, test proporcji, różnica z CI, względny wzrost i poprawka Holma
R
# B319 – analiza testu A/B: kontrola proporcji grup, test proporcji, różnica z 95% CI, względny wzrost
# Dane symulowane, set.seed(3245): 14 dni, każdy nowy odwiedzający losowo trafia do wersji A albo B.
set.seed(3245)
dni <- 14
na_dzien <- rpois(dni, 450)
dane <- data.frame(dzien = rep(seq_len(dni), na_dzien))
dane$wersja <- factor(ifelse(runif(nrow(dane)) < 0.5, "A", "B"))
p_zapis <- ifelse(dane$wersja == "B", 0.125, 0.10)              # prawda w populacji
dane$zapis <- rbinom(nrow(dane), 1, p_zapis)                      # metryka główna
dane$cennik <- rbinom(nrow(dane), 1, ifelse(dane$wersja == "B", 0.215, 0.20))   # metryki dodatkowe
dane$formularz <- rbinom(nrow(dane), 1, ifelse(dane$wersja == "B", 0.19, 0.18))
write.csv(dane, "../ab-test-dane-przyklad.csv", row.names = FALSE)

# 1. Kontrola proporcji grup (sample ratio mismatch): czy podział jest zgodny z planem 50/50?
n <- table(dane$wersja); print(n)
print(chisq.test(n, p = c(0.5, 0.5)))
# Moc przy faktycznej liczebności (średnio na wersję) i założonej różnicy 10% -> 12.5%
round(power.prop.test(n = mean(n), p1 = 0.10, p2 = 0.125)$power, 3)

# 2. Tabela 2 × 2 i test proporcji (bez poprawki Yatesa; to ten sam test co chi-kwadrat)
x <- tapply(dane$zapis, dane$wersja, sum)
tab <- table(wersja = dane$wersja, zapis = dane$zapis); print(tab)
print(round(100 * x / n, 2))
pt <- prop.test(x[c("B", "A")], n[c("B", "A")], correct = FALSE); print(pt)

# 3. Różnica odsetków B − A z 95% CI Newcombe'a (łączy przedziały Wilsona obu grup)
wilson <- function(x, n, z = qnorm(0.975)) {
  p <- x / n; srodek <- (p + z^2 / (2 * n)) / (1 + z^2 / n)
  pol <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2)) / (1 + z^2 / n)
  c(srodek - pol, srodek + pol)
}
newcombe <- function(x1, n1, x2, n2) {
  p1 <- x1 / n1; p2 <- x2 / n2; w1 <- wilson(x1, n1); w2 <- wilson(x2, n2); d <- p1 - p2
  c(roznica = d, dol = d - sqrt((p1 - w1[1])^2 + (w2[2] - p2)^2),
    gor = d + sqrt((w1[2] - p1)^2 + (p2 - w2[1])^2))
}
print(round(100 * newcombe(x[["B"]], n[["B"]], x[["A"]], n[["A"]]), 2))

# 4. Względny wzrost (lift) = pB / pA − 1 z 95% CI z logarytmu ryzyka względnego
rr <- (x[["B"]] / n[["B"]]) / (x[["A"]] / n[["A"]])
se_log <- sqrt(1 / x[["B"]] - 1 / n[["B"]] + 1 / x[["A"]] - 1 / n[["A"]])
print(round(100 * (c(lift = rr, dol = rr * exp(-1.96 * se_log), gor = rr * exp(1.96 * se_log)) - 1), 1))

# 5. Metryki dodatkowe i poprawka Holma (metryka główna testowana bez poprawki, bo była jedna i ustalona z góry)
p_dod <- sapply(c("cennik", "formularz"), function(m) {
  xx <- tapply(dane[[m]], dane$wersja, sum)
  prop.test(xx[c("B", "A")], n[c("B", "A")], correct = FALSE)$p.value
})
print(round(rbind(p = p_dod, p_holm = p.adjust(p_dod, "holm")), 3))
Wynik w R
   A    B
3125 3167

	Chi-squared test for given probabilities

data:  n
X-squared = 0.28036, df = 1, p-value = 0.5965

[1] 0.881
      zapis
wersja    0    1
     A 2803  322
     B 2759  408
    A     B
10.30 12.88

	2-sample test for equality of proportions without continuity correction

data:  x[c("B", "A")] out of n[c("B", "A")]
X-squared = 10.2, df = 1, p-value = 0.001405
alternative hypothesis: two.sided
95 percent confidence interval:
 0.00998521 0.04159188
sample estimates:
   prop 1    prop 2
0.1288285 0.1030400

roznica     dol     gor
   2.58    1.00    4.16
lift  dol  gor
25.0  9.0 43.5
       cennik formularz
p       0.312     0.046
p_holm  0.312     0.092
3. Symulacja: podglądanie wyników i wiele wariantów
R
# B319 – podglądanie wyników (peeking): symulacja błędu I rodzaju i zawyżonego efektu
# Dane symulowane, set.seed(3191). Test trwa 14 dni, codziennie po ok. 225 nowych osób na wersję.
set.seed(3191)
R <- 10000; dni <- 14; na_dzien <- 225

# z dla dwóch proporcji (wspólna proporcja w mianowniku) – to samo co prop.test bez poprawki
z_prop <- function(xA, xB, nA, nB) {
  p <- (xA + xB) / (nA + nB)
  (xB / nB - xA / nA) / sqrt(p * (1 - p) * (1 / nA + 1 / nB))
}
# Jeden zestaw R testów: skumulowane wyniki po każdym z K równych „podglądów”
symuluj <- function(pA, pB, K, n_calk = dni * na_dzien) {
  n_k <- round(n_calk * seq_len(K) / K)
  przyrost <- diff(c(0, n_k))
  xA <- t(apply(matrix(rbinom(R * K, rep(przyrost, each = R), pA), R), 1, cumsum))
  xB <- t(apply(matrix(rbinom(R * K, rep(przyrost, each = R), pB), R), 1, cumsum))
  if (K == 1) { xA <- t(xA); xB <- t(xB) }
  list(z = z_prop(xA, xB, rep(n_k, each = R), rep(n_k, each = R)),
       lift = (xB / rep(n_k, each = R)) / (xA / rep(n_k, each = R)) - 1)
}

# 1. Test A/A (obie wersje identyczne, 10%): codzienny podgląd i stop przy pierwszym p < .05
aa <- symuluj(0.10, 0.10, K = dni)
fpr_koniec <- mean(abs(aa$z[, dni]) > qnorm(0.975))
fpr_codziennie <- mean(apply(abs(aa$z) > qnorm(0.975), 1, any))
cat("Błąd I rodzaju – jeden test po 14 dniach:", round(100 * fpr_koniec, 1), "%\n")
cat("Błąd I rodzaju – podgląd codziennie (14 razy):", round(100 * fpr_codziennie, 1), "%\n")

# 2. Stała granica dla 14 podglądów (w duchu Pococka), wyznaczona symulacyjnie na rozkładzie normalnym
zN <- t(apply(matrix(rnorm(200000 * dni), ncol = dni), 1, cumsum)) / rep(sqrt(seq_len(dni)), each = 200000)
max_z <- apply(abs(zN), 1, max)
granica <- unname(quantile(max_z, 0.95))
cat("Stała granica |z| dla 14 podglądów:", round(granica, 3),
    " (nominalne p =", sub("^0", "", formatC(2 * pnorm(-granica), format = "f", digits = 4)), ")\n")
cat("Błąd I rodzaju z tą granicą:", round(100 * mean(apply(abs(aa$z) > granica, 1, any)), 1), "%\n")

# 3. Jak błąd rośnie z liczbą podglądów (ta sama łączna liczebność)
K_siatka <- c(1, 2, 3, 5, 7, 10, 14, 20)
fpr_K <- sapply(K_siatka, function(K) mean(apply(abs(symuluj(0.10, 0.10, K)$z) > qnorm(0.975), 1, any)))
print(data.frame(podglady = K_siatka, blad_I_proc = round(100 * fpr_K, 1)), row.names = FALSE)

# 4. Prawdziwy efekt (10% -> 12.5%, wzrost o 25%): zatrzymanie przy pierwszym p < .05 zawyża wzrost
ab <- symuluj(0.10, 0.125, K = dni)
istotny <- abs(ab$z) > qnorm(0.975) & ab$z > 0
dzien_stop <- apply(istotny, 1, function(w) if (any(w)) which(w)[1] else NA)
lift_stop <- ab$lift[cbind(seq_len(R), ifelse(is.na(dzien_stop), dni, dzien_stop))]
wczesnie <- !is.na(dzien_stop) & dzien_stop <= 7
cat("Moc – jeden test po 14 dniach:", round(100 * mean(istotny[, dni]), 1), "%\n")
cat("Odsetek testów zatrzymanych w 1. tygodniu:", round(100 * mean(wczesnie), 1), "%\n")
cat("Średni oszacowany wzrost: zatrzymane w 1. tygodniu", round(100 * mean(lift_stop[wczesnie]), 1),
    "%, jeden test po 14 dniach (wszystkie)", round(100 * mean(ab$lift[, dni]), 1), "%\n")

# 5. Wiele wariantów: kontrola i 3 identyczne warianty (A/A/A/A), każdy porównany z kontrolą
n_w <- dni * na_dzien
xK <- rbinom(R, n_w, 0.10)
xW <- matrix(rbinom(3 * R, n_w, 0.10), R)
p_w <- 2 * pnorm(-abs(z_prop(xK, xW, n_w, n_w)))
cat("Co najmniej jeden fałszywy „zwycięzca” spośród 3 wariantów – bez poprawki:",
    round(100 * mean(apply(p_w < 0.05, 1, any)), 1), "%, z poprawką Holma:",
    round(100 * mean(apply(p_w, 1, function(p) any(p.adjust(p, "holm") < 0.05))), 1), "%\n")
Wynik w R
Błąd I rodzaju – jeden test po 14 dniach: 4.7 %
Błąd I rodzaju – podgląd codziennie (14 razy): 22.1 %
Stała granica |z| dla 14 podglądów: 2.61  (nominalne p = .0090 )
Błąd I rodzaju z tą granicą: 4.8 %
 podglady blad_I_proc
        1         5.1
        2         8.8
        3        10.6
        5        14.1
        7        16.4
       10        18.7
       14        21.9
       20        24.4
Moc – jeden test po 14 dniach: 88.5 %
Odsetek testów zatrzymanych w 1. tygodniu: 71.1 %
Średni oszacowany wzrost: zatrzymane w 1. tygodniu 50.4 %, jeden test po 14 dniach (wszystkie) 25.4 %
Co najmniej jeden fałszywy „zwycięzca” spośród 3 wariantów – bez poprawki: 12.2 %, z poprawką Holma: 4.3 %
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet stats); rysunki powstały w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Ile osób potrzeba do testu A/B?
To zależy od odsetka bazowego i najmniejszej różnicy, którą chcesz wykryć. Przy 10% zapisów, różnicy 2.5 punktu procentowego, α = .05 i mocy 80% power.prop.test() w R daje 2507 osób na wersję. Przy różnicy 1 punktu procentowego potrzeba już 14 751 osób na wersję. Policz to przed startem, np. w kalkulatorze liczebności próby.
Czy mogę zakończyć test A/B, gdy wynik stanie się istotny?
Nie, jeśli nie masz planu sekwencyjnego. W symulacji 10 000 testów A/A codzienne sprawdzanie i zatrzymanie przy pierwszym p < .05 dało fałszywy alarm w 22.1% testów zamiast 5%, a przy prawdziwym efekcie wczesne zatrzymanie średnio podwajało oszacowany wzrost. Ustal z góry liczebność i czas trwania albo liczbę podglądów z surowszą granicą.
Jaki test statystyczny zastosować w teście A/B?
Gdy wynik to tak/nie, a grupy są niezależne, użyj testu dla dwóch proporcji, który bez poprawki na ciągłość jest tym samym co chi-kwadrat dla tabeli 2 × 2. Do testu dodaj różnicę odsetków z 95% przedziałem ufności Newcombe’a i względny wzrost z przedziałem policzonym na skali logarytmu ryzyka względnego. Dla wyniku ciągłego, np. kwoty zamówienia, porównujesz średnie.
Jak zaplanować czas trwania testu A/B przy małym ruchu na stronie?
Podziel wymaganą liczebność przez dzienny ruch i zaokrąglij wynik w górę do pełnych tygodni. Przy 5014 potrzebnych osobach i 450 nowych odwiedzających dziennie to 11.1 dnia, czyli w praktyce 14 dni. Pełne tygodnie obejmują dni robocze i weekend, kiedy na stronę trafiają inne osoby. Termin zakończenia ustal przed startem.
Co to jest sample ratio mismatch w teście A/B?
To sytuacja, w której podział osób między wersje odbiega od zaplanowanego, np. od 50/50. Sprawdzisz to testem chi-kwadrat zgodności liczebności grup. Wyraźnie istotny wynik zwykle oznacza błąd w przypisywaniu wersji albo w zapisie danych. Wtedy nie interpretuj wyniku głównego, dopóki nie znajdziesz przyczyny (Fabijan i in., 2019).
Powiązane hasła
Przeczytaj też
Statystyka w pracy z informatyki
Test użyteczności, test A/B, algorytmy na wielu zbiorach danych, ankieta akceptacji technologii i benchmarki: testy, wielkość efektu, zdania APA i kod R.
Czytaj →PoradnikStatystyka w pracy z marketingu
Skala postaw wobec marki, NPS z przedziałem ufności, test A/B, intencja zakupu, mediacja i segmentacja: testy, zdania APA, dane XLSX i kod R.
Czytaj →PoradnikJak porównać odsetki w dwóch grupach?
Tabela 2 × 2, test chi-kwadrat lub Fishera i różnica w punktach procentowych z 95% CI Newcombe’a – z przykładem w R i wzorem opisu.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikPułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikCUPED – krótszy test A/B
Wydatki sprzed testu jako kowariant: węższy przedział, symulacja 1000 testów, związek z ANCOVA i pułapka kowariantu po starcie – z kodem R.
Czytaj →PoradnikWskaźniki ilorazowe w testach A/B – CTR i średni koszyk
Losujesz użytkowników, a liczysz wyświetlenia i zamówienia: naiwny przedział, metoda delta, bootstrap po użytkownikach i 1000 testów A/A – z kodem R.
Czytaj →PoradnikWielorękie bandyty a test A/B
Portal z przepisami i cztery nagłówki: test A/B, strategia epsilon-zachłanna i UCB1 w 1000 symulacjach – utracone kliknięcia, trafność i obciążone średnie.
Czytaj →PoradnikTest A/B z wieloma wariantami
Pięć tematów maila i kontrola: Dunnett, Holm i Tukey, klątwa zwycięzcy w 1000 symulacji, test potwierdzający i moc – pięć rysunków z kodem R.
Czytaj →PoradnikDługoterminowy holdout personalizacji
Serwis z muzyką: efekt personalizacji tydzień po tygodniu, zanik nowości, retencja abonentów, pułapki i koszt holdoutu – kod R.
Czytaj →Planujesz test A/B do pracy dyplomowej?
Sprawdzimy plan eksperymentu, liczebność i metrykę główną, policzymy analizę i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Fabijan, A., Gupchup, J., Gupta, S., Omhover, J., Qin, W., Vermeer, L., & Dmitriev, P. (2019). Diagnosing sample ratio mismatch in online controlled experiments: A taxonomy and rules of thumb for practitioners. In Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 2156–2164). ACM. https://doi.org/10.1145/3292500.3330722
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Johari, R., Koomen, P., Pekelis, L., & Walsh, D. (2022). Always valid inference: Continuous monitoring of A/B tests. Operations Research, 70(3), 1806–1821. https://doi.org/10.1287/opre.2021.2135
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Pocock, S. J. (1977). Group sequential methods in the design and analysis of clinical trials. Biometrika, 64(2), 191–199. https://doi.org/10.1093/biomet/64.2.191
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
Cytowania BibTeX
@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@inproceedings{fabijan2019diagnosing, author={Fabijan, Aleksander and Gupchup, Jayant and Gupta, Somit and Omhover, Jeff and Qin, Wen and Vermeer, Lukas and Dmitriev, Pavel}, title={{Diagnosing sample ratio mismatch in online controlled experiments: A taxonomy and rules of thumb for practitioners}}, booktitle={Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery \& Data Mining}, year={2019}, pages={2156--2164}, publisher={ACM}, doi={10.1145/3292500.3330722}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{johari2022always, author={Johari, Ramesh and Koomen, Pete and Pekelis, Leonid and Walsh, David}, title={{Always valid inference: Continuous monitoring of A/B tests}}, journal={Operations Research}, year={2022}, volume={70}, number={3}, pages={1806--1821}, doi={10.1287/opre.2021.2135}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{pocock1977group, author={Pocock, Stuart J.}, title={{Group sequential methods in the design and analysis of clinical trials}}, journal={Biometrika}, year={1977}, volume={64}, number={2}, pages={191--199}, doi={10.1093/biomet/64.2.191}}@article{simmons2011false, author={Simmons, Joseph P. and Nelson, Leif D. and Simonsohn, Uri}, title={{False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant}}, journal={Psychological Science}, year={2011}, volume={22}, number={11}, pages={1359--1366}, doi={10.1177/0956797611417632}}