Przykład: serwis streamingowy z muzyką i nowa strona główna
Fikcyjny serwis streamingowy z muzyką zmienia stronę główną aplikacji. Zamiast tych samych list przebojów i playlist redakcji każdy abonent widzi teraz miksy dobrane do swojego gustu. Krótki test A/B wypadł świetnie: po dwóch tygodniach abonenci z nową stroną słuchali o 12.7% więcej. Dyrektor produktu pyta jednak: czy ten zysk zostanie, czy to tylko ciekawość nowości? I czy personalizacja zatrzymuje abonentów, skoro rezygnacje rozkładają się na miesiące, a nie na dwa tygodnie?
Odpowiedź daje długoterminowy holdout. Przy wdrożeniu losujemy 5% abonentów i zostawiamy im starą stronę główną na pół roku. Reszta (95%) dostaje personalizację. Różnica między grupami tydzień po tygodniu pokazuje, jak efekt zmienia się w czasie. Ten sam pomysł w reklamie – wyłączenie kampanii losowej części klientów – opisuje wpis test wyłączenia reklamy (holdout). Tu holdout trwa dłużej i mierzy dwie rzeczy: słuchanie i odejścia.
Dane są fikcyjne, więc znamy prawdę. Ręcznie ustaliliśmy m.in.: 200 000 abonentów (10 000 w holdoucie); ukryte zaangażowanie, od którego zależy i słuchanie (mediana 55 odsłuchów tygodniowo), i ryzyko rezygnacji (przeciętnie 1.1% tygodniowo); efekt nowości (+15% w 1. tygodniu, szybko wygasa); efekt uczenia się (narasta do +6%); spadek szans rezygnacji o 15%; nową funkcję dla obu grup od 14. tygodnia i 0.4% holdoutu tygodniowo, które „wypada” z grupy po zmianie urządzenia. Pełną listę podajemy przy kodzie. Ziarno 686 ustaliliśmy raz. Po pierwszym uruchomieniu zmieniliśmy parametry (m.in. efekt nowości z 10% na 15% i liczbę abonentów ze 100 000 na 200 000), bo tygodniowe przedziały zasłaniały kształt efektu; ziarna nie zmienialiśmy. Dane pobierzesz jako holdout-personalizacji-abonenci.csv (wiersz = abonent: grupa P – personalizacja, H – holdout; odsłuchy w 4 tygodniach przed startem, tydzień rezygnacji lub końca obserwacji, rezygnacja, tydzień wypadnięcia z holdoutu) i holdout-personalizacji-tygodnie.csv (sumy odsłuchów i liczba aktywnych w każdym tygodniu i grupie).
Rysunek 1: oś czasu holdoutu
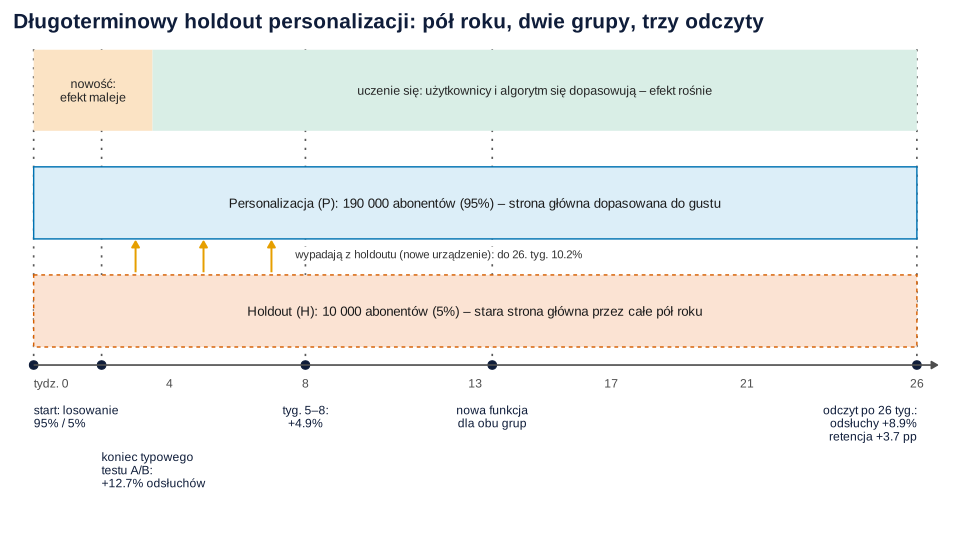
set.seed(686)).Co widać. Randomizacja w dniu startu dzieli abonentów 95/5 i ten podział trwa pół roku. Na osi są trzy odczyty, które dają trzy różne odpowiedzi: po 2 tygodniach +12.7% odsłuchów, w tygodniach 5–8 tylko +4.9%, a po pół roku +8.9% i 3.7 pp więcej abonentów. W 14. tygodniu obie grupy dostają jednocześnie nową funkcję.
Jak może zmylić. Holdout przecieka: abonent, który zmienia telefon, może stracić oznaczenie grupy. Do 26. tygodnia stronę z personalizacją zobaczyło 10.2% holdoutu (rysunek 4).
Zdanie do Metody:
Rysunek 2: efekt tydzień po tygodniu – nowość i uczenie się
W każdym tygodniu porównujemy średnią liczbę odsłuchów na abonenta z losowania. Kto zrezygnował, ma zero – to analiza ITT, w której nikogo nie usuwamy. Wynik podajemy jako procent względem holdoutu z przedziałem z metody delta na skali logarytmu ilorazu średnich. Odsłuchy z 4 tygodni przed startem posłużyły jako kowariant (CUPED; Deng i in., 2013). Korekta zwęziła przedział w 26. tygodniu z ±2.45 do ±2.04 punktu procentowego.
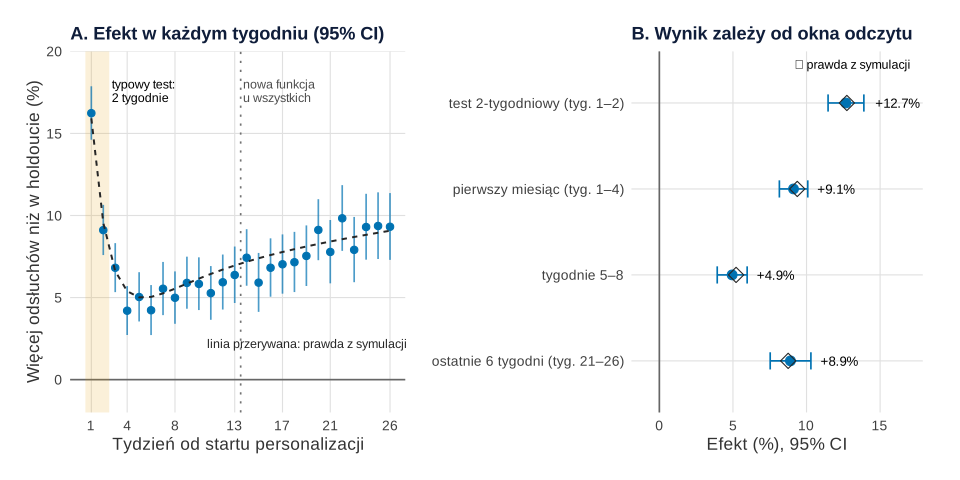
set.seed(686)).Co widać. W 1. tygodniu abonenci z personalizacją słuchają o 16.2% więcej, 95% CI [14.6, 17.9]. W 4. tygodniu przewaga spada do +4.2% [2.7, 5.7] – ciekawość nowej strony wygasła. Potem efekt powoli rośnie i w 26. tygodniu wynosi +9.3% [7.3, 11.4]. Ten wzrost ma dwa źródła: abonenci uczą się korzystać z miksów (a algorytm uczy się ich gustu), a w grupie z personalizacją więcej osób wciąż płaci abonament. Sadeghi i in. (2022) nazywają malejący efekt efektem nowości, a rosnący – efektem pierwszeństwa, związanym z przyzwyczajaniem się użytkowników do zmiany. Panel B pokazuje skutek: test 2-tygodniowy daje +12.7% [11.5, 13.9], tygodnie 5–8 – +4.9% [3.9, 6.0], a ostatnie 6 tygodni – +8.9% [7.5, 10.3]. Prawda z symulacji dla tych okien to 12.7%, 5.2% i 8.8%: każde okno mierzy dobrze, ale co innego.
Jak może zmylić. Krótki test poprawnie mierzy efekt pierwszych dwóch tygodni; błędem jest przenoszenie go na pół roku: tu zawyżyłby trwały efekt o około 40%, a test zatrzymany po miesiącu trafiłby przypadkiem w środek. Hohnhold i in. (2015) zwracają uwagę, że efekt krótkoterminowy nie zawsze przewiduje efekt po pełnym wdrożeniu, gdy użytkownicy zmienią już zachowanie. Efekt nowości w teście trwającym 4 tygodnie pokazuje wpis pułapki testów A/B na obrazkach; tu widać, co dzieje się dalej. Pojedyncze tygodnie skaczą, więc trendu nie odczytuj z jednego punktu.
Zdanie do Wyników:
Rysunek 3: retencja – ilu abonentów zostaje
Większość abonentów po pół roku wciąż płaci – ich czas do rezygnacji jest cenzurowany. Dlatego retencję liczymy krzywą Kaplana–Meiera i modelem Coxa, jak we wpisie churn jako analiza przeżycia. Tam pytamy, kiedy klienci odchodzą; tu – o ile odchodzi ich mniej dzięki losowo przydzielonej zmianie.
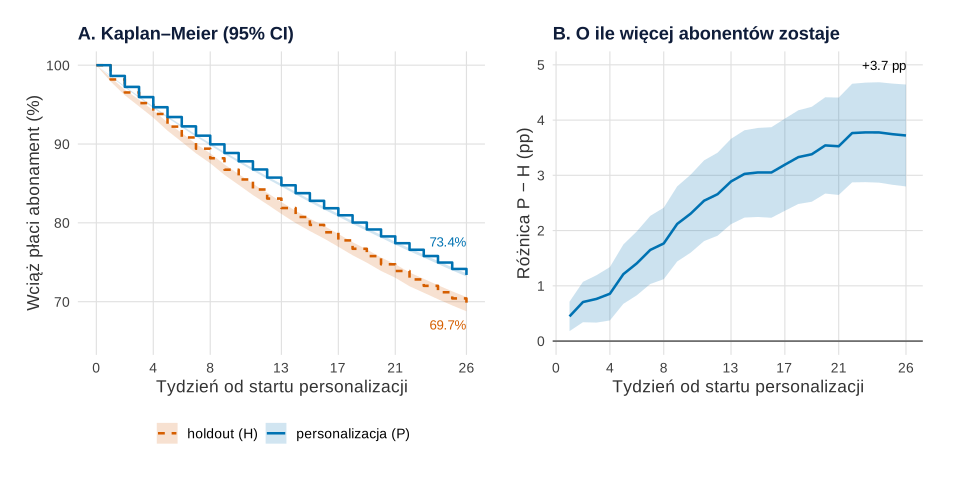
Co widać. Po 26 tygodniach abonament płaci 73.4% grupy z personalizacją, 95% CI [73.2, 73.6], i 69.7% holdoutu [68.8, 70.6]. Różnica wynosi 3.7 pp [2.8, 4.6] (prawda: 3.3 pp) i rośnie z każdym tygodniem. W przeliczeniu na całą bazę to około 7442 abonentów więcej. Model Coxa daje HR = 0.85, 95% CI [0.82, 0.88], p < .001; test proporcjonalności ryzyk (reszty Schoenfelda) nie wskazał odstępstw, χ²(1) = 2.90, p = .089.
Jak może zmylić. HR to jedna liczba, która uśrednia ryzyko z całego okresu, a jej wartość zależy od długości obserwacji; ma też wbudowane obciążenie selekcją, bo w każdym tygodniu porównuje tylko tych, którzy jeszcze zostali (Hernán, 2010). Dlatego jako wynik główny podaj różnicę odsetka abonentów w ustalonym momencie (26 tygodni) z przedziałem, a HR – jako uzupełnienie. Duży serwis streamingowy ocenia algorytmy rekomendacji właśnie w testach A/B nastawionych na retencję i zaangażowanie w średnim horyzoncie (Gomez-Uribe i Hunt, 2015).
Zdanie do Wyników:
Rysunek 4: kogo porównujesz i kto wypada z holdoutu
Panele często pokazują „odsłuchy na aktywnego użytkownika”. W długim holdoucie to pułapka: personalizacja zatrzymuje także słabiej zaangażowanych, więc po kilku miesiącach aktywni w obu grupach to już inni ludzie. To błąd przeżywalności: porównanie przestaje być porównaniem z losowania.
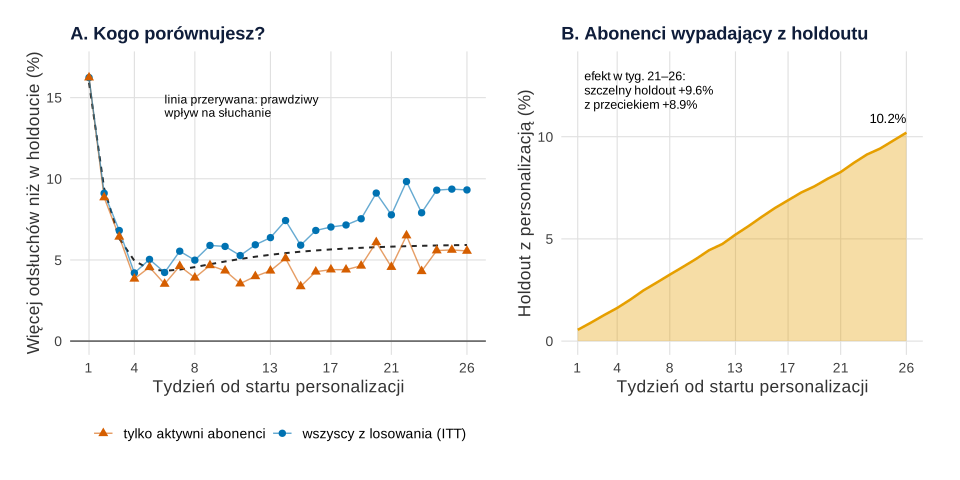
Co widać. Panel A: na początku obie linie się pokrywają, bo prawie nikt nie zrezygnował. W tygodniach 21–26 porównanie abonentów aktywnych do końca daje +5.4% [4.4, 6.4], a porównanie wszystkich z losowania +8.9% [7.5, 10.3]. Pierwsza liczba pomija zysk z retencji, a do tego jest zaniżona względem prawdziwego wpływu na słuchanie (5.9%), bo wśród aktywnych po pół roku słabo zaangażowanych (dolna ćwiartka) jest 16.0% w grupie z personalizacją i 14.8% w holdoucie. Zhou i Fishbach (2016) pokazali ten sam mechanizm w eksperymentach internetowych: gdy odsetek porzuceń różni się między warunkami, losowy przydział przestaje działać i powstają fałszywe wnioski.
Panel B – abonenci wypadający z holdoutu. Do 4. tygodnia personalizację zobaczyło 1.6% holdoutu, do 13. – 5.2%, do 26. – 10.2%. To kontaminacja między grupami: holdout staje się trochę podobny do grupy z personalizacją, więc różnica maleje. W tygodniach 21–26 oszacowanie wynosi +8.9% zamiast +9.6% przy szczelnym holdoucie – jest zaniżone o 7.7%. Nie usuwaj tych osób (zmiana urządzenia może zależeć od aktywności) – analizuj grupy z losowania i raportuj przeciek.
Zdanie do Wyników:
Rysunek 5: koszt holdoutu a wartość wiedzy
Holdout nie jest darmowy. Abonent z holdoutu odsłuchał przez pół roku o 115 utworów mniej (7.3%); razem to 1.15 mln odsłuchów i 6249 opłaconych tygodni abonamentu, czyli około 34 595 zł przychodu. Co za to dostajemy? Liczymy precyzję przy innych udziałach holdoutu (te same wariancje, inne liczebności).
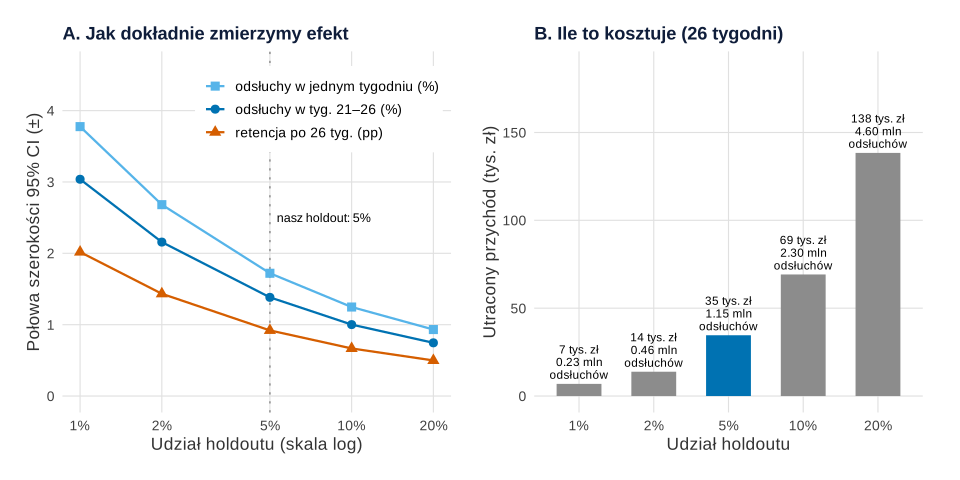
set.seed(686)).Co widać. Koszt rośnie liniowo z udziałem holdoutu, a precyzja – jak pierwiastek. Przy 1% (2000 abonentów) przedział dla jednego tygodnia ma ±3.78 punktu procentowego, czyli tyle, ile wynosi cały spadek po efekcie nowości; krzywej z rysunku 2 nie dałoby się odczytać. Przy 5% to ±1.72, przy 20% ±0.93 – za czterokrotnie wyższą cenę (138 tys. zł). Sam fakt, że retencja się poprawia, wykryłby nawet holdout 1% (w 91.8% symulacji; błąd Monte Carlo 0.9 pp), ale z przedziałem ±2.02 pp zamiast ±0.92 pp.
Jak może zmylić. Rysunek liczy precyzję przy efekcie z tych danych; przed wdrożeniem go nie znasz. Wartość wiedzy zależy od decyzji: tu holdout pokazał, że krótki test zawyżał trwały efekt na słuchanie, a zysk z retencji jest wyraźny dopiero po miesiącach. Kohavi i in. (2020) radzą wybierać metrykę główną testów tak, by przewidywała długoterminową wartość (ogólne kryterium oceny); holdout jest sposobem, by sprawdzić, czy krótkie metryki ją przewidują.
Zdanie do Metody:
Co z tym zrobić w marketingu
- Nie planuj budżetu na wyniku 2-tygodniowego testu. Tu +12.7% po dwóch tygodniach, a trwały efekt na odsłuchy około +9% – i to z udziałem retencji. Do prognozy przychodu bierz okno z ostatnich tygodni holdoutu.
- Raportuj dwie liczby: efekt na odsłuchy na abonenta z losowania i różnicę odsetka abonentów po 26 tygodniach. Retencja (+3.7 pp) to przy abonamencie główne źródło wartości personalizacji.
- Powtarzaj holdout co pół roku – pokaże, czy efekt nie znika.
- Testuj ulepszenia algorytmu na tle holdoutu. Kolejne wersje rekomendacji porównuj krótkimi testami (np. przeplataniem list, jak we wpisie wyszukiwarka w sklepie – NDCG i test przeplatania), a długi holdout trzymaj jako punkt odniesienia dla całej personalizacji. Podstawy rekomendacji: analiza koszykowa i rekomendacje.
- Nie zaglądaj co tydzień z decyzją „zatrzymać”. Jeśli chcesz kończyć wcześniej, zaplanuj analizy pośrednie z granicami, jak we wpisie sekwencyjny test A/B.
Jak opisać w pracy
W Metodzie podaj jednostkę losowania, udział i czas holdoutu, metrykę główną, kowariant CUPED, zmiany produktu w trakcie i sposób liczenia retencji. W Wynikach – efekt w oknach (początek, środek, koniec), różnicę retencji z CI, HR i odsetek przecieku. Inne tematy prac z danymi marketingowymi zebraliśmy we wpisie statystyka w pracy z marketingu.
Kod R: dane, efekt w czasie, retencja, pułapki i koszt holdoutu
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne przepisy. Efekty liczymy w bazowym R, retencję w pakiecie survival (survfit(), coxph()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 5; każdy zaczyna od własnego set.seed(686). Ziarno 686 ustalono raz i nie zmieniano go. Ręcznie ustalono: 200 000 abonentów i holdout 10 000 (5%), 26 tygodni, ukryte zaangażowanie abonenta (rozkład normalny), średnią odsłuchów (mediana 55 tygodniowo, rozrzut lognormalny 0.6), tygodniowe wahania słuchania (rozkład gamma o kształcie 4), odsłuchy z 4 tygodni przed startem, efekt nowości (+15%, stała czasowa 1.5 tygodnia), efekt uczenia się (+6%, stała 6 tygodni), nową funkcję dla obu grup od 14. tygodnia (+6%), ryzyko rezygnacji (1.1% tygodniowo, −0.9 × zaangażowanie w skali logitu), iloraz szans rezygnacji przy personalizacji 0.85, przeciek 0.4% holdoutu tygodniowo i cenę abonamentu 23.99 zł miesięcznie. Po pierwszym uruchomieniu zmieniono: efekt nowości (10% → 15%), liczbę abonentów (100 000 → 200 000), kształt rozkładu gamma (3 → 4) i zależność rezygnacji od zaangażowania (−0.5 → −0.9) oraz dodano korektę CUPED – tak, by kształt efektu i różnica składu aktywnych były widoczne. Powtórzenia: 1000 symulowanych holdoutów dla każdego z 5 udziałów. Całość liczy się w kilkanaście sekund.
1. Paleta, motyw i dane abonentów
R
# Dane. Fikcyjny serwis streamingowy z muzyką: personalizacja strony głównej i stały holdout 5% przez 26 tygodni
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey55", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie ---------------------------------------------------------------
N         <- 200000   # abonenci w dniu startu personalizacji
udzial_H  <- 0.05     # stały holdout: 5% bez personalizacji przez 26 tygodni
TYG       <- 26       # tygodnie obserwacji
nowosc    <- 0.15     # efekt nowości: +15% odsłuchów w 1. tygodniu ...
tau_now   <- 1.5      # ... wygasający wykładniczo (stała czasowa 1.5 tygodnia)
dlugi     <- 0.06     # efekt uczenia się: narasta do +6% ...
tau_ucz   <- 6        # ... ze stałą czasową 6 tygodni
tydz_zmiany <- 14     # od 14. tygodnia nowa funkcja dla wszystkich (obie grupy): +6% odsłuchów
h_baza    <- 0.011    # tygodniowe ryzyko rezygnacji przeciętnego abonenta bez personalizacji
or_rez    <- 0.85     # personalizacja mnoży szanse rezygnacji przez 0.85
p_przeciek <- 0.004   # tygodniowa szansa, że abonent z holdoutu „wypadnie” z grupy (nowe urządzenie) i zobaczy personalizację

efekt <- function(k) ifelse(k >= 1, 1 + nowosc * exp(-(k - 1) / tau_now) + dlugi * (1 - exp(-k / tau_ucz)), 1)
trend <- ifelse(1:TYG >= tydz_zmiany, 1.06, 1)

set.seed(686)
zaang <- rnorm(N)                                         # ukryte zaangażowanie abonenta (analityk go nie zna)
grupa <- sample(rep(c("P", "H"), c(N * (1 - udzial_H), N * udzial_H)))   # P – personalizacja, H – holdout
mu <- exp(log(55) + 0.6 * zaang)                          # średnia odsłuchów w tygodniu bez personalizacji
h0 <- plogis(qlogis(h_baza) - 0.9 * zaang)                # ryzyko rezygnacji bez personalizacji
h1 <- plogis(qlogis(h0) + log(or_rez))                    # ... i z personalizacją
przeciek <- ifelse(grupa == "H", rgeom(N, p_przeciek) + 1, Inf)   # tydzień, od którego abonent z H widzi personalizację
przeciek[przeciek > TYG] <- Inf
G <- matrix(rgamma(N * TYG, 4, 4), N, TYG)                # tygodniowe wahania słuchania (średnio 1)
U <- matrix(runif(N * TYG), N, TYG); V <- matrix(runif(N * TYG), N, TYG)
przed <- rpois(N, mu * rgamma(N, 16, 4))                  # odsłuchy w 4 tygodniach przed startem (do korekty CUPED)

symuluj <- function(start) {   # start: tydzień pierwszej personalizacji (Inf = nigdy); te same liczby losowe
  aktywny <- rep(TRUE, N); Y <- matrix(0L, N, TYG); czas <- rep(TYG, N); rez <- rep(0L, N)
  for (t in 1:TYG) {
    pers <- t >= start
    Y[, t] <- ifelse(aktywny, qpois(U[, t], mu * trend[t] * efekt(t - start + 1) * G[, t]), 0L)
    koniec <- aktywny & V[, t] < ifelse(pers, h1, h0)
    czas[koniec] <- t; rez[koniec] <- 1L; aktywny <- aktywny & !koniec
  }
  list(Y = Y, czas = czas, rez = rez)
}
obs <- symuluj(ifelse(grupa == "P", 1, przeciek))         # to, co widzi analityk (z przeciekami)
bez <- symuluj(ifelse(grupa == "P", 1, Inf))              # gdyby holdout był szczelny (tylko w symulacji)

# Prawda znana z symulacji (oczekiwane wartości, bez przecieków)
S0 <- sapply(0:(TYG - 1), function(t) mean(mu * (1 - h0)^t)); S1 <- sapply(0:(TYG - 1), function(t) mean(mu * (1 - h1)^t))
prawda <- data.frame(tydzien = 1:TYG, zaangazowanie = 100 * (efekt(1:TYG) - 1),
                     itt = 100 * (S1 * efekt(1:TYG) / S0 - 1))
prawda_ret <- 100 * c(H = mean((1 - h0)^TYG), P = mean((1 - h1)^TYG))

# Pliki CSV: abonent (grupa, tydzień rezygnacji lub końca, rezygnacja, tydzień przecieku) i sumy tygodniowe
abonenci <- data.frame(grupa, odsluchy_przed_4tyg = przed, czas_tyg = obs$czas, rezygnacja = obs$rez,
                       przeciek_tyg = ifelse(is.finite(przeciek) & przeciek <= obs$czas, przeciek, NA))
write.csv(abonenci, "holdout-personalizacji-abonenci.csv", row.names = FALSE, quote = FALSE, na = "")
tyg <- do.call(rbind, lapply(1:TYG, function(t) do.call(rbind, lapply(c("P", "H"), function(g) {
  i <- grupa == g; a <- i & obs$czas >= t
  data.frame(tydzien = t, grupa = g, z_losowania = sum(i), aktywni = sum(a), odsluchy = sum(obs$Y[i, t]),
             sd_na_abonenta = round(sd(obs$Y[i, t]), 2), sd_na_aktywnego = round(sd(obs$Y[a, t]), 2)) }))))
write.csv(tyg, "holdout-personalizacji-tygodnie.csv", row.names = FALSE, quote = FALSE)

# Opis danych
c(abonenci = N, P = sum(grupa == "P"), H = sum(grupa == "H"),
  odsluchy_tydz1_na_abonenta = round(mean(obs$Y[, 1]), 1),
  rezygnacje_26_tyg_proc = round(100 * mean(obs$rez), 1))
round(prawda[c(1, 2, 4, 5, 8, 13, 20, 26), ], 2)
round(prawda_ret, 2)
Wynik w R
                  abonenci                          P
                  200000.0                   190000.0
                         H odsluchy_tydz1_na_abonenta
                   10000.0                       75.7
    rezygnacje_26_tyg_proc
                      26.8
   tydzien zaangazowanie   itt
1        1         15.92 15.92
2        2          9.40  9.56
4        4          4.95  5.39
5        5          4.43  5.01
8        8          4.56  5.54
13      13          5.32  6.95
20      20          5.79  8.27
26      26          5.92  9.07
    H     P
70.03 73.36
2. Efekt tydzień po tygodniu i okna odczytu: Rysunek 2
R
# Rysunek 2. Efekt personalizacji tydzień po tygodniu (ITT) i co pokazałby krótki test
# Korzysta z obiektów przepisu 1: obs, grupa, przed, prawda, TYG, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)

P <- grupa == "P"; H <- grupa == "H"
wzgl <- function(y, x, p = P, h = H) {   # różnica średnich w % (grupa p względem h) z 95% CI; korekta CUPED kowariantem x
  ya <- y - cov(y[p | h], x[p | h]) / var(x[p | h]) * (x - mean(x[p | h]))
  m1 <- mean(ya[p]); m0 <- mean(ya[h])
  se <- sqrt(var(ya[p]) / (sum(p) * m1^2) + var(ya[h]) / (sum(h) * m0^2))   # metoda delta na skali log
  setNames(100 * (exp(log(m1 / m0) + c(0, -1.96, 1.96) * se) - 1), c("efekt", "dolna", "gorna"))
}
# Odsłuchy na abonenta z losowania (po rezygnacji 0) – porównanie całych grup (ITT), osobno w każdym tygodniu
tydz <- data.frame(tydzien = 1:TYG, t(sapply(1:TYG, function(t) wzgl(obs$Y[, t], przed))), prawda = prawda$itt)
round(tydz[c(1:6, 8, 10, 13, 14, 17, 20, 23, 26), ], 2)
# Bez korekty CUPED przedziały są szersze (połowa szerokości w tygodniu 1 i 26)
bez_cuped <- function(t) { y <- obs$Y[, t]; m1 <- mean(y[P]); m0 <- mean(y[H])
  100 * 1.96 * sqrt(var(y[P]) / (sum(P) * m1^2) + var(y[H]) / (sum(H) * m0^2)) }
round(c(pol_CI_tydz1_bez = bez_cuped(1), pol_CI_tydz1_cuped = (tydz$gorna[1] - tydz$dolna[1]) / 2,
        pol_CI_tydz26_bez = bez_cuped(26), pol_CI_tydz26_cuped = (tydz$gorna[26] - tydz$dolna[26]) / 2), 2)
# Okna odczytu: średnia z tygodni w oknie na abonenta
okno <- function(t) c(wzgl(rowMeans(obs$Y[, t, drop = FALSE]), przed), prawda = mean(prawda$itt[t]))
okna <- rbind("test 2-tygodniowy (tyg. 1–2)" = okno(1:2), "pierwszy miesiąc (tyg. 1–4)" = okno(1:4),
              "tygodnie 5–8" = okno(5:8), "ostatnie 6 tygodni (tyg. 21–26)" = okno(21:26))
round(okna, 2)
c(najnizszy_tydzien = which.min(tydz$efekt), najnizszy_efekt = round(min(tydz$efekt), 2))

# Rysunek 2A: efekt w kolejnych tygodniach z 95% CI i prawda z symulacji
pA <- ggplot(tydz, aes(tydzien, efekt)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  annotate("rect", xmin = 0.5, xmax = 2.5, ymin = -Inf, ymax = Inf, fill = kol[["pomarancz"]], alpha = 0.15) +
  annotate("text", x = 2.7, y = 17.6, label = "typowy test:\n2 tygodnie", hjust = 0, size = 3.3, lineheight = 0.9) +
  geom_vline(xintercept = 13.5, colour = "grey45", linetype = "13") +
  annotate("text", x = 13.7, y = 17.6, label = "nowa funkcja\nu wszystkich", hjust = 0, size = 3.3, lineheight = 0.9, colour = "grey30") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0, colour = kol[["niebieski"]], alpha = 0.7) +
  geom_point(colour = kol[["niebieski"]], size = 2.2) +
  geom_line(aes(y = prawda), colour = "grey15", linetype = "22", linewidth = 0.7) +
  annotate("text", x = 19, y = 2.2, label = "linia przerywana: prawda z symulacji", size = 3.3, colour = "grey15") +
  scale_x_continuous(breaks = c(1, 4, 8, 13, 17, 21, 26)) +
  coord_cartesian(ylim = c(-1, 19)) +
  labs(x = "Tydzień od startu personalizacji", y = "Więcej odsłuchów niż w holdoucie (%)",
       title = "A. Efekt w każdym tygodniu (95% CI)") + motyw
# Rysunek 2B: oszacowanie zależy od okna odczytu
d <- data.frame(okno = factor(rownames(okna), levels = rev(rownames(okna))), okna)
pB <- ggplot(d, aes(efekt, okno)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, orientation = "y", colour = kol[["niebieski"]]) +
  geom_point(size = 3, colour = kol[["niebieski"]]) +
  geom_point(aes(x = prawda), shape = 5, size = 3.4, colour = "grey15") +
  geom_text(aes(x = gorna, label = sprintf("%+.1f%%", efekt)), hjust = -0.25, size = 3.5) +
  annotate("text", x = 17, y = 4.45, hjust = 1, size = 3.3, label = "◇ prawda z symulacji") +
  scale_x_continuous(limits = c(-1, 17), breaks = seq(0, 15, 5)) +
  labs(x = "Efekt (%), 95% CI", y = NULL, title = "B. Wynik zależy od okna odczytu") + motyw
p2 <- pA + pB + plot_layout(widths = c(1.15, 1))
p2   # zapis: ggsave("holdout-personalizacji-efekt-tydzien-po-tygodniu.svg", p2, width = 10, height = 5)
Wynik w R
   tydzien efekt dolna gorna prawda
1        1 16.24 14.62 17.88  15.92
2        2  9.11  7.59 10.65   9.56
3        3  6.81  5.33  8.32   6.61
4        4  4.20  2.72  5.70   5.39
5        5  5.03  3.54  6.54   5.01
6        6  4.23  2.72  5.76   5.04
8        8  4.99  3.40  6.60   5.54
10      10  5.83  4.24  7.45   6.15
13      13  6.37  4.67  8.11   6.95
14      14  7.43  5.72  9.16   7.18
17      17  7.03  5.24  8.85   7.78
20      20  9.12  7.28 10.99   8.27
23      23  7.91  5.94  9.91   8.69
26      26  9.31  7.30 11.37   9.07
   pol_CI_tydz1_bez  pol_CI_tydz1_cuped   pol_CI_tydz26_bez pol_CI_tydz26_cuped
               1.88                1.63                2.45                2.04
                                efekt dolna gorna prawda
test 2-tygodniowy (tyg. 1–2)    12.67 11.46 13.89  12.74
pierwszy miesiąc (tyg. 1–4)      9.11  8.15 10.08   9.37
tygodnie 5–8                     4.94  3.93  5.96   5.21
ostatnie 6 tygodni (tyg. 21–26)  8.90  7.53 10.30   8.75
najnizszy_tydzien   najnizszy_efekt
              4.0               4.2
3. Retencja: Kaplan–Meier i model Coxa – Rysunek 3
R
# Rysunek 3. Retencja: ilu abonentów zostaje w każdej grupie (Kaplan–Meier) i model Coxa
# Korzysta z obiektów przepisu 1: obs, grupa, prawda_ret, TYG, kol, motyw. Niczego nie losuje.
library(ggplot2)
library(patchwork)
library(survival)

d <- data.frame(grupa = factor(grupa, levels = c("H", "P")), czas = obs$czas, rez = obs$rez)
km <- survfit(Surv(czas, rez) ~ grupa, data = d)
s26 <- summary(km, times = TYG)
ret <- data.frame(grupa = c("holdout (H)", "personalizacja (P)"), aktywni_proc = 100 * s26$surv,
                  dolna = 100 * s26$lower, gorna = 100 * s26$upper)
ret[, -1] <- round(ret[, -1], 2); ret
roznica <- 100 * diff(s26$surv); se_r <- 100 * sqrt(sum(s26$std.err^2))
round(c(roznica_pp = roznica, dolna = roznica - 1.96 * se_r, gorna = roznica + 1.96 * se_r), 2)
round(prawda_ret, 2)
cox <- coxph(Surv(czas, rez) ~ grupa, data = d, ties = "efron")
round(c(HR = exp(coef(cox)), exp(confint(cox)), p = summary(cox)$coefficients[, "Pr(>|z|)"]), 4)
# Sprawdzenie proporcjonalności ryzyk (reszty Schoenfelda)
round(cox.zph(cox)$table, 3)
# Ile abonentów więcej po pół roku w całej bazie, gdyby personalizacja objęła wszystkich
c(dodatkowi_abonenci_na_200_tys = round(roznica / 100 * nrow(d)))

# Rysunek 3A: odsetek abonentów, którzy wciąż płacą (Kaplan–Meier, 95% CI)
s <- summary(km, times = 0:TYG)
dk <- data.frame(tydzien = s$time, aktywni = 100 * s$surv, dolna = 100 * s$lower, gorna = 100 * s$upper,
                 grupa = ifelse(grepl("P", s$strata), "personalizacja (P)", "holdout (H)"))
pA <- ggplot(dk, aes(tydzien, aktywni, colour = grupa, fill = grupa, linetype = grupa)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), stat = "identity", alpha = 0.18, colour = NA) +
  geom_step(linewidth = 0.9) +
  annotate("text", x = TYG, y = ret$aktywni_proc + c(-2.6, 4.2), hjust = 1, size = 3.5,
           label = sprintf("%.1f%%", ret$aktywni_proc), colour = c(kol[["cynober"]], kol[["niebieski"]])) +
  scale_colour_manual(values = c("holdout (H)" = kol[["cynober"]], "personalizacja (P)" = kol[["niebieski"]]), name = NULL) +
  scale_fill_manual(values = c("holdout (H)" = kol[["cynober"]], "personalizacja (P)" = kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("holdout (H)" = "22", "personalizacja (P)" = "solid"), name = NULL) +
  scale_x_continuous(breaks = c(0, 4, 8, 13, 17, 21, 26)) +
  coord_cartesian(ylim = c(65, 100)) +
  labs(x = "Tydzień od startu personalizacji", y = "Wciąż płaci abonament (%)",
       title = "A. Kaplan–Meier (95% CI)") + motyw
# Rysunek 3B: różnica odsetka abonentów (P − H) w kolejnych tygodniach z 95% CI
dr <- do.call(rbind, lapply(1:TYG, function(t) { x <- summary(km, times = t)
  r <- 100 * diff(x$surv); se <- 100 * sqrt(sum(x$std.err^2)); data.frame(tydzien = t, r, dolna = r - 1.96 * se, gorna = r + 1.96 * se) }))
pB <- ggplot(dr, aes(tydzien, r)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = kol[["niebieski"]], alpha = 0.2) +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.9) +
  annotate("text", x = TYG, y = dr$gorna[TYG] + 0.35, hjust = 1, size = 3.5, label = sprintf("%+.1f pp", dr$r[TYG])) +
  scale_x_continuous(breaks = c(0, 4, 8, 13, 17, 21, 26)) +
  labs(x = "Tydzień od startu personalizacji", y = "Różnica P − H (pp)", title = "B. O ile więcej abonentów zostaje") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.1, 1)) & theme(legend.position = "bottom")
p3   # zapis: ggsave("holdout-personalizacji-retencja-kaplan-meier.svg", p3, width = 10, height = 5)
Wynik w R
               grupa aktywni_proc dolna gorna
1        holdout (H)        69.67 68.77 70.58
2 personalizacja (P)        73.39 73.19 73.59
roznica_pp      dolna      gorna
      3.72       2.80       4.64
    H     P
70.03 73.36
HR.grupaP                             p
   0.8531    0.8224    0.8849    0.0000
       chisq df     p
grupa  2.896  1 0.089
GLOBAL 2.896  1 0.089
dodatkowi_abonenci_na_200_tys
                         7442
4. Porównanie tylko aktywnych i abonenci wypadający z holdoutu: Rysunek 4
R
# Rysunek 4. Dwie pułapki długiego holdoutu: porównanie tylko aktywnych (przeżycie) i abonenci wypadający z holdoutu
# Korzysta z obiektów przepisów 1–2: obs, bez, grupa, zaang, przed, przeciek, prawda, tydz, okna, wzgl, P, H, TYG, kol, motyw.
# Niczego nie losuje.
library(ggplot2)
library(patchwork)

# Pułapka 1: odsłuchy na aktywnego abonenta (tylko ci, którzy jeszcze płacą w danym tygodniu)
aktywni <- data.frame(tydzien = 1:TYG, t(sapply(1:TYG, function(t) {
  a <- obs$czas >= t; wzgl(obs$Y[, t], przed, P & a, H & a) })))
porown <- data.frame(tydzien = 1:TYG, tylko_aktywni = aktywni$efekt, ITT = tydz$efekt,
                     prawda_zaangazowanie = prawda$zaangazowanie, prawda_ITT = prawda$itt)
round(porown[c(1, 4, 8, 13, 17, 21, 26), ], 2)
okno_akt <- function(t) {   # tygodnie 21–26, tylko abonenci aktywni do końca 26. tygodnia
  a <- obs$czas >= max(t) & !(obs$czas == max(t) & obs$rez == 1); wzgl(rowMeans(obs$Y[, t]), przed, P & a, H & a) }
round(rbind(tylko_aktywni_do_konca = okno_akt(21:26), ITT_wszyscy_z_losowania = okna[4, 1:3],
            prawda_zaangazowanie = rep(mean(prawda$zaangazowanie[21:26]), 3)), 2)
# Dlaczego: personalizacja zatrzymuje słabiej zaangażowanych – skład aktywnych się różni
slabi <- zaang < quantile(zaang, 0.25)                     # dolna ćwiartka ukrytego zaangażowania
round(100 * c(slabi_wsrod_aktywnych_P = mean(slabi[P & obs$czas == TYG & obs$rez == 0]),
              slabi_wsrod_aktywnych_H = mean(slabi[H & obs$czas == TYG & obs$rez == 0])), 1)

# Pułapka 2: abonenci, którzy wypadli z holdoutu (nowe urządzenie) i zobaczyli personalizację
wypadli <- sapply(1:TYG, function(t) 100 * mean(przeciek[H] <= t))
round(c(tydz4 = wypadli[4], tydz13 = wypadli[13], tydz26 = wypadli[26]), 1)
z_przeciekiem <- okna[4, 1:3]
szczelny <- wzgl(rowMeans(bez$Y[, 21:26]), przed)            # ten sam holdout bez przecieków (znany tylko w symulacji)
round(rbind(z_przeciekiem, szczelny_holdout = szczelny), 2)
round(100 * (1 - z_przeciekiem[["efekt"]] / szczelny[["efekt"]]), 1)   # o ile procent przeciek zaniżył efekt

# Rysunek 4A: odsłuchy – wszyscy z losowania (ITT) a tylko aktywni, na tle prawdy
dl <- rbind(data.frame(tydzien = 1:TYG, efekt = tydz$efekt, co = "wszyscy z losowania (ITT)"),
            data.frame(tydzien = 1:TYG, efekt = aktywni$efekt, co = "tylko aktywni abonenci"))
pA <- ggplot(dl, aes(tydzien, efekt, colour = co, shape = co)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_line(data = prawda, aes(tydzien, zaangazowanie), inherit.aes = FALSE, colour = "grey15", linetype = "22", linewidth = 0.7) +
  geom_line(linewidth = 0.5, alpha = 0.6) + geom_point(size = 2.2) +
  annotate("text", x = 6, y = 14.5, hjust = 0, size = 3.2, label = "linia przerywana: prawdziwy\nwpływ na słuchanie", lineheight = 0.9) +
  scale_colour_manual(values = c("wszyscy z losowania (ITT)" = kol[["niebieski"]], "tylko aktywni abonenci" = kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c("wszyscy z losowania (ITT)" = 16, "tylko aktywni abonenci" = 17), name = NULL) +
  scale_x_continuous(breaks = c(1, 4, 8, 13, 17, 21, 26)) +
  coord_cartesian(ylim = c(0, 17)) +
  labs(x = "Tydzień od startu personalizacji", y = "Więcej odsłuchów niż w holdoucie (%)",
       title = "A. Kogo porównujesz?") + motyw + theme(legend.position = "bottom")
# Rysunek 4B: odsetek holdoutu, który zobaczył personalizację
pB <- ggplot(data.frame(tydzien = 1:TYG, wypadli), aes(tydzien, wypadli)) +
  geom_area(fill = kol[["pomarancz"]], alpha = 0.35) +
  geom_line(colour = kol[["pomarancz"]], linewidth = 0.9) +
  annotate("text", x = 1.5, y = 13.2, hjust = 0, vjust = 1, size = 3.3, lineheight = 0.95,
           label = sprintf("efekt w tyg. 21–26:\nszczelny holdout %+.1f%%\nz przeciekiem %+.1f%%",
                           szczelny[["efekt"]], z_przeciekiem[["efekt"]])) +
  annotate("text", x = TYG, y = wypadli[TYG] + 0.7, hjust = 1, size = 3.5, label = sprintf("%.1f%%", wypadli[TYG])) +
  scale_x_continuous(breaks = c(1, 4, 8, 13, 17, 21, 26)) +
  coord_cartesian(ylim = c(0, 13.5)) +
  labs(x = "Tydzień od startu personalizacji", y = "Holdout z personalizacją (%)",
       title = "B. Abonenci wypadający z holdoutu") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.15, 1))
p4   # zapis: ggsave("holdout-personalizacji-pulapki-przezycie-przeciek.svg", p4, width = 10, height = 5)
Wynik w R
   tydzien tylko_aktywni   ITT prawda_zaangazowanie prawda_ITT
1        1         16.24 16.24                15.92      15.92
4        4          3.84  4.20                 4.95       5.39
8        8          3.90  4.99                 4.56       5.54
13      13          4.33  6.37                 5.32       6.95
17      17          4.40  7.03                 5.65       7.78
21      21          4.56  7.78                 5.82       8.41
26      26          5.56  9.31                 5.92       9.07
                        efekt dolna gorna
tylko_aktywni_do_konca   5.39  4.42  6.36
ITT_wszyscy_z_losowania  8.90  7.53 10.30
prawda_zaangazowanie     5.88  5.88  5.88
slabi_wsrod_aktywnych_P slabi_wsrod_aktywnych_H
                   16.0                    14.8
 tydz4 tydz13 tydz26
   1.6    5.2   10.2
                 efekt dolna gorna
z_przeciekiem     8.90  7.53 10.30
szczelny_holdout  9.65  8.26 11.05
[1] 7.7
5. Koszt holdoutu a precyzja: Rysunek 5
R
# Rysunek 5. Koszt holdoutu (utracone odsłuchy i abonamenty) a to, czego się z niego dowiadujemy
# Korzysta z obiektów przepisów 1–4: obs, przed, P, H, N, TYG, prawda_ret, okna, kol, motyw. Losuje – własne set.seed(686).
library(ggplot2)
library(patchwork)

cena_tydz <- 23.99 * 12 / 52                                  # abonament 23.99 zł miesięcznie, w przeliczeniu na tydzień
# Koszt obecnego holdoutu 5% (10 000 abonentów) przez 26 tygodni
odsl_na_os <- mean(rowSums(obs$Y[P, ])) - mean(rowSums(obs$Y[H, ]))   # ile odsłuchów mniej na abonenta w H
tyg_na_os <- mean(obs$czas[P]) - mean(obs$czas[H])                     # ile opłaconych tygodni mniej na abonenta w H
koszt5 <- c(odsluchy_mniej_na_abonenta = odsl_na_os, odsluchy_mniej_tys = sum(H) * odsl_na_os / 1000,
            proc_odsluchow_holdoutu = 100 * odsl_na_os / mean(rowSums(obs$Y[H, ])),
            tygodnie_abonamentu_mniej = sum(H) * tyg_na_os, przychod_mniej_zl = sum(H) * tyg_na_os * cena_tydz)
round(koszt5, 1)

# Precyzja i koszt przy różnych udziałach holdoutu (wariancje z danych, liczebności przeskalowane)
skladniki <- function(y) { ya <- y - cov(y, przed) / var(przed) * (przed - mean(przed))   # CUPED jak w przepisie 2
  c(m1 = mean(ya[P]), m0 = mean(ya[H]), v1 = var(ya[P]), v0 = var(ya[H])) }
pol_CI <- function(k, n1, n0) {   # połowa szerokości 95% CI dla efektu w % przy liczebnościach n1, n0
  se <- sqrt(k[["v1"]] / (n1 * k[["m1"]]^2) + k[["v0"]] / (n0 * k[["m0"]]^2)); e <- log(k[["m1"]] / k[["m0"]])
  c(pol = 100 * (exp(e + 1.96 * se) - exp(e - 1.96 * se)) / 2, moc = 100 * pnorm(e / se - 1.96)) }
k_okno <- skladniki(rowMeans(obs$Y[, 21:26]))                  # okno tygodni 21–26
k_tydz <- skladniki(obs$Y[, 13])                               # pojedynczy tydzień (13.) – kształt krzywej
udzialy <- c(0.01, 0.02, 0.05, 0.10, 0.20)
S <- prawda_ret / 100                                          # prawdziwy odsetek abonentów po 26 tygodniach (H, P)
set.seed(686)
plan <- do.call(rbind, lapply(udzialy, function(u) {
  n0 <- u * N; n1 <- (1 - u) * N
  # 1000 symulowanych holdoutów: czy 95% CI dla różnicy odsetka abonentów po 26 tygodniach wyklucza zero?
  x0 <- rbinom(1000, n0, S[["H"]]); x1 <- rbinom(1000, n1, S[["P"]])
  r <- x1 / n1 - x0 / n0; se_r <- sqrt(x1 / n1 * (1 - x1 / n1) / n1 + x0 / n0 * (1 - x0 / n0) / n0)
  data.frame(holdout_proc = 100 * u, abonentow_H = n0,
             pol_CI_tydzien_proc = pol_CI(k_tydz, n1, n0)[["pol"]], pol_CI_okno_proc = pol_CI(k_okno, n1, n0)[["pol"]],
             moc_okno = pol_CI(k_okno, n1, n0)[["moc"]],
             pol_CI_retencja_pp = 100 * 1.96 * mean(se_r),
             moc_retencja = 100 * mean(r - 1.96 * se_r > 0),
             koszt_tys_zl = n0 * tyg_na_os * cena_tydz / 1000,
             odsluchy_mln = n0 * odsl_na_os / 1e6) }))
plan$blad_mc_retencja <- sqrt(plan$moc_retencja * (100 - plan$moc_retencja) / 1000)
round(plan, 2)

# Rysunek 5A: pewność wyniku według wielkości holdoutu
d1 <- rbind(data.frame(h = plan$holdout_proc, pol = plan$pol_CI_tydzien_proc, co = "odsłuchy w jednym tygodniu (%)"),
            data.frame(h = plan$holdout_proc, pol = plan$pol_CI_okno_proc, co = "odsłuchy w tyg. 21–26 (%)"),
            data.frame(h = plan$holdout_proc, pol = plan$pol_CI_retencja_pp, co = "retencja po 26 tyg. (pp)"))
pA <- ggplot(d1, aes(h, pol, colour = co, shape = co)) +
  geom_vline(xintercept = 5, colour = "grey60", linetype = "13") +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  annotate("text", x = 5.3, y = 2.5, hjust = 0, size = 3.3, label = "nasz holdout: 5%") +
  scale_colour_manual(values = c(kol[["blekit"]], kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(15, 16, 17), name = NULL) +
  scale_x_continuous(trans = "log10", breaks = 100 * udzialy, labels = paste0(100 * udzialy, "%")) +
  scale_y_continuous(limits = c(0, 4.6)) +
  labs(x = "Udział holdoutu (skala log)", y = "Połowa szerokości 95% CI (±)", title = "A. Jak dokładnie zmierzymy efekt") + motyw +
  theme(legend.position = "inside", legend.position.inside = c(0.66, 0.84), legend.background = element_rect(fill = "white", colour = NA))
# Rysunek 5B: koszt – utracony przychód z abonamentów w holdoucie przez 26 tygodni
pB <- ggplot(plan, aes(factor(paste0(holdout_proc, "%"), levels = paste0(100 * udzialy, "%")), koszt_tys_zl)) +
  geom_col(aes(fill = holdout_proc == 5), width = 0.6) +
  geom_text(aes(label = sprintf("%.0f tys. zł\n%.2f mln\nodsłuchów", koszt_tys_zl, odsluchy_mln)), vjust = -0.15, size = 3.1, lineheight = 0.9) +
  scale_fill_manual(values = c(kol[["szary"]], kol[["niebieski"]]), guide = "none") +
  scale_y_continuous(limits = c(0, 1.35 * max(plan$koszt_tys_zl))) +
  labs(x = "Udział holdoutu", y = "Utracony przychód (tys. zł)", title = "B. Ile to kosztuje (26 tygodni)") + motyw
p5 <- pA + pB + plot_layout(widths = c(1, 1))
p5   # zapis: ggsave("holdout-personalizacji-koszt-a-wiedza.svg", p5, width = 10, height = 5)
Wynik w R
odsluchy_mniej_na_abonenta         odsluchy_mniej_tys
                     115.0                     1150.2
   proc_odsluchow_holdoutu  tygodnie_abonamentu_mniej
                       7.3                     6249.0
         przychod_mniej_zl
                   34595.4
  holdout_proc abonentow_H pol_CI_tydzien_proc pol_CI_okno_proc moc_okno
1            1        2000                3.78             3.04      100
2            2        4000                2.68             2.16      100
3            5       10000                1.72             1.38      100
4           10       20000                1.25             1.00      100
5           20       40000                0.93             0.75      100
  pol_CI_retencja_pp moc_retencja koszt_tys_zl odsluchy_mln blad_mc_retencja
1               2.02         91.8         6.92         0.23             0.87
2               1.43         99.8        13.84         0.46             0.14
3               0.92        100.0        34.60         1.15             0.00
4               0.67        100.0        69.19         2.30             0.00
5               0.50        100.0       138.38         4.60             0.00
6. Grafika: oś czasu holdoutu – Rysunek 1
R
# Rysunek 1. Grafika: oś czasu długoterminowego holdoutu personalizacji
# Korzysta z obiektów przepisów 1–4: grupa, okna, roznica, wypadli, TYG, tydz_zmiany. Liczby na osi pochodzą z danych.
# Niczego nie losuje.
library(ggplot2)

tys <- function(x) format(x, big.mark = " ")
strzalka <- arrow(length = unit(0.18, "cm"), type = "closed")
fazy <- data.frame(x0 = c(0, 3.5), x1 = c(3.5, TYG), tlo = c("#FBE3C4", "#D9EEE6"),
                   tekst = c("nowość:\nefekt maleje", "uczenie się: użytkownicy i algorytm się dopasowują – efekt rośnie"))
zdarzenia <- data.frame(
  x = c(0, 2, 8, tydz_zmiany - 0.5, TYG), y = c(1.3, 0.78, 1.3, 1.3, 1.3),
  tekst = c("start: losowanie\n95% / 5%",
            sprintf("koniec typowego\ntestu A/B:\n%+.1f%% odsłuchów", okna[1, "efekt"]),
            sprintf("tyg. 5–8:\n%+.1f%%", okna[3, "efekt"]),
            "nowa funkcja\ndla obu grup",
            sprintf("odczyt po 26 tyg.:\nodsłuchy %+.1f%%\nretencja %+.1f pp", okna[4, "efekt"], roznica)))
p1 <- ggplot() +
  geom_segment(data = zdarzenia, aes(x = x, xend = x, y = 1.75, yend = 5.3), colour = "grey35", linetype = "13") +
  geom_rect(data = fazy, aes(xmin = x0, xmax = x1, ymin = 4.35, ymax = 5.25, fill = tlo), colour = NA) +
  geom_text(data = fazy, aes(x = (x0 + x1) / 2, y = 4.8, label = tekst), size = 3.3, lineheight = 0.9, colour = "grey15") +
  annotate("rect", xmin = 0, xmax = TYG, ymin = 3.15, ymax = 3.95, fill = "#DCEEF8", colour = "#0072B2", linewidth = 0.5) +
  annotate("text", x = TYG / 2, y = 3.55, size = 3.5, colour = "grey10",
           label = sprintf("Personalizacja (P): %s abonentów (95%%) – strona główna dopasowana do gustu", tys(sum(grupa == "P")))) +
  annotate("rect", xmin = 0, xmax = TYG, ymin = 1.95, ymax = 2.75, fill = "#FBE3D3", colour = "#D55E00", linewidth = 0.5, linetype = "22") +
  annotate("text", x = TYG / 2, y = 2.35, size = 3.5, colour = "grey10",
           label = sprintf("Holdout (H): %s abonentów (5%%) – stara strona główna przez całe pół roku", tys(sum(grupa == "H")))) +
  annotate("segment", x = c(3, 5, 7), xend = c(3, 5, 7), y = 2.78, yend = 3.12, arrow = strzalka, colour = "#E69F00", linewidth = 0.7) +
  annotate("label", x = 7.6, y = 2.98, hjust = 0, size = 3.0, linewidth = 0, fill = "white", colour = "grey20",
           label = sprintf("wypadają z holdoutu (nowe urządzenie): do 26. tyg. %.1f%%", wypadli[TYG])) +
  geom_point(data = zdarzenia, aes(x, 1.75), size = 2.6, colour = "#0f1d3a") +
  geom_text(data = zdarzenia, aes(x, y, label = tekst), size = 3.2, lineheight = 0.9, vjust = 1,
            hjust = c(0, 0, 0.5, 0.5, 1), colour = "#0f1d3a") +
  annotate("segment", x = 0, xend = TYG + 0.6, y = 1.75, yend = 1.75, colour = "grey30", arrow = strzalka) +
  annotate("text", x = c(0, 4, 8, 13, 17, 21, 26), y = 1.55, label = c("tydz. 0", 4, 8, 13, 17, 21, 26), size = 3.2,
           colour = "grey30", hjust = c(0, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5)) +
  scale_fill_identity() +
  coord_cartesian(xlim = c(-0.6, TYG + 0.8), ylim = c(-0.05, 5.35), expand = FALSE) +
  labs(title = "Długoterminowy holdout personalizacji: pół roku, dwie grupy, trzy odczyty") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", margin = margin(b = 6)),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 12, 8, 10))
p1   # zapis: ggsave("holdout-personalizacji-os-czasu.svg", p1, width = 10, height = 5.6)
7. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (personalizacja / holdout)" = c("#0072B2", "#D55E00"),
             "niebieski – błękit (okno 21–26 / jeden tydzień)" = c("#0072B2", "#56B4E9"),
             "cynober – pomarańczowy (holdout / przeciek)" = c("#D55E00", "#E69F00"),
             "niebieski – szary (holdout 5% / inne udziały)" = c("#0072B2", "#8C8C8C"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                widzenie_typowe deuteranopia
niebieski – cynober (personalizacja / holdout)            114.6        108.3
niebieski – błękit (okno 21–26 / jeden tydzień)            26.4         24.7
cynober – pomarańczowy (holdout / przeciek)                33.4         18.4
niebieski – szary (holdout 5% / inne udziały)              43.2         47.1
czerwony – zielony (do unikania)                          121.7         21.1
                                                protanopia
niebieski – cynober (personalizacja / holdout)        91.9
niebieski – błękit (okno 21–26 / jeden tydzień)       24.6
cynober – pomarańczowy (holdout / przeciek)           24.9
niebieski – szary (holdout 5% / inne udziały)         39.2
czerwony – zielony (do unikania)                      31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, średnie, wariancje i rozkłady – pakiety base i stats; krzywe Kaplana–Meiera i model Coxa – pakiet survival). Rysunki wykonano w ggplot2 i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Porównanie tylko aktywnych abonentów. Daje +5.4% zamiast +8.9% i pomija zysk z retencji. Licz na wszystkich z losowania, z zerem po rezygnacji.
- Zmiany produktu w trakcie holdoutu. Nowa funkcja dla obu grup (tu od 14. tygodnia) nie psuje porównania, ale zmienia jego treść: mierzysz personalizację w nowym produkcie. Gdyby trafiła tylko do jednej grupy, holdout przestałby mierzyć samą personalizację. Prowadź dziennik zmian.
- Abonenci wypadający z holdoutu. Przypisuj grupę do konta, nie do urządzenia, i co tydzień sprawdzaj odsetek przecieku. Przy 10% przecieku efekt jest zaniżony.
- Jedna liczba HR zamiast krzywych. HR uśrednia cały okres; podaj różnicę odsetka abonentów w ustalonym czasie.
- Nowi abonenci w trakcie. Osoby, które zapisały się po starcie, analizuj osobno (jako kolejne kohorty, jak we wpisie analiza kohortowa retencji klientów); nie dokładaj ich do kohorty z dnia losowania.
Najczęstsze pytania
Co to jest długoterminowy holdout?
To losowa grupa użytkowników (np. 5%), która po wdrożeniu zmiany zostaje na starej wersji przez kilka miesięcy. Porównanie z resztą pokazuje, jak efekt zmienia się w czasie i czy zmiana wpływa na rzadkie zdarzenia, takie jak rezygnacja z abonamentu. W przykładzie personalizacja dała +8.9% odsłuchów w tygodniach 21–26 i +3.7 pp abonentów po pół roku.
Ile trwa efekt nowości po wdrożeniu personalizacji?
Zwykle kilka tygodni, ale sprawdź to na danych: policz efekt osobno w każdym tygodniu holdoutu z przedziałami. Efekt nowości maleje, gdy użytkownicy przestają zauważać zmianę; efekt pierwszeństwa rośnie, gdy uczą się z niej korzystać (Sadeghi i in., 2022). W przykładzie efekt spadł z +16.2% w 1. tygodniu do +4.2% w 4. i wzrósł do +9.3% w 26.
Dlaczego nie porównywać tylko aktywnych użytkowników?
Bo zmiana wpływa na to, kto zostaje. Personalizacja zatrzymała także słabiej zaangażowanych abonentów, więc aktywni w obu grupach przestali być porównywalni (błąd przeżywalności). Porównanie aktywnych dało +5.4% zamiast +8.9% z porównania wszystkich z losowania i pominęło zysk z retencji.
Jak duży powinien być holdout i ile kosztuje?
Koszt rośnie liniowo z udziałem holdoutu, a precyzja tylko jak pierwiastek z liczebności. W przykładzie 200 000 abonentów holdout 1% dawał przedział tygodniowego efektu ±3.8 pp, 5% – ±1.7 pp, 20% – ±0.9 pp; utracony przychód wyniósł odpowiednio 7, 35 i 138 tys. zł w 26 tygodni. Wybierz najmniejszy udział, który pozwoli odczytać kształt efektu.
Jak podać wpływ na retencję w teście A/B?
Jako różnicę odsetka klientów, którzy zostali, w ustalonym momencie (np. po 26 tygodniach) z przedziałem z krzywych Kaplana–Meiera, a hazard ratio jako uzupełnienie. HR uśrednia cały okres i ma wbudowane obciążenie selekcją (Hernán, 2010). W przykładzie: 73.4% wobec 69.7%, różnica 3.7 pp, 95% CI [2.8, 4.6], HR = 0.85.
Powiązane hasła
Przeczytaj też
Pułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikChurn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Analizujesz długi test A/B w pracy z marketingu?
Pomożemy zaplanować holdout, policzyć efekt w kolejnych tygodniach i wpływ na retencję z przedziałami oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Deng, A., Xu, Y., Kohavi, R., & Walker, T. (2013). Improving the sensitivity of online controlled experiments by utilizing pre-experiment data. In Proceedings of the Sixth ACM International Conference on Web Search and Data Mining (pp. 123–132). ACM. https://doi.org/10.1145/2433396.2433413
- Gomez-Uribe, C. A., & Hunt, N. (2015). The Netflix recommender system: Algorithms, business value, and innovation. ACM Transactions on Management Information Systems, 6(4), 1–19. https://doi.org/10.1145/2843948
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
- Hohnhold, H., O’Brien, D., & Tang, D. (2015). Focusing on the long-term: It’s good for users and business. In Proceedings of the 21th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (pp. 1849–1858). ACM. https://doi.org/10.1145/2783258.2788583 ● Otwarty dostęp
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Sadeghi, S., Gupta, S., Gramatovici, S., Lu, J., Ai, H., & Zhang, R. (2022). Novelty and primacy: A long-term estimator for online experiments. Technometrics, 64(4), 524–534. https://doi.org/10.1080/00401706.2022.2124309 ● Otwarty dostęp: pełny tekst
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@inproceedings{deng2013improving, author={Deng, Alex and Xu, Ya and Kohavi, Ron and Walker, Toby}, title={{Improving the sensitivity of online controlled experiments by utilizing pre-experiment data}}, booktitle={Proceedings of the Sixth ACM International Conference on Web Search and Data Mining}, year={2013}, pages={123--132}, publisher={ACM}, doi={10.1145/2433396.2433413}}@article{gomezuribe2015netflix, author={Gomez-Uribe, Carlos A. and Hunt, Neil}, title={{The Netflix recommender system: Algorithms, business value, and innovation}}, journal={ACM Transactions on Management Information Systems}, year={2015}, volume={6}, number={4}, pages={1--19}, doi={10.1145/2843948}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}@inproceedings{hohnhold2015focusing, author={Hohnhold, Henning and O'Brien, Deirdre and Tang, Diane}, title={{Focusing on the long-term: It’s good for users and business}}, booktitle={Proceedings of the 21th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining}, year={2015}, pages={1849--1858}, publisher={ACM}, doi={10.1145/2783258.2788583}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{sadeghi2022novelty, author={Sadeghi, Soheil and Gupta, Somit and Gramatovici, Stefan and Lu, Jiannan and Ai, Hao and Zhang, Ruhan}, title={{Novelty and primacy: A long-term estimator for online experiments}}, journal={Technometrics}, year={2022}, volume={64}, number={4}, pages={524--534}, doi={10.1080/00401706.2022.2124309}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}