Przykład: sklep zoologiczny i 30 kohort klientów
Internetowy sklep z karmą dla zwierząt pozyskuje co miesiąc od 128 do 285 nowych klientów. Karma się kończy, więc dobry klient wraca co kilka tygodni. Dział marketingu pyta: ilu nowych klientów wraca i czy wprowadzony w październiku 2025 roku program lojalnościowy coś zmienił?
Odpowiedź daje analiza kohortowa. Kohorta to wszyscy klienci, którzy pierwszy raz kupili w tym samym miesiącu. Śledzimy każdą kohortę osobno: jaki odsetek jej klientów kupił znowu w 1., 2., 3. miesiącu od pierwszego zakupu. To ta sama logika co w badaniu kohortowym w epidemiologii, tylko zamiast choroby liczymy powrót do sklepu.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Mamy 4793 klientów pozyskanych od stycznia 2024 do czerwca 2026 i 18 246 transakcji. Parametry ustawiliśmy ręcznie, żeby było widać cztery zjawiska: klienci pozyskani w listopadzie i grudniu (promocje) wracają rzadziej; w grudniu wszyscy kupują częściej; od października 2025 sklep pozyskuje więcej klientów z mediów społecznościowych, którzy wracają rzadziej; program lojalnościowy naprawdę podnosi szansę zakupu klientów pozyskanych od października 2025 – o 0.30 na skali logitu. Ziarno 605 ustalono raz i nie zmieniano go. Transakcje pobierzesz jako kohorty-transakcje-sklepu-zoologicznego.csv (klient, kanał pozyskania, data, kwota).
Segmentację klientów pokazuje analiza skupień w marketingu, czas do odejścia klienta – churn jako analiza przeżycia, a wartość klienta w złotówkach – wartość klienta w czasie (CLV).
Rysunek 1: od transakcji do tabeli kohortowej
Sklep ma tylko listę zamówień: kto, kiedy, za ile. Tabela kohortowa powstaje w trzech krokach: dla każdego klienta znajdujemy miesiąc pierwszego zakupu (to jego kohorta). Każdemu zamówieniu przypisujemy m – liczbę miesięcy od miesiąca pierwszego zakupu. Na koniec liczymy, ilu różnych klientów kohorty kupiło w miesiącu m.
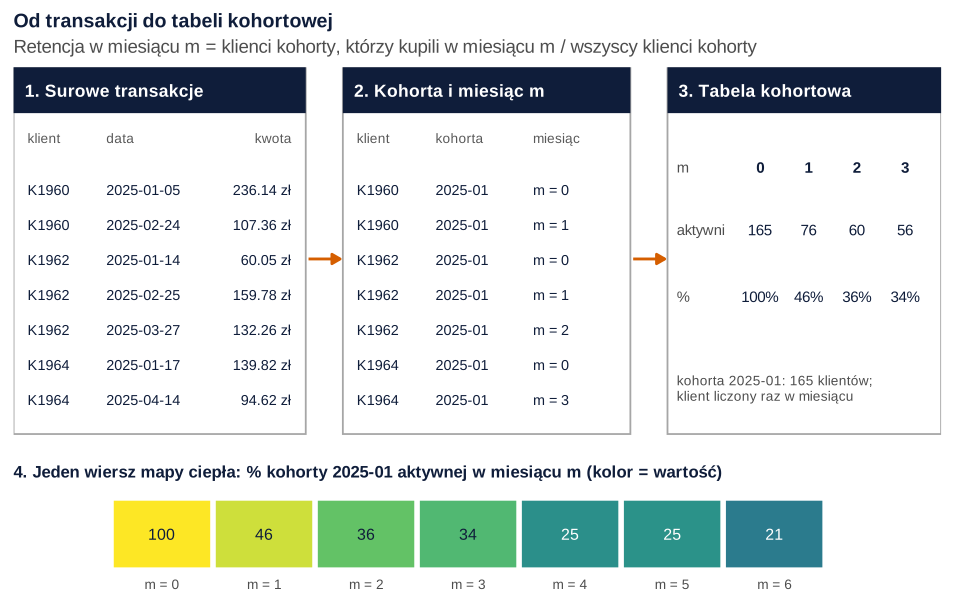
set.seed(605)).Co widać. Kohorta ze stycznia 2025 liczy 165 klientów. W następnym miesiącu (m = 1) kupiło znowu 76 z nich, w m = 2 – 60, w m = 3 – 56. Retencja w miesiącu m to:
Dla m = 1 to 76 / 165 = 46.1%, dla m = 3 – 33.9%. Mianownik się nie zmienia: zawsze dzielimy przez liczebność kohorty, nie przez liczbę klientów aktywnych miesiąc wcześniej. Klient K1964 nie kupił w lutym ani w marcu, a wrócił w kwietniu. Liczy się więc w m = 3, choć nie w m = 1 i 2.
Jak może zmylić. To jedna z kilku definicji retencji: „aktywny w miesiącu m”. Inna to „kupił w miesiącu m lub później” (wyższe liczby). Klient z dwoma zamówieniami w jednym miesiącu liczy się raz. Przed porównaniem z innym raportem sprawdź definicję.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: mapa ciepła retencji
Dla wszystkich kohort dostajemy tabelę: wiersz to kohorta, kolumna to m. Kolor pozwala zobaczyć wzorce w 282 komórkach naraz.
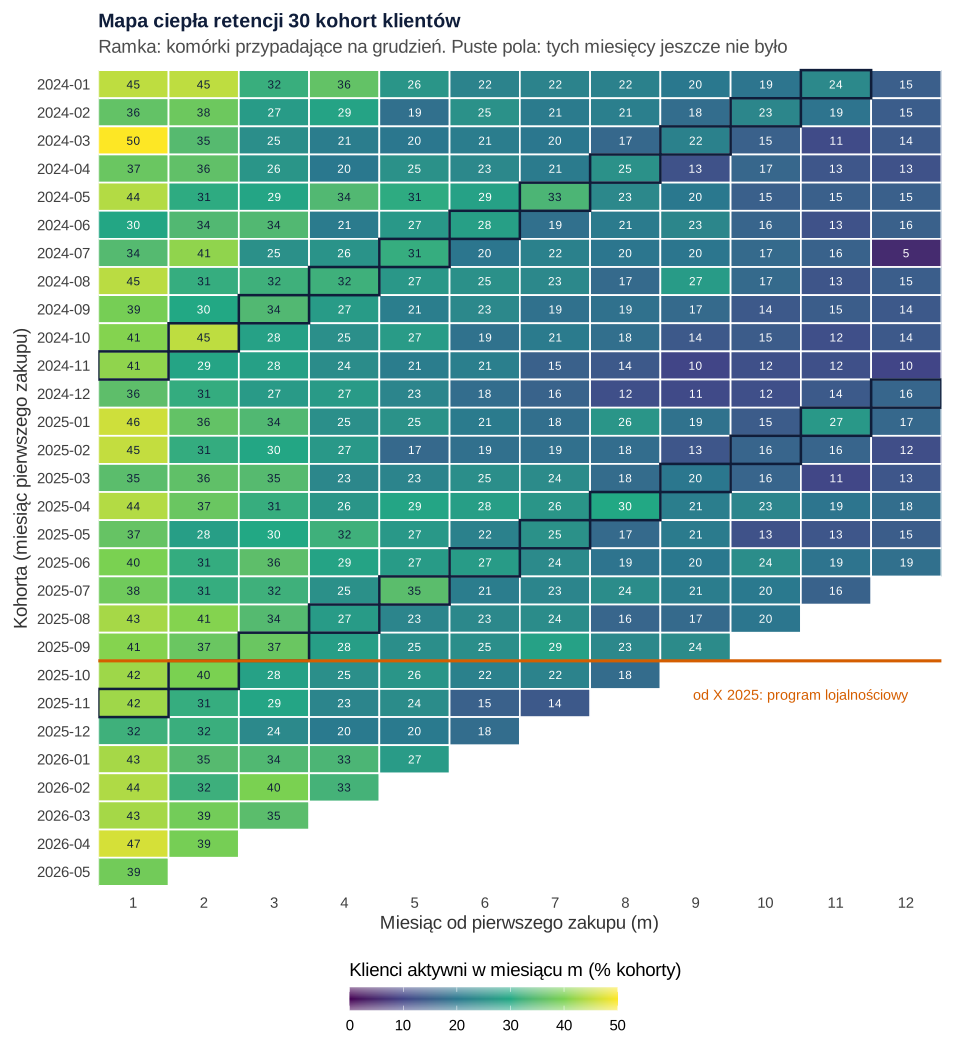
set.seed(605)).Co widać. Czytaj mapę na trzy sposoby. Wiersz to historia jednej kohorty: retencja spada średnio z 40.7% w pierwszym miesiącu do 31.0% w trzecim, 22.5% w szóstym i 14.2% w dwunastym. Kolumna porównuje kohorty w tym samym wieku: kohorty z listopada i grudnia mają w miesiącach 1–6 średnio 26.6% wobec 30.5% w pozostałych. Ukośna linia to jeden miesiąc kalendarzowy. Komórki grudniowe (w ramkach) leżą średnio 5.2 punktu procentowego (pp) powyżej średniej swojej kolumny. Grudzień podnosi zakupy wszystkich kohort naraz – to efekt okresu, a nie cecha kohorty.
Jak może zmylić. Mapa ma kształt trójkąta. Pierwszy miesiąc znamy dla 29 kohort, dwunasty już tylko dla 18 najstarszych. „Średnia retencja w 12. miesiącu” opisuje więc inne kohorty niż średnia w 1. miesiącu. Młode kohorty nie mają złej retencji – po prostu ich przyszłość jeszcze się nie wydarzyła. To ta sama idea co obserwacja cenzurowana w analizie przeżycia. Drugi kłopot: wiek kohorty (m), kalendarz i kohorta są ze sobą powiązane (miesiąc kalendarzowy = kohorta + m). Bell (2020) pokazuje, że liniowych efektów wieku, okresu i kohorty nie da się rozdzielić bez silnych założeń (zob. efekt kohorty i model APC).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: krzywe retencji z przedziałami
Do porównań lepsze są krzywe. Łączymy kohorty z 2025 roku w cztery kwartały i rysujemy krzywe retencji z 95% przedziałem ufności dla proporcji. Używamy przedziału Wilsona, bo prosty przedział Walda ma zawodne pokrycie (Brown i in., 2001).
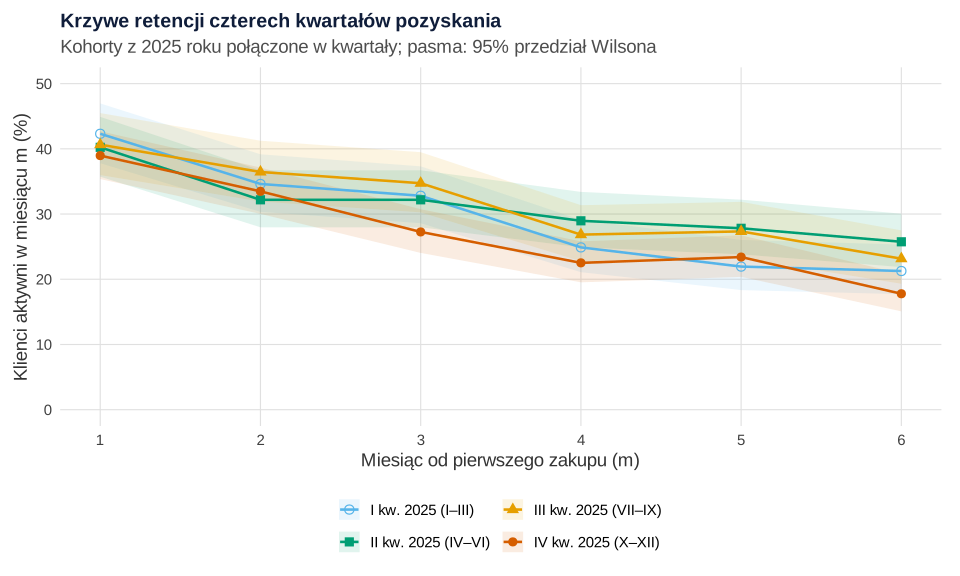
set.seed(605)).Co widać. W pierwszym miesiącu wszystkie kwartały są blisko siebie (od 39.0% do 42.3%). Potem czwarty kwartał odstaje: w trzecim miesiącu 27.3% [24.0, 30.7] wobec 32.2–34.7% w pozostałych. W szóstym miesiącu 17.8% [15.1, 20.8] wobec 25.7% [21.9, 30.1] w drugim kwartale. Czwarty kwartał to akurat kohorty z programem lojalnościowym.
Jak może zmylić. Kusi wniosek: „program zaszkodził”. Ale czwarty kwartał to też listopad i grudzień z promocjami, a do tego inna mieszanka kanałów. Przedziały mówią, że różnica raczej nie jest przypadkiem, ale nie mówią, co ją spowodowało. Tu wszystkie cztery kwartały mają pełne sześć miesięcy historii, więc trójkąt z mapy nie przeszkadza.
Podpis do pracy:
Zdanie do Wyników:
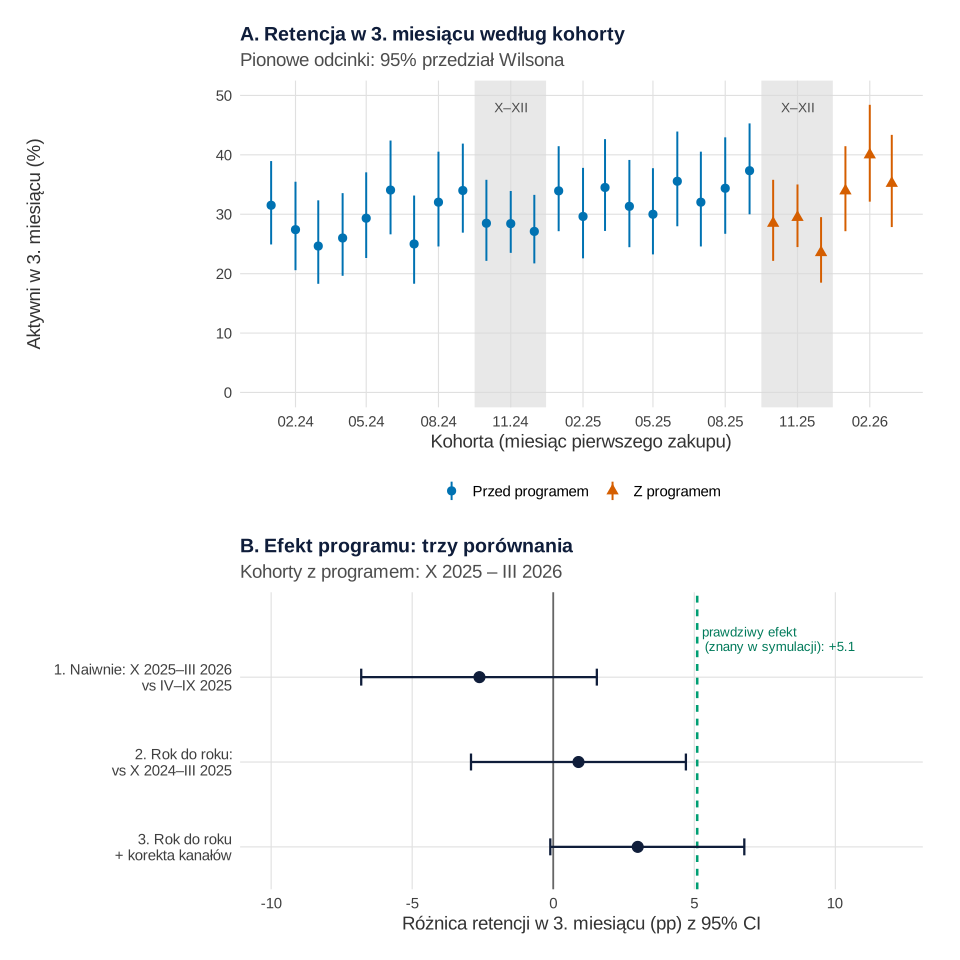
Rysunek 4: czy program lojalnościowy zadziałał?
Typowe pytanie brzmi: „czy po zmianie kohorty wracają częściej?”. Porównujemy retencję w trzecim miesiącu (ostatnim, który znamy dla wszystkich sześciu kohort z programem: od października 2025 do marca 2026) na trzy sposoby. Różnice proporcji mają 95% przedział Newcombe’a, bo prosty przedział Walda działa dobrze dopiero przy dużych próbach (Fagerland i in., 2015).
set.seed(605)).Co widać.
- Naiwnie – sześć kohort z programem (30.8%) wobec sześciu poprzednich, kwiecień–wrzesień 2025 (33.4%): różnica −2.6 pp [−6.8, 1.5].
- Rok do roku – te same miesiące pozyskania rok wcześniej (październik 2024 – marzec 2025, 29.9%). Sezon jest ten sam po obu stronach. Różnica +0.9 pp [−2.9, 4.7].
- Rok do roku z korektą kanałów – regresja logistyczna zakupu w trzecim miesiącu z programem, kanałem pozyskania i miesiącem pozyskania. Potem przewidujemy retencję klientów z programem raz z programem, raz bez niego. Przedział z 500 prób bootstrapowych: +3.0 pp [−0.1, 6.8].
Prawdziwy efekt, znany tylko dlatego, że dane są fikcyjne, to +5.1 pp. (ci sami klienci „przepuszczeni” z programem i bez niego).
Jak może zmylić. Każdy krok usunął jedną zmienną zakłócającą: najpierw sezonowość, potem mieszankę kanałów (w kohortach z programem 43.4% klientów przyszło z mediów społecznościowych, wcześniej 24.4%). Wynik zbliżał się do prawdy, ale nadal kryje wszystko, co poza programem zmieniło się w ciągu roku. Lopez Bernal i in. (2018) piszą, że prosty przerwany szereg czasowy nie wyklucza zakłócenia przez inne zdarzenia z tego samego okresu, a szereg kontrolny trzeba dobrać z góry. W prawdziwych danych nie ma zielonej linii, więc zmiana między kohortami to nie efekt programu. Do oceny zmian w czasie służą regresja segmentowa i przerwany szereg czasowy oraz różnica w różnicach. Najpewniejszy jest losowy podział nowych klientów (test A/B).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: retencja a przychód z kohorty
Retencja liczy klientów, a sklep żyje z pieniędzy. Dla 18 kohort z pełnymi 12 miesiącami historii (styczeń 2024 – czerwiec 2025) porównujemy kanały pozyskania na dwa sposoby: odsetek aktywnych i przychód narastająco na jednego pozyskanego klienta.
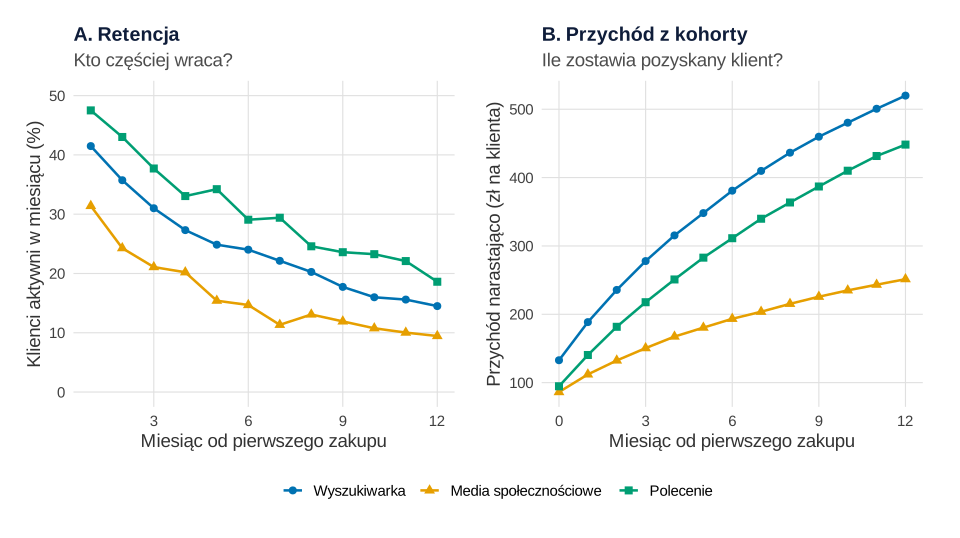
set.seed(605)).Co widać. Klienci z poleceń wracają najczęściej (średnio 30.5% aktywnych w miesiącach 1–12 wobec 24.2% z wyszukiwarki). Mimo to po roku klient z wyszukiwarki przyniósł 520 zł, a klient z polecenia 448 zł. Powód: średnie zamówienie z wyszukiwarki to 133.1 zł, z polecenia 96.2 zł. Klient z mediów społecznościowych przegrywa w obu miarach (251 zł).
Jak może zmylić. Ranking kanałów zależy od miary. Reinartz i Kumar (2000) na danych firmy wysyłkowej pokazali, że długoletni klienci nie muszą być zyskowni. Przychód to też nie zysk: brakuje kosztu pozyskania i marży. To zadanie dla wartości klienta w czasie. Do prognozy retencji na kolejne miesiące Fader i Hardie (2007) proponują model procesu odejść zamiast dopasowywania krzywej regresją.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Ustal definicję i trzymaj się jej. „Aktywny w miesiącu m”, mianownik = liczebność kohorty.
- Pierwszy miesiąc jest kluczowy. Najwięcej klientów odpada po pierwszym zakupie. Przypomnienie o kończącej się karmie po 3–4 tygodniach to dobry kandydat do testu.
- Klienci z promocji listopadowych wracają rzadziej. Nie porównuj ich z kohortami wiosennymi.
- Oceniaj kanały przychodem z kohorty, a nie samą retencją, i odejmuj koszt pozyskania.
- Nowy program włącz losowo dla połowy nowych klientów przez kilka miesięcy. Po trzech miesiącach porównanie kohort da odpowiedź bez zgadywania. Na wykresie Kaplana–Meiera pokażesz potem czas do odejścia w obu grupach.
Inne projekty z danych sklepu do pracy dyplomowej opisuje wpis statystyka w pracy z marketingu.
Jak opisać w pracy
Do Wyników dołącz tabelę retencji w wybranych miesiącach – czytelniejszą niż pełna mapa:
| Kwartał pozyskania (2025) | n | m = 1, % [95% CI] | m = 3, % [95% CI] | m = 6, % [95% CI] |
|---|---|---|---|---|
| I kw. 2025 (I–III) | 442 | 42.3 [37.8, 47.0] | 32.8 [28.6, 37.3] | 21.3 [17.7, 25.3] |
| II kw. 2025 (IV–VI) | 435 | 40.2 [35.7, 44.9] | 32.2 [28.0, 36.7] | 25.7 [21.9, 30.1] |
| III kw. 2025 (VII–IX) | 406 | 40.6 [36.0, 45.5] | 34.7 [30.3, 39.5] | 23.2 [19.3, 27.5] |
| IV kw. 2025 (X–XII) | 675 | 39.0 [35.4, 42.7] | 27.3 [24.0, 30.7] | 17.8 [15.1, 20.8] |
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i tabelę kohortową, z których korzystają pozostałe. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko dwa bloki i każdy zaczyna od własnego set.seed(605): przepis 1 (klienci i transakcje) i przepis 5 (500 prób bootstrapowych). Ziarno 605 ustalono raz i nie zmieniano go. Ręcznie ustalono (przepis 1): okres i liczbę kohort (I 2024 – VI 2026), liczebności kohort (150 × mnożnik miesiąca, od 128 do 285 osób), udziały kanałów przed programem (55%, 25%, 20%) i od października 2025 (37%, 45%, 18%), wpływ kanału (0, −0.6, 0.4 na skali logitu), typowe kwoty zamówień (125, 80 i 90 zł), efekt okresu (lipiec–sierpień −0.25, grudzień +0.35), gorszy powrót klientów z listopada i grudnia (−0.5), zróżnicowanie klientów (SD = 1.2), spadek z czasem (−0.35 · ln m), miesięczne trwałe odejście 5% klientów i prawdziwy efekt programu (+0.30). Parametry dobrano tak, żeby sezon i zmiana mieszanki kanałów wyraźnie zasłaniały efekt programu. W przepisach 3–6 ręcznie wybrano okna porównań (12 miesięcy na mapie, kwartały 2025 roku, trzeci miesiąc, kohorty z pełnym rokiem). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane: klienci, transakcje i tabela kohortowa
R
# Przepis 1. Fikcyjny sklep internetowy z karmą dla zwierząt: klienci, transakcje i tabela kohortowa
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw wszystkich rysunków
kol_prog <- c("Przed programem" = "#0072B2", "Z programem" = "#D55E00")
kol_kanal <- c("Wyszukiwarka" = "#0072B2", "Media społecznościowe" = "#E69F00", "Polecenie" = "#009E73")
ksz_kanal <- c("Wyszukiwarka" = 16, "Media społecznościowe" = 17, "Polecenie" = 15)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 30 kohort: klienci, którzy pierwszy raz kupili od stycznia 2024 do czerwca 2026 (koniec obserwacji: VI 2026).
# Wszystkie liczby poniżej ustalono ręcznie, żeby w danych były widoczne: sezon (więcej, ale mniej wiernych
# klientów z listopada i grudnia), grudniowe zakupy wszystkich kohort, zmiana mieszanki kanałów od X 2025
# i prawdziwy, niewielki efekt programu lojalnościowego dla klientów pozyskanych od X 2025.
set.seed(605)                                         # ziarno ustalone raz, bez dobierania pod wynik
start <- seq(as.Date("2024-01-01"), as.Date("2026-06-01"), by = "month")
K <- length(start)                                    # 30 miesięcy obserwacji
mies <- as.integer(format(start, "%m"))               # miesiąc kalendarzowy 1–12
program <- start >= as.Date("2025-10-01")             # program lojalnościowy dla nowych klientów od X 2025
nowi <- round(150 * c(1.1, 0.9, 0.95, 1, 1, 0.9, 0.85, 0.85, 1, 1.1, 1.9, 1.5)[mies])  # liczebność kohort
p_kanal <- rbind(przed = c(0.55, 0.25, 0.20), po = c(0.37, 0.45, 0.18))  # od X 2025 więcej reklam w social media
ef_kanal <- c(0, -0.6, 0.4)                           # wpływ kanału na szansę zakupu (skala logitu)
kwota_typowa <- c(125, 80, 90)                        # typowa kwota zamówienia (zł) według kanału
ef_okres <- c(rep(0, 6), -0.25, -0.25, 0, 0, 0, 0.35) # lipiec–sierpień rzadziej, grudzień częściej (wszyscy)
ef_promo <- -0.5                                      # klienci z promocji XI–XII rzadziej wracają
ef_programu <- 0.30                                   # prawdziwy efekt programu (logit) – znany, bo dane są fikcyjne
odejscie <- 0.05                                      # co miesiąc 5% aktywnych klientów odchodzi na dobre

klienci <- data.frame(kohorta = rep(seq_len(K), nowi))
n <- nrow(klienci)
klienci$id <- sprintf("K%04d", seq_len(n))
klienci$kanal <- factor(sapply(klienci$kohorta, function(k)
  sample(names(kol_kanal), 1, prob = p_kanal[if (program[k]) "po" else "przed", ])), names(kol_kanal))
klienci$program <- program[klienci$kohorta]
u <- rnorm(n, 0, 1.2)                                 # niewidoczne różnice między klientami
# Miesiące m = 1, 2, … od pierwszego zakupu do końca obserwacji; te same liczby losowe dla dwóch scenariuszy
mc <- data.frame(i = rep(seq_len(n), K - klienci$kohorta))
mc$m <- sequence(K - klienci$kohorta)
mc$t <- klienci$kohorta[mc$i] + mc$m                  # miesiąc kalendarzowy obserwacji (indeks 1–30)
zostal <- ave(runif(nrow(mc)) > odejscie, mc$i, FUN = cumprod) == 1
eta <- -0.3 + ef_kanal[as.integer(klienci$kanal[mc$i])] + u[mc$i] - 0.35 * log(mc$m) + ef_okres[mies[mc$t]] +
  ef_promo * (mies[klienci$kohorta[mc$i]] %in% 11:12)
los <- runif(nrow(mc))
mc$kupil_bez <- zostal & los < plogis(eta)                    # scenariusz bez programu
mc$kupil_z <- zostal & los < plogis(eta + ef_programu)        # scenariusz z programem
mc$kupil <- ifelse(klienci$program[mc$i], mc$kupil_z, mc$kupil_bez)   # to, co sklep naprawdę widzi

# Surowe transakcje: pierwszy zakup + zakupy w kolejnych miesiącach (jedno zamówienie w miesiącu)
kup <- mc[mc$kupil, ]
tr <- rbind(data.frame(i = seq_len(n), t = klienci$kohorta), kup[c("i", "t")])
tr$dzien <- sample(1:28, nrow(tr), replace = TRUE)
transakcje <- data.frame(id_klienta = klienci$id[tr$i], kanal = klienci$kanal[tr$i],
                         data_zamowienia = start[tr$t] + tr$dzien - 1,
                         kwota_zl = round(kwota_typowa[as.integer(klienci$kanal[tr$i])] * exp(rnorm(nrow(tr), 0, 0.35)), 2))
transakcje <- transakcje[order(transakcje$id_klienta, transakcje$data_zamowienia), ]
write.csv(transform(transakcje, kanal = c("wyszukiwarka", "social", "polecenie")[as.integer(kanal)]),
          "kohorty-transakcje-sklepu-zoologicznego.csv", row.names = FALSE)
range(nowi)                                           # najmniejsza i największa kohorta
c(klienci = n, transakcje = nrow(transakcje))
head(transakcje, 4)

# Od transakcji do tabeli kohortowej: kohorta = miesiąc pierwszego zakupu, m = miesiące od tego miesiąca
miesiac <- function(d) as.integer(format(d, "%Y")) * 12 + as.integer(format(d, "%m"))
transakcje$kohorta <- ave(miesiac(transakcje$data_zamowienia), transakcje$id_klienta, FUN = min)
transakcje$m <- miesiac(transakcje$data_zamowienia) - transakcje$kohorta
aktywni <- unique(transakcje[c("id_klienta", "kohorta", "m")])          # klient liczony raz w miesiącu
tabela <- table(kohorta = aktywni$kohorta, m = aktywni$m)               # liczba aktywnych klientów
retencja <- 100 * sweep(tabela, 1, tabela[, "0"], "/")                  # % klientów kohorty aktywnych w m
widoczne <- outer(seq_len(K), 0:(K - 1), function(k, m) m <= K - k)     # komórki, które już mogły się zdarzyć
retencja[!widoczne] <- NA
rownames(retencja) <- format(start, "%Y-%m")
round(retencja[c("2024-01", "2025-06", "2026-03"), 1:7], 1)
# Mieszanka kanałów w kohortach przed programem i z programem (% klientów)
round(100 * prop.table(table(ifelse(klienci$program, "Z programem", "Przed programem"), klienci$kanal), 1), 1)
Wynik w R
[1] 128 285
   klienci transakcje
      4793      18246
     id_klienta        kanal data_zamowienia kwota_zl
1         K0001 Wyszukiwarka      2024-01-06   135.12
2         K0002 Wyszukiwarka      2024-01-12    93.67
4794      K0002 Wyszukiwarka      2024-03-11   106.51
4795      K0002 Wyszukiwarka      2024-04-07   129.22
         m
kohorta       0     1     2     3     4     5     6
  2024-01 100.0  44.8  44.8  31.5  36.4  26.1  22.4
  2025-06 100.0  40.0  31.1  35.6  28.9  27.4  27.4
  2026-03 100.0  43.0  38.7  35.2

                  Wyszukiwarka Media społecznościowe Polecenie
  Przed programem         54.7                  24.4      20.9
  Z programem             38.9                  43.4      17.7
2. Od transakcji do tabeli: Rysunek 1
R
# Przepis 2. Grafika: jak z surowych transakcji powstaje tabela kohortowa (na trzech klientach z kohorty I 2025)
# (korzysta z transakcje, tabela, retencja i miesiac() z przepisu 1)
library(ggplot2)

koh <- miesiac(as.Date("2025-01-01"))
ile <- table(subset(transakcje, kohorta == koh & m <= 3)$id_klienta)
wybrani <- head(names(ile)[ile %in% 2:3], 3)                   # trzej pierwsi klienci z 2–3 zakupami w m = 0–3
przyklad <- subset(transakcje, id_klienta %in% wybrani & m <= 3)[c("id_klienta", "data_zamowienia", "kwota_zl", "m")]
przyklad
wiersz <- tabela[as.character(koh), 1:7]                       # aktywni klienci kohorty I 2025 w m = 0–6
wiersz
round(retencja["2025-01", 1:7], 1)

# Pola tekstu: trzy ramki (transakcje -> kohorta i m -> tabela) i pasek mapy ciepła pod spodem
ramki <- data.frame(x0 = c(0, 3.55, 7.05), x1 = c(3.15, 6.65, 10), y0 = 2.2, y1 = 6.6,
                    tytul = c("1. Surowe transakcje", "2. Kohorta i miesiąc m", "3. Tabela kohortowa"))
y_w <- 5.55 - 0.42 * seq_len(nrow(przyklad))
tx <- data.frame(x = c(0.15, 1.0, 3.0, 3.7, 4.55, 5.6), hjust = c(0, 0, 1, 0, 0, 0))   # kolumny w ramkach 1 i 2
wiersze <- data.frame(x = rep(tx$x, each = nrow(przyklad)), y = y_w, hjust = rep(tx$hjust, each = nrow(przyklad)),
                      lab = c(przyklad$id_klienta, format(przyklad$data_zamowienia), sprintf("%.2f zł", przyklad$kwota_zl),
                              przyklad$id_klienta, rep("2025-01", nrow(przyklad)), paste("m =", przyklad$m)))
naglowki <- data.frame(x = tx$x, y = 5.75, hjust = tx$hjust, lab = c("klient", "data", "kwota", "klient", "kohorta", "miesiąc"))
kom <- expand.grid(m = 0:3, wiersz = 1:2)
kom$lab <- ifelse(kom$wiersz == 1, as.character(wiersz[kom$m + 1]), sprintf("%.0f%%", retencja["2025-01", kom$m + 1]))
kom$x <- 8.05 + 0.52 * kom$m; kom$y <- ifelse(kom$wiersz == 1, 4.65, 3.85)
tab_opis <- data.frame(x = c(7.15, 7.15, 7.15), y = c(5.4, 4.65, 3.85), lab = c("m", "aktywni", "%"))
pasek <- data.frame(m = 0:6, ret = as.numeric(retencja["2025-01", 1:7]))
p1 <- ggplot() +
  geom_rect(data = ramki, aes(xmin = x0, xmax = x1, ymin = y0, ymax = y1), fill = "white", colour = "grey65") +
  geom_rect(data = ramki, aes(xmin = x0, xmax = x1, ymin = y1 - 0.55, ymax = y1), fill = "#0f1d3a") +
  geom_text(data = ramki, aes(x = x0 + 0.12, y = y1 - 0.28, label = tytul), hjust = 0, colour = "white",
            fontface = "bold", size = 4.6) +
  geom_text(data = naglowki, aes(x, y, label = lab, hjust = hjust), size = 3.6, colour = "grey35") +
  geom_text(data = wiersze, aes(x, y, label = lab, hjust = hjust), size = 3.8, colour = "#0f1d3a") +
  geom_text(data = tab_opis, aes(x, y, label = lab), hjust = 0, size = 3.9, colour = "grey30") +
  geom_text(data = data.frame(x = 8.05 + 0.52 * (0:3), y = 5.4, lab = 0:3), aes(x, y, label = lab),
            size = 4, fontface = "bold", colour = "#0f1d3a") +
  geom_text(data = kom, aes(x, y, label = lab), size = 4, colour = "#0f1d3a") +
  annotate("text", x = 7.15, y = 2.75, hjust = 0, size = 3.6, colour = "grey30", lineheight = 0.95,
           label = sprintf("kohorta 2025-01: %d klientów;\nklient liczony raz w miesiącu", wiersz[1])) +
  annotate("segment", x = c(3.18, 6.68), xend = c(3.52, 7.02), y = 4.3, yend = 4.3, linewidth = 1,
           colour = "#D55E00", arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  geom_tile(data = pasek, aes(x = 1.6 + 1.1 * m, y = 1, fill = ret), width = 1.04, height = 0.8) +
  geom_text(data = pasek, aes(x = 1.6 + 1.1 * m, y = 1, label = sprintf("%.0f", ret), colour = ret > 30),
            size = 4.2, show.legend = FALSE) +
  geom_text(data = pasek, aes(x = 1.6 + 1.1 * m, y = 0.4, label = paste("m =", m)), size = 3.6, colour = "grey30") +
  annotate("text", x = 0, y = 1.75, hjust = 0, size = 4.4, fontface = "bold", colour = "#0f1d3a",
           label = "4. Jeden wiersz mapy ciepła: % kohorty 2025-01 aktywnej w miesiącu m (kolor = wartość)") +
  scale_fill_viridis_c(limits = c(0, 50), oob = scales::squish, guide = "none") +   # skala jak na rysunku 2
  scale_colour_manual(values = c(`TRUE` = "#0f1d3a", `FALSE` = "white")) +
  coord_cartesian(xlim = c(0, 10), ylim = c(0.2, 6.6), expand = FALSE) +
  labs(title = "Od transakcji do tabeli kohortowej",
       subtitle = "Retencja w miesiącu m = klienci kohorty, którzy kupili w miesiącu m / wszyscy klienci kohorty") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("kohorty-schemat-tabeli.svg", p1, width = 10, height = 6.4)
Wynik w R
      id_klienta data_zamowienia kwota_zl m
1960       K1960      2025-01-05   236.14 0
12211      K1960      2025-02-24   107.36 1
1962       K1962      2025-01-14    60.05 0
12217      K1962      2025-02-25   159.78 1
12218      K1962      2025-03-27   132.26 2
1964       K1964      2025-01-17   139.82 0
12219      K1964      2025-04-14    94.62 3
  0   1   2   3   4   5   6
165  76  60  56  41  42  34
    0     1     2     3     4     5     6
100.0  46.1  36.4  33.9  24.8  25.5  20.6
3. Mapa ciepła retencji: Rysunek 2
R
# Przepis 3. Mapa ciepła retencji: kohorta × miesiąc od pierwszego zakupu
# (korzysta z retencja, start, mies, K i motyw z przepisu 1)
library(ggplot2)

mapa <- expand.grid(k = seq_len(K), m = 1:12)
mapa$retencja <- retencja[cbind(mapa$k, mapa$m + 1)]
mapa <- mapa[!is.na(mapa$retencja), ]
mapa$kohorta <- factor(format(start[mapa$k], "%Y-%m"), rev(format(start[-K], "%Y-%m")))  # bez VI 2026 (brak m ≥ 1)
mapa$grudzien <- mies[mapa$k + mapa$m] == 12          # komórka przypada na grudzień
nrow(mapa)                                            # liczba komórek na mapie (m = 1–12)
# Ile kohort widać w danym miesiącu od startu? (trójkąt: młode kohorty mają krótszą historię)
sapply(c(m1 = 1, m3 = 3, m6 = 6, m12 = 12), function(m) sum(!is.na(retencja[, m + 1])))
# Średnia retencja w m = 1, 3, 6 i 12 (komórki, które już można było zobaczyć)
round(sapply(c(m1 = 1, m3 = 3, m6 = 6, m12 = 12), function(m) mean(retencja[, m + 1], na.rm = TRUE)), 1)
# Efekt okresu: o ile punktów procentowych komórki grudniowe odbiegają od średniej swojej kolumny m
mapa$odchylenie <- mapa$retencja - ave(mapa$retencja, mapa$m)
round(tapply(mapa$odchylenie, ifelse(mapa$grudzien, "grudzień", "inne miesiące"), mean), 1)
# Kohorty z XI i XII a pozostałe: średnia retencja w m = 1–6 (tylko kohorty z pełnymi 6 miesiącami)
pelne6 <- seq_len(K - 6)
round(tapply(rowMeans(retencja[pelne6, 2:7]), mies[pelne6] %in% 11:12, mean), 1)

p2 <- ggplot(mapa, aes(m, kohorta, fill = retencja)) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_tile(data = subset(mapa, grudzien), colour = "#0f1d3a", linewidth = 0.9, fill = NA) +
  geom_text(aes(label = round(retencja), colour = retencja > 30), size = 3.1, show.legend = FALSE) +
  geom_hline(yintercept = which(levels(mapa$kohorta) == "2025-10") + 0.5, colour = "#D55E00", linewidth = 1.1) +
  annotate("label", x = 10.5, y = which(levels(mapa$kohorta) == "2025-10") - 0.7, size = 3.8,
           label = "od X 2025: program lojalnościowy", colour = "#D55E00", fill = "white", linewidth = 0) +
  scale_fill_viridis_c(option = "viridis", limits = c(0, 50), name = "Klienci aktywni w miesiącu m (% kohorty)",
                       guide = guide_colourbar(barwidth = 14, title.position = "top")) +
  scale_colour_manual(values = c(`TRUE` = "#0f1d3a", `FALSE` = "white")) +
  scale_x_continuous(breaks = 1:12, expand = c(0, 0)) +
  labs(x = "Miesiąc od pierwszego zakupu (m)", y = "Kohorta (miesiąc pierwszego zakupu)",
       title = "Mapa ciepła retencji 30 kohort klientów",
       subtitle = "Ramka: komórki przypadające na grudzień. Puste pola: tych miesięcy jeszcze nie było") +
  motyw + theme(panel.grid.major = element_blank())
p2   # zapis: ggsave("kohorty-mapa-ciepla-retencji.svg", p2, width = 10, height = 11)
Wynik w R
[1] 282
 m1  m3  m6 m12
 29  27  24  18
  m1   m3   m6  m12
40.7 31.0 22.5 14.2
     grudzień inne miesiące
          5.2          -0.5
FALSE  TRUE
 30.5  26.6
4. Krzywe retencji z przedziałami Wilsona: Rysunek 3
R
# Przepis 4. Krzywe retencji kohort kwartalnych z 2025 roku z 95% przedziałami Wilsona
# (korzysta z tabela, start i motyw z przepisu 1)
library(ggplot2)

kwartal <- c("I kw. 2025 (I–III)", "II kw. 2025 (IV–VI)", "III kw. 2025 (VII–IX)", "IV kw. 2025 (X–XII)")
kol_kw <- setNames(c("#56B4E9", "#009E73", "#E69F00", "#D55E00"), kwartal)
ksz_kw <- setNames(c(1, 15, 17, 16), kwartal)
rok <- format(start, "%Y") == "2025"
grupa <- factor(kwartal[(as.integer(format(start, "%m")) - 1) %/% 3 + 1], kwartal)
krzywe <- do.call(rbind, lapply(kwartal, function(g) {
  wiersze <- which(rok & grupa == g)
  do.call(rbind, lapply(0:6, function(m) {
    x <- sum(tabela[wiersze, m + 1]); n <- sum(tabela[wiersze, 1])     # aktywni w m / wszyscy z kohort
    ci <- if (m == 0) c(1, 1) else prop.test(x, n, correct = FALSE)$conf.int   # przedział Wilsona
    data.frame(grupa = g, m, n, aktywni = x, retencja = 100 * x / n, dolna = 100 * ci[1], gorna = 100 * ci[2])
  }))
}))
krzywe$grupa <- factor(krzywe$grupa, kwartal)
print(transform(subset(krzywe, m %in% c(1, 3, 6)), retencja = round(retencja, 1), dolna = round(dolna, 1),
                gorna = round(gorna, 1)), row.names = FALSE)

p3 <- ggplot(subset(krzywe, m > 0), aes(m, retencja, colour = grupa, fill = grupa, shape = grupa)) +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), alpha = 0.12, colour = NA) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8, fill = "white") +
  scale_colour_manual(values = kol_kw, name = NULL) + scale_fill_manual(values = kol_kw, name = NULL) +
  scale_shape_manual(values = ksz_kw, name = NULL) +
  scale_x_continuous(breaks = 1:6) + scale_y_continuous(limits = c(0, 50)) +
  guides(colour = guide_legend(nrow = 2), fill = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(x = "Miesiąc od pierwszego zakupu (m)", y = "Klienci aktywni w miesiącu m (%)",
       title = "Krzywe retencji czterech kwartałów pozyskania",
       subtitle = "Kohorty z 2025 roku połączone w kwartały; pasma: 95% przedział Wilsona") + motyw
p3   # zapis: ggsave("kohorty-krzywe-retencji.svg", p3, width = 10, height = 6)
Wynik w R
                 grupa m   n aktywni retencja dolna gorna
    I kw. 2025 (I–III) 1 442     187     42.3  37.8  47.0
    I kw. 2025 (I–III) 3 442     145     32.8  28.6  37.3
    I kw. 2025 (I–III) 6 442      94     21.3  17.7  25.3
   II kw. 2025 (IV–VI) 1 435     175     40.2  35.7  44.9
   II kw. 2025 (IV–VI) 3 435     140     32.2  28.0  36.7
   II kw. 2025 (IV–VI) 6 435     112     25.7  21.9  30.1
 III kw. 2025 (VII–IX) 1 406     165     40.6  36.0  45.5
 III kw. 2025 (VII–IX) 3 406     141     34.7  30.3  39.5
 III kw. 2025 (VII–IX) 6 406      94     23.2  19.3  27.5
   IV kw. 2025 (X–XII) 1 675     263     39.0  35.4  42.7
   IV kw. 2025 (X–XII) 3 675     184     27.3  24.0  30.7
   IV kw. 2025 (X–XII) 6 675     120     17.8  15.1  20.8
5. Program lojalnościowy: trzy porównania i prawda z symulacji: Rysunek 4
R
# Przepis 5. Czy program lojalnościowy podniósł retencję w 3. miesiącu? Cztery odpowiedzi na to samo pytanie
# (korzysta z klienci, mc, start, mies, program, kol_prog i motyw z przepisu 1)
library(ggplot2)
library(patchwork)

m3 <- mc[mc$m == 3, ]                                  # klienci, których 3. miesiąc już minął
m3$kohorta <- klienci$kohorta[m3$i]; m3$kanal <- klienci$kanal[m3$i]; m3$program <- program[m3$kohorta]
m3$mies_poz <- factor(mies[m3$kohorta])                # miesiąc kalendarzowy pozyskania (sezon)
wilson <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int
newcombe <- function(x1, n1, x0, n0) {                 # różnica proporcji p1 − p0 z 95% CI Newcombe’a
  p1 <- x1 / n1; p0 <- x0 / n0; l1 <- wilson(x1, n1); l0 <- wilson(x0, n0)
  d <- p1 - p0
  100 * c(roznica = d, dolna = d - sqrt((p1 - l1[1])^2 + (l0[2] - p0)^2), gorna = d + sqrt((l1[2] - p1)^2 + (p0 - l0[1])^2))
}
okno <- function(od, do) which(start >= as.Date(od) & start <= as.Date(do))
z_prog <- okno("2025-10-01", "2026-03-01")             # 6 kohort z programem (ich 3. miesiąc: I–VI 2026)
przed <- okno("2025-04-01", "2025-09-01")              # 6 kohort tuż przed programem
rok_wczesniej <- z_prog - 12                           # te same miesiące rok wcześniej (X 2024 – III 2025)
licz <- function(ks) c(x = sum(m3$kupil[m3$kohorta %in% ks]), n = sum(m3$kohorta %in% ks))
a <- licz(z_prog); b <- licz(przed); c0 <- licz(rok_wczesniej)
tab3 <- rbind(z_programem = a, przed_programem = b, rok_wczesniej = c0)
cbind(tab3, procent = round(100 * tab3[, "x"] / tab3[, "n"], 1))

# 1. Naiwnie: kohorty z programem a sześć poprzednich
naiwnie <- newcombe(a["x"], a["n"], b["x"], b["n"])
# 2. Rok do roku: te same miesiące pozyskania, więc ten sam sezon
rr <- newcombe(a["x"], a["n"], c0["x"], c0["n"])
# 3. Rok do roku + korekta mieszanki kanałów: regresja logistyczna i standaryzacja do klientów z programem
d <- subset(m3, kohorta %in% c(rok_wczesniej, z_prog))
efekt_kor <- function(dd) {
  f <- glm(kupil ~ program + kanal + mies_poz, family = binomial, data = dd)
  nd <- dd[dd$program, ]
  100 * (mean(predict(f, transform(nd, program = TRUE), type = "response")) -
           mean(predict(f, transform(nd, program = FALSE), type = "response")))
}
set.seed(605)
boot <- replicate(500, efekt_kor(d[sample(nrow(d), replace = TRUE), ]))   # bootstrap klientów, 500 prób
korekta <- c(roznica = efekt_kor(d), quantile(boot, c(0.025, 0.975)))
# 4. Prawda – znana tylko w symulacji: ci sami klienci z programem i bez niego (te same liczby losowe)
prawda <- 100 * mean(m3$kupil_z[m3$program] - m3$kupil_bez[m3$program])
efekty <- data.frame(podejscie = c("1. Naiwnie: X 2025–III 2026\nvs IV–IX 2025", "2. Rok do roku:\nvs X 2024–III 2025",
                                   "3. Rok do roku\n+ korekta kanałów"),
                     rbind(naiwnie, rr, korekta))
names(efekty)[2:4] <- c("roznica", "dolna", "gorna")
print(transform(efekty, podejscie = gsub("\n", " ", podejscie), roznica = round(roznica, 1), dolna = round(dolna, 1),
                gorna = round(gorna, 1)), row.names = FALSE)
round(prawda, 1)

# Panel A: retencja w 3. miesiącu dla każdej kohorty (I 2024 – III 2026) z przedziałem Wilsona
po_kohortach <- do.call(rbind, lapply(1:27, function(k) {
  x <- sum(m3$kupil[m3$kohorta == k]); n <- sum(m3$kohorta == k); ci <- wilson(x, n)
  data.frame(start = start[k], retencja = 100 * x / n, dolna = 100 * ci[1], gorna = 100 * ci[2],
             grupa = if (program[k]) "Z programem" else "Przed programem")
}))
print(transform(subset(po_kohortach, format(start, "%m") %in% c("11", "12"))[1:2], retencja = round(retencja, 1)),
      row.names = FALSE)                               # kohorty listopadowe i grudniowe
pa <- ggplot(po_kohortach, aes(start, retencja, colour = grupa, shape = grupa)) +
  annotate("rect", xmin = start[c(10, 22)] - 15, xmax = start[c(12, 24)] + 15, ymin = -Inf, ymax = Inf,
           fill = "grey85", alpha = 0.6) +
  annotate("text", x = start[c(11, 23)], y = 48, label = "X–XII", size = 3.6, colour = "grey30") +
  geom_linerange(aes(ymin = dolna, ymax = gorna), linewidth = 0.7) + geom_point(size = 2.8) +
  scale_colour_manual(values = kol_prog, name = NULL) + scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_x_date(date_labels = "%m.%y", date_breaks = "3 months") + scale_y_continuous(limits = c(0, 50)) +
  labs(x = "Kohorta (miesiąc pierwszego zakupu)", y = "Aktywni w 3. miesiącu (%)",
       title = "A. Retencja w 3. miesiącu według kohorty", subtitle = "Pionowe odcinki: 95% przedział Wilsona") + motyw
efekty$podejscie <- factor(efekty$podejscie, rev(efekty$podejscie))
pb <- ggplot(efekty, aes(roznica, podejscie)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_vline(xintercept = prawda, colour = "#009E73", linetype = "22", linewidth = 0.9) +
  annotate("text", x = prawda, y = 3.45, label = sprintf("prawdziwy efekt\n(znany w symulacji): +%.1f", prawda),
           hjust = -0.05, size = 3.5, colour = "#007A5A", lineheight = 0.9) +
  geom_errorbar(aes(xmin = dolna, xmax = gorna), width = 0.2, linewidth = 0.8, colour = "#0f1d3a") +
  geom_point(size = 3.4, colour = "#0f1d3a") +
  scale_x_continuous(limits = c(-10, 12)) + scale_y_discrete(expand = expansion(add = c(0.5, 1))) +
  labs(x = "Różnica retencji w 3. miesiącu (pp) z 95% CI", y = NULL,
       title = "B. Efekt programu: trzy porównania", subtitle = "Kohorty z programem: X 2025 – III 2026") + motyw
p4 <- pa / pb + plot_layout(heights = c(1.1, 1))
p4   # zapis: ggsave("kohorty-program-lojalnosciowy.svg", p4, width = 10, height = 10)
Wynik w R
                  x    n procent
z_programem     344 1117    30.8
przed_programem 281  841    33.4
rok_wczesniej   334 1117    29.9
                                 podejscie roznica dolna gorna
 1. Naiwnie: X 2025–III 2026 vs IV–IX 2025    -2.6  -6.8   1.5
        2. Rok do roku: vs X 2024–III 2025     0.9  -2.9   4.7
          3. Rok do roku + korekta kanałów     3.0  -0.1   6.8
[1] 5.1
      start retencja
 2024-11-01     28.4
 2024-12-01     27.1
 2025-11-01     29.5
 2025-12-01     23.6
6. Retencja a przychód według kanału: Rysunek 5
R
# Przepis 6. Retencja a przychód z kohorty według kanału pozyskania (kohorty I 2024 – VI 2025, pełne 12 miesięcy)
# (korzysta z transakcje, klienci, kol_kanal, ksz_kanal i motyw z przepisu 1)
library(ggplot2)
library(patchwork)

stare <- unique(transakcje$kohorta[transakcje$m == 0])
stare <- sort(stare)[1:18]                                         # 18 kohort z co najmniej 12 miesiącami historii
t12 <- subset(transakcje, kohorta %in% stare & m <= 12)
n_kanal <- table(unique(t12[c("id_klienta", "kanal")])$kanal)      # klienci pozyskani w każdym kanale
n_kanal
wg <- do.call(rbind, lapply(names(n_kanal), function(k) {
  d <- subset(t12, kanal == k)
  akt <- tapply(d$id_klienta, d$m, function(x) length(unique(x)))
  przych <- tapply(d$kwota_zl, d$m, sum)
  data.frame(kanal = k, m = 0:12, retencja = 100 * as.numeric(akt) / n_kanal[[k]],
             przychod_skum = cumsum(as.numeric(przych)) / n_kanal[[k]])   # zł na jednego pozyskanego klienta
}))
wg$kanal <- factor(wg$kanal, names(kol_kanal))
# Po 1 i 12 miesiącach: retencja (%) i skumulowany przychód na pozyskanego klienta (zł)
print(transform(subset(wg, m %in% c(1, 12)), retencja = round(retencja, 1), przychod_skum = round(przychod_skum)),
      row.names = FALSE)
# Średnia retencja w m = 1–12 i średnia kwota zamówienia według kanału
round(tapply(wg$retencja[wg$m > 0], wg$kanal[wg$m > 0], mean), 1)
round(tapply(t12$kwota_zl, t12$kanal, mean), 1)

skala <- list(scale_colour_manual(values = kol_kanal, name = NULL), scale_shape_manual(values = ksz_kanal, name = NULL),
              scale_x_continuous(breaks = seq(0, 12, 3)))
pa <- ggplot(subset(wg, m > 0), aes(m, retencja, colour = kanal, shape = kanal)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) + skala + scale_y_continuous(limits = c(0, 50)) +
  labs(x = "Miesiąc od pierwszego zakupu", y = "Klienci aktywni w miesiącu (%)", title = "A. Retencja",
       subtitle = "Kto częściej wraca?") + motyw
pb <- ggplot(wg, aes(m, przychod_skum, colour = kanal, shape = kanal)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) + skala +
  labs(x = "Miesiąc od pierwszego zakupu", y = "Przychód narastająco (zł na klienta)",
       title = "B. Przychód z kohorty", subtitle = "Ile zostawia pozyskany klient?") + motyw
p5 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("kohorty-retencja-a-przychod.svg", p5, width = 10, height = 5.6)
Wynik w R
         Wyszukiwarka Media społecznościowe             Polecenie
                 1545                   688                   602
                 kanal  m retencja przychod_skum
          Wyszukiwarka  1     41.5           189
          Wyszukiwarka 12     14.5           520
 Media społecznościowe  1     31.4           112
 Media społecznościowe 12      9.4           251
             Polecenie  1     47.5           140
             Polecenie 12     18.6           448
         Wyszukiwarka Media społecznościowe             Polecenie
                 24.2                  16.1                  30.5
         Wyszukiwarka Media społecznościowe             Polecenie
                133.1                  85.6                  96.2
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("Przed programem – Z programem" = c("#0072B2", "#D55E00"),
             "Wyszukiwarka – Media społecznościowe" = c("#0072B2", "#E69F00"),
             "Wyszukiwarka – Polecenie" = c("#0072B2", "#009E73"),
             "Media społecznościowe – Polecenie" = c("#E69F00", "#009E73"),
             "I kw. – II kw." = c("#56B4E9", "#009E73"), "II kw. – III kw." = c("#009E73", "#E69F00"),
             "III kw. – IV kw." = c("#E69F00", "#D55E00"), "I kw. – IV kw." = c("#56B4E9", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
# Mapa ciepła: skala viridis – jasność rośnie monotonicznie także po symulacji deuteranopii
v <- viridisLite::viridis(6)
round(rbind(typowe = coords(as(hex2RGB(v), "polarLUV"))[, "L"], deuteranopia = coords(as(hex2RGB(deutan(v)), "polarLUV"))[, "L"]))
Wynik w R
                                     widzenie_typowe deuteranopia protanopia
Przed programem – Z programem                  114.6        108.3       91.9
Wyszukiwarka – Media społecznościowe           120.2        121.5      109.3
Wyszukiwarka – Polecenie                        70.1         55.4       58.0
Media społecznościowe – Polecenie               88.7         66.3       51.5
I kw. – II kw.                                  59.5         48.8       51.9
II kw. – III kw.                                88.7         66.3       51.5
III kw. – IV kw.                                33.4         18.4       24.9
I kw. – IV kw.                                 113.6        101.1       89.0
czerwony – zielony (do unikania)               121.7         21.1       31.6
             [,1] [,2] [,3] [,4] [,5] [,6]
typowe         15   32   47   62   76   91
deuteranopia   16   31   45   60   75   92
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, przedziały Wilsona (prop.test()) i regresja logistyczna (glm()) – pakiet stats z podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2 (skala barw viridis z pakietu viridisLite, przycinanie skali funkcją z pakietu scales), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zmiana w czasie to nie efekt. Naiwne porównanie dało −2.6 pp przy prawdziwym efekcie +5.1 pp (rysunek 4). Sezon, kanały i inne zmiany w sklepie zmieniają retencję razem z programem.
- Trójkąt danych. Średnia z kolumny m = 12 opisuje tylko 18 najstarszych kohort. Porównuj kohorty w tym samym wieku i tylko w miesiącach, które wszystkie już przeżyły.
- Niepełny ostatni miesiąc. Dane kończące się w połowie miesiąca zaniżają ostatnią kolumnę – licz pełne miesiące.
- Mały mianownik. Kohorta 165 klientów ma przedział o szerokości kilkunastu pp. Pojedyncza ciemna komórka mapy może być przypadkiem.
- Retencja „rośnie”? Jeśli mianownikiem są klienci aktywni miesiąc wcześniej, zostają w nim najwierniejsi i krzywa wygląda coraz lepiej. To selekcja, a nie rosnąca lojalność. Mianownik = cała kohorta.
Najczęstsze pytania
Jak policzyć retencję kohorty klientów?
Przypisz każdego klienta do kohorty według miesiąca pierwszego zakupu, a każdemu zamówieniu – numer miesiąca od tego zakupu (m). Retencja w miesiącu m to liczba różnych klientów kohorty, którzy kupili w miesiącu m, podzielona przez liczebność całej kohorty. W przykładzie kohorta ze stycznia 2025 liczyła 165 klientów, a w pierwszym miesiącu wróciło 76, czyli 46.1%.
Jak czytać mapę ciepła retencji?
Wiersz to historia jednej kohorty, kolumna porównuje kohorty w tym samym wieku, a ukośna linia to jeden miesiąc kalendarzowy, który działa na wszystkie kohorty naraz. W przykładzie komórki grudniowe leżały średnio 5.2 pp powyżej średniej swojej kolumny. Pusty trójkąt w prawym dolnym rogu to miesiące, które dla młodych kohort jeszcze się nie wydarzyły.
Czy wzrost retencji nowych kohort dowodzi, że program lojalnościowy działa?
Nie. Kohorty z programem różnią się też sezonem pozyskania, mieszanką kanałów i wszystkim, co zmieniło się w sklepie w tym samym czasie. W przykładzie trzy porównania dały od −2.6 do +3.0 pp przy prawdziwym efekcie +5.1 pp. Porównanie rok do roku i korekta kanałów pomagają, ale pewną odpowiedź daje losowy podział nowych klientów na grupę z programem i bez niego.
Czy kanał z najwyższą retencją jest najlepszy?
Niekoniecznie. W przykładzie klienci z poleceń wracali najczęściej (18.6% aktywnych po roku), ale klient z wyszukiwarki przyniósł w ciągu roku 520 zł wobec 448 zł, bo składał większe zamówienia. Oceniaj kanały przychodem lub zyskiem z kohorty, a nie samą retencją.
Jak opisać analizę kohortową w pracy z marketingu?
W Metodzie podaj definicję kohorty i retencji (co jest licznikiem i mianownikiem), okres obserwacji, metodę przedziałów ufności i sposób porównania kohort. W Wynikach – tabelę retencji w wybranych miesiącach z 95% CI i mapę ciepła. Porównania kohort przed i po zmianie opisz jako obserwacyjne, z nazwanymi możliwymi zakłóceniami (sezon, kanały).
Powiązane hasła
Przeczytaj też
Wartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →PoradnikChurn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza skupień w marketingu – segmentacja klientów
Księgarnia internetowa, 1500 klientów i RFM: przekształcenia, liczba segmentów, mapa PCA, karty segmentów z działaniami i stabilność – sześć rysunków z kodem R.
Czytaj →PoradnikRegresja segmentowa i przerwany szereg czasowy
Zmiana poziomu i nachylenia, gls z AR(1), sezonowość, szereg kontrolny, nieznany punkt załamania z bootstrapem, przykład w R i wzór opisu.
Czytaj →PoradnikRabat na pierwszy miesiąc a rezygnacje
Konwersja rośnie, a co z retencją? Test A/B rabatu, Kaplan–Meier, Cox z resztami Schoenfelda i marża na odwiedzającego z bootstrapu – z kodem R.
Czytaj →Analizujesz retencję klientów do pracy z marketingu?
Pomożemy przygotować tabelę kohortową z danych sprzedażowych, dobrać porównania kohort, policzyć przedziały ufności i opisać wyniki tak, żeby nie obiecywały więcej, niż pokazują dane.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bell, A. (2020). Age period cohort analysis: A review of what we should and shouldn’t do. Annals of Human Biology, 47(2), 208–217. https://doi.org/10.1080/03014460.2019.1707872
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Fader, P. S., & Hardie, B. G. S. (2007). How to project customer retention. Journal of Interactive Marketing, 21(1), 76–90. https://doi.org/10.1002/dir.20074 ● Otwarty dostęp: pełny tekst
- Fagerland, M. W., Lydersen, S., & Laake, P. (2015). Recommended confidence intervals for two independent binomial proportions. Statistical Methods in Medical Research, 24(2), 224–254. https://doi.org/10.1177/0962280211415469
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2018). The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology, 47(6), 2082–2093. https://doi.org/10.1093/ije/dyy135
- Reinartz, W. J., & Kumar, V. (2000). On the profitability of long-life customers in a noncontractual setting: An empirical investigation and implications for marketing. Journal of Marketing, 64(4), 17–35. https://doi.org/10.1509/jmkg.64.4.17.18077
Cytowania BibTeX
@article{bell2020age, author={Bell, Andrew}, title={{Age period cohort analysis: A review of what we should and shouldn’t do}}, journal={Annals of Human Biology}, year={2020}, volume={47}, number={2}, pages={208--217}, doi={10.1080/03014460.2019.1707872}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{fader2007how, author={Fader, Peter S. and Hardie, Bruce G. S.}, title={{How to project customer retention}}, journal={Journal of Interactive Marketing}, year={2007}, volume={21}, number={1}, pages={76--90}, doi={10.1002/dir.20074}}@article{fagerland2015recommended, author={Fagerland, Morten W. and Lydersen, Stian and Laake, Petter}, title={{Recommended confidence intervals for two independent binomial proportions}}, journal={Statistical Methods in Medical Research}, year={2015}, volume={24}, number={2}, pages={224--254}, doi={10.1177/0962280211415469}}@article{lopezbernal2018use, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{The use of controls in interrupted time series studies of public health interventions}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={6}, pages={2082--2093}, doi={10.1093/ije/dyy135}}@article{reinartz2000profitability, author={Reinartz, Werner J. and Kumar, V.}, title={{On the profitability of long-life customers in a noncontractual setting: An empirical investigation and implications for marketing}}, journal={Journal of Marketing}, year={2000}, volume={64}, number={4}, pages={17--35}, doi={10.1509/jmkg.64.4.17.18077}}