Przykład: sklep zoologiczny z abonamentem na karmę
Fikcyjny sklep internetowy dla zwierząt sprzedaje karmę w abonamencie: co miesiąc paczka przychodzi sama, a klient może zrezygnować w dowolnym momencie. Obok abonamentu klienci robią zakupy jednorazowe – zabawki, żwirek, przysmaki. Sklep obserwował 2400 klientów przez pierwsze 12 miesięcy. Dział marketingu pyta: ile jest wart przeciętny klient i ile najwyżej opłaca się zapłacić za pozyskanie nowego – osobno w kanałach: wyszukiwarka, polecenie znajomego i kupon rabatowy? Odpowiedzią jest wartość klienta w czasie (ang. customer lifetime value, CLV): oczekiwana suma zdyskontowanych przyszłych zysków z klienta (Gupta i in., 2004). Jak podzielić klientów na grupy, pokazuje wpis analiza skupień w marketingu, a jak śledzić retencję kolejnych grup nowych klientów – analiza kohortowa retencji klientów.
Dane są fikcyjne, więc znamy prawdę, którą w nich ukryliśmy. Ręcznie ustaliliśmy: marżę z abonamentu (22 zł miesięcznie za mały plan, 38 zł za duży; 40% klientów ma duży), kupon obniżający marżę o 15 zł w miesiącach 1–3, miesięczne prawdopodobieństwo rezygnacji zależne od kanału, mniejsze w dużym planie i różne u poszczególnych klientów (każdy ma własną „skłonność do odejścia”), skok rezygnacji klientów z kuponu w 4. miesiącu, po końcu rabatu, oraz zakupy jednorazowe – u większości rzadkie, a u 3% klientów (hodowle) częste i duże. Parametry ustalono przed pierwszym uruchomieniem, a ziarna 606 nie zmieniano. Po 12 miesiącach płaciło jeszcze 1057 klientów (44.0%) – ich dalszy los jest nieznany, to obserwacje cenzurowane. Dane pobierzesz jako wartosc-klienta-sklep-zoologiczny.csv (wiersz = klient: kanał, plan, opłacone miesiące, czy wciąż płaci, marża z abonamentu i z zakupów jednorazowych).
Rysunek 1: kto naprawdę przynosi marżę
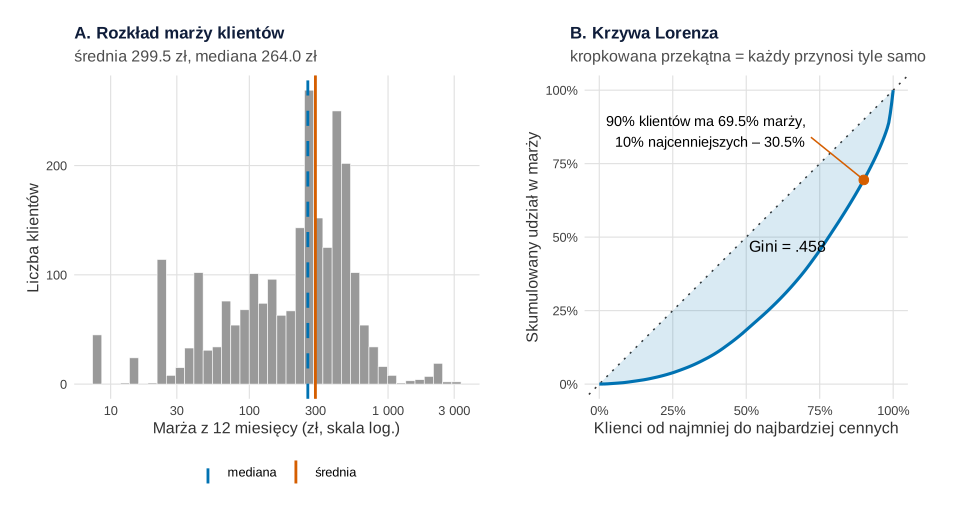
set.seed(606)).Co widać. Średnia marża klienta z pierwszego roku wynosi 299.5 zł, a mediana 264.0 zł; 60.6% klientów przynosi mniej niż średnia. Na krzywej Lorenza 10% najcenniejszych klientów daje 30.5% całej marży, 1% najcenniejszych – 8.0%, a słabsza połowa klientów – tylko 18.4%. Indeks Giniego wynosi .458. Długi prawy ogon robią zakupy jednorazowe hodowli (29.3% marży to zakupy jednorazowe).
Jak może zmylić. To marża już zarobiona, a nie CLV: nie mówi, ile klienci przyniosą w przyszłości. Średnia jest tu tylko o 13% wyższa od mediany, ale przy mocniejszej koncentracji różnica rośnie. „Przeciętny klient” ze średniej to więc nie typowy klient – typowego lepiej opisuje mediana. Średnia ucinana (bez 5% skrajnych z każdej strony) wynosi 263.5 zł, zob. średnia ucinana i winsoryzacja.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: skąd bierze się CLV
Prosty wzór na CLV ma cztery składniki: marżę z jednego miesiąca, retencję (jaki odsetek płacących zostaje na kolejny miesiąc), stopę dyskonta i horyzont.
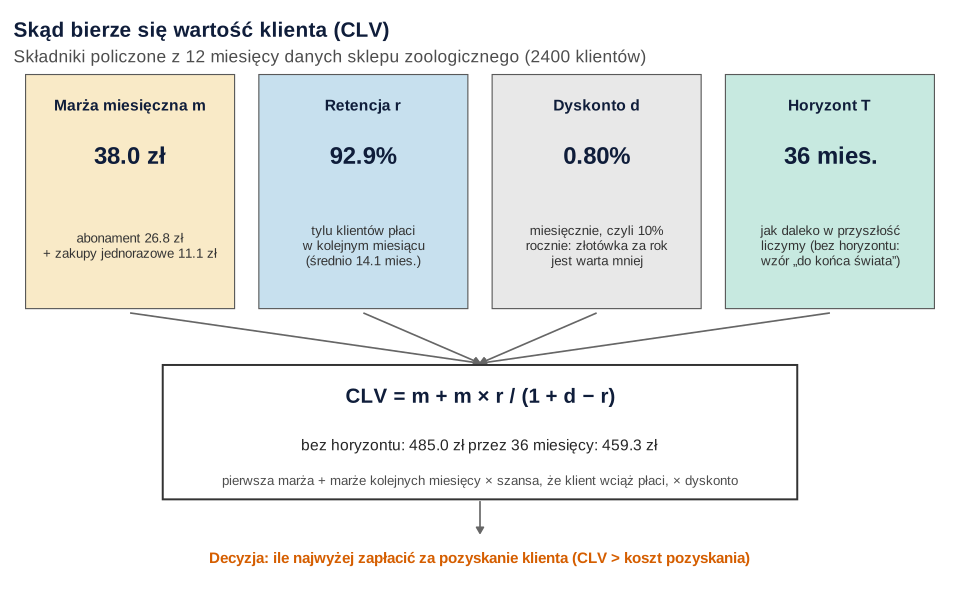
Co widać. Klient płaci średnio 37.98 zł marży za każdy opłacony miesiąc. Retencja r = 1 − (rezygnacje / opłacone miesiące) = .929, więc przeciętnie klient zostaje 1 / (1 − r) = 14.1 miesiąca. Roczne dyskonto 10% to d = 1.101/12 − 1 = 0.80% na miesiąc. Wzór:
Pierwsza marża wpływa od razu; każda kolejna jest mnożona przez szansę, że klient wciąż płaci (r, r², r³…), i przez dyskonto, bo złotówka za rok jest warta mniej niż dziś. Wzór sumuje te marże bez końca. Gdy liczymy tylko 36 miesięcy, CLV = 459.3 zł. Kontrola: wzór przez 12 miesięcy daje 302.7 zł, a faktyczna średnia marża z roku to 299.5 zł.
Jak może zmylić. Wzór zakłada, że r i m są takie same u wszystkich klientów i w każdym miesiącu. Tu tak nie jest: klienci z kuponu odchodzą masowo w 4. miesiącu, a w kolejnych miesiącach zostają ci, którzy odchodzą rzadziej. Co z tego wynika – rysunek 4.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: wykres wrażliwości
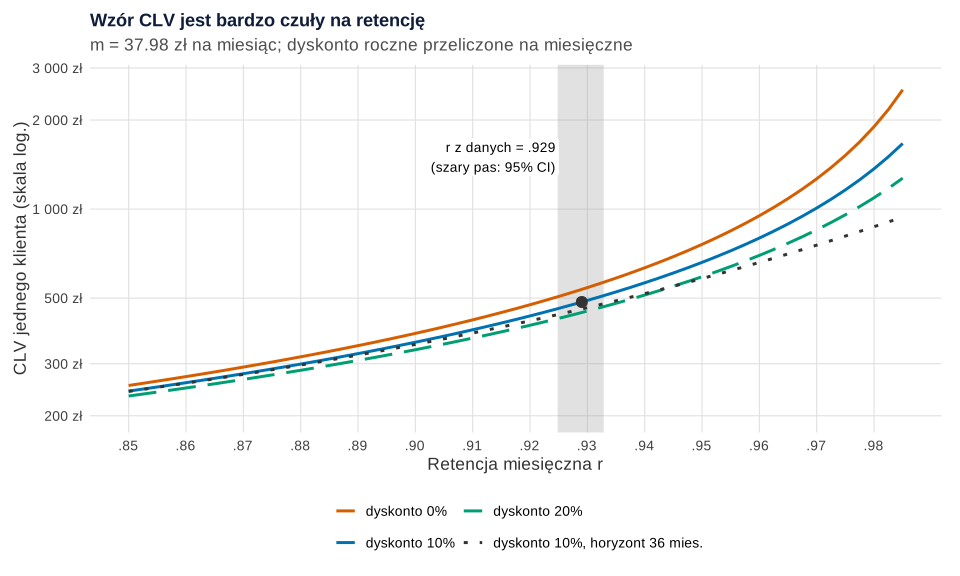
set.seed(606)).Co widać. CLV rośnie coraz szybciej, gdy r zbliża się do 1. Przy r = .90 wzór daje 354.6 zł, przy .95 – 660.4 zł, a przy .97 – 1008.2 zł. Wzrost retencji o 1 punkt procentowy podnosi CLV o 14.5%, a spadek rocznego dyskonta z 10% do 9% – tylko o 0.9%. To zgodne z wynikami Gupty i in. (2004): poprawa retencji o 1% zmieniała wartość firmy kilka razy mocniej niż zmiana stopy dyskontowej. Horyzont 36 miesięcy (kropki) ucina tę „eksplozję”: przy r = .97 daje 755.2 zł zamiast 1008.2 zł.
Jak może zmylić. Szary pas to 95% przedział r z bootstrapu klientów (1000 prób): [.925, .933]. Przekłada się na CLV od 456.3 do 515.6 zł bez horyzontu i od 435.5 do 484.8 zł dla 36 miesięcy. Ten przedział obejmuje tylko błąd losowy próby. Nie obejmuje błędu założenia, że r będzie stałe przez lata, a ten bywa dużo większy. Wykres to analiza wrażliwości: pokazuje, które założenie najbardziej zmienia wynik.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: retencja z modelu zamiast jednej liczby
Zamiast jednego r możesz policzyć szansę rezygnacji w każdym miesiącu. Dane rozkładamy na wiersze „klient-miesiąc”: klient, który płacił 5 miesięcy i zrezygnował, daje 5 wierszy, a w ostatnim wynik = 1. Na takich danych liczymy zwykłą regresję logistyczną – to analiza przeżycia w czasie dyskretnym (Willett i Singer, 1993). Predyktory: kanał, plan, koniec rabatu kuponu (4. miesiąc klientów z kuponu) i logarytm numeru miesiąca. Klienci wciąż płacący po 12 miesiącach po prostu nie mają wiersza z rezygnacją – tak model uwzględnia cenzurowanie. Ciągłą wersję tej analizy (Kaplan–Meier, model Coxa) opisuje wpis odejścia klientów jako analiza przeżycia.
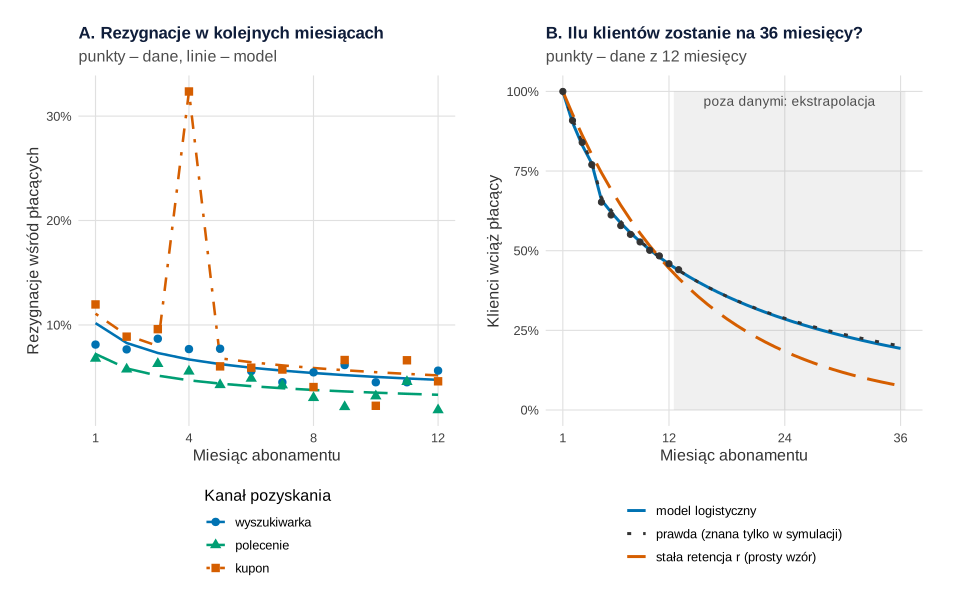
Co widać. W panelu A rezygnacje maleją z miesiąca na miesiąc (iloraz szans OR = 0.722 na jednostkę log(miesiąca), 95% CI [0.671, 0.776]), a u klientów z kuponu w 4. miesiącu skaczą z 9.6% do 32.4% (OR = 6.080 [4.977, 7.429]). Polecenie ma szanse rezygnacji o 31% niższe niż wyszukiwarka (OR = 0.690 [0.592, 0.804]), duży plan – o 23% niższe (OR = 0.772 [0.686, 0.869]). Poza 4. miesiącem kupon nie różni się wyraźnie od wyszukiwarki (OR = 1.096 [0.954, 1.260]). W panelu B model przewiduje, że po 36 miesiącach płaci 19.3% klientów, a prawda ukryta w danych to 20.1%. Stała retencja z prostego wzoru daje tylko 7.6%.
Jak może zmylić. Wszystko po 12. miesiącu (szare tło) to ekstrapolacja: model przedłuża trend log(miesiąca), którego w danych nie widział. Tu trafił, bo dane powstały z mechanizmu, który ten trend dobrze naśladuje. W prawdziwym sklepie sprawdź prognozę na kolejnych miesiącach, gdy tylko je zobaczysz. Fader i Hardie (2007) proponują zamiast dopasowywania krzywych model probabilistyczny procesu odchodzenia (shifted-beta-geometric). Malejące rezygnacje nie znaczą też, że klienci „przywiązują się” do sklepu. W tych danych szansa rezygnacji każdego klienta jest stała (poza końcem rabatu), a spadek bierze się tylko stąd, że najpierw odpadają klienci skłonni do odejścia.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: ile jest wart klient z każdego kanału
CLV z modelu to suma marż z 36 miesięcy pomnożonych przez przewidzianą szansę płacenia i zdyskontowanych. Marża w miesiącu to abonament planu (z rabatem kuponu w miesiącach 1–3) plus średnia marża z zakupów jednorazowych w danym kanale i planie. Niepewność daje bootstrap: losujemy ze zwracaniem 2400 klientów, liczymy od nowa model i CLV, i tak 1000 razy (Efron, 1979). Bootstrap krok po kroku pokazuje wpis bootstrap – wizualizacja na obrazkach.
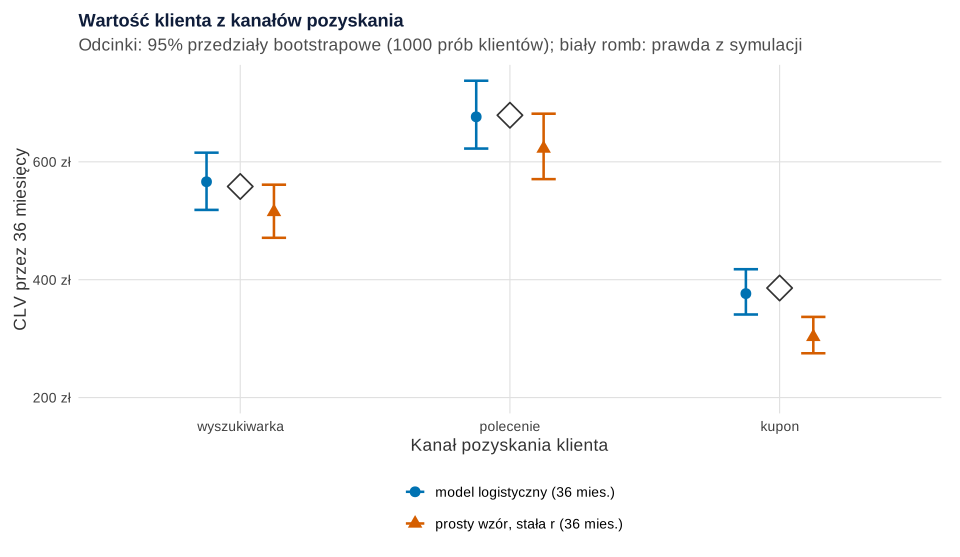
set.seed(606)).Co widać. Klient z polecenia jest wart 676.4 zł, 95% CI [622.6, 737.7], z wyszukiwarki 566.2 zł [518.5, 615.6], a z kuponu 376.4 zł [340.9, 417.8]. Różnica polecenie − kupon to 300.0 zł [233.4, 367.6]. Prawdziwe wartości (558.2, 679.1 i 385.9 zł) leżą we wszystkich trzech przedziałach modelu. Prosty wzór ze stałą retencją, liczony osobno w każdym kanale, zaniża CLV: dla kuponu daje 302.9 zł [275.2, 336.9] – przedział nie obejmuje prawdy.
Jak może zmylić. Przedziały bootstrapowe mówią o niepewności z próby 2400 klientów, nie o błędzie ekstrapolacji. Wąski przedział prostego wzoru dla kuponu jest „precyzyjnie zły”: skok rezygnacji po rabacie rozlał się na wszystkie przyszłe miesiące. Różnica między kanałami to też nie efekt kanału – polecenie przyciąga innych klientów, niż przyciągnąłby ich kupon (zob. korelacja a przyczynowość).
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Budżet pozyskania według kanału: koszt pozyskania klienta (CAC) porównuj z CLV kanału, nie ze średnią. Gdyby pozyskanie klienta kuponem kosztowało np. 400 zł, kanał byłby na minusie, choć przy średnim CLV 459 zł wyglądałby na opłacalny. Zostaw zapas na niepewność – weź dolną granicę przedziału.
- Program poleceń: klient z polecenia jest wart o 300 zł więcej niż z kuponu. To argument za nagrodą dla polecającego, ale jej skutek sprawdź w eksperymencie.
- Koniec rabatu: w 4. miesiącu odchodzi 32.4% wciąż płacących klientów z kuponu. Przetestuj łagodniejsze wyjście z rabatu albo kontakt przed końcem promocji – komu wysłać ofertę, podpowie model przewidywania odejść, a czy oferta naprawdę coś zmienia – modelowanie uplift.
- Hodowle: najcenniejszy 1% klientów (24 osoby) to same hodowle i daje 8.0% marży z pierwszego roku. Zadbaj o nich osobno (opiekun, oferta hurtowa), ale nie licz CLV całego sklepu z ich średniej.
Jak opisać w pracy
W Metodzie podaj definicję CLV (marża czy przychód, horyzont, stopa dyskonta), sposób oszacowania retencji, okres danych i sposób liczenia niepewności. Przegląd modeli CLV i ich zastosowań w segmentacji oraz podziale budżetu daje Gupta i in. (2006). Gdy klienci nie mają umowy, a tylko kupują od czasu do czasu, nie widać, kiedy odeszli – wtedy stosuje się modele oparte na liczbie i czasie wcześniejszych zakupów (Schmittlein i in., 1987), także łączące RFM z CLV (Fader i in., 2005), np. z pakietów R BTYD lub CLVTools.
W Wynikach pokaż tabelę: kanał, liczba klientów, retencja po 12 miesiącach, CLV z przedziałem. W Ograniczeniach napisz, że retencja po 12. miesiącu jest ekstrapolacją, a CLV kanałów nie mówi, co by się stało, gdyby tych samych klientów pozyskać innym kanałem.
Kod R: CLV ze wzoru, z modelu i z bootstrapem
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, z których korzystają kolejne. Wzór, model (glm()) i bootstrap liczy bazowy R – bez pakietów do CLV. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 4 i 6 (bootstrap); każdy zaczyna się od własnego set.seed(606). Ziarno 606 ustalono raz i nie zmieniano go. Ręcznie ustalono: 2400 klientów i 12 miesięcy obserwacji, udziały kanałów (.40, .25, .35) i dużego planu (.4), marżę planów (22 i 38 zł), rabat kuponu (15 zł w miesiącach 1–3), logity miesięcznej rezygnacji kanałów (−2.6, −3.1, −2.4), efekt dużego planu (−0.3), skok po rabacie (+1.8), SD skłonności do rezygnacji (1.0), 3% hodowli z 2.5 zamówienia na miesiąc i marżą 60 zł z zamówienia, pozostałym klientom średnio 0.35 zamówienia (rozkład gamma) po 20 zł marży, dyskonto 10% rocznie i horyzont 36 miesięcy. Całość liczy się w kilka sekund.
1. Paleta, motyw i dane klientów
R
# Przepis 1. Fikcyjny sklep zoologiczny z abonamentem na karmę: 2400 klientów przez 12 miesięcy (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", zielony = "#009E73", pomarancz = "#E69F00",
         szary = "grey60", ciemny = "grey20")
kol_kanal <- c(wyszukiwarka = kol[["niebieski"]], polecenie = kol[["zielony"]], kupon = kol[["cynober"]])
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (prawda ukryta w danych)
N <- 2400; okno <- 12                                    # klienci i miesiące obserwacji
marza_planu <- c(maly = 22, duzy = 38)                   # marża z abonamentu na miesiąc (zł)
rabat_kuponu <- 15                                       # kupon: o 15 zł mniejsza marża w miesiącach 1–3
logit_kanalu <- c(wyszukiwarka = -2.6, polecenie = -3.1, kupon = -2.4)   # logit miesięcznej rezygnacji
efekt_duzego <- -0.3; skok_po_promocji <- 1.8; sd_sklonnosci <- 1.0

set.seed(606)                                            # ziarno ustalone raz, bez dobierania pod wynik
klienci <- data.frame(id = seq_len(N),
  kanal = factor(sample(names(logit_kanalu), N, replace = TRUE, prob = c(.40, .25, .35)), names(logit_kanalu)),
  plan = factor(sample(c("maly", "duzy"), N, replace = TRUE, prob = c(.6, .4)), c("maly", "duzy")))
sklonnosc <- rnorm(N, 0, sd_sklonnosci)               # ukryta skłonność do rezygnacji (różna u klientów)
hodowca <- rbinom(N, 1, 0.03)                            # 3% klientów to hodowle: dużo zakupów jednorazowych
lambda <- ifelse(hodowca == 1, 2.5, rgamma(N, shape = 0.6, rate = 0.6 / 0.35))  # zamówienia jednorazowe na miesiąc
srednia_zam <- ifelse(hodowca == 1, 60, 20)              # przeciętna marża z jednego zamówienia (zł)

# Prawdopodobieństwo rezygnacji klienta i w miesiącu t (kupon: skok w miesiącu 4, po końcu rabatu)
hazard <- function(t, i) plogis(logit_kanalu[as.character(klienci$kanal[i])] + efekt_duzego * (klienci$plan[i] == "duzy") +
                                  sklonnosc[i] + skok_po_promocji * (t == 4 & klienci$kanal[i] == "kupon"))
H <- sapply(1:36, hazard, i = seq_len(N))                # macierz N × 36 (prawda do miesiąca 36)
odejscie <- matrix(rbinom(N * 36, 1, H), N)              # czy rezygnuje na koniec miesiąca t
pierwsze <- apply(odejscie, 1, function(z) if (any(z == 1)) which(z == 1)[1] else Inf)
klienci$miesiace <- pmin(pierwsze, okno)                 # opłacone miesiące widoczne w oknie 12 miesięcy
klienci$aktywny <- as.integer(pierwsze > okno)           # 1 = wciąż płaci po 12 miesiącach (obserwacja cenzurowana)
klienci$zamowienia <- rpois(N, lambda * klienci$miesiace)
klienci$marza_jednorazowe <- round(sapply(klienci$zamowienia, function(k) sum(rlnorm(k, 0, 0.6))) /
                                     exp(0.6^2 / 2) * srednia_zam, 2)
miesiace_z_rabatem <- pmin(klienci$miesiace, 3) * (klienci$kanal == "kupon")
klienci$marza_abonament <- marza_planu[as.character(klienci$plan)] * klienci$miesiace - rabat_kuponu * miesiace_z_rabatem
klienci$marza_12m <- klienci$marza_abonament + klienci$marza_jednorazowe
write.csv(klienci, "wartosc-klienta-sklep-zoologiczny.csv", row.names = FALSE)

c(klienci = N, aktywni_po_12m = sum(klienci$aktywny), hodowle = sum(hodowca))
round(100 * prop.table(table(klienci$kanal)), 1)
round(c(srednia_marza_12m = mean(klienci$marza_12m), mediana_marza_12m = median(klienci$marza_12m),
        udzial_jednorazowych_proc = 100 * sum(klienci$marza_jednorazowe) / sum(klienci$marza_12m)), 1)
Wynik w R
       klienci aktywni_po_12m        hodowle
          2400           1057             65

wyszukiwarka    polecenie        kupon
        38.5         26.4         35.2
        srednia_marza_12m         mediana_marza_12m udzial_jednorazowych_proc
                    299.5                     264.0                      29.3
2. Koncentracja marży: Rysunek 1
R
# Rysunek 1. Kto przynosi marżę? Rozkład marży z 12 miesięcy, krzywa Lorenza i indeks Giniego
# Korzysta z obiektów przepisu 1: klienci, hodowca, kol, motyw. Niczego nie losuje.
library(ggplot2); library(patchwork)

x <- sort(klienci$marza_12m)                    # marża klienta z 12 miesięcy (zł), rosnąco
n <- length(x)
pkt <- round(seq(0, 1, by = 0.005) * n)                     # 201 punktów krzywej wystarczy do rysunku
lorenz <- data.frame(klienci = pkt / n, udzial = c(0, cumsum(x))[pkt + 1] / sum(x))
gini <- sum((2 * seq_len(n) - n - 1) * x) / (n * sum(x))      # indeks Giniego (wzór dla posortowanych danych)
udzial_gory <- function(p) sum(tail(x, round(p * n))) / sum(x)  # udział p% najcenniejszych klientów
round(c(srednia = mean(x), mediana = median(x), srednia_ucinana_5proc = mean(x, trim = 0.05),
        odsetek_ponizej_sredniej = 100 * mean(x < mean(x))), 1)
round(c(gini = gini, gora_1proc = udzial_gory(0.01), gora_10proc = udzial_gory(0.10),
        gora_20proc = udzial_gory(0.20), dol_50proc = 1 - udzial_gory(0.50)), 3)
gorny_1proc <- order(klienci$marza_12m, decreasing = TRUE)[1:round(0.01 * n)]
c(hodowle_w_gornym_1proc = sum(hodowca[gorny_1proc]), klienci_w_gornym_1proc = length(gorny_1proc))

srodki <- data.frame(miara = c("średnia", "mediana"), wartosc = c(mean(x), median(x)))
pA <- ggplot(klienci, aes(marza_12m + 1)) +
  geom_histogram(bins = 40, fill = kol[["szary"]], colour = "white", linewidth = 0.2) +
  geom_vline(data = srodki, aes(xintercept = wartosc, colour = miara, linetype = miara), linewidth = 1) +
  scale_colour_manual(values = c(średnia = kol[["cynober"]], mediana = kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c(średnia = "solid", mediana = "dashed"), name = NULL) +
  scale_x_log10(breaks = c(10, 30, 100, 300, 1000, 3000), labels = scales::label_number(big.mark = " ")) +
  labs(x = "Marża z 12 miesięcy (zł, skala log.)", y = "Liczba klientów",
       title = "A. Rozkład marży klientów",
       subtitle = sprintf("średnia %.1f zł, mediana %.1f zł", mean(x), median(x))) +
  motyw
pB <- ggplot(lorenz, aes(klienci, udzial)) +
  geom_abline(slope = 1, intercept = 0, linetype = "dotted", colour = kol[["ciemny"]]) +
  geom_ribbon(aes(ymin = udzial, ymax = klienci), fill = kol[["niebieski"]], alpha = 0.15) +
  geom_line(colour = kol[["niebieski"]], linewidth = 1.1) +
  annotate("point", x = 0.9, y = 1 - udzial_gory(0.10), colour = kol[["cynober"]], size = 3) +
  annotate("segment", x = 0.9, xend = 0.72, y = 1 - udzial_gory(0.10), yend = 0.84, colour = kol[["cynober"]]) +
  annotate("text", x = 0.70, y = 0.86, hjust = 1, size = 3.8,
           label = sprintf("90%% klientów ma %.1f%% marży,\n10%% najcenniejszych – %.1f%%",
                           100 * (1 - udzial_gory(0.10)), 100 * udzial_gory(0.10))) +
  annotate("text", x = 0.64, y = 0.47, size = 4.2, label = sprintf("Gini = %s", sub("^0", "", sprintf("%.3f", gini)))) +
  scale_x_continuous(labels = scales::percent) + scale_y_continuous(labels = scales::percent) +
  coord_equal() +
  labs(x = "Klienci od najmniej do najbardziej cennych", y = "Skumulowany udział w marży",
       title = "B. Krzywa Lorenza", subtitle = "kropkowana przekątna = każdy przynosi tyle samo") +
  motyw
p1 <- pA + pB + plot_layout(widths = c(1.15, 1))
p1   # zapis: ggsave("wartosc-klienta-rozklad-lorenz.svg", p1, width = 10, height = 5.4)
Wynik w R
                 srednia                  mediana    srednia_ucinana_5proc
                   299.5                    264.0                    263.5
odsetek_ponizej_sredniej
                    60.6
       gini  gora_1proc gora_10proc gora_20proc  dol_50proc
      0.458       0.080       0.305       0.470       0.184
hodowle_w_gornym_1proc klienci_w_gornym_1proc
                    24                     24
3. Prosty wzór CLV i karta składników: Rysunek 2
R
# Rysunek 2. Skąd bierze się CLV: składniki prostego wzoru policzone z danych sklepu
# Korzysta z obiektów przepisu 1: klienci, kol, motyw. Niczego nie losuje.
library(ggplot2)

miesiace_klientow <- sum(klienci$miesiace)               # opłacone miesiące wszystkich klientów
m_abon <- sum(klienci$marza_abonament) / miesiace_klientow
m_jedn <- sum(klienci$marza_jednorazowe) / miesiace_klientow
m <- m_abon + m_jedn                                     # marża na aktywny miesiąc
r <- 1 - sum(1 - klienci$aktywny) / miesiace_klientow    # retencja miesięczna = 1 − rezygnacje / miesiące
d <- 1.10^(1 / 12) - 1                                   # dyskonto 10% rocznie w przeliczeniu na miesiąc
clv_wzor <- function(m, r, d) m + m * r / (1 + d - r)    # pierwsza marża + wartość przyszłych miesięcy (bez końca)
clv_T <- function(m, r, d, T) sum(m * (r / (1 + d))^(0:(T - 1)))   # to samo, ale tylko przez T miesięcy
round(c(m_abonament = m_abon, m_jednorazowe = m_jedn, m = m, r = r, d_proc = 100 * d,
        sredni_czas_mies = 1 / (1 - r)), 3)
round(c(CLV_bez_horyzontu = clv_wzor(m, r, d), CLV_36_mies = clv_T(m, r, d, 36),
        CLV_12_mies = clv_T(m, r, d, 12), CLV_bez_dyskonta_36 = clv_T(m, r, 0, 36)), 1)

zl <- function(v) paste(formatC(v, format = "f", digits = 1), "zł")
karty <- data.frame(
  x = c(1.25, 3.75, 6.25, 8.75), y = 4.6, kolor = c("marza", "retencja", "dyskonto", "horyzont"),
  tytul = c("Marża miesięczna m", "Retencja r", "Dyskonto d", "Horyzont T"),
  liczba = c(zl(m), sprintf("%.1f%%", 100 * r), sprintf("%.2f%%", 100 * d), "36 mies."),
  opis = c(sprintf("abonament %s\n+ zakupy jednorazowe %s", zl(m_abon), zl(m_jedn)),
           sprintf("tylu klientów płaci\nw kolejnym miesiącu\n(średnio %.1f mies.)", 1 / (1 - r)),
           "miesięcznie, czyli 10%\nrocznie: złotówka za rok\njest warta mniej",
           "jak daleko w przyszłość\nliczymy (bez horyzontu:\nwzór „do końca świata”)"))
p2 <- ggplot() +
  geom_rect(data = karty, aes(xmin = x - 1.12, xmax = x + 1.12, ymin = y - 1.35, ymax = y + 1.35, fill = kolor),
            colour = "grey35", linewidth = 0.4, alpha = 0.22) +
  geom_text(data = karty, aes(x, y + 1.0, label = tytul), fontface = "bold", size = 4.1, colour = "#0f1d3a") +
  geom_text(data = karty, aes(x, y + 0.42, label = liczba), fontface = "bold", size = 6.3, colour = "#0f1d3a") +
  geom_text(data = karty, aes(x, y - 0.62, label = opis), size = 3.5, lineheight = 0.95, colour = "grey20") +
  annotate("segment", x = karty$x, xend = 5, y = 3.2, yend = 2.62, colour = "grey40",
           arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  annotate("rect", xmin = 1.6, xmax = 8.4, ymin = 1.05, ymax = 2.6, fill = "white", colour = kol[["ciemny"]], linewidth = 0.7) +
  annotate("text", x = 5, y = 2.25, label = "CLV = m + m × r / (1 + d − r)", fontface = "bold", size = 5.4, colour = "#0f1d3a") +
  annotate("text", x = 5, y = 1.68, size = 4.1, colour = "grey15",
           label = sprintf("bez horyzontu: %s      przez 36 miesięcy: %s", zl(clv_wzor(m, r, d)), zl(clv_T(m, r, d, 36)))) +
  annotate("text", x = 5, y = 1.27, size = 3.5, colour = "grey30",
           label = "pierwsza marża + marże kolejnych miesięcy × szansa, że klient wciąż płaci, × dyskonto") +
  annotate("segment", x = 5, xend = 5, y = 1.03, yend = 0.66, colour = "grey40",
           arrow = arrow(length = unit(0.18, "cm"), type = "closed")) +
  annotate("text", x = 5, y = 0.38, size = 4.0, colour = kol[["cynober"]], fontface = "bold",
           label = "Decyzja: ile najwyżej zapłacić za pozyskanie klienta (CLV > koszt pozyskania)") +
  scale_fill_manual(values = c(marza = kol[["pomarancz"]], retencja = kol[["niebieski"]],
                               dyskonto = kol[["szary"]], horyzont = kol[["zielony"]]), guide = "none") +
  coord_cartesian(xlim = c(0, 10), ylim = c(0.1, 6.05), expand = FALSE) +
  labs(title = "Skąd bierze się wartość klienta (CLV)",
       subtitle = "Składniki policzone z 12 miesięcy danych sklepu zoologicznego (2400 klientów)") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 10, 10, 10))
p2   # zapis: ggsave("wartosc-klienta-skladniki-clv.svg", p2, width = 10, height = 6.2)
Wynik w R
     m_abonament    m_jednorazowe                m                r
          26.838           11.146           37.984            0.929
          d_proc sredni_czas_mies
           0.797           14.091
  CLV_bez_horyzontu         CLV_36_mies         CLV_12_mies CLV_bez_dyskonta_36
              485.0               459.3               302.7               497.4
4. Wrażliwość CLV i bootstrap retencji: Rysunek 3
R
# Rysunek 3. Jak bardzo CLV zależy od retencji, dyskonta i horyzontu (wykres wrażliwości)
# Korzysta z obiektów przepisów 1 i 3: klienci, m, r, d, clv_wzor, clv_T, kol, motyw.
library(ggplot2)

# Niepewność r i m: bootstrap klientów (1000 prób)
set.seed(606)                                            # to samo ziarno co w przepisie 1
odeszli <- 1 - klienci$aktywny
boot <- t(replicate(1000, {
  i <- sample(nrow(klienci), replace = TRUE)
  mies <- sum(klienci$miesiace[i])
  c(r = 1 - sum(odeszli[i]) / mies, m = sum(klienci$marza_12m[i]) / mies)
}))
clv_boot <- cbind(bez_horyzontu = clv_wzor(boot[, "m"], boot[, "r"], d),
                  T36 = sapply(seq_len(nrow(boot)), function(b) clv_T(boot[b, "m"], boot[b, "r"], d, 36)))
round(rbind(r = quantile(boot[, "r"], c(.025, .975)), m = quantile(boot[, "m"], c(.025, .975))), 3)
round(apply(clv_boot, 2, quantile, c(.025, .975)), 1)

# Ten sam wzór przy innych wartościach r (m i d bez zmian)
round(sapply(c(0.90, r, 0.94, 0.95, 0.97), function(rr)
  c(r = rr, bez_horyzontu = clv_wzor(m, rr, d), T36 = clv_T(m, rr, d, 36), bez_dyskonta = clv_wzor(m, rr, 0))), 3)
# Zmiana CLV (w %), gdy r rośnie o 1 punkt procentowy, a gdy dyskonto roczne spada z 10% do 9%
round(100 * c(r_plus_1pp = clv_wzor(m, r + 0.01, d) / clv_wzor(m, r, d) - 1,
              dyskonto_9proc = clv_wzor(m, r, 1.09^(1 / 12) - 1) / clv_wzor(m, r, d) - 1), 1)

siatka <- expand.grid(r = seq(0.85, 0.985, by = 0.0025),
                      wariant = c("dyskonto 0%", "dyskonto 10%", "dyskonto 20%", "dyskonto 10%, horyzont 36 mies."))
d_roczne <- c(0, 0.10, 0.20, 0.10)[as.integer(siatka$wariant)]
siatka$clv <- mapply(function(rr, dr, w) {
  d_mies <- (1 + dr)^(1 / 12) - 1
  if (grepl("36", w)) clv_T(m, rr, d_mies, 36) else clv_wzor(m, rr, d_mies)
}, siatka$r, d_roczne, as.character(siatka$wariant))
ci_r <- quantile(boot[, "r"], c(.025, .975))
p3 <- ggplot(siatka, aes(r, clv, colour = wariant, linetype = wariant)) +
  annotate("rect", xmin = ci_r[1], xmax = ci_r[2], ymin = 1, ymax = 1e5, fill = kol[["szary"]], alpha = 0.3) +
  geom_line(linewidth = 1.05) +
  annotate("point", x = r, y = clv_wzor(m, r, d), size = 3.4, colour = kol[["ciemny"]]) +
  annotate("label", x = r - 0.004, y = 1500, hjust = 1, size = 3.6, linewidth = 0, fill = "white",
           label = sprintf("r z danych = %s\n(szary pas: 95%% CI)", sub("^0", "", sprintf("%.3f", r)))) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["niebieski"]], kol[["zielony"]], kol[["ciemny"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "longdash", "dotted"), name = NULL) +
  scale_y_log10(breaks = c(200, 300, 500, 1000, 2000, 3000), labels = scales::label_number(suffix = " zł", big.mark = " ")) +
  scale_x_continuous(breaks = seq(0.85, 0.98, 0.01), labels = function(v) sub("^0", "", sprintf("%.2f", v))) +
  coord_cartesian(ylim = c(200, 2700)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Retencja miesięczna r", y = "CLV jednego klienta (skala log.)",
       title = "Wzór CLV jest bardzo czuły na retencję",
       subtitle = sprintf("m = %.2f zł na miesiąc; dyskonto roczne przeliczone na miesięczne", m)) +
  motyw
p3   # zapis: ggsave("wartosc-klienta-wrazliwosc.svg", p3, width = 10, height = 6)
Wynik w R
    2.5%  97.5%
r  0.925  0.933
m 36.775 39.268
      bez_horyzontu   T36
2.5%          456.3 435.5
97.5%         515.6 484.8
                 [,1]    [,2]    [,3]    [,4]     [,5]
r               0.900   0.929   0.940   0.950    0.970
bez_horyzontu 354.595 485.001 563.259 660.416 1008.240
T36           348.593 459.257 517.641 582.129  755.212
bez_dyskonta  379.841 535.229 633.069 759.683 1266.138
    r_plus_1pp dyskonto_9proc
          14.5            0.9
5. Regresja logistyczna w czasie dyskretnym i CLV kanałów: Rysunek 4
R
# Rysunek 4. CLV z prostego modelu: regresja logistyczna miesięcznych rezygnacji (czas dyskretny)
# Korzysta z obiektów przepisów 1 i 3: klienci, okno, marza_planu, rabat_kuponu, d, clv_T, kol, kol_kanal, motyw.
# Na końcu porównanie z prawdą ukrytą w danych (H, lambda, srednia_zam z przepisu 1) – w prawdziwych danych jej nie ma.
library(ggplot2); library(patchwork)

# Tabela „klient-miesiąc” zagregowana: ilu klientów płaciło w miesiącu t i ilu zrezygnowało na jego koniec
zlicz <- function(k) {
  siatka <- expand.grid(miesiac = 1:okno, plan = levels(k$plan), kanal = levels(k$kanal))
  siatka$aktywni <- mapply(function(t, p, c) sum(k$miesiace >= t & k$plan == p & k$kanal == c),
                           siatka$miesiac, siatka$plan, siatka$kanal)
  siatka$odejscia <- mapply(function(t, p, c) sum(k$miesiace == t & k$aktywny == 0 & k$plan == p & k$kanal == c),
                            siatka$miesiac, siatka$plan, siatka$kanal)
  siatka
}
dm <- zlicz(klienci)
dm$koniec_promocji <- as.integer(dm$kanal == "kupon" & dm$miesiac == 4)   # rabat kuponu kończy się po 3 miesiącach
model <- glm(cbind(odejscia, aktywni - odejscia) ~ kanal + plan + koniec_promocji + log(miesiac),
             family = binomial, data = dm)
round(cbind(OR = exp(coef(model)), exp(confint.default(model))), 3)

# Retencja przewidziana na 36 miesięcy (poza 12. miesiącem to już ekstrapolacja trendu log(miesiąc))
przyszlosc <- expand.grid(miesiac = 1:36, plan = levels(klienci$plan), kanal = levels(klienci$kanal))
przyszlosc$koniec_promocji <- as.integer(przyszlosc$kanal == "kupon" & przyszlosc$miesiac == 4)
przyszlosc$h <- predict(model, przyszlosc, type = "response")
przyszlosc <- przyszlosc[order(przyszlosc$kanal, przyszlosc$plan, przyszlosc$miesiac), ]
przyszlosc$placi <- ave(przyszlosc$h, przyszlosc$kanal, przyszlosc$plan,
                        FUN = function(h) c(1, cumprod(1 - h))[seq_along(h)])   # szansa, że płaci w miesiącu t
# Marża w miesiącu t: abonament (z rabatem kuponu w miesiącach 1–3) + zakupy jednorazowe na aktywny miesiąc
jedn <- aggregate(cbind(marza_jednorazowe, miesiace) ~ kanal + plan, data = klienci, FUN = sum)
jedn$m_jedn <- jedn$marza_jednorazowe / jedn$miesiace
przyszlosc <- merge(przyszlosc, jedn[, c("kanal", "plan", "m_jedn")])
przyszlosc$marza <- marza_planu[as.character(przyszlosc$plan)] + przyszlosc$m_jedn -
  rabat_kuponu * (przyszlosc$kanal == "kupon" & przyszlosc$miesiac <= 3)
przyszlosc$wartosc <- przyszlosc$marza * przyszlosc$placi / (1 + d)^(przyszlosc$miesiac - 1)
segmenty <- aggregate(wartosc ~ kanal + plan, data = przyszlosc, FUN = sum)
udzialy <- as.data.frame(prop.table(table(klienci$kanal, klienci$plan), 1), responseName = "udzial")
names(udzialy)[1:2] <- c("kanal", "plan")
segmenty <- merge(segmenty, udzialy)
clv_model <- sapply(split(segmenty, segmenty$kanal), function(s) sum(s$wartosc * s$udzial))

# Dla porównania: prosty wzór ze stałą retencją, osobno w każdym kanale
clv_prosty <- sapply(split(klienci, klienci$kanal), function(k) {
  mies <- sum(k$miesiace); clv_T(sum(k$marza_12m) / mies, 1 - sum(1 - k$aktywny) / mies, d, 36)
})
# Prawda ukryta w symulacji: oczekiwana marża i szansa płacenia każdego klienta z jego własnych parametrów
placi_prawda <- cbind(1, t(apply(1 - H, 1, cumprod)))[, 1:36]
marza_prawda <- outer(marza_planu[as.character(klienci$plan)] + lambda * srednia_zam, rep(1, 36)) -
  rabat_kuponu * outer(klienci$kanal == "kupon", 1:36 <= 3)
clv_prawda <- tapply(rowSums(marza_prawda * placi_prawda / outer(rep(1, N), (1 + d)^(0:35))), klienci$kanal, mean)
round(rbind(prosty_wzor = clv_prosty, model = clv_model, prawda = clv_prawda), 1)

# Szansa, że klient wciąż płaci w miesiącu 13, 24 i 36: model, stała retencja i prawda
pk <- merge(przyszlosc, udzialy)                         # segmenty kanał × plan z udziałami planów w kanale
pk$waga <- pk$udzial * as.numeric(prop.table(table(klienci$kanal)))[as.integer(pk$kanal)]
krzywe <- rbind(
  data.frame(miesiac = 1:36, placi = tapply(pk$placi * pk$waga, pk$miesiac, sum), zrodlo = "model logistyczny"),
  data.frame(miesiac = 1:36, placi = r^(0:35), zrodlo = "stała retencja r (prosty wzór)"),
  data.frame(miesiac = 1:36, placi = colMeans(placi_prawda), zrodlo = "prawda (znana tylko w symulacji)"))
dane_km <- data.frame(miesiac = 1:(okno + 1),            # odsetek płacących w miesiącu t (13. = aktywni po roku)
                      placi = c(sapply(1:okno, function(t) mean(klienci$miesiace >= t)), mean(klienci$aktywny)))
round(sapply(split(krzywe, krzywe$zrodlo), function(k) setNames(k$placi[c(13, 24, 36)], c("m13", "m24", "m36"))), 3)
round(c(dane_m13 = dane_km$placi[13]), 3)

# Rezygnacje w kanale = średnia z planów ważona liczbą wciąż płacących (do panelu A)
dm_k <- aggregate(cbind(aktywni, odejscia) ~ kanal + miesiac, data = dm, FUN = sum)
dm_k$h <- dm_k$odejscia / dm_k$aktywni
round(100 * xtabs(h ~ kanal + miesiac, data = subset(dm_k, miesiac %in% 3:5)), 1)   # rezygnacje (%) w miesiącach 3–5
pk$w <- pk$placi * pk$udzial
mod_k <- aggregate(cbind(hw = h * w, w) ~ kanal + miesiac, data = pk, FUN = sum)
mod_k$h <- mod_k$hw / mod_k$w
pA <- ggplot(dm_k, aes(miesiac, h, colour = kanal, shape = kanal)) +
  geom_line(data = subset(mod_k, miesiac <= okno), aes(linetype = kanal), linewidth = 0.9) +
  geom_point(size = 2.6) +
  scale_colour_manual(values = kol_kanal, name = "Kanał pozyskania") +
  scale_shape_manual(values = c(16, 17, 15), name = "Kanał pozyskania") +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash"), name = "Kanał pozyskania") +
  scale_x_continuous(breaks = c(1, 4, 8, 12)) + scale_y_continuous(labels = scales::percent) +
  labs(x = "Miesiąc abonamentu", y = "Rezygnacje wśród płacących",
       title = "A. Rezygnacje w kolejnych miesiącach", subtitle = "punkty – dane, linie – model") +
  motyw + theme(legend.position = "bottom", legend.direction = "vertical")
pB <- ggplot(krzywe, aes(miesiac, placi)) +
  annotate("rect", xmin = okno + 0.5, xmax = 36.5, ymin = 0, ymax = 1, fill = kol[["szary"]], alpha = 0.15) +
  annotate("text", x = 24.5, y = 0.97, label = "poza danymi: ekstrapolacja", size = 3.6, colour = "grey30") +
  geom_line(aes(colour = zrodlo, linetype = zrodlo), linewidth = 1.05) +
  geom_point(data = dane_km, colour = kol[["ciemny"]], size = 1.8) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["ciemny"]], kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "dotted", "longdash"), name = NULL) +
  scale_x_continuous(breaks = c(1, 12, 24, 36)) + scale_y_continuous(labels = scales::percent, limits = c(0, 1)) +
  labs(x = "Miesiąc abonamentu", y = "Klienci wciąż płacący",
       title = "B. Ilu klientów zostanie na 36 miesięcy?", subtitle = "punkty – dane z 12 miesięcy") +
  motyw + theme(legend.position = "bottom", legend.direction = "vertical")
p4 <- pA + pB
p4   # zapis: ggsave("wartosc-klienta-model-retencji.svg", p4, width = 10, height = 6.2)
Wynik w R
                   OR 2.5 % 97.5 %
(Intercept)     0.125 0.109  0.143
kanalpolecenie  0.690 0.592  0.804
kanalkupon      1.096 0.954  1.260
planduzy        0.772 0.686  0.869
koniec_promocji 6.080 4.977  7.429
log(miesiac)    0.722 0.671  0.776
            wyszukiwarka polecenie kupon
prosty_wzor        515.0     622.6 302.9
model              566.2     676.4 376.4
prawda             558.2     679.1 385.9
    model logistyczny prawda (znana tylko w symulacji)
m13             0.438                            0.438
m24             0.285                            0.288
m36             0.193                            0.201
    stała retencja r (prosty wzór)
m13                          0.413
m24                          0.184
m36                          0.076
dane_m13
    0.44
              miesiac
kanal             3    4    5
  wyszukiwarka  8.7  7.7  7.7
  polecenie     6.3  5.6  4.3
  kupon         9.6 32.4  6.0
6. Bootstrap CLV w kanałach: Rysunek 5
R
# Rysunek 5. CLV przez 36 miesięcy w kanałach pozyskania: 95% przedziały z bootstrapu klientów
# Korzysta z obiektów przepisów 1, 3 i 5: klienci, okno, marza_planu, rabat_kuponu, d, clv_T, clv_prawda, kol, motyw.
library(ggplot2)

# Cała procedura z przepisu 5 jako jedna funkcja: dane klientów -> CLV(36) kanałów z modelu i z prostego wzoru
segment <- interaction(klienci$kanal, klienci$plan)                 # 6 segmentów kanał × plan
siatka <- expand.grid(miesiac = 1:36, seg = levels(segment))
siatka$kanal <- factor(sub("\\..*", "", siatka$seg), levels(klienci$kanal))
siatka$plan <- factor(sub(".*\\.", "", siatka$seg), levels(klienci$plan))
siatka$koniec_promocji <- as.integer(siatka$kanal == "kupon" & siatka$miesiac == 4)
dyskonto <- (1 + d)^-(siatka$miesiac - 1)
clv_kanaly <- function(i) {                     # i = numery klientów (próba bootstrapowa)
  k <- klienci[i, ]; s <- segment[i]
  na_koniec <- table(factor(k$miesiace, 1:okno), s)                # ilu płaciło dokładnie t miesięcy
  odeszli <- table(factor(k$miesiace[k$aktywny == 0], 1:okno), s[k$aktywny == 0])
  aktywni <- apply(na_koniec, 2, function(v) rev(cumsum(rev(v))))  # płacący w miesiącu t
  dm <- data.frame(miesiac = rep(1:okno, 6), seg = rep(colnames(aktywni), each = okno),
                   aktywni = as.vector(aktywni), odejscia = as.vector(odeszli))
  dm$kanal <- factor(sub("\\..*", "", dm$seg), levels(klienci$kanal))
  dm$plan <- factor(sub(".*\\.", "", dm$seg), levels(klienci$plan))
  dm$koniec_promocji <- as.integer(dm$kanal == "kupon" & dm$miesiac == 4)
  fit <- glm(cbind(odejscia, aktywni - odejscia) ~ kanal + plan + koniec_promocji + log(miesiac),
             family = binomial, data = dm)
  h <- predict(fit, siatka, type = "response")
  placi <- ave(h, siatka$seg, FUN = function(x) c(1, cumprod(1 - x))[seq_along(x)])
  m_jedn <- tapply(k$marza_jednorazowe, s, sum) / tapply(k$miesiace, s, sum)
  marza <- marza_planu[as.character(siatka$plan)] + m_jedn[as.character(siatka$seg)] -
    rabat_kuponu * (siatka$kanal == "kupon" & siatka$miesiac <= 3)
  wartosc_seg <- tapply(marza * placi * dyskonto, siatka$seg, sum)
  udzial <- tapply(rep(1, length(s)), s, sum) / tapply(rep(1, length(s)), k$kanal, sum)[sub("\\..*", "", levels(s))]
  model <- tapply(wartosc_seg * udzial, sub("\\..*", "", names(wartosc_seg)), sum)[levels(klienci$kanal)]
  prosty <- sapply(split(k, k$kanal), function(kk) {
    mies <- sum(kk$miesiace); clv_T(sum(kk$marza_12m) / mies, 1 - sum(1 - kk$aktywny) / mies, d, 36) })
  c(model = model, prosty = prosty)
}
round(clv_kanaly(seq_len(nrow(klienci))), 1)          # te same liczby co w przepisie 5

set.seed(606)                                            # to samo ziarno co w przepisie 1
B <- t(replicate(1000, clv_kanaly(sample(nrow(klienci), replace = TRUE))))
oszac <- clv_kanaly(seq_len(nrow(klienci)))
wynik <- data.frame(nazwa = names(oszac), clv = oszac, dolna = apply(B, 2, quantile, 0.025),
                    gorna = apply(B, 2, quantile, 0.975), row.names = NULL)
wynik$metoda <- ifelse(grepl("^model", wynik$nazwa), "model logistyczny (36 mies.)", "prosty wzór, stała r (36 mies.)")
wynik$kanal <- factor(sub("^(model|prosty)\\.", "", wynik$nazwa), levels(klienci$kanal))
print(transform(wynik[, c("metoda", "kanal", "clv", "dolna", "gorna")], clv = round(clv, 1),
                dolna = round(dolna, 1), gorna = round(gorna, 1)), row.names = FALSE)
# Różnica polecenie − kupon w modelu i czy prawda mieści się w przedziale modelu
roznica <- B[, "model.polecenie"] - B[, "model.kupon"]
round(c(roznica = unname(oszac["model.polecenie"] - oszac["model.kupon"]), quantile(roznica, c(.025, .975))), 1)
mod <- subset(wynik, grepl("^model", nazwa))
c(prawda_w_przedziale_modelu = sum(clv_prawda[as.character(mod$kanal)] >= mod$dolna & clv_prawda[as.character(mod$kanal)] <= mod$gorna))

prawda <- data.frame(kanal = factor(names(clv_prawda), levels(klienci$kanal)), clv = as.numeric(clv_prawda))
p5 <- ggplot(wynik, aes(kanal, clv, colour = metoda, shape = metoda)) +
  geom_point(data = prawda, aes(kanal, clv), inherit.aes = FALSE, shape = 23, size = 6.5, stroke = 0.9,
             colour = kol[["ciemny"]], fill = "white") +
  geom_errorbar(aes(ymin = dolna, ymax = gorna), width = 0.18, linewidth = 0.9, position = position_dodge(width = 0.5)) +
  geom_point(size = 3.4, position = position_dodge(width = 0.5)) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_y_continuous(labels = scales::label_number(suffix = " zł"), limits = c(200, NA)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2)) +
  labs(x = "Kanał pozyskania klienta", y = "CLV przez 36 miesięcy",
       title = "Wartość klienta z kanałów pozyskania",
       subtitle = "Odcinki: 95% przedziały bootstrapowe (1000 prób klientów); biały romb: prawda z symulacji") +
  motyw
p5   # zapis: ggsave("wartosc-klienta-kanaly-bootstrap.svg", p5, width = 10, height = 5.8)
Wynik w R
 model.wyszukiwarka     model.polecenie         model.kupon prosty.wyszukiwarka
              566.2               676.4               376.4               515.0
   prosty.polecenie        prosty.kupon
              622.6               302.9
                          metoda        kanal   clv dolna gorna
    model logistyczny (36 mies.) wyszukiwarka 566.2 518.5 615.6
    model logistyczny (36 mies.)    polecenie 676.4 622.6 737.7
    model logistyczny (36 mies.)        kupon 376.4 340.9 417.8
 prosty wzór, stała r (36 mies.) wyszukiwarka 515.0 471.1 561.2
 prosty wzór, stała r (36 mies.)    polecenie 622.6 570.7 681.7
 prosty wzór, stała r (36 mies.)        kupon 302.9 275.2 336.9
roznica    2.5%   97.5%
  300.0   233.4   367.6
prawda_w_przedziale_modelu
                         3
7. Sprawdzenie palety (deuteranopia, protanopia)
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (średnia / mediana; model / prosty wzór)" = c("#0072B2", "#D55E00"),
             "niebieski – zielony (wyszukiwarka / polecenie)" = c("#0072B2", "#009E73"),
             "zielony – cynober (polecenie / kupon)" = c("#009E73", "#D55E00"),
             "cynober – ciemnoszary (stała retencja / prawda)" = c("#D55E00", "#333333"),
             "niebieski – ciemnoszary (model / prawda)" = c("#0072B2", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                             widzenie_typowe
niebieski – cynober (średnia / mediana; model / prosty wzór)           114.6
niebieski – zielony (wyszukiwarka / polecenie)                          70.1
zielony – cynober (polecenie / kupon)                                  102.4
cynober – ciemnoszary (stała retencja / prawda)                         83.4
niebieski – ciemnoszary (model / prawda)                                48.3
czerwony – zielony (do unikania)                                       121.7
                                                             deuteranopia
niebieski – cynober (średnia / mediana; model / prosty wzór)        108.3
niebieski – zielony (wyszukiwarka / polecenie)                       55.4
zielony – cynober (polecenie / kupon)                                53.5
cynober – ciemnoszary (stała retencja / prawda)                      72.7
niebieski – ciemnoszary (model / prawda)                             50.3
czerwony – zielony (do unikania)                                     21.1
                                                             protanopia
niebieski – cynober (średnia / mediana; model / prosty wzór)       91.9
niebieski – zielony (wyszukiwarka / polecenie)                     58.0
zielony – cynober (polecenie / kupon)                              37.3
cynober – ciemnoszary (stała retencja / prawda)                    59.9
niebieski – ciemnoszary (model / prawda)                           47.4
czerwony – zielony (do unikania)                                   31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, regresja logistyczna glm(), bootstrap – pakiety base i stats). Rysunki wykonano w ggplot2 (osie – pakiet scales, panele – patchwork); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Średnia zawyżona przez nielicznych. Średnia marża to nie marża typowego klienta: 60.6% klientów przynosi mniej (rysunek 1). Podawaj medianę i udział najcenniejszych 10%.
- „CLV” bez horyzontu i dyskonta. Liczba bez tych dwóch założeń nic nie znaczy: przy r = .97 to 1008.2 zł bez horyzontu i 755.2 zł przez 36 miesięcy. Zawsze je podawaj.
- Stała retencja wzięta z pierwszego roku. Mieszanka klientów odchodzących szybko i wolno sprawia, że retencja grupy rośnie z czasem. Prosty wzór przewidział 7.6% płacących po 36 miesiącach wobec prawdziwych 20.1% (rysunek 4).
- Ekstrapolacja daleko poza dane. Model z 12 miesięcy trafił tu w 36. miesiąc, bo znał właściwy kształt trendu. Im dalej poza dane, tym bardziej prognoza zależy od założeń, a nie od danych – 36 miesięcy to już trzykrotność okresu obserwacji.
- Przedział tylko z próby. Bootstrap nie naprawi złego modelu – pokaż też analizę wrażliwości (rysunek 3).
Pomoc przy takiej analizie w pracy dyplomowej: analizy statystyczne dla studentów.
Najczęstsze pytania
Jak policzyć CLV klienta?
Najprościej: CLV = m + m × r / (1 + d − r), gdzie m to marża z jednego okresu, r – retencja (odsetek klientów zostających na kolejny okres), a d – stopa dyskonta na okres. W przykładzie m = 37.98 zł, r = .929 i d = 0.80% miesięcznie dały 485.0 zł bez horyzontu i 459.3 zł przez 36 miesięcy. Gdy retencja zmienia się w czasie albo między grupami, policz ją modelem.
Czy CLV liczyć z przychodu, czy z marży?
Z marży (przychód minus koszty zmienne: towar, wysyłka, prowizje). CLV z przychodu przecenia klientów kupujących tanie produkty z niską marżą i zachęca do przepłacania za pozyskanie. W pracy napisz wprost, co weszło do marży.
Jaką stopę dyskonta przyjąć do CLV?
Zwykle koszt kapitału firmy albo przyjętą stopę, np. 10% rocznie, przeliczoną na okres: (1 + 0.10)1/12 − 1 = 0.80% miesięcznie. Wynik mniej zależy od dyskonta niż od retencji: w przykładzie spadek dyskonta z 10% do 9% podniósł CLV o 0.9%, a wzrost retencji o 1 punkt – o 14.5%.
Dlaczego CLV z prostego wzoru może być błędne?
Wzór zakłada stałą retencję u wszystkich klientów i w każdym miesiącu. Gdy w bazie są klienci odchodzący szybko i wolno, retencja grupy rośnie z czasem, a jednorazowe skoki (np. koniec rabatu) wzór rozlewa na całą przyszłość. W przykładzie przewidział 7.6% płacących po 36 miesiącach wobec prawdziwych 20.1%.
Jak podać niepewność CLV?
Policz przedział bootstrapowy: losuj klientów ze zwracaniem, licz CLV od nowa (np. 1000 razy) i weź 2.5. i 97.5. percentyl. Dla klientów z polecenia dało to 676.4 zł, 95% CI [622.6, 737.7]. Przedział nie obejmuje błędu ekstrapolacji, więc dodaj wykres wrażliwości na retencję, dyskonto i horyzont.
Powiązane hasła
Przeczytaj też
Analiza kohortowa retencji klientów
Sklep z karmą, 30 kohort i 18 tys. transakcji: tabela kohortowa, mapa ciepła, krzywe z przedziałami i pułapki oceny programu lojalnościowego – pięć rysunków z kodem R.
Czytaj →PoradnikChurn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikModel odejść klientów i kampania retencyjna
Operator komórkowy, 10 000 abonentów: regresja i las losowy, gain i lift, kalibracja, macierz decyzji, krzywa zysku i przeciek danych – pięć rysunków z kodem R.
Czytaj →PoradnikModel BG/NBD – aktywni klienci
Sklep z przyprawami: BG/NBD napisany ręcznie w R, P(aktywny), prognoza zakupów na rok 2 i porównanie z regułą 180 dni – sześć rysunków.
Czytaj →Liczysz wartość klienta w pracy z marketingu?
Pomożemy przygotować dane klientów, oszacować retencję i CLV z przedziałami, sprawdzić wrażliwość założeń i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552 ● Otwarty dostęp
- Fader, P. S., & Hardie, B. G. S. (2007). How to project customer retention. Journal of Interactive Marketing, 21(1), 76–90. https://doi.org/10.1002/dir.20074 ● Otwarty dostęp: pełny tekst
- Fader, P. S., Hardie, B. G. S., & Lee, K. L. (2005). RFM and CLV: Using iso-value curves for customer base analysis. Journal of Marketing Research, 42(4), 415–430. https://doi.org/10.1509/jmkr.2005.42.4.415
- Gupta, S., Hanssens, D., Hardie, B., Kahn, W., Kumar, V., Lin, N., Ravishanker, N., & Sriram, S. (2006). Modeling customer lifetime value. Journal of Service Research, 9(2), 139–155. https://doi.org/10.1177/1094670506293810
- Gupta, S., Lehmann, D. R., & Stuart, J. A. (2004). Valuing customers. Journal of Marketing Research, 41(1), 7–18. https://doi.org/10.1509/jmkr.41.1.7.25084
- Schmittlein, D. C., Morrison, D. G., & Colombo, R. (1987). Counting your customers: Who are they and what will they do next? Management Science, 33(1), 1–24. https://doi.org/10.1287/mnsc.33.1.1
- Willett, J. B., & Singer, J. D. (1993). Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence. Journal of Consulting and Clinical Psychology, 61(6), 952–965. https://doi.org/10.1037/0022-006X.61.6.952
Cytowania BibTeX
@article{efron1979bootstrap, author={Efron, Bradley}, title={{Bootstrap methods: Another look at the jackknife}}, journal={The Annals of Statistics}, year={1979}, volume={7}, number={1}, pages={1--26}, doi={10.1214/aos/1176344552}}@article{fader2007how, author={Fader, Peter S. and Hardie, Bruce G. S.}, title={{How to project customer retention}}, journal={Journal of Interactive Marketing}, year={2007}, volume={21}, number={1}, pages={76--90}, doi={10.1002/dir.20074}}@article{fader2005rfm, author={Fader, Peter S. and Hardie, Bruce G. S. and Lee, Ka Lok}, title={{RFM and CLV: Using iso-value curves for customer base analysis}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={4}, pages={415--430}, doi={10.1509/jmkr.2005.42.4.415}}@article{gupta2006modeling, author={Gupta, Sunil and Hanssens, Dominique and Hardie, Bruce and Kahn, Wiliam and Kumar, V. and Lin, Nathaniel and Ravishanker, Nalini and Sriram, S.}, title={{Modeling customer lifetime value}}, journal={Journal of Service Research}, year={2006}, volume={9}, number={2}, pages={139--155}, doi={10.1177/1094670506293810}}@article{gupta2004valuing, author={Gupta, Sunil and Lehmann, Donald R. and Stuart, Jennifer Ames}, title={{Valuing customers}}, journal={Journal of Marketing Research}, year={2004}, volume={41}, number={1}, pages={7--18}, doi={10.1509/jmkr.41.1.7.25084}}@article{schmittlein1987counting, author={Schmittlein, David C. and Morrison, Donald G. and Colombo, Richard}, title={{Counting your customers: Who are they and what will they do next?}}, journal={Management Science}, year={1987}, volume={33}, number={1}, pages={1--24}, doi={10.1287/mnsc.33.1.1}}@article{willett1993investigating, author={Willett, John B. and Singer, Judith D.}, title={{Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence}}, journal={Journal of Consulting and Clinical Psychology}, year={1993}, volume={61}, number={6}, pages={952--965}, doi={10.1037/0022-006x.61.6.952}}