optim()) przewidział zakupy całej bazy w roku 2 z błędem 0.3%, ale w wyborze klientów do kampanii prosta reguła „180 dni bez zakupu” była równie dobra. Klientów hurtowych i zmiany oferty model nie rozpozna – analizuj je osobno.Przykład: sklep internetowy z przyprawami
Fikcyjny sklep internetowy z przyprawami sprzedaje mieszanki, pieprze i zioła. Klient nie podpisuje umowy ani nie anuluje subskrypcji: po prostu przestaje kupować, a sklep tego nie widzi. Kierownik marketingu pyta: kto z klientów pozyskanych zimą 2024 r. jest jeszcze klientem i ile zamówień złożą wszyscy w 2025 r.? To inne pytanie niż we wpisie churn jako analiza przeżycia, gdzie moment rezygnacji z abonamentu jest zapisany w danych.
Mamy dwa lata transakcji (2024–2025) 2420 klientów, którzy pierwszy raz kupili w pierwszych 12 tygodniach 2024 r. Rok 1 służy do dopasowania modelu (kalibracja), rok 2 – do sprawdzenia prognozy. Wśród klientów jest 20 hurtowych (restauracje i firmy cateringowe), które sklep rozpoznaje po fakturach na firmę; model dopasowujemy do 2400 klientów detalicznych, a hurtowych zostawiamy na koniec.
Dane są fikcyjne, więc wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy: tempo zakupów klientów detalicznych z rozkładu gamma (parametry r i α: 0.70 i 9, czyli średnio 0.078 zamówienia tygodniowo), szansę odejścia po każdym zakupie z rozkładu beta (a = 0.90, b = 3.20, średnio 0.22) i hurtowych kupujących co 1–2 tygodnie bez odejść. Parametrów danych ani ziarna 672 nie zmienialiśmy po pierwszym uruchomieniu; poprawiliśmy tylko wygląd rysunków 1, 5 i 6. Dane pobierzesz jako bg-nbd-sklep-z-przyprawami-transakcje.csv (wiersz = transakcja: klient, data, znacznik klienta hurtowego).
Rysunek 1: trzy liczby i opowieść modelu
Model BG/NBD (beta-geometric/negative binomial distribution) zaproponowali Fader i in. (2005) jako prostszą w estymacji wersję modelu Pareto/NBD, który Schmittlein i in. (1987) zbudowali, by liczyć szansę, że klient bez umowy jest wciąż aktywny. Model potrzebuje z historii każdego klienta tylko trzech liczb: x – liczby powtórnych zakupów (pierwszego nie liczymy), tx – czasu od pierwszego do ostatniego zakupu i T – czasu od pierwszego zakupu do końca obserwacji (tu w tygodniach).
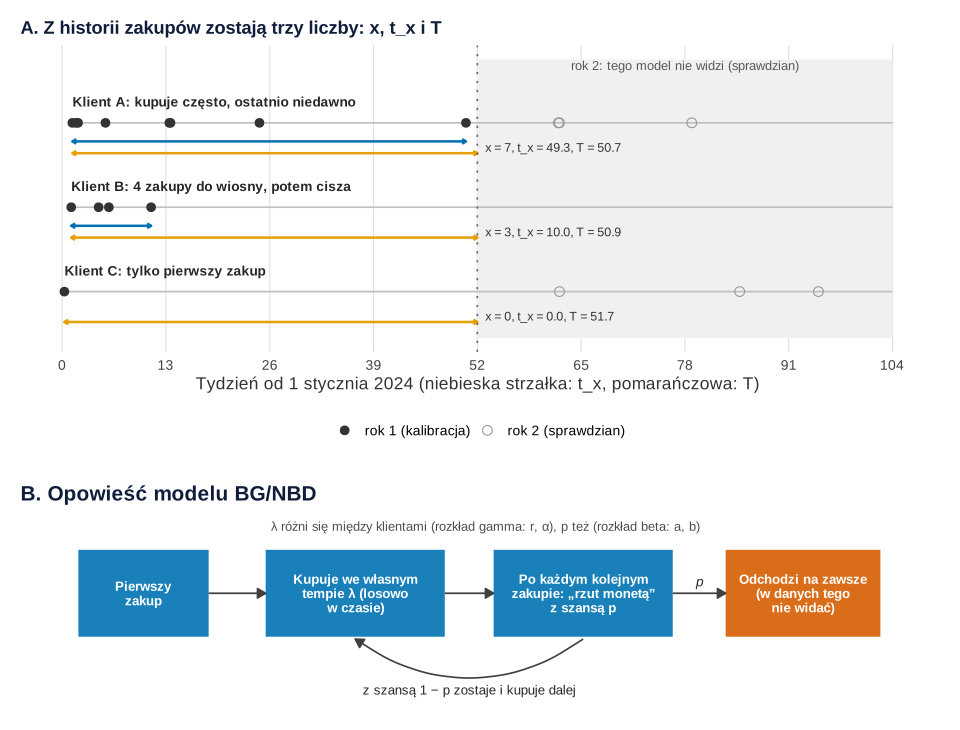
set.seed(672)).Co widać. Panel B to cała „opowieść” modelu. Aktywny klient kupuje losowo w czasie we własnym tempie λ (liczba zakupów w danym okresie ma rozkład Poissona). Po każdym powtórnym zakupie „rzuca monetą”: z szansą p odchodzi na zawsze. Klienci różnią się tempem (λ z rozkładu gamma o parametrach r i α) i skłonnością do odejścia (p z rozkładu beta o parametrach a i b). Mieszanka Poissona z gammą to rozkład ujemny dwumianowy (NBD) – ten sam, który zna się z regresji ujemnej dwumianowej.
Jak może zmylić. Klient B długo milczy, ale nie wiemy, czy odszedł – w danych nie ma momentu odejścia. Podobnie jest z obserwacją cenzurowaną, tylko tu nawet nie wiadomo, czy zdarzenie w ogóle nastąpiło. Klient C to pułapka założenia: bez powtórnego zakupu model uznaje go za aktywnego na pewno, bo odejść można tylko po zakupie.
Rysunek 2: model napisany ręcznie i przedziały z hesjanu
Gotowy pakiet (np. BTYD) nie jest potrzebny – model mieści się w kilkunastu linijkach R. Funkcja log-wiarygodności klienta ma dwa składniki: „wciąż aktywny w T” i „odszedł zaraz po zakupie w tx” (drugi tylko przy x > 0). Sumę po klientach maksymalizuje optim() – to zwykła metoda największej wiarygodności. Parametry szacujemy na skali logarytmu, żeby były dodatnie. Odwrotność hesjanu daje błędy standardowe logarytmów parametrów, a przedział 95% to exp(log ± 1.96 SE).
| Parametr | Co opisuje | Ocena | 95% CI | Prawda |
|---|---|---|---|---|
| r | kształt rozkładu tempa zakupów | 0.656 | [0.603, 0.713] | 0.70 |
| α | skala tempa (tygodnie) | 8.52 | [7.57, 9.59] | 9 |
| a | rozkład szansy odejścia | 0.905 | [0.638, 1.285] | 0.90 |
| b | rozkład szansy odejścia | 3.32 | [2.14, 5.14] | 3.20 |
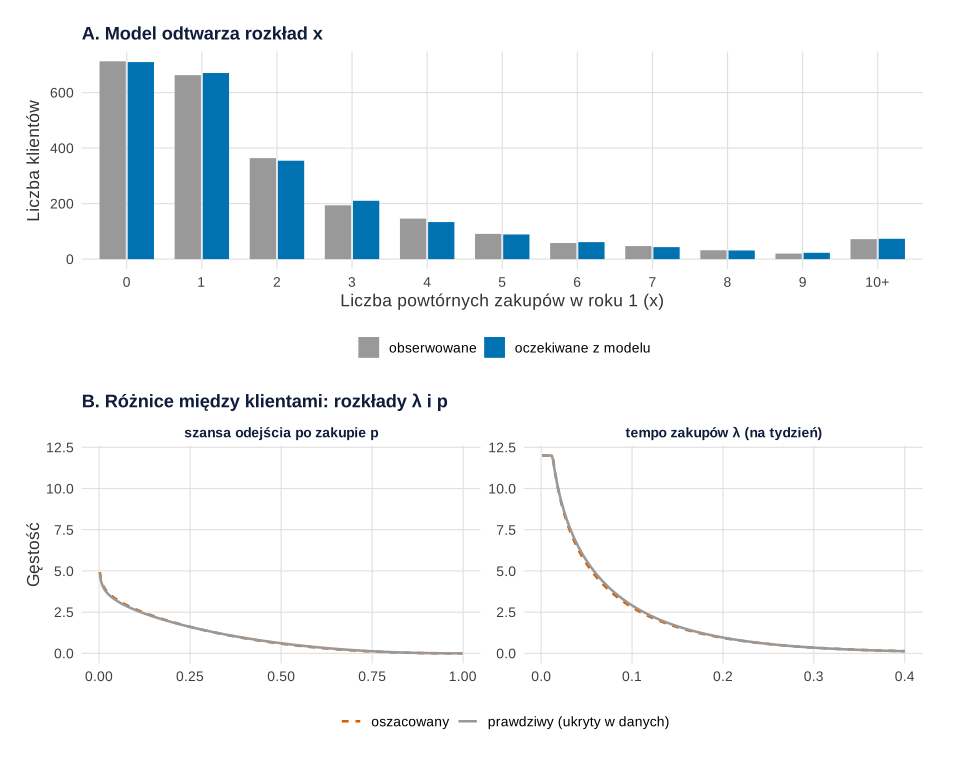
Co widać. Przeciętny klient kupuje 0.077 razy w tygodniu (4.0 zamówienia rocznie), a po zakupie odchodzi z szansą 0.214. Model dobrze odtwarza rozkład x: test chi-kwadrat zgodności daje χ²(6) = 3.70, p = .717. Wszystkie cztery przedziały obejmują prawdę, a krzywe oszacowane i prawdziwe prawie się pokrywają.
Jak może zmylić. Przedział dla b jest szeroki (od 2.14 do 5.14), bo o odejściach dowiadujemy się tylko pośrednio – z ciszy po zakupach. Przedziały z hesjanu zakładają symetrię na skali logarytmu; przy małej bazie klientów sprawdź przedział z profilu wiarygodności. Dobre dopasowanie w roku 1 nie dowodzi jeszcze, że prognoza na rok 2 będzie trafna.
Rysunek 3: kto jest jeszcze klientem
Prawdopodobieństwo, że klient z historią (x, tx, T) jest wciąż aktywny, ma w BG/NBD prosty wzór (Fader i in., 2005):
Słowami: im dłuższa cisza (T − tx) i im więcej wcześniej kupowanych razy, tym mniej prawdopodobne, że klient tylko „robi przerwę”.
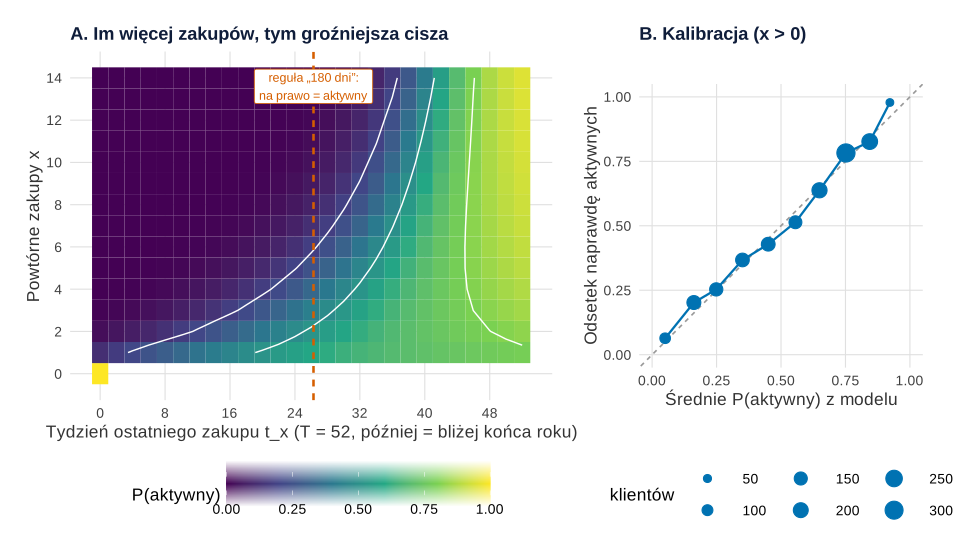
Co widać. Dwóch klientów z 4 zakupami i T = 52: ostatni zakup w tygodniu 48 daje P = .821, w tygodniu 20 – tylko .273. Klient z 12 zakupami, który milczy od 22 tygodni, ma P = .071: przy jego tempie taka przerwa jest bardzo nietypowa. Panel B pokazuje, że prawdopodobieństwa są dobrze skalibrowane (kalibracja modelu): średnie P(aktywny) wynosi .666, a naprawdę aktywnych było 66.7% klientów.
Jak może zmylić. Kalibrację względem prawdy da się sprawdzić tylko w symulacji. Na prawdziwych danych nikt nie wie, kto odszedł, więc model ocenia się po prognozie zakupów (rysunek 4). Mapa łączy też recency i frequency w jedną liczbę inaczej niż punktowe RFM ze segmentacji klientów.
Rysunek 4: prognoza na rok 2 kontra rzeczywistość
Z tych samych parametrów model liczy oczekiwaną liczbę zakupów każdego klienta w kolejnych 52 tygodniach (wzór z funkcją hipergeometryczną – w kodzie). Rok 2 nie brał udziału w estymacji, więc to uczciwy sprawdzian, jak przy walidacji w czasie.
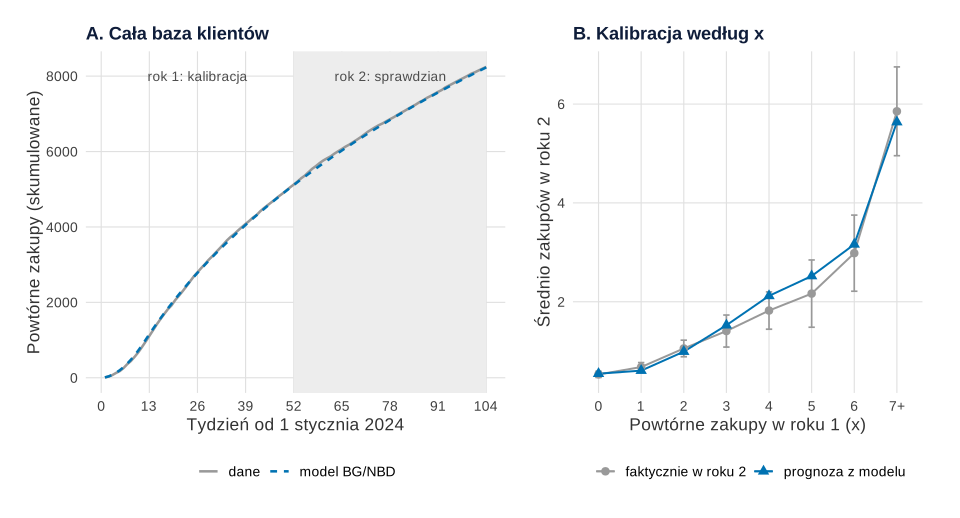
Co widać. Suma prognoz na rok 2 wynosi 3132 zakupy, a klienci złożyli 3122 zamówienia (błąd +0.3%). W panelu B prognoza trafia w grupy: klienci bez powtórnego zakupu 0.54 wobec 0.53, z 7 i więcej zakupami 5.63 wobec 5.85.
Jak może zmylić. Przy x = 4 prognoza (2.12) wychodzi tuż ponad przedział faktycznej średniej [1.44, 2.20] – w małych grupach tak wygląda zwykły rozrzut. Trafna suma nie znaczy, że trafne są prognozy pojedynczych klientów: większość osób kupi 0, 1 albo 2 razy, a prognoza to ułamek.
Rysunek 5: model czy reguła „180 dni bez zakupu”?
Wiele sklepów uznaje za utraconego każdego, kto nie kupił od 180 dni. Na koniec 2024 r. ta reguła wskazuje 992 aktywnych klientów. Porównujemy ją z wyborem 992 klientów z najwyższą prognozą zakupów z modelu.
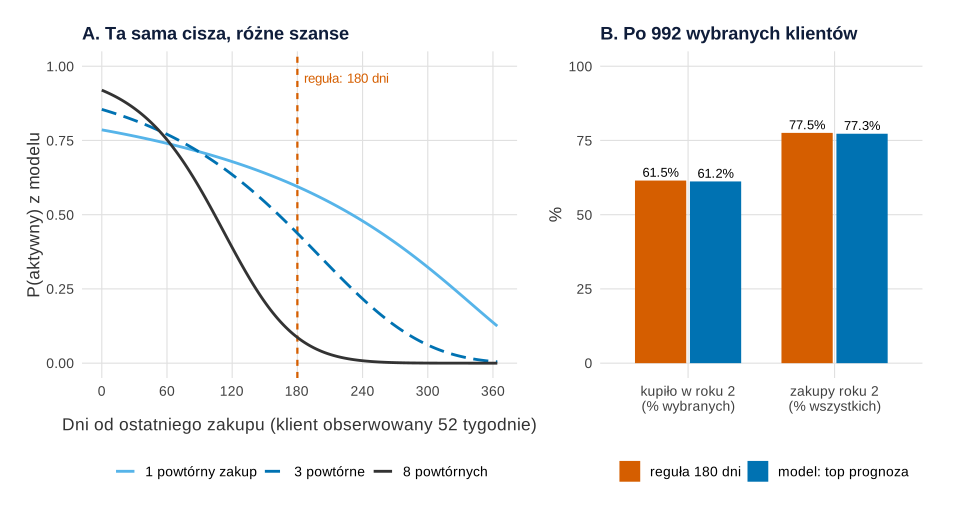
Co widać. Panel A: 180 dni ciszy u klienta z 1 powtórnym zakupem oznacza P(aktywny) = .595, z 3 – .437, a z 8 – tylko .087. Reguła tego nie rozróżnia. Mimo to w panelu B obie metody wypadają prawie tak samo: w 2025 r. kupiło 61.5% klientów z reguły i 61.2% z modelu, a ich zamówienia to 77.5% i 77.3% wszystkich zakupów. Wybory różnią się tylko 56 klientami w każdą stronę. Model lepiej porządkuje całą bazę (pole pod krzywą ROC dla „kupi w roku 2”: .713 wobec .676).
Jak może zmylić. To zgodne z tym, co Wübben i von Wangenheim (2008) znaleźli na prawdziwych danych: proste reguły działały co najmniej tak dobrze jak modele we wszystkich zadaniach poza prognozą zakupów całej bazy. Tę przewagę model ma i tutaj – reguła nie powie, że w 2025 r. będzie około 3100 zamówień. Nie wybieraj też klientów według samego P(aktywny) > .5: to 1645 osób (w tym wszyscy 713 bez powtórnego zakupu), a w roku 2 kupiło tylko 51.9% z nich.
Rysunek 6: klienci hurtowi i zmiana oferty
Dwie sytuacje, w których poprawny rachunek daje złą prognozę: (a) dopasowanie do wszystkich 2420 klientów razem z 20 hurtowymi, (b) zmiana oferty od 3 marca 2025 r. – sklep wycofał zestawy prezentowe i podniósł próg darmowej dostawy. Symulujemy ją, usuwając losowo 30% zakupów detalicznych po tej dacie (scenariusz ustalony ręcznie, set.seed(6722)).
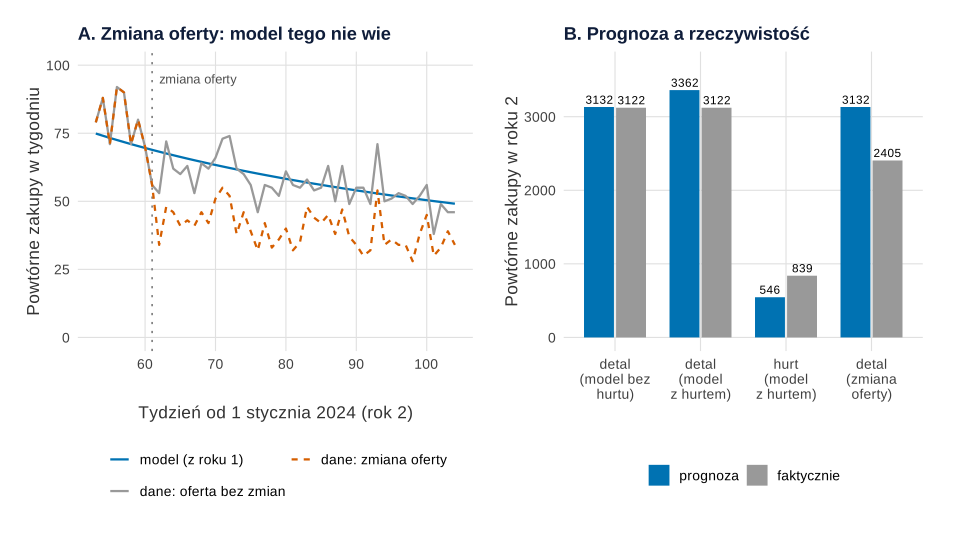
Co widać. (a) Hurtowi mają średnio 36.3 powtórnych zakupów w roku 1 i nigdy nie odchodzą. Dodani do modelu zmieniają wszystkie parametry (np. a spada z 0.905 do 0.600), zawyżają prognozę dla klientów detalicznych o 7.7% (3362 wobec 3122), a dla samych hurtowych zaniżają ją o 34.9% (546 wobec 839). (b) Po zmianie oferty model, który zna tylko 2024 r., przeszacowuje zakupy o 30.2% (3132 wobec 2405).
Jak może zmylić. BG/NBD zakłada stałe tempo zakupów aktywnego klienta i stałe warunki rynku. Sezonowość, promocje i zmiany oferty są dla niego niewidoczne. Krzywa śledząca z panelu A, aktualizowana co tydzień, pokazuje taki rozjazd szybciej niż roczne podsumowanie.
Co z tym zrobić w marketingu
- Do budżetu i planu zapasów używaj prognozy całej bazy. Model przewidział rok 2 z błędem 0.3%; reguła 180 dni takiej liczby nie daje. Sumę prognoz możesz pomnożyć przez marżę i wstawić do modelu wartości klienta (CLV); przegląd takich modeli daje Gupta i in. (2006).
- Do wyboru adresatów kampanii reaktywacyjnej wystarczy często prosta reguła. Tu model i reguła wybrały prawie tych samych klientów. Model przydaje się, gdy chcesz ich uszeregować: najpierw klienci z wysoką prognozą i średnim P(aktywny), np. częsty klient, który milczy od 3 miesięcy.
- Nie mierz efektu kampanii prognozą. Wysłanie kuponu klientom „zagrożonym” wymaga grupy kontrolnej – jak we wpisie o modelu odejść i kampanii retencyjnej i przy ocenie efektu programu lojalnościowego.
- Częsty i aktywny nie znaczy zyskowny. Reinartz i Kumar (2000) pokazali w relacji bez umowy, że długoletni klienci nie muszą przynosić większego zysku. BG/NBD prognozuje liczbę zamówień, nie ich wartość.
- Analizuj hurt osobno, a model przeliczaj po każdej większej zmianie oferty.
Jak opisać w pracy
W Metodzie podaj okres kalibracji i testu, jednostkę czasu, definicję powtórnego zakupu (łączenie zakupów z jednego dnia), wykluczenia (hurt) i sposób estymacji. W Wynikach – parametry z przedziałami, dopasowanie i trafność prognozy w okresie testowym. Więcej o pracach na danych z firmy: statystyka w pracy z marketingu.
Kod R: dane, model BG/NBD, prognoza i porównanie z regułą
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i dane, a kolejne korzystają z obiektów i funkcji wcześniejszych (dopasuj(), p_aktywny(), oczek_warunkowe()). Model jest napisany ręcznie w bazowym R (optim(), lgamma(), lbeta()); wzory na log-wiarygodność, P(aktywny) i oczekiwaną liczbę zakupów pochodzą z artykułu Fadera i in. (2005). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 (set.seed(672)) i 7 (set.seed(6722)); ziaren ustalonych na początku nie zmieniano. Ręcznie ustalono: 2400 klientów detalicznych z pierwszym zakupem w tygodniach 0–12, λ z rozkładu gamma (r i α: 0.70 i 9), p z rozkładu beta (a i b: 0.90 i 3.20), 20 klientów hurtowych z tempem 0.5–1.0 zakupu tygodniowo bez odejść, podział na rok kalibracji i rok testowy, próg reguły (180 dni) oraz scenariusz zmiany oferty (−30% zakupów detalicznych od 3 marca 2025 r.). Parametrów danych nie zmieniano po pierwszym uruchomieniu; po nim poprawiono tylko rysunki (wybór klienta A na rysunku 1, krzywe zamiast chmury punktów na rysunku 5, krótsze etykiety na rysunkach 5 i 6). Całość liczy się w kilka sekund.
1. Paleta, dane i format (x, t_x, T)
R
# Przepis 1. Fikcyjny sklep internetowy z przyprawami: dwa lata transakcji i format (x, t_x, T) (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", blekit = "#56B4E9", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (prawda, którą model ma odnaleźć) ------------------------------
n_klientow <- 2400                  # nowi klienci detaliczni z pierwszych 12 tygodni 2024 r.
r_pr <- 0.70; alfa_pr <- 9          # tempo zakupów λ ~ Gamma(r, α): średnio 0.078 zakupu na tydzień
a_pr <- 0.90; b_pr <- 3.20          # szansa odejścia po zakupie p ~ Beta(a, b): średnio 0.22
n_hurt <- 20                        # klienci hurtowi (restauracje, catering): co tydzień lub dwa, bez odejść
start <- as.Date("2024-01-01")      # dane: 104 tygodnie, 2024-01-01 – 2025-12-28
koniec_kal <- start + 52 * 7        # 2024-12-30: koniec okresu kalibracji (rok 1), dalej okres testowy (rok 2)

# Jeden klient według BG/NBD: kupuje w tempie λ, po każdym kolejnym zakupie odchodzi z szansą p
klient <- function(id, t0, lambda, p, hurtowy = 0, horyzont = 104) {
  t <- t0; zakupy <- t0; zywy <- TRUE; t_odejscia <- Inf
  repeat {
    t <- t + rexp(1, lambda)
    if (t >= horyzont) break
    zakupy <- c(zakupy, t)
    if (runif(1) < p) { t_odejscia <- t; break }
  }
  list(transakcje = data.frame(klient = id, data = start + floor(zakupy * 7), hurtowy = hurtowy),
       aktywny_52 = t_odejscia > 52)
}
set.seed(672)
t0 <- runif(n_klientow, 0, 12)                       # tydzień pierwszego zakupu
lam <- rgamma(n_klientow, shape = r_pr, rate = alfa_pr)
pp <- rbeta(n_klientow, a_pr, b_pr)
sym <- lapply(seq_len(n_klientow), function(i) klient(i, t0[i], lam[i], pp[i]))
hurt <- lapply(seq_len(n_hurt), function(j) klient(n_klientow + j, runif(1, 0, 12), runif(1, 0.5, 1.0), 0, hurtowy = 1))
transakcje <- unique(do.call(rbind, lapply(c(sym, hurt), `[[`, "transakcje")))   # zakupy z tego samego dnia łączymy
transakcje <- transakcje[order(transakcje$klient, transakcje$data), ]
write.csv(transakcje, "bg-nbd-sklep-z-przyprawami-transakcje.csv", row.names = FALSE)

# Z listy transakcji do formatu (x, t_x, T): rok 1 to kalibracja, rok 2 – sprawdzian
do_xtT <- function(tr) {
  kal <- tr[tr$data < koniec_kal, ]
  pierwszy <- tapply(kal$data, kal$klient, min); ostatni <- tapply(kal$data, kal$klient, max)
  d <- data.frame(klient = as.integer(names(pierwszy)),
                  x = as.vector(table(kal$klient)) - 1,                         # liczba POWTÓRNYCH zakupów
                  t_x = as.numeric(ostatni - pierwszy) / 7,                      # tydzień ostatniego zakupu (od pierwszego)
                  T = as.numeric(koniec_kal - pierwszy) / 7)                     # jak długo obserwujemy klienta
  test <- table(factor(tr$klient[tr$data >= koniec_kal], levels = d$klient))
  d$x_test <- as.vector(test)                                                    # zakupy w roku 2
  d$hurtowy <- as.integer(d$klient > n_klientow)
  d
}
klienci <- do_xtT(transakcje)
klienci$aktywny_52 <- c(sapply(sym, `[[`, "aktywny_52"), rep(TRUE, n_hurt))     # prawda znana tylko w symulacji
head(klienci, 4)

# Opis danych: detal i hurt
opis <- function(d) c(klienci = nrow(d), transakcje_rok1 = sum(d$x + 1), transakcje_rok2 = sum(d$x_test),
                      bez_powtornego_proc = 100 * mean(d$x == 0), srednia_x = mean(d$x), maks_x = max(d$x),
                      kupilo_w_roku2_proc = 100 * mean(d$x_test > 0), aktywni_52_proc = 100 * mean(d$aktywny_52))
round(sapply(split(klienci, ifelse(klienci$hurtowy == 1, "hurt", "detal")), opis), 2)
detal <- klienci[klienci$hurtowy == 0, ]
table(pmin(detal$x, 10))   # rozkład liczby powtórnych zakupów w roku 1 (10 = 10 i więcej)
Wynik w R
  klient x      t_x        T x_test hurtowy aktywny_52
1      1 4 22.71429 41.14286      0       0      FALSE
2      2 2 45.71429 48.71429      3       0       TRUE
3      3 2 31.00000 45.28571      0       0      FALSE
4      4 8 41.57143 44.57143      8       0       TRUE
                      detal  hurt
klienci             2400.00  20.0
transakcje_rok1     7523.00 746.0
transakcje_rok2     3122.00 839.0
bez_powtornego_proc   29.71   0.0
srednia_x              2.13  36.3
maks_x                26.00  51.0
kupilo_w_roku2_proc   42.71 100.0
aktywni_52_proc       66.75 100.0

  0   1   2   3   4   5   6   7   8   9  10
713 663 364 194 146  91  58  47  32  20  72
2. Grafika: oś czasu klienta i schemat modelu – Rysunek 1
R
# Przepis 2. Grafika: jak BG/NBD „widzi” klienta – oś czasu (x, t_x, T) i proces zakupów (Rysunek 1)
# Korzysta z obiektów przepisu 1 (transakcje, klienci, kol, motyw, start, koniec_kal).
# Trzech klientów z danych: częsty i wciąż aktywny, taki, który odszedł, i taki bez powtórnego zakupu
wybor <- c(
  klienci$klient[klienci$hurtowy == 0 & klienci$x >= 6 & klienci$x <= 10 & klienci$T > 50 & klienci$aktywny_52 & klienci$t_x > 45][1],
  klienci$klient[klienci$hurtowy == 0 & klienci$x == 3 & klienci$t_x < 20 & klienci$T > 50 & !klienci$aktywny_52][1],
  klienci$klient[klienci$hurtowy == 0 & klienci$x == 0 & klienci$T > 50][1])
osie <- klienci[match(wybor, klienci$klient), c("klient", "x", "t_x", "T", "x_test", "aktywny_52")]
osie$y <- 3:1
osie$t0 <- 52 - osie$T
osie
zak <- transakcje[transakcje$klient %in% wybor, ]
zak$tydz <- as.numeric(zak$data - start) / 7
zak$y <- osie$y[match(zak$klient, osie$klient)]
zak$okres <- ifelse(zak$tydz < 52, "rok 1 (kalibracja)", "rok 2 (sprawdzian)")
osie$etykieta <- sprintf("x = %d,  t_x = %.1f,  T = %.1f", osie$x, osie$t_x, osie$T)
osie$opis <- c("Klient A: kupuje często, ostatnio niedawno", "Klient B: 4 zakupy do wiosny, potem cisza",
               "Klient C: tylko pierwszy zakup")
pA <- ggplot() +
  annotate("rect", xmin = 52, xmax = 104, ymin = 0.45, ymax = 3.75, fill = "grey94") +
  annotate("text", x = 78, y = 3.68, label = "rok 2: tego model nie widzi (sprawdzian)", size = 3.4, colour = "grey35") +
  geom_segment(data = osie, aes(x = t0, xend = 104, y = y, yend = y), colour = "grey75", linewidth = 0.6) +
  geom_segment(data = osie[osie$x > 0, ], aes(x = t0, xend = t0 + t_x, y = y - 0.22, yend = y - 0.22), colour = kol[["niebieski"]],
               linewidth = 0.9, arrow = arrow(length = unit(0.12, "cm"), ends = "both")) +
  geom_segment(data = osie, aes(x = t0, xend = 52, y = y - 0.36, yend = y - 0.36), colour = kol[["pomarancz"]],
               linewidth = 0.9, arrow = arrow(length = unit(0.12, "cm"), ends = "both")) +
  geom_point(data = zak, aes(tydz, y, shape = okres, colour = okres), size = 3) +
  geom_text(data = osie, aes(x = t0, y = y + 0.25, label = opis), hjust = 0, size = 3.6, fontface = "bold", colour = "grey15") +
  geom_text(data = osie, aes(x = 53, y = y - 0.29, label = etykieta), hjust = 0, size = 3.3, colour = "grey20") +
  geom_vline(xintercept = 52, colour = "grey40", linetype = "dotted") +
  scale_shape_manual(values = c(16, 1), name = NULL) +
  scale_colour_manual(values = c(kol[["ciemny"]], kol[["szary"]]), name = NULL) +
  scale_x_continuous(breaks = seq(0, 104, 13), limits = c(0, 104)) + scale_y_continuous(limits = c(0.45, 3.75)) +
  labs(x = "Tydzień od 1 stycznia 2024 (niebieska strzałka: t_x, pomarańczowa: T)", y = NULL,
       title = "A. Z historii zakupów zostają trzy liczby: x, t_x i T") +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank())

# Schemat procesu: prostokąty i strzałki narysowane w ggplot2
pud <- data.frame(x = c(1, 3.6, 6.4, 9.1), y = c(1, 1, 1, 1), w = c(1.6, 2.2, 2.2, 1.9),
                  lab = c("Pierwszy\nzakup", "Kupuje we własnym\ntempie λ (losowo\nw czasie)",
                          "Po każdym kolejnym\nzakupie: „rzut monetą”\nz szansą p", "Odchodzi na zawsze\n(w danych tego\nnie widać)"),
                  typ = c("a", "a", "a", "b"))
pB <- ggplot() +
  geom_rect(data = pud, aes(xmin = x - w / 2, xmax = x + w / 2, ymin = y - 0.55, ymax = y + 0.55, fill = typ),
            colour = NA, alpha = 0.9) +
  geom_text(data = pud, aes(x, y, label = lab), size = 3.5, colour = "white", fontface = "bold", lineheight = 0.9) +
  annotate("segment", x = c(1.8, 4.7, 7.5), xend = c(2.5, 5.3, 8.15), y = 1, yend = 1,
           arrow = arrow(length = unit(0.25, "cm"), type = "closed"), colour = "grey25") +
  annotate("text", x = 7.83, y = 1.15, label = "p", size = 3.6, colour = "grey15", fontface = "italic") +
  annotate("curve", x = 6.4, xend = 3.6, y = 0.42, yend = 0.42, curvature = -0.35,
           arrow = arrow(length = unit(0.25, "cm"), type = "closed"), colour = "grey25") +
  annotate("text", x = 5, y = -0.22, label = "z szansą 1 − p zostaje i kupuje dalej", size = 3.5, colour = "grey15") +
  annotate("text", x = 5.2, y = 1.85, size = 3.4, colour = "grey30",
           label = "λ różni się między klientami (rozkład gamma: r, α), p też (rozkład beta: a, b)") +
  scale_fill_manual(values = c(a = kol[["niebieski"]], b = kol[["cynober"]]), guide = "none") +
  coord_cartesian(xlim = c(0, 10.2), ylim = c(-0.35, 2)) +
  labs(title = "B. Opowieść modelu BG/NBD") + theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
p1 <- pA / pB + plot_layout(heights = c(1.5, 1))
p1   # zapis: ggsave("bg-nbd-schemat-procesu.svg", p1, width = 10, height = 7.6)
Wynik w R
    klient x      t_x        T x_test aktywny_52 y        t0
208    208 7 49.28571 50.71429      3       TRUE 3 1.2857143
267    267 3 10.00000 50.85714      0      FALSE 2 1.1428571
23      23 0  0.00000 51.71429      3       TRUE 1 0.2857143
3. Log-wiarygodność BG/NBD, optim() i przedziały z hesjanu – Rysunek 2
R
# Przepis 3. BG/NBD napisany ręcznie: log-wiarygodność, optim(), przedziały z hesjanu (Rysunek 2)
# Korzysta z obiektów przepisu 1 (detal, kol, motyw, parametry prawdziwe).

# Log-wiarygodność jednego klienta (Fader i in., 2005), parametry na skali logarytmu (zawsze > 0)
ll_bgnbd <- function(lpar, x, t_x, T) {
  r <- exp(lpar[1]); alfa <- exp(lpar[2]); a <- exp(lpar[3]); b <- exp(lpar[4])
  wspolne <- lgamma(r + x) - lgamma(r) + r * log(alfa)
  A <- lbeta(a, b + x) - lbeta(a, b) - (r + x) * log(alfa + T)               # klient wciąż aktywny w T
  B <- ifelse(x > 0, lbeta(a + 1, pmax(b + x - 1, 1e-10)) - lbeta(a, b) - (r + x) * log(alfa + t_x), -Inf)  # odszedł po t_x
  wspolne + pmax(A, B) + log1p(exp(-abs(A - B)))                              # log(e^A + e^B) bez przepełnienia
}
dopasuj <- function(d) {
  ujemna <- function(lpar) -sum(ll_bgnbd(lpar, d$x, d$t_x, d$T))
  o <- optim(log(c(1, 10, 1, 1)), ujemna, method = "BFGS", hessian = TRUE, control = list(maxit = 500))
  se <- sqrt(diag(solve(o$hessian)))                                          # błędy standardowe log-parametrów
  tab <- data.frame(parametr = c("r", "alfa", "a", "b"), ocena = exp(o$par),
                    ci_dol = exp(o$par - 1.96 * se), ci_gora = exp(o$par + 1.96 * se))
  list(par = setNames(exp(o$par), tab$parametr), tab = tab, ll = -o$value, zbiezne = o$convergence == 0)
}
fit <- dopasuj(detal)
cbind(fit$tab[, 1:2], prawda = c(r_pr, alfa_pr, a_pr, b_pr), fit$tab[, 3:4])
c(logLik = fit$ll, zbiezne = fit$zbiezne)
# Co znaczą parametry: średnie tempo zakupów (na tydzień i na rok) i średnia szansa odejścia po zakupie
with(as.list(fit$par), round(c(lambda_tydz = r / alfa, zakupy_rok = 52 * r / alfa, p_srednie = a / (a + b)), 3))

# Rozkład liczby powtórnych zakupów: obserwowany vs oczekiwany z modelu (wzór na P(X(t) = x))
p_x <- function(xx, t, par) {
  r <- par[["r"]]; alfa <- par[["alfa"]]; a <- par[["a"]]; b <- par[["b"]]
  z <- t / (alfa + t)
  nbd <- function(j) exp(lgamma(r + j) - lgamma(r) - lgamma(j + 1) + r * log(1 - z) + j * log(z))
  sapply(xx, function(x) exp(lbeta(a, b + x) - lbeta(a, b)) * nbd(x) +
           if (x > 0) exp(lbeta(a + 1, b + x - 1) - lbeta(a, b)) * (1 - sum(nbd(0:(x - 1)))) else 0)
}
oczek <- rowSums(sapply(detal$T, function(t) { p <- p_x(0:9, t, fit$par); c(p, 1 - sum(p)) }))
roz <- data.frame(x = factor(rep(c(0:9, "10+"), 2), levels = c(0:9, "10+")),
                  zrodlo = rep(c("obserwowane", "oczekiwane z modelu"), each = 11),
                  n = c(as.vector(table(pmin(detal$x, 10))), oczek))
chi2 <- sum((roz$n[1:11] - roz$n[12:22])^2 / roz$n[12:22])
round(c(chi2 = chi2, df = 11 - 1 - 4, p = pchisq(chi2, 11 - 1 - 4, lower.tail = FALSE)), 3)

pA <- ggplot(roz, aes(x, n, fill = zrodlo)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  scale_fill_manual(values = c("obserwowane" = kol[["szary"]], "oczekiwane z modelu" = kol[["niebieski"]]), name = NULL) +
  labs(x = "Liczba powtórnych zakupów w roku 1 (x)", y = "Liczba klientów", title = "A. Model odtwarza rozkład x") + motyw
siatka <- rbind(
  data.frame(panel = "tempo zakupów λ (na tydzień)", v = seq(0.001, 0.4, length = 300)),
  data.frame(panel = "szansa odejścia po zakupie p", v = seq(0.002, 0.998, length = 300)))
gest <- function(par) ifelse(siatka$panel == "szansa odejścia po zakupie p", dbeta(siatka$v, par[3], par[4]),
                             dgamma(siatka$v, par[1], rate = par[2]))
gst <- rbind(data.frame(siatka, wersja = "prawdziwy (ukryty w danych)", g = gest(c(r_pr, alfa_pr, a_pr, b_pr))),
             data.frame(siatka, wersja = "oszacowany", g = gest(fit$par)))
pB <- ggplot(gst, aes(v, g, colour = wersja, linetype = wersja)) + geom_line(linewidth = 0.9) +
  facet_wrap(~panel, scales = "free") + coord_cartesian(ylim = c(0, NA)) +
  scale_y_continuous(limits = c(0, 12), oob = scales::squish) +
  scale_colour_manual(values = c("prawdziwy (ukryty w danych)" = kol[["szary"]], "oszacowany" = kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("prawdziwy (ukryty w danych)" = "solid", "oszacowany" = "22"), name = NULL) +
  labs(x = NULL, y = "Gęstość", title = "B. Różnice między klientami: rozkłady λ i p") + motyw
p2 <- pA / pB
p2   # zapis: ggsave("bg-nbd-dopasowanie.svg", p2, width = 10, height = 8)
Wynik w R
  parametr     ocena prawda    ci_dol   ci_gora
1        r 0.6555427    0.7 0.6025867 0.7131527
2     alfa 8.5208173    9.0 7.5720810 9.5884246
3        a 0.9054619    0.9 0.6380683 1.2849114
4        b 3.3191479    3.2 2.1442175 5.1378850
   logLik   zbiezne
-19253.29      1.00
lambda_tydz  zakupy_rok   p_srednie
      0.077       4.001       0.214
 chi2    df     p
3.704 6.000 0.717
4. P(aktywny): przykłady, mapa ciepła i kalibracja – Rysunek 3
R
# Przepis 4. P(klient aktywny) w funkcji recency i frequency: mapa ciepła i sprawdzenie z prawdą (Rysunek 3)
# Korzysta z obiektów przepisów 1 i 3 (detal, fit, kol, motyw).
p_aktywny <- function(x, t_x, T, par) {
  r <- par[["r"]]; alfa <- par[["alfa"]]; a <- par[["a"]]; b <- par[["b"]]
  1 / (1 + (x > 0) * a / (b + x - 1) * ((alfa + T) / (alfa + t_x))^(r + x))
}
detal$p_akt <- p_aktywny(detal$x, detal$t_x, detal$T, fit$par)

# Trzech klientów z tym samym T = 52 tygodnie i różną historią
przyklady <- data.frame(kto = c("4 zakupy, ostatni w tyg. 48", "4 zakupy, ostatni w tyg. 20",
                                "12 zakupów, ostatni w tyg. 30", "1 zakup (bez powtórnego)"),
                        x = c(3, 3, 11, 0), t_x = c(48, 20, 30, 0), T = 52)
przyklady$p_akt <- round(p_aktywny(przyklady$x, przyklady$t_x, przyklady$T, fit$par), 3)
przyklady$tyg_bez_zakupu <- przyklady$T - przyklady$t_x
przyklady

# Mapa ciepła: klient obserwowany 52 tygodnie, x = 0–14, tydzień ostatniego zakupu t_x = 0–52
siatka <- expand.grid(x = 0:14, t_x = seq(0, 52, by = 2))
siatka <- siatka[siatka$x > 0 | siatka$t_x == 0, ]      # bez powtórnego zakupu t_x = 0
siatka$p <- p_aktywny(siatka$x, siatka$t_x, 52, fit$par)
pA <- ggplot(siatka, aes(t_x, x, fill = p)) +
  geom_tile(width = 2, height = 1) +
  geom_contour(data = siatka[siatka$x > 0, ], aes(t_x, x, z = p), inherit.aes = FALSE,
               breaks = c(0.2, 0.5, 0.8), colour = "white", linewidth = 0.5) +
  geom_vline(xintercept = 52 - 180 / 7, colour = kol[["cynober"]], linetype = "22", linewidth = 0.9) +
  annotate("label", x = 52 - 180 / 7, y = 13.6, label = "reguła „180 dni”:\nna prawo = aktywny", size = 3.3,
           colour = kol[["cynober"]], fill = "white") +
  scale_fill_viridis_c(name = "P(aktywny)", limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  scale_x_continuous(breaks = seq(0, 52, 8)) + scale_y_continuous(breaks = seq(0, 14, 2)) +
  labs(x = "Tydzień ostatniego zakupu t_x (T = 52, później = bliżej końca roku)", y = "Powtórne zakupy x",
       title = "A. Im więcej zakupów, tym groźniejsza cisza") +
  motyw + theme(legend.key.width = unit(1.6, "cm"))

# Czy P(aktywny) jest skalibrowane? Prawda o odejściu jest znana tylko w symulacji
z_powt <- detal[detal$x > 0, ]
z_powt$przedzial <- cut(z_powt$p_akt, breaks = seq(0, 1, 0.1), include.lowest = TRUE)
kal <- aggregate(cbind(przewidziane = p_akt, prawda = aktywny_52) ~ przedzial, data = z_powt, FUN = mean)
kal$n <- as.vector(table(z_powt$przedzial)[as.character(kal$przedzial)])
nrow(z_powt)   # klienci z co najmniej jednym powtórnym zakupem
round(cbind(kal[, -1]), 3)
round(c(srednie_p_akt = mean(detal$p_akt), odsetek_aktywnych = mean(detal$aktywny_52),
        srednie_p_akt_x_wieksze_0 = mean(z_powt$p_akt), odsetek_aktywnych_x_wieksze_0 = mean(z_powt$aktywny_52)), 3)
pB <- ggplot(kal, aes(przewidziane, prawda)) +
  geom_abline(slope = 1, intercept = 0, colour = kol[["szary"]], linetype = "22") +
  geom_line(colour = kol[["niebieski"]], linewidth = 0.8) + geom_point(aes(size = n), colour = kol[["niebieski"]]) +
  scale_size_area(max_size = 6, name = "klientów") + coord_equal(xlim = c(0, 1), ylim = c(0, 1)) +
  labs(x = "Średnie P(aktywny) z modelu", y = "Odsetek naprawdę aktywnych", title = "B. Kalibracja (x > 0)") + motyw
p3 <- pA + pB + plot_layout(widths = c(1.7, 1))
p3   # zapis: ggsave("bg-nbd-mapa-p-aktywny.svg", p3, width = 10, height = 5.6)
Wynik w R
                            kto  x t_x  T p_akt tyg_bez_zakupu
1   4 zakupy, ostatni w tyg. 48  3  48 52 0.821              4
2   4 zakupy, ostatni w tyg. 20  3  20 52 0.273             32
3 12 zakupów, ostatni w tyg. 30 11  30 52 0.071             22
4      1 zakup (bez powtórnego)  0   0 52 1.000             52
[1] 1687
   przewidziane prawda   n
1         0.051  0.064  94
2         0.162  0.202 173
3         0.249  0.253 154
4         0.350  0.367 166
5         0.450  0.429 168
6         0.556  0.514 146
7         0.649  0.638 207
8         0.752  0.782 308
9         0.844  0.827 225
10        0.922  0.978  46
                srednie_p_akt             odsetek_aktywnych
                        0.666                         0.667
    srednie_p_akt_x_wieksze_0 odsetek_aktywnych_x_wieksze_0
                        0.524                         0.529
5. Prognoza na rok 2 i krzywa śledząca – Rysunek 4
R
# Przepis 5. Prognoza zakupów w roku 2 i porównanie z tym, co się stało (Rysunek 4)
# Korzysta z obiektów przepisów 1, 3 i 4 (detal, transakcje, fit, p_aktywny, kol, motyw, start, koniec_kal).

# Funkcja hipergeometryczna Gaussa 2F1(a, b; c; z) z szeregu (|z| < 1), wektorowo względem b, c i z
h2f1 <- function(a, b, c, z, maks = 5000) {
  n <- max(length(a), length(b), length(c), length(z))
  a <- rep_len(a, n); b <- rep_len(b, n); c <- rep_len(c, n); z <- rep_len(z, n)
  wyraz <- rep(1, n); suma <- rep(1, n)
  for (j in 0:(maks - 1)) {
    wyraz <- wyraz * (a + j) * (b + j) / ((c + j) * (j + 1)) * z
    suma <- suma + wyraz
    if (all(abs(wyraz) < 1e-12 * abs(suma))) break
  }
  suma
}
# Oczekiwana liczba zakupów w ciągu kolejnych t tygodni dla klienta z historią (x, t_x, T)
oczek_warunkowe <- function(t, x, t_x, T, par) {
  r <- par[["r"]]; alfa <- par[["alfa"]]; a <- par[["a"]]; b <- par[["b"]]
  (a + b + x - 1) / (a - 1) *
    (1 - ((alfa + T) / (alfa + T + t))^(r + x) * h2f1(r + x, b + x, a + b + x - 1, t / (alfa + T + t))) /
    (1 + (x > 0) * a / (b + x - 1) * ((alfa + T) / (alfa + t_x))^(r + x))
}
# Oczekiwana liczba powtórnych zakupów nowego klienta w ciągu t tygodni od pierwszego zakupu
oczek_nowy <- function(t, par) {
  r <- par[["r"]]; alfa <- par[["alfa"]]; a <- par[["a"]]; b <- par[["b"]]
  (a + b - 1) / (a - 1) * (1 - (alfa / (alfa + t))^r * h2f1(r, b, a + b - 1, t / (alfa + t)))
}
detal$prognoza <- oczek_warunkowe(52, detal$x, detal$t_x, detal$T, fit$par)
round(c(prognoza_suma = sum(detal$prognoza), obserwowane_suma = sum(detal$x_test),
        blad_proc = 100 * (sum(detal$prognoza) / sum(detal$x_test) - 1)), 1)

# Wykres kalibracji: średnia prognoza i średnia faktyczna liczba zakupów w roku 2 według x z roku 1
detal$grupa_x <- factor(pmin(detal$x, 7), levels = 0:7, labels = c(0:6, "7+"))
kalib <- aggregate(cbind(prognoza, x_test) ~ grupa_x, data = detal, FUN = mean)
kalib$n <- as.vector(table(detal$grupa_x))
kalib$sd <- tapply(detal$x_test, detal$grupa_x, sd)
kalib$dol <- kalib$x_test - 1.96 * kalib$sd / sqrt(kalib$n); kalib$gora <- kalib$x_test + 1.96 * kalib$sd / sqrt(kalib$n)
print(round(kalib[, -1], 2), row.names = kalib$grupa_x)

# Krzywa śledząca: skumulowana liczba powtórnych zakupów tydzień po tygodniu (model vs dane)
tydzien <- floor(as.numeric(transakcje$data - start) / 7)
pierwsze <- !duplicated(transakcje$klient)
det_tr <- transakcje$hurtowy == 0 & !pierwsze
obs_kum <- cumsum(tabulate(tydzien[det_tr] + 1, nbins = 104))
t0_det <- 52 - detal$T                                   # tydzień pierwszego zakupu (koniec_kal = tydzień 52)
mod_kum <- sapply(1:104, function(w) sum(oczek_nowy(pmax(w - t0_det, 0), fit$par)))
sled <- data.frame(tydzien = rep(1:104, 2), zrodlo = rep(c("dane", "model BG/NBD"), each = 104),
                   kum = c(obs_kum, mod_kum))
round(c(rok1_dane = obs_kum[52], rok1_model = mod_kum[52], rok2_dane = obs_kum[104] - obs_kum[52],
        rok2_model = mod_kum[104] - mod_kum[52]), 0)

pA <- ggplot(sled, aes(tydzien, kum, colour = zrodlo, linetype = zrodlo)) +
  annotate("rect", xmin = 52, xmax = 104, ymin = -Inf, ymax = Inf, fill = "grey93") +
  annotate("text", x = 26, y = max(sled$kum) * 0.97, label = "rok 1: kalibracja", size = 3.6, colour = "grey30") +
  annotate("text", x = 78, y = max(sled$kum) * 0.97, label = "rok 2: sprawdzian", size = 3.6, colour = "grey30") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = c("dane" = kol[["szary"]], "model BG/NBD" = kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("dane" = "solid", "model BG/NBD" = "22"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 104, 13)) +
  labs(x = "Tydzień od 1 stycznia 2024", y = "Powtórne zakupy (skumulowane)", title = "A. Cała baza klientów") + motyw
kal_dl <- rbind(data.frame(grupa_x = kalib$grupa_x, zrodlo = "faktycznie w roku 2", y = kalib$x_test, dol = kalib$dol, gora = kalib$gora),
                data.frame(grupa_x = kalib$grupa_x, zrodlo = "prognoza z modelu", y = kalib$prognoza, dol = NA, gora = NA))
pB <- ggplot(kal_dl, aes(grupa_x, y, colour = zrodlo, shape = zrodlo, group = zrodlo)) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0.15, na.rm = TRUE) +
  geom_line(linewidth = 0.7) + geom_point(size = 2.6) +
  scale_colour_manual(values = c("faktycznie w roku 2" = kol[["szary"]], "prognoza z modelu" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("faktycznie w roku 2" = 16, "prognoza z modelu" = 17), name = NULL) +
  labs(x = "Powtórne zakupy w roku 1 (x)", y = "Średnio zakupów w roku 2", title = "B. Kalibracja według x") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.2, 1))
p4   # zapis: ggsave("bg-nbd-prognoza-kalibracja.svg", p4, width = 10, height = 5.4)
Wynik w R
   prognoza_suma obserwowane_suma        blad_proc
          3132.0           3122.0              0.3
   prognoza x_test   n   sd  dol gora
0      0.54   0.53 713 0.84 0.47 0.59
1      0.61   0.68 663 1.19 0.59 0.77
2      0.99   1.05 364 1.63 0.89 1.22
3      1.52   1.41 194 2.30 1.08 1.73
4      2.12   1.82 146 2.33 1.44 2.20
5      2.52   2.16  91 3.31 1.48 2.85
6      3.16   2.98  58 2.99 2.21 3.75
7+     5.63   5.85 171 6.00 4.96 6.75
 rok1_dane rok1_model  rok2_dane rok2_model
      5123       5112       3122       3120
6. Reguła 180 dni kontra model – Rysunek 5
R
# Przepis 6. Model czy prosta reguła „brak zakupu przez 180 dni = klient utracony”? (Rysunek 5)
# Korzysta z obiektów przepisów 1–5 (detal z kolumnami p_akt i prognoza, kol, motyw).
detal$dni_bez_zakupu <- round((detal$T - detal$t_x) * 7)
detal$regula <- detal$dni_bez_zakupu <= 180                       # reguła: aktywny, jeśli kupił w ostatnich 180 dniach
n_wybranych <- sum(detal$regula)
detal$model_top <- rank(-detal$prognoza, ties.method = "first") <= n_wybranych   # tylu samych klientów z najwyższą prognozą
kupil <- detal$x_test > 0
auc <- function(wynik, y) { rr <- rank(wynik); n1 <- sum(y); (sum(rr[y]) - n1 * (n1 + 1) / 2) / (n1 * sum(!y)) }
ocena <- function(wybrani) c(wybranych = sum(wybrani),
                             trafnosc_wobec_prawdy_proc = 100 * mean(wybrani == detal$aktywny_52),
                             kupilo_w_roku2_proc = 100 * mean(kupil[wybrani]),
                             udzial_zakupow_roku2_proc = 100 * sum(detal$x_test[wybrani]) / sum(detal$x_test))
porown <- rbind(regula_180_dni = ocena(detal$regula), model_top_prognoza = ocena(detal$model_top),
                model_p_aktywny_0.5 = ocena(detal$p_akt > 0.5))
round(porown, 1)
round(c(auc_regula = auc(-detal$dni_bez_zakupu, kupil), auc_prognoza = auc(detal$prognoza, kupil),
        auc_p_aktywny = auc(detal$p_akt, kupil)), 3)
# Gdzie reguła i model się nie zgadzają
table(regula = detal$regula, model = detal$model_top)
niezgodni <- detal[detal$regula != detal$model_top, ]
round(aggregate(cbind(x, dni_bez_zakupu, prognoza, x_test, kupil = x_test > 0) ~ regula, data = niezgodni, FUN = mean), 2)

# Rysunek 5A: dni bez zakupu a P(aktywny) – ta sama cisza znaczy co innego przy różnej liczbie zakupów
krzywe <- expand.grid(dni = 0:364, x = c(1, 3, 8))
krzywe$p_akt <- p_aktywny(krzywe$x, 52 - krzywe$dni / 7, 52, fit$par)       # klient obserwowany 52 tygodnie
krzywe$czestosc <- factor(paste(krzywe$x, "powt."), levels = c("1 powt.", "3 powt.", "8 powt."),
                          labels = c("1 powtórny zakup", "3 powtórne", "8 powtórnych"))
round(xtabs(p_akt ~ dni + x, data = krzywe[krzywe$dni %in% c(30, 90, 180), ]), 3)
pA <- ggplot(krzywe, aes(dni, p_akt, colour = czestosc, linetype = czestosc)) +
  geom_vline(xintercept = 180, colour = kol[["cynober"]], linetype = "22", linewidth = 0.8) +
  geom_line(linewidth = 1) +
  annotate("text", x = 186, y = 0.96, label = "reguła: 180 dni", hjust = 0, colour = kol[["cynober"]], size = 3.5) +
  scale_colour_manual(values = c(kol[["blekit"]], kol[["niebieski"]], kol[["ciemny"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 360, 60)) + scale_y_continuous(limits = c(0, 1)) +
  labs(x = "Dni od ostatniego zakupu (klient obserwowany 52 tygodnie)", y = "P(aktywny) z modelu",
       title = "A. Ta sama cisza, różne szanse") + motyw
wyk <- data.frame(metoda = rep(c("reguła 180 dni", "model: top prognoza"), each = 2),
                  miara = rep(c("kupiło w roku 2\n(% wybranych)", "zakupy roku 2\n(% wszystkich)"), 2),
                  v = c(porown[1, 3:4], porown[2, 3:4]))
wyk$metoda <- factor(wyk$metoda, levels = c("reguła 180 dni", "model: top prognoza"))
pB <- ggplot(wyk, aes(miara, v, fill = metoda)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = sprintf("%.1f%%", v)), position = position_dodge(width = 0.75), vjust = -0.4, size = 3.4) +
  scale_fill_manual(values = c("reguła 180 dni" = kol[["cynober"]], "model: top prognoza" = kol[["niebieski"]]), name = NULL) +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 25)) +
  labs(x = NULL, y = "%", title = sprintf("B. Po %d wybranych klientów", n_wybranych)) + motyw
p5 <- pA + pB + plot_layout(widths = c(1.35, 1))
p5   # zapis: ggsave("bg-nbd-regula-180-dni.svg", p5, width = 10, height = 5.4)
Wynik w R
                    wybranych trafnosc_wobec_prawdy_proc kupilo_w_roku2_proc
regula_180_dni            992                       49.6                61.5
model_top_prognoza        992                       48.9                61.2
model_p_aktywny_0.5      1645                       80.5                51.9
                    udzial_zakupow_roku2_proc
regula_180_dni                           77.5
model_top_prognoza                       77.3
model_p_aktywny_0.5                      85.9
   auc_regula  auc_prognoza auc_p_aktywny
        0.676         0.713         0.602
       model
regula  FALSE TRUE
  FALSE  1352   56
  TRUE     56  936
  regula    x dni_bez_zakupu prognoza x_test kupil
1      0 2.48         190.62      0.9   0.66  0.32
2      1 2.89         165.00      0.7   0.82  0.38
     x
dni       1     3     8
  30  0.764 0.818 0.858
  90  0.712 0.710 0.591
  180 0.595 0.437 0.087
7. Klienci hurtowi i zmiana oferty – Rysunek 6
R
# Przepis 7. Dwie pułapki: klienci hurtowi w danych i zmiana oferty w roku 2 (Rysunek 6)
# Korzysta z obiektów przepisów 1–5 (klienci, detal, transakcje, dopasuj, p_aktywny, oczek_warunkowe, oczek_nowy...).

# (a) Model dopasowany do wszystkich 2420 klientów, razem z 20 hurtowymi
fit_wsz <- dopasuj(klienci)
round(cbind(tylko_detal = fit$par, z_hurtowymi = fit_wsz$par), 3)
prog_wsz <- oczek_warunkowe(52, detal$x, detal$t_x, detal$T, fit_wsz$par)
hurt <- klienci[klienci$hurtowy == 1, ]
prog_hurt <- oczek_warunkowe(52, hurt$x, hurt$t_x, hurt$T, fit_wsz$par)
round(c(detal_prognoza_model_detal = sum(detal$prognoza), detal_prognoza_model_z_hurtem = sum(prog_wsz),
        detal_faktycznie = sum(detal$x_test), hurt_prognoza = sum(prog_hurt), hurt_faktycznie = sum(hurt$x_test)), 0)
round(c(blad_detal_model_z_hurtem_proc = 100 * (sum(prog_wsz) / sum(detal$x_test) - 1),
        blad_hurt_proc = 100 * (sum(prog_hurt) / sum(hurt$x_test) - 1)), 1)
# Klienci z 1 powtórnym zakupem: przeciętna prognoza na rok 2 w obu modelach
round(c(model_detal = mean(detal$prognoza[detal$x == 1]), model_z_hurtem = mean(prog_wsz[detal$x == 1]),
        faktycznie = mean(detal$x_test[detal$x == 1])), 3)

# (b) Zmiana oferty: od 3 marca 2025 r. sklep wycofał zestawy prezentowe i podniósł próg darmowej dostawy.
# Symulujemy to, usuwając losowo 30% zakupów detalicznych po tej dacie (ręcznie ustalony scenariusz).
zmiana <- as.Date("2025-03-03")
set.seed(6722)
po_zm <- transakcje$hurtowy == 0 & transakcje$data >= zmiana
tr_zm <- transakcje[!(po_zm & runif(nrow(transakcje)) < 0.30), ]
x_test_zm <- as.vector(table(factor(tr_zm$klient[tr_zm$data >= koniec_kal & tr_zm$hurtowy == 0], levels = detal$klient)))
round(c(prognoza = sum(detal$prognoza), faktycznie_po_zmianie = sum(x_test_zm),
        blad_proc = 100 * (sum(detal$prognoza) / sum(x_test_zm) - 1)), 1)

# Rysunek 6A: tygodniowe powtórne zakupy w roku 2 – model vs dane bez zmiany i po zmianie oferty
tyg <- function(tr) {
  pierwsze <- !duplicated(tr$klient); w <- floor(as.numeric(tr$data - start) / 7)
  tabulate(w[tr$hurtowy == 0 & !pierwsze] + 1, nbins = 104)
}
mod_tyg <- diff(c(0, sapply(1:104, function(w) sum(oczek_nowy(pmax(w - t0_det, 0), fit$par)))))
tygodnie <- data.frame(tydzien = rep(53:104, 3),
                       wersja = rep(c("model (z roku 1)", "dane: oferta bez zmian", "dane: zmiana oferty"), each = 52),
                       n = c(mod_tyg[53:104], tyg(transakcje)[53:104], tyg(tr_zm)[53:104]))
tygodnie$wersja <- factor(tygodnie$wersja, levels = c("model (z roku 1)", "dane: oferta bez zmian", "dane: zmiana oferty"))
pA <- ggplot(tygodnie, aes(tydzien, n, colour = wersja, linetype = wersja)) +
  geom_vline(xintercept = as.numeric(zmiana - start) / 7, colour = "grey50", linetype = "dotted") +
  annotate("text", x = as.numeric(zmiana - start) / 7 + 1, y = 95, label = "zmiana oferty", hjust = 0, size = 3.4, colour = "grey30") +
  geom_line(linewidth = 0.8) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["szary"]], kol[["cynober"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "22"), name = NULL) +
  scale_y_continuous(limits = c(0, 100)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(x = "Tydzień od 1 stycznia 2024 (rok 2)", y = "Powtórne zakupy w tygodniu", title = "A. Zmiana oferty: model tego nie wie") + motyw
# Rysunek 6B: suma prognoz na rok 2 a faktyczne zakupy w czterech sytuacjach
sc <- data.frame(sytuacja = rep(c("detal\n(model bez\nhurtu)", "detal\n(model\nz hurtem)", "hurt\n(model\nz hurtem)", "detal\n(zmiana\noferty)"), 2),
                 co = rep(c("prognoza", "faktycznie"), each = 4),
                 n = c(sum(detal$prognoza), sum(prog_wsz), sum(prog_hurt), sum(detal$prognoza),
                       sum(detal$x_test), sum(detal$x_test), sum(hurt$x_test), sum(x_test_zm)))
sc$sytuacja <- factor(sc$sytuacja, levels = unique(sc$sytuacja))
sc$co <- factor(sc$co, levels = c("prognoza", "faktycznie"))
pB <- ggplot(sc, aes(sytuacja, n, fill = co)) +
  geom_col(position = position_dodge(width = 0.75), width = 0.7) +
  geom_text(aes(label = round(n)), position = position_dodge(width = 0.75), vjust = -0.4, size = 3.1) +
  scale_fill_manual(values = c("prognoza" = kol[["niebieski"]], "faktycznie" = kol[["szary"]]), name = NULL) +
  scale_y_continuous(limits = c(0, 3700)) +
  labs(x = NULL, y = "Powtórne zakupy w roku 2", title = "B. Prognoza a rzeczywistość") + motyw +
  theme(axis.text.x = element_text(size = rel(0.8)))
p6 <- pA + pB + plot_layout(widths = c(1.1, 1))
p6   # zapis: ggsave("bg-nbd-pulapki.svg", p6, width = 10, height = 5.4)
Wynik w R
     tylko_detal z_hurtowymi
r          0.656       0.589
alfa       8.521       6.859
a          0.905       0.600
b          3.319       2.097
   detal_prognoza_model_detal detal_prognoza_model_z_hurtem
                         3132                          3362
             detal_faktycznie                 hurt_prognoza
                         3122                           546
              hurt_faktycznie
                          839
blad_detal_model_z_hurtem_proc                 blad_hurt_proc
                           7.7                          -34.9
   model_detal model_z_hurtem     faktycznie
         0.606          0.589          0.679
             prognoza faktycznie_po_zmianie             blad_proc
               3132.0                2405.0                  30.2
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Przepis 8. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – szary (model / dane)" = c("#0072B2", "#999999"),
             "cynober – niebieski (reguła / model)" = c("#D55E00", "#0072B2"),
             "niebieski – pomarańczowy (t_x / T)" = c("#0072B2", "#E69F00"),
             "cynober – szary (zmiana oferty / bez zmian)" = c("#D55E00", "#999999"),
             "błękit – ciemny (1 / 8 powtórnych zakupów)" = c("#56B4E9", "#333333"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                            widzenie_typowe deuteranopia
niebieski – szary (model / dane)                       44.9         48.9
cynober – niebieski (reguła / model)                  114.6        108.3
niebieski – pomarańczowy (t_x / T)                    120.2        121.5
cynober – szary (zmiana oferty / bez zmian)            77.2         62.9
błękit – ciemny (1 / 8 powtórnych zakupów)             60.9         60.0
czerwony – zielony (do unikania)                      121.7         21.1
                                            protanopia
niebieski – szary (model / dane)                  40.6
cynober – niebieski (reguła / model)              91.9
niebieski – pomarańczowy (t_x / T)               109.3
cynober – szary (zmiana oferty / bez zmian)       56.0
błękit – ciemny (1 / 8 powtórnych zakupów)        60.7
czerwony – zielony (do unikania)                  31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, optim(), funkcje gamma i beta – pakiety base i stats). Rysunki wykonano w ggplot2 (mapa ciepła ze skalą viridis z pakietu viridisLite) i złożono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Liczenie pierwszego zakupu jako x. x to tylko zakupy powtórne; pomyłka przesuwa wszystkie parametry.
- Klienci z różnych lat w jednym modelu bez T. Każdy klient ma własny czas obserwacji – właśnie dlatego model potrzebuje T. Kohorty i sezonowość opisuje wpis o analizie kohortowej retencji.
- „P(aktywny) = 1”, więc klient jest pewny. Dla klienta bez powtórnego zakupu to założenie modelu, nie wiedza.
- Ocena modelu tylko w okresie kalibracji. Zawsze zostaw okres testowy.
- Hurt, konta firmowe i zmiana oferty w danych. Model nie odróżni ich od zwykłych klientów.
- Zbyt mała baza. Przy kilkuset klientach przedziały dla a i b są bardzo szerokie; liczbę zakupów w roku modelami zliczeń opisuje wpis liczba zakupów: zliczenia z zerami, a różnice między markami – prawo podwójnego zagrożenia.
Najczęstsze pytania
Co oznaczają x, t_x i T w modelu BG/NBD?
x to liczba powtórnych zakupów w okresie kalibracji (bez pierwszego), tx – czas od pierwszego do ostatniego zakupu, a T – czas od pierwszego zakupu do końca okresu. Model nie potrzebuje dat pośrednich zakupów (Fader i in., 2005). Najczęstszy błąd to liczenie pierwszego zakupu jako x.
Czym BG/NBD różni się od modelu Pareto/NBD?
Oba zakładają, że aktywny klient kupuje losowo we własnym tempie. W Pareto/NBD klient może odejść w dowolnej chwili, a w BG/NBD tylko zaraz po zakupie. Fader i in. (2005) pokazali, że oba modele dają bardzo podobne wyniki, a BG/NBD jest znacznie łatwiejszy w estymacji.
Dlaczego BG/NBD daje P(aktywny) = 1 klientom z jednym zakupem?
Bo w modelu klient może odejść tylko po powtórnym zakupie, więc ktoś, kto kupił raz, nie miał jeszcze okazji „odejść”. To założenie, nie wiedza: w przykładzie 713 takich klientów złożyło w następnym roku średnio tylko 0.53 zamówienia. Do wyboru klientów używaj oczekiwanej liczby zakupów, nie samego P(aktywny).
Czy model BG/NBD jest lepszy od reguły „brak zakupu przez 180 dni”?
Do wyboru klientów – często niewiele. W przykładzie po 992 wybranych klientów kupiło w roku 2 61.5% (reguła) i 61.2% (model). Model wygrywa w prognozie zakupów całej bazy, czego reguła nie daje; podobny wynik na prawdziwych danych opisali Wübben i von Wangenheim (2008).
Jak sprawdzić, czy prognoza BG/NBD jest trafna?
Podziel dane na okres kalibracji i okres testowy. Porównaj sumę prognoz z faktycznymi zakupami, narysuj krzywą skumulowanych zakupów tydzień po tygodniu i średnie zakupy w okresie testowym według x. W przykładzie model przewidział 3132 zakupy wobec 3122 faktycznych.
Powiązane hasła
Przeczytaj też
Wartość klienta w czasie (CLV)
Sklep z abonamentem na karmę: koncentracja marży, prosty wzór CLV, wrażliwość na retencję, model rezygnacji i bootstrap – pięć rysunków z kodem R.
Czytaj →PoradnikChurn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikAnaliza kohortowa retencji klientów
Sklep z karmą, 30 kohort i 18 tys. transakcji: tabela kohortowa, mapa ciepła, krzywe z przedziałami i pułapki oceny programu lojalnościowego – pięć rysunków z kodem R.
Czytaj →PoradnikSegmentacja RFM: kwintyle czy model
125 komórek RFM, wynik sumaryczny i regresja ujemna dwumianowa ocenione na kolejnym półroczu – gain, lift, kalibracja i kod R.
Czytaj →Analizujesz zakupy klientów w pracy z marketingu?
Pomożemy przygotować dane transakcyjne, dopasować model BG/NBD, sprawdzić prognozę na okresie testowym i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Fader, P. S., Hardie, B. G. S., & Lee, K. L. (2005). “Counting your customers” the easy way: An alternative to the Pareto/NBD model. Marketing Science, 24(2), 275–284. https://doi.org/10.1287/mksc.1040.0098 ● Otwarty dostęp: pełny tekst
- Gupta, S., Hanssens, D., Hardie, B., Kahn, W., Kumar, V., Lin, N., Ravishanker, N., & Sriram, S. (2006). Modeling customer lifetime value. Journal of Service Research, 9(2), 139–155. https://doi.org/10.1177/1094670506293810
- Reinartz, W. J., & Kumar, V. (2000). On the profitability of long-life customers in a noncontractual setting: An empirical investigation and implications for marketing. Journal of Marketing, 64(4), 17–35. https://doi.org/10.1509/jmkg.64.4.17.18077
- Schmittlein, D. C., Morrison, D. G., & Colombo, R. (1987). Counting your customers: Who are they and what will they do next? Management Science, 33(1), 1–24. https://doi.org/10.1287/mnsc.33.1.1
- Wübben, M., & von Wangenheim, F. (2008). Instant customer base analysis: Managerial heuristics often “get it right”. Journal of Marketing, 72(3), 82–93. https://doi.org/10.1509/jmkg.72.3.082 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{fader2005counting, author={Fader, Peter S. and Hardie, Bruce G. S. and Lee, Ka Lok}, title={{“Counting your customers” the easy way: An alternative to the Pareto/NBD model}}, journal={Marketing Science}, year={2005}, volume={24}, number={2}, pages={275--284}, doi={10.1287/mksc.1040.0098}}@article{gupta2006modeling, author={Gupta, Sunil and Hanssens, Dominique and Hardie, Bruce and Kahn, Wiliam and Kumar, V. and Lin, Nathaniel and Ravishanker, Nalini and Sriram, S.}, title={{Modeling customer lifetime value}}, journal={Journal of Service Research}, year={2006}, volume={9}, number={2}, pages={139--155}, doi={10.1177/1094670506293810}}@article{reinartz2000profitability, author={Reinartz, Werner J. and Kumar, V.}, title={{On the profitability of long-life customers in a noncontractual setting: An empirical investigation and implications for marketing}}, journal={Journal of Marketing}, year={2000}, volume={64}, number={4}, pages={17--35}, doi={10.1509/jmkg.64.4.17.18077}}@article{schmittlein1987counting, author={Schmittlein, David C. and Morrison, Donald G. and Colombo, Richard}, title={{Counting your customers: Who are they and what will they do next?}}, journal={Management Science}, year={1987}, volume={33}, number={1}, pages={1--24}, doi={10.1287/mnsc.33.1.1}}@article{wubben2008instant, author={W{\"u}bben, Markus and von Wangenheim, Florian}, title={{Instant customer base analysis: Managerial heuristics often “get it right”}}, journal={Journal of Marketing}, year={2008}, volume={72}, number={3}, pages={82--93}, doi={10.1509/jmkg.72.3.082}}