Przykład: sklep z akcesoriami kuchennymi i pytanie „komu wysłać katalog?”
Fikcyjny sklep internetowy z akcesoriami kuchennymi (noże, formy, przybory) ma dwa lata historii transakcji. Raz na pół roku wysyła drogi, drukowany katalog z rabatem – tylko do 20% klientów, którzy w kolejnym półroczu kupią najwięcej. Jak ich wskazać?
Klasyczna odpowiedź to RFM: R (recency) – dni od ostatniego zakupu, F (frequency) – liczba zakupów w ostatnim roku, M (monetary) – wydatki w tym roku w zł. Fader i in. (2005) łączą te trzy liczby z przewidywaną wartością klienta w czasie (CLV). Pytanie brzmi: pociąć je na kwintyle i komórki czy wstawić do modelu?
Nie grupujemy tu klientów (to robi wpis analiza skupień w marketingu) ani nie modelujemy odchodzenia klientów (model BG/NBD). Porównujemy trzy proste reguły wyboru.
Dane są fikcyjne i wiemy, jak powstały. Ręcznie ustaliliśmy tempo zakupów (gamma, średnio jeden zakup na 120 dni), czas aktywności klienta (wykładniczy, średnio 500 dni) i wartość zamówienia (log-normalna, średnio ok. 140 zł; pełna lista przy kodzie). Wartość koszyka celowo nie zależy od tempa zakupów. Ziarna 728 ani parametrów danych nie zmienialiśmy po pierwszym uruchomieniu. Wśród klientów z zakupem w roku 1 (11 812 osób) 42.7% kupiło tylko raz, mediana R to 111 dni, a mediana M – 256 zł. W kolejnym półroczu (półrocze 3) 61.9% z nich nie kupiło nic. Dane pobierzesz jako segmentacja-rfm-sklep-kuchenny.csv (wiersz = klient w jednym z dwóch momentów).
Walidacja w czasie. Reguły budujemy na stanie z końca roku 1 i zakupach w półroczu 3, a oceniamy pół roku później: na 12 221 klientach z zakupem w ostatnim roku i ich zakupach w półroczu 4. Losowy podział jednego zbioru zawyża trafność (Roberts i in., 2017; zob. przeciek danych i walidacja w czasie).
Rysunek 1: 125 komórek RFM
Każdą liczbę dzielisz na kwintyle (5 = najświeższy zakup, najwięcej zakupów, najwyższe wydatki). Kod klienta, np. 5-5-5, to jedna ze 125 komórek, a prognoza – średnia liczba zakupów komórki w zbiorze uczącym. Prostsza wersja to wynik sumaryczny R + F + M (3–15).
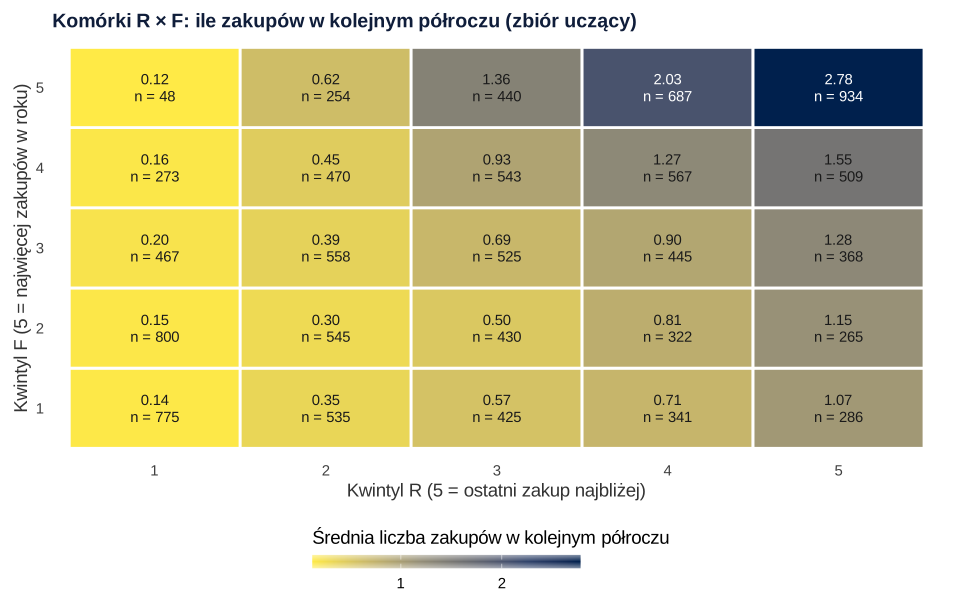
set.seed(728)).Co widać. Liczba zakupów rośnie z obiema liczbami: od 0.12 w komórce R1 × F5 (ostatni zakup dawno, choć kupowali często) do 2.78 w R5 × F5. Na R przypada większa część różnic. Ale tylko 113 ze 125 komórek R × F × M ma choćby jednego klienta, 34 komórki mają mniej niż 30 klientów, a mediana liczebności to 94.
Jak może zmylić. Mapa uśrednia po M, więc ukrywa małe komórki. A kwintyl F jest sztuczny: 5042 klientów z jednym zakupem trafiło do kwintyli 1, 2 i 3 tylko według kolejności numerów. W następnym półroczu kupili średnio 0.459, 0.453 i 0.469 razy – tak samo.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: kwintyle a model zliczeń ze splajnami
Liczba zakupów to zliczenie z wieloma zerami i długim ogonem. Zamiast komórek dopasowujemy więc regresję ujemną dwumianową (NB), która dopuszcza nadmierną dyspersję (Gardner i in., 1995). R, log F i log M wchodzą jako splajny naturalne, więc zależność może być krzywa:
Y to liczba zakupów w kolejnym półroczu, s – splajny, θ – parametr rozproszenia. Wyszło θ = 0.97 (SE = 0.04), więc regresja Poissona pasuje wyraźnie gorzej (AIC 29 896.8 wobec 27 436.5). Model ma 12 parametrów; model z czynnikiem „komórka” – 114 i AIC 27 685.7, z wynikiem sumarycznym – 28 179.7. Inne modele zliczeń pokazuje wpis liczba zakupów: zliczenia z zerami.
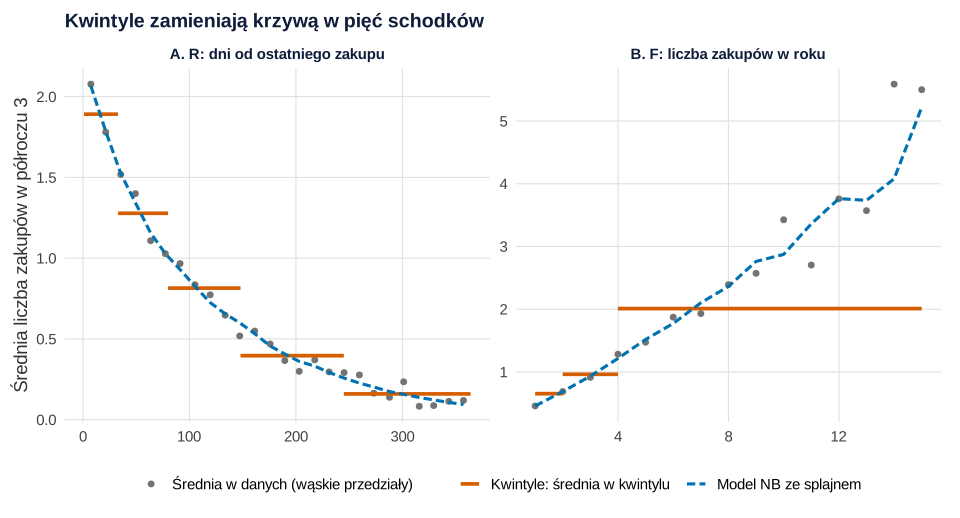
Co widać. Średnie w wąskich przedziałach (punkty) tworzą gładką krzywą i model (linia przerywana) idzie razem z nimi. Kwintyle robią z niej pięć schodków. Najwięcej traci kwintyl F 5: jedna średnia 2.01 dla klientów z 4 zakupami (w danych 1.28) i z 15 lub więcej (5.50). To wada podziału na kwantyle (Bennette i Vickers, 2012) i każdej kategoryzacji zmiennej ciągłej (Royston i in., 2006; zob. dychotomizacja zmiennych ciągłych).
Jak może zmylić. Punkty i linia to średnie w tych samych grupach, więc zgodność wygląda lepiej niż w nowych danych. Kształt splajnu zależy od liczby węzłów (Perperoglou i in., 2019) – ustal ją przed oceną. M nic nie dodało: χ²(3) = 1.36, p = .714 – tak zbudowaliśmy dane; w swoich sprawdź to testem.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: walidacja w czasie – gain i lift dla górnych 20%
Rozstrzyga test pół roku później: każda reguła porządkuje 12 221 klientów od najwyższej prognozy, a my liczymy, jaki odsetek zakupów półrocza 4 przypada na wybrane 20%. To wykres gain; lift to ten odsetek podzielony przez 20% (Vuk i Curk, 2006). Remisy rozstrzygamy losowo.
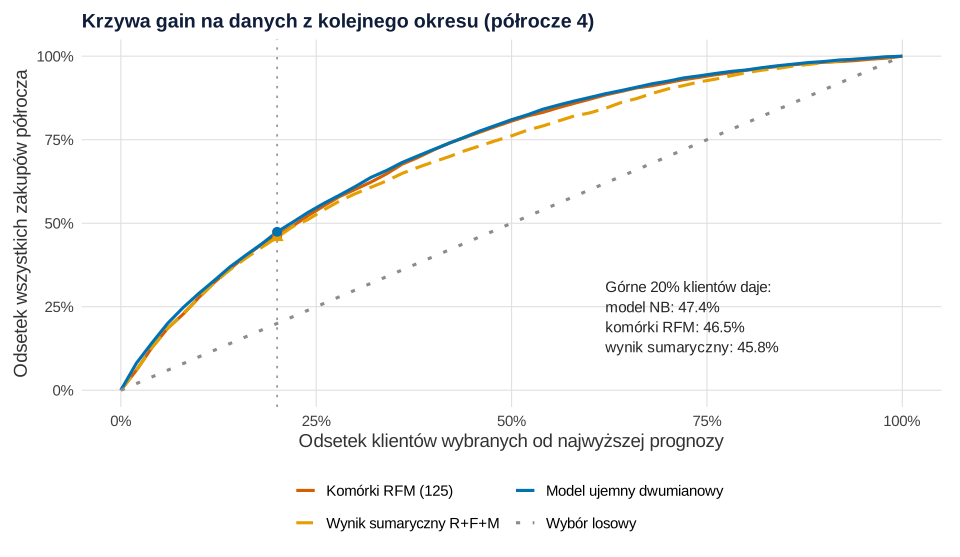
Co widać. Trzy reguły są daleko nad wyborem losowym i blisko siebie. Górne 20% według modelu daje 47.4% zakupów (lift 2.37), według komórek – 46.5% (2.32), według wyniku sumarycznego – 45.8% (2.29). Bootstrap klientów (1000 powtórzeń) daje przewagę modelu nad komórkami 95% CI [0.1, 1.6] pp, a nad wynikiem sumarycznym [0.7, 2.4] pp. W górnych 5% różnica jest większa: 17.1% wobec 15.9% zakupów, CI [0.3, 2.1].
Jak może zmylić. Gain ocenia tylko kolejność klientów, nie trafność liczby zakupów. Nie mówi też, czy katalog zmieni zakupy.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: kalibracja – czy liczba zakupów się zgadza
Do budżetu potrzebna jest liczba zakupów, nie tylko kolejność. To pytanie o kalibrację. Dzielimy klientów na decyle prognozy i porównujemy średnią przewidywaną z obserwowaną w półroczu 4.
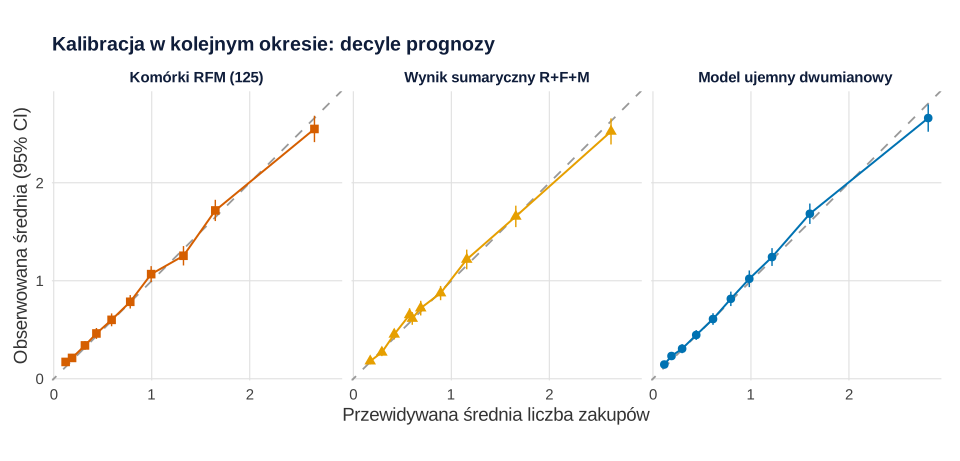
Co widać. Wszystkie trzy reguły leżą blisko przekątnej. Suma prognoz komórek i modelu to 11 075 zakupów wobec 11 202 obserwowanych (1.1% za mało). W górnym decylu model przeszacowuje: 2.81 wobec 2.66, komórki – 2.66 wobec 2.55. Średni błąd bezwzględny na klienta (MAE) to 0.922 dla modelu, 0.935 dla komórek i 0.969 dla wyniku sumarycznego.
Jak może zmylić. Półrocze 4 przypomina tu półrocze 3. W prawdziwym sklepie sezon przesunie wszystkie reguły – porównuj te same półrocza rok do roku.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: niestabilne komórki
Średnia z 10 klientów to głównie przypadek. Porównujemy prognozę każdej komórki z tym, ile pół roku później kupili klienci tej samej komórki.
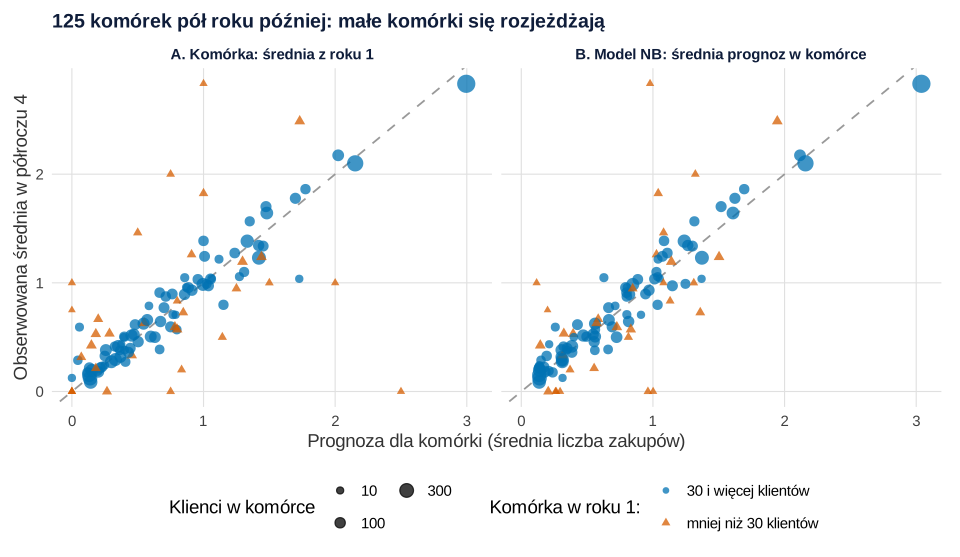
Co widać. Duże komórki (30 i więcej klientów) trzymają się przekątnej: średni błąd komórki 0.114 zakupu, modelu – 0.112. W 33 małych komórkach (443 klientów w teście) błąd komórki to 0.516, a modelu – 0.383: skrajne średnie wracają do środka (regresja do średniej). Dziewięciu klientów trafiło do komórek pustych w roku 1 i dostało średnią całej bazy.
Jak może zmylić. Ważony liczbą klientów błąd jest prawie równy (0.104 i 0.103), bo w małych komórkach jest mało ludzi. Kłopot zaczyna się, gdy ktoś wybiera „najlepsze komórki” z rankingu średnich – na górę trafiają małe komórki.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 6: karta „komórka RFM 5-5-5”
Komórka 5-5-5 to „najlepsi klienci”. Karta pokazuje, co komórka mówi, a czego nie.
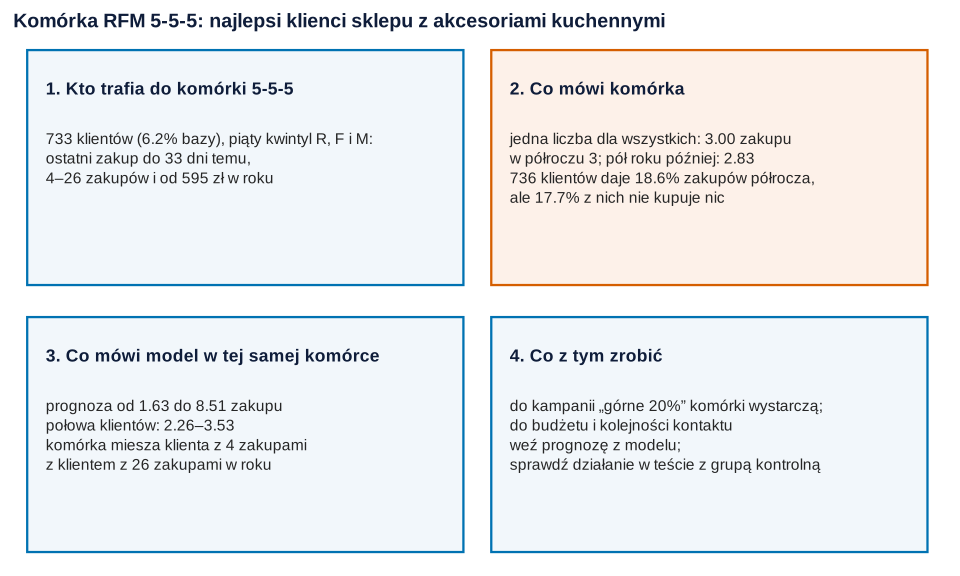
Co widać. 733 klientów (6.2% bazy) z zakupem w ostatnich 33 dniach, 4–26 zakupami i wydatkami od 595 zł dostaje jedną prognozę: 3.00 zakupu. Pół roku później klienci komórki kupili średnio 2.83 razy i zrobili 18.6% wszystkich zakupów, ale 17.7% z nich nic. Model daje im prognozy od 1.63 do 8.51.
Jak może zmylić. Karta wygląda jak „persona”, ale to tylko przedziały trzech liczb – nie mówi, dlaczego klienci kupują.
Podpis do pracy:
Zdanie do Wyników:
Co z tym zrobić w marketingu
- Do prostego wyboru „górne 20%” RFM wystarczy. Listy z komórek i z modelu pokrywają się w 89.6%, a różnica w zakupach to ok. 1 pp. Wübben i von Wangenheim (2008) też pokazali, że proste reguły menedżerskie często dorównują modelom. Zaleta RFM: każdy w firmie rozumie „5-5-5”.
- Do budżetu, kolejności kontaktu i wąskich kampanii (górne 5%) weź model. Daje ciągłą prognozę i nie miesza klienta z 4 i z 26 zakupami.
- Łącz komórki o mniej niż 30 klientach albo używaj wyniku sumarycznego.
- Sprawdzaj regułę na kolejnym okresie, nie na tym samym.
- Ranking to nie efekt kampanii. Czy katalog zwiększa zakupy, sprawdzisz tylko w teście z grupą wyłączoną – część klientów z górnych 20% losowo bez katalogu.
- Wartość klienta to więcej niż liczba zakupów. Do decyzji o kosztach połącz prognozę zakupów z wartością koszyka (wartość klienta CLV); dokąd odchodzą klienci, pokazuje wpis o przechodzeniu między markami.
Jak opisać w pracy
Napisz, jak zdefiniowano R, F i M, moment prognozy, okno wyniku i sposób oceny w czasie. Ogólne wskazówki: statystyka w pracy z marketingu.
| Reguła | Górne 5%: % zakupów | Górne 20%: % zakupów [95% CI] | Lift 20% | MAE | Parametry |
|---|---|---|---|---|---|
| Komórki RFM (125) | 15.9 | 46.5 [45.0, 48.0] | 2.32 | 0.935 | 114 |
| Wynik sumaryczny R+F+M | 15.9 | 45.8 [44.4, 47.3] | 2.29 | 0.969 | 14 |
| Model ujemny dwumianowy | 17.1 | 47.4 [45.9, 48.8] | 2.37 | 0.922 | 12 |
Kod R: komórki RFM, model ujemny dwumianowy i walidacja w czasie
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(728)) i 4 (set.seed(7281) – kolejność remisów, set.seed(7282) – bootstrap, 1000 powtórzeń); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 30 000 klientów pozyskanych od dnia −1100 do dnia 546, tempo zakupów z rozkładu gamma (kształt 1.2, średnio 1/120 zakupu dziennie), czas aktywności wykładniczy (średnio 500 dni), wartość zamówienia log-normalną (średnia klienta ok. 140 zł, rozrzut 0.35 między klientami i 0.45 między zamówieniami), okno historii 364 dni i okno wyniku 182 dni. Parametrów danych nie zmieniano po pierwszym uruchomieniu. Zmieniono tylko analizę i rysunki: węzły splajnu log F ustawiono ręcznie przy 2 i 4 zakupach (przy domyślnych węzłach R ostrzegał o remisach), dodano wynik dla górnych 5%, a w rysunku 2 linię modelu liczymy jako średnią prognoz w tych samych grupach co punkty. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się ok. 10 sekund.
1. Dane: dwa lata transakcji i RFM w dwóch momentach
R
# Przepis 1. Fikcyjny sklep internetowy z akcesoriami kuchennymi: dwa lata transakcji i RFM w dwóch momentach
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c("Komórki RFM (125)" = "#D55E00", "Wynik sumaryczny R+F+M" = "#E69F00",
         "Model ujemny dwumianowy" = "#0072B2", "Wybór losowy" = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)              # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (czas w dniach; dzień 0 = początek danych, dane kończą się w dniu 728)
n_klientow <- 30000                                  # wszyscy klienci, także pozyskani przed początkiem danych
pozyskanie <- c(-1100, 546)                          # dzień pierwszego zakupu: równomiernie w tym zakresie
tempo_ksztalt <- 1.2; tempo_srednie <- 1 / 120        # tempo zakupów aktywnego klienta: gamma, średnio co 120 dni
staz_sredni <- 500                                   # czas aktywności po pierwszym zakupie: wykładniczy, średnio 500 dni
koszyk_klienta <- c(log(140), 0.35)                  # średnia wartość zamówienia klienta (zł): log-normalny
koszyk_zmiennosc <- 0.45                             # rozrzut wartości kolejnych zamówień tego samego klienta

set.seed(728)
a <- runif(n_klientow, pozyskanie[1], pozyskanie[2])
lambda <- rgamma(n_klientow, shape = tempo_ksztalt, rate = tempo_ksztalt / tempo_srednie)
koniec <- a + rexp(n_klientow, 1 / staz_sredni)
mu <- rlnorm(n_klientow, koszyk_klienta[1], koszyk_klienta[2])
k <- rpois(n_klientow, lambda * (pmin(koniec, 728) - a))   # kolejne zakupy w okresie aktywności
transakcje <- data.frame(id = c(seq_len(n_klientow), rep(seq_len(n_klientow), k)),
                         dzien = c(a, a[rep(seq_len(n_klientow), k)] +
                                      runif(sum(k)) * (pmin(koniec, 728) - a)[rep(seq_len(n_klientow), k)]))
transakcje$wartosc <- round(rlnorm(nrow(transakcje), log(mu[transakcje$id]) - koszyk_zmiennosc^2 / 2, koszyk_zmiennosc), 2)
transakcje <- transakcje[transakcje$dzien >= 0 & transakcje$dzien < 728, ]   # widzimy tylko dwa lata

# RFM na moment c: klienci z zakupem w 364 dniach przed c; wynik = liczba zakupów w 182 dniach po c
rfm_na_moment <- function(tr, c) {
  hist <- tr[tr$dzien >= c - 364 & tr$dzien < c, ]
  nast <- tr[tr$dzien >= c & tr$dzien < c + 182, ]
  d <- data.frame(id = sort(unique(hist$id)))
  d$R <- ceiling(c - tapply(hist$dzien, hist$id, max)[as.character(d$id)])   # dni od ostatniego zakupu
  d$F <- as.vector(table(hist$id)[as.character(d$id)])                        # liczba zakupów w roku
  d$M <- round(as.vector(tapply(hist$wartosc, hist$id, sum)[as.character(d$id)]))  # wydatki w roku (zł)
  y <- table(factor(nast$id, levels = d$id))
  d$zakupy_nast <- as.vector(y)                                               # zakupy w kolejnym półroczu
  d
}
ucz <- rfm_na_moment(transakcje, 364)                # moment 1: koniec roku 1, wynik w półroczu 3
test <- rfm_na_moment(transakcje, 546)               # moment 2: pół roku później, wynik w półroczu 4
ucz$moment <- "koniec roku 1"; test$moment <- "pół roku później"
write.csv(rbind(ucz, test), "segmentacja-rfm-sklep-kuchenny.csv", row.names = FALSE, fileEncoding = "UTF-8")

opis <- function(d) c(klienci = nrow(d), R_mediana = median(d$R), F_mediana = median(d$F), F_1_proc = round(100 * mean(d$F == 1), 1),
                      M_mediana = median(d$M), zakupy_srednia = round(mean(d$zakupy_nast), 3),
                      bez_zakupu_proc = round(100 * mean(d$zakupy_nast == 0), 1), zakupy_suma = sum(d$zakupy_nast))
rbind(uczenie = opis(ucz), test = opis(test))
c(transakcje_w_2_latach = nrow(transakcje), klienci_w_obu_momentach = length(intersect(ucz$id, test$id)))
Wynik w R
        klienci R_mediana F_mediana F_1_proc M_mediana zakupy_srednia bez_zakupu_proc zakupy_suma
uczenie   11812       111         2     42.7       256          0.908            61.9       10724
test      12221       113         2     42.6       256          0.917            61.4       11202
  transakcje_w_2_latach klienci_w_obu_momentach
                  60585                    8531
2. Kwintyle, 125 komórek i wynik sumaryczny: Rysunek 1
R
# Przepis 2. Klasyczne RFM: kwintyle R, F, M, 125 komórek i wynik sumaryczny; Rysunek 1
# Korzysta z ucz i test (przepis 1).
kwintyl <- function(x) ceiling(5 * rank(x, ties.method = "first") / length(x))  # remisy: w kolejności numerów klientów
dodaj_rfm <- function(d) {
  d$r5 <- 6 - kwintyl(d$R)                           # 5 = najświeższy zakup
  d$f5 <- kwintyl(d$F); d$m5 <- kwintyl(d$M)          # 5 = najwięcej zakupów / najwyższe wydatki
  d$komorka <- paste(d$r5, d$f5, d$m5, sep = "-")
  d$suma <- d$r5 + d$f5 + d$m5                        # wynik sumaryczny 3–15
  d
}
ucz <- dodaj_rfm(ucz); test <- dodaj_rfm(test)

# Prognoza z komórek: średnia liczba zakupów komórki w półroczu 3 (zbiór uczący)
sr_komorki <- tapply(ucz$zakupy_nast, ucz$komorka, mean)
n_komorki <- table(ucz$komorka)
sr_sumy <- tapply(ucz$zakupy_nast, ucz$suma, mean)
c(komorki_niepuste = length(sr_komorki), komorki_ponizej_30 = sum(n_komorki < 30), komorki_ponizej_10 = sum(n_komorki < 10),
  klienci_w_komorkach_ponizej_30 = sum(n_komorki[n_komorki < 30]), mediana_liczebnosci = median(n_komorki))
round(range(sr_komorki), 2)                          # najmniejsza i największa średnia komórki

# Ile informacji zostaje w kwintylu F: jak klienci z jednym zakupem rozkładają się na kwintyle F
table(F_rowne_1_kwintyl = ucz$f5[ucz$F == 1])
do.call(rbind, tapply(ucz$F, ucz$f5, range))       # zakres F (min, max) w każdym kwintylu
round(sr_sumy, 2)                                    # średnia zakupów wg wyniku sumarycznego

# Rysunek 1: mapa R × F (średnia po M) – średnia liczba zakupów w półroczu 3 i liczba klientów
rf <- aggregate(zakupy_nast ~ r5 + f5, data = ucz, FUN = function(v) c(sr = mean(v), n = length(v)))
rf <- data.frame(r5 = rf$r5, f5 = rf$f5, sr = rf$zakupy_nast[, "sr"], n = rf$zakupy_nast[, "n"])
p1 <- ggplot(rf, aes(factor(r5), factor(f5), fill = sr)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = sprintf("%.2f\nn = %d", sr, n), colour = sr > 1.6), size = 3.9, lineheight = 0.95) +
  scale_colour_manual(values = c("TRUE" = "white", "FALSE" = "grey10"), guide = "none") +
  scale_fill_viridis_c(option = "cividis", name = "Średnia liczba zakupów w kolejnym półroczu", direction = -1,
                       guide = guide_colourbar(barwidth = 14, barheight = 0.7, title.position = "top")) +
  labs(title = "Komórki R × F: ile zakupów w kolejnym półroczu (zbiór uczący)",
       x = "Kwintyl R (5 = ostatni zakup najbliżej)", y = "Kwintyl F (5 = najwięcej zakupów w roku)") +
  motyw + theme(panel.grid.major = element_blank())
p1   # zapis: ggsave("segmentacja-rfm-mapa-komorek.svg", p1, width = 10, height = 6.4)
Wynik w R
              komorki_niepuste             komorki_ponizej_30             komorki_ponizej_10
                           113                             34                             16
klienci_w_komorkach_ponizej_30            mediana_liczebnosci
                           389                             94
[1] 0 3
F_rowne_1_kwintyl
   1    2    3
2362 2362  318
  [,1] [,2]
1    1    1
2    1    1
3    1    2
4    2    4
5    4   26
   3    4    5    6    7    8    9   10   11   12   13   14   15
0.14 0.19 0.29 0.40 0.59 0.57 0.65 0.74 0.97 1.17 1.49 2.08 3.00
3. Regresja ujemna dwumianowa ze splajnami: Rysunek 2
R
# Przepis 3. Model zliczeń: regresja ujemna dwumianowa ze splajnami R, F, M; Rysunek 2
# Korzysta z ucz (przepisy 1–2).
library(MASS); library(splines)
# Splajny naturalne: R – 4 stopnie swobody; log F – węzły przy 2 i 4 zakupach (F ma wiele remisów); log M – 3 stopnie
m_nb <- glm.nb(zakupy_nast ~ ns(R, df = 4) + ns(log(F), knots = log(c(2, 4))) + ns(log(M), df = 3), data = ucz)
m_po <- glm(zakupy_nast ~ ns(R, df = 4) + ns(log(F), knots = log(c(2, 4))) + ns(log(M), df = 3), family = poisson, data = ucz)
m_bez_M <- glm.nb(zakupy_nast ~ ns(R, df = 4) + ns(log(F), knots = log(c(2, 4))), data = ucz)
m_komorki <- glm.nb(zakupy_nast ~ factor(komorka), data = ucz)        # 125 komórek jako czynnik
m_suma <- glm.nb(zakupy_nast ~ factor(suma), data = ucz)              # 13 poziomów wyniku sumarycznego
c(theta = round(m_nb$theta, 2), theta_SE = round(m_nb$SE.theta, 2))
data.frame(model = c("NB, splajny R, F, M", "Poisson, te same splajny", "NB, splajny R, F (bez M)",
                     "NB, 125 komórek", "NB, wynik sumaryczny"),
           parametry = c(length(coef(m_nb)) + 1, length(coef(m_po)), length(coef(m_bez_M)) + 1,
                         length(coef(m_komorki)) + 1, length(coef(m_suma)) + 1),
           AIC = round(c(AIC(m_nb), AIC(m_po), AIC(m_bez_M), AIC(m_komorki), AIC(m_suma)), 1))
anova(m_bez_M, m_nb)                                  # test ilorazu wiarygodności: czy M coś dodaje?

# Rysunek 2: średnia liczba zakupów wg R i F – dane, kwintyle i prognoza modelu (średnia prognoz w tej samej grupie)
ucz$p_nb <- fitted(m_nb)
przedz_R <- cut(ucz$R, seq(0, 364, 14))                # przedziały R po 14 dni
F15 <- pmin(ucz$F, 15)                                 # F: 15 i więcej razem
punkty <- rbind(
  data.frame(zm = "A. R: dni od ostatniego zakupu", x = tapply(ucz$R, przedz_R, mean), y = tapply(ucz$zakupy_nast, przedz_R, mean),
             model = tapply(ucz$p_nb, przedz_R, mean)),
  data.frame(zm = "B. F: liczba zakupów w roku", x = 1:15, y = as.vector(tapply(ucz$zakupy_nast, F15, mean)),
             model = as.vector(tapply(ucz$p_nb, F15, mean))))
schodki <- rbind(
  data.frame(zm = "A. R: dni od ostatniego zakupu", x0 = tapply(ucz$R, ucz$r5, min), x1 = tapply(ucz$R, ucz$r5, max),
             y = tapply(ucz$zakupy_nast, ucz$r5, mean)),
  data.frame(zm = "B. F: liczba zakupów w roku", x0 = tapply(ucz$F, ucz$f5, min), x1 = pmin(tapply(ucz$F, ucz$f5, max), 15),
             y = tapply(ucz$zakupy_nast, ucz$f5, mean)))
round(schodki$y, 2)                                    # średnia w kwintylach R (5 → 1) i F (1 → 5)
round(punkty$y[punkty$zm == "B. F: liczba zakupów w roku"][c(4, 8, 15)], 2)   # dane: F = 4, 8 i 15+
p2 <- ggplot() +
  geom_point(data = punkty, aes(x, y, shape = "Średnia w danych (wąskie przedziały)"), colour = "grey45", size = 2) +
  geom_segment(data = schodki, aes(x = x0, xend = x1, y = y, yend = y, linetype = "Kwintyle: średnia w kwintylu"),
               colour = "#D55E00", linewidth = 1.3) +
  geom_line(data = punkty, aes(x, model, linetype = "Model NB ze splajnem"), colour = "#0072B2", linewidth = 1.1) +
  facet_wrap(~ zm, scales = "free") +
  scale_linetype_manual(values = c("Kwintyle: średnia w kwintylu" = "solid", "Model NB ze splajnem" = "21"), name = NULL) +
  scale_shape_manual(values = c("Średnia w danych (wąskie przedziały)" = 16), name = NULL) +
  labs(title = "Kwintyle zamieniają krzywą w pięć schodków",
       x = NULL, y = "Średnia liczba zakupów w półroczu 3") + motyw
p2   # zapis: ggsave("segmentacja-rfm-schodki-a-splajn.svg", p2, width = 10, height = 5.4)
Wynik w R
   theta theta_SE
    0.97     0.04
                     model parametry     AIC
1      NB, splajny R, F, M        12 27436.5
2 Poisson, te same splajny        11 29896.8
3 NB, splajny R, F (bez M)         9 27431.9
4          NB, 125 komórek       114 27685.7
5     NB, wynik sumaryczny        14 28179.7
Likelihood ratio tests of Negative Binomial Models

Response: zakupy_nast
                                                                  Model     theta Resid. df    2 x log-lik.   Test
1                      ns(R, df = 4) + ns(log(F), knots = log(c(2, 4))) 0.9646885     11804       -27413.91
2 ns(R, df = 4) + ns(log(F), knots = log(c(2, 4))) + ns(log(M), df = 3) 0.9650699     11801       -27412.54 1 vs 2
     df LR stat.   Pr(Chi)
1
2     3  1.36356 0.7140982
 [1] 0.16 0.40 0.81 1.28 1.89 0.46 0.45 0.65 0.96 2.01
[1] 1.28 2.39 5.50
4. Walidacja w czasie: gain, lift i bootstrap: Rysunek 3
R
# Przepis 4. Walidacja w czasie: reguły z roku 1 na klientach pół roku później; gain i lift dla górnych 20%; Rysunek 3
# Korzysta z ucz, test, sr_komorki, sr_sumy, m_nb (przepisy 1–3).
test$p_komorki <- as.vector(sr_komorki[test$komorka])
c(klienci_w_komorkach_bez_historii = sum(is.na(test$p_komorki)))
test$p_komorki[is.na(test$p_komorki)] <- mean(ucz$zakupy_nast)       # komórka pusta w zbiorze uczącym
test$p_suma <- as.vector(sr_sumy[as.character(test$suma)])
test$p_nb <- as.vector(predict(m_nb, newdata = test, type = "response"))
metody <- c("Komórki RFM (125)" = "p_komorki", "Wynik sumaryczny R+F+M" = "p_suma", "Model ujemny dwumianowy" = "p_nb")

set.seed(7281)                                       # remisy w prognozie (te same komórki) – kolejność losowa
los <- runif(nrow(test))
gora <- function(pred, y, u, ile) {                  # udział zakupów półrocza 4 u górnych 5% / 20% klientów
  o <- order(-pred, u); sapply(ile, function(q) sum(y[o[seq_len(round(q * length(y)))]]) / sum(y))
}
wyn <- t(sapply(metody, function(m) gora(test[[m]], test$zakupy_nast, los, c(0.05, 0.2))))
colnames(wyn) <- c("gora_5proc", "gora_20proc")
round(cbind(100 * wyn, lift_5 = wyn[, 1] / 0.05, lift_20 = wyn[, 2] / 0.2), 2)
kup20 <- sapply(metody, function(m) { i <- order(-test[[m]], los)[seq_len(round(0.2 * nrow(test)))]
  sum(test$zakupy_nast[i] > 0) / sum(test$zakupy_nast > 0) })
round(100 * kup20, 1)                                # odsetek wszystkich kupujących, który trafia do górnych 20%

# Niepewność: bootstrap klientów zbioru testowego (1000 powtórzeń)
set.seed(7282)
B <- 1000
bs <- replicate(B, { i <- sample(nrow(test), replace = TRUE)
  sapply(metody, function(m) gora(test[[m]][i], test$zakupy_nast[i], los[i], c(0.05, 0.2))) })   # 2 × 3 × B
ci <- function(v) round(100 * quantile(v, c(.025, .975)), 1)
rbind("górne 5%: komórki" = ci(bs[1, 1, ]), "górne 5%: suma" = ci(bs[1, 2, ]), "górne 5%: NB" = ci(bs[1, 3, ]),
      "górne 5%: NB − komórki (pp)" = ci(bs[1, 3, ] - bs[1, 1, ]),
      "górne 20%: komórki" = ci(bs[2, 1, ]), "górne 20%: suma" = ci(bs[2, 2, ]), "górne 20%: NB" = ci(bs[2, 3, ]),
      "górne 20%: NB − komórki (pp)" = ci(bs[2, 3, ] - bs[2, 1, ]), "górne 20%: NB − suma (pp)" = ci(bs[2, 3, ] - bs[2, 2, ]))
round(sapply(metody, function(m) cor(test[[m]], test$zakupy_nast)), 3)   # korelacja prognozy z wynikiem

# Rysunek 3: krzywa gain (skumulowany udział zakupów półrocza 4) dla trzech metod i wyboru losowego
odsetki <- seq(0, 1, 0.02)
gain <- do.call(rbind, lapply(names(metody), function(nm) {
  o <- order(-test[[metody[nm]]], los); cs <- c(0, cumsum(test$zakupy_nast[o])) / sum(test$zakupy_nast)
  data.frame(metoda = nm, x = odsetki, y = cs[round(odsetki * nrow(test)) + 1]) }))
gain <- rbind(gain, data.frame(metoda = "Wybór losowy", x = odsetki, y = odsetki))
gain$metoda <- factor(gain$metoda, levels = names(kol))
etyk <- data.frame(metoda = factor(names(metody), levels = names(kol)), y = wyn[, 2])
p3 <- ggplot(gain, aes(x, y, colour = metoda, linetype = metoda)) +
  geom_vline(xintercept = 0.2, colour = "grey60", linetype = "dotted") +
  geom_line(linewidth = 1.1) +
  geom_point(data = etyk, aes(x = 0.2, y = y, shape = metoda), size = 3, inherit.aes = FALSE, colour = kol[names(metody)]) +
  annotate("text", x = 0.62, y = 0.22, hjust = 0, size = 4, lineheight = 1.1, colour = "grey15",
           label = sprintf("Górne 20%% klientów daje:\nmodel NB: %.1f%%\nkomórki RFM: %.1f%%\nwynik sumaryczny: %.1f%%",
                           100 * wyn[3, 2], 100 * wyn[1, 2], 100 * wyn[2, 2])) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "42", "solid", "dotted"), name = NULL) +
  scale_shape_manual(values = c(15, 17, 16), guide = "none") +
  scale_x_continuous(labels = function(v) paste0(100 * v, "%")) +
  scale_y_continuous(labels = function(v) paste0(100 * v, "%")) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Krzywa gain na danych z kolejnego okresu (półrocze 4)",
       x = "Odsetek klientów wybranych od najwyższej prognozy", y = "Odsetek wszystkich zakupów półrocza") + motyw
p3   # zapis: ggsave("segmentacja-rfm-gain.svg", p3, width = 10, height = 5.8)
Wynik w R
klienci_w_komorkach_bez_historii
                               9
                        gora_5proc gora_20proc lift_5 lift_20
Komórki RFM (125)            15.89       46.46   3.18    2.32
Wynik sumaryczny R+F+M       15.89       45.77   3.18    2.29
Model ujemny dwumianowy      17.08       47.42   3.42    2.37
      Komórki RFM (125)  Wynik sumaryczny R+F+M Model ujemny dwumianowy
                   36.6                    35.7                    37.0
                             2.5% 97.5%
górne 5%: komórki            14.9  16.9
górne 5%: suma               14.9  16.9
górne 5%: NB                 16.0  18.2
górne 5%: NB − komórki (pp)   0.3   2.1
górne 20%: komórki           45.0  48.0
górne 20%: suma              44.4  47.3
górne 20%: NB                45.9  48.8
górne 20%: NB − komórki (pp)  0.1   1.6
górne 20%: NB − suma (pp)     0.7   2.4
      Komórki RFM (125)  Wynik sumaryczny R+F+M Model ujemny dwumianowy
                  0.460                   0.439                   0.488
5. Kalibracja w decylach: Rysunek 4
R
# Przepis 5. Kalibracja: przewidywana a obserwowana liczba zakupów w decylach prognozy (półrocze 4); Rysunek 4
# Korzysta z test, metody, los (przepisy 1–4).
decyle <- do.call(rbind, lapply(names(metody), function(nm) {
  p <- test[[metody[nm]]]; dec <- ceiling(10 * rank(p + los * 1e-9, ties.method = "first") / length(p))
  data.frame(metoda = nm, decyl = 1:10, przewidywane = as.vector(tapply(p, dec, mean)),
             obserwowane = as.vector(tapply(test$zakupy_nast, dec, mean)),
             se = as.vector(tapply(test$zakupy_nast, dec, function(v) sd(v) / sqrt(length(v))))) }))
decyle$metoda <- factor(decyle$metoda, levels = names(metody))
print(within(decyle[decyle$decyl %in% c(1, 5, 9, 10), ], { przewidywane <- round(przewidywane, 2)
  obserwowane <- round(obserwowane, 2); se <- round(se, 3) }), row.names = FALSE)
data.frame(metoda = names(metody), suma_przewidywana = round(sapply(metody, function(m) sum(test[[m]]))),
           suma_obserwowana = sum(test$zakupy_nast),
           MAE_klient = round(sapply(metody, function(m) mean(abs(test[[m]] - test$zakupy_nast))), 3),
           blad_decyla_max = round(tapply(abs(decyle$przewidywane - decyle$obserwowane), decyle$metoda, max), 2),
           row.names = NULL)

p4 <- ggplot(decyle, aes(przewidywane, obserwowane, colour = metoda, shape = metoda)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = "dashed") +
  geom_errorbar(aes(ymin = obserwowane - 1.96 * se, ymax = obserwowane + 1.96 * se), width = 0, linewidth = 0.5) +
  geom_line(linewidth = 0.7) + geom_point(size = 2.6) +
  facet_wrap(~ metoda) +
  scale_colour_manual(values = kol[names(metody)], guide = "none") +
  scale_shape_manual(values = c(15, 17, 16), guide = "none") +
  coord_equal() +
  labs(title = "Kalibracja w kolejnym okresie: decyle prognozy",
       x = "Przewidywana średnia liczba zakupów", y = "Obserwowana średnia (95% CI)") + motyw
p4   # zapis: ggsave("segmentacja-rfm-kalibracja.svg", p4, width = 10, height = 4.8)
Wynik w R
                  metoda decyl przewidywane obserwowane    se
       Komórki RFM (125)     1         0.12        0.17 0.017
       Komórki RFM (125)     5         0.59        0.60 0.034
       Komórki RFM (125)     9         1.65        1.72 0.055
       Komórki RFM (125)    10         2.66        2.55 0.069
  Wynik sumaryczny R+F+M     1         0.17        0.18 0.016
  Wynik sumaryczny R+F+M     5         0.60        0.61 0.033
  Wynik sumaryczny R+F+M     9         1.66        1.66 0.056
  Wynik sumaryczny R+F+M    10         2.63        2.52 0.068
 Model ujemny dwumianowy     1         0.12        0.15 0.015
 Model ujemny dwumianowy     5         0.61        0.61 0.030
 Model ujemny dwumianowy     9         1.60        1.68 0.053
 Model ujemny dwumianowy    10         2.81        2.66 0.071
                   metoda suma_przewidywana suma_obserwowana MAE_klient blad_decyla_max
1       Komórki RFM (125)             11075            11202      0.935            0.11
2  Wynik sumaryczny R+F+M             11096            11202      0.969            0.11
3 Model ujemny dwumianowy             11075            11202      0.922            0.15
6. Stabilność komórek: Rysunek 5
R
# Przepis 6. Niestabilne komórki: średnia komórki z roku 1 a wynik tej samej komórki pół roku później; Rysunek 5
# Korzysta z ucz, test, n_komorki (przepisy 1–4).
kom <- data.frame(komorka = names(n_komorki), n_ucz = as.vector(n_komorki))
kom$sr_ucz <- as.vector(tapply(ucz$zakupy_nast, ucz$komorka, mean)[kom$komorka])
kom$n_test <- as.vector(table(factor(test$komorka, levels = kom$komorka)))
kom$sr_test <- as.vector(tapply(test$zakupy_nast, factor(test$komorka, levels = kom$komorka), mean))
kom$nb_test <- as.vector(tapply(test$p_nb, factor(test$komorka, levels = kom$komorka), mean))
kom <- kom[kom$n_test > 0, ]
kom$grupa <- ifelse(kom$n_ucz < 30, "mniej niż 30 klientów", "30 i więcej klientów")
podsum <- function(d) c(komorki = nrow(d), klienci_test = sum(d$n_test),
  sredni_blad_komorki = round(mean(abs(d$sr_ucz - d$sr_test)), 3), sredni_blad_modelu = round(mean(abs(d$nb_test - d$sr_test)), 3))
rbind(wszystkie = podsum(kom), ponizej_30 = podsum(kom[kom$n_ucz < 30, ]), od_30 = podsum(kom[kom$n_ucz >= 30, ]))
w <- function(a, b, n) round(sum(n * abs(a - b)) / sum(n), 3)   # błąd ważony liczbą klientów testowych
c(blad_wazony_komorki = w(kom$sr_ucz, kom$sr_test, kom$n_test), blad_wazony_modelu = w(kom$nb_test, kom$sr_test, kom$n_test))

dl <- rbind(data.frame(panel = "A. Komórka: średnia z roku 1", x = kom$sr_ucz, y = kom$sr_test, n = kom$n_ucz, grupa = kom$grupa),
            data.frame(panel = "B. Model NB: średnia prognoz w komórce", x = kom$nb_test, y = kom$sr_test, n = kom$n_ucz, grupa = kom$grupa))
p5 <- ggplot(dl, aes(x, y)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey60", linetype = "dashed") +
  geom_point(aes(size = n, colour = grupa, shape = grupa), alpha = 0.75) +
  facet_wrap(~ panel) +
  scale_colour_manual(values = c("mniej niż 30 klientów" = "#D55E00", "30 i więcej klientów" = "#0072B2"), name = "Komórka w roku 1:") +
  scale_shape_manual(values = c("mniej niż 30 klientów" = 17, "30 i więcej klientów" = 16), name = "Komórka w roku 1:") +
  scale_size(range = c(1.6, 6), name = "Klienci w komórce", breaks = c(10, 100, 300)) +
  guides(colour = guide_legend(nrow = 2), shape = guide_legend(nrow = 2), size = guide_legend(nrow = 2)) +
  labs(title = "125 komórek pół roku później: małe komórki się rozjeżdżają",
       x = "Prognoza dla komórki (średnia liczba zakupów)", y = "Obserwowana średnia w półroczu 4") + motyw
p5   # zapis: ggsave("segmentacja-rfm-stabilnosc-komorek.svg", p5, width = 10, height = 5.8)
Wynik w R
           komorki klienci_test sredni_blad_komorki sredni_blad_modelu
wszystkie      112        12212               0.232              0.192
ponizej_30      33          443               0.516              0.383
od_30           79        11769               0.114              0.112
blad_wazony_komorki  blad_wazony_modelu
              0.104               0.103
7. Karta komórki 5-5-5: Rysunek 6
R
# Przepis 7. Grafika: karta „komórka RFM 5-5-5” z liczbami z przykładu; Rysunek 6
# Korzysta z ucz, test, sr_komorki (przepisy 1–4).
u <- ucz[ucz$komorka == "5-5-5", ]; t5 <- test[test$komorka == "5-5-5", ]
q_nb <- quantile(t5$p_nb, c(0, .25, .5, .75, 1))
karta <- c(klienci_rok1 = nrow(u), proc_bazy = round(100 * nrow(u) / nrow(ucz), 1),
           R_max = max(u$R), F_min = min(u$F), F_max = max(u$F), M_min = min(u$M),
           srednia_rok1 = round(mean(u$zakupy_nast), 2), klienci_test = nrow(t5),
           srednia_test = round(mean(t5$zakupy_nast), 2), udzial_zakupow_test = round(100 * sum(t5$zakupy_nast) / sum(test$zakupy_nast), 1),
           bez_zakupu_test = round(100 * mean(t5$zakupy_nast == 0), 1))
karta
round(q_nb, 2)                                       # prognozy modelu NB w komórce 5-5-5 (pół roku później)
f1 <- function(x) sprintf("%.1f", x); f2 <- function(x) sprintf("%.2f", x)
kafle <- data.frame(
  x = c(0, 1, 0, 1), y = c(1, 1, 0, 0),
  naglowek = c("1. Kto trafia do komórki 5-5-5", "2. Co mówi komórka", "3. Co mówi model w tej samej komórce", "4. Co z tym zrobić"),
  tresc = c(
    sprintf("%d klientów (%s%% bazy), piąty kwintyl R, F i M:\nostatni zakup do %d dni temu,\n%d–%d zakupów i od %d zł w roku",
            karta[["klienci_rok1"]], f1(karta[["proc_bazy"]]), karta[["R_max"]], karta[["F_min"]], karta[["F_max"]], karta[["M_min"]]),
    sprintf("jedna liczba dla wszystkich: %s zakupu\nw półroczu 3; pół roku później: %s\n%d klientów daje %s%% zakupów półrocza,\nale %s%% z nich nie kupuje nic",
            f2(karta[["srednia_rok1"]]), f2(karta[["srednia_test"]]), karta[["klienci_test"]], f1(karta[["udzial_zakupow_test"]]),
            f1(karta[["bez_zakupu_test"]])),
    sprintf("prognoza od %s do %s zakupu\npołowa klientów: %s–%s\nkomórka miesza klienta z %d zakupami\nz klientem z %d zakupami w roku",
            f2(q_nb[[1]]), f2(q_nb[[5]]), f2(q_nb[[2]]), f2(q_nb[[4]]), karta[["F_min"]], karta[["F_max"]]),
    "do kampanii „górne 20%” komórki wystarczą;\ndo budżetu i kolejności kontaktu\nweź prognozę z modelu;\nsprawdź działanie w teście z grupą kontrolną"))
p6 <- ggplot(kafle) +
  geom_rect(aes(xmin = x - 0.47, xmax = x + 0.47, ymin = y - 0.44, ymax = y + 0.44),
            fill = c("#F2F7FB", "#FDF1E9", "#F2F7FB", "#F2F7FB"), colour = c("#0072B2", "#D55E00", "#0072B2", "#0072B2"),
            linewidth = 0.8) +
  geom_text(aes(x = x - 0.43, y = y + 0.32, label = naglowek), hjust = 0, vjust = 1, fontface = "bold",
            size = 4.6, colour = "#0f1d3a") +
  geom_text(aes(x = x - 0.43, y = y + 0.13, label = tresc), hjust = 0, vjust = 1, size = 4.1,
            lineheight = 1.05, colour = "grey15") +
  coord_cartesian(xlim = c(-0.5, 1.5), ylim = c(-0.48, 1.48), expand = FALSE) +
  labs(title = "Komórka RFM 5-5-5: najlepsi klienci sklepu z akcesoriami kuchennymi", x = NULL, y = NULL) +
  motyw + theme(axis.text = element_blank(), panel.grid.major = element_blank())
p6   # zapis: ggsave("segmentacja-rfm-karta-komorki-555.svg", p6, width = 10, height = 6)
Wynik w R
       klienci_rok1           proc_bazy               R_max               F_min               F_max               M_min
             733.00                6.20               33.00                4.00               26.00              595.00
       srednia_rok1        klienci_test        srednia_test udzial_zakupow_test     bez_zakupu_test
               3.00              736.00                2.83               18.60               17.70
  0%  25%  50%  75% 100%
1.63 2.26 2.72 3.53 8.51
8. Pułapki: remisy, granice kwintyli i zgodność list
R
# Przepis 8. Pułapki: remisy w F, przesuwające się granice kwintyli i zgodność list „górne 20%”
# Korzysta z ucz, test, metody, los (przepisy 1–4).
# Klienci z jednym zakupem dostają różne kwintyle F, choć kupują tak samo
aggregate(zakupy_nast ~ f5, data = ucz[ucz$F == 1, ], FUN = function(v) round(c(n = length(v), srednia = mean(v)), 3))

# Granice kwintyli R (dni) w roku 1 i pół roku później
rbind(rok1 = quantile(ucz$R, (1:4) / 5, type = 1), pol_roku_pozniej = quantile(test$R, (1:4) / 5, type = 1))

# Na ile listy „górne 20%” się pokrywają
lista <- function(m) test$id[order(-test[[m]], los)[seq_len(round(0.2 * nrow(test)))]]
c(wspolni_komorki_NB_proc = round(100 * length(intersect(lista("p_komorki"), lista("p_nb"))) / round(0.2 * nrow(test)), 1),
  wspolni_suma_NB_proc = round(100 * length(intersect(lista("p_suma"), lista("p_nb"))) / round(0.2 * nrow(test)), 1),
  spearman_suma_NB = round(cor(test$p_suma, test$p_nb, method = "spearman"), 3))

# Ile zakupów daje 20% klientów wybranych według samej liczby zakupów F (remisy losowo)
round(100 * gora(test$F, test$zakupy_nast, los, 0.2), 2)
Wynik w R
  f5 zakupy_nast.n zakupy_nast.srednia
1  1      2362.000               0.459
2  2      2362.000               0.453
3  3       318.000               0.469
                 20% 40% 60% 80%
rok1              33  80 148 245
pol_roku_pozniej  33  81 152 250
wspolni_komorki_NB_proc    wspolni_suma_NB_proc        spearman_suma_NB
                 89.600                  86.100                   0.862
[1] 42.76
9. Kontrola palety przy zaburzeniach widzenia barw
R
# Przepis 9. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("komórki – model NB" = c("#D55E00", "#0072B2"), "komórki – wynik sumaryczny" = c("#D55E00", "#E69F00"),
             "wynik sumaryczny – model NB" = c("#E69F00", "#0072B2"), "model NB – wybór losowy" = c("#0072B2", "grey55"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
komórki – model NB                         114.6        108.3       91.9
komórki – wynik sumaryczny                  33.4         18.4       24.9
wynik sumaryczny – model NB                120.2        121.5      109.3
model NB – wybór losowy                     43.2         47.1       39.2
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, regresja Poissona (glm), test ilorazu wiarygodności i kwantyle – pakiet stats; splajny naturalne (ns) – pakiet splines dołączony do R; regresja ujemna dwumianowa (glm.nb) – pakiet MASS. Rysunki wykonano w pakiecie ggplot2 (skala barw cividis z pakietu viridisLite) i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, A. P., Sciaini, M., & Scherer, C. (2023). viridisLite: Colorblind-friendly color maps (lite version) [R package]. https://doi.org/10.32614/CRAN.package.viridisLite
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Remisy w F. Przy 42.7% klientów z jednym zakupem kwintyle F są sztuczne: te same osoby lądują w kwintylu 1, 2 lub 3 według kolejności w bazie. Lepiej użyć przedziałów samej liczby zakupów (1, 2, 3–4, 5+) albo modelu.
- Granice kwintyli się przesuwają. Granice R w roku 1: 33, 80, 148 i 245 dni, pół roku później: 33, 81, 152 i 250. Zapisuj je w dniach i zł.
- M nie zawsze coś dodaje. Tu wydatki nie poprawiły prognozy liczby zakupów (p = .714), a mnożyły komórki pięciokrotnie. Do prognozy wartości koszyka M jest potrzebne – ale to osobny model.
- Sama F to za mało. 20% klientów z największą liczbą zakupów dało tylko 42.8% zakupów półrocza wobec 47.4% z modelu – bez R nie odróżnisz stałego klienta od tego, który już odszedł.
Najczęstsze pytania
Co to jest segmentacja RFM?
To podział klientów według trzech liczb z historii zakupów: R (recency) – ile dni minęło od ostatniego zakupu, F (frequency) – ile razy klient kupił w danym okresie, M (monetary) – ile wydał. Najczęściej każdą liczbę dzieli się na kwintyle (1–5), co daje kod komórki, np. 5-5-5, albo wynik sumaryczny od 3 do 15.
Kwintyle RFM czy model regresji – co wybrać?
W przykładzie różnica w wyborze górnych 20% klientów była mała: 46.5% zakupów kolejnego półrocza dla komórek RFM i 47.4% dla regresji ujemnej dwumianowej. Model wygrywał wyraźniej w wąskiej grupie (górne 5%: 17.1% wobec 15.9%) i w małych komórkach. Gdy potrzebujesz prostej, zrozumiałej listy – RFM wystarczy; gdy prognozy liczby zakupów dla każdego klienta – użyj modelu.
Dlaczego kwintyle tracą informację?
Bo zamieniają liczbę ciągłą w pięć schodków. W przykładzie kwintyl F 5 łączył klientów z 4 i z 26 zakupami w roku i dawał im jedną prognozę 2.01 zakupu, choć w danych klienci z 4 zakupami kupowali średnio 1.28 razy, a z 15 i więcej – 5.50 razy. Przy wielu remisach (np. 42.7% klientów z jednym zakupem) te same osoby trafiają do różnych kwintyli tylko według kolejności w bazie.
Jak sprawdzić, czy segmentacja RFM działa?
Zbuduj reguły na danych do pewnego momentu i oceń je na zakupach z następnego okresu (walidacja w czasie), a nie na tym samym zbiorze. Policz, jaki odsetek zakupów przypada na górne 5% lub 20% klientów (wykres gain i lift), sprawdź kalibrację w decylach prognozy i dodaj przedział ufności z bootstrapu.
Ilu klientów powinno być w komórce RFM?
Na tyle dużo, by średnia była stabilna. W przykładzie w komórkach z mniej niż 30 klientami średni błąd prognozy w kolejnym okresie wynosił 0.52 zakupu, a w większych 0.11. Łącz małe komórki, używaj wyniku sumarycznego albo modelu, który nie potrzebuje osobnej średniej dla każdej komórki.
Powiązane hasła
Przeczytaj też
Analiza skupień w marketingu – segmentacja klientów
Księgarnia internetowa, 1500 klientów i RFM: przekształcenia, liczba segmentów, mapa PCA, karty segmentów z działaniami i stabilność – sześć rysunków z kodem R.
Czytaj →PoradnikModel BG/NBD – aktywni klienci
Sklep z przyprawami: BG/NBD napisany ręcznie w R, P(aktywny), prognoza zakupów na rok 2 i porównanie z regułą 180 dni – sześć rysunków.
Czytaj →PoradnikPrzeciek danych i walidacja w czasie
Sieć siłowni i rezygnacje z karnetu: zmienne z przyszłości, losowy podział, wybór zmiennych na szumie i okno przesuwane – pięć rysunków z kodem R.
Czytaj →Segmentujesz klientów albo piszesz o tym pracę?
Pomożemy policzyć RFM z danych sprzedażowych, zbudować model liczby zakupów, ocenić go na kolejnym okresie i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bennette, C., & Vickers, A. (2012). Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents. BMC Medical Research Methodology, 12(1), Article 21. https://doi.org/10.1186/1471-2288-12-21 ● Otwarty dostęp
- Fader, P. S., Hardie, B. G. S., & Lee, K. L. (2005). RFM and CLV: Using iso-value curves for customer base analysis. Journal of Marketing Research, 42(4), 415–430. https://doi.org/10.1509/jmkr.2005.42.4.415
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Perperoglou, A., Sauerbrei, W., Abrahamowicz, M., & Schmid, M. (2019). A review of spline function procedures in R. BMC Medical Research Methodology, 19(1), Article 46. https://doi.org/10.1186/s12874-019-0666-3 ● Otwarty dostęp
- Roberts, D. R., Bahn, V., Ciuti, S., Boyce, M. S., Elith, J., Guillera-Arroita, G., Hauenstein, S., Lahoz-Monfort, J. J., Schröder, B., Thuiller, W., Warton, D. I., Wintle, B. A., Hartig, F., & Dormann, C. F. (2017). Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography, 40(8), 913–929. https://doi.org/10.1111/ecog.02881
- Royston, P., Altman, D. G., & Sauerbrei, W. (2006). Dichotomizing continuous predictors in multiple regression: A bad idea. Statistics in Medicine, 25(1), 127–141. https://doi.org/10.1002/sim.2331
- Vuk, M., & Curk, T. (2006). ROC curve, lift chart and calibration plot. Advances in Methodology and Statistics, 3(1). https://doi.org/10.51936/noqf3710 ● Otwarty dostęp
- Wübben, M., & von Wangenheim, F. (2008). Instant customer base analysis: Managerial heuristics often “get it right”. Journal of Marketing, 72(3), 82–93. https://doi.org/10.1509/jmkg.72.3.082 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bennette2012against, author={Bennette, Caroline and Vickers, Andrew}, title={{Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={21}, doi={10.1186/1471-2288-12-21}}@article{fader2005rfm, author={Fader, Peter S. and Hardie, Bruce G. S. and Lee, Ka Lok}, title={{RFM and CLV: Using iso-value curves for customer base analysis}}, journal={Journal of Marketing Research}, year={2005}, volume={42}, number={4}, pages={415--430}, doi={10.1509/jmkr.2005.42.4.415}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{perperoglou2019review, author={Perperoglou, Aris and Sauerbrei, Willi and Abrahamowicz, Michal and Schmid, Matthias}, title={{A review of spline function procedures in R}}, journal={BMC Medical Research Methodology}, year={2019}, volume={19}, number={1}, eid={46}, doi={10.1186/s12874-019-0666-3}}@article{roberts2017cross, author={Roberts, David R. and Bahn, Volker and Ciuti, Simone and Boyce, Mark S. and Elith, Jane and Guillera-Arroita, Gurutzeta and Hauenstein, Severin and Lahoz-Monfort, José J. and Schröder, Boris and Thuiller, Wilfried and Warton, David I. and Wintle, Brendan A. and Hartig, Florian and Dormann, Carsten F.}, title={{Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure}}, journal={Ecography}, year={2017}, volume={40}, number={8}, pages={913--929}, doi={10.1111/ecog.02881}}@article{royston2006dichotomizing, author={Royston, Patrick and Altman, Douglas G. and Sauerbrei, Willi}, title={{Dichotomizing continuous predictors in multiple regression: A bad idea}}, journal={Statistics in Medicine}, year={2006}, volume={25}, number={1}, pages={127--141}, doi={10.1002/sim.2331}}@article{vuk2006roc, author={Vuk, Miha and Curk, Tomaž}, title={{ROC curve, lift chart and calibration plot}}, journal={Advances in Methodology and Statistics}, year={2006}, volume={3}, number={1}, doi={10.51936/noqf3710}}@article{wubben2008instant, author={W{\"u}bben, Markus and von Wangenheim, Florian}, title={{Instant customer base analysis: Managerial heuristics often “get it right”}}, journal={Journal of Marketing}, year={2008}, volume={72}, number={3}, pages={82--93}, doi={10.1509/jmkg.72.3.082}}