Przykład: sześć marek jogurtów pitnych w panelu 2500 gospodarstw
Fikcyjny producent jogurtu pitnego Zdrojka kupił dane z panelu konsumenckiego: 2500 gospodarstw domowych zapisywało przez cały 2025 r. każdy zakup jogurtu pitnego z datą i marką. Na półce jest sześć marek (nazwy zmyślone): Lazurka, Zdrojka i Bystrza (naturalne i probiotyczne) oraz Pastwina, Kremik i Tęczka (owocowe i deserowe). W II półroczu Zdrojka prowadziła promocję przez 8 tygodni. Dział marketingu pyta: od kogo przychodzą klienci, komu ich oddajemy i co zrobiła z tym promocja?
Z panelu budujemy ciąg zakupów każdego gospodarstwa i liczymy przejścia: marka przy zakupie t → marka przy zakupie t + 1. Panel ma 42461 zakupów i 39961 przejść. Pomijamy 3914 par zakupów z tego samego dnia, bo ich kolejność na paragonie jest przypadkowa (pułapka na końcu). Zostaje 36047 przejść w 2471 gospodarstwach.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Parametry ustawiliśmy ręcznie (lista przy kodzie): 30% gospodarstw jest „wiernych” (ulubiona marka z szansą 0.95), pozostałe powtarzają ostatnią markę z szansą 0.40, a w innych przypadkach wybierają według własnych preferencji, w których marki „swojej” grupy (A albo B) mają wagę 2.5 raza większą. W tygodniach promocji szansa wyboru Zdrojki przez gospodarstwa niewierne rośnie trzykrotnie. Parametrów danych po pierwszym uruchomieniu nie zmienialiśmy; ziarno 729. Dane pobierzesz jako przechodzenie-miedzy-markami-panel-jogurty.csv.
Rysunek 1: macierz przejść – lojalność, odpływ i przyciąganie
Przejścia układasz w tabelę krzyżową: wiersz – marka przy zakupie t, kolumna – przy następnym. Odsetki w wierszu to szacowane prawdopodobieństwa przejść pij = nij / ni (estymator największej wiarygodności; Anderson i Goodman, 1957).
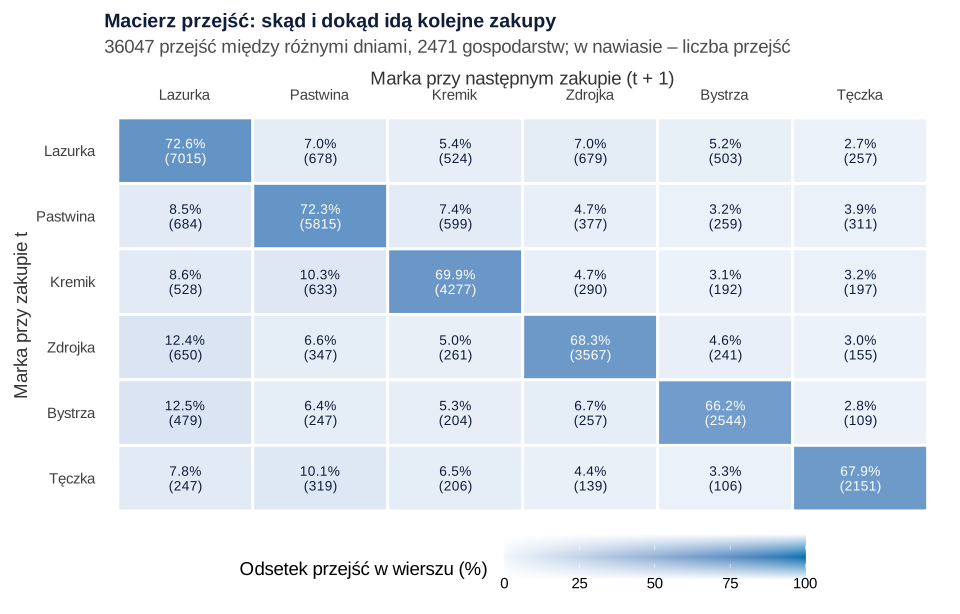
set.seed(729)).Co widać. Przekątna to lojalność: przy Lazurce zostaje 72.6% kolejnych zakupów, przy Bystrzy 66.2%. Reszta wiersza to odpływ (27.4–33.8%) i jego kierunki: Zdrojka oddaje 12.4% zakupów Lazurce. Przyciąganie mierzymy udziałem marki wśród wszystkich zmian marki (29.6% przejść): Zdrojka zdobywa 16.3% zmian przy 14.7% udziału w zakupach, Lazurka 24.2% przy 26.6%. Mniejsze marki mają nieco niższą lojalność – to zgodne z prawem podwójnego zagrożenia (Ehrenberg i in., 1990), które omawiamy we wpisie o prawie podwójnego zagrożenia.
Jak może zmylić. Kolor zdominowała przekątna, więc różnice poza nią (3–12%) giną. Odsetki w wierszu mówią, dokąd idą klienci marki, a nie, ilu ich jest – 12.5% z Bystrzy to 479 przejść, 8.5% z Pastwiny to 684.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 2: porównanie z modelem niezależności
Ile przejść byłoby, gdyby następna marka nie zależała od poprzedniej, a tylko od udziałów? To model niezależności z testu chi-kwadrat: oczekiwana liczba = suma wiersza × udział kolumny. Różnicę mierzy odchylenie standaryzowane (reszta Pearsona):
Tu O to obserwowana, a E – oczekiwana liczba przejść. Wartości powyżej 2 lub poniżej −2 traktuj jako wyraźne. Panel B powtarza rachunek tylko dla zmian marki: odchodzący klient wybiera nową markę proporcjonalnie do udziałów pozostałych.
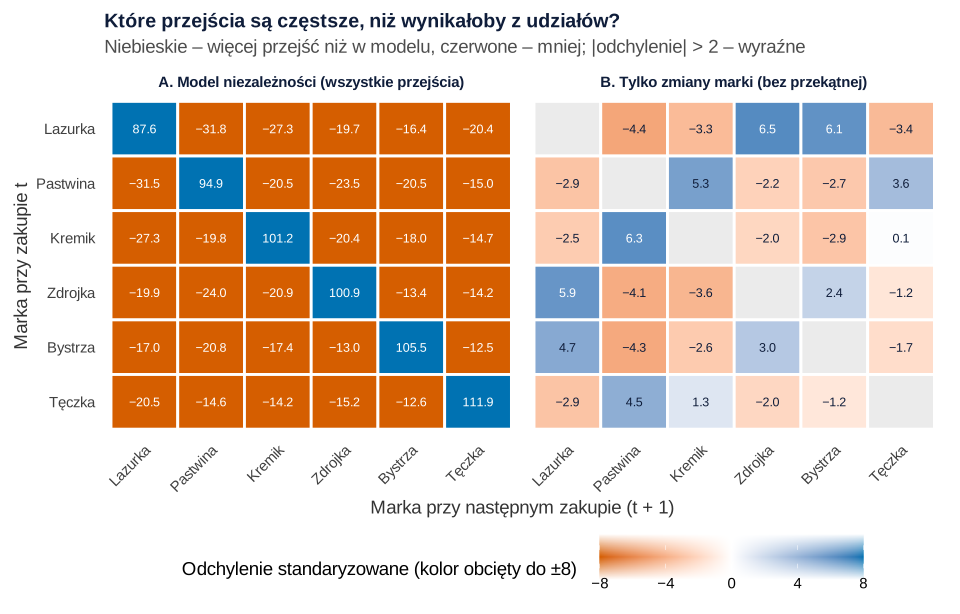
set.seed(729)).Co widać. W panelu A test niezależności daje χ²(25) = 72646, p < .001 – ale to tylko skutek ogromnej przekątnej (odchylenia 87.6–111.9): ludzie powtarzają markę. Ciekawszy jest panel B, χ²(24) = 405.9, p < .001. Zmiany zachodzą głównie wewnątrz grup: z Lazurki do Zdrojki (6.5) i Bystrzy (6.1), z Kremika do Pastwiny (6.3). Między grupami przejść jest mniej, niż wynikałoby z udziałów (Lazurka → Pastwina: −4.4). Rynek dzieli się na dwa podrynki – Zdrojka konkuruje przede wszystkim z Lazurką.
Jak może zmylić. Model z panelu B to uproszczony punkt odniesienia; stopnie swobody są orientacyjne. Przy 36 tysiącach przejść niemal każda różnica jest „istotna” – czytaj wielkość odchyleń, nie p. Wiele przejść tego samego gospodarstwa nie jest niezależnych, więc p są za małe.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: łańcuch Markowa – dokąd zmierzają udziały
Jeśli przyjmiemy, że następny zakup zależy tylko od obecnego, a prawdopodobieństwa przejść są stałe, macierz P opisuje łańcuch Markowa. Mnożąc bieżące udziały przez P raz, dwa, dziesięć razy, dostajesz prognozę udziałów po kolejnych zakupach. Granica to rozkład stacjonarny π, spełniający π = πP: udziały, przy których przepływy w obie strony się równoważą. Niepewność liczymy bootstrapem całych gospodarstw (1000 prób): losujemy gospodarstwa ze zwracaniem razem ze wszystkimi ich przejściami, bo bootstrap całych klastrów daje zgodne oszacowania wariancji (Field i Welsh, 2007).
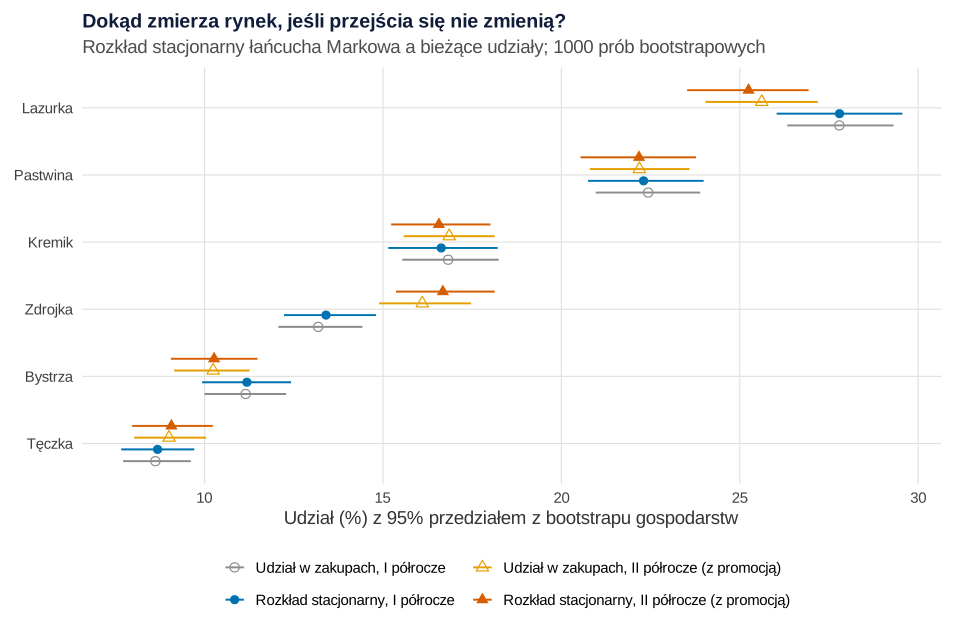
set.seed(7291), 1000 prób).Co widać. W I półroczu rozkład stacjonarny niemal pokrywa się z udziałami (Zdrojka: 13.4% wobec 13.2%) – rynek był w równowadze. Macierz z II półrocza, z promocją, prowadzi Zdrojkę do 16.7%, 95% CI [15.4, 18.1], o 3.3 punktu procentowego [2.1, 4.6] wyżej niż macierz z I półrocza. Od bieżącego udziału (16.1%) dzieli ją już tylko 0.6 pp [0.1, 1.1]; po 10 zakupach prognoza osiąga 16.7%.
Jak może zmylić. Rozkład stacjonarny to odpowiedź na pytanie „co, jeśli przejścia się nie zmienią”, a nie prognoza na przyszły rok. Tu znaczy: „gdyby promocje z II półrocza powtarzały się stale”. Ehrenberg (1965) przestrzegał, że teoria Markowa ma podstawowe trudności z danymi o zmianach marek – jedną z nich pokazuje Rysunek 5.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: czy macierz się zmieniła? Test jednorodności i promocja
Łańcuch zakłada stałą macierz. Sprawdzasz to testem jednorodności: dla każdej marki wyjściowej porównujesz rozkład następnych marek w I i II półroczu (tabela 2 × 6, chi-kwadrat) i sumujesz statystyki – to test stałości przejść Andersona i Goodmana (1957). Wynik: χ²(30) = 48.0, p = .020. Żaden wiersz osobno nie był istotny (p od .074 do .326), ale we wszystkich wzrósł odsetek przejść do Zdrojki (o 1.0–2.2 pp).
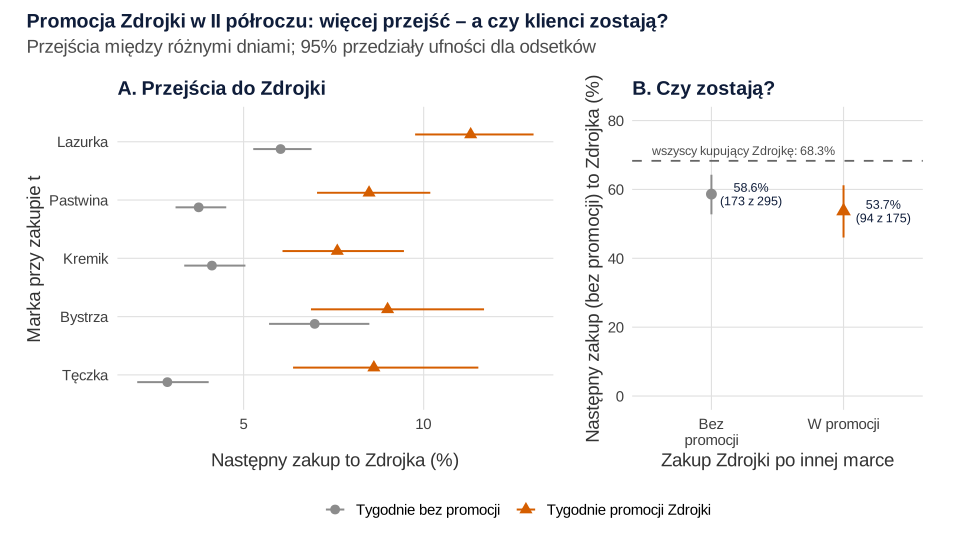
Co widać. W tygodniach promocji z każdej marki częściej przechodzono do Zdrojki: z Lazurki 11.3% wobec 6.0%, z Tęczki 8.6% wobec 2.9%. Czy przyciągnięci zostają? Następny zakup w zwykłej cenie to znów Zdrojka u 53.7% osób przyciągniętych w promocji i 58.6% przyciągniętych poza nią: różnica 4.9 pp, 95% CI [−4.8, 14.7], p = .344. Obie wartości są niższe niż lojalność wszystkich kupujących Zdrojkę (68.3%).
Jak może zmylić. Brak istotnej różnicy w panelu B nie dowodzi, że promocja przyciąga trwałych klientów – przedział jest szeroki. Przejścia do Zdrojki to też nie miara całego efektu promocji: w przeliczeniu van Heerde i in. (2003) tylko ok. 33% przyrostu sztuk w promocji pochodziło ze strat innych marek tej samej kategorii. O formie promocji pisaliśmy we wpisie „2 za 1” czy −50%.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: pułapka – gospodarstwa nie są jednakowe
Łańcuch z jedną macierzą zakłada, że każde gospodarstwo przechodzi między markami z tymi samymi prawdopodobieństwami. W naszych danych tak nie jest: 30% gospodarstw jest „wiernych”. To niejawna heterogeniczność. Sprawdzasz ją, porównując odsetek par zakupów (t, t + k) z tą samą marką w danych z przewidywaniem z macierzy Pk.
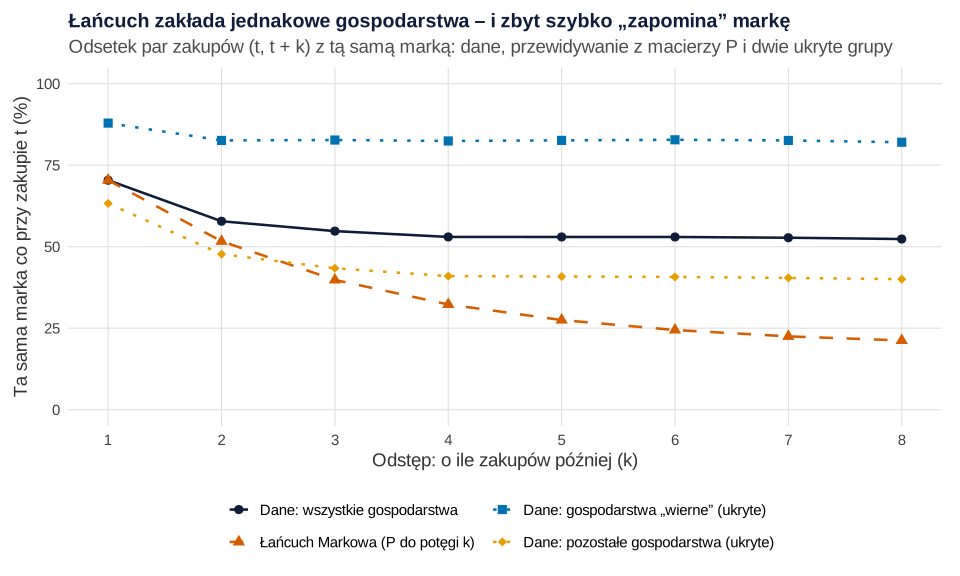
set.seed(729)).Co widać. Dla k = 1 obie linie się zgadzają (70.4%), bo macierz z tego wyliczono. Dalej łańcuch „zapomina” markę: przy k = 8 przewiduje 21.2% powtórzeń, a w danych jest 52.3%. Powód widać w liniach ukrytych grup: wierni powtarzają markę w 82–88%, pozostali – w 40–63%. Wśród 2179 gospodarstw z co najmniej 6 zakupami tylko jedną markę kupiło 8.3%; łańcuch przewiduje 2.8% (symulacja, set.seed(7292)).
Jak może zmylić. Mieszanina „wiernych” i „ruchliwych” wygląda w jednej macierzy jak umiarkowana lojalność wszystkich. Prognozy z łańcucha za szybko zbiegają wtedy do równowagi. Lepszy jest model mieszaniny dwóch łańcuchów, czyli model „ruchliwi–stali” (Frydman, 1984), albo model z klasą klientów twardo lojalnych i klasą zmieniających markę (Colombo i Morrison, 1989) – pokrewny analizie klas latentnych.
Podpis do pracy:
Zdanie do Metody:
Rysunek 6: diagram przepływów między markami
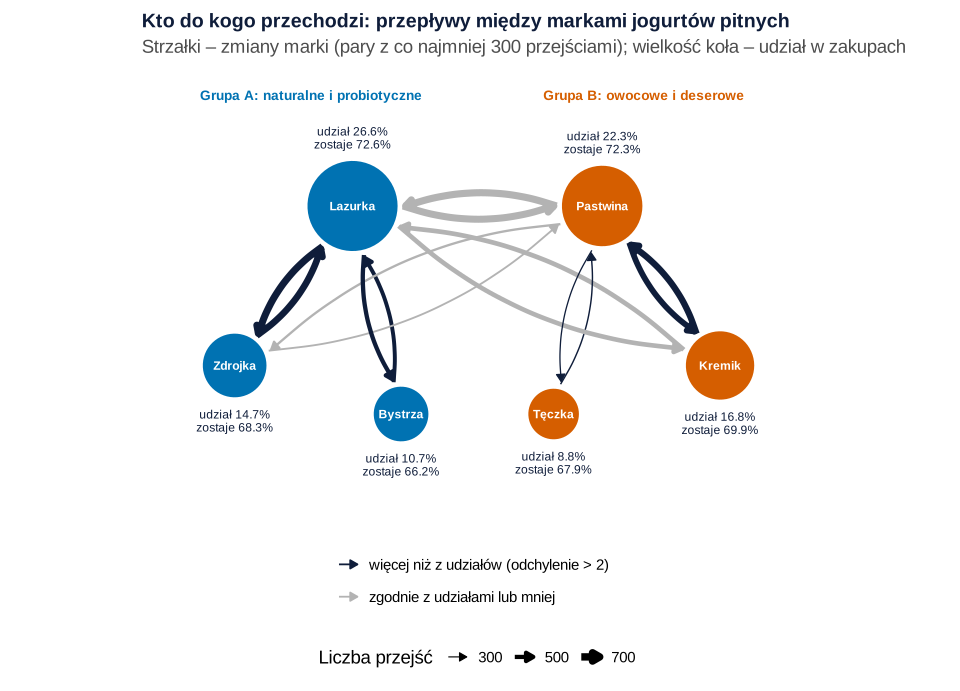
Co widać. Diagram zbiera Rysunki 1 i 2 w jednym obrazie dla zarządu. Najgrubsze strzałki łączą największe marki obu grup (Pastwina → Lazurka: 684), ale to „zwykły” ruch wynikający z ich wielkości. Ciemne strzałki pokazują ponadprzeciętną wymianę w obrębie grup: Lazurka ↔ Zdrojka (679 i 650 przejść) i Kremik ↔ Pastwina.
Jak może zmylić. Pominęliśmy rzadsze przepływy, a strzałka nie mówi, czy wymiana jest zrównoważona. Przepływy osób w kolejnych okresach pokaże też diagram Sankeya.
Co z tym zrobić w marketingu
- Znajdź swojego głównego rywala. Zdrojka wymienia klientów przede wszystkim z Lazurką – tam kieruj porównania w komunikacji i obserwuj jej promocje.
- Oceniaj promocję po przejściach, nie tylko po sprzedaży. Licz, skąd przyszli klienci i ilu kupiło znów w zwykłej cenie. Tu 53.7% – mniej niż przeciętna lojalność 68.3%.
- Traktuj rozkład stacjonarny jako scenariusz. „Jeśli przejścia z II półrocza się utrzymają, udział Zdrojki ustabilizuje się koło 16.7%” – z przedziałem i założeniami.
- Sprawdzaj, czy macierz jest stała. Licz ją osobno dla okresów i testuj jednorodność przed prognozą.
- Szukaj wiernych. Jeśli łańcuch nie odtwarza powtórzeń po kilku zakupach, segmentuj klientów (wpis o segmentacji RFM), a udział marki w wydatkach klienta zmierz jak we wpisie o udziale w portfelu.
Udziały na poziomie sklepu i cen modeluje natomiast model atrakcyjności udziałów (MCI), a ścieżki kontaktów z kanałami – atrybucja łańcuchem Markowa.
Jak opisać w pracy
Podaj źródło danych, definicję przejścia (co z zakupami z jednego dnia), liczbę gospodarstw i przejść, macierz z liczbami, test jednorodności i założenia łańcucha. Ogólne wskazówki: statystyka w pracy z marketingu.
Kod R: macierz przejść, łańcuch Markowa, bootstrap i test jednorodności
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę, motyw i funkcję minus(), z których korzystają następne. Przepisy 2–7 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (set.seed(729)), 4 (set.seed(7291), 1000 prób bootstrapowych) i 6 (set.seed(7292), symulacja ciągów z łańcucha); ziarna ustalono raz i nie zmieniano. Ręcznie ustalono: 2500 gospodarstw, średnie preferencje marek (0.27, 0.23, 0.17, 0.14, 0.11, 0.08), rozrzut preferencji (Dirichlet, S = 3), wagę marek „swojej” grupy (× 2.5), 30% gospodarstw „wiernych” (ulubiona marka z szansą 0.95), szansę powtórzenia ostatniej marki u pozostałych (0.40), liczbę wizyt (ujemny dwumianowy, średnio 16 w roku), tygodnie promocji Zdrojki (30–33 i 42–45) i jej mnożnik (× 3), szansę drugiej marki tego samego dnia (0.07), próg 300 przejść na diagramie i próg odchylenia 2. Parametrów danych po pierwszym uruchomieniu nie zmieniano. Zmieniono jedną miarę: w panelu B Rysunku 4 pierwotnie liczyliśmy ponowny zakup Zdrojki przy dowolnym następnym zakupie (61.9% bez promocji i 60.6% w promocji); ponieważ następny zakup często wypadał jeszcze w tygodniu promocji, ograniczyliśmy porównanie do następnych zakupów w zwykłej cenie. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilka sekund.
1. Dane: panel 2500 gospodarstw i przejścia między zakupami
R
# Przepis 1. Fikcyjny panel: 2500 gospodarstw i kolejne zakupy jogurtów pitnych sześciu marek w 2025 r.
library(ggplot2)
options(width = 120)                                 # szerokie wydruki tabel

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw rysunków
kol <- c(niebieski = "#0072B2", pomarancz = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
         blekitny = "#56B4E9", ciemny = "#0f1d3a", szary = "grey55")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
minus <- function(x) gsub("-", "−", x)          # znak minus (−) w etykietach rysunków

# Parametry ustalone ręcznie (marki zmyślone)
marki <- c("Lazurka", "Pastwina", "Kremik", "Zdrojka", "Bystrza", "Tęczka")
grupa <- c("A", "B", "B", "A", "A", "B")             # A – naturalne i probiotyczne, B – owocowe i deserowe
udzial_bazowy <- c(.27, .23, .17, .14, .11, .08)     # średnie preferencje marek
n_gosp <- 2500
odsetek_lojalnych <- 0.30                            # gospodarstwa „wierne”: prawie zawsze ulubiona marka
p_ulubionej <- 0.95
bezwladnosc <- 0.40                                  # pozostali: szansa powtórzenia ostatniej marki
wzmocnienie_grupy <- 2.5                             # gospodarstwo woli marki ze „swojej” grupy (A albo B)
S <- 3                                               # rozrzut preferencji między gospodarstwami (Dirichlet)
tyg_promocji <- c(30:33, 42:45)                      # promocja Zdrojki: 8 tygodni drugiego półrocza
mnoznik_promocji <- 3                                # w tygodniu promocji szansa wyboru Zdrojki × 3 (nie dotyczy wiernych)
p_drugiej_marki <- 0.07                              # szansa, że w tym samym dniu kupiono drugą markę

set.seed(729)
wiersze <- vector("list", n_gosp)
for (h in seq_len(n_gosp)) {
  segment <- sample(c("A", "B"), 1)
  w <- udzial_bazowy * ifelse(grupa == segment, wzmocnienie_grupy, 1)
  pref <- rgamma(6, S * w / sum(w)); pref <- pref / sum(pref)      # preferencje gospodarstwa (Dirichlet)
  wierne <- runif(1) < odsetek_lojalnych
  ulubiona <- sample(6, 1, prob = pref)
  n <- rnbinom(1, mu = 15, size = 2) + 1                           # liczba wizyt z zakupem w roku
  dni <- sort(sample(1:364, n, replace = TRUE))
  marka <- integer(0); dzien <- integer(0); ostatnia <- NA
  for (d in dni) {
    promo <- ceiling(d / 7) %in% tyg_promocji
    if (wierne) {
      m <- if (runif(1) < p_ulubionej) ulubiona else sample(6, 1, prob = pref)
    } else if (!is.na(ostatnia) && runif(1) < bezwladnosc) {
      m <- ostatnia
    } else {
      pr <- pref; if (promo) pr[4] <- pr[4] * mnoznik_promocji
      m <- sample(6, 1, prob = pr)
    }
    kupione <- m
    if (runif(1) < p_drugiej_marki) {                              # druga marka w tym samym dniu
      druga <- sample(setdiff(1:6, m), 1, prob = pref[-m])
      kupione <- sample(c(m, druga))                               # kolejność na paragonie przypadkowa
    }
    marka <- c(marka, kupione); dzien <- c(dzien, rep(d, length(kupione)))
    ostatnia <- kupione[length(kupione)]
  }
  wiersze[[h]] <- data.frame(gospodarstwo = h, nr_zakupu = seq_along(marka), dzien = dzien, marka = marka,
                             wierne = wierne)
}
panel <- do.call(rbind, wiersze)
panel$tydzien <- ceiling(panel$dzien / 7)
panel$polrocze <- ifelse(panel$tydzien <= 26, "I", "II")
panel$promocja_zdrojki <- as.integer(panel$tydzien %in% tyg_promocji)
panel$marka <- factor(marki[panel$marka], levels = marki)
write.csv(panel[, c("gospodarstwo", "nr_zakupu", "dzien", "tydzien", "polrocze", "marka", "promocja_zdrojki")],
          "przechodzenie-miedzy-markami-panel-jogurty.csv", row.names = FALSE, fileEncoding = "UTF-8")

# Przejścia: zakup t → zakup t + 1 w tym samym gospodarstwie
nast <- c(panel$gospodarstwo[-1] == panel$gospodarstwo[-nrow(panel)], FALSE)
przejscia <- data.frame(gospodarstwo = panel$gospodarstwo[nast], z = panel$marka[nast],
                        do = panel$marka[which(nast) + 1], dzien = panel$dzien[which(nast) + 1],
                        ten_sam_dzien = panel$dzien[which(nast) + 1] == panel$dzien[nast],
                        polrocze = panel$polrocze[which(nast) + 1], promocja = panel$promocja_zdrojki[which(nast) + 1])
prz <- subset(przejscia, !ten_sam_dzien)            # do analizy: tylko przejścia między różnymi dniami

c(gospodarstwa = n_gosp, zakupy = nrow(panel), gosp_z_przejsciem = length(unique(przejscia$gospodarstwo)),
  przejscia = nrow(przejscia), w_tym_ten_sam_dzien = sum(przejscia$ten_sam_dzien), do_analizy = nrow(prz))
round(100 * prop.table(table(panel$polrocze, panel$marka), 1), 1)   # udziały marek w zakupach (%) w półroczach
Wynik w R
       gospodarstwa              zakupy   gosp_z_przejsciem           przejscia w_tym_ten_sam_dzien          do_analizy
               2500               42461                2473               39961                3914               36047

     Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
  I     27.6     22.4   17.0    13.2    11.1    8.7
  II    25.4     22.2   16.9    16.1    10.4    9.0
2. Macierz przejść, lojalność, odpływ i przyciąganie: Rysunek 1
R
# Przepis 2. Macierz przejść: liczby, odsetki w wierszach, lojalność, odpływ i przyciąganie: Rysunek 1
# Korzysta z prz, marki, kol, motyw (przepis 1).
N <- table(z = prz$z, do = prz$do)                   # wiersz – marka zakupu t, kolumna – marka zakupu t + 1
P <- prop.table(N, 1)                                # odsetki w wierszach = szacowane prawdopodobieństwa przejść
print(N)
print(round(100 * P, 1))

udzial <- 100 * colSums(N) / sum(N)                  # udział marki w zakupach t + 1 (%)
zmiany <- N; diag(zmiany) <- 0                       # tylko zmiany marki
wskazniki <- data.frame(marka = marki, udzial = udzial,
                        lojalnosc = 100 * diag(P),                       # zostaje przy marce
                        odplyw = 100 * (1 - diag(P)),                    # odchodzi do innej marki
                        przyciaganie = 100 * colSums(zmiany) / sum(zmiany))  # udział marki wśród wszystkich zmian
print(data.frame(marka = marki, round(wskazniki[-1], 1)), row.names = FALSE)
c(gospodarstwa = length(unique(prz$gospodarstwo)), zmiany_marki_proc = round(100 * sum(zmiany) / sum(N), 1))

mapa <- as.data.frame(N, responseName = "n")
mapa$proc <- as.vector(100 * P)
mapa$z <- factor(mapa$z, rev(marki))                 # pierwsza marka na górze
p1 <- ggplot(mapa, aes(do, z, fill = proc)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = sprintf("%.1f%%\n(%d)", proc, n), colour = proc > 45), size = 3.6, lineheight = 0.9) +
  scale_colour_manual(values = c(`TRUE` = "white", `FALSE` = "#0f1d3a"), guide = "none") +
  scale_fill_gradient("Odsetek przejść w wierszu (%)", low = "#f1f6fb", high = kol[["niebieski"]], limits = c(0, 100)) +
  scale_x_discrete("Marka przy następnym zakupie (t + 1)", position = "top") +
  labs(y = "Marka przy zakupie t", title = "Macierz przejść: skąd i dokąd idą kolejne zakupy",
       subtitle = sprintf("%d przejść między różnymi dniami, %d gospodarstw; w nawiasie – liczba przejść",
                         sum(N), length(unique(prz$gospodarstwo)))) +
  motyw + theme(panel.grid.major = element_blank(), legend.key.width = unit(1.6, "cm"))
p1
# ggsave("przejscia-macierz-mapa.svg", p1, width = 10, height = 6.4)
Wynik w R
          do
z          Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
  Lazurka     7015      678    524     679     503    257
  Pastwina     684     5815    599     377     259    311
  Kremik       528      633   4277     290     192    197
  Zdrojka      650      347    261    3567     241    155
  Bystrza      479      247    204     257    2544    109
  Tęczka       247      319    206     139     106   2151
          do
z          Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
  Lazurka     72.6      7.0    5.4     7.0     5.2    2.7
  Pastwina     8.5     72.3    7.4     4.7     3.2    3.9
  Kremik       8.6     10.3   69.9     4.7     3.1    3.2
  Zdrojka     12.4      6.6    5.0    68.3     4.6    3.0
  Bystrza     12.5      6.4    5.3     6.7    66.2    2.8
  Tęczka       7.8     10.1    6.5     4.4     3.3   67.9
    marka udzial lojalnosc odplyw przyciaganie
  Lazurka   26.6      72.6   27.4         24.2
 Pastwina   22.3      72.3   27.7         20.8
   Kremik   16.8      69.9   30.1         16.8
  Zdrojka   14.7      68.3   31.7         16.3
  Bystrza   10.7      66.2   33.8         12.2
   Tęczka    8.8      67.9   32.1          9.6
     gospodarstwa zmiany_marki_proc
           2471.0              29.6
3. Model niezależności i odchylenia standaryzowane: Rysunek 2
R
# Przepis 3. Porównanie z modelem niezależności: odchylenia standaryzowane: Rysunek 2
# Korzysta z N, marki, kol, motyw, minus() (przepisy 1–2).
# A. Model niezależności: następna marka wybierana zgodnie z udziałami, bez względu na poprzednią
E_niez <- outer(rowSums(N), colSums(N)) / sum(N)
R_niez <- (N - E_niez) / sqrt(E_niez)                # odchylenie standaryzowane (reszta Pearsona)
test_niez <- suppressWarnings(chisq.test(N))
data.frame(chi2 = round(unname(test_niez$statistic), 1), df = unname(test_niez$parameter),
           p = format.pval(test_niez$p.value, eps = .001))
round(R_niez, 1)

# B. Tylko zmiany marki: dokąd odchodzą klienci, gdyby wybierali nową markę proporcjonalnie do udziałów pozostałych
s <- colSums(N) / sum(N)
E_zm <- t(sapply(seq_along(marki), function(i) {
  e <- (rowSums(N)[i] - N[i, i]) * s / (1 - s[i]); e[i] <- NA; e }))
dimnames(E_zm) <- dimnames(N)
R_zm <- (N - E_zm) / sqrt(E_zm)
round(R_zm, 1)
chi2_zm <- sum(R_zm^2, na.rm = TRUE)
data.frame(chi2_zmiany = round(chi2_zm, 1), df = 6 * 4,                # 6 wierszy × (5 komórek − 1); orientacyjnie
           p = format.pval(pchisq(chi2_zm, 6 * 4, lower.tail = FALSE), eps = .001))

reszty <- rbind(
  data.frame(panel = "A. Model niezależności (wszystkie przejścia)", as.data.frame(as.table(R_niez), responseName = "r")),
  data.frame(panel = "B. Tylko zmiany marki (bez przekątnej)", as.data.frame(as.table(R_zm), responseName = "r")))
reszty$z <- factor(reszty$z, rev(marki))
reszty$etykieta <- ifelse(is.na(reszty$r), "", minus(sprintf("%.1f", reszty$r)))
reszty$r_obc <- pmax(pmin(reszty$r, 8), -8)          # kolor obcięty do ±8, liczby bez obcięcia
p2 <- ggplot(reszty, aes(do, z, fill = r_obc)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_text(aes(label = etykieta, colour = abs(r_obc) > 5.5), size = 3.3) +
  scale_colour_manual(values = c(`TRUE` = "white", `FALSE` = "#0f1d3a"), guide = "none") +
  scale_fill_gradient2("Odchylenie standaryzowane (kolor obcięty do ±8)", low = kol[["cynober"]], mid = "white",
                       high = kol[["niebieski"]], midpoint = 0, limits = c(-8, 8), na.value = "grey92",
                       labels = function(x) minus(x)) +
  facet_wrap(~panel, ncol = 2) +
  labs(x = "Marka przy następnym zakupie (t + 1)", y = "Marka przy zakupie t",
       title = "Które przejścia są częstsze, niż wynikałoby z udziałów?",
       subtitle = "Niebieskie – więcej przejść niż w modelu, czerwone – mniej; |odchylenie| > 2 – wyraźne") +
  motyw + theme(panel.grid.major = element_blank(), axis.text.x = element_text(angle = 45, hjust = 1),
                legend.key.width = unit(1.4, "cm"))
p2
# ggsave("przejscia-odchylenia-standaryzowane.svg", p2, width = 10, height = 6.4)
Wynik w R
   chi2 df       p
1 72646 25 < 0.001
          do
z          Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
  Lazurka     87.6    -31.8  -27.3   -19.7   -16.4  -20.4
  Pastwina   -31.5     94.9  -20.5   -23.5   -20.5  -15.0
  Kremik     -27.3    -19.8  101.2   -20.4   -18.0  -14.7
  Zdrojka    -19.9    -24.0  -20.9   100.9   -13.4  -14.2
  Bystrza    -17.0    -20.8  -17.4   -13.0   105.5  -12.5
  Tęczka     -20.5    -14.6  -14.2   -15.2   -12.6  111.9
          do
z          Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
  Lazurka              -4.4   -3.3     6.5     6.1   -3.4
  Pastwina    -2.9             5.3    -2.2    -2.7    3.6
  Kremik      -2.5      6.3           -2.0    -2.9    0.1
  Zdrojka      5.9     -4.1   -3.6             2.4   -1.2
  Bystrza      4.7     -4.3   -2.6     3.0           -1.7
  Tęczka      -2.9      4.5    1.3    -2.0    -1.2
  chi2_zmiany df       p
1       405.9 24 < 0.001
4. Rozkład stacjonarny i bootstrap gospodarstw: Rysunek 3
R
# Przepis 4. Łańcuch Markowa: rozkład stacjonarny a bieżące udziały, przedziały z bootstrapu gospodarstw: Rysunek 3
# Korzysta z prz, marki, kol, motyw (przepis 1).
stacjonarny <- function(P) {                         # lewy wektor własny P dla wartości własnej 1: π = πP
  e <- eigen(t(P)); v <- Re(e$vectors[, which.max(Re(e$values))]); v / sum(v)
}
# Liczby przejść każdego gospodarstwa jako wiersz 36 komórek – osobno dla I i II półrocza
gosp <- sort(unique(prz$gospodarstwo))
komorki <- function(d) {
  idx <- (as.integer(d$z) - 1) * 6 + as.integer(d$do)   # komórka (z, do) w kolejności wierszami
  unclass(table(factor(d$gospodarstwo, gosp), factor(idx, 1:36)))
}
C1 <- komorki(subset(prz, polrocze == "I")); C2 <- komorki(subset(prz, polrocze == "II"))
miary <- function(w) {                               # w – wagi gospodarstw (liczba wylosowań w próbie bootstrapowej)
  N1 <- matrix(colSums(C1 * w), 6, byrow = TRUE); N2 <- matrix(colSums(C2 * w), 6, byrow = TRUE)
  c(udzial_I = colSums(N1) / sum(N1), stac_I = stacjonarny(N1 / rowSums(N1)),
    udzial_II = colSums(N2) / sum(N2), stac_II = stacjonarny(N2 / rowSums(N2)))
}
ocena <- miary(rep(1, length(gosp)))
B <- 1000
set.seed(7291)
boot <- replicate(B, miary(tabulate(sample(length(gosp), replace = TRUE), length(gosp))))
ci <- apply(boot, 1, quantile, c(.025, .975))
wyn <- data.frame(marka = rep(marki, 4), miara = rep(c("udzial_I", "stac_I", "udzial_II", "stac_II"), each = 6),
                  ocena = 100 * ocena, dol = 100 * ci[1, ], gora = 100 * ci[2, ])
print(data.frame(wyn[1:2], round(wyn[3:5], 1)), row.names = FALSE)

# Zdrojka: różnica rozkład stacjonarny − bieżący udział w II półroczu i stacjonarny II − I (punkty procentowe)
roznica <- function(a, b) round(100 * c(ocena = unname(ocena[a] - ocena[b]), quantile(boot[a, ] - boot[b, ], c(.025, .975))), 1)
rbind(stac_II_minus_udzial_II = roznica("stac_II4", "udzial_II4"), stac_II_minus_stac_I = roznica("stac_II4", "stac_I4"))
# Kolejne zakupy przy macierzy z II półrocza: rozkład marek po 1, 3 i 10 krokach od udziałów z II półrocza
P2 <- matrix(colSums(C2), 6, byrow = TRUE); P2 <- P2 / rowSums(P2)
krok <- function(k) { x <- ocena[paste0("udzial_II", 1:6)]; for (i in seq_len(k)) x <- x %*% P2; 100 * as.vector(x) }
tab_krokow <- rbind(start = krok(0), po_1 = krok(1), po_3 = krok(3), po_10 = krok(10), stacjonarny = 100 * stacjonarny(P2))
colnames(tab_krokow) <- marki
round(tab_krokow, 1)

wyn$miara <- factor(wyn$miara, c("udzial_I", "stac_I", "udzial_II", "stac_II"),
                    c("Udział w zakupach, I półrocze", "Rozkład stacjonarny, I półrocze",
                      "Udział w zakupach, II półrocze (z promocją)", "Rozkład stacjonarny, II półrocze (z promocją)"))
wyn$marka <- factor(wyn$marka, rev(marki))
p3 <- ggplot(wyn, aes(ocena, marka, colour = miara, shape = miara)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), orientation = "y", width = 0, linewidth = 0.7,
                position = position_dodge(width = 0.7)) +
  geom_point(size = 2.8, position = position_dodge(width = 0.7)) +
  scale_colour_manual(NULL, values = c(kol[["szary"]], kol[["niebieski"]], kol[["pomarancz"]], kol[["cynober"]])) +
  scale_shape_manual(NULL, values = c(1, 16, 2, 17)) +
  scale_x_continuous("Udział (%) z 95% przedziałem z bootstrapu gospodarstw", breaks = seq(0, 30, 5)) +
  labs(y = NULL, title = "Dokąd zmierza rynek, jeśli przejścia się nie zmienią?",
       subtitle = "Rozkład stacjonarny łańcucha Markowa a bieżące udziały; 1000 prób bootstrapowych") +
  guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2)) + motyw
p3
# ggsave("przejscia-rozklad-stacjonarny.svg", p3, width = 10, height = 6.6)
Wynik w R
    marka     miara ocena  dol gora
  Lazurka  udzial_I  27.8 26.3 29.3
 Pastwina  udzial_I  22.4 21.0 23.9
   Kremik  udzial_I  16.8 15.5 18.2
  Zdrojka  udzial_I  13.2 12.1 14.4
  Bystrza  udzial_I  11.1 10.0 12.3
   Tęczka  udzial_I   8.6  7.7  9.6
  Lazurka    stac_I  27.8 26.0 29.6
 Pastwina    stac_I  22.3 20.7 24.0
   Kremik    stac_I  16.6 15.1 18.2
  Zdrojka    stac_I  13.4 12.2 14.8
  Bystrza    stac_I  11.2  9.9 12.4
   Tęczka    stac_I   8.7  7.7  9.7
  Lazurka udzial_II  25.6 24.0 27.2
 Pastwina udzial_II  22.2 20.8 23.6
   Kremik udzial_II  16.9 15.6 18.1
  Zdrojka udzial_II  16.1 14.9 17.5
  Bystrza udzial_II  10.2  9.1 11.3
   Tęczka udzial_II   9.0  8.0 10.0
  Lazurka   stac_II  25.2 23.5 26.9
 Pastwina   stac_II  22.2 20.5 23.8
   Kremik   stac_II  16.6 15.2 18.0
  Zdrojka   stac_II  16.7 15.4 18.1
  Bystrza   stac_II  10.3  9.1 11.5
   Tęczka   stac_II   9.1  8.0 10.2
                        ocena 2.5% 97.5%
stac_II_minus_udzial_II   0.6  0.1   1.1
stac_II_minus_stac_I      3.3  2.1   4.6
            Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
start          25.6     22.2   16.9    16.1    10.2    9.0
po_1           25.5     22.2   16.8    16.3    10.2    9.0
po_3           25.3     22.2   16.6    16.5    10.3    9.0
po_10          25.2     22.2   16.6    16.7    10.3    9.1
stacjonarny    25.2     22.2   16.6    16.7    10.3    9.1
5. Test jednorodności i efekt promocji: Rysunek 4
R
# Przepis 5. Czy macierz jest taka sama w obu półroczach? Test jednorodności i efekt promocji Zdrojki: Rysunek 4
# Korzysta z panel, prz, marki, kol, motyw (przepis 1) i P (przepis 2).
library(patchwork)
N1 <- table(subset(prz, polrocze == "I")[, c("z", "do")]); N2 <- table(subset(prz, polrocze == "II")[, c("z", "do")])
jednorodnosc <- t(sapply(marki, function(m) {        # dla każdej marki wyjściowej: tabela 2 półrocza × 6 marek
  t2 <- suppressWarnings(chisq.test(rbind(N1[m, ], N2[m, ])))
  c(chi2 = unname(t2$statistic), df = unname(t2$parameter), p = t2$p.value)
}))
print(round(jednorodnosc, 3))
chi2 <- sum(jednorodnosc[, "chi2"]); df <- sum(jednorodnosc[, "df"])
data.frame(chi2 = round(chi2, 1), df = df, p = round(pchisq(chi2, df, lower.tail = FALSE), 3))
round(100 * (prop.table(N2, 1) - prop.table(N1, 1)), 1)       # zmiana odsetków przejść: II − I (pp)

# Promocja (tylko II półrocze): przejścia do Zdrojki w tygodniach z promocją i bez niej
h2 <- subset(prz, polrocze == "II" & z != "Zdrojka")
do_zdrojki <- do.call(rbind, lapply(setdiff(marki, "Zdrojka"), function(m) {
  d <- subset(h2, z == m)
  do.call(rbind, lapply(c(0, 1), function(pr) {
    x <- sum(d$do[d$promocja == pr] == "Zdrojka"); n <- sum(d$promocja == pr)
    ci <- prop.test(x, n)$conf.int
    data.frame(z = m, promocja = pr, x = x, n = n, proc = 100 * x / n, dol = 100 * ci[1], gora = 100 * ci[2])
  }))
}))
print(data.frame(do_zdrojki[1:4], round(do_zdrojki[5:7], 1)), row.names = FALSE)

# Czy klienci przyciągnięci promocją zostają? Zakup Zdrojki po innej marce i czy następny zakup – już poza
# tygodniami promocji, czyli w zwykłej cenie – to znów Zdrojka
n <- nrow(panel); g <- panel$gospodarstwo; d <- panel$dzien
poprz <- c(NA, ifelse(g[-1] == g[-n] & d[-1] != d[-n], seq_len(n - 1), NA))   # poprzedni zakup (inny dzień)
nastepny <- c(ifelse(g[-n] == g[-1] & d[-n] != d[-1], 2:n, NA), NA)          # następny zakup (inny dzień)
wejscie <- which(panel$marka == "Zdrojka" & panel$polrocze == "II" & !is.na(poprz) & !is.na(nastepny))
wejscie <- wejscie[panel$marka[poprz[wejscie]] != "Zdrojka"]
# Pierwsza wersja miary: dowolny następny zakup (często jeszcze w tygodniu promocji) – ponowny zakup Zdrojki (%)
round(100 * tapply(panel$marka[nastepny[wejscie]] == "Zdrojka", panel$promocja_zdrojki[wejscie], mean), 1)
wejscie <- wejscie[panel$promocja_zdrojki[nastepny[wejscie]] == 0]   # wersja ostateczna: następny zakup bez promocji
zostaje <- panel$marka[nastepny[wejscie]] == "Zdrojka"
promo_wejscia <- panel$promocja_zdrojki[wejscie]
po_wejsciu <- do.call(rbind, lapply(c(0, 1), function(pr) {
  x <- sum(zostaje[promo_wejscia == pr]); m <- sum(promo_wejscia == pr); ci <- prop.test(x, m)$conf.int
  data.frame(promocja = pr, x = x, n = m, proc = 100 * x / m, dol = 100 * ci[1], gora = 100 * ci[2])
}))
print(data.frame(po_wejsciu[1:3], round(po_wejsciu[4:6], 1)), row.names = FALSE)
test_po <- prop.test(po_wejsciu$x, po_wejsciu$n)
c(roznica_pp = round(po_wejsciu$proc[1] - po_wejsciu$proc[2], 1),      # bez promocji − w promocji
  ci_dol = round(100 * test_po$conf.int[1], 1), ci_gora = round(100 * test_po$conf.int[2], 1),
  p = round(test_po$p.value, 3))
c(lojalnosc_zdrojki = round(100 * P["Zdrojka", "Zdrojka"], 1))

etyk <- c(`0` = "Tygodnie bez promocji", `1` = "Tygodnie promocji Zdrojki")
do_zdrojki$promocja <- factor(etyk[as.character(do_zdrojki$promocja)], etyk)
do_zdrojki$z <- factor(do_zdrojki$z, rev(setdiff(marki, "Zdrojka")))
po_wejsciu$promocja <- factor(etyk[as.character(po_wejsciu$promocja)], etyk)
pa <- ggplot(do_zdrojki, aes(proc, z, colour = promocja, shape = promocja)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), orientation = "y", width = 0, linewidth = 0.7,
                position = position_dodge(width = 0.5)) +
  geom_point(size = 3, position = position_dodge(width = 0.5)) +
  scale_colour_manual(NULL, values = c(kol[["szary"]], kol[["cynober"]])) + scale_shape_manual(NULL, values = c(16, 17)) +
  labs(x = "Następny zakup to Zdrojka (%)", y = "Marka przy zakupie t", title = "A. Przejścia do Zdrojki") + motyw
pb <- ggplot(po_wejsciu, aes(promocja, proc, colour = promocja, shape = promocja)) +
  geom_hline(yintercept = 100 * P["Zdrojka", "Zdrojka"], linetype = "dashed", colour = "grey40") +
  annotate("text", x = 0.55, y = 100 * P["Zdrojka", "Zdrojka"] + 3, hjust = 0, size = 3.3, colour = "grey30",
           label = sprintf("wszyscy kupujący Zdrojkę: %.1f%%", 100 * P["Zdrojka", "Zdrojka"])) +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0, linewidth = 0.7) + geom_point(size = 3.4) +
  geom_text(aes(label = sprintf("%.1f%%\n(%d z %d)", proc, x, n)), nudge_x = 0.3, size = 3.3, colour = "#0f1d3a",
            lineheight = 0.9) +
  scale_colour_manual(NULL, values = c(kol[["szary"]], kol[["cynober"]]), guide = "none") +
  scale_shape_manual(NULL, values = c(16, 17), guide = "none") +
  scale_x_discrete(labels = c("Bez\npromocji", "W promocji")) +
  scale_y_continuous(limits = c(0, 80)) +
  labs(x = "Zakup Zdrojki po innej marce", y = "Następny zakup (bez promocji) to Zdrojka (%)", title = "B. Czy zostają?") + motyw
p4 <- (pa | pb) + plot_layout(widths = c(1.5, 1), guides = "collect") +
  plot_annotation(title = "Promocja Zdrojki w II półroczu: więcej przejść – a czy klienci zostają?",
                  subtitle = "Przejścia między różnymi dniami; 95% przedziały ufności dla odsetków",
                  theme = motyw) & theme(legend.position = "bottom")
p4
# ggsave("przejscia-promocja-zdrojki.svg", p4, width = 10, height = 5.8)
Wynik w R
           chi2 df     p
Lazurka  10.050  5 0.074
Pastwina  8.275  5 0.142
Kremik    8.727  5 0.120
Zdrojka   9.198  5 0.101
Bystrza   5.973  5 0.309
Tęczka    5.806  5 0.326
  chi2 df    p
1   48 30 0.02
          do
z          Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
  Lazurka     -0.9      0.3    0.5     1.2    -0.6   -0.5
  Pastwina    -0.6      0.3   -0.4     1.0    -0.6    0.3
  Kremik       0.1     -1.1   -0.2     1.0     0.7   -0.5
  Zdrojka     -2.5      0.2   -0.3     2.2    -0.1    0.5
  Bystrza     -0.8     -0.1    0.5     1.8    -1.2   -0.2
  Tęczka      -2.1     -0.4    0.0     0.4    -0.3    2.5
        z promocja   x    n proc dol gora
  Lazurka        0 208 3451  6.0 5.3  6.9
  Lazurka        1 168 1486 11.3 9.8 13.1
 Pastwina        0 111 2958  3.8 3.1  4.5
 Pastwina        1 108 1273  8.5 7.0 10.2
   Kremik        0  92 2233  4.1 3.4  5.1
   Kremik        1  77 1013  7.6 6.1  9.5
  Bystrza        0  95 1362  7.0 5.7  8.5
  Bystrza        1  53  589  9.0 6.9 11.7
   Tęczka        0  35 1214  2.9 2.0  4.0
   Tęczka        1  43  499  8.6 6.4 11.5
   0    1
61.9 60.6
 promocja   x   n proc  dol gora
        0 173 295 58.6 52.8 64.3
        1  94 175 53.7 46.0 61.2
roznica_pp     ci_dol    ci_gora          p
     4.900     -4.800     14.700      0.344
lojalnosc_zdrojki
             68.3
6. Pułapki: niejednakowe gospodarstwa i zakupy z jednego dnia: Rysunek 5
R
# Przepis 6. Pułapka: gospodarstwa nie są jednakowe. Powtórzenie marki po k zakupach – dane a łańcuch Markowa: Rysunek 5
# Korzysta z panel, przejscia, marki, kol, motyw (przepis 1) i P (przepis 2). Kolumna wierne to „prawda” znana tylko z symulacji.
n <- nrow(panel); g <- panel$gospodarstwo
powtorzenie <- do.call(rbind, lapply(1:8, function(k) {
  i <- which(g[seq_len(n - k)] == g[-seq_len(k)] & panel$dzien[seq_len(n - k)] != panel$dzien[-seq_len(k)])
  ta_sama <- panel$marka[i] == panel$marka[i + k]
  f <- prop.table(table(panel$marka[i]))                   # rozkład marek w punkcie wyjścia
  Pk <- diag(length(marki)); for (j in seq_len(k)) Pk <- Pk %*% P
  rbind(data.frame(k = k, linia = "Dane: wszystkie gospodarstwa", proc = 100 * mean(ta_sama)),
        data.frame(k = k, linia = "Łańcuch Markowa (P do potęgi k)", proc = 100 * sum(f * diag(Pk))),
        data.frame(k = k, linia = "Dane: gospodarstwa „wierne” (ukryte)", proc = 100 * mean(ta_sama[panel$wierne[i]])),
        data.frame(k = k, linia = "Dane: pozostałe gospodarstwa (ukryte)", proc = 100 * mean(ta_sama[!panel$wierne[i]])))
}))
powtorzenie$linia <- factor(powtorzenie$linia, unique(powtorzenie$linia))
round(xtabs(proc ~ linia + k, powtorzenie), 1)       # wiersze – linie rysunku, kolumny – odstęp k

# Gospodarstwa z co najmniej 6 zakupami: ile kupiło przez cały rok tylko jedną markę – dane a symulacja z łańcucha
gosp <- split(panel, panel$gospodarstwo)
gosp <- gosp[sapply(gosp, nrow) >= 6]
jedna_dane <- sapply(gosp, function(x) length(unique(x$marka)) == 1)
set.seed(7292)
jedna_lancuch <- sapply(gosp, function(x) {               # ten sam start i ta sama liczba zakupów, przejścia z P
  m <- as.integer(x$marka[1])
  for (j in 2:nrow(x)) m <- c(m, sample(length(marki), 1, prob = P[m[j - 1], ]))
  length(unique(m)) == 1
})
c(gospodarstwa = length(gosp), tylko_jedna_marka_dane = round(100 * mean(jedna_dane), 1),
  tylko_jedna_marka_lancuch = round(100 * mean(jedna_lancuch), 1),
  wierne_wsrod_nich = round(100 * mean(sapply(gosp, function(x) x$wierne[1])[jedna_dane]), 1))


# Zakupy kilku marek tego samego dnia: kolejność na paragonie jest przypadkowa. Co, jeśli policzyć też takie pary?
# Korzysta z przejscia (przepis 1).
P_wszystkie <- prop.table(table(przejscia$z, przejscia$do), 1)
round(100 * rbind(bez_par_z_jednego_dnia = diag(P), z_parami_z_jednego_dnia = diag(P_wszystkie)), 1)
c(pary_z_jednego_dnia = sum(przejscia$ten_sam_dzien),
  w_tym_zmiana_marki_proc = round(100 * mean(przejscia$z[przejscia$ten_sam_dzien] != przejscia$do[przejscia$ten_sam_dzien]), 1))

p5 <- ggplot(powtorzenie, aes(k, proc, colour = linia, shape = linia, linetype = linia)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_colour_manual(NULL, values = c(kol[["ciemny"]], kol[["cynober"]], kol[["niebieski"]], kol[["pomarancz"]])) +
  scale_shape_manual(NULL, values = c(16, 17, 15, 18)) +
  scale_linetype_manual(NULL, values = c("solid", "dashed", "dotted", "dotted")) +
  scale_x_continuous("Odstęp: o ile zakupów później (k)", breaks = 1:8) +
  scale_y_continuous("Ta sama marka co przy zakupie t (%)", limits = c(0, 100)) +
  labs(title = "Łańcuch zakłada jednakowe gospodarstwa – i zbyt szybko „zapomina” markę",
       subtitle = "Odsetek par zakupów (t, t + k) z tą samą marką: dane, przewidywanie z macierzy P i dwie ukryte grupy") +
  guides(colour = guide_legend(ncol = 2), shape = guide_legend(ncol = 2), linetype = guide_legend(ncol = 2)) + motyw
p5
# ggsave("przejscia-heterogenicznosc-gospodarstw.svg", p5, width = 10, height = 6)
Wynik w R
                                       k
linia                                      1    2    3    4    5    6    7    8
  Dane: wszystkie gospodarstwa          70.4 57.8 54.8 53.0 53.0 53.0 52.7 52.3
  Łańcuch Markowa (P do potęgi k)       70.4 51.6 39.8 32.3 27.5 24.4 22.5 21.2
  Dane: gospodarstwa „wierne” (ukryte)  87.9 82.6 82.7 82.4 82.6 82.8 82.6 82.0
  Dane: pozostałe gospodarstwa (ukryte) 63.3 47.7 43.4 41.0 40.8 40.7 40.4 40.0
             gospodarstwa    tylko_jedna_marka_dane tylko_jedna_marka_lancuch         wierne_wsrod_nich
                   2179.0                       8.3                       2.8                      72.9
                        Lazurka Pastwina Kremik Zdrojka Bystrza Tęczka
bez_par_z_jednego_dnia     72.6     72.3   69.9    68.3    66.2   67.9
z_parami_z_jednego_dnia    68.2     67.7   65.1    63.3    61.5   63.2
    pary_z_jednego_dnia w_tym_zmiana_marki_proc
                 3914.0                    77.6
7. Grafika: diagram przepływów: Rysunek 6
R
# Przepis 7. Grafika: diagram przepływów między markami: Rysunek 6
# Korzysta z N, P, wskazniki (przepis 2), R_zm (przepis 3), marki, grupa, kol, motyw (przepis 1).
# Położenie kół ustalone ręcznie: grupa A po lewej, grupa B po prawej
xy <- rbind(Lazurka = c(-0.9, 0.7), Zdrojka = c(-1.75, -0.45), Bystrza = c(-0.55, -0.8),
            Pastwina = c(0.9, 0.7), Kremik = c(1.75, -0.45), Tęczka = c(0.55, -0.8))
wezly <- data.frame(marka = marki, grupa = grupa, x = xy[marki, 1], y = xy[marki, 2],
                    udzial = wskazniki$udzial, lojalnosc = wskazniki$lojalnosc)
wezly$r <- 0.12 + 0.008 * wezly$udzial                # promień koła rośnie z udziałem w zakupach
wezly$y_tekst <- ifelse(wezly$y > 0, wezly$y + wezly$r + 0.16, wezly$y - wezly$r - 0.16)
krawedzie <- subset(as.data.frame(N, responseName = "n"), z != do & n >= 300)
krawedzie$reszta <- R_zm[cbind(as.character(krawedzie$z), as.character(krawedzie$do))]
krawedzie$typ <- ifelse(krawedzie$reszta > 2, "więcej niż z udziałów (odchylenie > 2)", "zgodnie z udziałami lub mniej")
a <- wezly[match(krawedzie$z, wezly$marka), ]; b <- wezly[match(krawedzie$do, wezly$marka), ]
dl <- sqrt((b$x - a$x)^2 + (b$y - a$y)^2)
krawedzie$x <- a$x + (b$x - a$x) * (a$r + 0.03) / dl; krawedzie$y <- a$y + (b$y - a$y) * (a$r + 0.03) / dl
krawedzie$xend <- b$x - (b$x - a$x) * (b$r + 0.05) / dl; krawedzie$yend <- b$y - (b$y - a$y) * (b$r + 0.05) / dl
print(krawedzie[order(-krawedzie$n), c("z", "do", "n", "typ")], row.names = FALSE)

okrag <- do.call(rbind, lapply(seq_len(nrow(wezly)), function(i)
  data.frame(marka = wezly$marka[i], grupa = wezly$grupa[i], t = seq(0, 2 * pi, length.out = 60),
             x0 = wezly$x[i], y0 = wezly$y[i], r = wezly$r[i])))
okrag$x <- okrag$x0 + okrag$r * cos(okrag$t); okrag$y <- okrag$y0 + okrag$r * sin(okrag$t)
p6 <- ggplot() +
  geom_curve(data = krawedzie, aes(x, y, xend = xend, yend = yend, linewidth = n, colour = typ), curvature = 0.18,
             arrow = arrow(length = unit(0.22, "cm"), type = "closed"), lineend = "butt") +
  geom_polygon(data = okrag, aes(x, y, group = marka, fill = grupa), colour = "white", linewidth = 0.8) +
  geom_text(data = wezly, aes(x, y, label = marka), colour = "white", fontface = "bold", size = 3.2) +
  geom_text(data = wezly, aes(x, y_tekst, label = sprintf("udział %.1f%%\nzostaje %.1f%%", udzial, lojalnosc)),
            size = 3.2, colour = "#0f1d3a", lineheight = 0.9) +
  annotate("text", x = -1.2, y = 1.5, label = "Grupa A: naturalne i probiotyczne", fontface = "bold", size = 3.6,
           colour = kol[["niebieski"]]) +
  annotate("text", x = 1.2, y = 1.5, label = "Grupa B: owocowe i deserowe", fontface = "bold", size = 3.6,
           colour = kol[["cynober"]]) +
  scale_fill_manual(values = c(A = kol[["niebieski"]], B = kol[["cynober"]]), guide = "none") +
  scale_colour_manual(NULL, values = c("więcej niż z udziałów (odchylenie > 2)" = "#0f1d3a",
                                       "zgodnie z udziałami lub mniej" = "grey70")) +
  scale_linewidth_continuous("Liczba przejść", range = c(0.4, 2.6), limits = c(300, 700),
                             breaks = c(300, 500, 700)) +
  coord_equal(xlim = c(-2.2, 2.2), ylim = c(-1.45, 1.55)) +
  labs(x = NULL, y = NULL, title = "Kto do kogo przechodzi: przepływy między markami jogurtów pitnych",
       subtitle = "Strzałki – zmiany marki (pary z co najmniej 300 przejściami); wielkość koła – udział w zakupach") +
  guides(colour = guide_legend(ncol = 1, order = 1), linewidth = guide_legend(order = 2)) +
  motyw + theme(panel.grid.major = element_blank(), axis.text = element_blank(), legend.box = "vertical")
p6
# ggsave("przejscia-diagram-przeplywow.svg", p6, width = 10, height = 7.2)
Wynik w R
        z       do   n                                    typ
 Pastwina  Lazurka 684          zgodnie z udziałami lub mniej
  Lazurka  Zdrojka 679 więcej niż z udziałów (odchylenie > 2)
  Lazurka Pastwina 678          zgodnie z udziałami lub mniej
  Zdrojka  Lazurka 650 więcej niż z udziałów (odchylenie > 2)
   Kremik Pastwina 633 więcej niż z udziałów (odchylenie > 2)
 Pastwina   Kremik 599 więcej niż z udziałów (odchylenie > 2)
   Kremik  Lazurka 528          zgodnie z udziałami lub mniej
  Lazurka   Kremik 524          zgodnie z udziałami lub mniej
  Lazurka  Bystrza 503 więcej niż z udziałów (odchylenie > 2)
  Bystrza  Lazurka 479 więcej niż z udziałów (odchylenie > 2)
 Pastwina  Zdrojka 377          zgodnie z udziałami lub mniej
  Zdrojka Pastwina 347          zgodnie z udziałami lub mniej
   Tęczka Pastwina 319 więcej niż z udziałów (odchylenie > 2)
 Pastwina   Tęczka 311 więcej niż z udziałów (odchylenie > 2)
8. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Przepis 8. Kontrola palety: symulacja zaburzeń widzenia barw
library(colorspace)
pary <- list("grupa A – grupa B" = c("#0072B2", "#D55E00"),
             "bez promocji – promocja" = c("grey55", "#D55E00"),
             "udział I – stacjonarny I" = c("grey55", "#0072B2"),
             "udział II – stacjonarny II" = c("#E69F00", "#D55E00"),
             "„wierne” – pozostałe" = c("#0072B2", "#E69F00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
col2hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(col2hex(k)), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(col2hex(k))),
                                   protanopia = roznica(protan(col2hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
grupa A – grupa B                          114.6        108.3       91.9
bez promocji – promocja                     76.8         62.6       54.8
udział I – stacjonarny I                    43.2         47.1       39.2
udział II – stacjonarny II                  33.4         18.4       24.9
„wierne” – pozostałe                       120.2        121.5      109.3
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, test chi-kwadrat (chisq.test), przedziały dla odsetków (prop.test) i wektory własne (eigen) – pakiet stats i funkcje podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Zakupy kilku marek naraz. 3914 par zakupów pochodzi z tego samego dnia, a 77.6% z nich to zmiana marki – często po prostu dwie marki w jednym koszyku. Gdybyś je policzył, lojalność spadłaby o ok. 4–5 pp (Lazurka: 68.2% zamiast 72.6%). Pomiń takie pary albo traktuj wizytę jako jedną obserwację.
- Jednakowe gospodarstwa. Rysunek 5: jedna macierz zaniża trwałość lojalności. Sprawdź powtórzenia po k zakupach albo dopasuj mieszaninę.
- Zależne obserwacje. Gospodarstwo daje kilkanaście przejść, więc zwykłe testy chi-kwadrat są zbyt optymistyczne. Przedziały licz bootstrapem gospodarstw albo z błędami odpornymi na klastrowanie.
- Rząd łańcucha. Zakup może zależeć od dwóch poprzednich. Test rzędu podali Anderson i Goodman (1957); stan ukryty rozważ w ukrytym modelu Markowa.
- Zmiana macierzy w czasie. Promocje, nowe marki i sezon zmieniają przejścia; rozkład stacjonarny z jednego okresu nie przewiduje następnego.
Najczęstsze pytania
Co to jest macierz przejść między markami?
To tabela krzyżowa, w której wiersz oznacza markę kupioną przy zakupie t, a kolumna – markę przy następnym zakupie tego samego gospodarstwa. Odsetki w wierszu są szacowanymi prawdopodobieństwami przejść: na przekątnej leży lojalność (powtórny zakup marki), poza nią – odpływ do konkretnych marek.
Jak policzyć lojalność, odpływ i przyciąganie marki?
Lojalność to odsetek na przekątnej (np. 72.6% dla Lazurki), odpływ to 1 minus lojalność, a przyciąganie – udział marki wśród wszystkich zmian marki. W przykładzie Zdrojka miała 14.7% udziału w zakupach, ale 16.3% udziału wśród zmian marki, czyli przyciągała więcej, niż wynikałoby z jej wielkości.
Co to jest rozkład stacjonarny łańcucha Markowa w marketingu?
To udziały marek, przy których przepływy między markami się równoważą (π = πP). Pokazuje, dokąd zmierzałyby udziały, gdyby prawdopodobieństwa przejść się nie zmieniały. To scenariusz, a nie prognoza: wymaga stałej macierzy i jednakowych klientów, więc podawaj go z przedziałem (np. z bootstrapu gospodarstw) i założeniami.
Jak sprawdzić, czy macierz przejść zmieniła się w czasie?
Dla każdej marki wyjściowej porównaj rozkład następnych marek w dwóch okresach testem chi-kwadrat (tabela 2 × liczba marek) i zsumuj statystyki – to test stałości przejść Andersona i Goodmana. W przykładzie χ²(30) = 48.0, p = .020: w II półroczu, z promocją Zdrojki, rosły przejścia do tej marki.
Dlaczego łańcuch Markowa źle przewiduje lojalność klientów?
Bo zakłada, że wszystkie gospodarstwa przechodzą między markami z tymi samymi prawdopodobieństwami. Gdy część klientów jest bardzo wierna, a część często zmienia markę, jedna macierz za szybko „zapomina” markę. Pomaga model mieszaniny, np. model „ruchliwi–stali” (mover-stayer) albo klasy lojalnych i zmieniających markę.
Powiązane hasła
Przeczytaj też
Prawo podwójnego zagrożenia
Osiem marek makaronu w panelu 3000 gospodarstw: penetracja i częstość, NBD, model Dirichleta ręcznie, marki niszowe i „na zmianę” – z kodem R.
Czytaj →PoradnikModel atrakcyjności udziałów (MCI)
Rynek proszków do prania: udział jako atrakcyjność, log-centrowanie, elastyczności krzyżowe, symulacja obniżki ceny i logit udziałów – z kodem R.
Czytaj →PoradnikSegmentacja RFM: kwintyle czy model
125 komórek RFM, wynik sumaryczny i regresja ujemna dwumianowa ocenione na kolejnym półroczu – gain, lift, kalibracja i kod R.
Czytaj →Masz w pracy dane o zakupach lub wyborach marek?
Pomożemy zbudować macierz przejść, sprawdzić jej stałość, policzyć rozkład stacjonarny z przedziałami i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Anderson, T. W., & Goodman, L. A. (1957). Statistical inference about Markov chains. The Annals of Mathematical Statistics, 28(1), 89–110. https://doi.org/10.1214/aoms/1177707039 ● Otwarty dostęp
- Colombo, R. A., & Morrison, D. G. (1989). A brand switching model with implications for marketing strategies. Marketing Science, 8(1), 89–99. https://doi.org/10.1287/mksc.8.1.89
- Ehrenberg, A. S. C. (1965). An appraisal of Markov brand-switching models. Journal of Marketing Research, 2(4), 347–362. https://doi.org/10.1177/002224376500200402
- Ehrenberg, A. S. C., Goodhardt, G. J., & Barwise, T. P. (1990). Double jeopardy revisited. Journal of Marketing, 54(3), 82–91. https://doi.org/10.1177/002224299005400307
- Field, C. A., & Welsh, A. H. (2007). Bootstrapping clustered data. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 69(3), 369–390. https://doi.org/10.1111/j.1467-9868.2007.00593.x
- Frydman, H. (1984). Maximum likelihood estimation in the mover-stayer model. Journal of the American Statistical Association, 79(387), 632–638. https://doi.org/10.1080/01621459.1984.10478090
- van Heerde, H. J., Gupta, S., & Wittink, D. R. (2003). Is 75% of the sales promotion bump due to brand switching? No, only 33% is. Journal of Marketing Research, 40(4), 481–491. https://doi.org/10.1509/jmkr.40.4.481.19386
Cytowania BibTeX
@article{anderson1957statistical, author={Anderson, T. W. and Goodman, Leo A.}, title={{Statistical inference about Markov chains}}, journal={The Annals of Mathematical Statistics}, year={1957}, volume={28}, number={1}, pages={89--110}, doi={10.1214/aoms/1177707039}}@article{colombo1989brand, author={Colombo, Richard A. and Morrison, Donald G.}, title={{A brand switching model with implications for marketing strategies}}, journal={Marketing Science}, year={1989}, volume={8}, number={1}, pages={89--99}, doi={10.1287/mksc.8.1.89}}@article{ehrenberg1965appraisal, author={Ehrenberg, A. S. C.}, title={{An appraisal of Markov brand-switching models}}, journal={Journal of Marketing Research}, year={1965}, volume={2}, number={4}, pages={347--362}, doi={10.1177/002224376500200402}}@article{ehrenberg1990double, author={Ehrenberg, Andrew S. C. and Goodhardt, Gerald J. and Barwise, T. Patrick}, title={{Double jeopardy revisited}}, journal={Journal of Marketing}, year={1990}, volume={54}, number={3}, pages={82--91}, doi={10.1177/002224299005400307}}@article{field2007bootstrapping, author={Field, Christopher A. and Welsh, Alan H.}, title={{Bootstrapping clustered data}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2007}, volume={69}, number={3}, pages={369--390}, doi={10.1111/j.1467-9868.2007.00593.x}}@article{frydman1984maximum, author={Frydman, Halina}, title={{Maximum likelihood estimation in the mover-stayer model}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={632--638}, doi={10.1080/01621459.1984.10478090}}@article{vanheerde2003is, author={van Heerde, Harald J. and Gupta, Sachin and Wittink, Dick R.}, title={{Is 75\% of the sales promotion bump due to brand switching? No, only 33\% is}}, journal={Journal of Marketing Research}, year={2003}, volume={40}, number={4}, pages={481--491}, doi={10.1509/jmkr.40.4.481.19386}}