Przykład: pięć proszków do prania w trzech sieciach
Fikcyjny producent proszku do prania marki C ma dane z trzech sieci handlowych za 104 tygodnie. Na półce stoi pięć fikcyjnych marek: A (lider), B (premium), C (średnia półka), D (tania) i E (nowa marka ekologiczna, która dopiero zdobywa sklepy). Dla każdej sieci, tygodnia i marki znamy cenę za kilogram, obecność w gazetce, dystrybucję ważoną (jaka część obrotu kategorii przypada na sklepy z marką na półce) i sprzedaż w kilogramach. Dyrektor pyta: ile udziału da obniżka ceny C o 10% i komu go zabierze?
1560 wierszy (3 sieci × 104 tygodnie × 5 marek) pobierzesz jako mci-proszki-sieci-tygodnie.csv.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Ręcznie ustaliliśmy m.in. ceny regularne (5.00–12.00 zł/kg), udziały przy cenach regularnych (30, 14, 24, 22 i 10%), wykładniki ceny marek (−2.0, −1.4, −2.6, −3.0 i −1.6), efekt gazetki (0.40), wykładnik dystrybucji (1.10) i siłę reakcji ceny na popyt w pułapce z rysunku 6 (0.5); pełna lista jest przy kodzie. Parametrów nie zmienialiśmy po pierwszym uruchomieniu kodu; ziarno 691 ustaliliśmy raz.
Wpis o elastyczności cenowej liczy reakcję sprzedaży jednego produktu. Tu patrzymy na cały rynek: zysk jednej marki jest stratą innych.
Rysunek 1: od atrakcyjności do udziału
Model atrakcyjności udziałów (MCI, multiplicative competitive interaction) zakłada, że każda marka ma w danym tygodniu atrakcyjność zależną od jej działań, a jej udział to atrakcyjność podzielona przez sumę atrakcyjności wszystkich marek:
Słowami: αi to siła marki „sama w sobie”, βi (ujemne) mówi, jak mocno atrakcyjność spada z ceną, γ – ile dodaje gazetka, a δ – ile dodaje obecność w sklepach. Bell, Keeney i Little (1975) wyprowadzili tę zasadę z trzech prostych założeń, m.in. że atrakcyjność jest nieujemna, a równe atrakcyjności dają równe udziały. Tak samo działa model Huffa dla sklepów.
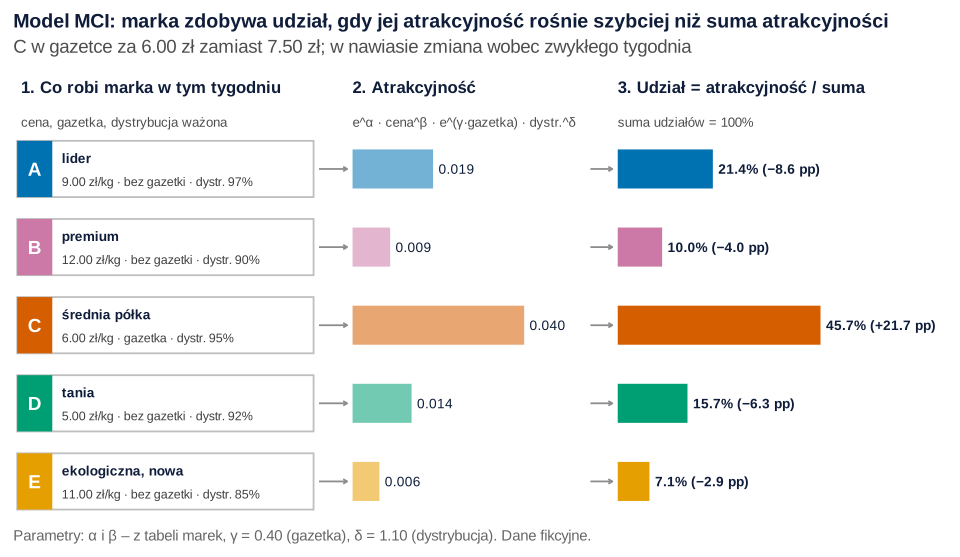
Co widać. W zwykłym tygodniu C ma 24% rynku. Gdy trafia do gazetki z ceną 6.00 zł zamiast 7.50 zł, jej atrakcyjność rośnie 2.7 razy, a udział – do 45.7%. Pozostałe marki nic nie zmieniły, a tracą od 2.9 pp (E) do 8.6 pp (A). Każda z nich traci ten sam odsetek swojego udziału: ok. 28.5%.
Jak może zmylić. Atrakcyjność nie ma jednostki – liczą się tylko proporcje, więc nie porównuj jej między rynkami. Model opisuje też tylko podział rynku, a nie jego wielkość.
Podpis do pracy:
Rysunek 2: co jest w danych
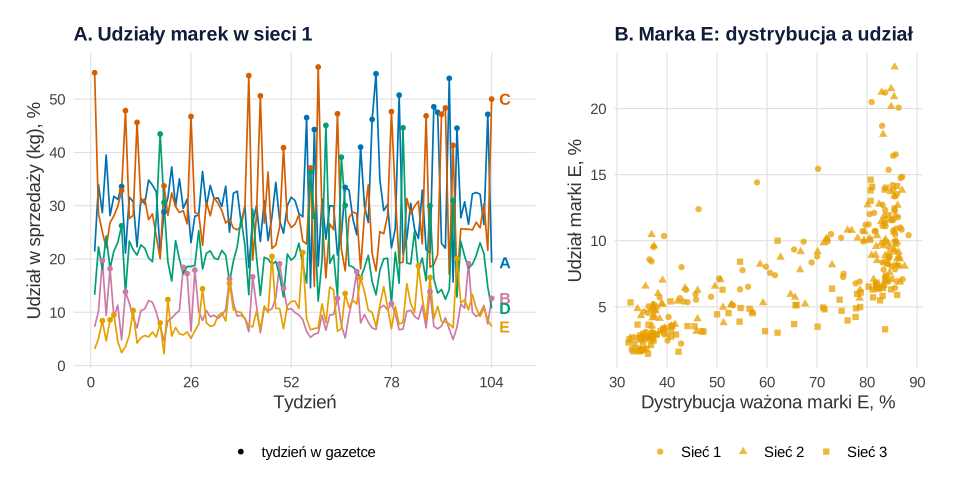
set.seed(691)).Co widać. W tygodniu gazetki marka potrafi przejąć połowę rynku sieci. Średnio A ma 27.8% rynku, C 26.4%, D 25.7%, B 12.4%, a E 7.6%. Udział E rośnie w kolejnych kwartałach (4.5, 6.6, 9.0 i 10.3%) razem z jej dystrybucją ważoną (panel B).
Jak może zmylić. Gazetka zawsze oznacza obniżkę (korelacja logarytmu ceny z gazetką: −.22). Bez obniżek poza gazetką model nie oddzieliłby efektu ceny od ekspozycji (współliniowość). Związek dystrybucji z udziałem bywa też odwrócony – sklepy biorą marki, które się sprzedają (dystrybucja a sprzedaż); u nas dystrybucja E rośnie według planu wejścia do sklepów.
Podpis do pracy:
Rysunek 3: log-centrowanie – jak z ułamka zrobić regresję liniową
Wzór na udział to ułamek z sumą w mianowniku, więc nie da się go wprost wstawić do regresji liniowej. Nakanishi i Cooper (1974) pokazali, jak to obejść metodą najmniejszych kwadratów. W każdym tygodniu i sieci dzielimy udział marki przez średnią geometryczną udziałów pięciu marek i bierzemy logarytm. Mianownik (suma atrakcyjności) jest wspólny dla wszystkich marek, więc znika:
Tylda oznacza średnią geometryczną z pięciu marek w tym samym tygodniu i sieci, a kreska – zwykłą średnią; każdą zmienną mierzymy względem „przeciętnej marki” na rynku. To centrowany log-iloraz znany z danych kompozycyjnych. Daje on te same współczynniki co regresja z efektami stałymi każdego rynku (sieć × tydzień). W modelu głównym każda marka ma własny wykładnik ceny βi, a każda marka w każdej sieci – własną stałą.
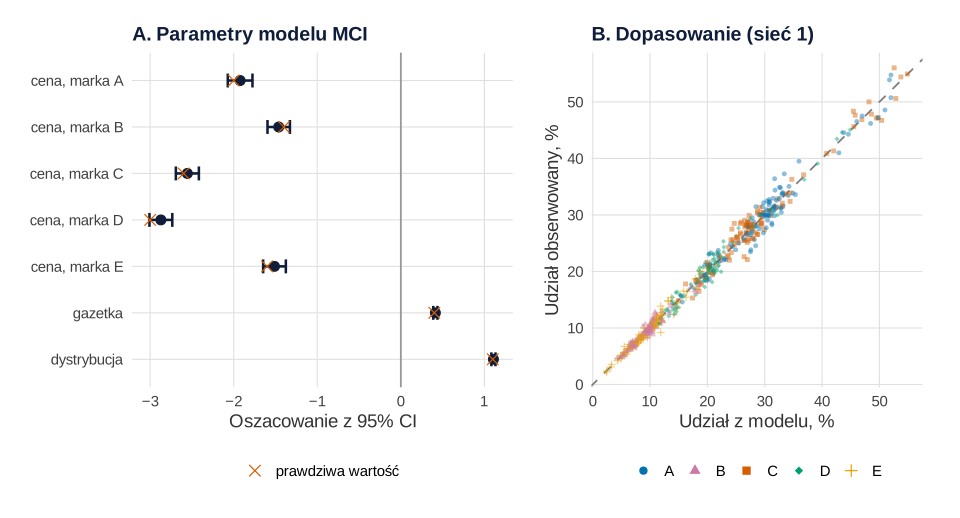
set.seed(691)).Co widać. Regresja odzyskała parametry: wykładnik ceny C wynosi −2.56, 95% CI [−2.69, −2.42], przy prawdzie −2.6. Najmniej wrażliwa na cenę jest marka premium B (−1.46 [−1.60, −1.33]), najbardziej – tania D (−2.87 [−3.01, −2.74]). Gazetka mnoży atrakcyjność przez e0.413 = 1.51, a wykładnik dystrybucji wynosi 1.11 [1.08, 1.13]. Wszystkie siedem przedziałów obejmuje prawdę. Model odtwarza udziały z błędem średniokwadratowym 1.21 pp (R² = .989).
Jak może zmylić. Zwykła regresja na ręcznie wycentrowanych zmiennych daje te same współczynniki, ale za wąskie przedziały: program nie wie, że w każdym rynku zużyliśmy stopień swobody na średnią. W prostszym modelu ze wspólnym wykładnikiem ceny błąd standardowy wyszedł 0.057 zamiast 0.064. Dlatego licz wersję z efektami stałymi. Dobre dopasowanie nie gwarantuje też trafnych elastyczności (rysunek 6).
Zdanie do Wyników:
Rysunek 4: elastyczności własne i krzyżowe
Wykładnik βi nie jest jeszcze elastycznością udziału, bo tańsza marka podnosi też mianownik, w którym sama siedzi. Dlatego elastyczność własna wynosi βi · (1 − udziałi), a elastyczność krzyżowa udziału marki k względem ceny marki i wynosi −βi · udziałi. Liczymy je przy średnich udziałach z ostatnich 26 tygodni: A 28.0%, B 12.3%, C 26.0%, D 23.4%, E 10.3%.
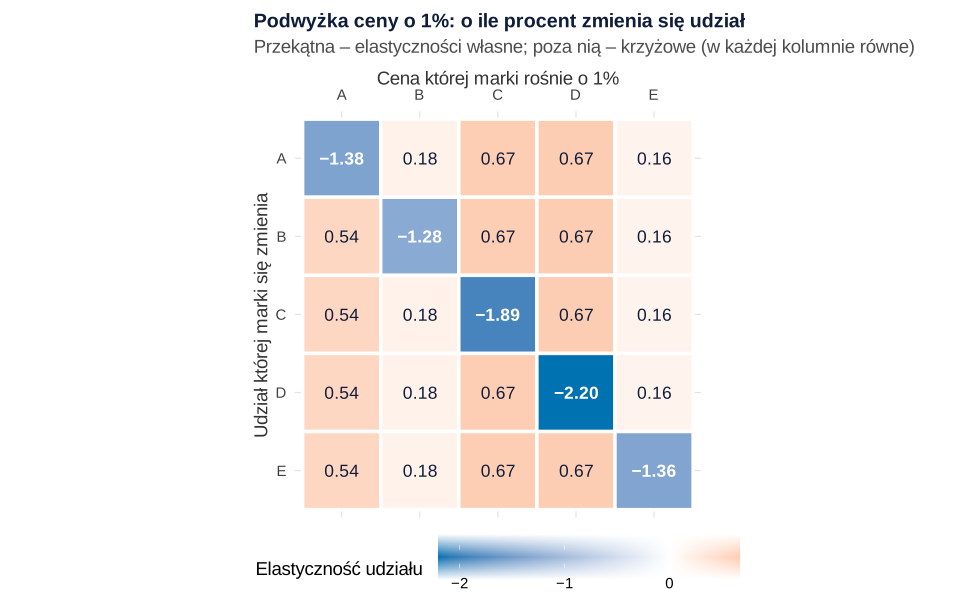
set.seed(691)).Co widać. Podwyżka ceny o 1% obniża udział D o 2.20%, 95% CI [2.10, 2.31], a C o 1.89% [1.79, 1.99]; A, E i B reagują słabiej. Gdy drożeje C albo D, udziały wszystkich pozostałych rosną o 0.67%, a gdy B albo E – tylko o 0.18 i 0.16%. Groźni są konkurenci duzi i wrażliwi na cenę. Elastyczność udziału względem dystrybucji wynosi od 0.80 (A) do 0.99 (E): mała marka zyskuje na każdym nowym sklepie prawie proporcjonalnie.
Jak może zmylić. Równe liczby w kolumnie to założenie modelu: gdy C tanieje, premium B i tania D tracą ten sam procent udziału, choć w prawdziwym rynku C pewnie bardziej podbierałaby klientów D. Carpenter i in. (1988) pokazali, jak rozszerzyć model, żeby efekty konkurencji mogły być zróżnicowane i asymetryczne. Taki model ma jednak dużo więcej parametrów do oszacowania. Elastyczność udziału to też nie elastyczność sprzedaży, gdy rośnie cała kategoria.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: obniżka ceny C – skąd przychodzą klienci
Odpowiedź dla dyrektora. Bierzemy typowy tydzień w sieci 1 z ostatnich 26 tygodni: ceny regularne, bez gazetek, 17 280 kg sprzedaży kategorii. Obniżamy cenę C z 7.07 do 6.36 zł i liczymy udziały z modelu przed obniżką i po niej. Niepewność daje 1000 losowań parametrów z rozkładu oszacowań (uproszczony bootstrap parametryczny).
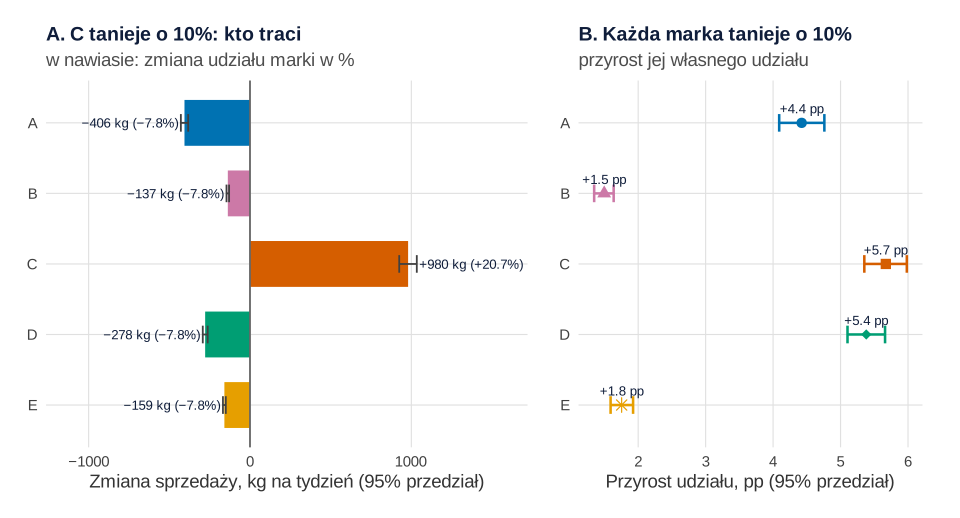
set.seed(691) i set.seed(6915)).Co widać. Udział C rośnie z 27.5 do 33.1%, czyli o 5.67 pp: to +980 kg tygodniowo, 95% przedział [925, 1034]. Najwięcej oddaje lider A (406 kg, 41.4% zysku C), potem D (278 kg, 28.4%), E (159 kg, 16.2%) i B (137 kg, 14.0%). Każdy konkurent traci 7.8% swojego udziału, więc „płaci” proporcjonalnie do swojej wielkości. Ta sama obniżka dałaby D +5.4 pp, a B tylko +1.5 pp (panel B).
Jak może zmylić. Proporcjonalne straty to założenie MCI (rysunek 4), nie odkrycie w danych. Przedziały mówią tylko o niepewności parametrów przy poprawnym modelu. Symulacja pomija też reakcję konkurentów, którzy mogą obniżyć swoje ceny. Przed decyzją cenową warto sprawdzić wynik losowym testem ceny w części sklepów.
Zdanie do Wyników:
Rysunek 6: logit udziałów i cena ustalana pod popyt
Najbliższy krewny MCI to logit udziałów (model atrakcyjności z wielomianowym logitem, MNL). Wygląda tak samo, ale cena wchodzi do atrakcyjności w złotówkach, a nie w logarytmie: Ai = exp(… + βi · cenai). To postać znana z wielomianowej regresji logistycznej i conjointu wyborczego, tylko liczona na udziałach. Szacujemy go tą samą regresją. Elastyczność własna wynosi tu βi · cenai · (1 − udziałi), więc rośnie z ceną.
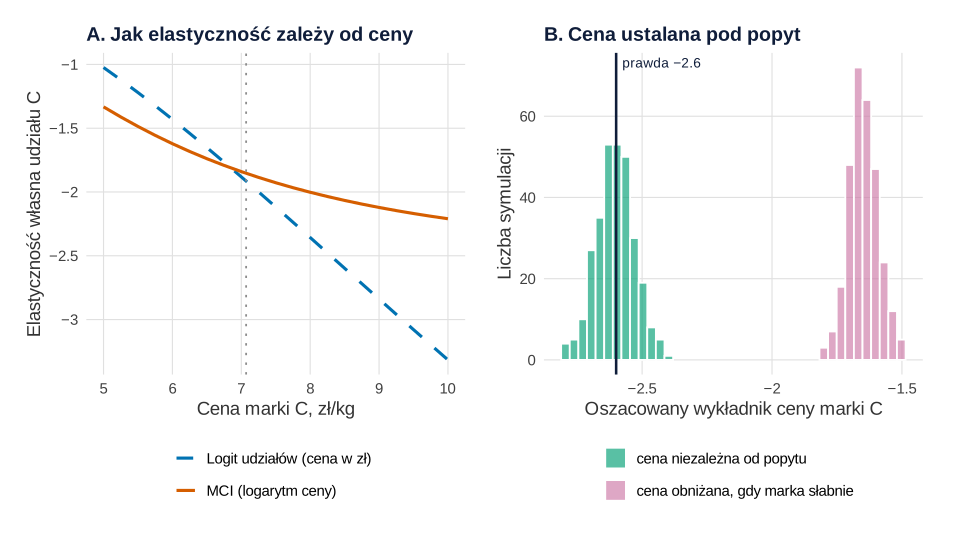
set.seed(691) i set.seed(6916)).Co widać. Przy cenie bliskiej obecnej (7 zł) oba modele dają prawie to samo: −1.84 w MCI i −1.88 w logicie. Rozjeżdżają się poza zakresem: przy 10 zł logit podaje −3.32, a MCI −2.21. Po dopasowaniu na tygodniach 1–78 błąd prognozy udziałów w tygodniach 79–104 wyniósł 1.17 pp dla MCI i 1.19 pp dla logitu. Ghosh i in. (1984) też dostali podobne prognozy z modeli liniowych, multiplikatywnych i atrakcyjności, a lepsze – z parametrami osobnymi dla marek.
Pułapka endogeniczności (panel B). Wygenerowaliśmy po 300 nowych rynków w dwóch wersjach. Gdy cena nie zależy od nieobserwowanych wahań popytu, średnie oszacowanie wykładnika ceny C wynosi −2.60, a 95% przedział obejmuje prawdę w 95.0% symulacji (błąd Monte Carlo 1.3 pp). Gdy kierownicy obniżają cenę, kiedy marka słabnie z powodów niewidocznych dla modelu, średnia spada do −1.65, a przedział nie trafia w prawdę ani razu: model widzi niską cenę przy słabej sprzedaży i uznaje, że cena mało działa. Villas-Boas i Winer (1999) pokazali takie obciążenie w modelach wyboru marki. Berry (1994) zaproponował, by „odwrócić” równanie udziałów i szacować model zmiennymi instrumentalnymi. Instrumentem może być np. koszt surowca, który zmienia cenę, ale nie popyt.
Co z tym zrobić w marketingu
- Porównaj zysk udziału z kosztem. Obniżka C o 10% daje +980 kg tygodniowo – zestaw to z utraconą marżą na wszystkich sprzedanych kilogramach.
- Obserwuj dużych i wrażliwych konkurentów. Ruchy cen C i D przesuwają rynek najmocniej (elastyczność krzyżowa 0.67); zmiany cen B i E – trzy, cztery razy słabiej.
- Licz dystrybucję razem z ceną. Dla małej marki E wejście do nowych sklepów może dać więcej niż kolejna promocja.
- Nie wierz w proporcjonalne straty bez sprawdzenia. Gdy konkurujesz głównie z jedną marką, sprawdź przepływy klientów w panelu konsumenckim.
- Testuj zamiast ufać historii. Gdy ceny ustalano pod popyt, elastyczność z historii będzie zaniżona. Pomaga eksperyment albo instrument.
Związek udziału w reklamie z udziałem w rynku opisuje wpis ESOV, a wpływ reklamy i promocji na wielkość sprzedaży – marketing mix modeling. Kształt reakcji na głębokość rabatu pokazuje wpis głębokość rabatu a sprzedaż. Więcej przykładów do pracy dyplomowej: statystyka w pracy z marketingu.
Jak opisać w pracy
Opisz rynek (sieć × tydzień), postać atrakcyjności, transformację i sposób liczenia elastyczności; w ograniczeniach – założenie IIA i możliwą endogeniczność ceny.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i parametry rynku, przepis 2 – generator i dane, przepis 3 – model i funkcje liczenia udziałów, przepis 5 – typowy tydzień używany w przepisie 6. Przepisy 1–6 kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 2 (set.seed(691) – dane), 5 (set.seed(6915) – 1000 losowań parametrów) i 6 (set.seed(6916) – 2 × 300 symulowanych rynków). Ziarna ustalono raz i nie zmieniano ich, a parametrów danych nie zmieniano po pierwszym uruchomieniu. Ręcznie ustalono (przepisy 1–2 i 6): ceny regularne, wykładniki ceny, docelowe udziały i dystrybucje marek (z nich kod wylicza stałe α), γ = 0.40, δ = 1.10, odchylenie wahań atrakcyjności 0.07, różnice marek między sieciami (SD = 0.15), częstość gazetek (12%) i obniżek bez gazetki (8%) z ich głębokością, krzywą wejścia marki E do sklepów, wielkość kategorii w sieciach oraz siłę reakcji ceny na popyt w pułapce (κ = 0.5). Przepis 6 liczy się ok. 17 sekund, pozostałe – po kilka sekund.
1. Schemat MCI: Rysunek 1
R
# Rysunek 1. Schemat modelu MCI: cena, promocja i dystrybucja → atrakcyjność marki → udział w rynku
library(ggplot2)

# Paleta Okabe–Ito dla pięciu marek (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(A = "#0072B2", B = "#CC79A7", C = "#D55E00", D = "#009E73", E = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Prawdziwe parametry fikcyjnego rynku proszków do prania (ustalone ręcznie; znamy je tylko dlatego, że dane są fikcyjne)
par <- data.frame(
  marka      = c("A", "B", "C", "D", "E"),
  opis       = c("lider", "premium", "średnia półka", "tania", "ekologiczna, nowa"),
  cena_reg   = c(9.0, 12.0, 7.5, 5.0, 11.0),       # cena regularna, zł za kg
  beta_cena  = c(-2.0, -1.4, -2.6, -3.0, -1.6),    # wykładnik ceny w atrakcyjności (inny dla każdej marki)
  udzial_cel = c(.30, .14, .24, .22, .10),          # udział przy cenie regularnej, bez gazetki, przy dyst_cel
  dyst_cel   = c(.97, .90, .95, .92, .85))          # docelowa dystrybucja ważona (odsetek obrotu sklepów)
gamma_promo <- 0.40    # gazetka/ekspozycja mnoży atrakcyjność przez exp(0.40) = 1.49
delta_dyst  <- 1.10    # wykładnik dystrybucji ważonej
sd_eps      <- 0.07    # losowe wahania atrakcyjności z tygodnia na tydzień (skala logarytmu)
# Stałe marek alfa wyliczone tak, by przy cenach regularnych, bez gazetki i przy dyst_cel udziały były równe udzial_cel
par$alfa <- log(par$udzial_cel) - par$beta_cena * log(par$cena_reg) - delta_dyst * log(par$dyst_cel)
par$alfa <- round(par$alfa - mean(par$alfa), 3)     # przesunięcie wszystkich alfa o stałą nie zmienia udziałów
atrakcyjnosc <- function(alfa, beta, cena, gazetka, dyst)
  exp(alfa + beta * log(cena) + gamma_promo * gazetka + delta_dyst * log(dyst))
print(par, row.names = FALSE)

# Jeden tydzień w liczbach: marka C w gazetce z ceną 6.00 zł zamiast 7.50 zł, pozostałe w cenach regularnych
tydz <- transform(par, cena = ifelse(marka == "C", 6.00, cena_reg), gazetka = as.integer(marka == "C"), dyst = dyst_cel)
tydz$atr <- with(tydz, atrakcyjnosc(alfa, beta_cena, cena, gazetka, dyst))
tydz$udzial <- tydz$atr / sum(tydz$atr)
print(transform(tydz[c("marka", "cena", "gazetka", "dyst", "udzial_cel")], atrakcyjnosc = round(tydz$atr, 4),
                udzial_proc = round(100 * tydz$udzial, 1), zmiana_pp = round(100 * (tydz$udzial - tydz$udzial_cel), 1)),
      row.names = FALSE)
round(100 * (tydz$udzial[-3] / tydz$udzial_cel[-3] - 1), 1)   # spadek udziału konkurentów C w % ich udziału

# Grafika: wiersz = marka; od lewej: wejścia → atrakcyjność (pasek) → udział (pasek)
tydz$y <- 5:1
fmt <- function(x, d = 1) gsub("-", "−", formatC(x, format = "f", digits = d))
tydz$wejscie <- sprintf("%s zł/kg · %s · dystr. %s%%", fmt(tydz$cena, 2),
                        ifelse(tydz$gazetka == 1, "gazetka", "bez gazetki"), fmt(100 * tydz$dyst, 0))
skala_atr <- 2.2 / max(tydz$atr); skala_udz <- 2.6 / max(tydz$udzial)
p1 <- ggplot(tydz) +
  annotate("text", x = c(0.1, 4.35, 7.75), y = 6.05, hjust = 0, fontface = "bold", size = 4.4, colour = "#0f1d3a",
           label = c("1. Co robi marka w tym tygodniu", "2. Atrakcyjność", "3. Udział = atrakcyjność / suma")) +
  annotate("text", x = c(0.1, 4.35, 7.75), y = 5.6, hjust = 0, size = 3.5, colour = "grey30",
           label = c("cena, gazetka, dystrybucja ważona", "e^α · cena^β · e^(γ·gazetka) · dystr.^δ",
                     "suma udziałów = 100%")) +
  geom_rect(aes(xmin = 0.05, xmax = 3.85, ymin = y - 0.36, ymax = y + 0.36), fill = "white", colour = "grey75") +
  geom_rect(aes(xmin = 0.05, xmax = 0.5, ymin = y - 0.36, ymax = y + 0.36, fill = marka), colour = NA) +
  geom_text(aes(0.275, y, label = marka), colour = "white", fontface = "bold", size = 5) +
  geom_text(aes(0.62, y + 0.14, label = opis), hjust = 0, size = 3.6, fontface = "bold", colour = "#0f1d3a") +
  geom_text(aes(0.62, y - 0.16, label = wejscie), hjust = 0, size = 3.3, colour = "grey25") +
  annotate("segment", x = 3.92, xend = 4.28, y = 1:5, yend = 1:5, colour = "grey55",
           arrow = arrow(length = unit(0.12, "cm"))) +
  geom_rect(aes(xmin = 4.35, xmax = 4.35 + atr * skala_atr, ymin = y - 0.25, ymax = y + 0.25, fill = marka), alpha = 0.55) +
  geom_text(aes(4.42 + atr * skala_atr, y, label = fmt(atr, 3)), hjust = 0, size = 3.6, colour = "#0f1d3a") +
  annotate("segment", x = 7.4, xend = 7.68, y = 1:5, yend = 1:5, colour = "grey55", arrow = arrow(length = unit(0.12, "cm"))) +
  geom_rect(aes(xmin = 7.75, xmax = 7.75 + udzial * skala_udz, ymin = y - 0.25, ymax = y + 0.25, fill = marka)) +
  geom_text(aes(7.82 + udzial * skala_udz, y, fontface = "bold",
                label = sprintf("%s%% (%s pp)", fmt(100 * udzial), sub("^([0-9])", "+\\1", fmt(100 * (udzial - udzial_cel))))),
            hjust = 0, size = 3.6, colour = "#0f1d3a") +
  scale_fill_manual(values = kol, guide = "none") +
  scale_x_continuous(limits = c(0, 11.9), expand = c(0, 0)) +
  scale_y_continuous(limits = c(0.5, 6.3), expand = c(0, 0)) +
  labs(title = "Model MCI: marka zdobywa udział, gdy jej atrakcyjność rośnie szybciej niż suma atrakcyjności",
       subtitle = "C w gazetce za 6.00 zł zamiast 7.50 zł; w nawiasie zmiana wobec zwykłego tygodnia",
       caption = "Parametry: α i β – z tabeli marek, γ = 0.40 (gazetka), δ = 1.10 (dystrybucja). Dane fikcyjne.") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("mci-schemat-atrakcyjnosc-udzial.svg", p1, width = 10, height = 5.8)
Wynik w R
 marka              opis cena_reg beta_cena udzial_cel dyst_cel   alfa
     A             lider      9.0      -2.0       0.30     0.97  0.456
     B           premium     12.0      -1.4       0.14     0.90 -1.139
     C     średnia półka      7.5      -2.6       0.24     0.95  1.100
     D             tania      5.0      -3.0       0.22     0.92  0.638
     E ekologiczna, nowa     11.0      -1.6       0.10     0.85 -1.055
 marka cena gazetka dyst udzial_cel atrakcyjnosc udzial_proc zmiana_pp
     A    9       0 0.97       0.30       0.0188        21.4      -8.6
     B   12       0 0.90       0.14       0.0088        10.0      -4.0
     C    6       1 0.95       0.24       0.0402        45.7      21.7
     D    5       0 0.92       0.22       0.0138        15.7      -6.3
     E   11       0 0.85       0.10       0.0063         7.1      -2.9
[1] -28.6 -28.5 -28.5 -28.5
2. Generator i dane: Rysunek 2
R
# Rysunek 2. Dane: 5 marek proszku do prania, 3 sieci, 104 tygodnie – udziały w czasie i rola dystrybucji
# (korzysta z kol, motyw, par, gamma_promo, delta_dyst i sd_eps z przepisu 1)
library(ggplot2)
library(patchwork)

# Generator danych: jedna linijka = sieć × tydzień × marka. kappa > 0 oznacza cenę ustalaną pod popyt (przepis 6)
generuj <- function(kappa = 0) {
  siatka <- expand.grid(marka = par$marka, tydzien = 1:104, siec = 1:3, stringsAsFactors = FALSE)
  k <- match(siatka$marka, par$marka); s <- siatka$siec; n <- nrow(siatka)
  u      <- matrix(rnorm(15, 0, 0.15), 5, 3)          # marka w danej sieci trochę mocniejsza lub słabsza
  poziom <- matrix(exp(rnorm(15, 0, 0.04)), 5, 3)     # poziom cen regularnych marki w sieci
  d_off  <- matrix(rnorm(15, 0, 0.02), 5, 3)          # poziom dystrybucji marki w sieci
  gazetka <- rbinom(n, 1, 0.12)                       # tydzień w gazetce i na ekspozycji (zawsze z obniżką)
  obnizka <- ifelse(gazetka == 1, 1L, rbinom(n, 1, 0.08))       # część obniżek bez gazetki
  glebokosc <- ifelse(gazetka == 1, runif(n, 0.15, 0.25), runif(n, 0.05, 0.15))
  cena <- par$cena_reg[k] * poziom[cbind(k, s)] * exp(rnorm(n, 0, 0.02)) * (1 - obnizka * glebokosc)
  dyst <- par$dyst_cel[k] + d_off[cbind(k, s)] + rnorm(n, 0, 0.015)
  # Marka E wchodzi na rynek: dystrybucja rośnie z ok. 35% do 85% (w sieci 3 najpóźniej)
  start <- c(30, 40, 60)[s]
  dyst <- ifelse(siatka$marka == "E", 0.35 + 0.50 / (1 + exp(-(siatka$tydzien - start) / 8)) + rnorm(n, 0, 0.015), dyst)
  dyst <- pmin(dyst, 0.995)
  eps <- rnorm(n, 0, sd_eps)                          # nieobserwowane wahania atrakcyjności
  cena <- cena * exp(kappa * eps)                     # kappa > 0: cena niższa, gdy marka akurat słabnie
  ln_atr <- par$alfa[k] + u[cbind(k, s)] + par$beta_cena[k] * log(cena) + gamma_promo * gazetka +
    delta_dyst * log(dyst) + eps
  rynek <- paste(s, siatka$tydzien)
  udzial <- ave(exp(ln_atr), rynek, FUN = function(a) a / sum(a))
  # Wielkość kategorii (kg tygodniowo) nie zależy od cen marek – model opisuje podział rynku, nie jego wielkość
  kat <- c(18000, 12000, 8000)[s] * (1 + 0.08 * sin(2 * pi * siatka$tydzien / 52)) *
    exp(rnorm(312, 0, 0.05))[match(rynek, unique(rynek))]
  out <- data.frame(siec = paste("Sieć", s), tydzien = siatka$tydzien, marka = siatka$marka,
                    cena = round(cena, 2), gazetka = gazetka, dyst = round(dyst, 3), kg = round(udzial * kat))
  out$udzial <- out$kg / ave(out$kg, out$siec, out$tydzien, FUN = sum)
  out
}

set.seed(691)                                        # ziarno ustalone raz, bez dobierania pod wynik
d <- generuj()
write.csv(d, "mci-proszki-sieci-tygodnie.csv", row.names = FALSE)

# Opis danych
c(wiersze = nrow(d), sieci = length(unique(d$siec)), tygodnie = max(d$tydzien), kg_lacznie = sum(d$kg))
op <- aggregate(cbind(cena, gazetka, dyst, udzial) ~ marka, d, mean)
op[-1] <- round(op[-1], 3); op
round(100 * tapply(d$udzial[d$marka == "E"], cut(d$tydzien[d$marka == "E"], c(0, 26, 52, 78, 104)), mean), 1)
round(cor(log(d$cena), d$gazetka), 2)                # cena i gazetka idą razem, ale nie w pełni

# A: udziały w sieci 1 tydzień po tygodniu; B: dystrybucja ważona marki E a jej udział (wszystkie sieci)
s1 <- subset(d, siec == "Sieć 1")
ostatni <- subset(s1, tydzien == 104)
pa <- ggplot(s1, aes(tydzien, 100 * udzial, colour = marka)) +
  geom_line(linewidth = 0.6) +
  geom_point(data = subset(s1, gazetka == 1), aes(shape = "tydzień w gazetce"), size = 1.6) +
  geom_text(data = ostatni, aes(x = 106, label = marka), hjust = 0, fontface = "bold", size = 4.2, show.legend = FALSE) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_shape_manual(values = 16, name = NULL) +
  scale_x_continuous(breaks = seq(0, 104, 26), limits = c(1, 110)) +
  labs(x = "Tydzień", y = "Udział w sprzedaży (kg), %", title = "A. Udziały marek w sieci 1") + motyw
pb <- ggplot(subset(d, marka == "E"), aes(100 * dyst, 100 * udzial, shape = siec)) +
  geom_point(colour = kol[["E"]], alpha = 0.75, size = 1.8) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  labs(x = "Dystrybucja ważona marki E, %", y = "Udział marki E, %", title = "B. Marka E: dystrybucja a udział") + motyw
p2 <- pa + pb + plot_layout(widths = c(1.5, 1))
p2   # zapis: ggsave("mci-dane-udzialy-dystrybucja.svg", p2, width = 10, height = 5.2)
Wynik w R
   wiersze      sieci   tygodnie kg_lacznie
      1560          3        104    3955428
  marka   cena gazetka  dyst udzial
1     A  9.218   0.099 0.966  0.278
2     B 12.063   0.125 0.891  0.124
3     C  7.088   0.125 0.927  0.264
4     D  4.744   0.138 0.925  0.257
5     E 10.586   0.138 0.643  0.076
  (0,26]  (26,52]  (52,78] (78,104]
     4.5      6.6      9.0     10.3
[1] -0.22
3. Log-centrowanie i regresja: Rysunek 3
R
# Rysunek 3. Log-centrowanie i regresja liniowa: oszacowane parametry MCI wobec prawdziwych
# (korzysta z kol, motyw, par, gamma_promo, delta_dyst z przepisu 1 i d z przepisu 2)
library(ggplot2)
library(patchwork)

d$rynek <- paste(d$siec, d$tydzien)                  # rynek = sieć w danym tygodniu (tu sumują się udziały)
d$ms    <- factor(paste(d$marka, d$siec))            # stała marki w sieci
d$marka <- factor(d$marka)
d$ln_s <- log(d$udzial); d$ln_c <- log(d$cena); d$ln_d <- log(d$dyst)

# (a) Log-centrowanie ręcznie: od każdej zmiennej odejmujemy jej średnią z 5 marek w tym samym rynku.
#     ln(udział) − średnia ln(udziałów) = ln(udział / średnia geometryczna udziałów) – mianownik modelu znika.
srodek <- function(x) x - ave(x, d$rynek)
X_ms <- apply(model.matrix(~ 0 + ms, d), 2, srodek)  # wycentrowane stałe marek w sieciach
m_c <- lm(srodek(ln_s) ~ 0 + X_ms + srodek(ln_c) + srodek(gazetka) + srodek(ln_d), data = d)
# (b) To samo jako regresja z efektami stałymi rynku (ten sam wynik, poprawne stopnie swobody)
m_fe <- lm(ln_s ~ 0 + factor(rynek) + ms + ln_c + gazetka + ln_d, data = d)
round(rbind(log_centrowanie = tail(coef(m_c), 3), efekty_stale = coef(m_fe)[c("ln_c", "gazetka", "ln_d")]), 4)
round(c(SE_centrowanie = summary(m_c)$coefficients["srodek(ln_c)", 2],
        SE_efekty_stale = summary(m_fe)$coefficients["ln_c", 2]), 4)

# (c) Model główny: osobny wykładnik ceny dla każdej marki (MCI z efektami zróżnicowanymi)
m2 <- lm(ln_s ~ 0 + factor(rynek) + ms + marka:ln_c + gazetka + ln_d, data = d)
nz <- c(paste0("marka", par$marka, ":ln_c"), "gazetka", "ln_d")
tab <- data.frame(parametr = c(paste("cena, marka", par$marka), "gazetka", "dystrybucja"),
                  prawda = c(par$beta_cena, gamma_promo, delta_dyst), ocena = coef(m2)[nz], confint(m2)[nz, ])
names(tab)[4:5] <- c("dol", "gora")
print(cbind(tab[1], round(tab[-1], 3)), row.names = FALSE)
round(c(sigma = sigma(m2), df_reszt = df.residual(m2)), 3)

# Udziały z modelu: atrakcyjność bez efektów rynku (one się skracają) i normalizacja w rynku
lp <- function(m, nd, zm = "ln_c") {                 # zm = "ln_c" (MCI) albo "cena" (logit udziałów)
  b <- coef(m); b[is.na(b)] <- 0
  a <- b[paste0("ms", nd$ms)]; a[is.na(a)] <- 0       # stała marki w sieci (poziom odniesienia = 0)
  unname(a + b[paste0("marka", nd$marka, ":", zm)] * nd[[zm]] + b["gazetka"] * nd$gazetka + b["ln_d"] * nd$ln_d)
}
udzialy <- function(eta, rynek) ave(exp(eta), rynek, FUN = function(a) a / sum(a))
d$udzial_mci <- udzialy(lp(m2, d), d$rynek)
round(c(R2_udzialow = cor(d$udzial, d$udzial_mci)^2, RMSE_pp = 100 * sqrt(mean((d$udzial - d$udzial_mci)^2))), 4)

# A: oszacowania z 95% CI i prawdziwe wartości; B: udział obserwowany a z modelu
tab$parametr <- factor(tab$parametr, rev(tab$parametr))
tab$grupa <- c(par$marka, "gazetka", "dystr.")
pa <- ggplot(tab, aes(ocena, parametr)) +
  geom_vline(xintercept = 0, colour = "grey60") +
  geom_errorbar(aes(xmin = dol, xmax = gora), orientation = "y", width = 0.3, linewidth = 0.9, colour = "#0f1d3a") +
  geom_point(size = 3, colour = "#0f1d3a") +
  geom_point(aes(prawda, shape = "prawdziwa wartość"), colour = kol[["C"]], size = 3.4) +
  scale_shape_manual(values = 4, name = NULL) +
  scale_x_continuous(labels = function(v) gsub("-", "−", v)) +
  labs(x = "Oszacowanie z 95% CI", y = NULL, title = "A. Parametry modelu MCI") + motyw
pb <- ggplot(subset(d, siec == "Sieć 1"), aes(100 * udzial_mci, 100 * udzial, colour = marka, shape = marka)) +
  geom_abline(slope = 1, intercept = 0, colour = "grey50", linetype = "dashed") +
  geom_point(alpha = 0.45, size = 1.3) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(16, 17, 15, 18, 3), name = NULL) +
  guides(colour = guide_legend(override.aes = list(alpha = 1, size = 2.5))) +
  labs(x = "Udział z modelu, %", y = "Udział obserwowany, %", title = "B. Dopasowanie (sieć 1)") + motyw
p3 <- pa + pb + plot_layout(widths = c(1.15, 1))
p3   # zapis: ggsave("mci-parametry-dopasowanie.svg", p3, width = 10, height = 5.4)
Wynik w R
                srodek(ln_c) srodek(gazetka) srodek(ln_d)
log_centrowanie      -2.0461          0.4189       1.1098
efekty_stale         -2.0461          0.4189       1.1098
 SE_centrowanie SE_efekty_stale
         0.0572          0.0640
      parametr prawda  ocena    dol   gora
 cena, marka A   -2.0 -1.923 -2.071 -1.776
 cena, marka B   -1.4 -1.462 -1.596 -1.328
 cena, marka C   -2.6 -2.555 -2.693 -2.417
 cena, marka D   -3.0 -2.872 -3.008 -2.735
 cena, marka E   -1.6 -1.512 -1.648 -1.376
       gazetka    0.4  0.413  0.388  0.439
   dystrybucja    1.1  1.108  1.083  1.132
   sigma df_reszt
   0.067 1229.000
R2_udzialow     RMSE_pp
     0.9889      1.2084
4. Elastyczności: Rysunek 4
R
# Rysunek 4. Elastyczności udziału względem ceny: własne (przekątna) i krzyżowe – mapa ciepła
# (korzysta z kol, motyw, par z przepisu 1, d z przepisu 2 i m2 z przepisu 3)
library(ggplot2)

b_cena <- coef(m2)[paste0("marka", par$marka, ":ln_c")]
ci_cena <- confint(m2)[paste0("marka", par$marka, ":ln_c"), ]
# Średnie udziały w ostatnich 26 tygodniach (wszystkie sieci) – w tym punkcie liczymy elastyczności
s_sr <- tapply(d$udzial[d$tydzien > 78], d$marka[d$tydzien > 78], mean)
round(100 * s_sr, 1)
# MCI: elastyczność udziału marki i względem ceny marki j
#   własna (i = j):  beta_i * (1 − s_i)      krzyżowa (i ≠ j):  −beta_j * s_j  (taka sama dla każdego i!)
E <- outer(1:5, 1:5, function(i, j) ifelse(i == j, b_cena[j] * (1 - s_sr[j]), -b_cena[j] * s_sr[j]))
dimnames(E) <- list(udzial = par$marka, cena = par$marka)
round(E, 2)
wlasne <- data.frame(marka = par$marka, elastycznosc = b_cena * (1 - s_sr),
                     dol = ci_cena[, 1] * (1 - s_sr), gora = ci_cena[, 2] * (1 - s_sr),
                     prawda = par$beta_cena * (1 - s_sr))
print(cbind(wlasne[1], round(wlasne[-1], 2)), row.names = FALSE)
# Elastyczność udziału względem dystrybucji ważonej i efekt gazetki (mnożnik atrakcyjności)
round(c(delta = unname(coef(m2)["ln_d"]), mnoznik_gazetki = unname(exp(coef(m2)["gazetka"]))), 3)
round(coef(m2)["ln_d"] * (1 - s_sr), 2)

# Mapa ciepła: wiersz = czyj udział, kolumna = czyja cena się zmienia
mapa <- as.data.frame(as.table(E), responseName = "e")
mapa$udzial <- factor(mapa$udzial, rev(par$marka))
mapa$etyk <- gsub("-", "−", sprintf("%.2f", mapa$e))
p4 <- ggplot(mapa, aes(cena, udzial, fill = e)) +
  geom_tile(colour = "white", linewidth = 1.2) +
  geom_text(aes(label = etyk, fontface = ifelse(as.character(cena) == as.character(udzial), "bold", "plain")),
            size = 4.6, colour = ifelse(abs(mapa$e) > 1.2, "white", "#0f1d3a")) +
  scale_fill_gradient2(low = "#0072B2", mid = "white", high = "#D55E00", midpoint = 0,
                       name = "Elastyczność udziału", labels = function(v) gsub("-", "−", v)) +
  scale_x_discrete(position = "top") +
  labs(x = "Cena której marki rośnie o 1%", y = "Udział której marki się zmienia",
       title = "Podwyżka ceny o 1%: o ile procent zmienia się udział",
       subtitle = "Przekątna – elastyczności własne; poza nią – krzyżowe (w każdej kolumnie równe)") +
  coord_fixed() + motyw + theme(panel.grid = element_blank(), legend.key.width = unit(1.6, "cm"), plot.title.position = "plot")
p4   # zapis: ggsave("mci-mapa-elastycznosci.svg", p4, width = 10, height = 6.4)
Wynik w R
   A    B    C    D    E
28.0 12.3 26.0 23.4 10.3
      cena
udzial     A     B     C     D     E
     A -1.38  0.18  0.67  0.67  0.16
     B  0.54 -1.28  0.67  0.67  0.16
     C  0.54  0.18 -1.89  0.67  0.16
     D  0.54  0.18  0.67 -2.20  0.16
     E  0.54  0.18  0.67  0.67 -1.36
 marka elastycznosc   dol  gora prawda
     A        -1.38 -1.49 -1.28  -1.44
     B        -1.28 -1.40 -1.16  -1.23
     C        -1.89 -1.99 -1.79  -1.92
     D        -2.20 -2.31 -2.10  -2.30
     E        -1.36 -1.48 -1.23  -1.43
          delta mnoznik_gazetki
          1.108           1.512
   A    B    C    D    E
0.80 0.97 0.82 0.85 0.99
5. Symulacja obniżki ceny: Rysunek 5
R
# Rysunek 5. Symulacja: marka C obniża cenę o 10% w sieci 1 – skąd przychodzą kilogramy?
# (korzysta z kol, motyw, par z przepisu 1, d z przepisu 2 oraz m2, lp i udzialy z przepisu 3)
library(ggplot2)
library(patchwork)
library(MASS)       # mvrnorm(): losowanie parametrów z rozkładu oszacowań

# Typowy tydzień w sieci 1 (tygodnie 79–104): mediana ceny poza gazetką, średnia dystrybucja, bez gazetki
ost <- subset(d, siec == "Sieć 1" & tydzien > 78)
typ <- data.frame(marka = factor(par$marka, levels(d$marka)), siec = "Sieć 1", gazetka = 0,
                  cena = as.vector(tapply(ost$cena[ost$gazetka == 0], ost$marka[ost$gazetka == 0], median)),
                  dyst = as.vector(tapply(ost$dyst, ost$marka, mean)))
typ$ms <- factor(paste(typ$marka, typ$siec), levels(d$ms)); typ$ln_d <- log(typ$dyst); typ$rynek <- "typowy"
kat_kg <- mean(tapply(ost$kg, ost$tydzien, sum))     # średnia sprzedaż kategorii w sieci 1, kg/tydzień
round(kat_kg)

scenariusz <- function(m, kto, zmiana = 0.90) {      # udziały przed i po zmianie ceny marki "kto"
  przed <- transform(typ, ln_c = log(cena)); po <- przed
  po$ln_c[po$marka == kto] <- log(po$cena[po$marka == kto] * zmiana)
  cbind(przed = udzialy(lp(m, przed), przed$rynek), po = udzialy(lp(m, po), po$rynek))
}
sc <- scenariusz(m2, "C")
wynik <- data.frame(marka = par$marka, cena = typ$cena, przed_proc = 100 * sc[, 1], po_proc = 100 * sc[, 2],
                    zmiana_pp = 100 * (sc[, 2] - sc[, 1]), zmiana_kg = kat_kg * (sc[, 2] - sc[, 1]),
                    zmiana_wzgl_proc = 100 * (sc[, 2] / sc[, 1] - 1))
print(cbind(wynik[1], round(wynik[-1], 2)), row.names = FALSE)
# Skąd przychodzą kilogramy C: odsetek zysku C zabrany każdemu konkurentowi = jego udział wśród konkurentów
round(100 * -wynik$zmiana_kg[-3] / wynik$zmiana_kg[3], 1)

# Niepewność: 1000 losowań parametrów z rozkładu normalnego oszacowań (średnia = coef, kowariancja = vcov)
set.seed(6915)
b_ok <- coef(m2)[!is.na(coef(m2))]
losy <- mvrnorm(1000, b_ok, vcov(m2, complete = FALSE))
m_los <- m2
sym <- t(apply(losy, 1, function(b) {
  m_los$coefficients[names(b)] <- b
  sc_b <- scenariusz(m_los, "C")
  wl <- sapply(par$marka, function(k) { s <- scenariusz(m_los, k); unname(100 * diff(s[par$marka == k, ])) })
  c(kat_kg * (sc_b[, 2] - sc_b[, 1]), wl)
}))
colnames(sym) <- c(paste0("kg_", par$marka), paste0("wlasna_", par$marka))
ci <- apply(sym, 2, quantile, c(.025, .975))
round(ci, 1)
# Każda marka osobno obniża cenę o 10%: przyrost własnego udziału (pp)
wl_pkt <- sapply(par$marka, function(k) { s <- scenariusz(m2, k); unname(100 * diff(s[par$marka == k, ])) })
round(wl_pkt, 2)

# A: zmiana sprzedaży (kg/tydzień) po obniżce C; B: przyrost udziału przy obniżce każdej marki
ka <- data.frame(marka = par$marka, kg = wynik$zmiana_kg, dol = ci[1, 1:5], gora = ci[2, 1:5],
                 etyk = sprintf("%+.0f kg (%+.1f%%)", wynik$zmiana_kg, wynik$zmiana_wzgl_proc))
ka$etyk <- gsub("-", "−", ka$etyk)
pa <- ggplot(ka, aes(kg, marka, fill = marka)) +
  geom_col(width = 0.65) +
  geom_errorbar(aes(xmin = dol, xmax = gora), orientation = "y", width = 0.25, colour = "grey25") +
  geom_text(aes(x = ifelse(kg > 0, gora + 15, dol - 15), label = etyk, hjust = ifelse(kg > 0, 0, 1)),
            size = 3.5, colour = "#0f1d3a") +
  geom_vline(xintercept = 0, colour = "grey40") +
  scale_fill_manual(values = kol, guide = "none") +
  scale_y_discrete(limits = rev(par$marka)) +
  scale_x_continuous(expand = expansion(mult = c(0.55, 0.45)), labels = function(v) gsub("-", "−", v)) +
  labs(x = "Zmiana sprzedaży, kg na tydzień (95% przedział)", y = NULL,
       title = "A. C tanieje o 10%: kto traci", subtitle = "w nawiasie: zmiana udziału marki w %") + motyw
kb <- data.frame(marka = par$marka, pp = wl_pkt, dol = ci[1, 6:10], gora = ci[2, 6:10])
pb <- ggplot(kb, aes(pp, marka, colour = marka, shape = marka)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), orientation = "y", width = 0.25, linewidth = 0.9) +
  geom_point(size = 3.2) +
  geom_text(aes(label = sprintf("+%.1f pp", pp)), vjust = -1.0, size = 3.5, colour = "#0f1d3a") +
  scale_colour_manual(values = kol, guide = "none") + scale_shape_manual(values = c(16, 17, 15, 18, 8), guide = "none") +
  scale_y_discrete(limits = rev(par$marka)) +
  labs(x = "Przyrost udziału, pp (95% przedział)", y = NULL, title = "B. Każda marka tanieje o 10%",
       subtitle = "przyrost jej własnego udziału") + motyw
p5 <- pa + pb + plot_layout(widths = c(1.4, 1))
p5   # zapis: ggsave("mci-symulacja-obnizki-ceny.svg", p5, width = 10, height = 5.4)
Wynik w R
[1] 17280
 marka  cena przed_proc po_proc zmiana_pp zmiana_kg zmiana_wzgl_proc
     A  9.75      30.06   27.71     -2.35   -406.01            -7.82
     B 12.76      10.17    9.38     -0.80   -137.43            -7.82
     C  7.07      27.46   33.13      5.67    979.94            20.66
     D  4.96      20.57   18.96     -1.61   -277.82            -7.82
     E 10.68      11.75   10.83     -0.92   -158.68            -7.82
[1] 41.4 14.0 28.4 16.2
        kg_A   kg_B   kg_C   kg_D   kg_E wlasna_A wlasna_B wlasna_C wlasna_D
2.5%  -428.3 -145.5  924.9 -292.6 -167.6      4.1      1.3      5.4      5.1
97.5% -383.0 -129.5 1033.8 -262.2 -149.9      4.8      1.6      6.0      5.7
      wlasna_E
2.5%       1.6
97.5%      1.9
   A    B    C    D    E
4.42 1.50 5.67 5.38 1.75
6. Logit udziałów i endogeniczność: Rysunek 6
R
# Rysunek 6. MCI a logit udziałów (cena w zł zamiast logarytmu) oraz pułapka ceny ustalanej pod popyt
# (korzysta z kol, motyw, par z przepisu 1, generuj i d z przepisu 2, m2, lp, udzialy z przepisu 3, typ z przepisu 5)
library(ggplot2)
library(patchwork)

# Logit udziałów (atrakcyjność = exp(... + beta · cena)) – ta sama regresja, tylko cena w zł
m_logit <- lm(ln_s ~ 0 + factor(rynek) + ms + marka:cena + gazetka + ln_d, data = d)
round(coef(m_logit)[paste0("marka", par$marka, ":cena")], 3)

# Sprawdzian prognozy: dopasowanie na tygodniach 1–78, prognoza udziałów na tygodniach 79–104
ucz <- subset(d, tydzien <= 78); test <- subset(d, tydzien > 78)
m_mci_u <- lm(ln_s ~ 0 + factor(rynek) + ms + marka:ln_c + gazetka + ln_d, data = ucz)
m_log_u <- lm(ln_s ~ 0 + factor(rynek) + ms + marka:cena + gazetka + ln_d, data = ucz)
test$p_mci <- udzialy(lp(m_mci_u, test, "ln_c"), test$rynek)
test$p_log <- udzialy(lp(m_log_u, test, "cena"), test$rynek)
round(100 * c(RMSE_MCI = sqrt(mean((test$udzial - test$p_mci)^2)), RMSE_logit = sqrt(mean((test$udzial - test$p_log)^2))), 3)
round(100 * sapply(split(test, test$marka), function(x)
  c(MCI = sqrt(mean((x$udzial - x$p_mci)^2)), logit = sqrt(mean((x$udzial - x$p_log)^2)))), 2)

# Elastyczność własna udziału marki C przy różnych cenach C (pozostałe marki jak w typowym tygodniu z przepisu 5)
krzywa <- do.call(rbind, lapply(seq(5, 10, by = 0.25), function(cc) {
  nd <- typ; nd$cena[nd$marka == "C"] <- cc; nd$ln_c <- log(nd$cena)
  s_mci <- udzialy(lp(m2, nd, "ln_c"), nd$rynek)[3]; s_log <- udzialy(lp(m_logit, nd, "cena"), nd$rynek)[3]
  data.frame(cena = cc, model = c("MCI (logarytm ceny)", "Logit udziałów (cena w zł)"),
             e = c(coef(m2)["markaC:ln_c"] * (1 - s_mci), coef(m_logit)["markaC:cena"] * cc * (1 - s_log)))
}))
k5 <- subset(krzywa, cena %in% c(5, 6, 7, 8, 9, 10)); k5$e <- round(k5$e, 2)
print(reshape(k5, idvar = "cena", timevar = "model", direction = "wide"), row.names = FALSE)

# Pułapka: cena ustalana pod popyt (kappa = 0.5). 300 nowych rynków na scenariusz, ten sam model
set.seed(6916)
dopasuj_C <- function(dd) {                          # szybkie log-centrowanie: wynik jak w lm z efektami rynku
  rynek <- paste(dd$siec, dd$tydzien); sr <- function(x) x - ave(x, rynek)
  stale <- do.call(cbind, lapply(c("A", "B", "C", "D"), function(k)
    sapply(1:3, function(s) as.numeric(dd$marka == k & dd$siec == paste("Sieć", s)))))
  X <- cbind(stale,                                   # stałe marek A–D w sieciach (E = poziom odniesienia)
             sapply(par$marka, function(k) (dd$marka == k) * log(dd$cena)), gazetka = dd$gazetka, ln_d = log(dd$dyst))
  X <- apply(X, 2, sr)
  f <- lm.fit(X, sr(log(dd$udzial)))
  df <- nrow(X) - ncol(X) - length(unique(rynek))     # stopnie swobody jak w modelu z efektami rynku
  se <- sqrt(sum(f$residuals^2) / df * diag(chol2inv(qr.R(f$qr))))
  j <- 12 + 3                                         # kolumna: cena marki C
  c(b = unname(f$coefficients[j]), se = se[j])
}
R <- 300
sim <- rbind(data.frame(scenariusz = "cena niezależna od popytu", t(replicate(R, dopasuj_C(generuj(0))))),
             data.frame(scenariusz = "cena obniżana, gdy marka słabnie", t(replicate(R, dopasuj_C(generuj(0.5))))))
sim$pokrywa <- abs(sim$b - par$beta_cena[3]) <= 1.96 * sim$se
podsum <- aggregate(cbind(b, pokrywa) ~ scenariusz, sim, mean)
podsum$blad_MC_pp <- 100 * sqrt(podsum$pokrywa * (1 - podsum$pokrywa) / R)
podsum$b <- round(podsum$b, 3); podsum$pokrywa <- round(100 * podsum$pokrywa, 1); podsum$blad_MC_pp <- round(podsum$blad_MC_pp, 1)
podsum

# A: elastyczność własna C w obu modelach; B: rozkład oszacowań wykładnika ceny C w 300 symulacjach
pa <- ggplot(krzywa, aes(cena, e, colour = model, linetype = model)) +
  geom_line(linewidth = 1.1) +
  geom_vline(xintercept = typ$cena[typ$marka == "C"], colour = "grey55", linetype = "dotted") +
  scale_colour_manual(values = c("#0072B2", "#D55E00"), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_y_continuous(labels = function(v) gsub("-", "−", v)) +
  guides(colour = guide_legend(nrow = 2)) +
  labs(x = "Cena marki C, zł/kg", y = "Elastyczność własna udziału C", title = "A. Jak elastyczność zależy od ceny") + motyw
pb <- ggplot(sim, aes(b, fill = scenariusz)) +
  geom_histogram(bins = 40, position = "identity", alpha = 0.65, colour = "white") +
  geom_vline(xintercept = par$beta_cena[3], linewidth = 0.9, colour = "#0f1d3a") +
  annotate("text", x = par$beta_cena[3], y = Inf, vjust = 1.5, hjust = -0.08, label = "prawda −2.6", size = 3.6,
           colour = "#0f1d3a") +
  scale_fill_manual(values = c("#009E73", "#CC79A7"), name = NULL) +
  scale_x_continuous(labels = function(v) gsub("-", "−", v)) +
  guides(fill = guide_legend(nrow = 2)) +
  labs(x = "Oszacowany wykładnik ceny marki C", y = "Liczba symulacji", title = "B. Cena ustalana pod popyt") + motyw
p6 <- pa + pb
p6   # zapis: ggsave("mci-logit-i-endogenicznosc.svg", p6, width = 10, height = 5.6)
Wynik w R
markaA:cena markaB:cena markaC:cena markaD:cena markaE:cena
     -0.214      -0.122      -0.374      -0.631      -0.143
  RMSE_MCI RMSE_logit
     1.174      1.194
         A    B    C    D    E
MCI   1.48 0.72 1.48 1.19 0.78
logit 1.46 0.75 1.52 1.22 0.79
 cena e.MCI (logarytm ceny) e.Logit udziałów (cena w zł)
    5                 -1.33                        -1.02
    6                 -1.62                        -1.43
    7                 -1.84                        -1.88
    8                 -2.00                        -2.36
    9                 -2.12                        -2.84
   10                 -2.21                        -3.32
                        scenariusz      b pokrywa blad_MC_pp
1        cena niezależna od popytu -2.603      95        1.3
2 cena obniżana, gdy marka słabnie -1.648       0        0.0
7. Sprawdzenie palety
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
kol5 <- c(A = "#0072B2", B = "#CC79A7", C = "#D55E00", D = "#009E73", E = "#E69F00")
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
pary <- combn(names(kol5), 2, simplify = FALSE)
tab <- t(sapply(pary, function(p) { k <- kol5[p]
  c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)), protanopia = roznica(protan(k))) }))
rownames(tab) <- sapply(pary, paste, collapse = " – ")
round(tab, 1)
round(apply(tab, 2, min), 1)        # najmniej różniąca się para w każdym typie widzenia
Wynik w R
      widzenie_typowe deuteranopia protanopia
A – B            53.6         42.0       22.5
A – C           114.6        108.3       91.9
A – D            70.1         55.4       58.0
A – E           120.2        121.5      109.3
B – C            74.3         70.2       71.9
B – D            87.5         18.1       36.2
B – E            88.6         81.3       87.6
C – D           102.4         53.5       37.3
C – E            33.4         18.4       24.9
D – E            88.7         66.3       51.5
widzenie_typowe    deuteranopia      protanopia
           33.4            18.1            22.5
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i regresje (lm, lm.fit) – pakiet stats z podstawowej instalacji R. Losowanie parametrów z wielowymiarowego rozkładu normalnego – pakiet MASS. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Proporcjonalne straty (IIA). MCI i logit udziałów zakładają niezależność od nieistotnych alternatyw: nowa lub tańsza marka zabiera wszystkim ten sam procent. Testy tego założenia często nie wykrywają problemu właśnie przy bliskich substytutach (Cheng i Long, 2007).
- Cena ustalana pod popyt. W symulacji zaniżyła wykładnik ceny C z −2.6 do średnio −1.65 (rysunek 6). Szukaj zmienności ceny niezależnej od popytu: eksperymentu, zmian kosztów, decyzji centrali.
- Zerowe udziały. Logarytm zera nie istnieje. Marka nieobecna w sieci w danym tygodniu nie należy do tego rynku, więc usuń ją z tego tygodnia, a nie wpisuj sztucznego „0.001”.
- Udział zamiast sprzedaży. Model nie powie, czy promocja powiększyła kategorię.
Najczęstsze pytania
Czym jest model atrakcyjności udziałów (MCI)?
To model, w którym udział marki w rynku równa się jej atrakcyjności podzielonej przez sumę atrakcyjności wszystkich marek. Atrakcyjność to iloczyn potęg zmiennych marketingowych, np. ceny, dystrybucji ważonej i efektu gazetki. Dzięki temu udziały zawsze sumują się do 100%, a działanie jednej marki zmienia udziały wszystkich pozostałych.
Jak oszacować model MCI zwykłą regresją liniową?
Zastosuj log-centrowanie: w każdym rynku (np. sieć × tydzień) podziel udział marki i jej zmienne przez ich średnią geometryczną z marek i weź logarytm. Mianownik znika i zostaje regresja liniowa. W praktyce to samo daje regresja logarytmu udziału na logarytmie ceny, gazetce i logarytmie dystrybucji z efektami stałymi każdego rynku – ma ona poprawne stopnie swobody.
Jak policzyć elastyczność udziału w rynku z modelu MCI?
Elastyczność własna względem ceny to β · (1 − udział marki), a krzyżowa – udział marki k względem ceny marki i – to −β_i · udział marki i. W przykładzie przy wykładniku −2.87 i udziale 23.4% marka D miała elastyczność własną −2.20. Elastyczności krzyżowe są w MCI takie same dla wszystkich konkurentów danej marki.
Czym różni się model MCI od logitu udziałów?
W MCI cena wchodzi do atrakcyjności w logarytmie, w logicie udziałów (MNL) – w złotówkach. W MCI elastyczność własna zmienia się z ceną łagodnie, w logicie rośnie proporcjonalnie do ceny. W przykładzie przy obecnej cenie oba modele dały podobną elastyczność (−1.84 i −1.88) i podobny błąd prognozy udziałów (1.17 i 1.19 pp), ale przy cenie 10 zł już −2.21 i −3.32.
Komu obniżka ceny zabiera klientów w modelu MCI?
Wszystkim konkurentom proporcjonalnie do ich udziałów – każdy traci ten sam procent swojego udziału. W przykładzie obniżka ceny C o 10% zabrała każdemu 7.8% udziału, więc najwięcej kilogramów oddał największy konkurent. To założenie IIA. Jeśli marki są bliskimi substytutami, rzeczywiste przepływy mogą być inne, dlatego warto je sprawdzić w danych panelowych.
Powiązane hasła
Przeczytaj też
Elastyczność cenowa z danych sprzedażowych
Sieć 10 sklepów i granola: regresja log–log z przedziałem, elastyczność krzyżowa, marża i cena optymalna oraz pułapka ceny ustalanej pod popyt – z kodem R.
Czytaj →PoradnikConjoint wyborczy (CBC) – analiza
400 osób wybiera abonament: warunkowy model logitowy, ważność atrybutów, gotowość do zapłaty, symulator udziałów i pułapki IIA – pięć rysunków z kodem R.
Czytaj →PoradnikGdzie otworzyć sklep – model Huffa
Sieć sklepów ogrodniczych i trzy działki: model Huffa z kart lojalnościowych, mapa udziałów, kanibalizacja, bootstrap i pułapka linii prostej – sześć rysunków z kodem R.
Czytaj →PoradnikDystrybucja a sprzedaż – krzywa udziału
Napój izotoniczny w 30 regionach: dystrybucja numeryczna i ważona, wypukła krzywa udziału z GAM i pułapka „sklepy biorą to, co się sprzedaje” – z kodem R.
Czytaj →PoradnikUdział w reklamie a udział w rynku (ESOV)
Osiem marek past do zębów: SOV, SOM i ESOV, regresja zmiany udziału, efekty stałe i symulacja, w której reklama nie działa, a wykres rośnie – z kodem R.
Czytaj →PoradnikPrzechodzenie klientów między markami
Macierz przejść z panelu 2500 gospodarstw: lojalność, odchylenia od niezależności, łańcuch Markowa, bootstrap i promocja – z kodem R.
Czytaj →PoradnikMarka własna a marki producentów
Płyny do mycia naczyń w 40 dyskontach: logit udziałów, elastyczności krzyżowe, asymetria i marża kategorii – z kodem R.
Czytaj →Analizujesz udziały w rynku w pracy?
Pomożemy przygotować dane z sieci i tygodni, oszacować model atrakcyjności udziałów, policzyć elastyczności i symulacje cenowe oraz opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bell, D. E., Keeney, R. L., & Little, J. D. C. (1975). A market share theorem. Journal of Marketing Research, 12(2), 136–141. https://doi.org/10.1177/002224377501200202 ● Otwarty dostęp: pełny tekst
- Berry, S. T. (1994). Estimating discrete-choice models of product differentiation. The RAND Journal of Economics, 25(2), 242–262. https://doi.org/10.2307/2555829
- Carpenter, G. S., Cooper, L. G., Hanssens, D. M., & Midgley, D. F. (1988). Modeling asymmetric competition. Marketing Science, 7(4), 393–412. https://doi.org/10.1287/mksc.7.4.393 ● Otwarty dostęp: pełny tekst
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- Ghosh, A., Neslin, S., & Shoemaker, R. (1984). A comparison of market share models and estimation procedures. Journal of Marketing Research, 21(2), 202–210. https://doi.org/10.1177/002224378402100208
- Nakanishi, M., & Cooper, L. G. (1974). Parameter estimation for a multiplicative competitive interaction model: Least squares approach. Journal of Marketing Research, 11(3), 303–311. https://doi.org/10.1177/002224377401100309
- Villas-Boas, J. M., & Winer, R. S. (1999). Endogeneity in brand choice models. Management Science, 45(10), 1324–1338. https://doi.org/10.1287/mnsc.45.10.1324
Cytowania BibTeX
@article{bell1975market, author={Bell, David E. and Keeney, Ralph L. and Little, John D. C.}, title={{A market share theorem}}, journal={Journal of Marketing Research}, year={1975}, volume={12}, number={2}, pages={136--141}, doi={10.1177/002224377501200202}}@article{berry1994estimating, author={Berry, Steven T.}, title={{Estimating discrete-choice models of product differentiation}}, journal={The RAND Journal of Economics}, year={1994}, volume={25}, number={2}, pages={242--262}, doi={10.2307/2555829}}@article{carpenter1988modeling, author={Carpenter, Gregory S. and Cooper, Lee G. and Hanssens, Dominique M. and Midgley, David F.}, title={{Modeling asymmetric competition}}, journal={Marketing Science}, year={1988}, volume={7}, number={4}, pages={393--412}, doi={10.1287/mksc.7.4.393}}@article{cheng2007testing, author={Cheng, Simon and Long, J. Scott}, title={{Testing for IIA in the multinomial logit model}}, journal={Sociological Methods \& Research}, year={2007}, volume={35}, number={4}, pages={583--600}, doi={10.1177/0049124106292361}}@article{ghosh1984comparison, author={Ghosh, Avijit and Neslin, Scott and Shoemaker, Robert}, title={{A comparison of market share models and estimation procedures}}, journal={Journal of Marketing Research}, year={1984}, volume={21}, number={2}, pages={202--210}, doi={10.1177/002224378402100208}}@article{nakanishi1974parameter, author={Nakanishi, Masao and Cooper, Lee G.}, title={{Parameter estimation for a multiplicative competitive interaction model: Least squares approach}}, journal={Journal of Marketing Research}, year={1974}, volume={11}, number={3}, pages={303--311}, doi={10.1177/002224377401100309}}@article{villasboas1999endogeneity, author={Villas-Boas, J. Miguel and Winer, Russell S.}, title={{Endogeneity in brand choice models}}, journal={Management Science}, year={1999}, volume={45}, number={10}, pages={1324--1338}, doi={10.1287/mnsc.45.10.1324}}