Co to są dane kompozycyjne?
Dane kompozycyjne (ang. compositional data) to wektory części jednej całości: udziały procentowe, proporcje albo godziny doby, które w każdym wierszu sumują się do tej samej stałej (100%, 1, 24 h). Ważne są tylko proporcje między częściami, a nie ich wartości bezwzględne. Aitchison (1982) zwrócił uwagę, że analiza takich danych sprawiała trudności, bo brakowało pojęć niezależności i rodzin rozkładów dla sympleksu – przestrzeni wektorów o stałej sumie – i zaproponował modele oparte na przekształconym rozkładzie normalnym. Przykłady to budżety czasu, struktura wydatków, skład głosów w wyborach i względne liczebności bakterii w badaniach mikrobiomu.
Dlaczego zwykłe korelacje zawodzą
Stała suma wymusza zależność: jeśli jedna część rośnie, inne muszą maleć. Część ujemnych korelacji między składnikami jest więc korelacją pozorną, wynikającą z domknięcia, a nie z zależności między zjawiskami. Gloor i in. (2017) pokazują, że dane z sekwencjonowania mikrobiomu są kompozycyjne, bo całkowitą liczbę odczytów narzuca aparat, i ostrzegają przed błędami wynikającymi z ignorowania tej cechy.
Transformacje log-ratio
- alr (addytywna): ln(xi/xD) – logarytmy ilorazów względem wybranej części odniesienia; wynik zależy od tego wyboru.
- clr (centrowana): ln(xi/g(x)), gdzie g to średnia geometryczna części; wartości sumują się do zera, więc ich macierz kowariancji jest osobliwa.
- ilr (izometryczna): D − 1 współrzędnych ortonormalnych, nadających się do regresji czy PCA; wymaga wyboru bazy, np. tzw. równowag.
Przykład
W symulacji 200 studentów czas nauki i czas wolny losowano niezależnie (r = −.002). Po przeliczeniu na budżet 24 h korelacja wyniosła −.335, a między snem a pracą −.419. Student z 6.3 h snu, 8.1 h nauki, 4.2 h pracy i 5.3 h czasu wolnego ma wartości clr 0.077, 0.330, −0.319 i −0.088 (suma 0), a alr względem czasu wolnego: 0.165, 0.417 i −0.232.
Na rysunku
Rysunek używa tych samych 200 symulowanych studentów co przykład (set.seed(646)). Parametry rozkładów gamma ustawiono ręcznie tak, żeby średnie przypominały typową dobę studenta; ziarna nie zmieniano. Cztery składniki losowano niezależnie, więc każda korelacja różna od zera pochodzi z przeliczenia, a nie z danych.
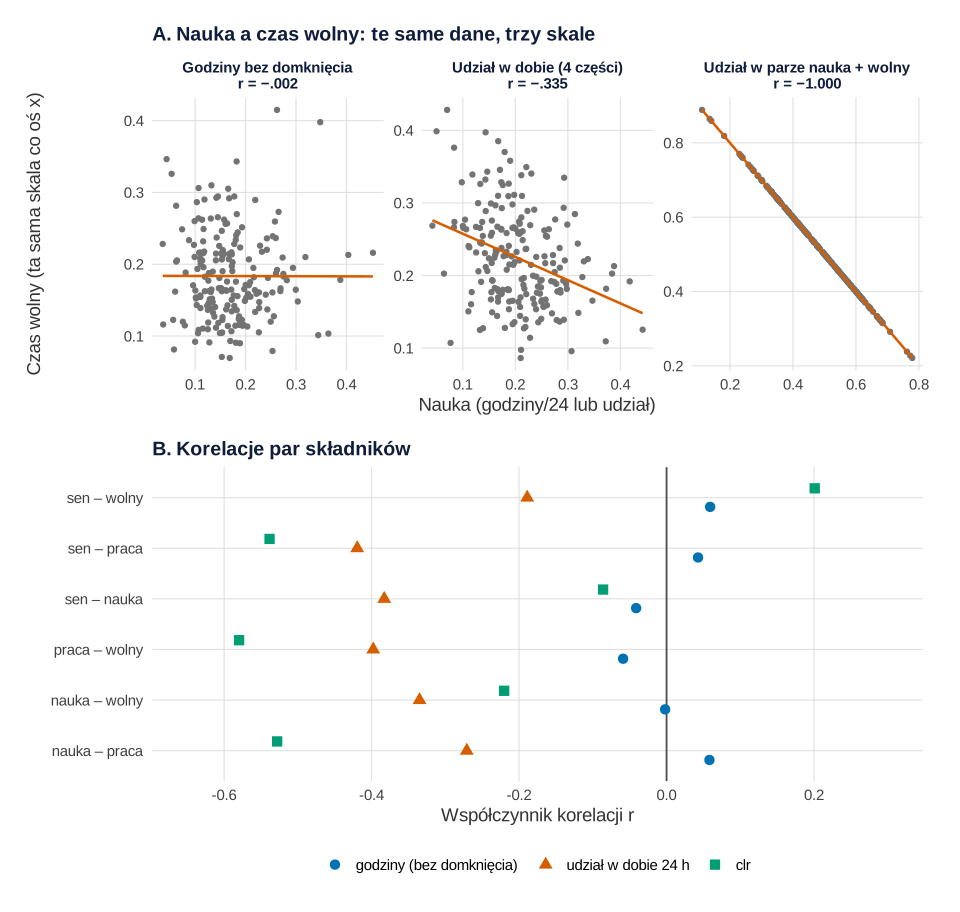
Co widać. Panel A pokazuje jedną parę, naukę i czas wolny. W godzinach nie są skorelowane (r = −.002). Po przeliczeniu na udziały w dobie korelacja spada do −.335, a w podkompozycji złożonej tylko z tych dwóch części wynosi dokładnie −1. Ta sama para ma więc trzy różne korelacje, zależnie od tego, jakie inne części wliczono do całości. Panel B pokazuje to samo dla wszystkich sześciu par. W godzinach korelacje mieszczą się między −.059 a .059. Po domknięciu wszystkie są ujemne (od −.419 do −.189).
Na co uważać. Transformacja clr nie przywraca zerowych korelacji. Kwadraty w panelu B leżą od −.580 do .201, bo wartości clr każdej osoby też sumują się do zera. Korelacji części nie da się więc „naprawić” przekształceniem. Niezmienne pozostają za to log-ilorazy: ln(nauka/wolny) jest identyczny w godzinach, w dobie i w parze (różnice rzędu 10−16 w wyniku kodu). Dlatego zależności w danych kompozycyjnych opisuje się ilorazami (alr, ilr, równowagi), a nie korelacjami udziałów. Wykres rozrzutu udziałów (zob. wykres rozrzutu) pokazuje kierunek, ale nie odróżnia zależności merytorycznej od tej wymuszonej stałą sumą. Rysunek nie pokazuje też problemu zer, które w log-ratio trzeba zastąpić przed analizą.
Podpis do pracy:
Kod poniżej odtwarza rysunek i wypisuje korelacje z panelu B. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu. Dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Korelacja pozorna z domknięcia: te same niezależne składniki jako godziny, udziały w dobie i po clr
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw; skalę rozróżnia też kształt punktu
kol <- c("godziny (bez domknięcia)" = "#0072B2", "udział w dobie 24 h" = "#D55E00", "clr" = "#009E73")
ksz <- c("godziny (bez domknięcia)" = 16, "udział w dobie 24 h" = 17, "clr" = 15)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(646)                                        # te same dane co w przykładzie (200 studentów)
n <- 200
surowe <- data.frame(sen = rgamma(n, 40, 5), nauka = rgamma(n, 6, 1.5),
                     praca = rgamma(n, 3, 1), wolny = rgamma(n, 9, 2))  # niezależne składniki
doba <- 24 * surowe / rowSums(surowe)                # domknięcie do 24 h (4 części)
pod <- surowe[c("nauka", "wolny")] / rowSums(surowe[c("nauka", "wolny")])  # podkompozycja nauka + wolny
clr <- function(x) log(x) - mean(log(x))
Z <- as.data.frame(t(apply(doba, 1, clr)))

# A. Nauka a czas wolny w trzech wersjach tych samych danych
fr <- function(r) sub("-", "−", sub("^(-?)0\\.", "\\1.", sprintf("%.3f", r)))   # r w zapisie APA
wersje <- c(paste0("Godziny bez domknięcia\nr = ", fr(cor(surowe$nauka, surowe$wolny))),
            paste0("Udział w dobie (4 części)\nr = ", fr(cor(doba$nauka, doba$wolny))),
            paste0("Udział w parze nauka + wolny\nr = ", fr(cor(pod$nauka, pod$wolny))))
rozrzut <- rbind(data.frame(wersja = wersje[1], x = surowe$nauka / 24, y = surowe$wolny / 24),
                 data.frame(wersja = wersje[2], x = doba$nauka / 24, y = doba$wolny / 24),
                 data.frame(wersja = wersje[3], x = pod$nauka, y = pod$wolny))
rozrzut$wersja <- factor(rozrzut$wersja, levels = wersje)
pA <- ggplot(rozrzut, aes(x, y)) +
  geom_point(colour = "grey45", size = 1.4) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#D55E00", linewidth = 0.9) +
  facet_wrap(~ wersja, nrow = 1, scales = "free") +
  labs(title = "A. Nauka a czas wolny: te same dane, trzy skale",
       x = "Nauka (godziny/24 lub udział)", y = "Czas wolny (ta sama skala co oś x)") +
  motyw + theme(axis.text = element_text(size = rel(0.75)))

# B. Korelacje wszystkich 6 par składników w trzech skalach
pary <- combn(names(surowe), 2)
r_par <- function(d, skala) data.frame(para = paste(pary[1, ], pary[2, ], sep = " – "), skala = skala,
                                       r = apply(pary, 2, function(p) cor(d[[p[1]]], d[[p[2]]])))
korel <- rbind(r_par(surowe, names(kol)[1]), r_par(doba, names(kol)[2]), r_par(Z, names(kol)[3]))
korel$skala <- factor(korel$skala, levels = names(kol))
tab <- reshape(korel, idvar = "para", timevar = "skala", direction = "wide")
names(tab) <- c("para", "godziny", "doba_24h", "clr")
print(cbind(tab[1], round(tab[-1], 3)), row.names = FALSE)
lr <- function(d) log(d$nauka / d$wolny)             # log-ratio nauka/wolny w każdej wersji
c(max_roznica_logratio_doba = max(abs(lr(surowe) - lr(doba))),
  max_roznica_logratio_para = max(abs(lr(surowe) - lr(pod))))

pB <- ggplot(korel, aes(r, para, colour = skala, shape = skala)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_point(size = 3.2, position = position_dodge(width = 0.55)) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = ksz, name = NULL) +
  scale_x_continuous(limits = c(-0.65, 0.3), breaks = c(-0.6, -0.4, -0.2, 0, 0.2)) +
  labs(title = "B. Korelacje par składników", x = "Współczynnik korelacji r", y = NULL) +
  motyw

p <- pA / pB + plot_layout(heights = c(1, 1.15))
p
Wynik w R
          para godziny doba_24h    clr
   sen – nauka  -0.041   -0.383 -0.086
   sen – praca   0.043   -0.419 -0.538
   sen – wolny   0.059   -0.189  0.201
 nauka – praca   0.058   -0.271 -0.528
 nauka – wolny  -0.002   -0.335 -0.220
 praca – wolny  -0.059   -0.398 -0.580
max_roznica_logratio_doba max_roznica_logratio_para
             4.440892e-16              4.440892e-16
Jak opisać w pracy
Na co uważać
Log-ratio nie istnieje dla zer – trzeba je zastąpić małą wartością albo połączyć rzadkie części, a decyzję opisać. Pojedynczą proporcję (np. odsetek zaliczonych) analizuje się inaczej, np. logitem. Podobny problem stałej sumy dotyczy wyników po ipsatyzacji.
Transformacje clr i alr w R
Kod domyka niezależne składniki do 24 h, porównuje korelacje i liczy clr oraz alr ręcznie, a następnie sprawdza je funkcjami pakietu compositions i wyznacza współrzędne ilr. Liczby w tekście pochodzą z tego kodu.
Korelacja pozorna z domknięcia, clr i alr
R
set.seed(646)                                       # dane symulowane: budżet doby 200 studentów
n <- 200
surowe <- data.frame(sen = rgamma(n, 40, 5), nauka = rgamma(n, 6, 1.5),
                     praca = rgamma(n, 3, 1), wolny = rgamma(n, 9, 2))  # niezależne składniki
doba <- 24 * surowe / rowSums(surowe)               # domknięcie: każdy wiersz sumuje się do 24 h
round(c(r_nauka_wolny_przed = cor(surowe$nauka, surowe$wolny),
        r_nauka_wolny_po = cor(doba$nauka, doba$wolny),
        r_sen_praca_po = cor(doba$sen, doba$praca)), 3)
clr <- function(x) log(x) - mean(log(x))            # log(x / średnia geometryczna)
alr <- function(x, ref = length(x)) log(x[-ref] / x[ref])   # odniesienie: ostatni składnik
os1 <- unlist(doba[1, ])
round(rbind(godziny = os1, clr = clr(os1)), 3)
round(c(suma_clr = sum(clr(os1)), alr(os1)), 3)     # alr względem czasu wolnego
Z <- t(apply(doba, 1, clr))
c(wyznacznik_kow_clr = det(cov(Z)), suma_wierszy_clr_max = max(abs(rowSums(Z))))   # macierz osobliwa
# Pakiet compositions: te same clr i alr oraz współrzędne ilr (D − 1 = 3)
suppressPackageStartupMessages(library(compositions))
I_ilr <- unclass(compositions::ilr(acomp(doba)))
c(roznica_clr_max = max(abs(unclass(compositions::clr(acomp(doba))) - Z)),
  roznica_alr_max = max(abs(unclass(compositions::alr(acomp(doba))) - t(apply(doba, 1, alr)))),
  wyznacznik_kow_ilr = det(cov(I_ilr)))
Wynik w R
r_nauka_wolny_przed    r_nauka_wolny_po      r_sen_praca_po
             -0.002              -0.335              -0.419
          sen nauka  praca  wolny
godziny 6.302 8.112  4.240  5.345
clr     0.077 0.330 -0.319 -0.088
suma_clr      sen    nauka    praca
   0.000    0.165    0.417   -0.232
  wyznacznik_kow_clr suma_wierszy_clr_max
        6.826509e-21         4.440892e-16
   roznica_clr_max    roznica_alr_max wyznacznik_kow_ilr
      5.551115e-16       4.440892e-16       3.324628e-03
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet compositions 2.0-9). Rysunek 1 wykonano pakietami ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- compositions (wersja 2.0-9): van den Boogaart, K. G., Tolosana-Delgado, R., & Bren, M. (2025). compositions: Compositional data analysis (R package version 2.0-9) [Computer software]. https://doi.org/10.32614/CRAN.package.compositions
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy odsetki z ankiety to dane kompozycyjne?
Tak, jeśli kilka odsetków opisuje podział tej samej całości, np. strukturę wydatków czy budżet czasu. Pojedynczy odsetek, np. odsetek poprawnych odpowiedzi, nie jest kompozycją wielu części.
Którą transformację log-ratio wybrać?
clr jest symetryczna i dobra do opisu oraz PCA; alr jest najprostsza, ale zależy od części odniesienia; ilr daje ortonormalne współrzędne bez osobliwej macierzy kowariancji, wygodne w regresji. Wybór uzasadnij pytaniem badawczym.
Co zrobić z zerami w danych kompozycyjnych?
Logarytm zera nie istnieje, więc zera zastępuje się małą wartością dodatnią albo łączy rzadkie części w kategorię „inne”. Opisz wybraną metodę i sprawdź, czy wyniki od niej zależą.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Aitchison, J. (1982). The statistical analysis of compositional data. Journal of the Royal Statistical Society: Series B (Methodological), 44(2), 139–160. https://doi.org/10.1111/j.2517-6161.1982.tb01195.x
- Gloor, G. B., Macklaim, J. M., Pawlowsky-Glahn, V., & Egozcue, J. J. (2017). Microbiome datasets are compositional: And this is not optional. Frontiers in Microbiology, 8, Article 2224. https://doi.org/10.3389/fmicb.2017.02224 ● Otwarty dostęp
Cytowania BibTeX
@article{aitchison1982statistical, author={Aitchison, John}, title={{The statistical analysis of compositional data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1982}, volume={44}, number={2}, pages={139--160}, doi={10.1111/j.2517-6161.1982.tb01195.x}}@article{gloor2017microbiome, author={Gloor, Gregory B. and Macklaim, Jean M. and Pawlowsky-Glahn, Vera and Egozcue, Juan J.}, title={{Microbiome datasets are compositional: And this is not optional}}, journal={Frontiers in Microbiology}, year={2017}, volume={8}, eid={2224}, doi={10.3389/fmicb.2017.02224}}