Najpierw pytanie: po co transformacja?
Transformacja to zamiana każdego wyniku na inny według jednej reguły, np. y → ln y albo y → √y. Studenci sięgają po nią zwykle wtedy, gdy test Shapiro–Wilka „odrzucił normalność” zmiennej. To najsłabszy powód z możliwych. Założenie normalności w regresji, teście t i ANOVA dotyczy reszt, a nie surowej zmiennej. Pokazujemy to we wpisie normalność reszt czy zmiennych.
Transformacja ma też koszt, o którym łatwo zapomnieć: zmienia pytanie badawcze. Po logarytmowaniu nie porównujesz już różnicy w minutach, tylko iloraz, czyli „o ile procent”. Wynik przeliczony z logarytmów to średnia geometryczna, a nie arytmetyczna. Pek i in. (2018) przejrzeli 61 podręczników i znaleźli co najmniej osiem sposobów radzenia sobie z nienormalnością. Transformacja jest tylko jednym z nich. Pozostałe to m.in. metody odporne, bootstrap i modele, które zakładają inny rozkład wyniku.
Kiedy tak, kiedy nie: tabela
| Sytuacja | Transformować? | Co zrobić |
|---|---|---|
| Wynik dodatni, prawostronnie skośny, efekty proporcjonalne (czas reakcji, czas zasypiania, kwoty) | Tak, jeśli pytasz o ilorazy | Logarytm i średnie geometryczne albo regresja gamma z łączem logarytmicznym |
| Zliczenia: liczba epizodów, dni, błędów, często z zerami | Nie | Regresja Poissona albo ujemna dwumianowa |
| Wynik skali kwestionariusza (suma lub średnia), lekko skośny | Zwykle nie | Analiza na surowych wynikach; przy dużych grupach test t i regresja są odporne na umiarkowaną skośność |
| Kilka skrajnych wyników | Nie | Sprawdź, czy to błąd danych; potem metody odporne, np. średnia ucinana |
| Rozrzut reszt rośnie z poziomem wyniku | Czasem | Logarytm, jeśli efekty są proporcjonalne; w innym razie odporne błędy standardowe HC3 |
| Skośny predyktor w regresji | Tylko dla liniowości | Predyktor nie musi mieć rozkładu normalnego; przy krzywoliniowym związku rozważ splajny |
| Pojedyncza pozycja Likerta (1–5) | Nie | Regresja porządkowa albo test nieparametryczny |
Przy umiarkowanej skośności i braku wpływowych obserwacji modele z normalnymi błędami dają dość wiarygodne wartości p. Taki wniosek przynoszą symulacje Kniefa i Forstmeiera (2021). Autorzy podkreślają jednak, że trzeba obejrzeć dane pod kątem obserwacji odstających i heteroskedastyczności. Jak sprawdzić rozkład, opisuje poradnik jak sprawdzić normalność rozkładu, a jak postąpić przy teście t – wpis test t przy rozkładzie innym niż normalny.
Logarytm i regresja gamma odpowiadają na podobne pytanie, ale nie są zamienne. Manning i Mullahy (2001) pokazali w symulacjach, że żadne z tych podejść nie wygrywa we wszystkich warunkach. Dlatego wybór uzasadnij rodzajem danych, a nie tym, które dało mniejsze p.
Przykład: logarytm ze stałą przy zliczeniach
Zliczenia mają zera, a ln 0 nie istnieje. Popularne „rozwiązanie” to ln(y + 1). Sprawdźmy, co ono robi. W symulowanym badaniu 120 osób z lękiem społecznym przez 14 dni zapisywało w dzienniczku sytuacje, których unikały. Po programie ekspozycji (n = 60) średnia wyniosła 2.43 sytuacji (SD = 2.49, 28.3% zer), a w grupie kontrolnej (n = 60) – 3.42 (SD = 2.61, 11.7% zer). Iloraz średnich to 0.712.
Policzyliśmy regresję liniową na ln(y + c) dla pięciu stałych c. Iloraz „program / kontrola” wyniósł od 0.34 przy c = 0.01 do 0.88 przy c = 5 (rysunek 1). Program zmniejszałby więc unikanie o 65.9% albo o 12.1%, zależnie od arbitralnej liczby dodanej do danych. Żadna z tych wartości nie jest „prawdziwa”, bo żadna nie odpowiada parametrowi, o który pytasz.
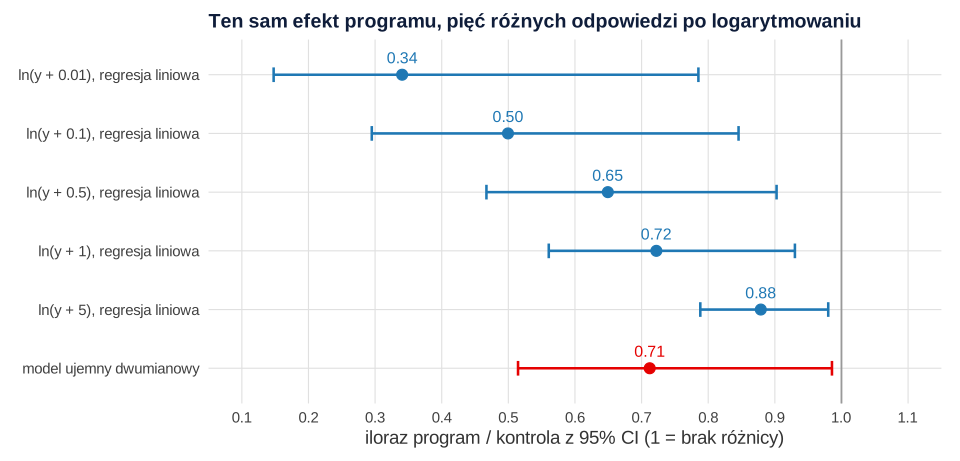
Model ujemny dwumianowy analizuje surowe zliczenia i nie potrzebuje żadnej stałej. Dał iloraz częstości (IRR) 0.712, 95% CI [0.515, 0.986], z = −2.05, p = .041. To dokładnie iloraz średnich z danych, czyli wielkość, którą da się opisać czytelnikowi. O’Hara i Kotze (2010) w symulacjach pokazali, że transformacje logarytmiczna i pierwiastkowa źle sprawdzają się przy zliczeniach (z wyjątkiem małego rozproszenia i dużych średnich), a modele dla zliczeń działają dobrze. Cały model krok po kroku opisuje poradnik regresja dla zliczeń.
Jeśli transformujesz – trzy zasady
- Zdecyduj przed analizą. Wybór transformacji zapisz w planie analiz. Sprawdzanie kilku transformacji i wybranie tej z najlepszym wynikiem to odmiana p-hackingu.
- Uważaj na interakcje. Nieliniowa transformacja może sprawić, że interakcja pojawi się albo zniknie. Lo i Andrews (2015) opisują dane z czasami reakcji, w których surowe wyniki dawały efekty addytywne, a przekształcone – interakcję. Wagenmakers i in. (2012) pokazują, że interakcje bez przecięcia linii zależą od skali pomiaru. Jeśli hipoteza dotyczy interakcji w ANOVA, wybierz skalę z uzasadnieniem teoretycznym.
- Raportuj w jednostkach zrozumiałych dla czytelnika. Przelicz wyniki z powrotem: średnie geometryczne, ilorazy, procentowe zmiany. Ogólniejszą rodzinę przekształceń opisuje hasło transformacja Boxa–Coxa. Tam też przeczytasz, jak opisać wybraną λ.
Jak to opisać w pracy
Wzór dla przykładu z dzienniczkiem unikania, gdy zamiast transformacji użyto modelu dla zliczeń:
Jeśli logarytmujesz dodatni wynik ciągły, podaj w metodzie powód (skośność reszt, efekty proporcjonalne), rodzaj logarytmu, a w wynikach – średnie geometryczne i iloraz z 95% CI. Gdzie w całej pracy umieścić takie decyzje, pokazuje przewodnik po statystyce w pracy dyplomowej, a wybór testu – przewodnik po testach statystycznych.
Logarytm ze stałą a model ujemny dwumianowy w R
Kod odtwarza wszystkie liczby z tekstu: statystyki opisowe zliczeń, iloraz z regresji na ln(y + c) dla pięciu stałych i iloraz częstości z modelu ujemnego dwumianowego (MASS::glm.nb()).
Pięć transformacji i jeden model dla zliczeń
R
# B195 – kiedy transformować zmienną: logarytm ze stałą a model dla zliczeń
# Dane symulowane: 120 osób z lękiem społecznym; liczba sytuacji unikania
# zapisanych w dzienniczku przez 14 dni po programie ekspozycji (n = 60)
# albo w grupie kontrolnej (n = 60).
library(MASS)
set.seed(1958)
dane <- data.frame(grupa = factor(rep(c("kontrola", "program"), each = 60),
                                  levels = c("kontrola", "program")),
                   unikanie = c(rnbinom(60, mu = 4.0, size = 1.2),
                                rnbinom(60, mu = 2.6, size = 1.2)))

# 1. Opis: średnia, SD, mediana, odsetek zer
aggregate(unikanie ~ grupa, dane, function(x)
  round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), zera_proc = 100 * mean(x == 0)), 2))
round(with(dane, tapply(unikanie, grupa, mean)["program"] / tapply(unikanie, grupa, mean)["kontrola"]), 3)

# 2. Regresja liniowa na ln(y + c): wynik zależy od arbitralnej stałej c
stale <- c(0.01, 0.1, 0.5, 1, 5)
log_c <- t(sapply(stale, function(cc) {
  m <- lm(log(unikanie + cc) ~ grupa, data = dane)
  ci <- confint(m)["grupaprogram", ]
  c(stala = cc, iloraz = exp(coef(m)[["grupaprogram"]]), dolna = exp(ci[[1]]), gorna = exp(ci[[2]]),
    p = summary(m)$coefficients["grupaprogram", 4])
}))
round(log_c, 3)

# 3. Model dla zliczeń bez transformacji: ujemny dwumianowy (glm.nb)
nb <- glm.nb(unikanie ~ grupa, data = dane)
s <- summary(nb)$coefficients["grupaprogram", ]
round(c(IRR = exp(s[["Estimate"]]),
        dolna = exp(s[["Estimate"]] - qnorm(.975) * s[["Std. Error"]]),
        gorna = exp(s[["Estimate"]] + qnorm(.975) * s[["Std. Error"]]),
        z = s[["z value"]], p = s[["Pr(>|z|)"]], theta = nb$theta), 3)

# 4. Ten sam efekt jako procentowa zmiana: 100 × (1 − iloraz)
round(100 * (1 - c(log_c[, "iloraz"], NB = exp(s[["Estimate"]]))), 1)
Wynik w R
     grupa unikanie.n unikanie.M unikanie.SD unikanie.Me unikanie.zera_proc
1 kontrola      60.00       3.42        2.61        3.00              11.67
2  program      60.00       2.43        2.49        2.00              28.33
program
  0.712
     stala iloraz dolna gorna     p
[1,]  0.01  0.341 0.148 0.785 0.012
[2,]  0.10  0.499 0.295 0.846 0.010
[3,]  0.50  0.649 0.467 0.903 0.011
[4,]  1.00  0.722 0.561 0.930 0.012
[5,]  5.00  0.879 0.788 0.980 0.021
   IRR  dolna  gorna      z      p  theta
 0.712  0.515  0.986 -2.047  0.041  2.113
                           NB
65.9 50.1 35.1 27.8 12.1 28.8
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm() z pakietu stats i glm.nb() z pakietu MASS); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy trzeba transformować zmienną, gdy test Shapiro–Wilka wyszedł istotny?
Nie. Założenie normalności w regresji, teście t i ANOVA dotyczy reszt, a nie surowej zmiennej, a przy większych grupach umiarkowana skośność rzadko szkodzi. Obejrzyj wykres Q-Q reszt i sprawdź obserwacje odstające. Transformację wybierz dopiero wtedy, gdy pasuje do pytania badawczego.
Czy można logarytmować zmienną z zerami, dodając 1?
Technicznie tak, ale wynik zależy od dodanej stałej. W przykładzie z tego wpisu iloraz efektu wahał się od 0.34 przy ln(y + 0.01) do 0.88 przy ln(y + 5). Przy zliczeniach z zerami użyj regresji Poissona albo ujemnej dwumianowej.
Jak opisać w pracy wyniki po transformacji logarytmicznej?
W metodzie podaj powód transformacji i rodzaj logarytmu. W wynikach przelicz oszacowania z powrotem: podaj średnie geometryczne zamiast arytmetycznych i iloraz z 95% przedziałem ufności, także jako zmianę procentową. Nie opisuj średniej geometrycznej jako zwykłej średniej.
Powiązane hasła
Przeczytaj też
Normalność reszt czy zmiennych?
Dlaczego w regresji i ANOVA sprawdzasz reszty, a nie surową zmienną: przykład w R z dwugarbnym rozkładem, wykres Q-Q reszt i wpływ liczebności próby.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →Nie wiesz, czy transformować zmienną?
Sprawdzimy rozkład reszt i rodzaj zmiennej, pomożemy wybrać między transformacją a odpowiednim modelem i wyjaśnimy, jak opisać tę decyzję w pracy.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Knief, U., & Forstmeier, W. (2021). Violating the normality assumption may be the lesser of two evils. Behavior Research Methods, 53(6), 2576–2590. https://doi.org/10.3758/s13428-021-01587-5 ● Otwarty dostęp
- Lo, S., & Andrews, S. (2015). To transform or not to transform: Using generalized linear mixed models to analyse reaction time data. Frontiers in Psychology, 6, Article 1171. https://doi.org/10.3389/fpsyg.2015.01171 ● Otwarty dostęp
- Manning, W. G., & Mullahy, J. (2001). Estimating log models: To transform or not to transform? Journal of Health Economics, 20(4), 461–494. https://doi.org/10.1016/s0167-6296(01)00086-8 ● Otwarty dostęp: pełny tekst
- O’Hara, R. B., & Kotze, D. J. (2010). Do not log-transform count data. Methods in Ecology and Evolution, 1(2), 118–122. https://doi.org/10.1111/j.2041-210x.2010.00021.x
- Pek, J., Wong, O., & Wong, A. C. M. (2018). How to address non-normality: A taxonomy of approaches, reviewed, and illustrated. Frontiers in Psychology, 9, Article 2104. https://doi.org/10.3389/fpsyg.2018.02104 ● Otwarty dostęp
- Wagenmakers, E.-J., Krypotos, A.-M., Criss, A. H., & Iverson, G. (2012). On the interpretation of removable interactions: A survey of the field 33 years after Loftus. Memory & Cognition, 40(2), 145–160. https://doi.org/10.3758/s13421-011-0158-0 ● Otwarty dostęp
Cytowania BibTeX
@article{knief2021violating, author={Knief, Ulrich and Forstmeier, Wolfgang}, title={{Violating the normality assumption may be the lesser of two evils}}, journal={Behavior Research Methods}, year={2021}, volume={53}, number={6}, pages={2576--2590}, doi={10.3758/s13428-021-01587-5}}@article{lo2015transform, author={Lo, Steson and Andrews, Sally}, title={{To transform or not to transform: Using generalized linear mixed models to analyse reaction time data}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={1171}, doi={10.3389/fpsyg.2015.01171}}@article{manning2001estimating, author={Manning, Willard G. and Mullahy, John}, title={{Estimating log models: To transform or not to transform?}}, journal={Journal of Health Economics}, year={2001}, volume={20}, number={4}, pages={461--494}, doi={10.1016/s0167-6296(01)00086-8}}@article{ohara2010do, author={O'Hara, Robert B. and Kotze, D. Johan}, title={{Do not log-transform count data}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={2}, pages={118--122}, doi={10.1111/j.2041-210x.2010.00021.x}}@article{pek2018address, author={Pek, Jolynn and Wong, Octavia and Wong, Augustine C. M.}, title={{How to address non-normality: A taxonomy of approaches, reviewed, and illustrated}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={2104}, doi={10.3389/fpsyg.2018.02104}}@article{wagenmakers2012interpretation, author={Wagenmakers, Eric-Jan and Krypotos, Angelos-Miltiadis and Criss, Amy H. and Iverson, Geoff}, title={{On the interpretation of removable interactions: A survey of the field 33 years after Loftus}}, journal={Memory \& Cognition}, year={2012}, volume={40}, number={2}, pages={145--160}, doi={10.3758/s13421-011-0158-0}}