Co to są transformacje logitowa i arcus sinus?
Transformacja logitowa (ang. logit transformation) zamienia proporcję p na logarytm szans: logit(p) = ln[p/(1 − p)]. Transformacja arcus sinus (kątowa, ang. arcsine square root transformation) liczy arcsin(√p). Obie rozciągają wartości blisko 0 i 1, żeby proporcje lepiej spełniały założenia modelu liniowego. Logit przenosi proporcje na całą oś liczbową, a arcus sinus – na przedział od 0 do π/2 (ok. 1.571). To krewne innych przekształceń stabilizujących wariancję, takich jak logarytmiczna, Boxa–Coxa czy Fishera z dla korelacji.
Kiedy którą wybrać
Warton i Hui (2011) odradzają arcus sinus w obu typowych sytuacjach:
- Dane dwumianowe (x sukcesów na n prób): zamiast przekształcać odsetki, użyj regresji logistycznej – łatwiej ją interpretować i zwykle ma większą moc. Sprawdź nadmierną dyspersję, a gdy występuje, dodaj efekty losowe.
- Proporcje niedwumianowe (np. odsetek czasu, pokrycie powierzchni): arcus sinus utrudnia interpretację i może dawać bezsensowne prognozy, dlatego autorzy proponują logit.
Alternatywą dla proporcji ciągłych jest regresja beta, która modeluje średnią proporcji bezpośrednio; przy łączu logit jej współczynniki interpretuje się jako ilorazy szans, inaczej niż w regresji liniowej na przekształconej zmiennej (Ferrari i Cribari-Neto, 2004). Logit nie istnieje dla 0 i 1, więc przed przekształceniem dodaje się małą poprawkę, np. empiryczny logit z (x + 0.5)/(n + 1).
Przykład
Dla proporcji .01, .50 i .99 logit wynosi −4.6, 0 i 4.6, a arcus sinus 0.10, 0.79 i 1.47. W symulowanych danych z 12 klas po 25 uczniów odsetek zdanych rósł z liczbą godzin zajęć dodatkowych. Regresja logistyczna dała b = 0.47 (OR = 1.59), a regresja liniowa empirycznego logitu – podobne 0.45. Model na arcus sinusie przewidział dla 10 godzin wartość 1.682, czyli powyżej π/2 – takiej proporcji nie ma. Regresja logistyczna przewidziała .983.
Na rysunku
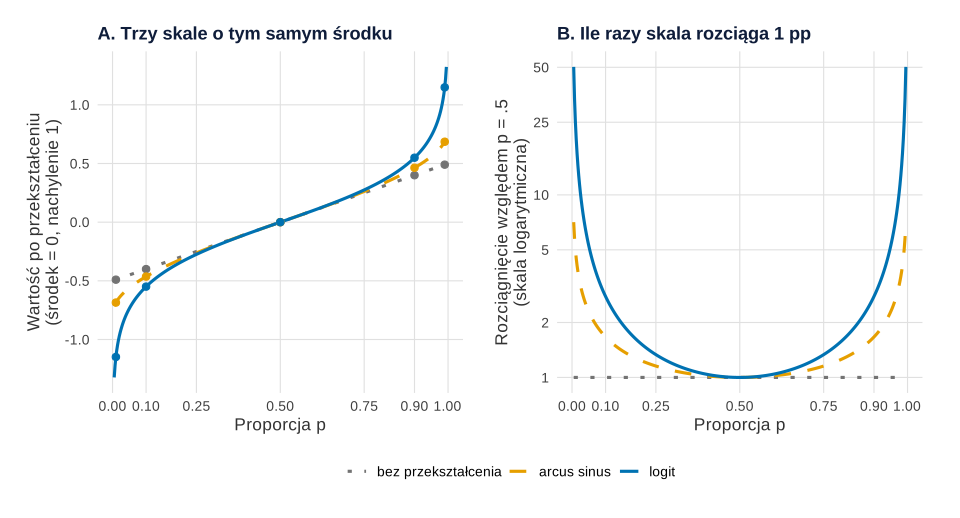
Co widać. W panelu A trzy skale przesunięto i przeskalowano tak, by w środku (p = .5) miały tę samą wartość i to samo nachylenie. Między ok. .25 a .75 linie prawie się pokrywają – tam przekształcenie niewiele zmienia. Różnice zaczynają się przy końcach. Arcus sinus odgina się łagodnie i kończy na skończonej wartości, a logit ucieka w nieskończoność przy 0 i 1. Panel B mówi to samo liczbami. Przy p = .25 różnica jednego punktu procentowego waży na skali arcus sinus 1.15 razy więcej niż w środku, a na skali logitu 1.33 razy więcej. Przy .10 – 1.67 i 2.78 razy, a przy .01 – 5.03 i 25.25 razy. Logit rozciąga więc skrajne odsetki znacznie mocniej niż arcus sinus.
Na co uważać. Rysunek pokazuje same skale, a nie dane. Nie mówi, czy po przekształceniu reszty będą miały stałą wariancję, ani czy w ogóle warto przekształcać. Przy danych dwumianowych lepiej od razu dopasować regresję logistyczną (Warton i Hui, 2011). Silne rozciąganie logitu przy końcach ma też koszt. Odsetek 0/25 i 1/25 dzieli na tej skali duża odległość, a jej wielkość zależy od dodanej poprawki (np. +0.5). Dlatego przy wielu zerach i jedynkach empiryczny logit bywa niestabilny. Jak ta sama skala logitu wygląda w modelu, pokazuje wpis regresja logistyczna w obrazkach.
Podpis do pracy:
Kod rysunku niczego nie losuje: krzywe to wzory, a rozciągnięcie to pochodne przekształceń podzielone przez ich wartość w p = .5. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Jak logit i arcus sinus rozciągają skrajne proporcje (bez losowania)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c("bez przekształcenia" = "grey45", "arcus sinus" = "#E69F00", "logit" = "#0072B2")   # Okabe–Ito
lin <- c("bez przekształcenia" = "dotted", "arcus sinus" = "dashed", "logit" = "solid")
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
p <- seq(0.005, 0.995, by = 0.0025)
skala <- c("bez przekształcenia", "arcus sinus", "logit")
# A: każda skala przesunięta i przeskalowana tak, by w p = .5 miała wartość 0 i nachylenie 1
A <- data.frame(p = rep(p, 3), skala = factor(rep(skala, each = length(p)), skala),
                y = c(p - 0.5, asin(sqrt(p)) - pi / 4, qlogis(p) / 4))
# B: lokalne rozciągnięcie (pochodna) względem środka skali, p = .5
B <- data.frame(p = rep(p, 3), skala = factor(rep(skala, each = length(p)), skala),
                y = c(rep(1, length(p)), 0.5 / sqrt(p * (1 - p)), 0.25 / (p * (1 - p))))
znaczniki <- c(.01, .10, .50, .90, .99)
pA <- ggplot(A, aes(p, y, colour = skala, linetype = skala)) + geom_line(linewidth = 1.1) +
  geom_point(data = subset(A, round(p, 4) %in% znaczniki), size = 2.2, show.legend = FALSE) +
  scale_x_continuous(breaks = c(0, .1, .25, .5, .75, .9, 1)) +
  labs(title = "A. Trzy skale o tym samym środku", x = "Proporcja p", y = "Wartość po przekształceniu\n(środek = 0, nachylenie 1)")
pB <- ggplot(B, aes(p, y, colour = skala, linetype = skala)) + geom_line(linewidth = 1.1) +
  scale_y_log10(breaks = c(1, 2, 5, 10, 25, 50)) + scale_x_continuous(breaks = c(0, .1, .25, .5, .75, .9, 1)) +
  labs(title = "B. Ile razy skala rozciąga 1 pp", x = "Proporcja p", y = "Rozciągnięcie względem p = .5\n(skala logarytmiczna)")
p1 <- (pA + pB) + plot_layout(guides = "collect") &
  scale_colour_manual(values = kol, name = NULL, drop = FALSE) &
  scale_linetype_manual(values = lin, name = NULL, drop = FALSE) & motyw
pp <- c(.01, .05, .10, .25, .50)
round(rbind(arcus_sinus = 0.5 / sqrt(pp * (1 - pp)), logit = 0.25 / (pp * (1 - pp))), 2) |>
  `colnames<-`(paste0("p = ", sub("^0", "", pp)))
p1
Wynik w R
            p = .01 p = .05 p = .1 p = .25 p = .5
arcus_sinus    5.03    2.29   1.67    1.15      1
logit         25.25    5.26   2.78    1.33      1
Jak opisać w pracy
Na co uważać
Wyniki modelu na przekształconej skali trudno przełożyć na punkty procentowe – podawaj prognozy po przekształceniu odwrotnym. Do przedziału ufności dla pojedynczej proporcji lepiej użyć metod z hasła przedział ufności dla proporcji niż ręcznej transformacji.
Logit, arcus sinus i regresja logistyczna w R
Kod pokazuje, jak obie transformacje rozciągają końce skali, a potem porównuje regresję liniową na arcus sinusie, regresję liniową empirycznego logitu i regresję logistyczną dla danych dwumianowych, łącznie z prognozą poza zakresem danych.
Trzy podejścia do odsetków zdanych egzaminów
R
set.seed(600)
p <- c(0.01, 0.10, 0.50, 0.90, 0.99)
round(rbind(logit = qlogis(p), arcsin = asin(sqrt(p))), 2)   # jak każda skala rozciąga końce
k <- 12; n <- 25                                   # 12 klas po 25 uczniów
godziny <- rep(1:6, each = 2)                      # godziny zajęć dodatkowych
zdani <- rbinom(k, n, plogis(-0.5 + 0.45 * godziny))
pr <- zdani / n
m_asin <- lm(asin(sqrt(pr)) ~ godziny)
m_logit <- lm(qlogis((zdani + 0.5) / (n + 1)) ~ godziny)  # empiryczny logit (+0.5 chroni przed 0 i 1)
m_glm <- glm(cbind(zdani, n - zdani) ~ godziny, family = binomial)
round(c(b_arcsin = coef(m_asin)[[2]], b_logit = coef(m_logit)[[2]],
        b_glm = coef(m_glm)[[2]], OR_glm = exp(coef(m_glm)[[2]])), 2)
nowe <- data.frame(godziny = 10)                   # prognoza poza zakresem danych
round(c(arcsin_skala = predict(m_asin, nowe)[[1]], granica = pi / 2,
        glm_p = predict(m_glm, nowe, type = "response")[[1]]), 3)
Wynik w R
       [,1]  [,2] [,3] [,4] [,5]
logit  -4.6 -2.20 0.00 2.20 4.60
arcsin  0.1  0.32 0.79 1.25 1.47
b_arcsin  b_logit    b_glm   OR_glm
    0.10     0.45     0.47     1.59
arcsin_skala      granica        glm_p
       1.682        1.571        0.983
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe qlogis(), asin(), lm(), glm(); rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy odsetki trzeba przekształcać arcus sinusem przed ANOVA?
Zwykle nie. Gdy odsetek pochodzi z liczby sukcesów na n prób, lepsza jest regresja logistyczna. Dla proporcji ciągłych zamiast arcus sinusa użyj logitu albo regresji beta.
Co zrobić z proporcjami równymi 0 lub 1 przed transformacją logitową?
Logit dla 0 i 1 jest nieskończony, więc dodaje się małą poprawkę, np. empiryczny logit z (x + 0.5)/(n + 1). Przy danych dwumianowych regresja logistyczna radzi sobie z nimi bez poprawek.
Jak policzyć logit i arcus sinus proporcji w R?
Logit daje funkcja qlogis(p), a przekształcenie odwrotne plogis(). Arcus sinus to asin(sqrt(p)), a powrót do proporcji – sin(x)^2.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Ferrari, S., & Cribari-Neto, F. (2004). Beta regression for modelling rates and proportions. Journal of Applied Statistics, 31(7), 799–815. https://doi.org/10.1080/0266476042000214501
- Warton, D. I., & Hui, F. K. C. (2011). The arcsine is asinine: The analysis of proportions in ecology. Ecology, 92(1), 3–10. https://doi.org/10.1890/10-0340.1 ● Otwarty dostęp
Cytowania BibTeX
@article{ferrari2004beta, author={Ferrari, Silvia and Cribari-Neto, Francisco}, title={{Beta regression for modelling rates and proportions}}, journal={Journal of Applied Statistics}, year={2004}, volume={31}, number={7}, pages={799--815}, doi={10.1080/0266476042000214501}}@article{warton2011arcsine, author={Warton, David I. and Hui, Francis K. C.}, title={{The arcsine is asinine: The analysis of proportions in ecology}}, journal={Ecology}, year={2011}, volume={92}, number={1}, pages={3--10}, doi={10.1890/10-0340.1}}