Co to jest nadmierna dyspersja?
Nadmierna dyspersja (ang. overdispersion, nadmierne rozproszenie) to sytuacja, w której wariancja zliczeń jest większa, niż przewiduje model. W regresji Poissona wariancja ma być równa średniej, tak jak w rozkładzie Poissona. Przy nadmiernej dyspersji współczynniki bywają poprawne, ale błędy standardowe są zaniżone, a wartości p – zbyt małe. Typowe przyczyny to pominięte predyktory (niejednorodność osób), zależność obserwacji, nadmiar zer i brak offsetu przy różnym czasie obserwacji.
Jak ją wykryć
Najprostszy wskaźnik to współczynnik dyspersji: suma kwadratów reszt Pearsona podzielona przez liczbę stopni swobody. Wartość bliska 1 jest w porządku, wyraźnie większa wskazuje na nadmierną dyspersję, mniejsza – na niedostateczną. Dean i Lawless (1989) zaproponowali testy, które wymagają dopasowania tylko modelu Poissona. Oceniaj dyspersję warunkową, po uwzględnieniu predyktorów, a nie surowy rozkład zmiennej zależnej.
Przykład
Zasymulowaliśmy w R 300 zliczeń z czystego modelu Poissona z dwoma predyktorami (M = 3.10, wariancja = 10.75). Model bez x2 miał współczynnik dyspersji 3.31, a model pełny – 0.94. W modelu bez x2 błąd standardowy dla x1 wynosił 0.033 w regresji Poissona, 0.061 w quasi-Poissonie i 0.059 w modelu ujemnym dwumianowym (θ = 1.46, AIC 1349 wobec 1607). Dyspersja wynikała tu z pominiętej zmiennej: najlepszym lekarstwem było jej dodanie.
Na rysunku
Rysunek pokazuje dane z przykładu powyżej. Osoby podzieliliśmy na 10 grup po 30 według wartości przewidywanej przez model i w każdej grupie policzyliśmy średnią i wariancję zliczeń. Tak wygląda dyspersja warunkowa: rozrzut wokół tego, co przewiduje model. Pokrycie przedziałów ufności przy nadmiernej dyspersji w 1000 badaniach pokazuje wpis Regresja Poissona – wizualizacja.
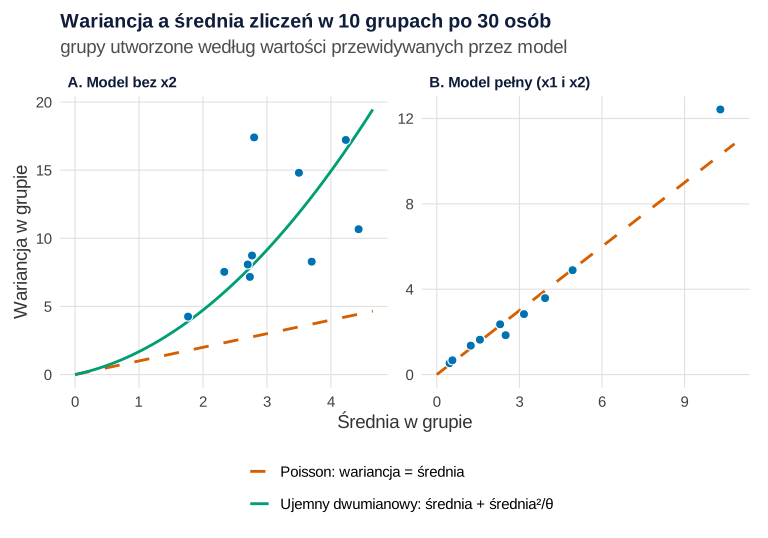
set.seed(4590)).Co widać. W modelu bez x2 (panel A) średnie w grupach mieszczą się między 1.77 a 4.43, a wariancje między 4.25 a 17.41. Mediana ilorazu wariancji do średniej wynosi 3.08 – blisko współczynnika dyspersji 3.31 z przykładu. Punkty układają się wokół krzywej ujemnego dwumianowego (średnia + średnia²/θ, θ = 1.46), a nie wokół linii Poissona. Po dodaniu x2 (panel B) ta sama zmienna zależna leży na linii wariancja = średnia (mediana ilorazu 1.03). Dane nie zmieniły się – zmienił się model.
Na co uważać. Każdy punkt to tylko 30 osób, więc wariancja w grupie sama mocno się waha; pojedynczy punkt nad linią niczego nie dowodzi. Panele mają różne skale osi. Wykres nie mówi, skąd bierze się nadmiar wariancji: pominięty predyktor, nadmiar zer i zależne obserwacje dają podobny obraz. Wariancja i średnia całej zmiennej zależnej (tu 10.75 i 3.10) mieszają rozrzut wyjaśniony przez predyktory z resztowym.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tej sekcji. Jest samowystarczalny: kolory Okabe–Ito i prosty motyw definiuje sam, a dane powstają od własnego set.seed(4590), tego samego co w przykładzie (ziarna nie zmieniano). Liczbę grup (10 po 30 osób) ustawiliśmy ręcznie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Wariancja a średnia w 10 grupach osób o podobnych wartościach przewidywanych
library(ggplot2)
suppressPackageStartupMessages(library(MASS))

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Te same dane co w przykładzie: czysty Poisson z dwoma predyktorami
set.seed(4590)
n  <- 300
x1 <- rnorm(n); x2 <- rnorm(n)
y  <- rpois(n, exp(0.8 + 0.3 * x1 + 0.7 * x2))
m_pom <- glm(y ~ x1, family = poisson)            # model bez x2
m_pel <- glm(y ~ x1 + x2, family = poisson)       # model pełny
m_nb  <- glm.nb(y ~ x1)                           # ujemny dwumianowy bez x2

# Dzielimy osoby na 10 grup po 30 według wartości przewidywanej przez model
# i w każdej grupie liczymy średnią i wariancję obserwowanych zliczeń
grupy <- function(m, etykieta) {
  g <- cut(rank(fitted(m), ties.method = "first"), 10, labels = FALSE)
  data.frame(model = etykieta, srednia = tapply(y, g, mean), wariancja = tapply(y, g, var))
}
tab <- rbind(grupy(m_pom, "A. Model bez x2"), grupy(m_pel, "B. Model pełny (x1 i x2)"))
# Zakres średnich i wariancji w grupach oraz mediana ilorazu wariancja / średnia
do.call(rbind, lapply(split(tab, tab$model), function(d)
  round(c(sr_min = min(d$srednia), sr_max = max(d$srednia), war_min = min(d$wariancja),
          war_max = max(d$wariancja), mediana_VM = median(d$wariancja / d$srednia)), 2)))
round(c(theta_NB = m_nb$theta), 2)

# Linie odniesienia rysowane w zakresie średnich każdego panelu
siatka <- lapply(split(tab$srednia, tab$model), function(v) seq(0, max(v) * 1.05, length.out = 100))
linie <- rbind(
  data.frame(model = rep(names(siatka), each = 100), srednia = unlist(siatka),
             wariancja = unlist(siatka), typ = "Poisson: wariancja = średnia"),
  data.frame(model = names(siatka)[1], srednia = siatka[[1]],
             wariancja = siatka[[1]] + siatka[[1]]^2 / m_nb$theta,
             typ = "Ujemny dwumianowy: średnia + średnia²/θ"))
p1 <- ggplot(tab, aes(srednia, wariancja)) +
  geom_line(data = linie, aes(colour = typ, linetype = typ), linewidth = 1) +
  geom_point(size = 2.8, shape = 21, fill = "#0072B2", colour = "white", stroke = 0.6) +
  facet_wrap(~ model, ncol = 2, scales = "free") +
  scale_colour_manual(values = c("#D55E00", "#009E73"), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(title = "Wariancja a średnia zliczeń w 10 grupach po 30 osób",
       subtitle = "grupy utworzone według wartości przewidywanych przez model",
       x = "Średnia w grupie", y = "Wariancja w grupie") + motyw
p1   # zapis: ggsave("nadmierna-dyspersja-wariancja-a-srednia.svg", p1, width = 8, height = 5.6)
Wynik w R
                         sr_min sr_max war_min war_max mediana_VM
A. Model bez x2            1.77   4.43    4.25   17.41       3.08
B. Model pełny (x1 i x2)   0.47  10.30    0.53   12.42       1.03
theta_NB
    1.46
Jak opisać w pracy
Na co uważać
- Zmiana rozkładu to nie zawsze rozwiązanie. Berk i MacDonald (2008) pokazują, że regresja ujemna dwumianowa „naprawia” problem tylko w szczególnych warunkach. Najpierw sprawdź specyfikację modelu.
- Quasi-Poisson a NB. Według Ver Hoefa i Bovenga (2007) w quasi-Poissonie wariancja jest liniową, a w NB kwadratową funkcją średniej, co zmienia wagi małych i dużych zliczeń.
- Nadmiar zer. Gdy zer jest więcej, niż przewiduje którykolwiek z tych modeli, rozważ model z nadmiarem zer.
Pełną analizę zliczeń pokazuje wpis Regresja dla zliczeń krok po kroku.
Nadmierna dyspersja w R
Kod symuluje zliczenia z modelu Poissona z dwoma predyktorami, dopasowuje model z pominiętym predyktorem i model pełny, liczy współczynnik dyspersji i porównuje błędy standardowe w regresji Poissona, quasi-Poissona i ujemnej dwumianowej.
Pominięty predyktor jako źródło nadmiernej dyspersji
R
suppressPackageStartupMessages(library(MASS))
set.seed(4590)
n  <- 300
x1 <- rnorm(n); x2 <- rnorm(n)                     # x2 – predyktor pominięty w modelu
y  <- rpois(n, exp(0.8 + 0.3 * x1 + 0.7 * x2))     # dane z czystego Poissona
dysp <- function(m) sum(residuals(m, type = "pearson")^2) / df.residual(m)
m_pom  <- glm(y ~ x1, family = poisson)            # model bez x2
m_pel  <- glm(y ~ x1 + x2, family = poisson)       # model pełny
m_qp   <- glm(y ~ x1, family = quasipoisson)       # quasi-Poisson bez x2
m_nb   <- glm.nb(y ~ x1)                           # ujemny dwumianowy bez x2
round(c(M = mean(y), wariancja = var(y),
        dysp_bez_x2 = dysp(m_pom), dysp_pelny = dysp(m_pel)), 2)
wsp <- function(m) unname(c(coef(m)["x1"], sqrt(diag(vcov(m)))["x1"]))
tab <- rbind(poisson = wsp(m_pom), quasi = wsp(m_qp), negbin = wsp(m_nb))
colnames(tab) <- c("b_x1", "SE")
round(tab, 3)
round(c(theta = m_nb$theta, AIC_pois = AIC(m_pom), AIC_nb = AIC(m_nb)), 2)
Wynik w R
          M   wariancja dysp_bez_x2  dysp_pelny
       3.10       10.75        3.31        0.94
         b_x1    SE
poisson 0.247 0.033
quasi   0.247 0.061
negbin  0.259 0.059
   theta AIC_pois   AIC_nb
    1.46  1607.13  1348.77
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet MASS). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak policzyć współczynnik dyspersji w modelu Poissona w R?
Podziel sumę kwadratów reszt Pearsona przez stopnie swobody: sum(residuals(m, type = "pearson")^2) / df.residual(m). Wartość wyraźnie większa od 1 wskazuje na nadmierną dyspersję.
Czy wariancja większa od średniej zmiennej zależnej oznacza nadmierną dyspersję?
Niekoniecznie. Model Poissona zakłada równość średniej i wariancji warunkowo, przy danych predyktorach. Surowa wariancja może przekraczać średnią, choć po uwzględnieniu predyktorów dyspersja jest prawidłowa.
Co to jest niedostateczna dyspersja (underdispersion)?
To sytuacja odwrotna: wariancja jest mniejsza, niż przewiduje model, a współczynnik dyspersji wyraźnie poniżej 1. Błędy standardowe są wtedy zawyżone, a testy – zbyt zachowawcze.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja Poissona – wizualizacja
Zliczenia a prosta, krzywa w skali logarytmu, nadmierna dyspersja w 1000 badaniach i IRR na osi logarytmicznej – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikRegresja Poissona i ujemna dwumianowa w jamovi (GAMLj)
Moduł GAMLj w jamovi: modele dla zliczeń, Chi-squared/DF jako sygnał nadmiernej dyspersji, Exp(B) jako IRR, średnie brzegowe, offset i różnice wobec SPSS.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikPytania o częstotliwość zachowań
Okres odniesienia, teleskopowanie, szacowanie i zaokrąglanie, zakres kategorii i nieostre kwantyfikatory oraz analiza zliczeń z ankiety w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Berk, R., & MacDonald, J. M. (2008). Overdispersion and Poisson regression. Journal of Quantitative Criminology, 24(3), 269–284. https://doi.org/10.1007/s10940-008-9048-4
- Dean, C., & Lawless, J. F. (1989). Tests for detecting overdispersion in Poisson regression models. Journal of the American Statistical Association, 84(406), 467–472. https://doi.org/10.1080/01621459.1989.10478792
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
Cytowania BibTeX
@article{berk2008overdispersion, author={Berk, Richard and MacDonald, John M.}, title={{Overdispersion and Poisson regression}}, journal={Journal of Quantitative Criminology}, year={2008}, volume={24}, number={3}, pages={269--284}, doi={10.1007/s10940-008-9048-4}}@article{dean1989tests, author={Dean, C. and Lawless, J. F.}, title={{Tests for detecting overdispersion in Poisson regression models}}, journal={Journal of the American Statistical Association}, year={1989}, volume={84}, number={406}, pages={467--472}, doi={10.1080/01621459.1989.10478792}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}