Co to jest regresja Conwaya–Maxwella–Poissona?
Regresja Conwaya–Maxwella–Poissona (COM-Poisson, CMP) to model dla zliczeń oparty na rozkładzie o prawdopodobieństwach proporcjonalnych do λy/(y!)ν. Parametr ν opisuje dyspersję: ν = 1 daje rozkład Poissona, ν > 1 – zaniżoną dyspersję (wariancja mniejsza od średniej), a ν < 1 – nadmierną dyspersję. Shmueli i in. (2005) pokazali, że ten dwuparametrowy rozkład obejmuje jako przypadki szczególne m.in. rozkład Poissona, Bernoulliego i geometryczny. Sellers i Shmueli (2010) zbudowali na nim regresję w podejściu GLM: log(λ) zależy od predyktorów, a test ν = 1 sprawdza, czy wystarczy zwykła regresja Poissona.
Główna przewaga nad regresją ujemną dwumianową: ta radzi sobie tylko z nadmierną dyspersją, a CMP także z zaniżoną. Zaniżona dyspersja pojawia się np. przy zliczeniach z górnym limitem albo bardzo regularnych procesach (liczba posiłków dziennie, wizyt kontrolnych zgodnych z harmonogramem). Poisson zawyża wtedy błędy standardowe, więc testy są zbyt zachowawcze.
Przykład
W 300 symulowanych zliczeniach średnia wyniosła 1.50, a wariancja 0.84; dyspersja Pearsona w modelu Poissona – 0.44. Model CMP oszacował ν = 2.99 (SE = 0.26), a test równej dyspersji dał χ²(1) = 91.58, p < .001. AIC spadło z 796.76 do 707.18. Współczynnik przy x w CMP (0.706) dotyczy log(λ), a nie log średniej, więc nie można go porównać wprost z Poissonem (0.299). Przeliczony na średnie daje iloraz 1.33 na jednostkę x – prawie tyle co w Poissonie (1.35).
Na rysunku
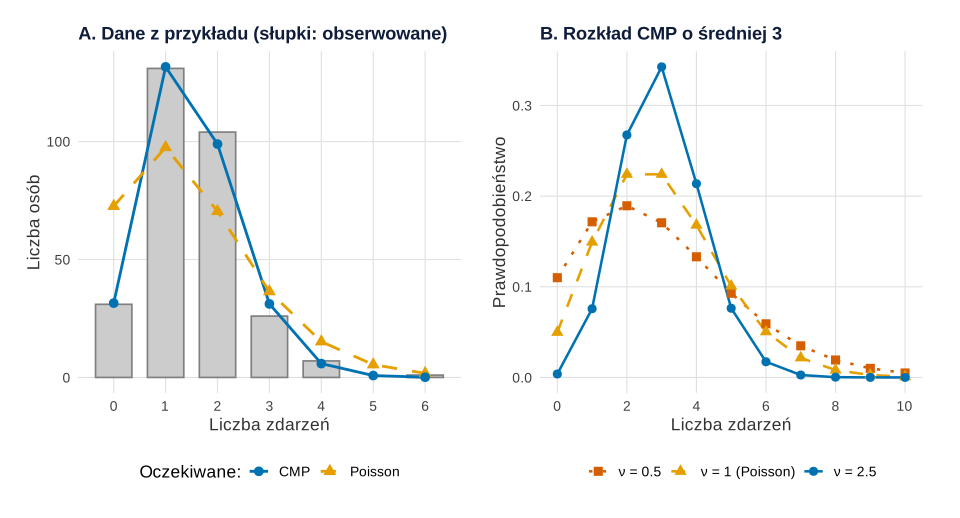
set.seed(690)).Co widać. Panel A: dla każdej osoby model daje rozkład prawdopodobieństw liczby zdarzeń; zsumowane po 300 osobach dają oczekiwaną liczbę osób z 0, 1, 2… zdarzeniami. Poisson przewiduje 72.6 osób bez zdarzeń, a jest ich 31; przy jednym zdarzeniu 97.5 wobec 131, a przy czterech i więcej – za dużo. Rozkład obserwowany jest węższy, niż pozwala Poisson. CMP z ν = 2.99 trafia niemal w każdy słupek (31.5 osób przy zerze, 131.6 przy jednym zdarzeniu). Panel B pokazuje rolę ν przy stałej średniej 3: wariancja wynosi 4.87 przy ν = 0.5, 3.00 przy ν = 1 i 1.33 przy ν = 2.5.
Na co uważać. Panel A porównuje rozkład brzegowy, a model ocenia się warunkowo na x: dobre dopasowanie słupków nie zastępuje testu ν = 1 ani porównania AIC z przykładu. Sumowanie prawdopodobieństw po osobach to ręczna wersja rootogramu – tę samą konstrukcję dla nadmiernej dyspersji pokazuje wpis Regresja Poissona – wizualizacja. Przy nadmiarze zer wykres wyglądałby inaczej (słupek przy zerze ponad oboma modelami) i potrzebny byłby model z nadmiarem zer. W panelu B średnią 3 i wartości ν (0.5, 1, 2.5) wybrano ręcznie, a λ dobrano tak, by średnia była równa 3; panel niczego nie losuje.
Podpis do pracy:
Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne. Ziarno 690 jest to samo co w przykładzie.
Kod R rysunku 1
# Rysunek 1. Liczebności obserwowane i oczekiwane z modeli Poissona i CMP (A) oraz rozkład CMP o tej samej średniej dla trzech ν (B)
suppressPackageStartupMessages({library(COMPoissonReg); library(ggplot2); library(patchwork)})
kol <- c("Poisson" = "#E69F00", "CMP" = "#0072B2", "ν = 0.5" = "#D55E00", "ν = 1 (Poisson)" = "#E69F00", "ν = 2.5" = "#0072B2")
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
set.seed(690)                                         # te same dane co w przykładzie
n <- 300
x <- rnorm(n)
lam <- exp(1.5 + 0.6 * x)
y <- sapply(lam, function(l) rcmp(1, lambda = l, nu = 2.5))
d <- data.frame(y, x)
m_pois <- glm(y ~ x, family = poisson, data = d)
m_cmp <- glm.cmp(y ~ x, formula.nu = ~ 1, data = d)
# A: oczekiwana liczba osób z k zdarzeniami = suma prawdopodobieństw P(Y = k) po osobach
k <- 0:6
par_i <- predict(m_cmp, type = "link")                # lambda i nu każdej osoby z modelu CMP
lam_i <- par_i$lambda
nu_hat <- par_i$nu[1]
oczek <- data.frame(k = rep(k, 2), model = rep(c("Poisson", "CMP"), each = length(k)),
  n = c(sapply(k, function(j) sum(dpois(j, fitted(m_pois)))),
        sapply(k, function(j) sum(dcmp(rep(j, n), lambda = lam_i, nu = rep(nu_hat, n))))))
obs <- data.frame(k, n = as.vector(table(factor(y, levels = k))))
print(data.frame(k, obserwowane = obs$n, Poisson = round(oczek$n[oczek$model == "Poisson"], 1),
                 CMP = round(oczek$n[oczek$model == "CMP"], 1)), row.names = FALSE)
pA <- ggplot(obs, aes(k, n)) +
  geom_col(fill = "grey80", colour = "grey50", width = 0.7) +
  geom_line(data = oczek, aes(colour = model, linetype = model), linewidth = 1) +
  geom_point(data = oczek, aes(colour = model, shape = model), size = 3) +
  scale_colour_manual(values = kol, name = "Oczekiwane:") +
  scale_linetype_manual(values = c(Poisson = "dashed", CMP = "solid"), name = "Oczekiwane:") +
  scale_shape_manual(values = c(Poisson = 17, CMP = 16), name = "Oczekiwane:") +
  scale_x_continuous(breaks = k) +
  labs(title = "A. Dane z przykładu (słupki: obserwowane)", x = "Liczba zdarzeń", y = "Liczba osób")
# B: rozkład CMP o średniej 3 przy różnym ν (lambda dobrana tak, by średnia = 3)
lam_dla <- function(nu) uniroot(function(l) ecmp(l, nu) - 3, c(0.01, 500))$root
k2 <- 0:10
roz <- do.call(rbind, lapply(c(0.5, 1, 2.5), function(v) {
  l <- lam_dla(v)
  data.frame(k = k2, p = dcmp(k2, lambda = l, nu = v), nu = v, wariancja = vcmp(l, v))
}))
roz$etykieta <- factor(ifelse(roz$nu == 1, "ν = 1 (Poisson)", paste0("ν = ", roz$nu)),
                       levels = c("ν = 0.5", "ν = 1 (Poisson)", "ν = 2.5"))
print(round(unique(roz[, c("nu", "wariancja")]), 2), row.names = FALSE)   # średnia = 3 we wszystkich trzech
pB <- ggplot(roz, aes(k, p, colour = etykieta, shape = etykieta, linetype = etykieta)) +
  geom_line(linewidth = 0.9) + geom_point(size = 2.8) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_shape_manual(values = c(15, 17, 16), name = NULL) +
  scale_linetype_manual(values = c("dotted", "dashed", "solid"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 10, 2)) +
  labs(title = "B. Rozkład CMP o średniej 3", x = "Liczba zdarzeń", y = "Prawdopodobieństwo")
p1 <- (pA + pB) & motyw
p1
Wynik w R
 k obserwowane Poisson   CMP
 0          31    72.6  31.5
 1         131    97.5 131.6
 2         104    70.4  98.9
 3          26    36.4  31.2
 4           7    15.2   5.9
 5           0     5.4   0.8
 6           1     1.7   0.1
  nu wariancja
 0.5      4.87
 1.0      3.00
 2.5      1.33
Jak opisać w pracy
Na co uważać
- Współczynniki dotyczą λ, nie średniej. Efekty raportuj jako przewidywane średnie lub ich ilorazy.
- Zera. Nadmiar zer to inny problem – zob. model z nadmiarem zer.
- Porównanie modeli przez AIC lub test ilorazu wiarygodności, nie przez sam rozkład zmiennej zależnej.
Regresja Conwaya–Maxwella–Poissona w R
Kod generuje zliczenia o zaniżonej dyspersji, dopasowuje regresję Poissona i model CMP funkcją COMPoissonReg::glm.cmp(), testuje ν = 1 i porównuje przewidywane średnie. Liczby w tekście pochodzą z tego kodu.
Poisson a CMP przy zaniżonej dyspersji
R
set.seed(690)                                        # dane symulowane: zliczenia o zaniżonej dyspersji
n <- 300
x <- rnorm(n)
lam <- exp(1.5 + 0.6 * x)                            # parametr lambda (nie jest to średnia)
y <- sapply(lam, function(l) COMPoissonReg::rcmp(1, lambda = l, nu = 2.5))
d <- data.frame(y, x)
round(c(srednia = mean(y), wariancja = var(y)), 3)
m_pois <- glm(y ~ x, family = poisson, data = d)
round(c(dyspersja_Pearsona = sum(residuals(m_pois, "pearson")^2) / df.residual(m_pois)), 3)
round(summary(m_pois)$coefficients[, 1:2], 4)
suppressPackageStartupMessages(library(COMPoissonReg))
m_cmp <- glm.cmp(y ~ x, formula.nu = ~ 1, data = d)  # log(lambda) ~ x, stałe nu
s <- summary(m_cmp)
print(s$DF[, 1:2], digits = 4)                       # X: log(lambda), S: log(nu)
print(s$DF.nu, digits = 4)                           # nu > 1: zaniżona dyspersja
e <- equitest(m_cmp)                                 # test H0: nu = 1 (zwykły Poisson)
round(c(X2 = e$teststat, df = e$df), 2); signif(e$pvalue, 3)
nowe <- data.frame(x = c(0, 1))
mu_cmp <- predict(m_cmp, newdata = nowe)             # przewidywane średnie z modelu CMP
mu_pois <- predict(m_pois, newdata = nowe, type = "response")
round(rbind(CMP = mu_cmp, Poisson = mu_pois), 3)
round(c(IRR_CMP = mu_cmp[2] / mu_cmp[1], IRR_Poisson = exp(coef(m_pois)[["x"]])), 3)
round(c(AIC_Poisson = AIC(m_pois), AIC_CMP = AIC(m_cmp)), 2)
Wynik w R
  srednia wariancja
    1.503     0.839
dyspersja_Pearsona
             0.439
            Estimate Std. Error
(Intercept)   0.3781     0.0485
x             0.2990     0.0495
              Estimate     SE
X:(Intercept)   1.8092 0.1933
X:x             0.7063 0.0952
S:(Intercept)   1.0951 0.0867
   Estimate     SE
nu     2.99 0.2593
   X2    df
91.58  1.00
[1] 1.07e-21
            1     2
CMP     1.476 1.969
Poisson 1.460 1.968
    IRR_CMP IRR_Poisson
      1.334       1.349
AIC_Poisson     AIC_CMP
     796.76      707.18
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet COMPoissonReg 0.8.2; rysunek 1 – także pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- COMPoissonReg (wersja 0.8.2): Sellers, K., Lotze, T., & Raim, A. (2026). COMPoissonReg: Conway-Maxwell Poisson (COM-Poisson) regression (R package version 0.8.2) [Computer software]. https://CRAN.R-project.org/package=COMPoissonReg
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Kiedy użyć regresji COM-Poisson zamiast ujemnej dwumianowej?
Gdy wariancja zliczeń jest mniejsza od średniej (zaniżona dyspersja) albo gdy nie wiesz z góry, w którą stronę dyspersja odbiega od Poissona. Przy samej nadmiernej dyspersji oba modele są możliwe; porównaj je przez AIC.
Co oznacza parametr ν?
ν mierzy odchylenie od dyspersji Poissona. ν = 1 to zwykły Poisson, ν > 1 oznacza zliczenia bardziej regularne (wariancja mniejsza od średniej), a ν < 1 – bardziej rozproszone. Test ν = 1 mówi, czy dodatkowy parametr jest potrzebny.
Dlaczego współczynniki CMP są inne niż w regresji Poissona?
Bo w podstawowej parametryzacji opisują log(λ), a λ nie jest średnią rozkładu, gdy ν ≠ 1. Aby porównać efekty, przelicz model na przewidywane średnie, np. predict() w COMPoissonReg, i podaj ich iloraz lub różnicę.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Sellers, K. F., & Shmueli, G. (2010). A flexible regression model for count data. The Annals of Applied Statistics, 4(2), 943–961. https://doi.org/10.1214/09-aoas306 ● Otwarty dostęp
- Shmueli, G., Minka, T. P., Kadane, J. B., Borle, S., & Boatwright, P. (2005). A useful distribution for fitting discrete data: Revival of the Conway–Maxwell–Poisson distribution. Journal of the Royal Statistical Society Series C: Applied Statistics, 54(1), 127–142. https://doi.org/10.1111/j.1467-9876.2005.00474.x
Cytowania BibTeX
@article{sellers2010flexible, author={Sellers, Kimberly F. and Shmueli, Galit}, title={{A flexible regression model for count data}}, journal={The Annals of Applied Statistics}, year={2010}, volume={4}, number={2}, pages={943--961}, doi={10.1214/09-aoas306}}@article{shmueli2005useful, author={Shmueli, Galit and Minka, Thomas P. and Kadane, Joseph B. and Borle, Sharad and Boatwright, Peter}, title={{A useful distribution for fitting discrete data: Revival of the Conway–Maxwell–Poisson distribution}}, journal={Journal of the Royal Statistical Society Series C: Applied Statistics}, year={2005}, volume={54}, number={1}, pages={127--142}, doi={10.1111/j.1467-9876.2005.00474.x}}