Pytanie o częstotliwość to zadanie z pamięci i rachunku
„Ile razy w ostatnim miesiącu…?” wygląda na pytanie o fakt. Dla respondenta to jednak kilka zadań naraz. Tourangeau i in. (2000) opisują odpowiadanie na pytanie ankiety jako ciąg procesów: zrozumienie pytania, przywołanie informacji, oszacowanie lub wnioskowanie i dopasowanie odpowiedzi do formatu. W pytaniach o zachowania najsłabszym ogniwem jest pamięć. Bradburn i in. (1987) zwracają uwagę, że gdy przypomnienie i zliczenie epizodów przerasta możliwości respondenta, konstruuje on liczbę z częściowej informacji, czyli wnioskuje, zamiast pamiętać.
Podstawowe zasady, takie jak „podaj okres odniesienia” i „unikaj nieostrych słów”, zebraliśmy we wpisie o najczęstszych błędach w ankietach. Ten wpis idzie dalej i jest przeznaczony dla badacza, który projektuje pytania o zachowania albo analizuje uzyskane z nich liczby. Omawia trzy decyzje: długość okresu odniesienia, format odpowiedzi (liczba, przedziały albo określenia słowne) i model analizy dla zliczeń z typowymi zniekształceniami. Każdą pokazujemy na symulacji w R.
Okres odniesienia: 7 dni, 30 dni czy typowy tydzień
Okres odniesienia to przedział czasu, którego dotyczy pytanie. Jego długość wpływa na dwa przeciwstawne błędy pamięci:
- Pominięcia. Im dłuższy okres, tym więcej zdarzeń respondent zapomina, zwłaszcza drobnych i rutynowych. Neter i Waksberg (1964) w eksperymencie dotyczącym wydatków gospodarstw domowych na naprawy i remonty stwierdzili, że wydłużenie okresu z jednego do trzech miesięcy dawało znacznie mniej zgłoszeń drobnych napraw, a prawie tyle samo dużych.
- Teleskopowanie. Zdarzenia sprzed okresu „wpadają” do niego, bo wydają się bliższe w czasie, niż były. Ci sami autorzy stwierdzili przewagę teleskopowania do przodu: wydatki częściej przesuwano do bliższego okresu niż w przeciwną stronę.
Sudman i Bradburn (1973) połączyli oba zjawiska w modelu wpływu czasu na pamięć. Pokazali też, że środki zaradcze działają wybiórczo. Korzystanie z dokumentów (rachunków, kalendarza) zmniejsza teleskopowanie, ale nie pominięcia. Przypominanie wspomagane, czyli lista przykładów, zmniejsza pominięcia, ale teleskopowania nie usuwa, a może je nawet nasilić. Ogólny mechanizm zniekształceń pamięci, także zróżnicowanych między grupami, opisuje hasło błąd przypominania.
| Sformułowanie | Co mierzy | Główne ryzyko | Kiedy wybrać |
|---|---|---|---|
| „W ciągu ostatnich 7 dni…” | Konkretne epizody z krótkiego okna | Teleskopowanie ma duży udział względny; tydzień może być nietypowy | Zachowania częste, gdy liczy się średnia w grupie |
| „W ciągu ostatnich 30 dni…” | Epizody z dłuższego okna | Pominięcia i szacowanie zamiast liczenia | Zachowania umiarkowanie częste lub nieregularne |
| „W typowym tygodniu…” | Ogólny wzorzec zachowania | Odpowiedź to szacunek z wiedzy o sobie, nie z epizodów | Stałe nawyki; badania, w których ważniejsza jest cecha osoby niż ostatni tydzień |
| „W ciągu ostatnich 12 miesięcy…” | Zdarzenia rzadkie i ważne | Teleskopowanie ważnych zdarzeń, zapominanie drobnych | Hospitalizacje, zmiana pracy, przeprowadzki |
Dwie techniki ograniczają teleskopowanie niezależnie od długości okresu. Pierwsza to wyraźna granica okresu, np. data lub wydarzenie („od początku semestru”) zamiast „w ostatnim miesiącu”. Druga to pomiar ograniczony, czyli wcześniejszy pomiar w badaniu panelowym, do którego odnosi się kolejne pytanie. Gdy potrzebujesz dokładnych liczb codziennych zachowań, rozważ zamiast jednego pytania retrospektywnego badanie dzienniczkowe, w którym zachowanie zapisuje się na bieżąco.
Zliczanie, szacowanie i zaokrąglanie
Respondent może odpowiedzieć na dwa sposoby. Może przywołać i zliczyć pojedyncze epizody albo oszacować liczbę z ogólnej wiedzy („chodzę dwa razy w tygodniu, więc w miesiącu będzie około ośmiu”). Burton i Blair (1991) potwierdzili w dwóch badaniach, że respondenci często odpowiadają drugim sposobem. Wybór strategii zależał od warunków zadania, m.in. od liczby zdarzeń do zgłoszenia i czasu na odpowiedź. Błędy biorą się więc nie tylko z pominięć i teleskopowania epizodów.
Szacunek ma charakterystyczny ślad w danych: zaokrąglanie (ang. heaping). Odpowiedzi skupiają się na wartościach „okrągłych”. Huttenlocher i in. (1990) pokazali, że badani podający czas od zdarzenia używali wartości prototypowych, np. 14, 21, 30 lub 60 dni, a odstępy między nimi rosły wraz z długością okresu. W ich danych raportowany czas był przy tym krótszy od rzeczywistego. Wang i Heitjan (2008) opisują to samo zjawisko w liczbie wypalanych papierosów (wielokrotności 20, 10 i 5) i pokazują, że może ono obciążać oszacowania, np. średniego spożycia.
Nieostre kwantyfikatory: „często” znaczy co innego dla każdego
Kafeteria słowna („nigdy – rzadko – czasami – często – bardzo często”) jest wygodna, ale mierzy dwie rzeczy naraz: częstość zachowania i to, co respondent uważa za „często”. Schaeffer (1991) wykazała, że znaczenie takich określeń różni się między grupami, np. wiekowymi i o różnym wykształceniu. Wniosek z porównania grup może więc zależeć od tego, czy analizujesz częstości względne (słowa), czy bezwzględne (liczby). „Często” u osoby biegającej rekreacyjnie i u zawodnika to inna liczba treningów.
Przy pytaniach o zachowania wybieraj kategorie liczbowe („1–2 razy w tygodniu”) zamiast słownych. Skala słowna ma sens, gdy interesuje cię subiektywna ocena częstości, a nie liczba zdarzeń. Tak jest w wielu skalach objawów i w skalach typu Likerta. O budowie samych kategorii (rozłączność, wyczerpywalność, opcje specjalne) piszemy w haśle kafeteria odpowiedzi.
Zakres kategorii zmienia odpowiedź
Kategorie liczbowe też nie są neutralne. Schwarz i in. (1985) prosili o podanie dziennego czasu oglądania telewizji na jednej z dwóch skal. Pierwsza obejmowała przedział od „do pół godziny” do „ponad dwóch i pół godziny”, a druga – od „do dwóch i pół godziny” do „ponad czterech i pół godziny”. Osoby ze skalą niską raportowały mniej oglądania. Autorzy wnioskują, że respondenci odczytują ze skali, ile wynosi „przeciętne” zachowanie, i używają tego jako punktu odniesienia. To bliski krewny efektu zakotwiczenia.
Odtworzyliśmy ten schemat w symulacji. 1500 osób losowo przydzielono po równo do trzech wersji pytania o czas oglądania filmów i seriali: skali niskiej, skali wysokiej i pytania otwartego o liczbę minut. Założyliśmy, że respondent ma nieprecyzyjny ślad w pamięci i przesuwa go częściowo w stronę środka skali. To założenie modelu, a nie wynik badań. Jego siłę w praktyce sprawdza się eksperymentem.
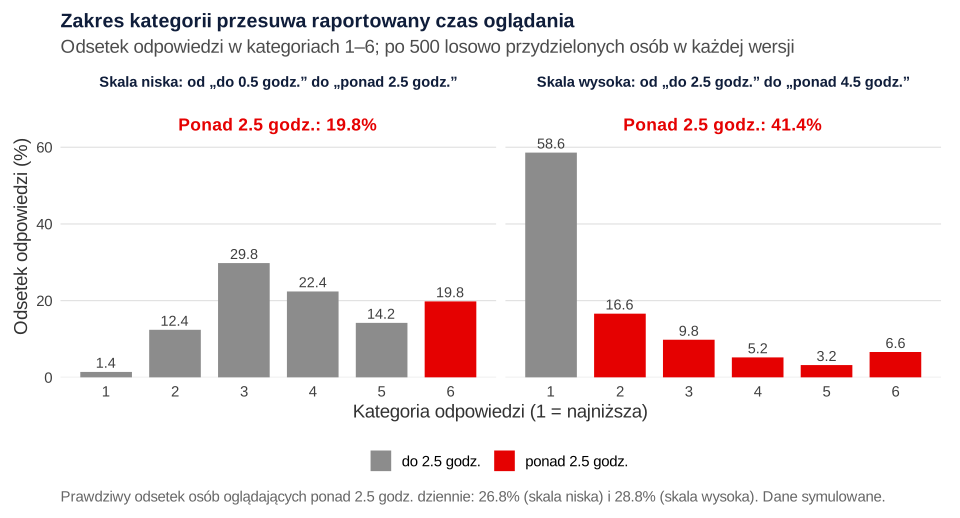
Na skali niskiej więcej niż 2.5 godziny dziennie zadeklarowało 19.8% osób, a na wysokiej – 41.4%. Różnica wyniosła 21.60 punktu procentowego, 95% CI [16.05, 27.15], χ²(1) = 54.92, p < .001. Prawdziwy odsetek w obu grupach był podobny (26.8% i 28.8%), więc całą różnicę stworzył format. W 500 powtórzeniach symulacji różnica wynosiła średnio 19.2 punktu (od 10.6 do 28.0). W pytaniu otwartym odsetek wyniósł 25.0% wobec prawdziwych 29.8%. Tu z kolei zadziałało zaokrąglanie: 70.4% odpowiedzi było pełnymi godzinami, a 5.8% osób podało dokładnie 150 minut, czyli wartość równą progowi.
Średnia liczona z punktów środkowych kategorii wyniosła 1.73 godziny na skali niskiej i 2.15 na wysokiej, przy prawdziwej średniej 2.15. Zgodność skali wysokiej nie jest jednak zasługą formatu. 58.6% osób trafiło tam do jednej szerokiej kategorii „do 2.5 godziny”. Wynik zależy więc głównie od tego, jaką wartość badacz jej przypisze. Podobny problem z otwartym górnym przedziałem omawiamy we wpisie o pytaniu o dochód.
Liczba czy przedziały?
| Format | Zalety | Wady |
|---|---|---|
| Liczba (pytanie otwarte) | Brak sugestii, ile to „przeciętnie”; pełna informacja do modeli zliczeń; dowolne przeliczenia | Zaokrąglanie do 5 i 10; literówki i wartości niemożliwe; więcej braków odpowiedzi |
| Przedziały (kafeteria) | Łatwiejsze dla respondenta; mniej skrajnych wartości | Zakres kategorii działa jak informacja o normie; utrata informacji; średnia zależy od wartości przypisanych kategoriom otwartym |
| Określenia słowne | Oddają subiektywną ocenę częstości | Różne znaczenie w grupach; nie da się przeliczyć na liczbę zdarzeń |
Do analiz ilościowych lepsza jest zwykle odpowiedź otwarta w postaci liczby z ograniczeniem zakresu w formularzu. Jeśli wybierasz przedziały, ustal je na podstawie rozkładu z pilotażu tak, by środek skali nie odbiegał od przewidywanej mediany, a ostatnia kategoria obejmowała niewielki odsetek osób. Gdy porównujesz grupy albo fale, używaj zawsze tej samej skali. Sprawdź też w wywiadzie poznawczym, jak respondenci rozumieją okres i zachowanie, np. czy spacer z psem „liczy się” jako spacer. Gdy chcesz porównać dwie wersje pytania, zaplanuj eksperyment split-ballot, tak jak w obu przykładach tego wpisu.
Analiza liczby zachowań: okres, zaokrąglanie i rozproszenie
Drugi przykład dotyczy pytania „Ile razy w ciągu ostatnich 7 / 30 dni wyszedłeś(-aś) na spacer trwający co najmniej 30 minut?”. Wersję z 7 albo 30 dniami losowo przydzielono 1200 osobom (po 600). Prawdziwa częstość spacerów zależy od wieku i posiadania psa (prawdziwy iloraz częstości dla psa wynosi 1.6), a między osobami jest duża niejednorodność. W symulacji przyjęliśmy następujące założenia:
- przy zliczaniu respondent pomija 3% spacerów z ostatnich 7 dni i 15% z ostatnich 30 dni;
- teleskopowanie „wciąga” do okna średnio tyle spacerów, ile osoba odbywa w ciągu 1.5 dnia;
- przy wielu zdarzeniach respondent zaczyna szacować i zaokrąglać do 5 (powyżej 30 – do 10).
W wersji 30-dniowej szacowało 46.2% osób, a w 7-dniowej – 6.7%. Rysunek 2 pokazuje skutek. Wśród odpowiedzi od 5 wzwyż wielokrotnościami 5 było 82.8% odpowiedzi, a w prawdziwych liczbach – 25.0%. Mediana i 90. centyl prawie się nie zmieniły (6 wobec 7 i 20 wobec 20), bo zaokrąglanie było symetryczne. Zmienił się kształt rozkładu.
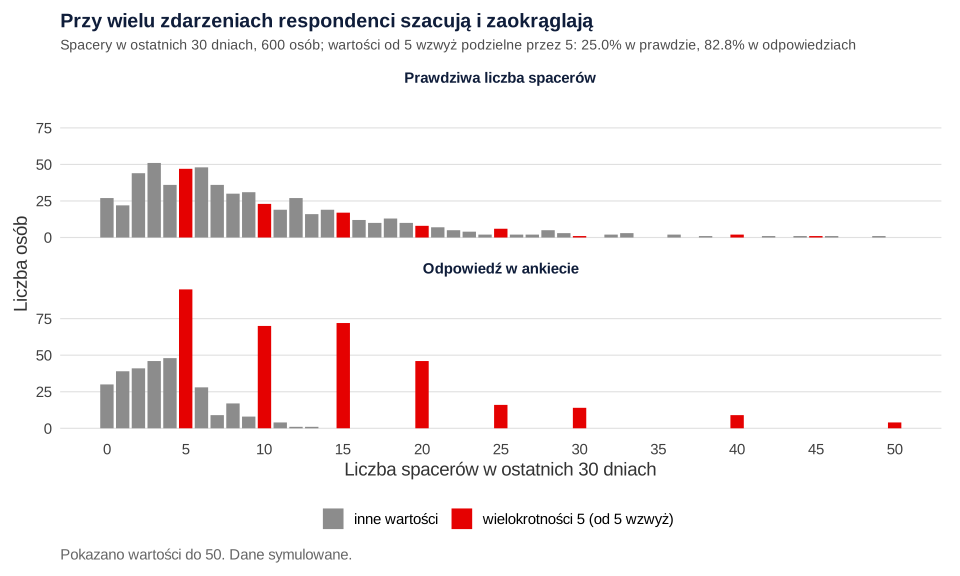
Krótszy okres nie okazał się automatycznie trafniejszy. Po przeliczeniu na tydzień wersja 7-dniowa dała 2.52 spaceru przy prawdzie 2.11, bo teleskopowanie ma w krótkim oknie duży udział względny. Wersja 30-dniowa dała 2.20 przy prawdzie 2.23, ale tylko dlatego, że pominięcia i teleskopowanie prawie się zniosły. W 300 powtórzeniach średnie wyniosły 2.49 (wersja 7-dniowa) i 2.16 (wersja 30-dniowa) przy prawdzie 2.14. Wielkość tych błędów wynika z przyjętych założeń. Ogólny wniosek jest jednak taki, że różne okresy odniesienia dają różne liczby, więc nie łącz ich bez zmiennej, która zapisuje wersję pytania.
Odpowiedzi to zliczenia, więc analizujesz je modelem dla zliczeń, a różną długość okresu uwzględniasz offsetem log(liczba dni). Wtedy współczynniki opisują częstość na dzień. Pełną procedurę wyboru modelu pokazuje wpis regresja dla zliczeń krok po kroku. Tu ważne są trzy obserwacje (Rysunek 3):
- Rozproszenie. W regresji Poissona współczynnik dyspersji wyniósł 4.00 dla prawdziwych liczb i 4.89 dla odpowiedzi. Zaokrąglanie dokłada więc nadmierną dyspersję do tej, która wynika z różnic między osobami. W regresji ujemnej dwumianowej θ spadło z 1.97 do 1.65, a AIC wyniosło 6324.1 wobec 8854.5 dla modelu Poissona.
- Efekt predyktora. Iloraz częstości dla psa w modelu ujemnym dwumianowym wyniósł 1.66, 95% CI [1.50, 1.84] dla prawdziwych liczb i 1.63, 95% CI [1.46, 1.82] dla odpowiedzi. Model Poissona dał 1.70 z przedziałem [1.62, 1.78], ponad dwukrotnie węższym niż w modelu ujemnym dwumianowym.
- Efekt wersji pytania. Model ujemny dwumianowy na odpowiedziach dał dla wersji 30-dniowej IRR = 0.86, 95% CI [0.78, 0.96]. Respondenci tej wersji raportowali o 14% mniej spacerów na dzień, choć w prawdzie różnicy nie było. W 300 powtórzeniach IRR wynosiło średnio 0.86. Model Poissona na prawdziwych liczbach dał tu fałszywy sygnał (IRR = 1.08, 95% CI [1.01, 1.14]), bo przy nadmiernej dyspersji zaniża błędy standardowe.
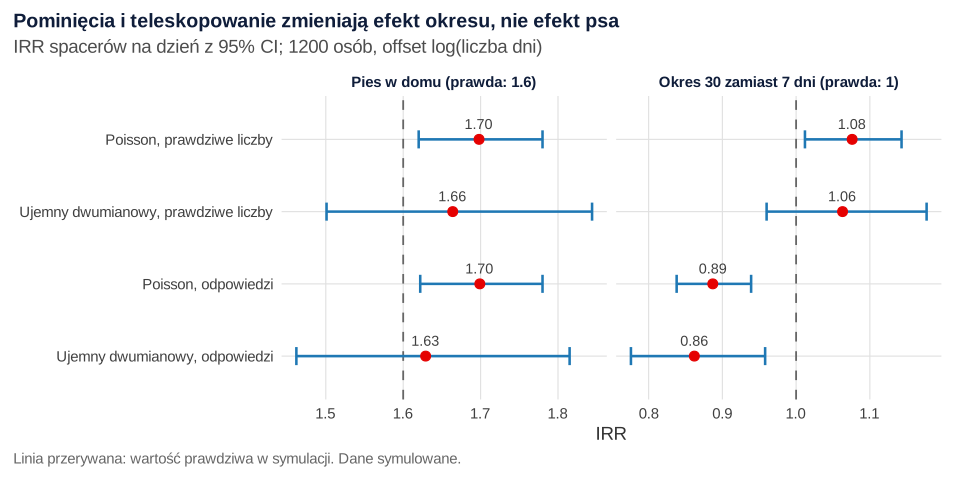
Zaokrąglanie symetryczne w tym przykładzie nie obciążyło efektu psa. Gdy jednak skłonność do szacowania zależy od grupy, a zaokrąglanie jest niesymetryczne (np. częściej w dół niż w górę; Huttenlocher i in., 1990), obciąża także porównania. Wtedy rozważ analizę wrażliwości: model na zmiennej zgrupowanej w przedziały pokrywające typowe „kopce” albo model, który opisuje zaokrąglanie wprost (Wang i Heitjan, 2008). Nadmiar zer, np. gdy część osób w ogóle nie wychodzi na spacery, wymaga osobnego rozważenia (zob. model z nadmiarem zer).
Jak opisać pytanie o częstotliwość w artykule
Podaj dosłowne brzmienie pytania z okresem odniesienia, format odpowiedzi (liczba lub kategorie z granicami), sposób kodowania kategorii otwartych i odsetek odpowiedzi zaokrąglonych. Jeśli w badaniu były różne wersje pytania, opisz przydział i uwzględnij wersję w modelu.
Jeśli planujesz badanie z pytaniami o zachowania i chcesz dobrać format oraz plan analizy przed zebraniem danych, pomożemy w ramach analiz statystycznych dla badaczy.
Przykład w R
Oba przepisy są niezależne. Drugi zapisuje dane, które widzi badacz (wersja pytania, pies, wiek i odpowiedź), do pliku zliczenia-okres-odniesienia.csv (możesz go pobrać tutaj). Potrzebny jest tylko pakiet MASS; reszta to bazowy R. Całość liczy się kilkanaście sekund.
1. Zakres kategorii i pytanie otwarte
R
# Krok 1. Zakres kategorii odpowiedzi zmienia raportowane zachowanie (dane symulowane)
# Eksperyment split-ballot: 1500 osób losowo dostaje jedną z trzech wersji pytania
# „Ile czasu w typowy dzień oglądasz filmy, seriale i programy (telewizja i serwisy wideo)?”
set.seed(3651)
N <- 1500
wersja <- sample(rep(c("niska", "wysoka", "otwarta"), each = N / 3))
prawda <- rlnorm(N, log(1.8), 0.6)                  # prawdziwy czas w godzinach (mediana 1.8 godz.)
pamiec <- prawda * exp(rnorm(N, 0, 0.35))           # nieprecyzyjny ślad w pamięci
w <- rbeta(N, 2, 5)                                 # jak mocno osoba opiera się na skali (średnio 0.29)

# Skale jak u Schwarza i in. (1985): sześć kategorii co pół godziny, przesunięte o 2 godziny
granice <- list(niska = c(0.5, 1, 1.5, 2, 2.5), wysoka = c(2.5, 3, 3.5, 4, 4.5))
etykiety <- list(niska = c("do 0.5", "0.5–1", "1–1.5", "1.5–2", "2–2.5", "ponad 2.5"),
                 wysoka = c("do 2.5", "2.5–3", "3–3.5", "3.5–4", "4–4.5", "ponad 4.5"))
srodek <- c(niska = 1.5, wysoka = 3.5)              # środek skali = domniemana „typowa” wartość
odpowiedz_kat <- function(x, s) {
  szac <- exp((1 - w[x]) * log(pamiec[x]) + w[x] * log(srodek[[s]]))   # wnioskowanie ze skali
  cut(szac, c(0, granice[[s]], Inf), labels = etykiety[[s]], right = FALSE)
}
i_n <- wersja == "niska"; i_w <- wersja == "wysoka"; i_o <- wersja == "otwarta"
kat_n <- odpowiedz_kat(i_n, "niska"); kat_w <- odpowiedz_kat(i_w, "wysoka")
# Pytanie otwarte (minuty): ok. 60% zaokrągla do pół godziny, reszta do pełnej godziny
min_o <- ifelse(runif(sum(i_o)) < 0.6, round(pamiec[i_o] * 2) * 30, round(pamiec[i_o]) * 60)

cat("Rozkład odpowiedzi (%), skala niska:\n"); print(round(100 * prop.table(table(kat_n)), 1))
cat("Rozkład odpowiedzi (%), skala wysoka:\n"); print(round(100 * prop.table(table(kat_w)), 1))

# Odsetek osób, które oglądają więcej niż 2.5 godziny dziennie
wiecej <- c(niska = sum(kat_n == "ponad 2.5"), wysoka = sum(kat_w != "do 2.5"), otwarta = sum(min_o > 150))
n_wer <- c(niska = sum(i_n), wysoka = sum(i_w), otwarta = sum(i_o))
prawdziwy <- tapply(prawda > 2.5, wersja, mean)[names(n_wer)]
print(round(rbind(raportowany_proc = 100 * wiecej / n_wer, prawdziwy_proc = 100 * prawdziwy), 1))
pt <- prop.test(wiecej[c("wysoka", "niska")], n_wer[c("wysoka", "niska")], correct = FALSE)
round(c(roznica_pp = 100 * unname(pt$estimate[1] - pt$estimate[2]), dolna = 100 * pt$conf.int[1],
        gorna = 100 * pt$conf.int[2], chi2 = unname(pt$statistic)), 2)
cat("p:", format.pval(pt$p.value, eps = .001), "\n")
cat("Odpowiedzi otwarte równe dokładnie 150 minut (%):", round(100 * mean(min_o == 150), 1), "\n")

# Średnia z punktów środkowych (kategorie otwarte: 0.25 i 2.75 albo 1.25 i 4.75 godz.)
pkt_n <- c(0.25, 0.75, 1.25, 1.75, 2.25, 2.75); pkt_w <- c(1.25, 2.75, 3.25, 3.75, 4.25, 4.75)
sr <- c(niska_pkt_srodkowe = mean(pkt_n[as.integer(kat_n)]), wysoka_pkt_srodkowe = mean(pkt_w[as.integer(kat_w)]),
        otwarta_srednia = mean(min_o) / 60, prawdziwa_cala_proba = mean(prawda))
round(sr, 2)
round(c(mediana_otwarta = median(min_o) / 60, mediana_prawdziwa = median(prawda)), 2)
cat("Odpowiedzi otwarte podzielne przez 60 minut (%):", round(100 * mean(min_o %% 60 == 0), 1), "\n")
write.csv(data.frame(wersja = c(rep("niska", 6), rep("wysoka", 6)),
                     kategoria = c(etykiety$niska, etykiety$wysoka),
                     procent = c(100 * prop.table(table(kat_n)), 100 * prop.table(table(kat_w)))),
          "rozklady-skal.csv", row.names = FALSE)

# Powtórzenia: czy wynik nie zależy od jednego losowania? (500 powtórzeń tego samego badania)
jedno <- function() {
  prawda <- rlnorm(N, log(1.8), 0.6); pamiec <- prawda * exp(rnorm(N, 0, 0.35)); w <- rbeta(N, 2, 5)
  wer <- sample(rep(c("niska", "wysoka", "otwarta"), each = N / 3))
  sz <- function(s) exp((1 - w) * log(pamiec) + w * log(srodek[[s]]))
  kn <- cut(sz("niska"), c(0, granice$niska, Inf), labels = FALSE, right = FALSE)[wer == "niska"]
  kw <- cut(sz("wysoka"), c(0, granice$wysoka, Inf), labels = FALSE, right = FALSE)[wer == "wysoka"]
  c(roznica_pp = 100 * (mean(kw > 1) - mean(kn == 6)),
    sr_niska = mean(pkt_n[kn]), sr_wysoka = mean(pkt_w[kw]), sr_prawdziwa = mean(prawda))
}
set.seed(3652)
mc <- t(replicate(500, jedno()))
round(rbind(srednia = colMeans(mc), min = apply(mc, 2, min), max = apply(mc, 2, max)), 2)
Wynik w R
Rozkład odpowiedzi (%), skala niska:
kat_n
   do 0.5     0.5–1     1–1.5     1.5–2     2–2.5 ponad 2.5
      1.4      12.4      29.8      22.4      14.2      19.8
Rozkład odpowiedzi (%), skala wysoka:
kat_w
   do 2.5     2.5–3     3–3.5     3.5–4     4–4.5 ponad 4.5
     58.6      16.6       9.8       5.2       3.2       6.6
                 niska wysoka otwarta
raportowany_proc  19.8   41.4    25.0
prawdziwy_proc    26.8   28.8    29.8
roznica_pp      dolna      gorna       chi2
     21.60      16.05      27.15      54.92
p: < 0.001
Odpowiedzi otwarte równe dokładnie 150 minut (%): 5.8
  niska_pkt_srodkowe  wysoka_pkt_srodkowe      otwarta_srednia
                1.73                 2.15                 2.17
prawdziwa_cala_proba
                2.15
  mediana_otwarta mediana_prawdziwa
             2.00              1.79
Odpowiedzi otwarte podzielne przez 60 minut (%): 70.4
        roznica_pp sr_niska sr_wysoka sr_prawdziwa
srednia       19.2     1.77      2.17         2.16
min           10.6     1.69      2.02         2.03
max           28.0     1.86      2.34         2.26
2. Okres odniesienia, zaokrąglanie i model ujemny dwumianowy
R
# Krok 2. Okres odniesienia, zaokrąglanie (heaping) i model dla zliczeń (dane symulowane)
# „Ile razy w ciągu ostatnich 7 / 30 dni wyszedłeś(-aś) na spacer trwający co najmniej 30 minut?”
suppressPackageStartupMessages(library(MASS))
generuj <- function(n) {
  pies <- rbinom(n, 1, 0.35)
  wiek_z <- rnorm(n)
  lambda <- exp(log(0.25) + log(1.6) * pies - 0.15 * wiek_z) * rgamma(n, shape = 2, rate = 2)  # spacery na dzień
  y30 <- rpois(n, 30 * lambda)                     # prawdziwa liczba w ostatnich 30 dniach
  y7 <- rbinom(n, y30, 7 / 30)                     # w tym ostatnie 7 dni
  okres <- sample(rep(c(7, 30), length.out = n))   # losowa wersja pytania (split-ballot)
  y <- ifelse(okres == 7, y7, y30)                 # prawdziwa liczba w pytanym okresie
  # Zliczanie epizodów: pominięcia rosną z długością okresu, a teleskopowanie
  # „wciąga” do okna zdarzenia sprzed niego (średnio z 1.5 dnia)
  pomin <- ifelse(okres == 7, 0.03, 0.15)
  zlicz <- rbinom(n, y, 1 - pomin) + rpois(n, 1.5 * lambda)
  # Przy wielu zdarzeniach szacowanie zamiast liczenia i zaokrąglanie do 5 (do 10 powyżej 30)
  szacuje <- runif(n) < plogis((y - 8) / 2)
  szac <- y * exp(rnorm(n, 0, 0.3))
  szac <- ifelse(szac > 30, round(szac / 10) * 10, round(szac / 5) * 5)
  data.frame(pies, wiek_z, lambda, okres, y, odp = ifelse(szacuje, szac, zlicz), szacuje)
}
set.seed(3653)
d <- generuj(1200)
write.csv(transform(d[, c("pies", "wiek_z", "okres", "odp")], wiek_z = round(wiek_z, 3)),
          "zliczenia-okres-odniesienia.csv", row.names = FALSE)

cat("Liczebność wersji pytania (dni):\n"); print(table(d$okres))
cat("Szacowało zamiast liczyć (%):\n"); print(round(100 * tapply(d$szacuje, d$okres, mean), 1))
# Średnia liczba spacerów na tydzień: prawda a odpowiedzi w obu wersjach
tyg <- function(x, okres) mean(x / okres * 7)
tab_tyg <- rbind(prawda = sapply(c(7, 30), function(k) tyg(d$y[d$okres == k], k)),
                 odpowiedzi = sapply(c(7, 30), function(k) tyg(d$odp[d$okres == k], k)))
colnames(tab_tyg) <- c("pytanie_7_dni", "pytanie_30_dni")
round(tab_tyg, 2)

# Heaping: odsetek odpowiedzi podzielnych przez 5 wśród wartości od 5 wzwyż (pytanie o 30 dni)
p30 <- d$okres == 30
podz5 <- function(x) mean(x[x >= 5] %% 5 == 0)
round(100 * c(prawda = podz5(d$y[p30]), odpowiedzi = podz5(d$odp[p30])), 1)
write.csv(d[p30, c("y", "odp")], "heaping-30-dni.csv", row.names = FALSE)   # do rysunku 2
round(rbind(prawda = quantile(d$y[p30], c(.5, .9)), odpowiedzi = quantile(d$odp[p30], c(.5, .9))), 1)

# Model ujemny dwumianowy z offsetem: liczba na dzień, wersja pytania i pies jako predyktory
d$okres30 <- as.integer(d$okres == 30)
irr <- function(m, co) { b <- coef(m)[co]; se <- sqrt(diag(vcov(m)))[co]
  data.frame(predyktor = co, IRR = exp(b), dolna = exp(b - 1.96 * se), gorna = exp(b + 1.96 * se)) }
dysp <- function(m) sum(residuals(m, type = "pearson")^2) / df.residual(m)
m_p_prawda <- glm(y ~ pies + wiek_z + okres30 + offset(log(okres)), family = poisson, data = d)
m_p_odp <- glm(odp ~ pies + wiek_z + okres30 + offset(log(okres)), family = poisson, data = d)
m_nb_prawda <- glm.nb(y ~ pies + wiek_z + okres30 + offset(log(okres)), data = d)
m_nb_odp <- glm.nb(odp ~ pies + wiek_z + okres30 + offset(log(okres)), data = d)
round(c(dyspersja_Poisson_prawda = dysp(m_p_prawda), dyspersja_Poisson_odp = dysp(m_p_odp),
        theta_NB_prawda = m_nb_prawda$theta, theta_NB_odp = m_nb_odp$theta), 2)
cat("IRR (prawdziwe IRR dla psa = 1.6, dla okresu 30 vs 7 dni = 1):\n")
modele <- list(Poisson_prawda = m_p_prawda, Poisson_odp = m_p_odp, NB_prawda = m_nb_prawda, NB_odp = m_nb_odp)
tab_irr <- do.call(rbind, lapply(names(modele), function(k) cbind(model = k, irr(modele[[k]], c("pies", "okres30")))))
tab_irr[, 3:5] <- round(tab_irr[, 3:5], 3)
print(tab_irr, row.names = FALSE)
write.csv(tab_irr, "irr-modele.csv", row.names = FALSE)
round(c(AIC_Poisson_odp = AIC(m_p_odp), AIC_NB_odp = AIC(m_nb_odp)), 1)

# Powtórzenia: 300 badań po 1200 osób
jedno <- function() {
  d <- generuj(1200); d$okres30 <- as.integer(d$okres == 30)
  m <- glm.nb(odp ~ pies + wiek_z + okres30 + offset(log(okres)), data = d)
  p30 <- d$okres == 30
  c(tydz_7 = tyg(d$odp[!p30], 7), tydz_30 = tyg(d$odp[p30], 30), tydz_prawda = mean(d$lambda) * 7,
    IRR_pies = exp(coef(m)[["pies"]]), IRR_okres30 = exp(coef(m)[["okres30"]]), heaping_proc = 100 * podz5(d$odp[p30]))
}
set.seed(3654)
mc <- t(replicate(300, jedno()))
round(rbind(srednia = colMeans(mc), min = apply(mc, 2, min), max = apply(mc, 2, max)), 2)
Wynik w R
Liczebność wersji pytania (dni):

  7  30
600 600
Szacowało zamiast liczyć (%):
   7   30
 6.7 46.2
           pytanie_7_dni pytanie_30_dni
prawda              2.11           2.23
odpowiedzi          2.52           2.20
    prawda odpowiedzi
      25.0       82.8
           50% 90%
prawda       7  20
odpowiedzi   6  20
dyspersja_Poisson_prawda    dyspersja_Poisson_odp          theta_NB_prawda
                    4.00                     4.89                     1.97
            theta_NB_odp
                    1.65
IRR (prawdziwe IRR dla psa = 1.6, dla okresu 30 vs 7 dni = 1):
          model predyktor   IRR dolna gorna
 Poisson_prawda      pies 1.698 1.620 1.780
 Poisson_prawda   okres30 1.076 1.012 1.143
    Poisson_odp      pies 1.699 1.622 1.780
    Poisson_odp   okres30 0.887 0.838 0.939
      NB_prawda      pies 1.664 1.501 1.844
      NB_prawda   okres30 1.063 0.960 1.177
         NB_odp      pies 1.629 1.462 1.815
         NB_odp   okres30 0.862 0.776 0.958
AIC_Poisson_odp      AIC_NB_odp
         8854.5          6324.1
        tydz_7 tydz_30 tydz_prawda IRR_pies IRR_okres30 heaping_proc
srednia   2.49    2.16        2.14     1.62        0.86        80.64
min       2.17    1.91        2.03     1.39        0.72        73.88
max       2.81    2.48        2.30     1.93        1.02        86.05
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–2 w R 4.5.3 (funkcje prop.test() i glm() z pakietu stats) z pakietem MASS (glm.nb()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Brak okresu odniesienia albo okres bez granicy. „Jak często…?” każdy rozumie po swojemu, a „ostatni miesiąc” sprzyja teleskopowaniu.
- Łączenie wersji z różnymi okresami albo skalami. Różne wersje dają różne liczby nawet przy tym samym zachowaniu.
- Przedziały ułożone „na oko”. Zakres kategorii działa jak informacja o tym, co jest typowe. Układaj je na podstawie pilotażu.
- Średnia z punktów środkowych podana jak pomiar. Wynik zależy od wartości przypisanych kategoriom otwartym. Zawsze podaj, jakie to były wartości.
- Model Poissona bez sprawdzenia rozproszenia. Odpowiedzi ankietowe prawie zawsze są nadmiernie rozproszone, a zaokrąglanie to rozproszenie zwiększa.
- Nieostre kwantyfikatory w porównaniach grup. „Często” w jednej grupie nie musi oznaczać tej samej liczby co w drugiej.
Najczęstsze pytania
Jaki okres odniesienia wybrać w pytaniu o częstotliwość zachowania?
Dopasuj go do częstości zachowania. O częste czynności pytaj o krótki okres albo typowy tydzień, o rzadkie i ważne zdarzenia – o dłuższy. Długi okres zwiększa pominięcia i szacowanie, krótki – względny udział teleskopowania. Granicę okresu wyznacz datą lub wydarzeniem, a nie słowami „w ostatnim miesiącu”.
Czy w pytaniu o liczbę zachowań lepiej podać pole na liczbę czy przedziały?
Do analiz ilościowych zwykle lepsza jest liczba z ograniczeniem zakresu w formularzu, bo nie podsuwa, ile to „przeciętnie”, i pozwala użyć modelu dla zliczeń. Przedziały są łatwiejsze dla respondenta, ale ich zakres przesuwa odpowiedzi, a średnia zależy od wartości przypisanych kategoriom otwartym.
Dlaczego zakres kategorii odpowiedzi zmienia raportowaną częstotliwość?
Respondenci traktują skalę jako informację o tym, co jest typowe, i porównują z nią swoje zachowanie (Schwarz i in., 1985). W symulacji z tym mechanizmem odsetek osób deklarujących ponad 2.5 godziny oglądania wyniósł 19.8% na skali niskiej i 41.4% na wysokiej, choć prawdziwe odsetki były podobne.
Co zrobić z odpowiedziami zaokrąglonymi do 5 i 10 w pytaniu o liczbę zdarzeń?
Nie usuwaj ich – to ślad szacowania, a nie błąd wpisu. Podaj odsetek odpowiedzi zaokrąglonych, użyj modelu ujemnego dwumianowego zamiast modelu Poissona, bo zaokrąglanie zwiększa rozproszenie, i rozważ analizę wrażliwości, gdy skłonność do zaokrąglania może różnić się między grupami.
Czy określenia „często” i „rzadko” nadają się do porównywania grup?
Tylko ostrożnie. Znaczenie nieostrych kwantyfikatorów różni się między grupami, np. wiekowymi i o różnym wykształceniu (Schaeffer, 1991), więc różnica w odpowiedziach może wynikać z innego rozumienia słów. Gdy interesuje cię liczba zdarzeń, użyj kategorii liczbowych.
Powiązane hasła
Przeczytaj też
Eksperyment split-ballot w ankiecie
Dwie losowe wersje pytania: kontrola losowania, „nie wiem” jako wynik, regresja porządkowa, moc i ocena, która wersja lepiej mierzy postawę.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikBadania dzienniczkowe i EMA – analiza danych
Compliance, ICC, centrowanie w osobie, opóźnienia w obrębie dnia, reaktywność afektywna w lme4 i rzetelność zmiany – z kodem R i wzorem opisu.
Czytaj →Projektujesz pytania o zachowania i nie wiesz, jak potem analizować liczby?
Pomożemy dobrać okres odniesienia i format odpowiedzi, zaplanować eksperyment z wersjami pytania i model dla zliczeń oraz opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bradburn, N. M., Rips, L. J., & Shevell, S. K. (1987). Answering autobiographical questions: The impact of memory and inference on surveys. Science, 236(4798), 157–161. https://doi.org/10.1126/science.3563494
- Burton, S., & Blair, E. (1991). Task conditions, response formulation processes, and response accuracy for behavioral frequency questions in surveys. Public Opinion Quarterly, 55(1), 50–79. https://doi.org/10.1086/269241
- Huttenlocher, J., Hedges, L. V., & Bradburn, N. M. (1990). Reports of elapsed time: Bounding and rounding processes in estimation. Journal of Experimental Psychology: Learning, Memory, and Cognition, 16(2), 196–213. https://doi.org/10.1037/0278-7393.16.2.196
- Neter, J., & Waksberg, J. (1964). A study of response errors in expenditures data from household interviews. Journal of the American Statistical Association, 59(305), 18–55. https://doi.org/10.1080/01621459.1964.10480699
- Schaeffer, N. C. (1991). Hardly ever or constantly? Group comparisons using vague quantifiers. Public Opinion Quarterly, 55(3), 395–423. https://doi.org/10.1086/269270
- Schwarz, N., Hippler, H.-J., Deutsch, B., & Strack, F. (1985). Response scales: Effects of category range on reported behavior and comparative judgments. Public Opinion Quarterly, 49(3), 388–395. https://doi.org/10.1086/268936
- Sudman, S., & Bradburn, N. M. (1973). Effects of time and memory factors on response in surveys. Journal of the American Statistical Association, 68(344), 805–815. https://doi.org/10.1080/01621459.1973.10481428
- Tourangeau, R., Rips, L. J., & Rasinski, K. (2000). The psychology of survey response. Cambridge University Press. https://doi.org/10.1017/cbo9780511819322
- Wang, H., & Heitjan, D. F. (2008). Modeling heaping in self-reported cigarette counts. Statistics in Medicine, 27(19), 3789–3804. https://doi.org/10.1002/sim.3281 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bradburn1987answering, author={Bradburn, Norman M. and Rips, Lance J. and Shevell, Steven K.}, title={{Answering autobiographical questions: The impact of memory and inference on surveys}}, journal={Science}, year={1987}, volume={236}, number={4798}, pages={157--161}, doi={10.1126/science.3563494}}@article{burton1991task, author={Burton, Scot and Blair, Edward}, title={{Task conditions, response formulation processes, and response accuracy for behavioral frequency questions in surveys}}, journal={Public Opinion Quarterly}, year={1991}, volume={55}, number={1}, pages={50--79}, doi={10.1086/269241}}@article{huttenlocher1990reports, author={Huttenlocher, Janellen and Hedges, Larry V. and Bradburn, Norman M.}, title={{Reports of elapsed time: Bounding and rounding processes in estimation}}, journal={Journal of Experimental Psychology: Learning, Memory, and Cognition}, year={1990}, volume={16}, number={2}, pages={196--213}, doi={10.1037/0278-7393.16.2.196}}@article{neter1964study, author={Neter, John and Waksberg, Joseph}, title={{A study of response errors in expenditures data from household interviews}}, journal={Journal of the American Statistical Association}, year={1964}, volume={59}, number={305}, pages={18--55}, doi={10.1080/01621459.1964.10480699}}@article{schaeffer1991hardly, author={Schaeffer, Nora Cate}, title={{Hardly ever or constantly? Group comparisons using vague quantifiers}}, journal={Public Opinion Quarterly}, year={1991}, volume={55}, number={3}, pages={395--423}, doi={10.1086/269270}}@article{schwarz1985response, author={Schwarz, Norbert and Hippler, Hans-J. and Deutsch, Brigitte and Strack, Fritz}, title={{Response scales: Effects of category range on reported behavior and comparative judgments}}, journal={Public Opinion Quarterly}, year={1985}, volume={49}, number={3}, pages={388--395}, doi={10.1086/268936}}@article{sudman1973effects, author={Sudman, Seymour and Bradburn, Norman M.}, title={{Effects of time and memory factors on response in surveys}}, journal={Journal of the American Statistical Association}, year={1973}, volume={68}, number={344}, pages={805--815}, doi={10.1080/01621459.1973.10481428}}@book{tourangeau2000psychology, author={Tourangeau, Roger and Rips, Lance J. and Rasinski, Kenneth}, title={{The psychology of survey response}}, year={2000}, publisher={Cambridge University Press}, doi={10.1017/cbo9780511819322}}@article{wang2008modeling, author={Wang, Hao and Heitjan, Daniel F.}, title={{Modeling heaping in self-reported cigarette counts}}, journal={Statistics in Medicine}, year={2008}, volume={27}, number={19}, pages={3789--3804}, doi={10.1002/sim.3281}}