Dlaczego pytanie o dochód psuje dane częściej niż inne
W metryczce dochód stoi obok wieku i wykształcenia, ale zachowuje się zupełnie inaczej. Na pytanie o wiek odpowiadają prawie wszyscy (zob. pytania o płeć i wiek). Na pytanie o dochód wiele osób odmawia albo odpowiada „nie wiem”. Tourangeau i Yan (2007) zaliczają dochód do pytań drażliwych, przy których respondenci „redagują” odpowiedź, żeby uniknąć zakłopotania. Odmowa i „nie wiem” to przy tym dwa różne zachowania. Schräpler (2004), analizując motywy niepodawania zarobków w niemieckim panelu SOEP, pokazuje, że trzeba je od siebie odróżniać. Riphahn i Serfling (2005) badali na tych samych danych, czy braki różnią się między pytaniami o różne składniki dochodu i majątku.
Problem nie kończy się na brakach. Hariri i Lassen (2017) porównali deklaracje z duńskimi rejestrami administracyjnymi. Respondenci podobni do osób zamożnych najczęściej zawyżali dochód, co autorzy wiążą z aprobatą społeczną. Ten wpis jest dla badacza, który projektuje pytanie o dochód albo ma już dane z brakami i przedziałami. Ogólne zasady postępowania z brakami w ankiecie znajdziesz we wpisie braki danych w ankiecie. Tu chodzi o to, co jest specyficzne dla dochodu.
Najpierw zdecyduj, jaki dochód mierzysz
„Jaki jest Pana/Pani dochód?” to pytanie, na które każdy odpowie o czymś innym. Jedna osoba poda pensję brutto z umowy, druga – kwotę na koncie, trzecia doliczy zasiłek, a czwarta poda dochód całej rodziny. Zanim wybierzesz format odpowiedzi, ustal definicję i wpisz ją do treści pytania.
| Decyzja | Możliwości | Wskazówka |
|---|---|---|
| Czyj dochód | osobisty albo gospodarstwa domowego | Do pozycji materialnej i ubóstwa – gospodarstwo. Do pytań o rynek pracy – dochód osobisty albo wynagrodzenie. |
| Netto czy brutto | „na rękę” albo przed podatkami i składkami | W ankietach ogólnych zwykle netto, bo tę kwotę ludzie znają. Brutto pytaj tylko wtedy, gdy respondenci znają je z umowy. |
| Okres | miesiąc, rok, „ostatni miesiąc” albo „zwykle” | Dopasuj okres do tego, jak dochód jest wypłacany. Hurd i in. (2003) pokazali, że takie dopasowanie wyraźnie poprawiło jakość deklaracji świadczeń. |
| Składniki | praca, świadczenia, renty i emerytury, najem, inne | Wymień je w pytaniu albo zapytaj o każdy osobno i zsumuj. Pytanie o sumę bez listy pomija drobne źródła. |
| Przeliczenie | na osobę albo na jednostkę ekwiwalentną | Do porównań gospodarstw różnej wielkości użyj skali ekwiwalentności, a w metryczce zapytaj o liczbę dorosłych i dzieci. |
Dochód na osobę zakłada, że czteroosobowa rodzina potrzebuje cztery razy więcej niż osoba samotna. Zmodyfikowana skala OECD uwzględnia wspólne koszty: pierwsza osoba dorosła ma wagę 1, każda kolejna osoba w wieku 14 lat i więcej – 0.5, a każde dziecko poniżej 14 lat – 0.3. Dochód ekwiwalentny to dochód gospodarstwa podzielony przez sumę wag. W przykładzie niżej mediana dochodu gospodarstwa wynosi 6673 zł, a mediana dochodu ekwiwalentnego – 4111 zł. Do tego przeliczenia potrzebujesz liczby dorosłych i dzieci, więc zaplanuj te pytania razem z pytaniem o dochód.
Kwota, przedziały czy kaskada przedziałów
Masz trzy formaty odpowiedzi. Różnią się ilością informacji i odsetkiem braków.
- Kwota (pytanie otwarte). Daje najwięcej informacji, ale też najwięcej odmów. Podane kwoty są zaokrąglane do okrągłych sum. Heitjan i Rubin (1991) traktują dane zaokrąglone, skupione na okrągłych wartościach i podane w przedziałach jako jeden typ danych „zgrubnych” (coarse data).
- Same przedziały (kafeteria z kategoriami dochodu). Łatwiejsze dla respondenta, ale tracą informację wewnątrz przedziałów i niemal nic nie mówią o górnej, otwartej kategorii. Kategorie muszą być rozłączne, z jednoznacznymi granicami („5000–6999 zł”, a nie „5000–7000 zł” i „7000–10 000 zł”).
- Kwota z kaskadą przedziałów (unfolding brackets). Osoba, która nie podała kwoty, dostaje serię pytań tak/nie: „Czy jest to co najmniej 5000 zł?”, potem „co najmniej 10 000 zł?” albo „co najmniej 3000 zł?”. Juster i Smith (1997) opisują takie pytania uzupełniające jako częściowe odpowiedzi, które wyraźnie zmniejszają odsetek braków i pomagają ograniczyć obciążenie przy nieignorowalnych brakach.
Pierwszy próg kaskady ustaw w pobliżu spodziewanej mediany, a kolejne tak, by przedziały miały podobną liczebność. Progi weź z danych o podobnej populacji albo z pilotażu. W ankiecie internetowej kaskada to pytania warunkowe wyświetlane tylko osobom, które zaznaczyły „nie chcę podać” lub „nie wiem”. Sprawdź ją przed startem na wszystkich ścieżkach (zob. test techniczny ankiety online). Opcje „nie wiem” i „wolę nie odpowiadać” zapisz jako osobne kody braków. Jak je kodować, opisuje hasło odpowiedź „nie wiem”. Pytanie postaw pod koniec ankiety i nie rób go obowiązkowym, bo wymuszona odpowiedź daje dane gorszej jakości albo przerwanie ankiety.
Odmowa, „nie wiem” i mechanizm braków
Przy dochodzie trudno bronić założenia, że braki są MCAR albo choćby MAR (zob. MCAR, MAR i MNAR). Jeśli osoby zamożniejsze częściej odmawiają, to brak zależy od samej niepodanej wartości. To mechanizm MNAR, którego nie usuną kowarianty demograficzne. Przedziały z kaskady zmieniają sytuację. Brak kwoty dalej jest nielosowy, ale wiemy już, w którym przedziale leży dochód. Heitjan i Rubin (1991) podają warunek, przy którym takie dane można analizować po prostu jak dane pogrupowane: muszą być „zgrubione losowo” (coarsened at random), co jest uogólnieniem MAR. Im węższe przedziały, tym mniej zależy od tego założenia.
Przykład: kaskada w 2000 gospodarstw
W symulacji 2000 gospodarstw ma log-normalny rozkład miesięcznego dochodu netto. Dochód zależy od wykształcenia, liczby dorosłych, liczby dzieci i wieku. Prawdopodobieństwo braku kwoty rośnie z dochodem. Kwotę podało 1359 gospodarstw (68%). 244 odpowiedziały „nie wiem”, a 397 odmówiły. Mediana prawdziwego dochodu wynosiła 5981 zł u osób z kwotą, 7982 zł przy „nie wiem” i 8324 zł przy odmowie. Kaskadę z progami 3000, 5000 i 10 000 zł wypełniło 198 osób z „nie wiem” i 219 z odmową. Bez żadnej informacji zostały 224 gospodarstwa.
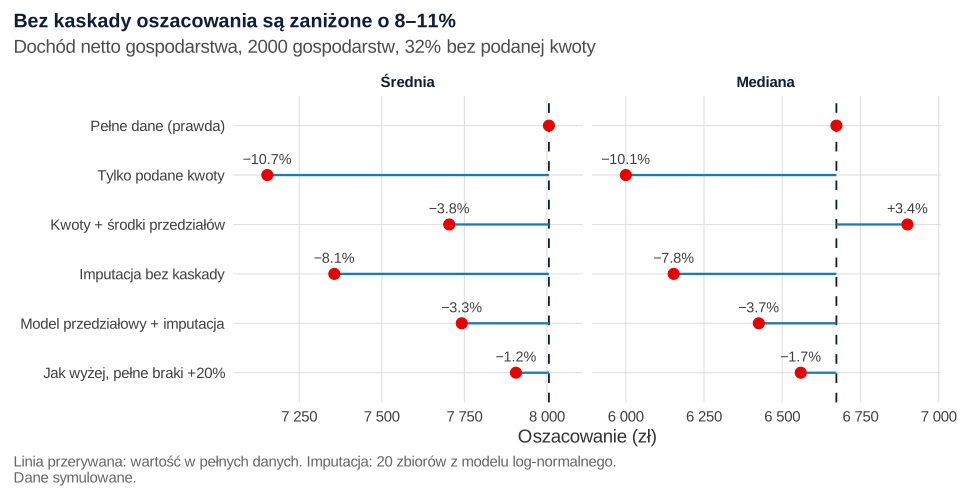
Średnia z samych podanych kwot wyniosła 7153 zł przy prawdziwej 8006 zł (−10.7%), a mediana 6000 zł przy 6673 zł (−10.1%). Imputacja wielokrotna z modelu z kowariantami, ale bez kaskady, poprawiła wynik tylko trochę: −8.1% dla średniej i −7.8% dla mediany. Kowarianty tłumaczą część różnic w dochodzie, ale nie to, że odmawiają osoby zamożniejsze w obrębie tych samych grup. Dopiero przedziały z kaskady zmniejszyły błąd do około 3–4%, i to niezależnie od tego, czy przedziały zastąpiono środkami (−3.8% dla średniej), czy użyto modelu przedziałowego (−3.3%).
Czy to nie przypadek jednej próby? W 300 powtórzeniach całego badania średni błąd średniej wyniósł −11.42% dla samych kwot, −9.04% dla imputacji bez kaskady, −4.24% dla środków przedziałów i −3.87% dla modelu przedziałowego. SD błędu między powtórzeniami wynosiło 0.8–1.1 punktu procentowego, więc różnice między metodami są wyraźnie większe od losowego rozrzutu. Środki przedziałów zawyżyły przy tym medianę średnio o 3.53%, a model ją zaniżył o 2.98%.
Resztę obciążenia tworzą 224 gospodarstwa bez kwoty i bez przedziału. Model imputuje im dochód z kowariantów, czyli przy założeniu MAR, a w danych są one zamożniejsze. Tego nie da się sprawdzić w prawdziwych danych, więc pokaż analizę wrażliwości. Przesuń imputowane wartości pełnych braków o założony procent i sprawdź, jak zmienia się wynik. W przykładzie przesunięcie o 20% dało średnią 7906 zł (−1.2%), a w powtórzeniach średni błąd −1.61%. Systematyczną wersję tej procedury opisuje hasło analiza punktu krytycznego.
Model przedziałowy zamiast punktów środkowych
Dane z kaskady to mieszanina trzech typów obserwacji: dokładnej kwoty, przedziału zamkniętego (np. 5000–10 000 zł) i przedziału otwartego od dołu albo od góry („co najmniej 10 000 zł”). Dokładnie taką strukturę obsługuje regresja dla danych cenzurowanych przedziałowo (zob. obserwacja cenzurowana). W R wystarczy survival::survreg() z Surv(dolna, gorna, type = "interval2") i rozkładem log-normalnym. Kwota ma równe granice, przedział zamknięty – dwie granice, a przedział otwarty od góry – NA jako górną granicę. Model szacuje się metodą największej wiarygodności, a każda osoba wnosi tyle informacji, ile podała.
Z modelu możesz policzyć średnią i medianę wprost. Wygodniejsza jest jednak imputacja wielokrotna. Dla każdej z 20 imputacji losujesz parametry modelu z ich rozkładu. Osobom z przedziałem losujesz dochód z rozkładu uciętego do ich przedziału, a osobom bez żadnej informacji – z pełnego rozkładu warunkowego. Taki zbiór możesz potem analizować jak każdy zbiór po imputacji i łączyć wyniki regułami Rubina (zob. imputacja wielokrotna w R). Zasady imputacji wielokrotnej i jej diagnostykę omawia van Buuren (2018). Pakiet mice nie ma gotowej metody dla przedziałów. Możesz ograniczyć imputacje argumentem post, ale proste przycięcie do granic skupia wartości na granicach przedziału. Dlatego w przepisie 1 imputację z modelu przedziałowego zapisaliśmy wprost.
Pytanie tylko w przedziałach: pułapka otwartej kategorii
Gdy pytasz wyłącznie o przedziały, każda odpowiedź jest przedziałem. Najczęstszy sposób liczenia średniej to przypisanie każdej kategorii jej środka. Dla górnej, otwartej kategorii środka nie ma, więc badacz przyjmuje wartość „na oko”, np. 1.5 × dolna granica. Rysunek 2 pokazuje, dlaczego to ryzykowne. Te same 2000 gospodarstw odpowiadało w 7 kategoriach, a w kategorii „10 000 zł i więcej” znalazło się 25.4% z nich.
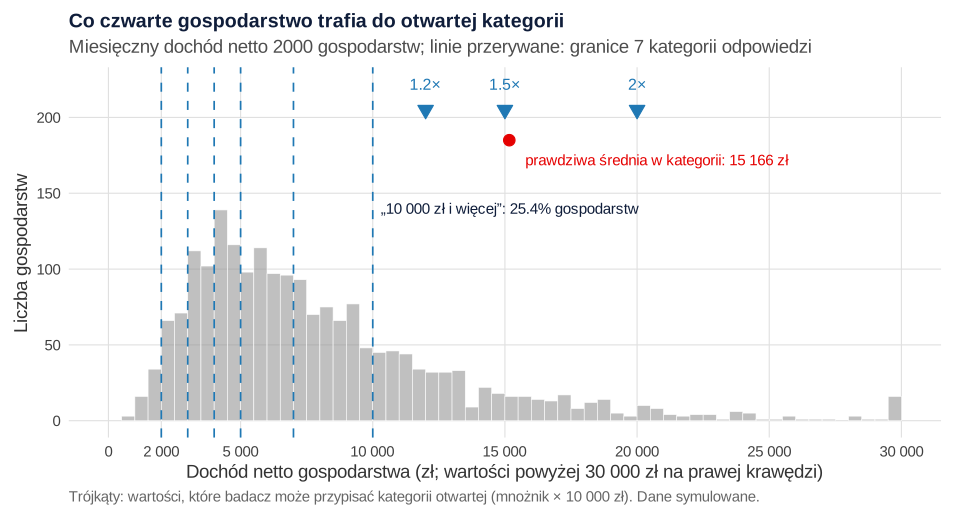
Przy prawdziwej średniej 8006 zł punkty środkowe dały 7226 zł przy mnożniku 1.2, 7987 zł przy 1.5 i 9254 zł przy 2. Log-normalny model przedziałowy bez kowariantów dał 8029 zł. Mediana ze środków to po prostu środek kategorii, w której leży połowa próby (6000 zł). Model dał 6644 zł przy prawdziwej 6673 zł. Gdy górna kategoria zaczynała się już od 7000 zł i obejmowała 46.8% gospodarstw, średnie ze środków wyniosły 6292, 7275 i 8913 zł, a z modelu 8041 zł.
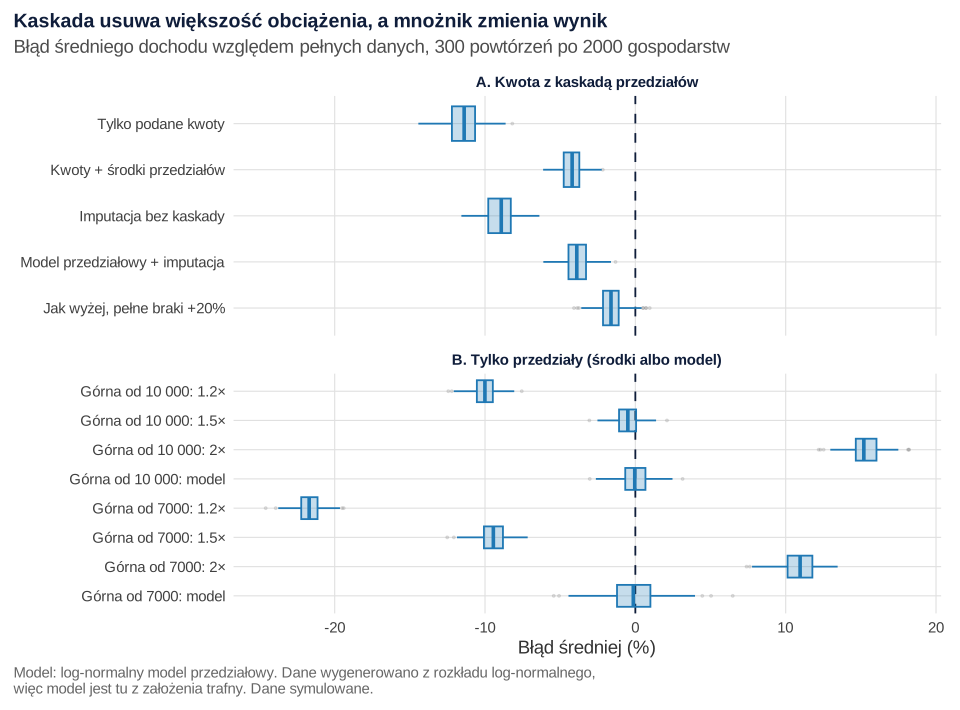
W 300 powtórzeniach (Rysunek 3) mnożnik 1.5 przy górnej kategorii od 10 000 zł dał średni błąd −0.53%, a przy kategorii od 7000 zł już −9.48%. Mnożnik 2 zawyżał średnią o 15.31% i 10.90%, a mnożnik 1.2 zaniżał ją o 10.03% i 21.70%. Model przedziałowy miał średni błąd 0.00% i −0.03%, choć przy szerszej górnej kategorii większy rozrzut (SD 1.82 wobec 1.06 punktu procentowego). Nie znaczy to, że mnożnik 1.5 jest dobry, a model zawsze trafny. Mnożnik trafił przypadkiem przy jednym układzie kategorii. Model wypadł idealnie, bo dane wygenerowaliśmy z rozkładu log-normalnego. W prawdziwych danych najwyższe dochody mają zwykle grubszy ogon niż rozkład log-normalny. Porównaj więc dopasowanie kilku rozkładów i podaj wynik zależny od tego wyboru jako analizę wrażliwości. Przede wszystkim projektuj kategorie tak, by w otwartej kategorii znalazło się jak najmniej osób.
Dochód jako zmienna w analizie
Jeśli dochód jest predyktorem albo zmienną kontrolną, zwykle wprowadza się go po transformacji logarytmicznej, bo ten sam przyrost w złotych znaczy więcej przy niskich dochodach. Hariri i Lassen (2017) pokazali dodatkowo, że w ich analizach logarytm usuwał obciążenie wynikające z zawyżania deklaracji. Kodów kategorii 1–7 nie traktuj jak liczby złotych. Przy kilku kategoriach lepiej wprowadzić je jako zmienną kategorialną albo użyć imputacji z modelu przedziałowego. Pamiętaj też, że model imputacji musi zawierać zmienne z analizy właściwej, inaczej imputacja osłabi związki dochodu z wynikiem. Przy pytaniach naprawdę drażliwych, gdy chcesz oszacować tylko odsetek, rozważ metody pośrednie z wpisu o pytaniach drażliwych.
Jak opisać pytanie o dochód i braki w artykule
Podaj brzmienie pytania (czyj dochód, netto czy brutto, okres, składniki), format odpowiedzi i progi kaskady. Zestaw odsetki kwot, odmów, „nie wiem” i przedziałów. Opisz model imputacji, liczbę imputacji, założenie o pełnych brakach i wynik analizy wrażliwości.
Jeśli masz w danych dochód z dużą liczbą braków albo tylko w przedziałach i chcesz go rzetelnie oszacować lub użyć w modelu, możemy pomóc w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z funkcji i obiektów z pierwszego). Całość liczy się kilka sekund. Potrzebne pakiety: survival, truncnorm i MASS.
1. Kwota, kaskada i model przedziałowy
R
# Krok 1. Pytanie o dochód z kaskadą przedziałów: kwota, odmowa, „nie wiem” (dane symulowane)
# 2000 gospodarstw domowych; prawdziwy miesięczny dochód netto gospodarstwa ma rozkład log-normalny.
suppressPackageStartupMessages({library(survival); library(truncnorm)})
options(width = 110)

generuj <- function(n) {
  dorosli <- sample(1:3, n, replace = TRUE, prob = c(.30, .55, .15))
  dzieci <- sample(0:3, n, replace = TRUE, prob = c(.55, .22, .17, .06))
  wiek <- round(runif(n, 25, 75))
  wyzsze <- rbinom(n, 1, plogis(0.4 - 0.03 * (wiek - 45)))
  logy <- log(4200) + 0.35 * wyzsze + 0.30 * (dorosli - 1) + 0.06 * dzieci -
          0.00015 * (wiek - 50)^2 + rnorm(n, 0, 0.55)
  dochod <- exp(logy)
  # Brak kwoty: częstszy przy wysokich dochodach (MNAR) i u osób z wyższym wykształceniem
  p_brak <- plogis(-1.25 + 0.9 * (logy - log(5000)) + 0.3 * wyzsze)
  brak <- runif(n) < p_brak
  powod <- ifelse(!brak, "kwota", ifelse(runif(n) < 0.4, "nie wiem", "odmowa"))
  # Kaskada przedziałów (unfolding brackets): „co najmniej 5000 zł?” → „co najmniej 10 000 zł?” albo „co najmniej 3000 zł?”
  kaskada <- powod != "kwota" & runif(n) < ifelse(powod == "nie wiem", 0.80, 0.55)
  granice <- c(0, 3000, 5000, 10000, Inf)
  przedzial <- ifelse(kaskada, findInterval(dochod, granice), NA)
  data.frame(dorosli, dzieci, wiek, wyzsze, dochod, powod, kaskada,
             kwota = ifelse(powod == "kwota", round(dochod, -2), NA),  # podane kwoty zaokrąglone do 100 zł
             dolna = ifelse(kaskada, granice[pmax(przedzial, 1)], NA),
             gorna = ifelse(kaskada, granice[pmax(przedzial, 1) + 1], NA))
}

set.seed(3661)
d <- generuj(2000)
cat("Odpowiedzi na pytanie o kwotę:\n"); print(table(d$powod))
cat("Przedział z kaskady wśród osób bez kwoty:\n"); print(table(d$powod[d$powod != "kwota"], d$kaskada[d$powod != "kwota"]))
cat("Mediana prawdziwego dochodu wg typu odpowiedzi:\n"); print(round(tapply(d$dochod, d$powod, median)))

# Dochód ekwiwalentny (zmodyfikowana skala OECD: 1 + 0.5 na każdą kolejną osobę 14+ i 0.3 na dziecko do 13 lat)
d$skala_oecd <- 1 + 0.5 * (d$dorosli - 1) + 0.3 * d$dzieci
round(c(mediana_gospodarstwo = median(d$dochod), mediana_ekwiwalentny = median(d$dochod / d$skala_oecd)))

# Model przedziałowy (log-normalny): kwota = punkt, kaskada = przedział, pełny brak = (0, ∞)
d$lo <- ifelse(!is.na(d$kwota), d$kwota, ifelse(d$kaskada, pmax(d$dolna, 1), NA))
d$hi <- ifelse(!is.na(d$kwota), d$kwota, ifelse(d$kaskada, d$gorna, NA))
d$hi[is.infinite(d$hi)] <- NA                       # otwarty górny przedział: NA = brak górnej granicy
m <- survreg(Surv(lo, hi, type = "interval2") ~ wyzsze + dorosli + dzieci + wiek + I((wiek - 50)^2),
             data = d[!is.na(d$lo), ], dist = "lognormal")
print(round(summary(m)$table, 4))

# Imputacja wielokrotna z modelu przedziałowego: losowanie parametrów, potem dochodu z ucięciem do przedziału
imputuj <- function(d, m, delta = 0, z_kaskada = TRUE) {
  b <- MASS::mvrnorm(1, c(coef(m), log(m$scale)), vcov(m))
  X <- model.matrix(~ wyzsze + dorosli + dzieci + wiek + I((wiek - 50)^2), d)
  mu <- drop(X %*% b[seq_along(coef(m))]); s <- exp(b[[length(b)]])
  y <- d$kwota
  k <- which(d$kaskada & z_kaskada)
  if (length(k)) y[k] <- exp(rtruncnorm(length(k), a = log(pmax(d$dolna[k], 1)), b = log(d$gorna[k]), mean = mu[k], sd = s))
  p <- which(is.na(y))                                   # pełny brak: MAR względem kowariantów (+ ewentualne przesunięcie delta)
  y[p] <- exp(rnorm(length(p), mu[p] + delta, s))
  y
}
oszacuj <- function(d, m, M = 20) {
  m0 <- update(m, data = d[!is.na(d$kwota), ])           # ten sam model tylko na podanych kwotach (kaskada pominięta)
  mid <- c(1500, 4000, 7500, 15000)                       # punkty środkowe; górny przedział otwarty: 1.5 × 10 000
  y_mid <- ifelse(!is.na(d$kwota), d$kwota, ifelse(d$kaskada, mid[match(d$dolna, c(0, 3000, 5000, 10000))], NA))
  imp <- replicate(M, imputuj(d, m))
  imp0 <- replicate(M, imputuj(d, m0, z_kaskada = FALSE))
  imp_d20 <- replicate(M, imputuj(d, m, delta = log(1.2)))
  rbind(pelne_dane = c(mean(d$dochod), median(d$dochod)),
        tylko_kwoty = c(mean(d$kwota, na.rm = TRUE), median(d$kwota, na.rm = TRUE)),
        kwoty_i_srodki_przedzialow = c(mean(y_mid, na.rm = TRUE), median(y_mid, na.rm = TRUE)),
        MI_bez_kaskady = c(mean(colMeans(imp0)), mean(apply(imp0, 2, median))),
        model_przedzialowy_MI = c(mean(colMeans(imp)), mean(apply(imp, 2, median))),
        MI_pelne_braki_plus_20proc = c(mean(colMeans(imp_d20)), mean(apply(imp_d20, 2, median))))
}
wyn <- oszacuj(d, m)
colnames(wyn) <- c("srednia", "mediana")
print(round(wyn))
cat("Błąd względem pełnych danych (%):\n"); print(round(100 * (sweep(wyn, 2, wyn[1, ], "/") - 1), 1))
write.csv(data.frame(metoda = rownames(wyn), round(wyn)), "oszacowania-kaskada.csv", row.names = FALSE)
Wynik w R
Odpowiedzi na pytanie o kwotę:

   kwota nie wiem   odmowa
    1359      244      397
Przedział z kaskady wśród osób bez kwoty:

           FALSE TRUE
  nie wiem    46  198
  odmowa     178  219
Mediana prawdziwego dochodu wg typu odpowiedzi:
   kwota nie wiem   odmowa
    5981     7982     8324
mediana_gospodarstwo mediana_ekwiwalentny
                6673                 4111
                   Value Std. Error        z      p
(Intercept)       8.0937     0.0689 117.3916 0.0000
wyzsze            0.3270     0.0274  11.9497 0.0000
dorosli           0.2929     0.0206  14.2229 0.0000
dzieci            0.0646     0.0137   4.7046 0.0000
wiek             -0.0013     0.0009  -1.4223 0.1549
I((wiek - 50)^2) -0.0002     0.0001  -2.1110 0.0348
Log(scale)       -0.6019     0.0180 -33.3908 0.0000
                           srednia mediana
pelne_dane                    8006    6673
tylko_kwoty                   7153    6000
kwoty_i_srodki_przedzialow    7704    6900
MI_bez_kaskady                7356    6153
model_przedzialowy_MI         7742    6425
MI_pelne_braki_plus_20proc    7906    6559
Błąd względem pełnych danych (%):
                           srednia mediana
pelne_dane                     0.0     0.0
tylko_kwoty                  -10.7   -10.1
kwoty_i_srodki_przedzialow    -3.8     3.4
MI_bez_kaskady                -8.1    -7.8
model_przedzialowy_MI         -3.3    -3.7
MI_pelne_braki_plus_20proc    -1.2    -1.7
2. Powtórzenia całego badania
R
# Krok 2. Czy wynik z kroku 1 to przypadek? 300 powtórzeń całego badania
# (wymaga funkcji generuj(), imputuj() i oszacuj() z kroku 1; M = 10 imputacji w każdym powtórzeniu)
jedno <- function() {
  d <- generuj(2000)
  d$lo <- ifelse(!is.na(d$kwota), d$kwota, ifelse(d$kaskada, pmax(d$dolna, 1), NA))
  d$hi <- ifelse(!is.na(d$kwota), d$kwota, ifelse(d$kaskada, d$gorna, NA))
  d$hi[is.infinite(d$hi)] <- NA
  m <- survreg(Surv(lo, hi, type = "interval2") ~ wyzsze + dorosli + dzieci + wiek + I((wiek - 50)^2),
               data = d[!is.na(d$lo), ], dist = "lognormal")
  w <- oszacuj(d, m, M = 10)
  c(100 * (w[-1, 1] / w[1, 1] - 1), 100 * (w[-1, 2] / w[1, 2] - 1), brak_kwoty = mean(d$powod != "kwota"))
}
set.seed(3662)
mc <- t(replicate(300, jedno()))
metody <- c("tylko_kwoty", "kwoty_i_srodki_przedzialow", "MI_bez_kaskady", "model_przedzialowy_MI", "MI_pelne_braki_plus_20proc")
colnames(mc) <- c(paste0("srednia.", metody), paste0("mediana.", metody), "brak_kwoty")
write.csv(round(mc, 3), "mc-kaskada.csv", row.names = FALSE)
podsum <- function(x) c(sredni_blad_proc = mean(x), SD = sd(x), blad_MC = sd(x) / sqrt(length(x)),
                        P5 = unname(quantile(x, .05)), P95 = unname(quantile(x, .95)))
print(round(t(apply(mc[, 1:10], 2, podsum)), 2))
round(c(sredni_odsetek_brakow_kwoty = mean(mc[, "brak_kwoty"])), 3)
Wynik w R
                                   sredni_blad_proc   SD blad_MC     P5   P95
srednia.tylko_kwoty                          -11.42 1.08    0.06 -13.15 -9.61
srednia.kwoty_i_srodki_przedzialow            -4.24 0.78    0.05  -5.52 -2.97
srednia.MI_bez_kaskady                        -9.04 1.07    0.06 -10.88 -7.27
srednia.model_przedzialowy_MI                 -3.87 0.85    0.05  -5.23 -2.54
srednia.MI_pelne_braki_plus_20proc            -1.61 0.87    0.05  -2.98 -0.19
mediana.tylko_kwoty                          -10.03 1.36    0.08 -12.35 -7.81
mediana.kwoty_i_srodki_przedzialow             3.53 1.39    0.08   1.48  5.86
mediana.MI_bez_kaskady                        -7.77 1.15    0.07  -9.71 -5.95
mediana.model_przedzialowy_MI                 -2.98 0.85    0.05  -4.36 -1.68
mediana.MI_pelne_braki_plus_20proc            -1.06 0.81    0.05  -2.27  0.23
sredni_odsetek_brakow_kwoty
                      0.318
3. Pytanie tylko w przedziałach
R
# Krok 3. Pytanie tylko w przedziałach (bez kwoty): punkty środkowe a model przedziałowy
# (wymaga generuj() z kroku 1; te same gospodarstwa d, tym razem wszyscy wybierają przedział)
granice7 <- c(0, 2000, 3000, 4000, 5000, 7000, 10000, Inf)  # 7 kategorii, górna otwarta od 10 000 zł
granice6 <- c(0, 2000, 3000, 4000, 5000, 7000, Inf)         # 6 kategorii, górna otwarta od 7000 zł

srodki <- function(gr, mnoznik) {                            # punkty środkowe; otwarta górna: mnożnik × dolna granica
  k <- length(gr) - 1
  c((gr[1:(k - 1)] + gr[2:k]) / 2, mnoznik * gr[k])
}
przedzialowo <- function(y, gr) {
  kat <- findInterval(y, gr)
  lo <- pmax(gr[kat], 1); hi <- gr[kat + 1]; hi[is.infinite(hi)] <- NA
  m <- survreg(Surv(lo, hi, type = "interval2") ~ 1, dist = "lognormal")
  mu <- coef(m)[[1]]; s <- m$scale
  wyn <- c(sapply(c(1.2, 1.5, 2), function(k) { x <- srodki(gr, k)[kat]; c(mean(x), median(x)) }),
           exp(mu + s^2 / 2), exp(mu))
  matrix(wyn, nrow = 2, dimnames = list(c("srednia", "mediana"),
         c("srodki_gora_1.2x", "srodki_gora_1.5x", "srodki_gora_2x", "model_lognormalny")))
}
y <- d$dochod
cat("Odsetek w górnej, otwartej kategorii:", round(100 * c(od_10000 = mean(y >= 10000), od_7000 = mean(y >= 7000)), 1), "\n")
round(c(prawdziwa_srednia = mean(y), prawdziwa_mediana = median(y)))
round(przedzialowo(y, granice7)); round(przedzialowo(y, granice6))

# Prawdziwa średnia w każdej kategorii a punkt środkowy (do rysunku 1)
kat <- findInterval(y, granice7)
tab <- data.frame(kategoria = 1:7, od = granice7[1:7], do = granice7[2:8], n = tabulate(kat, 7),
                  srodek = srodki(granice7, 1.5), srednia_w_kategorii = round(tapply(y, kat, mean)))
print(tab)
write.csv(tab, "kategorie-7.csv", row.names = FALSE)
write.csv(data.frame(dochod = round(y)), "dochod-prawdziwy.csv", row.names = FALSE)

# 300 powtórzeń: błąd średniej (%) przy różnych sposobach liczenia i dwóch układach kategorii
set.seed(3663)
mc3 <- t(replicate(300, { y <- generuj(2000)$dochod
  c(100 * (przedzialowo(y, granice7)["srednia", ] / mean(y) - 1), 100 * (przedzialowo(y, granice6)["srednia", ] / mean(y) - 1)) }))
colnames(mc3) <- c(paste0("gora10000.", c("1.2x", "1.5x", "2x", "model")), paste0("gora7000.", c("1.2x", "1.5x", "2x", "model")))
write.csv(round(mc3, 3), "mc-przedzialy.csv", row.names = FALSE)
round(rbind(sredni_blad_proc = colMeans(mc3), SD = apply(mc3, 2, sd)), 2)
Wynik w R
Odsetek w górnej, otwartej kategorii: 25.4 46.8
prawdziwa_srednia prawdziwa_mediana
             8006              6673
        srodki_gora_1.2x srodki_gora_1.5x srodki_gora_2x model_lognormalny
srednia             7226             7987           9254              8029
mediana             6000             6000           6000              6644
        srodki_gora_1.2x srodki_gora_1.5x srodki_gora_2x model_lognormalny
srednia             6292             7275           8913              8041
mediana             6000             6000           6000              6650
  kategoria    od    do   n srodek srednia_w_kategorii
1         1     0  2000  53   1000                1571
2         2  2000  3000 137   2500                2530
3         3  3000  4000 214   3500                3495
4         4  4000  5000 255   4500                4469
5         5  5000  7000 405   6000                5979
6         6  7000 10000 429   8500                8354
7         7 10000   Inf 507  15000               15166
                 gora10000.1.2x gora10000.1.5x gora10000.2x gora10000.model gora7000.1.2x gora7000.1.5x
sredni_blad_proc         -10.03          -0.53        15.31            0.00        -21.70         -9.48
SD                         0.79           0.83         1.04            1.06          0.85          0.94
                 gora7000.2x gora7000.model
sredni_blad_proc       10.90          -0.03
SD                      1.16           1.82
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 z pakietami survival (model survreg() dla danych cenzurowanych przedziałowo), truncnorm (losowanie z rozkładu uciętego) i MASS (losowanie parametrów modelu); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- truncnorm (wersja 1.0.9): Mersmann, O., Trautmann, H., Steuer, D., & Bornkamp, B. (2023). truncnorm: Truncated normal distribution (R package version 1.0.9) [Computer software]. https://doi.org/10.32614/CRAN.package.truncnorm
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Pytanie bez definicji. „Dochód” bez określenia, czyj, netto czy brutto i za jaki okres, daje odpowiedzi, których nie da się porównać.
- Dochód na osobę zamiast ekwiwalentnego. Dzielenie przez liczbę osób zaniża pozycję dużych gospodarstw. Do porównań użyj skali ekwiwalentności.
- Analiza tylko podanych kwot. Odmawiają częściej osoby zamożniejsze, więc średnia i mediana są zaniżone. W przykładzie o około 10–11%.
- Brak kaskady. Nawet dobra imputacja z kowariantów nie zastąpi kilku pytań tak/nie o przedział.
- Środki przedziałów z arbitralną wartością dla otwartej kategorii. Wynik zależy od mnożnika bardziej niż od danych.
- Wymuszanie odpowiedzi. Obowiązkowe pytanie o dochód zamienia odmowy w odpowiedzi przypadkowe albo w przerwania ankiety.
- „Nie wiem” i odmowa w jednym kodzie. To różne zachowania i różne grupy osób. Zapisz je osobno.
Najczęstsze pytania
Jak zapytać o dochód w ankiecie, żeby ludzie odpowiadali?
Zdefiniuj w pytaniu, o czyj dochód chodzi (osobisty czy gospodarstwa), czy netto, za jaki okres i jakie składniki wliczyć. Zapytaj najpierw o kwotę, a osobom, które jej nie podadzą, zadaj kaskadę dwóch–trzech pytań o przedział. Postaw pytanie pod koniec ankiety i nie rób go obowiązkowym.
Czy lepiej pytać o dochód w przedziałach czy o dokładną kwotę?
Kwota daje pełną informację, ale więcej odmów i zaokrągleń. Same przedziały tracą informację, zwłaszcza w otwartej górnej kategorii. Dobrym kompromisem jest kwota z kaskadą przedziałów dla osób, które kwoty nie podały: w przykładzie zmniejszyła ona zaniżenie średniej z 11% do 4%.
Jak policzyć średni dochód z danych w przedziałach?
Nie przypisuj punktów środkowych, bo wynik zależy od wartości wybranej dla otwartej kategorii: w symulacji mnożnik 1.2, 1.5 albo 2 dawał błąd od −10% do +15%. Dopasuj model przedziałowy, np. log-normalny w survival::survreg z Surv(type = "interval2"), i policz średnią oraz medianę z parametrów albo z imputacji. Sprawdź dopasowanie rozkładu.
Czy braki w pytaniu o dochód są losowe?
Zwykle nie. Odmowy są częstsze przy wysokich dochodach, więc brak zależy od wartości, której nie znamy (MNAR). Imputacja z kowariantów zakłada MAR i usuwa tylko część obciążenia. Dlatego zbieraj przedziały od osób bez kwoty i pokaż analizę wrażliwości z przesunięciem imputowanych wartości.
Co to jest dochód ekwiwalentny według skali OECD?
To dochód gospodarstwa podzielony przez liczbę jednostek ekwiwalentnych: 1 dla pierwszej osoby dorosłej, 0.5 dla każdej kolejnej osoby w wieku 14 lat i więcej i 0.3 dla każdego dziecka poniżej 14 lat. Pozwala porównywać gospodarstwa różnej wielkości lepiej niż dochód na osobę, bo uwzględnia wspólne koszty.
Powiązane hasła
Przeczytaj też
Braki danych w ankiecie – co zrobić?
Jak policzyć braki, kiedy wystarczy reguła proporcjonalna, jak sprawdzić osoby, które przerwały ankietę, i jak opisać braki w pracy.
Czytaj →PoradnikBraki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikPytania drażliwe: lista i RRT
Eksperyment listowy i randomizowane odpowiedzi w R: projekt listy, test błędu projektu, regresja z kowariantami i próg opłacalności metody pośredniej.
Czytaj →Masz w danych dochód z brakami i przedziałami?
Pomożemy zaprojektować pytanie z kaskadą, dopasować model przedziałowy i imputację, przygotować analizę wrażliwości oraz opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Hariri, J. G., & Lassen, D. D. (2017). Income and outcomes: Social desirability bias distorts measurements of the relationship between income and political behavior. Public Opinion Quarterly, 81(2), 564–576. https://doi.org/10.1093/poq/nfw044
- Heitjan, D. F., & Rubin, D. B. (1991). Ignorability and coarse data. The Annals of Statistics, 19(4), 2244–2253. https://doi.org/10.1214/aos/1176348396 ● Otwarty dostęp
- Hurd, M., Juster, F. T., & Smith, J. P. (2003). Enhancing the quality of data on income: Recent innovations from the HRS. Journal of Human Resources, XXXVIII(3), 758–772. https://doi.org/10.3368/jhr.xxxviii.3.758
- Juster, F. T., & Smith, J. P. (1997). Improving the quality of economic data: Lessons from the HRS and AHEAD. Journal of the American Statistical Association, 92(440), 1268–1278. https://doi.org/10.1080/01621459.1997.10473648
- Riphahn, R. T., & Serfling, O. (2005). Item non-response on income and wealth questions. Empirical Economics, 30(2), 521–538. https://doi.org/10.1007/s00181-005-0247-7 ● Otwarty dostęp: pełny tekst
- Schräpler, J.-P. (2004). Respondent behavior in panel studies: A case study for income nonresponse by means of the German Socio-Economic Panel (SOEP). Sociological Methods & Research, 33(1), 118–156. https://doi.org/10.1177/0049124103262689
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
- van Buuren, S. (2018). Flexible imputation of missing data (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9780429492259 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hariri2017income, author={Hariri, Jacob Gerner and Lassen, David Dreyer}, title={{Income and outcomes: Social desirability bias distorts measurements of the relationship between income and political behavior}}, journal={Public Opinion Quarterly}, year={2017}, volume={81}, number={2}, pages={564--576}, doi={10.1093/poq/nfw044}}@article{heitjan1991ignorability, author={Heitjan, Daniel F. and Rubin, Donald B.}, title={{Ignorability and coarse data}}, journal={The Annals of Statistics}, year={1991}, volume={19}, number={4}, pages={2244--2253}, doi={10.1214/aos/1176348396}}@article{hurd2003enhancing, author={Hurd, Michael and Juster, F. Thomas and Smith, James P.}, title={{Enhancing the quality of data on income: Recent innovations from the HRS}}, journal={Journal of Human Resources}, year={2003}, volume={XXXVIII}, number={3}, pages={758--772}, doi={10.3368/jhr.xxxviii.3.758}}@article{juster1997improving, author={Juster, F. Thomas and Smith, James P.}, title={{Improving the quality of economic data: Lessons from the HRS and AHEAD}}, journal={Journal of the American Statistical Association}, year={1997}, volume={92}, number={440}, pages={1268--1278}, doi={10.1080/01621459.1997.10473648}}@article{riphahn2005item, author={Riphahn, Regina T. and Serfling, Oliver}, title={{Item non-response on income and wealth questions}}, journal={Empirical Economics}, year={2005}, volume={30}, number={2}, pages={521--538}, doi={10.1007/s00181-005-0247-7}}@article{schrapler2004respondent, author={Schräpler, Jörg-Peter}, title={{Respondent behavior in panel studies: A case study for income nonresponse by means of the German Socio-Economic Panel (SOEP)}}, journal={Sociological Methods \& Research}, year={2004}, volume={33}, number={1}, pages={118--156}, doi={10.1177/0049124103262689}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}@book{vanbuuren2018flexible, author={van Buuren, Stef}, title={{Flexible imputation of missing data (2nd ed.)}}, year={2018}, publisher={Chapman \& Hall/CRC}, doi={10.1201/9780429492259}}