Co to jest analiza punktu krytycznego?
Analiza punktu krytycznego (ang. tipping point analysis) to analiza wrażliwości na braki danych typu MNAR. Sprawdza się coraz bardziej pesymistyczne założenia o brakach i szuka tego, przy którym wniosek się zmienia, np. efekt przestaje być istotny – to punkt krytyczny. Metoda należy do rodziny analiz wrażliwości i jest typowa dla badań z utratą uczestników.
Model mieszanin wzorców i przesunięcie δ
Little (1993) opisał modele mieszanin wzorców (ang. pattern-mixture models): rozkład wyniku określa się osobno dla osób z wynikiem i bez niego. Dane nic nie mówią o wyniku osób bez wyniku, więc potrzebne jest dodatkowe ograniczenie. Najprostsze to przesunięcie δ (δ-adjustment): wartości z imputacji wielokrotnej przy założeniu MAR przesuwa się o δ – brakujący mają wynik o δ gorszy (albo lepszy), niż przewiduje model. Cro i in. (2020) opisują tę procedurę i wybór δ w badaniach klinicznych. Alternatywą jest model selekcji, np. model Heckmana.
Jak szukać punktu krytycznego
- Imputuj dane przy MAR (δ = 0) – to analiza główna.
- Powtórz imputację dla siatki δ, zwykle tylko w grupie interwencji.
- Połącz wyniki regułami Rubina i znajdź najmniejsze δ, przy którym przedział ufności obejmuje 0.
- Oceń wiarygodność tego δ, np. względem SD wyniku lub minimalnej istotnej różnicy.
Przykład
W badaniu 200 osób (niższy wynik = lepiej) wyniku końcowego brakowało u 15% osób z grupy kontrolnej i 19% z grupy interwencji (dane symulowane). Przy MAR efekt interwencji wyniósł b = −4.97 pkt, 95% CI [−7.62, −2.32]. Przy δ = 10 efekt był jeszcze istotny (p = .044), przy δ = 12 już nie (p = .091). Interpolacja daje punkt krytyczny δ ≈ 10.3 pkt, czyli około 1.2 SD reszt (8.36).
Na rysunku
Rysunek używa tych samych danych i tej samej imputacji (m = 30) co przykład. Zamiast powtarzać imputację dla każdego δ, przesuwamy wartości już imputowane. Braki ma tu tylko wynik końcowy, więc daje to te same liczby co przesunięcie wewnątrz mice: przy δ = 10 znów b = −2.827, p = .044. Panel A ma siatkę co 0.5 pkt, a panel B dodaje drugie założenie: δ także w grupie kontrolnej, od −8 (brakujący lepsi, niż przewiduje MAR) do 8 pkt.
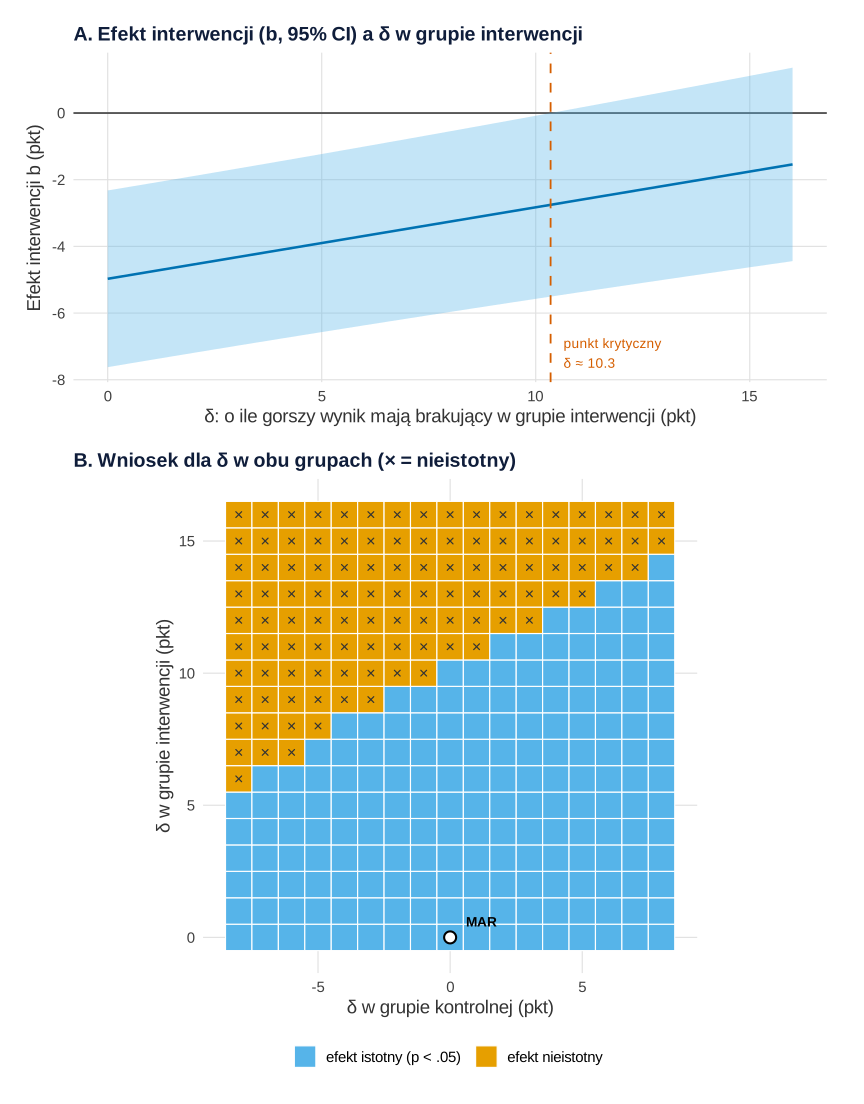
set.seed(7160), imputacja z seed = 716).Co widać. W panelu A efekt słabnie liniowo wraz z δ, a przedział ufności przesuwa się razem z nim. Górna granica CI dotyka zera przy δ ≈ 10.35 pkt, prawie tak jak w przykładzie (10.34). Panel B pokazuje, że punkt krytyczny zależy od założenia o grupie kontrolnej. Gdy brakujący w kontroli mają wynik o 8 pkt lepszy, niż przewiduje MAR, wniosek zmienia się już przy δ = 6 w grupie interwencji. Gdy mają o 8 pkt gorszy, dopiero przy δ = 15. Efekt jest istotny w 62.6% komórek siatki.
Na co uważać. Odsetek istotnych komórek zależy wyłącznie od zakresu siatki, który wybrano ręcznie, więc nie jest miarą „odporności” wyniku. Rysunek nie mówi, które δ jest prawdopodobne. To trzeba uzasadnić merytorycznie, np. znaną różnicą między osobami, które odpadły, a pozostałymi. Mapa pokazuje tylko granicę istotności przy p = .05, a nie wielkość efektu. Do odczytu wartości w całej siatce lepiej nadają się linie konturowe, jak w wykresie konturowym.
Podpis do pracy:
Kod rysunku liczy też liczby podane wyżej (wykonanie trwa kilkanaście sekund). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Punkt krytyczny: efekt z 95% CI w funkcji δ (A) i siatka δ w obu grupach (B)
suppressPackageStartupMessages(library(mice))
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie z hasła
set.seed(7160)
n <- 200
grupa <- rep(0:1, each = n / 2)
przed <- rnorm(n, 50, 10)
po <- 20 + 0.6 * przed - 3 * grupa + rnorm(n, 0, 8)  # niższy wynik = lepiej
p_brak <- plogis(-2 + 0.05 * (przed - 50) + 0.6 * grupa)
po[runif(n) < p_brak] <- NA
dane <- data.frame(grupa, przed, po)
brak <- is.na(dane$po)

# Jedna imputacja przy MAR; δ dodajemy potem do wartości imputowanych
# (tu tylko „po” ma braki, więc daje to te same wyniki co przesunięcie w mice przez post)
imp <- mice(dane, m = 30, method = "norm", seed = 716, printFlag = FALSE)
zbiory <- lapply(1:30, function(i) complete(imp, i))
analiza <- function(d_kontr, d_interw) {
  modele <- lapply(zbiory, function(d) {
    d$po[brak] <- d$po[brak] + ifelse(d$grupa[brak] == 1, d_interw, d_kontr)
    lm(po ~ grupa + przed, data = d)
  })
  s <- summary(pool(as.mira(modele)), conf.int = TRUE)
  s <- s[s$term == "grupa", ]
  c(b = s$estimate, dolna = s$`2.5 %`, gorna = s$`97.5 %`, p = s$p.value)
}

# A. δ tylko w grupie interwencji (jak w przykładzie), siatka co 0.5 pkt
A <- data.frame(delta = seq(0, 16, by = 0.5))
A <- cbind(A, t(sapply(A$delta, function(d) analiza(0, d))))
print(round(A[A$delta %in% c(0, 10, 12), ], 3), row.names = FALSE)
pk <- approx(A$gorna, A$delta, xout = 0)$y             # punkt krytyczny: górna granica CI = 0
round(pk, 2)

# B. δ w obu grupach: kontrola od −8 (brakujący lepsi) do 8, interwencja 0–16, co 1 pkt
B <- expand.grid(d_kontr = -8:8, d_interw = 0:16)
B$p <- mapply(function(a, b) analiza(a, b)["p"], B$d_kontr, B$d_interw)
B$wniosek <- factor(ifelse(B$p < .05, "efekt istotny (p < .05)", "efekt nieistotny"),
                    levels = c("efekt istotny (p < .05)", "efekt nieistotny"))
round(100 * mean(B$p < .05), 1)                        # % komórek siatki z efektem istotnym
# punkt krytyczny δ interwencji przy kilku δ w grupie kontrolnej (pierwsza komórka z p ≥ .05)
sapply(c(-8, -4, 0, 4, 8), function(k) { d <- B$d_interw[B$d_kontr == k & B$p >= .05]; if (length(d)) min(d) else NA })

pA <- ggplot(A, aes(delta, b)) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_ribbon(aes(ymin = dolna, ymax = gorna), fill = "#56B4E9", alpha = 0.35) +
  geom_line(linewidth = 0.9, colour = "#0072B2") +
  geom_vline(xintercept = pk, linetype = "dashed", colour = "#D55E00") +
  annotate("text", x = pk + 0.3, y = -7.2, label = paste0("punkt krytyczny\nδ ≈ ", round(pk, 1)),
           hjust = 0, size = 3.6, colour = "#D55E00") +
  labs(title = "A. Efekt interwencji (b, 95% CI) a δ w grupie interwencji",
       x = "δ: o ile gorszy wynik mają brakujący w grupie interwencji (pkt)", y = "Efekt interwencji b (pkt)") +
  motyw

pB <- ggplot(B, aes(d_kontr, d_interw)) +
  geom_tile(aes(fill = wniosek), colour = "white", linewidth = 0.4) +
  geom_point(data = subset(B, p >= .05), shape = 4, size = 1.6, colour = "grey20") +
  annotate("point", x = 0, y = 0, shape = 21, size = 3.5, fill = "white", stroke = 1.1) +
  annotate("text", x = 0.6, y = 0.6, label = "MAR", hjust = 0, size = 3.6, fontface = "bold") +
  scale_fill_manual(values = c("#56B4E9", "#E69F00"), name = NULL) +
  coord_equal() +
  labs(title = "B. Wniosek dla δ w obu grupach (× = nieistotny)",
       x = "δ w grupie kontrolnej (pkt)", y = "δ w grupie interwencji (pkt)") +
  motyw

p <- pA / pB + plot_layout(heights = c(1, 1.5))
p
Wynik w R
 delta      b  dolna  gorna     p
     0 -4.972 -7.622 -2.322 0.000
    10 -2.827 -5.573 -0.082 0.044
    12 -2.399 -5.189  0.392 0.091
[1] 10.35
[1] 62.6
[1]  6  9 11 13 15
Jak opisać w pracy
Na co uważać
- δ to założenie, nie oszacowanie. Dane nie rozstrzygną, które δ jest prawdziwe.
- Zaplanuj siatkę z góry. Zakres δ opisz w planie analiz, jak we wpisie plan analiz do wniosku grantowego.
Imputację w mice omawia wpis Braki danych i imputacja wielokrotna w R, a miejsce tej analizy w artykule – Analiza wrażliwości w artykule naukowym.
Punkt krytyczny w R
Kod symuluje badanie z brakami, imputuje dane w mice z przesunięciem δ w grupie interwencji (argument post), łączy wyniki regułami Rubina dla siatki δ i wyznacza punkt krytyczny. Liczby w tekście pochodzą z tego kodu.
Siatka δ i punkt krytyczny
R
set.seed(7160)
suppressPackageStartupMessages(library(mice))
n <- 200                                             # badanie z dwiema grupami (dane symulowane)
grupa <- rep(0:1, each = n / 2)
przed <- rnorm(n, 50, 10)
po <- 20 + 0.6 * przed - 3 * grupa + rnorm(n, 0, 8)  # niższy wynik = lepiej (np. objawy)
p_brak <- plogis(-2 + 0.05 * (przed - 50) + 0.6 * grupa)
po[runif(n) < p_brak] <- NA
dane <- data.frame(grupa, przed, po)
round(100 * tapply(is.na(dane$po), dane$grupa, mean), 1)   # % braków: kontrola, interwencja
analiza <- function(delta, m = 30) {
  post <- make.post(dane)
  # δ dodawane tylko w grupie interwencji: brakujący mają wynik o δ gorszy niż przewiduje MAR
  post["po"] <- paste0("imp[[j]][, i] <- imp[[j]][, i] + ", delta,
                       " * data$grupa[!r[, j]]")
  imp <- mice(dane, m = m, method = "norm", post = post, seed = 716, printFlag = FALSE)
  s <- summary(pool(with(imp, lm(po ~ grupa + przed))), conf.int = TRUE)
  s <- s[s$term == "grupa", ]
  c(delta = delta, b = s$estimate, CI_dolna = s$`2.5 %`, CI_gorna = s$`97.5 %`, p = s$p.value)
}
siatka <- t(sapply(seq(0, 16, by = 2), analiza))    # δ = 0 to analiza przy założeniu MAR
print(round(siatka, 3))
round(sigma(lm(po ~ grupa + przed, data = dane)), 2)   # SD reszt (skala do oceny δ)
# punkt krytyczny: najmniejsze δ z siatki, przy którym p > .05
siatka[which(siatka[, "p"] > .05)[1], "delta"]
# dokładniej: interpolacja liniowa górnej granicy CI między sąsiednimi δ
approx(siatka[, "CI_gorna"], siatka[, "delta"], xout = 0)$y
Wynik w R
 0  1
15 19
      delta      b CI_dolna CI_gorna     p
 [1,]     0 -4.972   -7.622   -2.322 0.000
 [2,]     2 -4.543   -7.195   -1.891 0.001
 [3,]     4 -4.114   -6.776   -1.452 0.003
 [4,]     6 -3.685   -6.367   -1.004 0.007
 [5,]     8 -3.256   -5.966   -0.547 0.019
 [6,]    10 -2.827   -5.573   -0.082 0.044
 [7,]    12 -2.399   -5.189    0.392 0.091
 [8,]    14 -1.970   -4.812    0.872 0.173
 [9,]    16 -1.541   -4.442    1.361 0.296
[1] 8.36
delta
   12
[1] 10.34491
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet mice). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mice (wersja 3.19.0): van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym analiza punktu krytycznego różni się od zwykłej analizy wrażliwości?
Zwykła analiza wrażliwości sprawdza kilka wybranych scenariuszy. Analiza punktu krytycznego odwraca pytanie: jak duże odstępstwo od MAR zmieniłoby wniosek. Wynikiem jest jedna wartość δ, którą łatwo ocenić merytorycznie.
Jak dobrać zakres δ?
Od 0 do wartości wyraźnie nieprawdopodobnej, np. 1–2 SD wyniku albo kilku minimalnych istotnych różnic, z krokiem pozwalającym zobaczyć zmianę wniosku. W przykładzie siatka obejmowała 0–16 pkt co 2 pkt przy SD reszt 8.36.
Jak zrobić δ-adjustment w pakiecie mice?
Przez argument post: post["y"] <- "imp[[j]][, i] <- imp[[j]][, i] + delta". Aby przesunąć wartości tylko w jednej grupie, pomnóż δ przez wskaźnik grupy dla imputowanych wierszy, jak w przykładzie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Braki danych i imputacja wielokrotna w R
MCAR, MAR i MNAR, test Little’a, symulacja metod i imputacja wielokrotna w R krok po kroku – z kodem, regułami Rubina i gotowym opisem APA.
Czytaj →PoradnikAnaliza wrażliwości w artykule naukowym
Jak dobrać warianty, policzyć je w R (braki danych, obserwacje odstające, specyfikacje), zbudować krzywą specyfikacji i opisać wyniki w artykule.
Czytaj →PoradnikPlan analiz do wniosku grantowego
Hipotezy przypisane do modeli, symulacja mocy przy randomizacji klas, braki danych, analiza wrażliwości δ, tabela ryzyk i wzór tekstu do metodyki.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cro, S., Morris, T. P., Kenward, M. G., & Carpenter, J. R. (2020). Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: A practical guide. Statistics in Medicine, 39(21), 2815–2842. https://doi.org/10.1002/sim.8569 ● Otwarty dostęp
- Little, R. J. A. (1993). Pattern-mixture models for multivariate incomplete data. Journal of the American Statistical Association, 88(421), 125–134. https://doi.org/10.1080/01621459.1993.10594302
Cytowania BibTeX
@article{cro2020sensitivity, author={Cro, Suzie and Morris, Tim P. and Kenward, Michael G. and Carpenter, James R.}, title={{Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: A practical guide}}, journal={Statistics in Medicine}, year={2020}, volume={39}, number={21}, pages={2815--2842}, doi={10.1002/sim.8569}}@article{little1993pattern, author={Little, Roderick J. A.}, title={{Pattern-mixture models for multivariate incomplete data}}, journal={Journal of the American Statistical Association}, year={1993}, volume={88}, number={421}, pages={125--134}, doi={10.1080/01621459.1993.10594302}}