Co to jest wykres konturowy i powierzchnia odpowiedzi?
Powierzchnia odpowiedzi (ang. response surface) to przewidywana wartość zmiennej zależnej dla każdej kombinacji dwóch predyktorów ciągłych – „teren” rozpięty nad płaszczyzną X × Z. Wykres konturowy (ang. contour plot) pokazuje ten teren z góry, jak mapa poziomicowa: każda linia (poziomica, kontur) łączy punkty o tym samym przewidywanym wyniku, a wypełnienie między liniami oznacza przedział wartości. W psychologii taki wykres pokazuje najczęściej interakcję dwóch zmiennych ciągłych (moderację), a w badaniach dopasowania – model wielomianowy, opisany we wpisie Analiza powierzchni odpowiedzi (RSA).
Jak czytać wykres
- Równoległe, równo rozstawione proste poziomice oznaczają model bez interakcji: krok w prawo zmienia wynik o tyle samo przy każdej wartości drugiej zmiennej.
- Poziomice rozchodzące się wachlarzem oznaczają interakcję. Tam, gdzie leżą gęsto, wynik zmienia się szybko; tam, gdzie rzadko – wolno.
- Zakrzywione albo zamknięte poziomice wskazują na człony kwadratowe i maksimum lub minimum powierzchni.
- Poziomy przekrój mapy przy wybranej wartości moderatora to jedna z prostych nachyleń, czyli jedna linia klasycznego wykresu interakcji.
Przykład
W danych symulowanych 300 studentów ma wynik testu zdolności (M = 100, SD = 15), motywację na skali 1–7 i wynik egzaminu. Model regresji wielorakiej z iloczynem pokazuje istotną interakcję, b = 0.098, SE = 0.025, t(296) = 3.88, p < .001. Nachylenie zdolności wynosi 0.225 przy motywacji o 1 SD poniżej średniej (2.68), 0.339 przy średniej (3.84) i 0.453 przy motywacji o 1 SD powyżej średniej (5.00). Przewidywania na siatce mówią więcej: przy motywacji 1 przewidywany wynik egzaminu rośnie od 37.9 do 42.6 punktu między zdolnościami 60 i 140, a przy motywacji 7 – od 35.2 do 87.1. Współczynniki symulacji ustawiono ręcznie tak, by wachlarz był wyraźny; ziarna 747 nie zmieniano.
Na rysunku
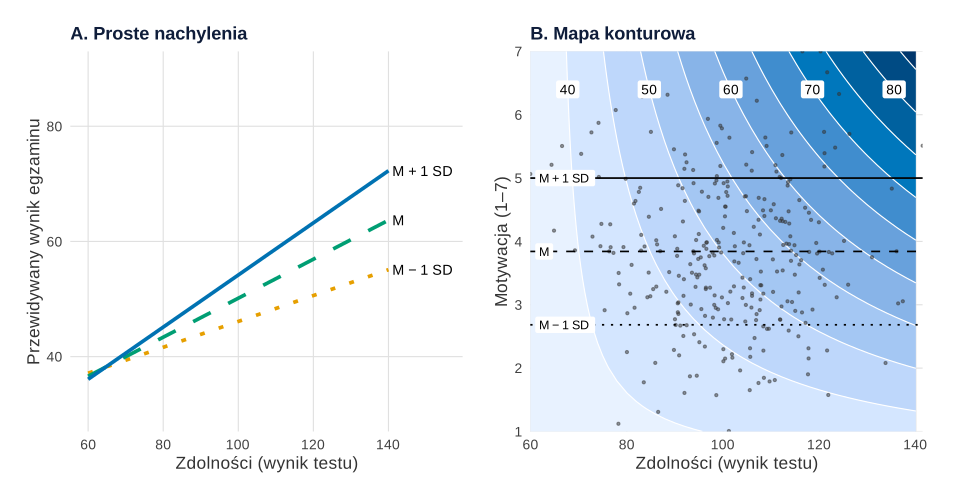
set.seed(747)).Co widać. Panel A to trzy proste nachylenia. Panel B pokazuje cały model: trzy poziome linie na mapie to dokładnie te same trzy proste, widziane z góry. Między nimi i poza nimi mapa pokazuje, jak nachylenie zmienia się płynnie. U góry mapy poziomice leżą gęsto, więc każdy krok w prawo wyraźnie podnosi wynik. U dołu leżą rzadko: przy motywacji 1 cały zakres zdolności zmienia przewidywanie o mniej niż 5 punktów. Etykiety poziomic i jeden odcień barwy sprawiają, że wykres da się czytać także w druku czarno-białym.
Na co uważać. Mapa barwi także rogi, w których nie ma danych. Osób ze zdolnościami poniżej 75 lub powyżej 125 i jednocześnie z motywacją poniżej 2 lub powyżej 6 jest w próbie łącznie jedna. Tam kolory to ekstrapolacja modelu, który wymusza liniową zmianę efektu; Hainmueller i in. (2019) pokazują, że takie oszacowania bywają mylące przy braku danych. Dlatego nanieś na mapę punkty obserwacji. Mapa nie pokazuje też niepewności – McCabe i in. (2018) zwracają uwagę, że wykresy interakcji często pomijają niepewność i dane. Przedziały dla nachyleń daje przedział Johnsona–Neymana (Preacher i in., 2006). Mapę z interakcją i bez niej porównuje wpis Moderacja – wizualizacja na obrazkach.
Podpis do pracy:
Kod rysunku i obliczeń z przykładu znajdziesz w sekcji Wykres konturowy w R.
Jak opisać w pracy
Na co uważać
- Nie interpretuj rogów bez danych. Ogranicz siatkę do zakresu obserwacji albo zaznacz go na mapie.
- Unikaj palety tęczowej. Wiele barw sugeruje granice, których w modelu nie ma; jeden odcień i etykiety poziomic wystarczą.
- Uważaj z wykresem 3D w pracy. Perspektywa zasłania część powierzchni i utrudnia odczyt wartości; mapa z góry jest czytelniejsza.
- Mapa pokazuje model, nie dane. Model z samym iloczynem zawsze da wachlarz prostych poziomic, bo tak wynika z równania. Krzywizny nie zobaczysz, jeśli nie ma jej w modelu.
Wykres konturowy w R
Pierwszy przepis dopasowuje model z interakcją, liczy proste nachylenia z błędami standardowymi i siatkę przewidywań, z której powstaje mapa. Drugi rysuje Rysunek 1; jest samowystarczalny (paleta Okabe–Ito, jednobarwna skala z pakietu colorspace i motyw zdefiniowane w kodzie). Oba zaczynają się od tego samego set.seed(747), więc skopiowane osobno dają te same liczby co na stronie. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Model z interakcją, proste nachylenia i siatka przewidywań
R
set.seed(747)                                         # te same dane co na rysunku 1
n <- 300
zdolnosci <- rnorm(n, 100, 15)
motywacja <- pmin(pmax(rnorm(n, 4, 1.2), 1), 7)
egzamin <- 50 + 0.3 * (zdolnosci - 100) + 3 * (motywacja - 4) +
  0.12 * (zdolnosci - 100) * (motywacja - 4) + rnorm(n, sd = 8)
m <- lm(egzamin ~ zdolnosci * motywacja)
round(summary(m)$coefficients, 3)
# nachylenie zdolności przy wybranej motywacji: b1 + b3 * motywacja (z błędem standardowym)
b <- coef(m); V <- vcov(m)
w <- mean(motywacja) + c(-1, 0, 1) * sd(motywacja)
nach <- b[2] + b[4] * w
se <- sqrt(V[2, 2] + w^2 * V[4, 4] + 2 * w * V[2, 4])
data.frame(motywacja = round(w, 2), nachylenie = round(nach, 3), SE = round(se, 3),
           t = round(nach / se, 2), p = signif(2 * pt(-abs(nach / se), df.residual(m)), 3))
# siatka przewidywań – z niej powstaje mapa konturowa
siatka <- expand.grid(zdolnosci = seq(60, 140, by = 20), motywacja = c(1, 4, 7))
siatka$przewidywany <- round(predict(m, siatka), 1)
xtabs(przewidywany ~ motywacja + zdolnosci, siatka)
Wynik w R
                    Estimate Std. Error t value Pr(>|t|)
(Intercept)           40.739     11.294   3.607    0.000
zdolnosci             -0.040      0.109  -0.363    0.717
motywacja             -6.365      2.627  -2.423    0.016
zdolnosci:motywacja    0.098      0.025   3.880    0.000
  motywacja nachylenie    SE     t        p
1      2.68      0.225 0.048  4.69 4.23e-06
2      3.84      0.339 0.031 10.78 4.53e-23
3      5.00      0.453 0.037 12.07 1.50e-27
         zdolnosci
motywacja   60   80  100  120  140
        1 37.9 39.1 40.3 41.4 42.6
        4 36.5 43.6 50.7 57.8 64.9
        7 35.2 48.1 61.1 74.1 87.1
Kod rysunku 1
Kod R rysunku 1
# Rysunek 1. Ten sam model z interakcją: proste nachylenia (A) i mapa konturowa przewidywań (B)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(colorspace)})
kol <- c(nisko = "#E69F00", srednio = "#009E73", wysoko = "#0072B2")   # Okabe–Ito + różne linie
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(747)                                         # 300 studentów: zdolności, motywacja, egzamin
n <- 300
zdolnosci <- rnorm(n, 100, 15)
motywacja <- pmin(pmax(rnorm(n, 4, 1.2), 1), 7)
egzamin <- 50 + 0.3 * (zdolnosci - 100) + 3 * (motywacja - 4) +
  0.12 * (zdolnosci - 100) * (motywacja - 4) + rnorm(n, sd = 8)
m <- lm(egzamin ~ zdolnosci * motywacja)
poziomy <- mean(motywacja) + c(-1, 0, 1) * sd(motywacja)               # M − 1 SD, M, M + 1 SD
nazwy <- c("M − 1 SD", "M", "M + 1 SD")
# A. Proste nachylenia: przewidywania dla trzech wartości motywacji
linie <- expand.grid(zdolnosci = seq(60, 140, 2), motywacja = poziomy)
linie$egzamin <- predict(m, linie)
linie$poziom <- factor(rep(nazwy, each = 41), levels = nazwy)
pA <- ggplot(linie, aes(zdolnosci, egzamin, colour = poziom, linetype = poziom)) +
  geom_line(linewidth = 1.3) +
  annotate("text", x = 141, y = predict(m, data.frame(zdolnosci = 140, motywacja = poziomy)),
           label = nazwy, hjust = 0, size = 3.8) +
  scale_colour_manual(values = unname(kol), guide = "none") +
  scale_linetype_manual(values = c("dotted", "dashed", "solid"), guide = "none") +
  coord_cartesian(xlim = c(60, 155), ylim = c(30, 90), clip = "off") +
  labs(title = "A. Proste nachylenia", x = "Zdolności (wynik testu)", y = "Przewidywany wynik egzaminu")
# B. Mapa konturowa: przewidywania na siatce zdolności × motywacja
siatka <- expand.grid(zdolnosci = seq(60, 140, length.out = 41), motywacja = seq(1, 7, length.out = 31))
siatka$egzamin <- predict(m, siatka)
progi <- seq(30, 90, 5)
etyk <- data.frame(egzamin = seq(40, 80, 10), motywacja = 6.4)        # etykiety poziomic przy motywacji 6.4
b <- coef(m)
etyk$zdolnosci <- (etyk$egzamin - b[1] - b[3] * etyk$motywacja) / (b[2] + b[4] * etyk$motywacja)
etyk <- subset(etyk, zdolnosci > 62 & zdolnosci < 138)
pB <- ggplot(siatka, aes(zdolnosci, motywacja)) +
  geom_contour_filled(aes(z = egzamin), breaks = progi, show.legend = FALSE) +
  geom_contour(aes(z = egzamin), breaks = progi, colour = "white", linewidth = 0.4) +
  scale_fill_manual(values = rev(sequential_hcl(length(progi) - 1, "Blues 3")), drop = FALSE) +
  geom_point(data = data.frame(zdolnosci, motywacja), colour = "grey20", size = 0.7, alpha = 0.5) +
  geom_hline(yintercept = poziomy, linetype = c("dotted", "dashed", "solid"), colour = "black") +
  annotate("label", x = 61, y = poziomy, label = nazwy, hjust = 0, size = 3.3, border.colour = NA) +
  geom_label(data = etyk, aes(label = egzamin), size = 3.6, border.colour = NA, fill = "white") +
  coord_cartesian(expand = FALSE) +
  labs(title = "B. Mapa konturowa", x = "Zdolności (wynik testu)", y = "Motywacja (1–7)")
p1 <- (pA + pB) & motyw
round(c(motywacja_M = mean(motywacja), motywacja_SD = sd(motywacja)), 2)
table(zdolnosci = cut(zdolnosci, c(-Inf, 75, 125, Inf), labels = c("<75", "75-125", ">125")),
      motywacja = cut(motywacja, c(-Inf, 2, 6, Inf), labels = c("<2", "2-6", ">6")))   # ile osób w rogach mapy
p1
Wynik w R
 motywacja_M motywacja_SD
        3.84         1.16
         motywacja
zdolnosci  <2 2-6  >6
   <75      0  14   0
   75-125  16 249  10
   >125     0  10   1
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe lm(), vcov(), predict(), expand.grid(); rysunek 1 – pakiety ggplot2, patchwork i colorspace). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czym różni się wykres konturowy od wykresu 3D powierzchni odpowiedzi?
To ta sama powierzchnia oglądana z dwóch stron. Wykres 3D pokazuje ją z boku i w perspektywie, więc część terenu bywa zasłonięta, a wartości trudno odczytać. Wykres konturowy pokazuje ją z góry, a poziomice z etykietami pozwalają odczytać przewidywany wynik w każdym punkcie.
Jak narysować wykres konturowy dla interakcji w R?
Utwórz siatkę wartości obu predyktorów funkcją expand.grid(), policz przewidywania funkcją predict() i narysuj je w ggplot2 warstwami geom_contour_filled() i geom_contour(). Na koniec dodaj punkty obserwacji, żeby było widać zakres danych.
Czy wykres konturowy zastępuje proste nachylenia w pracy?
Nie musi. Proste nachylenia z testami są zwięzłe i łatwe do opisania w Wynikach, a mapa konturowa pokazuje cały model i zakres danych. Często najlepiej dać oba panele obok siebie, jak w przykładzie.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Moderacja – wizualizacja na obrazkach
Proste nachylenia, obszar Johnsona–Neymana, mapa przewidywań, moderator dwuwartościowy, centrowanie i moc interakcji w 1000 badań – sześć rysunków z kodem R.
Czytaj →PoradnikAnaliza powierzchni odpowiedzi (RSA)
Regresja wielomianowa zamiast wyniku różnicowego: parametry a1–a4, główna oś, warunki hipotezy zgodności i przykład dopasowania osoba–praca w R.
Czytaj →PoradnikAnaliza moderacji krok po kroku
Hipoteza, centrowanie, model z interakcją, proste nachylenia, Johnson–Neyman, wykresy, moc, kod R, PROCESS w SPSS i opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hainmueller, J., Mummolo, J., & Xu, Y. (2019). How much should we trust estimates from multiplicative interaction models? Simple tools to improve empirical practice. Political Analysis, 27(2), 163–192. https://doi.org/10.1017/pan.2018.46 ● Otwarty dostęp
- McCabe, C. J., Kim, D. S., & King, K. M. (2018). Improving present practices in the visual display of interactions. Advances in Methods and Practices in Psychological Science, 1(2), 147–165. https://doi.org/10.1177/2515245917746792 ● Otwarty dostęp: pełny tekst
- Preacher, K. J., Curran, P. J., & Bauer, D. J. (2006). Computational tools for probing interactions in multiple linear regression, multilevel modeling, and latent curve analysis. Journal of Educational and Behavioral Statistics, 31(4), 437–448. https://doi.org/10.3102/10769986031004437 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{hainmueller2019how, author={Hainmueller, Jens and Mummolo, Jonathan and Xu, Yiqing}, title={{How much should we trust estimates from multiplicative interaction models? Simple tools to improve empirical practice}}, journal={Political Analysis}, year={2019}, volume={27}, number={2}, pages={163--192}, doi={10.1017/pan.2018.46}}@article{mccabe2018improving, author={McCabe, Connor J. and Kim, Dale S. and King, Kevin M.}, title={{Improving present practices in the visual display of interactions}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={147--165}, doi={10.1177/2515245917746792}}@article{preacher2006computational, author={Preacher, Kristopher J. and Curran, Patrick J. and Bauer, Daniel J.}, title={{Computational tools for probing interactions in multiple linear regression, multilevel modeling, and latent curve analysis}}, journal={Journal of Educational and Behavioral Statistics}, year={2006}, volume={31}, number={4}, pages={437--448}, doi={10.3102/10769986031004437}}